۱٫ مقدمه
توانایی نظارت، تجزیه و تحلیل، تجسم و پیشبینی حرکت ترافیک شهری در سالهای گذشته به دلیل افزایش ناگهانی دستگاههای مجهز به GNSS (سیستم ناوبری ماهوارهای جهانی) مانند تلفنهای هوشمند افزایش یافته است [ ۱ ، ۲ ]. به عنوان مثال، ناوگان ون های تحویلی مجهز به GNSS، یکی از این منابع داده است که امکان نظارت بر تراکم ترافیک در زمان واقعی در شهرهای شهری را ممکن می سازد. چنین داده هایی محبوبیت نقشه برداری ترافیک در حالت کمی را در میان گروه های تحقیقاتی افزایش داده است [ ۳ ، ۴ ، ۵]. ترافیک وسایل نقلیه به ویژه با استفاده از چنین داده هایی به دلیل تأثیر مستقیم آن بر اقتصاد و معیشت به طور گسترده مورد مطالعه قرار گرفته است. با این حال، مطالعات موجود به دلیل کمیاب بودن پوشش دادهها، پروکسیهای مقیاسپذیر و اعتبارسنجی حقیقت پایه، همیشه به مناطق مطالعاتی کوچک محدود شدهاند [ ۶ ]]. همه ارائه دهندگان عمده داده های ترافیکی در حال حاضر یا شرکت های خصوصی یا ارگان های دولتی هستند. بنابراین، دادهها به طور کلی برای علم و تحقیق در دسترس عموم قرار نمیگیرند-محققان برای دسترسی به آنها به حسن نیت سازمانهای صاحب دادهها یا منابع مالی کافی وابسته هستند. این امر نیاز روزافزونی به مجموعه دادههای جغرافیایی ارزان، در دسترس عموم، برای پیشبینی ترافیک با وضوح مکانی و زمانی قابلتوجه ایجاد میکند. چنین مجموعههای داده همچنین میتوانند برای پشتیبانی از سؤالات تحقیقاتی مشابه مربوط به انتشار CO ۲ ، برنامهریزی شهری، اهداف پایدار و رفاه کلی ساکنان شهری استفاده شوند [ ۷ ].
غولهای فناوری اطلاعات مانند Google، Yandex، HERE، Mapbox و غیره، در درجه اول به دادههای دورسنجی برای انجام تخمین ترافیک در مقیاس جهانی متکی هستند [ ۸ ، ۹ ]. بنابراین، جمعآوری دادهها یا از طریق API آنها (رابط برنامهنویسی برنامه)، از طریق SDK (کیت توسعه نرمافزار) نصب شده بر روی دستگاههای تلفن همراه کاربر مختلف یا از طریق برخی از ارائهدهندگان شخص ثالث مانند ناوگان ونهای تحویل دارای GNSS انجام میشود [ ۸ ، ۱۰ ]. مقدار دادههای تلهمتری جمعآوریشده به ترتیب میلیونها نقطه داده است، همانطور که Mapbox در سال ۲۰۱۷ گزارش داد، زمانی که این شرکت حدود ۲۰ میلیون نقطه برچسبگذاری شده جغرافیایی را برای ایجاد یک نقشه ترافیک جهانی جمعآوری کرد.
در دانشگاه، بسیاری از مطالعات منطقهای، قابلیت استفاده از دادههای رسانههای اجتماعی را برای درک تحرک انسان، ناوبری وسایل نقلیه، شهرهای هوشمند و مدلسازی شهری بررسی کردهاند [ ۱۱ ]. این فعالیتها بر جنبههایی مانند تراکم ترافیک وسایل نقلیه و عابران پیاده یا تخمینهای ماتریس مبدا-مقصد (OD) متمرکز شدهاند [ ۱۲ ]. با این حال، بیشتر کار بر اساس استفاده از داده های رسانه ای (متن، تصاویر، فیلم ها و برچسب ها) مرتبط با یک پلت فرم رسانه ای معین بوده است. برای مدلسازی ترافیک وسایل نقلیه، اکثر کارها مبتنی بر استفاده از محتوای پیامهای متنی دادههای توییتر برای شهرهای منتخب جهان است [ ۱۳ ].]. هسته اصلی این رویکرد جستجوی کلمات کلیدی مرتبط با ترافیک (در مورد توییتر) برای انجام تجزیه و تحلیل احساسات برای شناسایی شرایط ترافیکی در مجاورت است. این شامل متن کاوی و در برخی موارد تولید ماتریس OD است. این نوع رویکردها از نظر قابلیت انتقال به مناطق دیگر با زبان های گفتاری متفاوت دارای محدودیت هایی هستند. علاوه بر این، رویکردها را نمی توان به راحتی به سایر بسترهای رسانه ای منتقل کرد. Coffey [ ۱۴ ] تلاش کرد تا رابطه بین دادههای BikeShare و انواع پیامهای توییتی که توسط کاربران در طول سفر ایجاد میشود را بیابد. رویکرد اساسی تبدیل داده های تحرک به مجموعه ای از کلمات برای طبقه بندی مجدد بود. یکی دیگر از کارهای اخیر یائو [ ۹] سعی کرد با استخراج خوشه های فضایی از مختصات ارسال توییت، الگوهای تحرک انسان را کشف کند. نشان داده شده است که ویژگیهای مرتبط با توییت میتوانند تا حد زیادی پیشبینی ترافیک را برای بخشهای جادهای که تقاضای سفر نقش مهمی در تعیین ازدحام بازی میکند، بهبود بخشد [ ۱۵ ، ۱۶ ، ۱۷ ]. ژائو [ ۱۸ ] معیارهای مختلف مرکزیت سازگار را برای تخمین جریان ترافیک بررسی کرد. او علاوه بر مدلسازی شبکه با استفاده از نمودارهای اولیه و دوگانه، شبکه را بر اساس گروههایی از خیابانهای متراکم متصل، شبیه به مدل شبکه جادهای مبتنی بر جامعه، مدلسازی کرد. او همچنین تأثیر مدلهای شبکه را بر تخمین جریان ترافیک بررسی کرد.
Steiger [ ۱۹ ] اظهار داشت که «محتوای متنی توییتها که توسط کاربر تولید میشود، پر سر و صدا است، و استفاده از تکنیکهای پردازش زبان طبیعی (NLP) برای شناسایی اطلاعات معنادار را چالشبرانگیز میکند». او چند الگوی روزانه تکرار شونده را با ویژگیهای اختلال وابسته به زمان مشابه در امتداد جادههای شریانی (حلقهای) اصلی (مشابه مرکزیت جاده)، به عنوان شاخصی برای رفتار تحرک شناسایی کرد. گائو [ ۲۰] به طور جالبی با استفاده از مرکزیت بینالمللی برای پیشبینی ترافیک مخالفت کرد و گزارش داد که به دلیل تغییر شکل و دامنه در مناطق مورد مطالعه، شاخص پایداری نیست. برای دستیابی به سفرهای OD واقعیتر، او از اثر فاصله- فروپاشی برای وزن بیشتر به مسافتهای کوتاه به جای طولانی استفاده کرد. مطالعه قابل توجه دیگری در مورد این موضوع از Pun [ ۲۱ ] و Giles [ ۲۲ ] انجام شد که جریان ترافیک را بر اساس سه نوع اطلاعات جریان ترافیک، یعنی میانگین ترافیک روزانه سالانه (AADT)، ترافیک عمومی و ترافیک خصوصی مدلسازی کردند. آنها بیشتر تجزیه و تحلیل کردند که چگونه تراکم جمعیت OD بر تعداد سفرها در هر مسیر در روز تأثیر می گذارد.
در این مطالعه، امکان استفاده از دادههای رسانههای اجتماعی برچسبگذاریشده جغرافیایی به همراه یک معیار مرکزیت بین جادهای اقتباسشده و تقریبی و فضاهای ویژگی نقطهپوشش زمین مورد علاقه (POI)به عنوان یک پروکسی بالقوه برای تراکم ترافیک وسایل نقلیه مورد بررسی قرار گرفت. تلاشی جهانی برای درک بهتری انجام شده است که در آن وضوح مکانی و زمانی مناطق بسیار شلوغ مرتبط با وسایل نقلیه موتوری را می توان پیش بینی کرد. به طور خاص، حالتهای مختلف شمارش و کمیسازی نقاط داده و سایر پروکسیهای شناساییشده در مقیاسهای مختلف مورد بررسی قرار گرفتهاند که این را به یک مطالعه اثبات مفهوم تبدیل میکند. نویسندگان چارچوبی را برای استخراج این اطلاعات برای شبکههای مختلف خیابانهای شهری به نام SocialMedia2Traffic (SM2T) ارائه میکنند. این چارچوب افزایش آتی مجموعه داده های رسانه های اجتماعی در دسترس عموم را درک می کند، بنابراین بررسی می کند که آیا همه آنها می توانند به طور جمعی برای تقلید از داده های تله متری سایر راه حل های پولی استفاده شوند یا خیر. ما استدلال می کنیم که تجزیه و تحلیل مبتنی بر مکان برای تراکم ترافیک مقیاس پذیرتر و قوی تر است زیرا نیازی به تشخیص احساسات انسانی ندارد. ما یک روش بدون زمینه برای استخراج اطلاعات ترافیک پیشنهاد می کنیم. هدف این رویکرد این است که اطمینان حاصل شود که هر سرویس آینده بر اساس پیشبینیهای آن، در صورتی که یک منبع داده خاص از سرویس خارج شود، مجبور نباشد آفلاین شود – همانطور که تا حدی برای دادههای توئیتر با برچسب جغرافیایی در سال ۲۰۱۹ اتفاق افتاد، زمانی که این گزینه غیرفعال شد. مختصات مشتق از GNSS را به توییتها متصل کرد و فقط اطلاعات مکان دقیق کمتری را میتوان اضافه کرد.
دو راه برای استخراج اطلاعات ترافیک از داده های رسانه های اجتماعی تولید شده توسط انسان وجود دارد: (الف) با استفاده از زمینه رسانه تولید شده، و (ب) استفاده از موقعیت مکانی کاربر در طول دوره تولید داده [ ۲۳ ]. رویکرد مبتنی بر زمینه قابل انتقال در بسترهای رسانه های مختلف نیست [ ۲۴ ]، و پیچیده است اما با مقدار محدودی از داده کار می کند. از سوی دیگر، بازیابی ترافیک مبتنی بر مکان، مقیاسپذیر است و پیادهسازی آن آسانتر است، به این معنا که مستقل از هر پلتفرم خاصی باقی میماند و اگر به مقدار کافی ارائه شود، با یک پروکسی قوی استحکام بیشتری نشان میدهد [ ۲۵ ، ۲۶ ]]. احتمالاً تعداد نقاط دادهای «کافی» برای تجزیه و تحلیل مبتنی بر مکان برای وضوح مشخص، از منطقهای به منطقه دیگر متفاوت است. کارهایی مانند آنچه توسط Wang [ ۲۷ ] ارائه شده است چارچوب مشابهی را برای انجام نقشه برداری ترافیک ارائه می دهد. با این حال، این چارچوب از داده های رسانه های اجتماعی به عنوان یک پروکسی استفاده نمی کند و تنها بر مسیرهای GPS و داده های POI متکی است. Jayasinghe [ ۲۸ ] مناسب بودن معیارهای مرکزیت را برای تخمین جریان ترافیک بررسی کرد. به طور مشابه، ژانگ [ ۲۹] رابطه بین POIهای پوشش زمین کاربری زمین و ازدحام جریان ترافیک در چندین شهر را بررسی کرد. بنابراین، ادبیات از ایده استفاده از رسانههای اجتماعی، POI و دادههای مرکزی برای نقشهبرداری ترافیک پشتیبانی میکند، اگرچه هیچ تلاش ترکیبی برای اندازهگیری همه آن در مقیاس جهانی وجود نداشته است. علاوه بر این، چارچوبی برای توسعه نرم افزار به عنوان یک سرویس وجود ندارد.
اهداف این مقاله به شرح زیر است:
-
برای آزمایش وجود یک رابطه مستقیم و همچنین ترکیبی بین دادههای توئیتر برچسبگذاریشده جغرافیایی/ POI پوشش زمین کاربری زمین/مرکزیت بین و تراکم ترافیک بالا در جادهها.
-
ارائه چارچوبی برای آموزش مدل و استدلال برازندگی آن برای هدف.
هیچ سرویس وب باز در دسترس نیست که نقشه تراکم ترافیک پویا را در مقیاس جهانی ارائه دهد. یکی از کاربران فوری سرویس SM2T خدمات مسیریابی در دسترس عموم مانند OpenRouteService [ ۳۰ ] است که به شکل زمان تخمینی رسیدن بهتر سود می برد. چنین خدماتی قرار است به بسیاری از بخشها مانند تحویل پیک، برنامهریزی شهری، مدلسازی محیطی، انتشار کربن و غیره کمک کند [ ۳۱ ، ۳۲ ، ۳۳ ، ۳۴ ]. مجموعه داده سرعت Uber Movement برای به دست آوردن حقیقت پایه برای شهرهای منتخب جهان در دسترس است (داده ها را می توان از Uber Movement، (c) 2021 Uber Technologies, Inc., San Francisco, CA, USA, [ ۳۵ ] بازیابی کرد.]). هیچ کار بررسی شده با این ماهیت به صورت آنلاین در مقیاس جهانی موجود نیست. چارچوب ارائه شده در اینجا با هدف ارائه دادههایی در مورد ازدحام ترافیک بالا در مقیاس جهانی، بر خلاف مناطق آزمایشی کوچکی که مطالعات تحقیقاتی فعلی در حال حاضر ارائه میدهند، است. اگرچه دقت و وضوح مکانی/زمانی SM2T به خوبی پشت هر راه حل اختصاصی قرار می گیرد، این باید به عنوان یک مطالعه اولیه برای بررسی امکان در این جهت تلقی شود.
ما رابطه بین دادههای توییتر و سرعت ترافیک را با استفاده از تنظیمات آزمایشی زیر بررسی کردیم:
-
ما دو پراکسی مبتنی بر توییتر را به عنوان یک پیش بینی آزمایش کردیم: تعداد کاربران در یک بخش جاده و تعداد کاربران در مجاورت.
-
ما از POI های مربوط به کاربری زمین و پوشش زمین به عنوان یک پیش بینی اضافی استفاده کردیم و چهار روش مختلف را برای جمع آوری اطلاعات POI برای یک کاشی معین بررسی کردیم.
-
ما از یک اندازه گیری مرکزیت اقتباس شده به عنوان یک پیش بینی اضافی استفاده کردیم. مرکزیت بین با توجه به مجموعه متفاوتی از POI اندازه گیری شد.
-
ما چهار وضوح فضایی مختلف را برای یک مدل تسلاسیون مبتنی بر شبکه معمولی آزمایش کردیم.
-
ما قطعنامههای موضوعی مختلفی را بررسی کردیم: (۱) با استفاده از اطلاعات سرعت ترافیک پیوسته و (۲) استفاده از اطلاعات سرعت ترافیک طبقهبندی شده در سه سطح ازدحام.
-
ما عملکرد پنج مدل یادگیری ماشین را آزمایش کردیم.
۲٫ روش ها و داده ها
۲٫۱٫ چارچوب مفهومی
پلتفرمهای رسانههای اجتماعی مختلف اطلاعات را در قالبها و حالتهای مختلف تولید میکنند (به جدول ۱ مراجعه کنید )، که هر نوع تخمین حجم ترافیک را به شدت وابسته به پلتفرم میکند. به عنوان مثال، یک مدل مبتنی بر متن یا متن آموزش داده شده بر روی داده های توییتر را نمی توان برای داده های فلیکر مبتنی بر تصویر استفاده کرد. بنابراین، تجزیه و تحلیل مبتنی بر زمینه نیاز به یادگیری ماشینی گسترده برای رسانه خاص دارد که باید ویژگیهای پلتفرم را در بر بگیرد. از سوی دیگر، مدلی که فقط بر روی دادههای مکان و مهر زمانی از توییتر آموزش داده شده است، تا زمانی که اطلاعات مربوطه را ارائه میکند، میتواند در هر پلتفرم دیگری اعمال شود.
می توان انتظار داشت که موقعیت و اتصال بخش های جاده در یک شهر با میانگین حجم ترافیک مرتبط باشد. گمان می رود جاده هایی با اهمیت بالاتر به طور متوسط ترافیک بیشتری نسبت به سایرین دارند. علاوه بر این، ترافیک به جذابیت منطقه بستگی دارد. نویسندگان فرض کردهاند که این میتواند با استفاده از چگالی POIهای خاص گرفته شود. فرض بر این بود که تعداد بیشتری از این POI ها به طور مثبت با حجم ترافیک بالاتر مرتبط هستند. فرض بر این بود که جذابیت یک منطقه توسط آن POI ها افزایش می یابد، حتی اگر POI ها مستقیماً با ماشین قابل دسترسی نباشند، به عنوان مثال، اگر POI ها در مناطق عابر پیاده قرار داشته باشند. علاوه بر این عوامل ایستا، حجم ترافیک توسط عوامل پویا شکل می گیرد که به دلیل زمان روز، روز هفته منجر به الگوهای منظم و نامنظم می شود. وجود تعطیلات یا تعطیلات مدرسه یا رویدادهای خاص مانند کار ساختمانی، رویدادهای ورزشی بزرگ، تظاهرات، و غیره. نویسندگان فرض میکنند که این عوامل پویا را میتوان با فعالیت رسانههای اجتماعی در پلتفرم توییتر ثبت کرد. این فعالیتها و حجم ترافیک را میتوان بهطور مستقیم یا غیرمستقیم بسته به اینکه توییتهای مسافران (امیدوارم نه رانندگان) در طول سفر یا برای همه کاربران توییتر حاضر در یک منطقه فیلتر شود، بهطور مستقیم یا غیرمستقیم مرتبط شوند. احتمالاً مورد دوم با کمی تأخیر زمانی به حجم ترافیک مرتبط است. سطح بالاتری از فعالیتهای رسانههای اجتماعی بسته به جهت سفر ممکن است قبل و بعد از حجم ترافیک بالا باشد. اگر حجم ترافیک در یک سطح انباشته زمانی پیشبینی شود، این احتمالاً منجر به پیشبینیهای بهتری میشود زیرا نوسانات کوتاهمدت به طور میانگین محاسبه میشوند.
نویسندگان پنج رزولوشن زمانی مختلف را برای تحلیل فعلی مفهومسازی کردهاند ( شکل ۱ را ببینید ): لایه ترافیک زنده > لایه تجمعی زمان > لایه تجمعی در روز هفته > لایه تجمعی هفته > لایه محدودیت سرعت OSM . لایه Live Traffic پیشبینیهای ترافیکی را که با استفاده از دادههای رسانههای اجتماعی در زمان واقعی انجام میشود، همراه با سایر فضاهای ویژگی نگه میدارد. به محض اینکه این لایه خاص قدیمی شود، تمام لایههای زیرین بهجز لایه محدودیت سرعت OSM بهروزرسانی میشود . لایه Time Aggregatedشامل وضعیت ترافیک سطل های زمانی از پیش تعریف شده برای منعکس کننده ساعات رفت و آمد اداری است. لایه Weekdays Aggregated وضعیت ترافیک جمع آوری شده در چهار روز هفته گذشته را نشان می دهد – به عنوان مثال، با جمع آوری وضعیت ترافیک منطقه با جمع آوری چهار دوشنبه آخر اگر کاربر اطلاعات ترافیک دوشنبه را درخواست می کند. به طور مشابه، لایه Week Aggregated ارزش ترافیک را با تجمیع دادههای هفت روز گذشته، با در نظر گرفتن تمام زمانبندیها، حفظ میکند. علاوه بر این، در نهایت، اگر برای یک منطقه مشخص اطلاعاتی از هیچ یک از لایههای بالا در دسترس نباشد، لایه محدودیت سرعت OSMبرای بازگشت حداکثر سرعت مجاز بزرگراه استفاده می شود. بنابراین، این پشته لایه ترافیک تضمین می کند که کاربر حداقل اطلاعاتی را برای بخش جاده درخواستی دریافت می کند، با بالاترین وزن دادن به لایه ترافیک زنده و وزن نزولی به سمت لایه محدودیت سرعت OSM . پیشبینی کلی ترافیک میانگین وزنی تمام این لایهها خواهد بود.
در دسترس بودن نسبتاً بالای رسانه های اجتماعی با وضوح مکانی و زمانی نسبتاً بالا به عنوان یک نیاز برای استفاده قابل اعتماد از پشته لایه ترافیک SM2T انتظار می رفت. از آنجایی که فضاهای ویژگی انتخاب شده مستقیماً فقط بر لایه ترافیک زنده تأثیر میگذارند ، بقیه مقاله فقط رابطه بین این دو را بررسی میکند.
۲٫۲٫ شهرهای مورد استفاده برای مطالعه موردی
یازده شهر جهان (به جدول ۲ مراجعه کنید ) که دادههای سرعت Uber برای آنها در دسترس بود، برای آزمایش مدلهای مختلف انتخاب شدند. جعبههای مرزی شهر به ازای مرزهای سطح ۲ مدیر GADM [ ۳۶ ] برای انتخاب و برش مجموعههای داده استفاده شد.
۲٫۳٫ دادههای جنبش اوبر
Uber یک ارائهدهنده خدمات تحرک است که اخیراً شروع به ارائه دادههای سرعت خودروی شهری تحت مجوز Creative Commons Attribution Non-Commercial [ ۳۵ ] کرده است. نویسندگان از آن برای شناسایی بخش های جاده ای پر ترافیک در شهرهای انتخاب شده استفاده کردند. داده ها با شناسه بزرگراه OSM به عنوان یک کلید خارجی ارائه می شوند که امکان تطبیق آن با شبکه جاده ای OSM مربوطه را فراهم می کند. Uber داده های سرعت خودرو را برای بخش هایی از اشیاء جاده ای OSM ارائه می دهد. بخش های جاده با مشخص کردن OSM-id شروع و پایان بخش تعریف می شوند. علاوه بر این، جهت رانندگی نشان داده شده است. برای شهرهای منتخب، میانگین سرعت حرکت متفاوت است، بین ۲۷٫۰ کیلومتر در ساعت برای سائوپائولو و ۵۱٫۵ کیلومتر در ساعت برای سینسیناتی (به جدول ۳ مراجعه کنید ).
برآورد کلاس تراکم ترافیک در هر کاشی بر اساس این دادههای سرعت خودرو برای مارس ۲۰۱۸ تا نوامبر ۲۰۱۹ بود. هر بخش جاده با استفاده از جدول ۴ به یک کلاس تراکم ترافیک اختصاص داده شد . اشیاء جاده OSM با کاشی ها تلاقی می کردند. برای هر کاشی میانگین وزنی کلاس تراکم ترافیک محاسبه شد. از این رو، طول بخش های جاده ای تقسیم شده به عنوان وزن استفاده شد. از آنجایی که کلاسهای تراکم ترافیک بهعنوان ۰، ۱ و ۲ کدگذاری میشوند، گرد کردن میانگین وزنی به نزدیکترین عدد صحیح منجر به کلاس تراکم ترافیک تخمینی میشود (یعنی HTC، MTC یا LTC). بخشهای جاده با دادههای گمشده Uber نادیده گرفته شد.
۲٫۴٫ پروکسی توییتر
برای استفاده از فرمول فاصله برای تولید نقشه های ترافیکی، باید حداقل یک وسیله نقلیه در یک بخش جاده معین برای یک نقطه زمانی خاص با فرکانس تولید داده بالا داشته باشد. به طور کلی، SDK های راه حل های اختصاصی هر ۱۰ ثانیه نقاط داده GNSS را تولید می کنند. برخلاف دادههای تلهمتری، دادههای رسانههای اجتماعی برچسبگذاریشده جغرافیایی را نمیتوان به این روش استفاده کرد زیرا پوشش داده کافی نیست (توئیتر تنها ۱٪ از پوشش جهانی توییت را از طریق API استریم خود ارائه میکند) و ماهیت ذاتی که توسط آن تولید میشود. کاربر معینی که فید رسانه های اجتماعی را در فاصله زمانی ۱۰ ثانیه یا کمتر تولید می کند، باید به عنوان یک چیز دور از ذهن یا مصنوع در نظر گرفته شود.
در صورت تصمیم کاربر، دو روش وجود دارد که میتوان موقعیت جغرافیایی را به توییتها متصل کرد: با مختصات و با کلید مکان . کلید مختصات قبل از سال ۲۰۱۹ برای ذخیره مختصات GNSS از دستگاهی که کاربر از آن توییت کرده بود استفاده می شد. حداقل با استفاده از مشتری رسمی توییتر، از سال ۲۰۱۹ دیگر این امکان وجود ندارد. برنامه های شخص ثالث – مانند اینستاگرام – هنوز هم اجازه می دهند کلید پر شود. با این حال، به نظر میرسد اینستاگرام از کلید مختصات برای هدف دیگری استفاده میکند، نه موقعیت فعلی کاربر، بلکه مختصات را از یک مکان ثابت مشخص شده توسط کاربر [ ۳۷ ]. بنابراین با استفاده از مختصاتاحتمالاً کلید توییتهای فعلی منجر به نتایج بسیار گمراهکنندهای میشود. این رفتار اینستاگرام قبل از سال ۲۰۱۹ گزارش شده است [ ۳۷ ]. کلید مکان امکان انتخاب مختصات یک مکان با نام تعریف شده توسط توییتر را در نزدیکی مکانی که توییت در آن پست شده است را می دهد. این مکان ها با سطوح مختلفی از دانه بندی ارائه می شوند: دسته بندی ها “کشور”، “شهر” و “poi” هستند.
نویسندگان به داده های توییتر برای مارس ۲۰۱۸ تا نوامبر ۲۰۱۹ از API استریم توییتر دسترسی داشتند. توییت هایی با کلید GeoCoordinates با مختصات GNSS دقیق استفاده شد. تعداد کاربران مجزای توییتر و تعداد توییتها با بیش از یک مرتبه بزرگی بین شهرهای انتخاب شده متفاوت است ( جدول ۳ را ببینید). در دسترس بودن کم داده توییتر با استفاده از دو پراکسی برطرف شد. تعداد کاربر در یک پراکسی شبکه جاده ای بر اساس تمام توییت های موجود در یک بافر معین از یک بخش جاده است ( شکل ۲ الف را ببینید). اندازه بافر بسته به کلاسهای مختلف جاده OSM انتخاب شد ( جدول ۴ را ببینید). این پراکسی در نظر گرفته شده است که زیرمجموعه ای از جمعیت جاده را که در حین سواری توییت می کنند، ثبت کند، که ممکن است سهم کمی از همه کاربران جاده باشد. در حالی که انتظار میرود عرض جاده انواع جاده OSM در کشورهای مختلف متفاوت باشد، از بافرهای یکسانی برای تجزیه و تحلیل در همه شهرهای انتخاب شده استفاده میشود. راه دیگر برای تخمین تعداد واقعی کاربران جاده یا وسایل نقلیه در جاده، استفاده از تعداد کاربران در مجاورت (ر.ک. شکل ۲ ب) به عنوان یک پروکسی است. فضاهای عمومی کلیدی (به جدول ۵ مراجعه کنید ) برای انتخاب خوشه های توییت بدون بافر استفاده شد.
نویسندگان دو رویکرد اضافی را برای استخراج اطلاعات ترافیک از دادههای توییتر آزمایش کردند ( جدول ۶ را ببینید). رویکرد تخمین سرعت مستقیم از نقاط داده به عنوان داده های تله متری با استفاده از فرمول سرعت استفاده می کند. استفاده از آن به طور مستقیم از داده های تله متری و نحوه استفاده از آنها در راه حل های اختصاصی تقلید می کند. اگر بتوان از این رویکرد استفاده کرد، دیگر نیازی به هیچ مدل یادگیری ماشینی در لایه Live Traffic و استفاده از سایر فضاهای ویژگی وجود نخواهد داشت. با این حال، به دلیل فرکانس پایین تولید داده توسط کاربران، این رویکرد برای دادههای توییتر مناسب نیست – کاربران به ندرت چندین بار در هنگام عبور از یک بخش جاده توییت میکنند. مبتنی بر زمینهپروکسی در گذشته به طور گسترده توسط محققان مورد مطالعه قرار گرفته است. با این حال، وابستگی بالای پلت فرم و فقدان عبارات کلیدی استاندارد ترافیک، قابلیت انتقال آن را محدود می کند. استفاده از عبارات و فرهنگ های خاص زبان، تجزیه و تحلیل مبتنی بر زمینه را دست و پا گیر و بسیار پیچیده می کند. در دسترس بودن داده ها برای تجزیه و تحلیل مبتنی بر زمینه نیز کم است زیرا تعداد بسیار کمی از توییت ها حاوی عبارات یا احساسات مرتبط با ترافیک هستند. کاربران تمایل دارند بعد از ترافیک واقعی توییتهای مرتبط با ترافیک را پست کنند، بنابراین این پراکسی فقط برای زمانبندیهای بزرگتر قابل استفاده است.
۲٫۵٫ پروکسی نقطه بهره برداری از زمین و پوشش زمین
POI استفاده از زمین و پوشش زمین نشان دهنده زیرساخت هایی است که به عنوان یک راه نجات برای هر شهر عمل می کند. آنها از سوپرمارکتها، بیمارستانها، مدارس و دانشگاهها گرفته تا ایستگاههای اتوبوس، پارکینگها، و غیره را در بر میگیرند. در SM2T، POIهای کاربری زمین انتخاب شده به عنوان یک فضای ویژگی اضافی برای پیشبینی ترافیک استفاده میشوند. نویسندگان وزن ها و شعاع ضربه را اختصاص دادند (ر.ک. [ ۳۸ ]) و از آنها در طول پردازش داده ها برای محاسبه اثرات آنها بر ترافیک بخش های جاده های مجاور استفاده کردند.
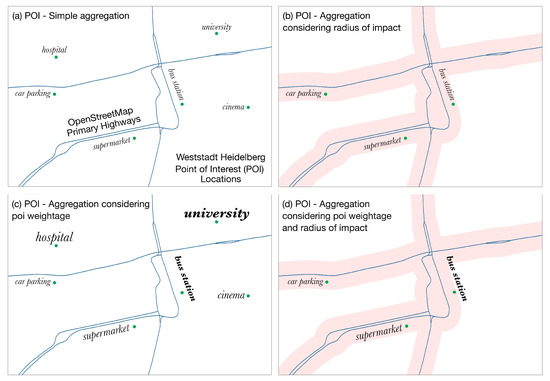
چهار رویکرد برای تجمیع یا شمارش POIهای مختلف کاربری زمین در نزدیکی یک بخش جاده آزمایش شده است ( شکل ۳ را ببینید). تجمیع با استفاده از یک شبکه معمولی برای تسلیت انجام شد. ایده این است که از این نقاط داده برای علامت گذاری بخش های جاده ای نزدیک با درجات مختلف ازدحام ترافیک استفاده شود. ساده ترین رویکرد (ر.ک. شکل ۳الف) تمام POIهایی را که در یک کادر محدود وجود دارند، می شمارد. سپس از این شمارشها برای علامتگذاری پرچمهای ترافیکی، بر اساس نوع جاده، برای تمام بخشهای جاده در داخل جعبه مرزی استفاده شد. با این حال، مشاهده شد که POI های مختلف بر اساس فاصله آنها از بخش های جاده مجاور و تعداد افرادی که به آنها خدمت می کنند، می توانند درجات مختلفی از تأثیر ترافیک را داشته باشند. برای ثبت این، بافرهای جاده و/یا وزن POI نیز به منظور فیلتر کردن و وزن کردن POIها مورد استفاده قرار گرفتند ( شکل ۳ b-d).
۲٫۶٫ پروکسی مرکزیت
در نهایت، یک اندازهگیری مرکزیت میانی اقتباس شده از هر بخش جاده به عنوان یک فضای ویژگی اضافی استفاده میشود. برای SM2T، نویسندگان معیار اصلی مرکزیت بین بودن [ ۳۹ ] را برای شامل توزیع فضایی تراکم جمعیت و POI ها تطبیق دادند. این مجموعه از POI با POIهای استفاده از زمین و پوشش زمین که برای پراکسی POI در بخش ۲٫۵ استفاده می شود متفاوت است. گائو [ ۴۰] نشان داد که انتخاب نقطه شروع و پایان سفرهای شبیه سازی شده بر اساس تراکم جمعیت و داده های POI، رابطه نزدیک تری بین شاخص مرکزیت و جریان ترافیک واقعی در یک شهر به دست می دهد. بخشهای اصلی جادهای که اکثریت جمعیت را به زیرساختهای حیاتی مانند سوپرمارکتها، بیمارستانها و غیره متصل میکنند، میتوانند شناسایی شوند و متعاقباً بهعنوان حساستر در برابر ترافیک مشخص شوند. Ohsome API [ ۴۱ ] برای دانلود شبکه جاده های شهر و POI های انتخاب شده استفاده شد. ما مرکزیت را با شبیه سازی ۲۰ هزار سفر در هر شهر، با موضوع و وزن توابع کنش انسانی با استفاده از openrouteservice محاسبه کردیم ( https://openrouteservice.orgقابل دسترسی در ۴ آوریل ۲۰۲۲). سفرها بر اساس جفت مکانهای نمونهبرداری شده برای هر شهر شبیهسازی شدند. یک مکان بر اساس رویکرد احتمال نمونه گیری ناهموار با استفاده از تراکم جمعیت به عنوان وزن احتمال ترسیم شد. مورد دیگر از POIهای تابع عمل انسانی انتخاب شد. دادههای جمعیت از لایه جمعیت اسکان انسانی جهانی [ ۴۲ ، ۴۳ ] به دست آمد]، مجموعه داده شطرنجی با اندازه سلول ۲۵۰ متری. POI تابع کنش انسانی شامل POIهایی از گروههای عملکردی «کار»، «آموزش»، «خرید» و «تفریح» است. سفرهای کوتاهتر از ۱ کیلومتر رد شد زیرا ما سفر ماشینی را فرض میکردیم. ما همچنین از یک تابع فاصله-واپاشی برای ایجاد سفرهای کوتاهتر از سفرهای طولانی مدت استفاده کردیم. تطبیق مسیرها به شبکه خیابان OSM برای محاسبه مرکزیت با استفاده از تطبیق نقشه سریع توسعه یافته توسط Canfast [ ۴۴ ] انجام شد.
۲٫۷٫ تفکیک مکانی، زمانی و موضوعی
سرعت حرکت وسایل نقلیه در یک بخش جاده – که با سطح تراکم ترافیک نسبت معکوس دارد – همیشه یک عدد صحیح مثبت است. در حالت ایده آل، مشکل اساسی باید به عنوان یک مشکل رگرسیونی در نظر گرفته شود که تمام فضاهای ویژگی و برچسب های هدف دارای اعداد صحیح مثبت هستند. با این حال، تجسم داده های اولیه و تجزیه و تحلیل آماری نشان داد که پیش بینی ترافیک در سطح جاده با وضوح زمانی چند دقیقه به دلیل در دسترس بودن بسیار کم داده های توییتر امکان پذیر نیست. در میان همه متغیرهای مستقل در نظر گرفته شده، داده های رسانه های اجتماعی تنها منبعی بودند که حاوی اطلاعات مهر زمانی بودند. بنابراین، این یک عامل کنترل کننده برای وضوح زمانی برای لایه ترافیک زنده بود ( شکل ۱ را ببینید.). علاوه بر این، تعداد توئیتهایی که با نقشه مطابقت داده شده با یک بخش جاده معین برای استخراج هر گونه پراکسی آماری معنیداری در مقیاس بخشهای جاده برای تحلیل رگرسیون کافی نبود. بنابراین، نویسندگان مجبور به کاهش وضوح مکانی، زمانی و موضوعی برای پیشبینیهای معنادار شدند. در مورد وضوح فضایی، چهار اندازه کاشی، یعنی ۵۰، ۱۰۰، ۵۰۰ و ۱۰۰۰ متر، برای شناسایی یک سازش خوب بین وضوح و دقت پیشبینی بررسی شد. در مورد وضوح زمانی، در ابتدا، سطلهای زمان ثابت که نشاندهنده ساعات رفتوآمد اداری هستند (۰۷:۰۰-۱۰:۰۰ و ۱۵:۰۰-۱۹:۰۰) بازرسی شدند. با این حال، به دلیل تعداد کم نقاط داده در هر سطل زمانی، تغییرات زمانی ترافیک در مدل در نظر گرفته نشد. بجای،
برای کاهش وضوح موضوعی، با استفاده از سه کلاس تراکم ترافیک به عنوان خروجی نهایی، مشکل به یک مشکل طبقه بندی تبدیل شد: تراکم ترافیک بالا (HTC)، تراکم ترافیک متوسط (MTC) و ازدحام ترافیک کم (LTC). تعریف سه کلاس تراکم برای یک اندازه کاشی معین مبتنی بر رویکرد سطل کمیت برابر با در نظر گرفتن توییتها، POIهای پوشش زمین کاربری زمین و شاخصهای مرکزیت بینالمللی است. ۳۳٪ بالا نشان دهنده HTC، ۳۳٪ پایین LTC و وسط ۳۳٪ MTC است. بنابراین، نویسندگان توانستند همه انواع بزرگراه OSM را ترکیب کنند، برخلاف رگرسیون، که در آن هر نوع بزرگراه باید به طور جداگانه مورد بررسی قرار می گرفت. این منجر به تعداد بیشتری از نمونه های آموزشی شد.
در نهایت، دادههای Uber Movement به عنوان برچسب هدف برای آموزش مدل استفاده شد. سطلهای سرعت ثابت (به جدول ۴ مراجعه کنید ) برای تبدیل دادههای Uber پیوسته به کلاسهای ترافیک برای هر نوع بزرگراه OSM (بزرگراه، تنه، اولیه، ثانویه، سوم و مسکونی) استفاده شد.
۲٫۸٫ مدیریت داده ها از دست رفته است
پس از پردازش دادهها، مجموعه داده دارای چندین کاشی (برای هر اندازه کاشی) به همراه برچسبهای کلاس HTC در مقابل بدون HTC برای Uber، Twitter، POIهای پوشش زمین کاربری زمین و مرکزیت بینالمللی بود. از آنجایی که کاشیهای زیادی وجود داشت که حداقل یکی از مقادیر در آنها وجود نداشت، نویسندگان سه مجموعه داده جداگانه برای آموزش مدل آماده کردند. در اولین مجموعه داده، فقط آن کاشیهایی گرفته شد که تمام مقادیر غیر تهی برای ستونهای مختلف وجود داشت. این مجموعه داده از نظر تعداد ردیف ها کوچکترین بود. در مجموعه داده دوم، همه آن کاشیها در جایی گرفته شدند که ستون توییتر دارای یک مقدار غیر تهی بود. در مورد مواردی که POIهای پوشش زمین استفاده از زمین و/یا کلاس مرکزیت میانی وجود نداشت، از برچسب no-HTC (ساختگی) استفاده شد. در نهایت، در مجموعه داده سوم، تمام کاشیها برداشته شدند و تمام سلولهای خالی با برچسب بدون HTC (ساختگی) جایگزین شدند. دلیل استفاده از برچسب no-HTC به عنوان ساختگی در اینجا این فرض بود که داده ها ممکن است به درستی عدم وجود هر گونه توییت را نشان دهند، در نتیجه نشان دهنده ازدحام کم ترافیک و در نتیجه عدم وجود HTC است. برای تمام آموزش های بعدی، این سه مجموعه داده به طور مستقل مورد تجزیه و تحلیل قرار گرفتند.
۲٫۹٫ مقایسه روش های یادگیری ماشین
برای یافتن بهترین الگوریتم طبقهبندی مناسب برای رگرسیون لجستیک [ ۴۵ ]، Naive Bayes [ ۴۵ ]، طبقهبندیکننده k-نزدیکترین همسایه [ ۴۶ ]، مدلهای جنگل تصادفی [ ۴۷ ] و مدلهای ماشین برداری پشتیبان [ ۴۸ ] با استفاده از CV جستجوی شبکهای مقایسه شدند. رویکرد در بسته پایتون Sklearn [ ۴۹ ] برای تنظیم هایپرپارامتر. اگرچه بسیاری از مدلهای دیگر را میتوان آزمایش کرد، اما این مدلهای انتخاب شده استانداردترین مدلهایی هستند که پیادهسازی آسان و همچنین سبک وزن هستند. دقت (ر.ک. معادله ( ۱ )) برای ارزیابی مدل مورد استفاده قرار گرفت، زیرا این بالاترین اولویت برای پروژه بود – فراخوانی یا امتیاز F1 استفاده نشد.
با TP مثبت واقعی و FP مثبت کاذب.
واحد فضایی که در آن مدلسازی صورت گرفت، سطح کاشیها بود.
۳٫ نتایج
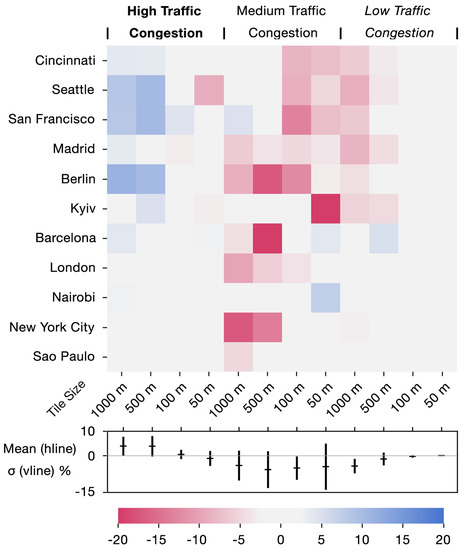
هنگام مقایسه پیش بینی انجام شده توسط کلاس مرکزیت به عنوان پیش بینی کننده برای اندازه های مختلف کاشی و سه سطل سرعت (HTC، MTC و LTC)، کلاس HTC بالاترین دقت را نشان داد ( شکل ۴ ). مقایسه اندازههای مختلف کاشی نشان داد که رابطه بین متغیر پیشبینیکننده و هدف در اندازههای کاشی ۱۰۰ و ۵۰ متر قویترین است ( شکل ۴ ). نتیجهگیریهای مشابهی برای پراکسیهای توییتر و پیشبینیکنندههای POI پوشش زمین استفاده از زمین پشتیبانی شد (نتایج نشان داده نشد). از آنجایی که بهترین پیشبینی هنگام پیشبینی تنها HTC به دست آمد، مشکل طبقهبندی چند کلاسه متعاقباً به یک طبقهبندی بولی تبدیل شد که در آن HTC در مقابل no-HTC ارزیابی و پیشبینی شد.
پیشبینیهای مبتنی بر دو پراکسی ( تعداد کاربر در یک بخش جاده و تعداد کاربر در مجاورت ) بهتر از استفاده از شمارش ساده توییت برای موقعیتهای تراکم ترافیک بالا بود ( شکل ۵ را ببینید). نتیجه مشابهی برای تجمع POIهای پوشش زمین کاربری زمین با استفاده از وزن و شعاع روش ضربه پیدا شد.
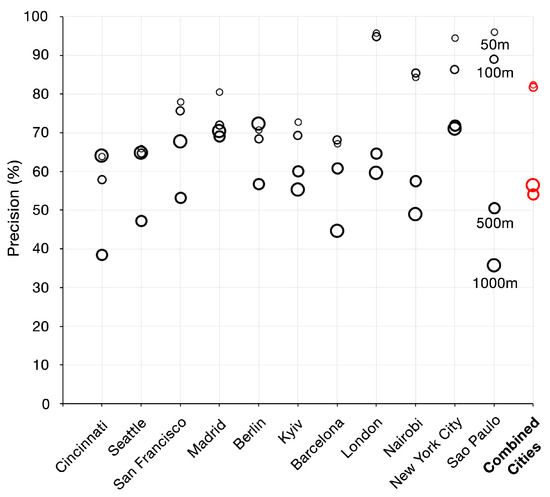
در حالی که پیشبینی تراکم ترافیک بالا برای ترکیب همه شهرها تقریباً متعادل بود، پیشبینیها برای شهرهای جداگانه نامتعادل بود ( شکل ۶ و شکل ۷ را ببینید.). سینسیناتی تقریباً به طور کامل بدون برچسب HTC و سائوپائولو تقریباً به طور کامل برچسب HTC برای اندازه کاشی های ۵۰۰ و ۱۰۰ متری داشت. از سوی دیگر، کیف توزیع متعادل تری از مکان های کاشی HTC و بدون HTC را در ۱۰۰۰ متر و همچنین در اندازه کاشی ۵۰۰ متر نشان داد. جالب است بدانید شهرهایی که ازدحام ترافیک بیشتری را نشان میدهند در صورتی که دادههای اوبر دقت پیشبینی بالاتری داشتند. بنابراین، یک رویکرد واقع بینانه تر، در نظر گرفتن تمام کاشی های شهرهای مختلف برای از بین بردن تأثیر شدید این عدم تعادل است، اگرچه همه شهرها نیز به طور مستقل برای آموزش بازرسی شدند.
سپس، با مقایسه پنج مدل مختلف یادگیری ماشینی از نظر دقت در همه شهرها، طبقهبندیکننده k نزدیکترین همسایهها بهترین عملکرد را از نظر میانگین دقت برای همه اندازههای کاشی داشت ( شکل ۸ را ببینید). با این حال، تفاوت عملکرد در بین مدلهای مختلف، بهویژه بین k-نزدیکترین همسایگان و طبقهبندی Random Forest بسیار ناچیز بود. با این حال، به دلیل پیچیدگی مدل کمتر، اولی را برای تحلیل بیشتر انتخاب کردیم. اگر مدل باید به عنوان بخشی از یک وب سرویس استفاده شود، مفید است، زیرا مدل های سبک وزن از پیش بینی سریع و تنظیم مجدد هایپرپارامتر پشتیبانی می کنند. در مطالعهای بر روی پیشبینی تراکم ترافیک با استفاده از مجموعهای از پیشبینیکنندهها، تیم Uber همچنین طبقهبندیکننده k-نزدیکترین همسایه و همچنین بهترین مدل را شناسایی کرد.۵۰ ]. در میان اندازههای مختلف کاشی، ۱۰۰ و ۵۰ متر بالاترین میانگین دقت را ارائه میدهند. در تمام مدلها، اگر کاشیهای دارای اطلاعات ویژگیهای گمشده به جای استفاده از یک مقدار ساختگی برای آن کاشیها حذف شوند، میانگین دقت بالاترین بود.
هیپرتنینگ طبقهبندیکننده k-نزدیکترین همسایه تعداد بهینه ۳۰ همسایه را برای اندازههای کاشی ۵۰، ۱۰۰ و ۵۰۰ متری پیشنهاد میکند ( شکل ۹ را ببینید). برای اندازه کاشی ۱۰۰۰ متری، هیچ ارزش واضحی قابل شناسایی نیست. این به دلیل تعداد بسیار کم نمونهها برای چنین وضوح فضایی درشتی است که منجر به تعداد بسیار کمی همسایهها میشود، بنابراین اجازه بهینهسازی مناسب پارامتر را نمیدهد.
شکل ۷٫ تجسم کلاسهای تراکم ترافیک مشتق شده از تمام فضاهای ویژگی با استفاده از یک رویکرد کمی و مجموعه داده اعتبار (Uber) برای سه شهر (هر دو سناریو مورد لبه را نشان میدهد). تعداد سلولهای دارای پیشبینی متفاوت است، زیرا پیشبینیکنندهها برای همه کاشیها در دسترس نبودند. دقت پیش بینی های مدل در شکل ۱۰ ارائه شده است .
شکل ۸٫ مقایسه دقت پنج الگوریتم طبقه بندی برای اندازه های مختلف کاشی. این سه نمودار مجموعه دادههای مختلف را بر اساس نحوه مدیریت سلولهای خالی با استفاده از مقدار ساختگی نشان میدهند. تنوع در نمودارهای جعبه به دلیل دقت متفاوت برای هر شهر است.
شکل ۹٫ انتخاب بهترین عملکرد تعداد همسایه طبقه بندی کننده k نزدیکترین همسایه برای اندازه های مختلف کاشی. منحنی قرمز نشان دهنده شهرهای ترکیبی است. رنگ های مشکی مختلف نشان دهنده هر شهر است. خط آبی عمودی مقدار انتخاب شده ۳۰ نزدیکترین همسایه را مشخص می کند.
شکل ۱۰٫ عملکرد طبقه بندی کننده k نزدیکترین همسایه (k = 30) برای اندازه های مختلف کاشی، شهرهای مختلف و مجموعه داده های ترکیبی. برای هر شهر، مدل با استفاده از یک رویکرد اعتبار سنجی متقابل ۵ برابری با استفاده از همه شهرها به جز شهر انتخاب شده آموزش داده شد و در برابر دومی اعتبار سنجی شد. برای مجموعه داده ترکیبی، مدل با استفاده از رویکرد اعتبارسنجی متقابل ۵ برابری و با دقت برای کل مجموعه داده محاسبه شد.
برای اندازههای کاشی ۱۰۰ و ۵۰ متری، طبقهبندیکننده k نزدیکترین همسایه با ۳۰ همسایه بیش از ۶۰ درصد دقت را برای هر شهر به دست آورد ( شکل ۱۰ را ببینید). برای مجموعه داده ترکیبی، دقت بالای ۸۰ درصد برای این دو اندازه کاشی بود. اگرچه دقت بالا بود، اما می توان انتظار داشت که بین ۷۰% و ۸۰% باشد زیرا عدم تعادل کلاس برای مجموعه داده ترکیبی هنوز در یک دال نسبتاً نامتعادل است ( شکل ۶ را ببینید.). در سطح شهر، دقت به طور مثبت با تعداد کاربران توییتر (Pearson’s r: 0.41) و با تعداد توییت ها (Pearson’s r: 0.37) مرتبط بود – انتظار می رفت تعداد توییت ها و کاربران توییتر در هر شهر همبستگی بالایی داشته باشند (Pearson’s r: 0.94). علاوه بر این، شهرهایی با عدم تعادل طبقاتی بالاتر با دقت بالاتری همراه بودند (Pearson’s r: 0.47).
۴٫ بحث و محدودیت
در دسترس بودن محدود توییت های جغرافیایی یک چالش بزرگ برای پیش بینی سرعت ترافیک یا تراکم ترافیک بود. بنابراین، مجبور شدیم مدل را ساده کنیم و بر پروکسی ها تکیه کنیم. مدل کاهشیافته اطلاعات کمتری نسبت به آنچه در ابتدا در نظر گرفته شده بود ارائه میکند، زیرا فقط میتواند بین HTC و no-HTC تمایز قائل شود. این ممکن است هنگام مقایسه این رویکرد با رویکردهای تجاری ناامید کننده باشد. با این وجود، رویکرد ما مهمترین حالتها را به تصویر میکشد: گیر کردن در ترافیک یا حرکت. این اطلاعات مهمی را برای مسیریابی فراهم میکند، زیرا موقعیتهای HTC پیامدهای جدی در زمان سفر دارند و بر سطح استرس رانندگان تأثیر زیادی میگذارند [ ۵۱ ]]. توییتر خدمات فراداده مختصات GNSS خود را در سال ۲۰۱۹ متوقف کرد. بنابراین، در دسترس بودن توییت بعید است بهبود یابد. با این حال، رویکرد مبتنی بر پروکسی میتواند به راحتی برای ترکیب سایر دادههای رسانههای اجتماعی با برچسب جغرافیایی در دسترس عموم تطبیق داده شود. گسترش پروکسی ها در این رابطه احتمالاً کیفیت پیش بینی را بهبود می بخشد.
مدل ها برای دقت تنظیم شده بودند. دقت ۸۱ درصد از طبقهبندیکننده k-نزدیکترین همسایه برای مجموعه داده ترکیبی در اندازه کاشی ۱۰۰ متر نشاندهنده عملکرد خوب مدل است. با این حال، از آنجایی که فراخوان در طول انتخاب مدل در نظر گرفته نشد، پیشبینی مدل ممکن است خیلی محافظهکار باشد و بخشهای جادهای را که از ازدحام رنج نمیبرند بهعنوان پر ترافیک طبقهبندی کند. بنابراین، پیشنهادهای مسیریابی با در نظر گرفتن پیشبینی مدل احتمالاً محافظهکارانه هستند.
از آنجایی که پیشبینی تراکم ترافیک در سطح کاشیها انجام میشود، استفاده از پیشبینی در مسیریابی عدم قطعیت بیشتری را اضافه میکند زیرا ازدحام بر تمام بخشهای جادهای که با کاشی تقاطع میکنند تأثیر میگذارد. ازدحام ترافیک در بزرگراه ممکن است بر ازدحام ترافیک در یک جاده مسکونی مجاور تأثیری نداشته باشد. با این حال، در بسیاری از موقعیتها این احتمال وجود دارد که ازدحام ترافیک به یک بخش جاده محدود نمیشود، بلکه بر بخشهای جاده متصل نیز تأثیر میگذارد.
به دلیل عدم پوشش دادههای Uber، شهرهای آسیایی و آفریقایی به شدت در مجموعه دادههای مطالعه موردی ما نشان داده نشده بودند. تنها یک شهر، نایروبی، از این دو قاره در دسترس بود. این نگرانیها را در مورد انتقال مدل به شهرهای آسیایی یا آفریقایی ایجاد میکند که با کیفیت دادههای OSM ضعیفتر و اطلاعات تراکم جمعیت کمتر مشخص میشوند. برای چند شهر آفریقایی یا آسیایی، مجموعه داده های مدیریتی یا عمومی ممکن است در دسترس باشد که می تواند به جای مجموعه داده Uber استفاده شود. با این حال، از آنجایی که این داده ها بدون ارجاع به اشیاء OSM ارائه می شوند، استفاده از این داده ها شامل تطبیق نقشه بین داده ها و شبکه جاده OSM است. این خارج از محدوده تحلیل فعلی بود، اما باید در مطالعات آینده انجام شود.
برای انتقال مدل به سایر شهرها نیاز به محاسبه پروکسی مرکزیت برای آنها نیز خواهد بود. اگر رویکرد به یک منطقه بزرگتر مانند شهرهای ایالات متحده یا هند منتقل شود، رویکرد مبتنی بر شبیهسازی ممکن است از نظر محاسباتی نیاز داشته باشد. کامل بودن کافی شبکه جادهای پیشنیاز این رویکرد است – در حالی که بیشتر شهرها نسبتاً خوب نقشهبرداری شدهاند [ ۵۲ ]، هنوز شهرهایی وجود دارند که کامل بودن آنها ممکن است یک مسئله باشد. با این حال، جادههای با اهمیت بالاتر معمولاً نقشهبرداری بسیار کاملتری دارند، بنابراین ممکن است این یک مشکل واقعی نباشد.
علاوه بر این، استفاده از رسانه های اجتماعی بین کشورها متفاوت است. تفاوت ها بر تعداد کل کاربران رسانه های اجتماعی، پلت فرم رسانه های اجتماعی و سهم توییت های جغرافیایی قبل از سال ۲۰۱۹ تأثیر می گذارد [ ۵۳ ]. این بر قابلیت انتقال تأثیر می گذارد و تعداد پست های جغرافیایی ارجاع داده شده باید به اندازه کافی زیاد باشد. تعداد کاربران توییتر و توییتهای جغرافیایی در شهرهایی که به عنوان مطالعه موردی ما استفاده میشوند، متفاوت است ( جدول ۳ را ببینید.). عملکرد مدل ارتباط مثبتی با این اعداد، به ویژه برای اندازههای کاشی کوچکتر نشان داد. از این رو، انتقال این رویکرد احتمالاً فقط برای شهرهایی با سطح کافی از فعالیت رسانههای اجتماعی مرجع جغرافیایی امیدوارکننده است. برای شهرهایی با حداقل فراوانی پستهای رسانههای اجتماعی جغرافیایی مشابه کیف (کمترین تعداد کاربران توییتر و توییتها در سایتهای مطالعه موردی ما)، این رویکرد ممکن است قابل اجرا باشد. با این حال، این نیاز به آزمایش بیشتری دارد.
برای طبقه بندی مجموعه داده Uber به برچسب های HTC و no-HTC، از تعاریف کلاس ایستا ( جدول ۴ ) استفاده شد. در حالی که این برای یک رویکرد قابل انتقال در مقیاس جهانی ضروری بود، از نظر ذهنی بودن معانی طبقاتی منجر به محدودیتهایی شد. محدودیت سرعت ترافیک بالا، متوسط یا کم یک اصطلاح ذهنی است که در درجه اول به کشور، نوع جاده و دیدگاه مسافر بستگی دارد. بنابراین، یک رویکرد کاربردی تر، تعریف یک فرهنگ لغت جهانی از تعاریف طبقاتی است که باید برای هر شهر یا کشور استفاده شود. با این حال، تا آنجا که نویسندگان اطلاعات دارند، این امر تاکنون توسط سایر مطالعات انجام نشده است و بررسی بیشتر در این راستا خارج از محدوده مطالعه حاضر بود.
شهرهای منفرد از نظر میزان تراکم ترافیک به شدت متفاوت بودند. در حالی که این منعکس کننده طیف موقعیت های ترافیکی در سراسر شهرها است، ممکن است بر کیفیت مدل و قابلیت انتقال به شهرهای دیگر تأثیر بگذارد. در حالی که کل مجموعه داده نسبتاً متعادل به نظر می رسد، شهرهای جداگانه برچسب های بیشتر یا کمتری را برای HTC به کلاس بدون HTC ارائه می دهند. بنابراین، ویژگیهای موارد شدید سائوپائولو و سینسیناتی ممکن است تأثیر زیادی بر آنچه مدل برای همه شهرها به عنوان ویژگیهای مهم برای پیشبینی بدون HTC و HTC آموخته باشد. مطالعات بیشتر در این زمینه ضروری به نظر می رسد.
چالش دیگر برای تحقیقات آینده، عادی سازی فضاهای ویژگی در سراسر شهرها است. رویکرد صدک فعلی صرفاً مبتنی بر داده است و احتمالاً قابل انتقال به شهرهای خارج از مطالعه موردی نیست. این ممکن است منجر به شکاف مصنوعی بین کاشی هایی با شرایط ترافیکی مشابه شود.
۵٫ نتیجه گیری و کار آینده
برآورد اطلاعات ترافیک از داده های رسانه های اجتماعی به وضوح چالش برانگیز است. در دسترس بودن داده ها به عنوان یک مانع بزرگ در این زمینه نشان داده شده است. با این حال، ما نشان دادهایم که هنگام ترکیب اطلاعات پراکسی مشتق شده از توییتر با اقدامات بین شبکه سازگار و اطلاعات POI استفاده از زمین و پوشش زمین، میتوان تراکم ترافیک بالا را پیشبینی کرد. ما یک روش معقول برای استفاده از این پروکسی ها برای شهرها در مطالعات موردی نشان داده ایم. مطالعه ما بسیاری از چالشهایی را که باید مورد توجه قرار گیرند برجسته میکند و راهنماییهایی در مورد مصالحههای معقول ارائه میکند.
پیشبینی تراکم ترافیک بالا در سطح کاشی ۱۰۰ متر بر اساس رویکرد ارائهشده از طریق یک سرویس وب در دسترس است ( شکل A1 ، SM2T https://sm2t.heigit.org در ۱۰ سپتامبر ۲۰۲۲ مشاهده شده است). این سرویس دارای چندین ماژول از نظر استقرار API، آموزش مدل و تنظیم هایپرپارامتر است که به اشتراک گذاری نتایج بر روی نقشه وب و ادغام با سرویس های شخص ثالث مانند OpenRouteService امکان پذیر است. در کار آینده، نویسندگان امکانسنجی استفاده از مدل فعلی در کشورهای آسیایی و آفریقایی را با آزمایش سایر منابع رسانههای اجتماعی و مجموعه دادههای سرعت در دسترس عموم به عنوان حقیقت اصلی بررسی خواهند کرد.