
با افزایش در دسترس بودن دستگاه های هوشمند، میلیاردها کاربر در حال حاضر برای بسیاری از کارهای اساسی روزانه مانند دریافت مسیرها و دریافت مسیرها به خدمات نقشه تکیه می کنند. بررسی کیفیت و سازگاری داده های مسیر ارائه شده توسط ارائه دهندگان نقشه های مختلف، روز به روز اهمیت بیشتری پیدا می کند. با این حال، تأیید این سازگاری به صورت دستی یک کار بسیار وقت گیر است. برای پرداختن به این مشکل، در این مقاله یک سیستم تجزیه و تحلیل دادههای مکانی جدید را معرفی میکنیم که بر اساس جهتگیری جاده است. ما سیستم کیفیت جهت گیری جاده (RDQS) خود را با استفاده از چندین ارائه دهنده نقشه، از جمله: Bing Maps، Google Maps، و OpenStreetMap بررسی می کنیم. نتایج آزمایشهای انجامشده نشان میدهد که شبکه عصبی تشخیص ما میتواند موقعیت و جهت پیکان را در تصاویر نقشه با > تشخیص دهد. ۹۰٪ امتیاز F1 در هر یک از ارائه دهندگان مختلف. سپس از این مدل برای تجزیه و تحلیل تصاویر نقشه در شش منطقه مختلف استفاده می کنیم. یافتههای ما نشان میدهد که رویکرد ما میتواند بهطور قابل اعتمادی کیفیت نقشه را ارزیابی کند و تفاوتها را در جهتیابی جاده در ارائهدهندگان مختلف کشف کند. ما درصد اختلاف یافت شده بین ارائه دهندگان نقشه را با استفاده از این رویکرد در یک منطقه مطالعه پیشنهادی گزارش می کنیم. این نتایج می تواند به تعیین مناطقی که نیاز به تجدید نظر و اولویت بندی برای بهبود کیفیت کلی داده ها در نقشه ها دارند کمک کند. ما درصد اختلاف یافت شده بین ارائه دهندگان نقشه را با استفاده از این رویکرد در یک منطقه مطالعه پیشنهادی گزارش می کنیم. این نتایج می تواند به تعیین مناطقی که نیاز به تجدید نظر و اولویت بندی برای بهبود کیفیت کلی داده ها در نقشه ها دارند کمک کند. ما درصد اختلاف یافت شده بین ارائه دهندگان نقشه را با استفاده از این رویکرد در یک منطقه مطالعه پیشنهادی گزارش می کنیم. این نتایج می تواند به تعیین مناطقی که نیاز به تجدید نظر و اولویت بندی برای بهبود کیفیت کلی داده ها در نقشه ها دارند کمک کند.
کلید واژه ها:
بینایی کامپیوتری ؛ جاده ها ; تجزیه و تحلیل جغرافیایی ; داده های جغرافیایی ؛ شهر هوشمند ؛ اینترنت اشیا ؛ شبکه های عصبی کانولوشنال ; تشخیص پیکان ؛ جهت پیکان ; دتکترون ۲ ; rcnn ; سریعتر-rcnn
۱٫ مقدمه
نقشه های دیجیتال در حال حاضر روزانه توسط میلیون ها کاربر استفاده می شود. این استفاده در دهه گذشته به دلیل افزایش چشمگیر در دسترس بودن دستگاه های هوشمند به طور قابل توجهی افزایش یافته است. تخمین زده می شود که Google Maps به تنهایی بیش از یک میلیارد کاربر فعال ماهانه دارد [ ۱ ]. برای ارائه دهندگان نقشه اهمیت بیشتری پیدا می کند که دقت بالایی برای نقشه های خود ارائه دهند. علیرغم دقت بالایی که قبلاً توسط ارائه دهندگان نقشه اصلی به دست آمده است، آنها هنوز با کامل بودن فاصله دارند. بسیاری از تحقیقات با تمرکز بر تجزیه و تحلیل کیفیت داده های نقشه، مانند [ ۲ ، ۳ ، ۴]، اختلافات را در جنبه های مختلف داده ها گزارش کنید. یکی از چالشهای موجود در بین ارائهدهندگان نقشه این است که در حالی که همه آنها از جهتیابی جادهها پشتیبانی میکنند، این جهتها لزوماً سازگار نیستند. از آنجا که هر ارائه دهنده از متدولوژی های متفاوتی استفاده می کند، بین نقشه های ارائه شده مغایرت وجود دارد. در حالی که برخی از اختلافات ممکن است باعث ناراحتی کاربران شود، سایر اختلافات مانند مسیرهای اشتباه جاده ممکن است خطرات جدی ایجاد کند. در حالی که ارائه دهندگان مراقبت زیادی برای جلوگیری از دادن مسیرهای اشتباه انجام می دهند، این یک تلاش پرهزینه است. سیستم ما این هزینه ها را با برجسته کردن مناطقی که احتمال وجود خطا در آنها وجود دارد، به طور چشمگیری کاهش می دهد.
در این مقاله، ما RDNN، یک مدل شبکه عصبی جهتیابی جاده را ارائه میکنیم که فلشها را تشخیص میدهد و جهت آنها را با دقت بالا در سه ارائهدهنده نقشه شامل: (الف) نقشههای گوگل، (ب) نقشههای بینگ، و (ج) نقشه خیابان باز (OSM) . ما میزان دقت به دست آمده برای ارائه دهندگان مختلف را اندازه گیری و گزارش می کنیم. سپس از این مدل برای اسکن و تجزیه و تحلیل مناطق بزرگ برای کشف اختلافات بالقوه در جهت جاده استفاده می کنیم. برای نشان دادن اهمیت تشخیص جهت پیکان، شکل ۱ را در نظر بگیرید که مقطعی از موقعیت جغرافیایی یکسان در بین دو ارائه دهنده (Google Maps و Bing Maps) را نشان می دهد، اما جهت فلش ها کاملاً متفاوت است. همانطور که در شکل ۱ مشاهده می شود، تصویر Bing Maps دارای یک فلش به سمت جنوب شرقی است، در حالی که پیکان تصویر Google Maps به سمت شمال غربی است. جهت پیکان ناسازگار، اختلافاتی را که ممکن است رخ دهد را نشان می دهد و نمونه ای از اطلاعات نادرست است که به کاربران نهایی ارسال می شود که ممکن است خطر ایمنی جدی ایجاد کند. در چنین مواردی مشخص نیست که کدام یک از دو ارائه دهنده دارای جهت گیری دقیق برای جاده مورد بررسی است، اما باید در یکی از آنها خطا وجود داشته باشد. از آنجایی که نقشه ها با اطلاعات بیشتری پر می شوند، چنین اختلافاتی در بین ارائه دهندگان نقشه رایج تر می شود. سیستم ما می تواند این خطاها را شناسایی و برای بررسی گزارش دهد.
چنین نادرستی ممکن است منجر به حوادث احتمالی شود. برای مثال، این برچسب نادرست مسیرهای جاده ممکن است باعث شود رانندهای که برای مسیرها و مسیریابی به خدمات نقشه وابسته است، تلاش کند در جهت اشتباه رانندگی کند، که میتواند یک خطر جدی ایمنی باشد و احتمالاً منجر به تصادفات جادهای شود. ممکن است این موضوع در جادههایی با ترافیک متراکم بدتر شود. این نمونه ای از مغایرت است که رویکرد ما می تواند به طور خودکار آن را شناسایی و گزارش کند. با اسکن نواحی بزرگ، سپس میتوانیم بخش بزرگتری از این اختلافات را شناسایی و گزارش کنیم و نتایج آماری را جمعآوری کنیم که میتواند راهنمایی کند که کدام مناطق حاوی درصد زیادی از اختلاف هستند و نیاز به تجدید نظر دارند. این می تواند به طور قابل توجهی به نقشه نگاران در بهبود کیفیت کلی نقشه هایی که اختصاصی هستند کمک کند (مثلاً نقشه های گوگل، نقشه های بینگ). در حالی که نقشههای منبع باز مانند OSM میتوانند به طور قابلتوجهی به تصحیح این نادرستیها کمک کنند، زیرا کاربران نهایی قادر به تصحیح آنها هستند، تغییرات در سایر نقشههای مناسب مانند Google Maps و Bing Maps نیازمند هزینههای اضافی یا مراحلی است که شامل تیمهای تحریریه برای مدیریت چنین تغییراتی است.
در این مقاله، ما به موارد زیر کمک می کنیم:
-
ما RDNN، یک مدل شبکه عصبی جهتدار جاده را ارائه میکنیم که جهتگیری فلشها را در تصاویر نقشه در سراسر ارائهدهندگان نقشه با دقت بالا تشخیص میدهد.
-
ما مجموعهای از آزمایشها را برای اندازهگیری و ارزیابی دقت مدل تشخیص با استفاده از مجموعه دادههای نقشههای دنیای واقعی انجام میدهیم.
-
ما مجموعه دادههای آموزشی و آزمایشی خود را که برای آموزش و ارزیابی شبکه عصبی استفاده میشود، منتشر میکنیم تا آن را برای کارهای آینده در این زمینه در دسترس قرار دهیم.
-
ما RDQS، یک سیستم کیفیت جهتیابی جاده را ارائه میکنیم که از این مدل، همراه با سایر مؤلفهها، برای ارزیابی کیفیت نقشهها و گزارش مغایرتها در جهتیابی جاده استفاده میکند و ادغام میکند.
-
ما آزمایشهایی را با استفاده از این سیستم انجام میدهیم تا بهطور خودکار هزاران مکان را در شش منطقه اصلی اسکن کنیم تا مغایرتها در جهت جاده کشفشده با روش ما شناسایی و گزارش شود.
۱٫۱٫ کار مرتبط
۱٫۱٫۱٫ سیستم تشخیص بخش جاده
یکی از زمینه های مهم برای مقایسه اختلافات بین ارائه دهندگان نقشه، بخش های جاده است. بسیاری از ارائه دهندگان در این زمینه مغایرت دارند. محققان UW Tacoma [ ۵ ] در حال توسعه سیستمی هستند که می تواند جاده ها را از روی تصاویر نقشه با استفاده از بینایی کامپیوتری تشخیص دهد. گروهی از تکنیک های مبتنی بر رنگ و تقسیم بندی با استفاده از k-means برای فیلتر کردن تصاویر و استخراج نمایش دودویی و اسکلتی بخش های جاده استفاده می شود. بعداً اطلاعات بیشتری در مورد عرض و طول بخش های مختلف جاده استخراج می شود. این اطلاعات جمعآوری شده و برای ارائه آماری استفاده میشود که تفاوتهای عمده بین ارائهدهندگان را در برخی مناطق برجسته میکند. ما از این کار در مقاله خود برای ایجاد یک نمودار کامل شبکه جاده (RNG) شامل جهت ها استفاده می کنیم تا بتوانیم RNG حاصل را در ارائه دهندگان مختلف مقایسه کنیم.
۱٫۱٫۲٫ نمودارهای شبکه جاده با استفاده از API مسیریابی
گروهی از محققین با استفاده از APIهای مسیریابی [ ۶ ]، نمودارهای شبکه جاده را در ارائه دهندگان مختلف بررسی کردند. رویکرد این بود که به طور تصادفی مسیرهایی از نقطه A تا نقطه B ایجاد شود و مسیرهای مختلف ارائه شده توسط ارائه دهندگان مختلف مقایسه شود. اگر مغایرتی وجود داشته باشد، این نشان دهنده تفاوت در سیستم نقشه برداری اساسی و بخش های جاده برای آن منطقه است. به عنوان مثال، جاده گم شده یا جاده ای که در یک ارائه دهنده دارای جهت اشتباه است، ممکن است باعث شود این ارائه دهنده مسیری را ارائه دهد که به طور قابل توجهی گران تر از مسیر ارائه شده توسط یک ارائه دهنده دیگر باشد.
ما با استفاده از بینایی کامپیوتری برای استخراج اطلاعات جهت پیکان و استفاده از آن برای کشف این اختلافات، رویکرد متفاوتی را دنبال می کنیم.
۱٫۱٫۳٫ تشخیص شبکه راه ها با استفاده از روش های نظری احتمالی و نموداری
محققان در [ ۷ ] یک سیستم خودکار برای تشخیص شبکه های جاده ای از تصاویر ماهواره ای و هوایی به منظور تولید نقشه پیشنهاد می کنند. روش به تشخیص مرکز جاده احتمالی و اطلاعات شبکه جاده مبتنی بر نظریه گراف بستگی دارد. نتایج بهدستآمده نشان میدهد که این سیستم میتواند در تشخیص شبکههای جادهای بر روی تصاویر ماهوارهای استفاده شود. رویکرد ما از این جهت متفاوت است که با تشخیص مکان فلش ها و جهت گیری از تصاویر نقشه، بر جهت یابی جاده تمرکز می کنیم.
۱٫۱٫۴٫ تشخیص چراغ راهنمایی و پیکان مبتنی بر دید
در این مقاله [ ۸ ]، محققان یک الگوریتم تشخیص مبتنی بر دید را برای چراغهای راهنمایی پیشنهاد کردند. هر سه چراغ راهنمایی از جمله جهت پیکان را تشخیص می دهد. این سیستم را می توان برای وسایل نقلیه هوشمند استفاده کرد. این سیستم از یک شبکه عصبی کانولوشن استفاده می کند که برای چراغ های راهنمایی و شرایط مختلف روشنایی به خوبی تنظیم شده است. با این حال، این تحقیق تنها بر روی تشخیص فلش ها در زمینه چراغ های راهنمایی تمرکز دارد و تنها سه جهت را تشخیص می دهد: چپ، راست و جلو. به تشخیص چند جهتی پیکان در تصاویر نقشه در ارائه دهندگان مختلف نمی پردازد، چیزی که در این مقاله روی آن تمرکز می کنیم.
۱٫۱٫۵٫ تشخیص پیکان در تصاویر پزشکی
محققان در [ ۹ ] مدلی برای تشخیص فلش های مورد استفاده برای برچسب زدن تصاویر پزشکی برای کمک به بهبود تجزیه و تحلیل مناطق مورد علاقه برای بازیابی تصویر مبتنی بر محتوا ساختند. آنها از تشخیص نقطه کلیدی برای شناسایی رئوس نوک پیکان استفاده کردند، در حالی که پایه فلش را نادیده گرفتند. آنها سپس از چهار لایه باینریزه کردن مقیاس خاکستری تصویر برای کمک به فیلتر کردن نویز و تمایز بین فلش های روی هم افتاده استفاده کردند. در نهایت، هدف آنها استفاده از این فلش های شناسایی شده برای یافتن بخش های قابل توجهی از یک تصویر برای تمرکز بر پردازش برای بازیابی اطلاعات بود. با این حال، تشخیص پیکان ما برای بازیابی محتوای تصویر در نظر گرفته نشده است، بلکه در عوض برای کمک به شناسایی خطاهای احتمالی در ارائه دهندگان نقشه در نظر گرفته شده است.
۱٫۱٫۶٫ تشخیص پیکان در نمودارهای دست نویس
نویسندگان در [ ۱۰] از اصلاح پیشنهادی سریعتر R-CNN به نام Arrow R-CNN برای تجزیه و تحلیل نمودارهای فلوچارت دستی استفاده کرد. Arrow R-CNN آنها R-CNN سریعتر را با استفاده از شبکههای هرمی ویژگی و تشخیص نقاط کلیدی تغییر میدهد و سر و دم فلشها را برچسبگذاری میکند. جالب است که آنها از تشخیص پیکان خود به عنوان مبنایی برای بازسازی نسخه های دیجیتالی نمودارهای دستی استفاده کردند، در حالی که ما قصد داریم از تشخیص پیکان خود برای ایجاد نمودار شبکه جاده ای استفاده کنیم. یک تفاوت اصلی این است که برای آنها، فلش ها به عنوان اتصالات بین بخش های یک فلوچارت عمل می کنند، در حالی که برای ما، این جاده ها هستند که نمودار ما را با فلش هایی که برای نشان دادن جهت یال ها استفاده می شوند، متصل می کنند. به همین دلیل، توانایی تعیین جهت فلش های ما بسیار مهم است.
۱٫۱٫۷٫ پیشرفته ترین مدل های یادگیری عمیق در بینایی کامپیوتر
الگوریتم اصلی یادگیری عمیق مورد استفاده برای وظایف بینایی کامپیوتری شبکه های عصبی کانولوشن (CNN) است. سیانانها در سالهای اخیر پیشرفتهای فوقالعادهای داشتهاند که عملکرد تشخیص شی را به طور قابلتوجهی در مجموعه دادههای معیار اصلی بهبود میبخشد. آنها همچنین، تا همین اواخر، ستون فقرات مدل های پیشرفته در حوزه بینایی کامپیوتر را تشکیل می دادند. یکی از آخرین پیشرفت ها، معرفی Fast R-CNN [ ۱۱ ] و Faster R-CNN [ ۱۲ ] بود. R-CNN سریعتر در زمان انتشار مقاله برای تشخیص اشیا و وظایف تقسیم بندی معنایی در مجموعه داده COCO [ ۱۳ ] به عملکرد پیشرفته ای دست یافت [ ۱۳ ].]، که مجموعه داده استاندارد فعلی است که برای مقایسه مدل ها برای وظایف تشخیص اشیا استفاده می شود. R-CNN سریعتر همچنان ستون فقرات مدل ها با یکی از بهترین نتایج در حوزه بینایی کامپیوتر است.
اخیراً در سال ۲۰۲۱، حوزه بینایی رایانه با معرفی مدلهای مبتنی بر ترانسفورماتور برای وظایف بینایی رایانه مانند ViT در حال تغییر است [ ۱۴ ]. اگرچه ViT نتایج امیدوارکنندهای را برای حل وظایف طبقهبندی ساده نشان میدهد، اما به دلیل اندازه ثابت ۱۶ × ۱۶ دستهای، نتوانست به خوبی برای کارهای پیچیدهتر مانند تشخیص اشیا و تقسیمبندی معنایی تعمیم یابد. علاوه بر این، زمان با افزایش اندازه تصویر به صورت درجه دوم افزایش می یابد. این امر استنتاج بلادرنگ را به یک چالش واقعی با ViT تبدیل می کند. بهبود در ViT برای رسیدگی به این چالش ها منجر به معرفی Swin Transformer [ ۱۵ ] شد. Swin Transformer از یک پنجره جابجا شده با توجه محدود استفاده می کند تا بتواند ویژگی ها را در مقیاس های مختلف ثبت کند. بر اساس کاغذ Swin Transformer [ ۱۵]، به نتایج پیشرفتهای برای وظایف تشخیص اشیا در مجموعه داده COCO دست مییابد [ ۱۳ ]. همگرایی ترانسفورماتورها در حوزه بینایی کامپیوتر هنوز بسیار جدید و یک زمینه مطالعاتی بسیار فعال است. مقاله ای بسیار جدید با نام “A ConvNet for the 2020s” [ ۱۶] بر اهمیت کانولوشن ها در بینایی کامپیوتر تاکید کرد و خانواده ای از مدل ها به نام ConvNeXts را معرفی کرد. ConvNeXts مدل های استاندارد ConvNet هستند که به سمت طراحی یک ترانسفورماتور بینایی سلسله مراتبی (Swin) مدرن شده اند. یعنی، ایده این است که تکنیکها را از ترانسفورماتورها به یک معماری کانولوشن بومی تطبیق دهیم تا مزایایی را که ترانسفورماتورها به ارمغان میآورند، درک کنند، در حالی که سادگی و کارایی یک معماری convnet را حفظ میکنند. این مقاله نشان میدهد که ConvNeXts به خوبی با Swin Transfomer در وظایف رایج بینایی کامپیوتری مانند تشخیص اشیا و تقسیمبندی معنایی رقابت میکنند.
در این مقاله، ما از مدلهای مبتنی بر R-CNN سریعتر استفاده میکنیم که توسط کتابخانه Detectron2 [ ۱۳ ] ارائه شده است.]. Detectron2 مدل هایی را با یکی از بهترین نتایج و عملکرد تقریباً پیشرفته برای بسیاری از وظایف بینایی رایانه ارائه می دهد. یکی از دلایل اصلی این انتخاب، میزان منابع موجود، مستندات، مثالها و چارچوبهای پشتیبانی کننده از این مدلها در مقایسه با مدلهای مبتنی بر ترانسفورماتور است که اخیراً معرفی شدهاند. علاوه بر این، اشیایی که ما در این مقاله تشخیص می دهیم (فلش ها) بسیار کوچک هستند. ViT با توجه به اندازه ثابت ۱۶ × ۱۶ دسته ای، مشکلات عمده ای در تشخیص ویژگی های کوچک در تصاویر دارد. Swin Transformer ظاهراً این مشکل را با رویکرد پنجره تغییر مکان حل می کند. با این حال، مشخص نیست که آیا این برای تشخیص اجسام بسیار کوچک (متشکل از چند پیکسل) مانند فلش کافی است یا خیر. مدلهای سریعتر R-CNN دارای یک معماری پایدار شناخته شده برای تشخیص ویژگیها در مقیاسهای مختلف هستند. علاوه بر این، ما مدلهای سریعتر R-CNN را برای کار با آنها بسیار آسان و آموزش مجدد آسانتر مییابیم. علاوه بر این، نتایج کافی برای هدف این مقاله به دست میآورد که بعداً ارائه میکنیم. استفاده از ترانسفورماتور Swin برای این کار قطعاً جالب است، اما از حوصله این مقاله خارج است و ممکن است زمینه بالقوه ای باشد که در کارهای آینده بررسی خواهیم کرد.
۱٫۱٫۸٫ کارهای مرتبط اضافی
با توجه به اهمیت دقت دادههای مکانی در نقشهها، بسیاری از ویژگیهای نقشه با جزئیات مورد مطالعه قرار گرفتهاند، مانند ارزیابی دقت نسبی خطوط خطوط برای نقشههای با وضوح بالا (HDM) برای رانندگی خودکار (AD) [ ۱۷ ] و موجودیتهای تطبیق در منابع داده های مختلف برای مناطق مسکونی [ ۱۸ ].
سایر محققان کیفیت اطلاعات معنایی مانند نوع جاده مرتبط با داده ها را در نقشه خیابان باز (OSM) بررسی کردند [ ۱۹ ]. محققان در این مقاله رویکردی را با استفاده از یادگیری ماشینی نظارت شده برای ارزیابی کیفیت دادههای مکانی ارائه شده از طریق اطلاعات جغرافیایی داوطلبانه (VGI) بر اساس تجزیه و تحلیل ویژگیهای خاص (ویژگیهای) دادهها پیشنهاد کردند. بسیاری از مطالعات دیگر بر کیفیت چندین ویژگی دیگر OSM مانند شبکههای راه [ ۲۰ ، ۲۱ ، ۲۲ ]، نام خیابانها [ ۲۳ ]، POI [ ۲ ]، نام جادهها [ ۲۴ ] و راههای مسیریابی [ ۲۵ ] متمرکز شدند.
با این حال، هیچ یک از این مطالعات بر کیفیت جهت گیری تمرکز نمی کند و کیفیت این داده ها را در ارائه دهندگان مختلف مانند OSM، Google Maps و Bing Maps مقایسه می کند، که در این مقاله تمرکز شده است.
۱٫۱٫۹٫ مقایسه با کارهای دیگر
تحقیقاتی برای تشخیص فلش ها در خط کشی های فیزیکی جاده ها [ ۲۶ ] و چراغ های راهنمایی [ ۸ ] انجام شده است، و تحقیقاتی برای شناسایی نمادهای فلش در نمودارهای جریان [ ۱۰ ] و در نمودارهای پزشکی [ ۹ ] انجام شده است، اما کار ما بر روی آموزش مدلی برای شناسایی و طبقهبندی نمادهای پیکان بر روی نقشههای آنلاین، که به نظر میرسد یک کاربرد عمدتاً ناشناخته از بینایی رایانه باشد. در حالی که محققان دیگری وجود دارند که ویژگی های ارائه دهندگان نقشه های مختلف را مقایسه می کنند [ ۵ ]، طبق دانش ما، ما تنها کسانی هستیم که جهت های پیکان نقشه را مقایسه می کنیم. در حالی که برخی از محققان ایجاد نمودارهای شبکه جاده را با استخراج بخشهای جاده از نقشهها مطالعه کردهاند [ ۵]، و دیگران آنها را با تجزیه و تحلیل تصاویر ماهواره ای [ ۷ ] ایجاد کرده اند، ما در توانایی خود در استفاده از تشخیص جهت پیکان در ایجاد نمودارهای چند جهته منحصر به فرد باقی می مانیم. جدول ۱ تفاوت های بین رویکرد ما و سایر کارهای مرتبط را خلاصه می کند.
۲٫ مواد و روشها
هدف ما تشخیص جهت پیکان با دقت بالا در ارائه دهندگان نقشه مختلف است. ما از Detectron2 [ ۱۳ ] استفاده می کنیم، که کتابخانه ای است که مجموعه های پیشرفته ای از شبکه های عصبی Fast R-CNN [ ۱۱ ] و سریعتر R-CNN [ ۱۲ ] را برای تشخیص اشیا ارائه می دهد. در بخش ۱٫۱٫۷از کارهای مرتبط، بحث مفصل تری را در مورد مدل های پیشرفته یادگیری عمیق در بینایی کامپیوتر ارائه می کنیم و توضیح می دهیم که چرا از این کتابخانه استفاده می کنیم. Fast R-CNN پیشرفتی نسبت به روش های سنتی R-CNN (شبکه عصبی کانولوشن مبتنی بر منطقه) است. R-CNN از یک الگوریتم جستجوی انتخابی برای استخراج لیستی از پیشنهادات منطقه استفاده می کند که سپس یک به یک به شبکه داده می شود. این امر باعث می شود شبکه بسیار کند به دلیل تولید چندین پیشنهاد منطقه ای که هر کدام باید به طور مستقل به CNN برای استخراج ویژگی ها داده شوند. علاوه بر این، الگوریتم جستجوی انتخابی ثابت است و نمیتوان آن را آموزش داد، که ممکن است منجر به پیشنهادهای نادرست منطقه کاندید بر روی کلاسهای جدید تصاویر شود که با توجه به اینکه آموزش مدل برای شناسایی کلاسهای جدید تصاویر بخشی از هدف این تحقیق است، مشکلساز خواهد بود.
R-CNN سریعتر نسبت به R-CNN سنتی و Fast R-CNN بهبود یافته است زیرا الگوریتم جستجوی انتخابی کند را حذف می کند و در عوض به شبکه اجازه می دهد تا پیشنهادات منطقه را یاد بگیرد. همانطور که در شکل ۲ ارائه شده است ، سریعتر R-CNN اساسا یک شبکه مجزا را برای یادگیری و پیش بینی پیشنهادات منطقه معرفی می کند. سپس این مناطق برای تشخیص اشیا به شبکه تشخیص داده می شوند. این باعث میشود که سریعتر و همچنین برای آموزش مجدد در کلاسهای مختلف مناسبتر باشد، زیرا شبکه پیشنهادی منطقه نیز میتواند دوباره آموزش داده شود.
برای این مزایا، ما با یک مدل سریعتر R-CNN از پیش آموزش دیده از کتابخانه Detectron2 شروع می کنیم. مدلی که انتخاب می کنیم سریعتر R-CNN با ستون فقرات ResNet-101 و شبکه هرمی ویژگی (FPN) است. این مدل در زمان معرفی به نتایج پیشرفتهای برای وظایف تشخیص اشیا دست یافت [ ۲۷ ]. استفاده از FPN آموزش مجدد در مجموعه داده های جدید را سریع و بسیار آسان می کند. FPN همچنین این مدل را در تشخیص اشیاء در مقیاس های مختلف بسیار خوب می کند، که برای هدف ما بسیار مهم است زیرا ما اشیاء فلش بسیار کوچک را در تصاویر نقشه تشخیص می دهیم. مدل از پیش آموزش دیده بر روی مجموعه داده COCO آموزش داده شده است [ ۲۸] که در مجموع ۲٫۵ میلیون نمونه برچسب گذاری شده در ۳۲۸ کیلو تصویر دارد. سپس، یک مجموعه داده آموزشی جدید را با برچسب گذاری تصاویر نقشه به دست آمده از دانلود تصاویر با استفاده از APIهای ارائه شده توسط ارائه دهندگان مختلف، آماده می کنیم. ما تمام لایه های شبکه عصبی را فریز می کنیم به جز لایه آخر. لایه آخر یک لایه کاملا متصل است. ما از مجموعه داده آموزشی برای آموزش مجدد شبکه و تنظیم وزن های آخرین لایه بر اساس مجموعه داده جدید استفاده می کنیم. این به ما شبکه ای می دهد که کلاس های مورد نظر جدید (جهت های پیکان) را شناسایی می کند.
سپس، دقت شبکه را با استفاده از مجموعه داده آزمایشی که به روشی مشابه مجموعه داده آموزشی تهیه شده است، کمی می کنیم. ما از AP (Average Precision) و AR (Average Recall) به عنوان معیارهای ارزیابی خود استفاده می کنیم. ما از متریک تقاطع روی اتحادیه با آستانه ۰٫۵ (AP50 و AR50) برای تعیین موارد مثبت واقعی استفاده می کنیم. این به این معنی است که اگر ناحیه ای از تقاطع جعبه مرزی پیش بینی شده و جعبه مرزی حقیقت زمینی بیش از نصف اندازه دو جعبه مرزی ترکیبی باشد، به عنوان یک پیش بینی معتبر محسوب می شود.
منoU=آrهآofOvهrلآپآrهآofUnمنon
مجموعه داده های آموزشی و آزمایشی از فرمت COCO [ ۲۸ ] استفاده می کنند. COCO یک فرمت محبوب است که در حوزه تشخیص اشیا استفاده می شود و با کتابخانه Detectron2 سازگار است. بنابراین ما از این قالب برای تمام آزمایشات خود در سراسر این مقاله استفاده می کنیم. AP و AR معیارهای استاندارد برای ارزیابی و گزارش مجموعه داده های COCO هستند که در این مقاله از آنها استفاده می کنیم.
ما توجه می کنیم که تشخیص جهت یک فلش در تصاویر نقشه معرفی شده در این مقاله یک تلاش جدید است. تا آنجا که ما می دانیم، قبلاً انجام نشده است. بنابراین ما هیچ خط پایه ای برای مقایسه دقت مدل خود نداریم. علاوه بر این، هیچ مجموعه داده استانداردی برای استفاده به عنوان معیار وجود ندارد. بنابراین به عنوان بخشی از این تلاش، مجموعه دادههای خود را منتشر میکنیم و آنها را بهعنوان منبع باز در دسترس قرار میدهیم تا به ایجاد یک معیار پایه کمک کنیم که بعداً توسط هر کار آینده در این زمینه قابل استفاده باشد.
در نهایت، پس از تنظیم این مدل، از آن در یک سیستم بزرگتر به نام RDQS (سیستم کیفیت جهتیابی جاده) استفاده میکنیم که بهطور خودکار تصاویر نقشه را دانلود میکند و این کاشیها را با استفاده از این مدل و سایر اجزای مبتنی بر بینایی کامپیوتری تجزیه و تحلیل میکند تا مغایرتها در جهت جادهها را اسکن کند. گزارش آمار کلی برای مناطق مختلف مطالعه.
در این بخش به ارائه جزئیات معماری سیستم پیشنهادی می پردازیم. در یک سطح بالا، معماری سیستم جهت گیری جاده ما در شکل ۳ ارائه شده است .
۲٫۱٫ معماری سیستم
همانطور که در شکل ۳ مشاهده می شود ، ما تصاویر را از Google Maps، Bing Maps و OSM جمع آوری کرده و آنها را به مدل شبکه عصبی تشخیص تغذیه می کنیم. شبکه هم مکان و هم جهت پیکان ها را تشخیص می دهد. ما همچنین از یک مؤلفه از مقاله منتشر شده توسط محققان دانشگاه واشنگتن استفاده می کنیم [ ۵] برای استخراج اطلاعات بخش جاده باینری و اسکلت. ما بخش های جاده را به عنوان جاده بین تقاطع ها تعریف می کنیم. سپس اطلاعات بخش جاده را به همراه اطلاعات جهت فلش های مربوطه به مؤلفه ای می خوریم که این دو را پوشش می دهد و هر بخش جاده را با فلشی که متعلق به آن است مطابقت می دهد. این در هر تصویر برای هر ارائه دهنده انجام می شود. سپس، بخشهای جادهای تولید شده را برای هر تصویر در ارائهدهندههای مختلف تجزیه و تحلیل میکنیم و بخشهای جاده مربوطه را بر اساس مکان نقشه مطابقت میدهیم. در نهایت، ما تفاوتها را در جهت پیکانهای مرتبط با بخشهای جاده همسان مقایسه و شناسایی میکنیم. علاوه بر این، ما نتایج را در کل منطقه مورد مطالعه جمع آوری می کنیم و میزان وقوع چنین شباهت ها و اختلافات را گزارش می کنیم.
۲٫۲٫ بررسی اجمالی مدل شبکه عصبی راه-جهت
در این بخش، ما یک نمای کلی معماری از مؤلفه RDNN (شبکه عصبی جاده-جهت) ارائه می کنیم:
همانطور که در شکل ۴ نشان داده شده است ، ما تصاویر آموزشی را از ارائه دهندگان مختلف جمع آوری می کنیم. ما از یک ابزار آنلاین به نام CVAT استفاده می کنیم [ ۲۹] برای ایجاد یک مجموعه داده آموزشی دارای برچسب در قالب COCO. برچسب زدن به صورت دستی انجام می شود. ما از مجموعه داده آموزشی برای آموزش مجدد یک مدل موجود از باغ وحش مدل Detectron2 استفاده می کنیم. اساساً، ما با وزنهای مدل از پیش آموزشدیده شروع میکنیم، تمام لایههای شبکه را منجمد میکنیم و آخرین لایه را در مجموعه داده آموزشی جدید خود آموزش میدهیم. این مکانیزم مزیت استفاده مجدد و استفاده از تمام ویژگیهای سطح بالا و انتزاعهای آموختهشده توسط شبکه اصلی را در حجم عظیمی از مجموعه دادههای آموزشی به ما میدهد. همین ویژگیها و انتزاعهای سطح بالا معمولاً هنوز برای تشخیص عمومی اشیا حتی برای کلاسهای جدید مفید هستند. این به ما این امکان را می دهد که در هنگام استفاده از مقدار کمی از مجموعه داده آموزشی، دقت بسیار خوبی برای تشخیص فلش ها به دست آوریم. این بسیار مهم است زیرا هیچ مجموعه آموزشی آنلاین موجود برای فلش ها وجود ندارد، و ایجاد آنها به صورت دستی بسیار زمان بر است. بنابراین، کاهش مقدار مجموعه داده آموزشی مورد نیاز بسیار ارزشمند است.
۲٫۳٫ جمع آوری اطلاعات
برای به دست آوردن داده های آموزشی، ما از API های ارائه شده توسط ارائه دهندگان مختلف برای دانلود تصاویر برای مکان های خاص در سطح بزرگنمایی خاص استفاده می کنیم. در زیر پوشش، ارائه دهندگان نقشه از یک سیستم نقشه کاشی [ ۳۰ ] استفاده می کنند تا بتوانند مجموعه تصاویر نقشه را در سطوح بزرگنمایی مختلف ارائه دهند. این سیستم یک نقشه بزرگ را به چهار ربع تقسیم می کند و سپس با افزایش سطح زوم، هر چهارم را به صورت بازگشتی به ۴ چهارم تقسیم می کند. شکل ۵ نمونه ای از سیستم کاشی نقشه های بینگ را نشان می دهد.
ما از API ارائه شده توسط ارائه دهندگان نقشه برای جمع آوری تصاویر برای مناطق مورد علاقه در سطوح مختلف بزرگنمایی استفاده می کنیم. فلش ها فقط در سطوح زوم بالا ظاهر می شوند. در این مقاله از سطح زوم ۱۸ استفاده میکنیم که مناسبترین سطح زوم برای تحلیل جهتیابی جاده است.
۲٫۴٫ آماده سازی داده ها و برچسب گذاری
ما باید شبکه عصبی خود را آموزش دهیم تا کلاس های جدید مربوط به جهت پیکان را تشخیص دهد. با این حال، چنین اطلاعات آموزشی به صورت آنلاین در دسترس نیست. بنابراین، ما مجموعه داده های آموزشی و آزمایشی خود را آماده می کنیم. ما از یک ابزار برچسب گذاری آنلاین به نام CVAT استفاده می کنیم. همانطور که در شکل ۶ مشاهده می شود ، این ابزار به ما امکان می دهد چند ضلعی ها و جعبه های مرزی را در اطراف اشیاء مورد نظر رسم کرده و آنها را برچسب گذاری کنیم.
ما برچسب گذاری را به صورت دستی با شناسایی هر فلشی که در تصویر ظاهر می شود انجام می دهیم و یک کادر دور آن می کشیم. ما تصاویر زیادی را برای هر ارائه دهنده آماده و برچسب گذاری می کنیم. سپس از ابزار برای تولید این مجموعه داده آموزشی در قالب COCO استفاده می کنیم. ما به طور مشابه مجموعه دیگری از تصاویر را برای استفاده به عنوان مجموعه داده آزمایشی برچسب گذاری می کنیم. این مجموعه داده آزمایشی به حقیقت اصلی تبدیل می شود که ما برای اندازه گیری دقت مدل از آن استفاده می کنیم. ما هم مجموعه دادههای آموزشی و هم آزمایشی را به اشتراک میگذاریم و آنها را به صورت آنلاین در دسترس قرار میدهیم تا در هر کار آینده در این زمینه مورد استفاده قرار گیرد. مجموعه داده آموزشی را می توان برای آموزش شبکه های عصبی مشابه برای تشخیص جهت پیکان در تصاویر نقشه استفاده کرد. داده های آزمایشی را می توان به عنوان یک معیار پایه استفاده کرد.
۲٫۵٫ الزامات سخت افزاری
شبکه های عصبی Detectron2 از GPU PyTorch برای آموزش استفاده می کنند. بنابراین، ما تمام آزمایشهای خود را بر روی پلتفرم Google COLAB اجرا میکنیم که زیرساخت و منابع ابری با قابلیتهای GPU را فراهم میکند.
۳٫ نتایج و بحث
ما چندین آزمایش مختلف را در طول این مقاله انجام می دهیم. در این بخش، نتایج هر آزمایش را به اشتراک می گذاریم.
۳٫۱٫ آزمایش شماره ۱: تشخیص پیکان
در این آزمایش، ما بر روی تشخیص اشیاء پیکان در همه ارائه دهندگان نقشه تمرکز می کنیم: نقشه های بینگ، نقشه های گوگل و OSM. چالش این است که هر ارائه دهنده از سبک و اندازه متفاوتی برای فلش ها استفاده می کند. علاوه بر این، حتی یک ارائه دهنده مانند Bing Maps از سبک های مختلف پیکان برای انواع جاده های مختلف استفاده می کند. Google Maps ساده ترین کار با آن است زیرا شکل فلش در نقشه نسبتاً ضخیم و بزرگ است. از سوی دیگر، نقشههای بینگ و OSM از شکلهای پیکانی استفاده میکنند که بسیار باریکتر و کوچکتر هستند که تشخیص آنها را سختتر میکند. همه موارد فوق تشخیص فلش را برای نقشه های Bing و OSM سخت تر می کند.
دو رویکرد اصلی برای انجام این کار وجود دارد. یکی ساخت مدل های مختلف و آموزش آنها به طور جداگانه برای هر ارائه دهنده است. دیگری استفاده از یک مدل و آموزش آن بر روی مجموعه داده های آموزشی حاوی تصاویر از همه ارائه دهندگان است. برای جلوگیری از پیچیدگی مدیریت چندین مدل و ایجاد یک راه حل کلی تر، ما با رویکرد یک مدل پیش می رویم به این امید که شبکه برخی از ویژگی های زیربنایی عمیق را از آنچه که واقعاً یک فلش را شکل می دهد یاد بگیرد و تفاوت های سطحی را تعمیم دهد. سبک، رنگ و اندازه فلش. ما در مجموع ۲۹۶ نقطه داده آموزشی را در همه ارائه دهندگان آماده می کنیم و شبکه را بر اساس این داده ها آموزش می دهیم. پس از تنظیم شبکه به نرخ های زیر می رسیم:
همانطور که در جدول ۲ در بالا مشاهده می شود، ما به امتیاز F1 بسیار بالایی برای نقشه های گوگل و OSM دست یافته ایم. امتیاز F1 بینگ مپس ۸۹٫۳ درصد است. این به دلیل نمایه های کوچک چالش برانگیز برای پیکان های Bing Maps و استفاده از سبک ها و پروفایل های مختلف پیکان برای انواع جاده ها است. ما معتقدیم که میتوان با استفاده از مجموعه دادههای آموزشی بیشتر که نمایههای مختلف پیکان را پوشش میدهند، این امر را بهبود بخشید. ما به طور ضمنی در آزمایش بعدی به این موضوع می پردازیم، جایی که تمرکز خود را برای تشخیص جهت پیکان تغییر می دهیم، و به عنوان بخشی از آن، مجموعه داده آموزشی بسیار بزرگتری را آماده می کنیم.
ما از مدل برای انجام استنتاج بر روی تصاویر نمونه استفاده می کنیم تا کیفیت نتایج را تجسم کنیم. شکل ۷ ، شکل ۸ ، شکل ۹ و شکل ۱۰ خروجی های نمونه مدل را نشان می دهد که کارایی آن را نشان می دهد:
۳٫۲٫ آزمایش شماره ۲: تشخیص جهت پیکان
یکی از اهداف اصلی این تحقیق تشخیص جهت پیکان است. در این آزمایش، مدل قبلی را تغییر داده و آن را گسترش می دهیم تا جهت پیکان را نیز تشخیص دهیم. ما از یک مجموعه داده آموزشی مشابه به عنوان آزمایش های قبلی استفاده می کنیم. با این حال، ما از برچسب های مختلف برای نشان دادن جهت فلش استفاده می کنیم. به طور خاص، ما از هشت جهت اصلی برای تقریب جهت پیکان به صورت راست، چپ، بالا، پایین، بالا-راست، بالا-چپ، پایین-راست و پایین-چپ استفاده می کنیم. شکل ۱۱ جهت ها را نشان می دهد. این هشت جهت اصلی برای هدف ما برای تعیین جهت جاده کافی است.
تعیین جهت پیکان کار بسیار سخت تری است. بنابراین ما یک مجموعه داده آموزشی بسیار بزرگتر حاوی ۲۴۹۳ نقطه داده را آماده می کنیم که همه ارائه دهندگان داده و هر هشت جهت اصلی را پوشش می دهد. ما همچنین از یک شبکه عصبی عمیق تر و یک faster_rcnn_101_FPN استفاده می کنیم که دارای ۱۰۱ لایه در مقایسه با شبکه ۵۰ لایه ای استفاده شده در آزمایش قبلی است. ما از این شبکه استفاده می کنیم زیرا استفاده از شبکه ۵۰ لایه برای دریافت پیچیدگی داده های آموزشی کافی نبود و قادر به کاهش اتلاف مجموعه داده های آموزشی به سطح قابل قبولی نبود. شکل ۱۲ نشان می دهد که چگونه دقت مدل ما در حدود ۷۶ درصد افزایش یافت و با استفاده از تنها ۵۰ لایه نتوانست بیشتر بهبود یابد.
ما همچنین چرخش خودکار تصویر را که بخشی از افزایش استاندارد داده انجام شده توسط مدل است، خاموش می کنیم. این به این دلیل است که برچسب های ما به جهت ها حساس هستند و چرخش تصاویر منجر به برچسب های نادرست می شود.
ما مدل خود را آموزش می دهیم و شبکه عصبی را برای یافتن بهترین نتایج تنظیم می کنیم. جدول ۳ دقت و نرخ های فراخوانی را که مدل ما به دست آورده است نشان می دهد. همانطور که در این جدول نشان داده شده است، مدل ما به بیش از ۹۰% دقت و یادآوری در تشخیص جهت پیکان برای همه ارائه دهندگان دست می یابد.
ما از مدل برای انجام استنتاج بر روی تصاویر نمونه استفاده می کنیم تا کیفیت نتایج را تجسم کنیم. شکل ۱۳ ، شکل ۱۴ و شکل ۱۵ خروجی های نمونه مدل پیشنهادی ما را نشان می دهد. همانطور که در شکل ۱۳ ، شکل ۱۴ و شکل ۱۵ مشاهده می شود، مدل ما قادر است با موفقیت جعبه های مرزی برای موقعیت فلش ها ایجاد کند و جهت آنها را شناسایی کند. درصدها نشان می دهد که مدل ما چقدر در ارزیابی خود مطمئن است. فلش های شکل ۱۳نشان می دهد که مدل به درستی بین فلش های رو به بالا-چپ و فلش های رو به بالا-راست تمایز قائل می شود. به طور مشابه، مدل ما میتواند فلشهای داخل تصویر را که در شکل ۱۴ نشان داده شده است بهعنوان جهت چپ و راست شناسایی کند، اگرچه نمایه فلش بسیار کوچک است. علاوه بر این، شکل ۱۵ نشان میدهد که مدل ما میتواند فلشهایی را با جهتگیری صحیح در OSM تشخیص دهد که پسزمینهای بهطور قابلتوجهی در مقایسه با شکلهای ۱۳ و شکل ۱۴ دارد.
۳٫۳٫ آزمایش شماره ۳: تشخیص اختلاف در مسیرهای جاده در ارائه دهندگان نقشه
در این آزمایش نتایج دو جزء را با هم ترکیب و تحلیل می کنیم. ابتدا، ما از شبکه عصبی جهت گیری جاده (RDNN) برای استخراج جهت گیری پیکان استفاده می کنیم. دوم، ما از یک مؤلفه مبتنی بر دوتایی که توسط محققان دانشگاه واشنگتن [ ۵ ] توسعه یافته است استفاده میکنیم که یک نمایش دودویی و اسکلتی از جادهها را در یک تصویر نقشه مشخص ایجاد میکند. ما از هر دو مؤلفه برای تشخیص اختلاف بین ارائه دهندگان نقشه استفاده می کنیم. شکل ۱۶به نشان دادن نحوه انجام مقایسه کمک می کند. ما بخشهای جاده را بهعنوان امتداد جاده بین تقاطعها تعریف میکنیم و سپس بخشها را با اطلاعات جهت پیکان شناساییشده از مدل ما روی هم قرار میدهیم. توجه داریم که هر بخش جاده ممکن است به دلایلی مانند قرار گرفتن چندین فلش در جاده یا دو طرفه بودن جاده حاوی فلش های زیادی باشد. بنابراین، ما مجموعه ای از فلش ها را برای هر بخش جاده پیگیری می کنیم. مقایسه بر اساس مجموعه ای از جهت های مختلف پیکان که در بخش جاده مربوطه وجود دارد و نه فقط تعداد فلش ها انجام می شود. سپس هر بخش جاده را در میان ارائه دهندگان مختلف بر اساس موقعیت نقشه مطابقت می دهیم و برای وجود اختلاف در جهت پیکان اسکن می کنیم. دو تصویر نقشه معمولاً نمی توانند با تمام بخش های جاده مطابقت داشته باشند زیرا برخی از جاده ها ممکن است تنها توسط یک ارائه دهنده نمایش داده شوند. به این دلیل،
ما هزاران تصویر نقشه مربوط به مختصاتی را که به طور تصادفی از شش منطقه انتخاب شده اند بررسی می کنیم: اسپانیا، بریتانیا، ایالات متحده، ایتالیا، برزیل و مکزیک. ما دو نوع اختلاف را تعریف می کنیم:
-
نوع ۱ (اختلاف ضعیف): این زمانی تعریف میشود که یک ارائهدهنده فلشهایی داشته باشد که جهت خاصی را برای یک بخش جاده نشان میدهد، در حالی که ارائهدهنده دیگر اطلاعات فلشهای مربوط به همان بخش جاده را ندارد.
-
نوع ۲ (اختلاف شدید): این زمانی اتفاق میافتد که هر دو ارائهدهنده فلشهایی برای یک بخش جاده داشته باشند اما جهتهای آنها مطابقت نداشته باشد، که نشاندهنده یک جهت جاده متناقض است.
هر دو نوع ناسازگاری مورد توجه و ارزش هستند، اما اختلاف نوع ۲ نگرانی اصلی ما به دلیل شدت خطایی است که باید در یک نقشه رخ دهد تا چنین اختلافاتی ایجاد شود. علاوه بر این، آنها خطرات ایمنی جدی را به دلیل اینکه بالقوه باعث می شوند رانندگان در جهت اشتباه رانندگی کنند، به همراه دارند. این اختلافات بسیار نادرتر هستند و در کمتر از ۱ درصد از جهتهای جادهای در مقایسه با یکدیگر رخ میدهند. با توجه به اینکه ارائه دهندگان نقشه دقت زیادی برای جلوگیری از نمایش مسیرهای نادرست جاده دارند، قابل انتظار است.
نوع ۱ نیز از ارزش بالایی برخوردار است زیرا اولاً نشان دهنده کمبود اطلاعات نقشه ضروری برای برخی از مناطق است، اما به طور پیش فرض، فقدان جهت معمولاً نشان دهنده این است که ارائه دهنده نقشه این جاده را به عنوان دو طرفه در نظر می گیرد که همچنین می تواند منجر به یک خطر ایمنی شود.
شکل ۱۷ و شکل ۱۸ درصد هر نوع اختلاف یافت شده در یک منطقه معین را نشان می دهد.
به عنوان مثال، برای اسپانیا، نقشه های گوگل ما در مقایسه با نقشه های بینگ، مغایرت های قوی را تشخیص می دهد که درصدی از ۰٫۷۲٪ را نشان می دهد. شکل ۱۹ و شکل ۲۰ نمونه هایی از اختلافات قوی را نشان می دهد که در این منطقه برای نقشه های گوگل در مقابل نقشه های بینگ یافت شده است.
به طور مشابه، سیستم ما اختلافات شدید ۰٫۴۵٪ در ایتالیا و ۰٫۱۹٪ در مکزیک را برای مقایسه نقشه های گوگل و بینگ مپ تشخیص می دهد. شکل ۲۱ ، شکل ۲۲ و شکل ۲۳ چند نمونه را نشان می دهد.
به دلیل نادر بودن آنها و اهمیت شناسایی چنین مغایرتی، سیستم ما با احتیاط اشتباه می کند و هر چیزی را که ممکن است مغایرت نوع ۲ باشد گزارش می دهد. برخی از این موارد مثبت کاذب هستند، اما مثبت کاذب بر منفی کاذب ارجحیت دارند. اگرچه همه مغایرتهای گزارششده نوع ۲ مطابق با خطاهای واقعی تضمین نمیشوند، سیستم ما میتواند به طور چشمگیری به محدود کردن مکانهایی که نیاز به جستجو دارند کمک کند. سیستم ما تعداد اختلافات را برای هر مختصات گزارش میکند تا به تسهیل این بررسی دستی کمک کند.
به عنوان مثال، جدول ۴ دقت ناهماهنگی های قوی گزارش شده توسط سیستم ما در اسپانیا را نشان می دهد.
نوع ۱ (اختلاف ضعیف) نیز ارزش زیادی دارد زیرا ابتدا نشان دهنده کمبود اطلاعات نقشه ضروری برای برخی از مناطق است، اما همچنین فقدان اطلاعات جهت معمولاً نشان می دهد که ارائه دهنده نقشه این جاده دو طرفه را که پیش فرض است در نظر می گیرد. این همچنین می تواند به یک خطر جدی ایمنی منجر شود. به عنوان مثال، اجازه دهید اختلاف ضعیف زیر را که توسط سیستم ما در مکزیک یافت شده است، در نظر بگیریم:
در شکل ۲۴ بالا، Bing Maps دارای یک فلش به سمت شمال برای جاده است که با رنگ قرمز دایره شده است، که نشان می دهد بخش جاده یک جهت است. با این حال، گوگل هیچ پیکانی برای این بخش جاده ندارد که نشان می دهد جاده به طور پیش فرض دو جهته است. برای تأیید این موضوع، مسیرهای ارائه شده توسط هر دو ارائه دهنده را بررسی می کنیم. شکل ۲۵ مسیرهای نقطه A تا B را در هر دو نقشه نشان می دهد.
گوگل به وضوح از این جاده در جهت مخالف (به سمت جنوب) استفاده می کند، در حالی که بینگ از این جاده اجتناب می کند و مسیر طولانی تر دیگری را انتخاب می کند. ما تصاویر ماهوارهای این جاده را بررسی میکنیم و از آن به عنوان یک حقیقت زمینی استفاده میکنیم، که به نظر میرسد نشان میدهد که جاده واقعاً یک جهته به سمت شمال است. این یک مثال واضح است که در آن یک اختلاف ضعیف سناریویی را آشکار می کند که در آن یک ارائه دهنده از یک جاده در جهت اشتباه استفاده می کند و خطرات ایمنی جدی را به همراه دارد.
۴٫ نتیجه گیری
در این مقاله، چالش تشخیص مکان و جهت پیکان در تصاویر نقشه در ارائه دهندگان مختلف را بررسی کردیم. ما یک مدل شبکه عصبی ارائه کردیم که جهت پیکان را با بیش از ۹۰٪ امتیاز F1 برای ارائه دهندگان مختلف شناسایی کرد (Google Maps: 91.9٪، Bing Maps: 91.0٪، OSM: 95.5٪). سپس از مدل، همراه با یک جزء تشخیص بخش جاده، برای تحلیل و اسکن خودکار مناطق مطالعه انتخابی تصادفی و گزارش درصد مغایرتهای کشف شده در جهت جادهها برای مناطق مختلف مطالعه استفاده کردیم. ما همچنین فهرستی از این اختلافات را برای بررسی دستی بیشتر تهیه کردیم. سیستم ما نمونههای واقعی مسیرهای جادهای متناقض را در بین ارائهدهندگان نقشه کشف کرد، که ثابت میکند چنین اختلافاتی وجود دارد و خطرات ایمنی جدی ایجاد میکند.
منابع
- ۹ نکته درباره داده های نقشه های گوگل: فراتر از نقشه. در دسترس آنلاین: https://cloud.google.com/blog/products/maps-platform/9-things-know-about-googles-maps-data-beyond-map (در ۴ آوریل ۲۰۲۲ قابل دسترسی است).
- سیپلوچ، بی. یعقوب، ر. مونی، پی. Winstanley، AC مقایسه دقت OpenStreetMap برای ایرلند با Google Maps و Bing Maps. در مجموعه مقالات نهمین سمپوزیوم بین المللی ارزیابی دقت فضایی در منابع طبیعی و علوم محیطی، لستر، بریتانیا، ۲۰ تا ۲۳ ژوئیه ۲۰۱۰٫ پ. ۳۳۷٫ [ Google Scholar ]
- بندیل، ع. گیردار، وی. چاو، اچ. علی، م. هنداوی، ع. گوویند، اچ. کائو، پی. آهنگ، A. GeoDart: سیستمی برای کشف اختلاف نقشه ها. در مجموعه مقالات سی و هفتمین کنفرانس بین المللی مهندسی داده (ICDE) IEEE 2021، Chania، یونان، ۱۹-۲۲ آوریل ۲۰۲۱؛ صص ۲۵۳۵–۲۵۴۶٫ [ Google Scholar ] [ CrossRef ]
- بصیری، ع. جکسون، ام. امیریان، پ. پورعبدالله، ع. سستر، ام. وینستانلی، ا. مور، تی. Zhang, L. ارزیابی کیفیت داده های OpenStreetMap با استفاده از استخراج مسیر. ژئو اسپات. Inf. علمی ۲۰۱۶ ، ۱۹ ، ۵۶-۶۸٫ [ Google Scholar ] [ CrossRef ]
- یک روش جغرافیایی برای تشخیص مغایرتهای بخش جاده مبتنی بر نقشه. در دسترس آنلاین: http://faculty.washington.edu/mhali/Publications/Publications.htm (دسترسی در ۱۰ مارس ۲۰۲۱).
- باندیل، ع. گیردار، وی. دینسر، ک. گوویند، اچ. کائو، پی. آهنگ، ا. علی، ام. یک سیستم تعاملی برای مقایسه، کاوش و شناسایی اختلافات در ارائه دهندگان نقشه. در مجموعه مقالات بیست و هشتمین کنفرانس بین المللی پیشرفت در سیستم های اطلاعات جغرافیایی، سیاتل، WA، ایالات متحده آمریکا، ۳ تا ۶ نوامبر ۲۰۲۰؛ ص ۴۲۵-۴۲۸٫ [ Google Scholar ]
- اونسالان، سی. Sirmacek، B. تشخیص شبکه جاده با استفاده از روشهای نظری احتمالی و نموداری. IEEE Trans. Geosci. Remote Sens. ۲۰۱۲ , ۵۰ , ۴۴۴۱–۴۴۵۳٫ [ Google Scholar ] [ CrossRef ]
- جان، وی. ژمینگ، ال. Mita, S. تشخیص چراغ راهنمایی و پیکان قوی با استفاده از پارامترهای بهینه دوربین و اولویت های مبتنی بر GPS. در مجموعه مقالات کنفرانس آسیا و اقیانوسیه ۲۰۱۶ در مورد سیستم های ربات هوشمند (ACIRS)، توکیو، ژاپن، ۲۰-۲۲ ژوئیه ۲۰۱۶؛ ص ۲۰۴-۲۰۸٫ [ Google Scholar ] [ CrossRef ]
- Santosh، KC; وندلینگ، ال. آنتانی، س. تشخیص پیکان روکش شده Thoma، GR برای برچسب زدن مناطق مورد علاقه در تصاویر زیست پزشکی. IEEE Intell. سیستم ۲۰۱۶ ، ۳۱ ، ۶۶-۷۵٫ [ Google Scholar ] [ CrossRef ]
- شفر، بی. کیپر، ام. Stuckenschmidt، H. Arrow R-CNN برای تشخیص نمودار دستنویس. بین المللی J. Doc. مقعدی تشخیص دهد. (IJDAR) ۲۰۲۱ ، ۲۴ ، ۳-۱۷٫ [ Google Scholar ] [ CrossRef ]
- Girshick, R. Fast r-cnn. در مجموعه مقالات کنفرانس بین المللی IEEE در بینایی کامپیوتر، سانتیاگو، شیلی، ۷ تا ۱۳ دسامبر ۲۰۱۵٫ ص ۱۴۴۰-۱۴۴۸٫ [ Google Scholar ]
- رن، اس. او، ک. گیرشیک، آر. Sun, J. Faster r-cnn: به سمت تشخیص شی در زمان واقعی با شبکه های پیشنهادی منطقه. Adv. عصبی Inf. روند. سیستم ۲۰۱۵ ، ۲۸ ، ۹۱-۹۹٫ [ Google Scholar ] [ CrossRef ]
- وو، ی. کریلوف، آ. ماسا، اف. لو، W.-Y. Girshick, R. Detectron2. ۲۰۱۹٫ در دسترس آنلاین: https://github.com/facebookresearch/detectron2 (در ۱۷ مه ۲۰۲۲ قابل دسترسی است).
- دوسوویتسکی، آ. بیر، ال. کولسنیکوف، آ. وایسنبورن، دی. ژای، ایکس. Unterthiner، T. دهقانی، م. مایندرر، م. هیگلد، جی. گلی، اس. و همکاران ارزش یک تصویر ۱۶×۱۶ کلمه است: ترانسفورماتور برای تشخیص تصویر در مقیاس. arXiv ۲۰۲۰ ، arXiv:2010.11929. [ Google Scholar ]
- لیو، ز. لین، ی. کائو، ی. متعجب.؛ وی، ی. ژانگ، ز. لین، اس. Guo, B. ترانسفورماتور Swin: ترانسفورماتور دید سلسله مراتبی با استفاده از پنجره های جابجا شده. در مجموعه مقالات کنفرانس بین المللی IEEE/CVF در بینایی کامپیوتر، مونترال، QC، کانادا، ۱۰ تا ۱۷ اکتبر ۲۰۲۱؛ صفحات ۱۰۰۱۲–۱۰۰۲۲٫ [ Google Scholar ]
- لیو، ز. مائو، اچ. وو، سی. فایختنهوفر، سی. دارل، تی. Xie, S. یک شبکه برای دهه ۲۰۲۰٫ در مجموعه مقالات کنفرانس IEEE/CVF در مورد دید کامپیوتری و تشخیص الگو، نیواورلئان، لس آنجلس، ایالات متحده آمریکا، ۱۹ تا ۲۰ ژوئن ۲۰۲۲؛ صفحات ۱۱۹۷۶-۱۱۹۸۶٫ [ Google Scholar ]
- یو، تی. هوانگ، اچ. جیانگ، ن. آچاریا، مطالعه TD در مورد دقت نسبی و روش تأیید نقشههای با وضوح بالا برای رانندگی خودمختار. ISPRS Int. J. Geo-Inf. ۲۰۲۱ ، ۱۰ ، ۷۶۱٫ [ Google Scholar ] [ CrossRef ]
- ما، جی. سان، س. ژو، ز. ون، بی. لی، اس. روش تطبیق مناطق مسکونی چند مقیاسی با در نظر گرفتن ویژگیهای همسایگی فضایی. ISPRS Int. J. Geo-Inf. ۲۰۲۲ ، ۱۱ ، ۳۳۱٫ [ Google Scholar ] [ CrossRef ]
- الغانیم، ع. جیلانی، م. برتولتو، ام. McArdle، G. استفاده از ویژگیهای جاده و رفتار مشارکتکننده برای ارزیابی کیفیت نوع جاده در OSM. ISPRS Int. J. Geo-Inf. ۲۰۲۱ ، ۱۰ ، ۴۳۶٫ [ Google Scholar ] [ CrossRef ]
- کوکولتسوس، تی. هاکلی، م. Ellul, C. روشی خودکار برای ارزیابی کامل بودن داده ها و دقت موقعیتی OpenStreetMap. In Proceedings of the GeoComputation، لندن، بریتانیا، ۲۰-۲۲ ژوئیه ۲۰۱۱٫ [ Google Scholar ]
- بروولی، MA; مینگینی، ام. Molinari، ME یک روش خودکار مبتنی بر چمن برای ارزیابی دقت هندسی شبکه جاده ای OpenStreetMap پاریس. در مجموعه مقالات کنگره ISPRS، پراگ، جمهوری چک، ۱۲ تا ۱۹ ژوئیه ۲۰۱۶٫ [ Google Scholar ]
- بروولی، MA; مینگینی، ام. مولیناری، م. Mooney, P. Towards یک مقایسه خودکار OpenStreetMap با مجموعه داده های معتبر جاده. ترانس. GIS ۲۰۱۷ ، ۲۱ ، ۱۹۱-۲۰۶٫ [ Google Scholar ] [ CrossRef ]
- جکسون، اس پی؛ مولن، دبلیو. آگوریس، پ. کروکس، آ. کرویتورو، آ. استفانیدیس، الف. ارزیابی کامل بودن و خطای مکانی ویژگیها در اطلاعات جغرافیایی داوطلبانه. ISPRS Int. J. Geo-Inf. ۲۰۱۳ ، ۲ ، ۵۰۷-۵۳۰٫ [ Google Scholar ] [ CrossRef ]
- لودویگ، آی. ووس، ا. Krause-Traudes، M. مقایسه شبکه های خیابانی Navteq و OSM در آلمان. در پیشرفت علم اطلاعات جغرافیایی برای جهانی در حال تغییر . Springer: برلین/هایدلبرگ، آلمان، ۲۰۱۱; صص ۶۵-۸۴٫ [ Google Scholar ]
- زیلسترا، دی. Hochmair، HH استفاده از دادههای رایگان و اختصاصی برای مقایسه طولهای کوتاهترین مسیر برای مسیریابی مؤثر عابر پیاده در شبکههای خیابانی. ترانسپ Res. ضبط ۲۰۱۲ ، ۲۲۹۹ ، ۴۱-۴۷٫ [ Google Scholar ] [ CrossRef ]
- وخیدوف، اچ. هنگ، HG; کانگ، جی کی. Hoang، TM; پارک، KR تشخیص علائم تیر-جاده آسیب دیده توسط حسگر دوربین نور مرئی بر اساس شبکه عصبی کانولوشن. Sensors ۲۰۱۶ , ۱۶ , ۲۱۶۰٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
- لین، TY; دلار، پی. گیرشیک، آر. او، ک. حریهاران، بی. Belongie, S. شبکه های هرمی را برای تشخیص اشیا مشخص کنید. در مجموعه مقالات کنفرانس IEEE در مورد دید رایانه و تشخیص الگو، هونولولو، HI، ایالات متحده آمریکا، ۲۱ تا ۲۶ ژوئیه ۲۰۱۷؛ صص ۲۱۱۷–۲۱۲۵٫ [ Google Scholar ]
- لین، تی.-ای. مایر، م. بلنگی، اس. هیز، جی. پرونا، پی. رامانان، دی. دلار، پی. Zitnick، CL مایکروسافت کوکو: اشیاء مشترک در زمینه. در کنفرانس اروپایی بینایی کامپیوتر ; Springer: Cham, Switerland, 2014; صص ۷۴۰-۷۵۵٫ [ Google Scholar ]
- CVAT. در دسترس آنلاین: https://cvat.org/ (دسترسی در ۴ فوریه ۲۰۲۲).
- سیستم کاشی نقشه بینگ. در دسترس آنلاین: https://docs.microsoft.com/en-us/bingmaps/articles/bing-maps-tile-system?redirectedfrom=MSDN (دسترسی در ۵ مارس ۲۰۲۲).

شکل ۱٫ مثال ناهماهنگی جهت گیری جاده در ارائه دهندگان مختلف: ( الف ) نقشه های بینگ این جاده را در اسپانیا نشان می دهد که به سمت جنوب شرقی می رود. ( ب ) نقشه های گوگل، با این حال، همین جاده را به سمت شمال غربی نشان می دهد.

شکل ۲٫ معماری سطح بالای R-CNN سریعتر.

شکل ۳٫ معماری کلی سیستم.

شکل ۴٫ معماری شبکه عصبی تشخیص جهت پیکان.
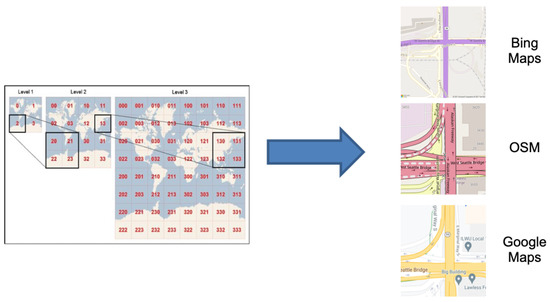
شکل ۵٫ سیستم کاشی نقشه های بینگ [ ۳۰ ].

شکل ۶٫ برچسب گذاری داده ها با استفاده از ابزار آنلاین CVAT.

شکل ۷٫ تشخیص موقعیت پیکان برای نقشه های گوگل.

شکل ۸٫ تشخیص موقعیت پیکان برای نقشه های بینگ.

شکل ۹٫ تشخیص موقعیت فلش برای OSM.

شکل ۱۰٫ تشخیص موقعیت فلش دوم برای نقشه های بینگ.
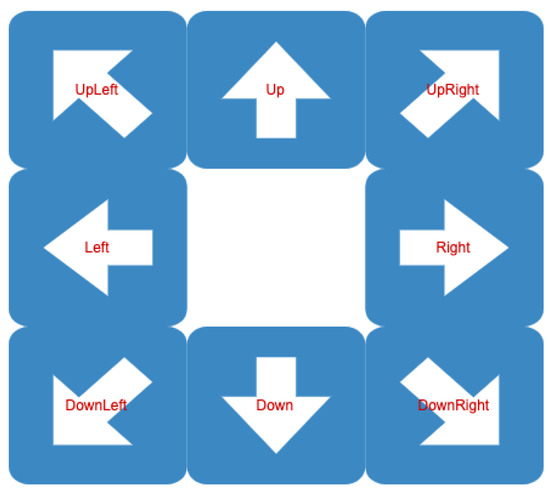
شکل ۱۱٫ کلاس های مورد استفاده برای طبقه بندی جهت پیکان.

شکل ۱۲٫ سقف دقت تمرین در ۷۶% برای Faster-RCNN با ۵۰ لایه.

شکل ۱۳٫ تشخیص جهت پیکان برای نقشه های گوگل.

شکل ۱۴٫ تشخیص جهت پیکان برای نقشه های بینگ.

شکل ۱۵٫ تشخیص جهت پیکان برای OSM.

شکل ۱۶٫ معماری تولید شبکه راه.

شکل ۱۷٫ آمار اختلاف جهت جاده نوع ۱ (اختلاف ضعیف).

شکل ۱۸٫ آمار اختلاف جهت جاده نوع ۲ (اختلاف شدید).

شکل ۱۹٫ نوع ۲ (اختلاف قوی) مثال شماره ۱-اسپانیا.

شکل ۲۰٫ نوع ۲ (اختلاف قوی) مثال #۲-اسپانیا.

شکل ۲۱٫ نوع ۲ (اختلاف قوی) مثال #۳-ایتالیا.

شکل ۲۲٫ نوع ۲ (اختلاف قوی) مثال #۴-ایتالیا.

شکل ۲۳٫ نوع ۲ (اختلاف قوی) مثال شماره ۵-مکزیک.

شکل ۲۴٫ نمونه ۱ (اختلاف ضعیف) – مکزیک.

شکل ۲۵٫ اختلاف در داده های مسیر – مکزیک.