۱٫ معرفی
اطلاعات به موقع و دقیق در مورد زیرساخت های شهری یک پیش نیاز مهم و پیوند کلیدی برای ارتقای توسعه مدرن حکمروایی شهری است و همچنین برای اجرای مفهوم “مدیریت تمام چرخه” شهرها و ساخت و ساز از اهمیت زیادی برخوردار است. شهرهای هوشمند [ ۱]. اطلاعات اولیه در مورد زیرساخت های شهری عمدتاً در قالب بررسی های میدانی جمع آوری و خلاصه شد. اگرچه این داده ها نسبتا دقیق هستند، این روش در هنگام بررسی اطلاعات در مقیاس بزرگ در مورد زیرساخت های شهری بسیار پرهزینه است. تصاویر نمای خیابان یک منبع داده سنجش از دور در حال ظهور است که به معیشت مردم مربوط می شود. توسعه شهرهای مدرن، فن آوری ها و روش های جدید برای بهبود سریع سطح به روز رسانی زیرساخت های شهری ضروری است. علاوه بر این، تصاویر نمای خیابان طیف وسیعی از مناطق را پوشش میدهند [ ۲ ، ۳]. در نتیجه، تصاویر نمای خیابان به روشی موثر برای به دست آوردن اطلاعات در مورد زیرساخت های شهری به موقع تبدیل شده است. بنابراین، محققان تحقیقاتی را بر روی استخراج اطلاعات در مورد زیرساخت های شهری با استفاده از این منبع داده سنجش از دور در حال ظهور انجام داده اند [ ۴ ، ۵ ، ۶ ].
اطلاعات از تابلوهای فروشگاه ها یکی از مهم ترین منابع اطلاعاتی در مورد زیرساخت های شهری است و برای مدیریت ظاهر شهری، تحلیل توسعه اقتصادی شهری و بازسازی سه بعدی شهری ارزش مهمی دارد [ ۷ ]. با این حال، تا به امروز، مطالعات کمی در مورد استخراج اطلاعات تابلوهای فروشگاهی با استفاده از تصاویر نمای خیابان انجام شده است. در این مطالعه، بر اساس ویژگی هایی که ویژگی های مشابهی با تابلوهای فروشگاهی دارند، تحقیق و تحلیلی انجام دادیم. با نزدیک شدن به تشخیص شی سنتی، روشهای شی گرا از یک الگوریتم تقسیمبندی تصویر [ ۸ ، ۹ ] برای خوشهبندی پیکسلهایی با ویژگیهای مشابه برای تشکیل یک واحد ناحیه تقسیمبندی شده استفاده میکنند و سپس از یک الگوریتم طبقهبندی تصویر استفاده میکنند. ۱۰ ، ۱۱] برای استخراج اشیاء. با این حال، روشهای سنتی بر اطلاعات طیفی و بافتی تصاویر در تقسیمبندی و طبقهبندی تکیه میکنند. یعنی بر اساس همگنی پیکسل ها، اشیاء تصویر از پایین به بالا جمع می شوند [ ۱۲ ، ۱۳ ]. با این حال، اطلاعات طیفی تصویر به راحتی تحت تأثیر محیط تصویربرداری، شرایط آب و هوایی، فصول و شرایط عکسبرداری [ ۱۴ ، ۱۵ ]، سایه ها [ ۱۶ ، ۱۷ ]، تغییر شکل رنگ اشیا [ ۱۸ ] قرار می گیرد. ]، همپوشانی اشیا [ ۱۹ ] قرار می گیرد.] و مشکلات دیگر. علاوه بر محدودیت های فوق، چالش اصلی در مورد استفاده از تابلوهای فروشگاهی به عنوان هدف شناسایی این است که شهرها به سرعت در حال توسعه هستند و فروشگاه ها می توانند اندازه های مختلفی داشته باشند. اگرچه تابلوهای فروشگاهی عمدتاً به شکل مستطیل منظم هستند، اما مشخصات، اندازه و رنگ آن بسیار متفاوت است، که منجر به ناهمگونی فضایی بالا و مشکل در استخراج اطلاعات از تابلوهای فروشگاهی می شود. در سطح روش فنی، روش تقسیم بندی و طبقه بندی برای به دست آوردن اشیاء تصویر اساساً ویژگی های سطح بالا مانند اطلاعات ریخت شناسی و اطلاعات بافت معنایی تصاویر را در نظر نمی گیرد. تجمیع پیکسلها که صرفاً بر اساس ویژگیهای طیفی است، از سایر ویژگیهای تصاویر نمای خیابان استفاده کامل نمیکند. در نتیجه، واحدهای شی بهدستآمده با روشهای سنتی اغلب با شناخت مورفولوژیکی افراد از اشیاء هدف واقعی مطابقت ندارند، که منجر به شکست طبقهبندی سطح شی میشود. بنابراین، انجام تحقیقات در زمینه استخراج دقیق اطلاعات از تابلوهای فروشگاهی در مناطق شهری از اهمیت عملی و ارزش کاربردی بالایی برخوردار است.
تا به امروز، وظیفه تفسیر تابلوهای فروشگاهی از تصاویر نمای خیابان عمدتاً توسط چشم انسان انجام شده است. دلیل این امر این است که انسان می تواند ویژگی های فضایی مانند شکل و بافت موجود در تصاویر را به صورت سلسله مراتبی درک کند و بتواند اطلاعات بصری به دست آمده را به صورت سلسله مراتبی استخراج کند تا به استخراج دقیق اطلاعات هدف دست یابد. بنابراین، نحوه استفاده کامل از ویژگیهای غنی تصاویر نمای خیابان، شبیهسازی مکانیسم ادراک بصری انسان، و استخراج واحدهای منطقهای که با اهداف واقعی مطابقت دارند (مانند تابلوهای فروشگاهی که در این مقاله به آنها توجه میکنیم) کلید
توسعه سریع شبکههای عصبی کانولوشنال (CNN) با تصمیمگیری مبتنی بر داده و بهینهسازی خود تکراری، دور جدیدی از تحقیقات در تجزیه و تحلیل و درک تصویر [ ۲۰ ] را ارتقا داده و همچنین به توسعه سریع تشخیص بصری هدف منجر شده است. ۲۱ ، ۲۲ ، ۲۳ ]. یادگیری بازنمایی از طریق شبکه های عمیق می تواند انتزاع چند سطحی را در تجزیه و تحلیل تصویر معنایی انجام دهد، به این معنی که می تواند از روش های سنتی در کاربردهای سنجش از دور بسیار بهتر عمل کند [ ۲۴ ]. ]. در زمینه پردازش تصویر، یادگیری عمیق را می توان به تقسیم بندی معنایی و تشخیص اشیاء تقسیم کرد [ ۲۵]. استخراج ویژگی معنایی چند مقیاسی بر اساس تقسیمبندی معنایی و تشخیص شی دارای ویژگیهای بازده و اتوماسیون بالا است که میتواند عملی بودن تشخیص تابلوهای فروشگاه را بهبود بخشد.
در تحقیق بر روی تقسیمبندی معنایی، به منظور حل مشکل رایج اشیاء در تصاویر نمای خیابان، یعنی تنوع مقیاس، شبکههای کاملاً کانولوشنال (FCNs) [ ۲۶ ] معمولاً با لایههای کانولوشنال متعدد و لایههای همگرایی انباشته میشوند [ ۲۷ ، ۲۸ ] ]. برای مثال، DeepLabv3 [ ۲۹ ] یک ماژول ادغام هرم فضایی آتروس (ASPP) را معرفی میکند و از پیچش آتروس به صورت آبشاری یا موازی برای گرفتن بافت چند مقیاسی با نرخهای آتروس مختلف [ ۳۰ ، ۳۱ ] و U-Net [ ۳۲ ] استفاده میکند. الحاق نقشه ها را در سطوح مختلف نشان می دهد [ ۳۳ ، ۳۴]. با این حال، با این روشهای تقسیمبندی مبتنی بر پیکسل، خروجی اغلب لبههای نامنظم و گوشههای بیش از حد صاف را نشان میدهد [ ۳۵ ]. کار قبلی در مورد تشخیص بیلبورد، مشکل تشخیص را به عنوان یک مشکل تقسیم بندی معنایی در نظر گرفته است [ ۳۶ , ۳۷]، انجام طبقه بندی و محلی سازی در سطح پیکسل تصویر. با این حال، از نقطه نظر کاربردی، حاشیه نویسی برای تقسیم بندی معنایی تصویر وقت گیرتر است، که دشواری ساخت مجموعه داده های بزرگ را افزایش می دهد. نکته دیگر این است که خروجی تقسیم بندی معنایی معمولاً به صورت گرافیک های نامنظم است، در حالی که شکل هندسی تابلوهای فروشگاه ها عمدتاً مستطیلی است. این با خروجی تشخیص اشیا مطابقت دارد، به طوری که روش های تشخیص اشیا برای کار تشخیص تابلوهای فروشگاه مناسب تر هستند.
در تحقیقات تشخیص اشیا، اکثر اشیاء تحقیقاتی مشکلات مشابهی برای ذخیره تابلوهای راهنما دارند. به عنوان مثال، برای رسیدگی به مشکلات انسداد و اهداف کوچک، Xu et al. [ ۳۸ ] از یک تابع از دست دادن دفعی برای حل مشکل انسداد هدف استفاده کرد و یک شبکه فرعی دو جهته آگاه از مقیاس برای شناسایی اهداف در دو مقیاس استفاده شد. سپس در پایان استنتاج، آمیختگی ادراکی انجام شد. موررا و همکاران برای مکان هدف پوشیده شده توسط یک پنجره شفاف. [ ۳۹ ] از یک مجموعه داده برچسبگذاری شده خود استفاده کرد و روشهای مختلف افزایش داده را به همراه توابع از دست دادن مانند از دست دادن محلیسازی اعمال کرد. وانگ و همکاران با هدف حل مشکلات نسبت پیکسل پایین اشیاء پیش زمینه و تفاوت های قابل توجه مقیاس های شیء. [ ۴۰] FSoD-Net را پیشنهاد کرد که یک هسته لاپلاس را با لایههای کانولوشنال چند مقیاسی موازی کمتری ادغام میکند و سه لایه شاخه رگرسیون جدا شده متفاوت را در بر میگیرد و امتیاز طبقهبندی جعبههای مرزی پیشبینیشده را بهبود میبخشد. یک مدل یادگیری عمیق را می توان برای دستیابی به طبقه بندی و استخراج انواع مختلف اشیاء در تصویر استفاده کرد، اما نمی تواند به اثر تفسیر بصری مصنوعی دست یابد، یعنی هر نوع شی باید با توجه به ویژگی های بصری خاص خود در نظر گرفته شود. [ ۴۱ ، ۴۲ ، ۴۳ ، ۴۴]. تابلوهای راهنمای فروشگاه ها معمولاً در وسط تصاویر نمای خیابان متمرکز می شوند و اغلب توسط درختان مسدود می شوند. این انسدادها اطلاعات هدف را تکه تکه می کنند و رابطه توپولوژیکی را از بین می برند. علاوه بر این، تابلوهای راهنما و تابلوهای تاکسی در صحنه نیز می توانند با تابلوهای فروشگاه تداخل داشته باشند. روشی برای طراحی یک روش شناسایی معقول و مؤثر با توجه به ویژگی های تابلوهای فروشگاهی در تصاویر نمای خیابان باید در هنگام ساخت یک مدل در نظر گرفته شود.
در این مطالعه، ما بر اساس جدیدترین نسخه YOLO پیشنهاد شده توسط Ultralytics [ ۴۵ ]، که شبکه ای است که اغلب با نام YOLOv5 نامیده می شود، ساخته ایم تا از دقت تشخیص بالا و استدلال سریع آن بهره ببریم. ما شبکه OSO-YOLOv5 را پیشنهاد میکنیم که توجه مکان و بازسازی توپولوژی را تحت محدودیت ویژگیهای مستطیلی یکپارچه میکند. با آزمایشهای فراوان، امکانسنجی و کارایی این روش برای استخراج تابلوهای فروشگاهی در محیطهای مختلف شهری بررسی شد.
آثار اصلی این مقاله را می توان به شرح زیر خلاصه کرد:
(۱) ما اطلاعات مختصات را قبل از لایه کانولوشن در ساختار ستون فقرات اضافه می کنیم که باعث می شود روش تا حدی از موقعیت آگاه باشد.
(۲) ما ماژول C3 را در ساختار ستون فقرات با بهبود بافت مقیاس و اطلاعات زمینه محله، که به ماژول جدید C3 محدودیتهای ویژگی مستطیلی شکل و یک تابع بازسازی توپولوژی میدهد، بهبود میبخشیم.
(۳) ما یک مدل ادغام هرم فضایی بهبود یافته را برای کاهش بار محاسباتی و بهبود توانایی یادگیری غیرخطی مدل با آبشاری استخرهای هسته کوچک پیشنهاد میکنیم. علاوه بر این، ما کانالها و ماژولهای توجه فضایی را اضافه میکنیم تا تضعیف ویژگیها به دلیل فرآیند تحویل را برطرف کنیم.
بقیه این مقاله به شرح زیر سازماندهی شده است: بخش ۲ جزئیات روش پیشنهادی را ارائه می کند. نتایج تجربی و تجزیه و تحلیل در بخش ۳ ارائه شده است. در نهایت، نتایج ما در بخش ۴ آورده شده است.
۲٫ روش ها
در محیط پیچیده و متغیر شهری، در مقیاسهای مختلف ساخت و ساز و اشکال برنامهریزی، تابلوهای فروشگاهی میتوانند ویژگیهای مورفولوژیکی بسیار متفاوتی را ارائه دهند. اطلاعات مورفولوژیکی بصری ویژگی اصلی استخراج اطلاعات تابلوهای فروشگاهی در تصاویر نمای خیابان است. از این رو با توجه به ویژگی های تابلوهای فروشگاهی در تصاویر نمای خیابان، روشی برای استخراج اطلاعات تابلوهای فروشگاهی معرفی می کنیم که از قابلیت انتزاع ویژگی چند سطحی و سرعت بالای شبکه YOLOv5 بهره می برد.
۲٫۱٫ تجزیه و تحلیل ویژگی های بصری
با توجه به تفاوت در محیط های خیابان و مقیاس فروشگاه، تابلوهای فروشگاهی ویژگی های بصری متفاوتی را در تصاویر نمای خیابان ارائه می دهند. بنابراین، بر اساس ویژگیهای هندسی، ویژگیهای بافتی و ویژگیهای مکان تابلوهای فروشگاهی در تصاویر نمای خیابان، میتوان آنها را به سه نوع تقسیم کرد: (۱) تابلوهای فروشگاهی بدون انسداد. (۲) تابلوهای راهنما را با درجه انسداد جزئی ذخیره کنید. و (۳) تابلوهای راهنما را با درجه انسداد بالا ذخیره کنید. مشخصات انواع تابلوهای فروشگاهی در جدول ۱ خلاصه شده است.
علاوه بر این، شکل ۱تصاویر نمای خیابان را با انواع مختلف تابلوهای راهنمای فروشگاه نشان می دهد و ویژگی های بصری آنها را توضیح می دهد: (۱) تابلوهای فروشگاهی بدون انسداد معمولاً دارای مرزهای واضح، بافت داخلی نسبتاً یکنواخت هستند و معمولاً از نظر فضایی در وسط تصاویر توزیع و متمرکز می شوند. آنها همچنین مورفولوژی مستطیلی واضحی را ارائه می دهند. (۲) تابلوهای فروشگاه با انسداد جزئی دارای اطلاعات مرزی ناقص، بافت ناهموار، شکل مستطیل شکل نسبتاً تار هستند و بیشتر در وسط تصاویر متمرکز شده اند. (۳) تابلوهای فروشگاه با درجه انسداد بالا دارای ویژگیهای مرزی مبهم یا اساساً غیرقابلوجود هستند و بافت نامرتب است. با این حال، شکل مستطیل را می توان با توجه به دانش قبلی تعیین کرد و بیشتر تابلوهای راهنما در وسط تصاویر متمرکز شده اند.
به طور خلاصه، در روش پیشنهادی، ما ویژگیهای مشترک تابلوهای فروشگاه را در نظر میگیریم – شکل مستطیلی و موقعیت توزیع شده در مرکز – و محدودیتهای ویژگی مستطیلی و ادراک را به شبکه اضافه میکنیم. از آنجایی که عامل تداخل اصلی در تشخیص خودکار تابلوهای فروشگاهی انسداد است، ما برای شناسایی آنها به بافت داخلی تابلوهای فروشگاه تکیه می کنیم و یک ماژول بازسازی توپولوژی را ادغام می کنیم. ما همچنین مشکل رایج اشیاء در تصاویر نمای خیابان – ویژگی های چند مقیاسی – را در نظر می گیریم و یک ماژول درک چند مقیاسی را معرفی می کنیم.
۲٫۲٫ مدل پیشنهادی
مدل طراحی شده در این مطالعه شامل دو بخش اصلی است: (۱) ستون فقرات، همانطور که در کادر آبی در شکل ۲ نشان داده شده است. در مرحله اول، ماژول با توجه به شکل و توزیع فضایی تابلوهای فروشگاه، با در نظر گرفتن محدودیتهای ویژگیهای مستطیلی، توجه به مکان و بازسازی توپولوژی، سازماندهی مجدد میشود. لایه CoordConv، ماژول C3_SC و ماژول C3 به منظور بهبود دقت استخراج ویژگی طراحی شده اند. ماژول بهبود یافته ادغام هرم فضایی (IFSPP) برای اطمینان از عملکرد آگاه از مقیاس و بهبود توانایی تعمیم مدل، بدون افزایش میزان محاسبه مدل استفاده میشود. (۲) گردن، همانطور که در کادر قرمز نشان داده شده است شکل ۲ نشان داده شده است، برای اطمینان از کفایت و دقت استفاده از ویژگی در فرآیند گسترش از ترکیب سطح بالا به سطح پایین ویژگی ها با معنایی قوی استفاده می شود و یک ماژول توجه اضافه می کند. معماری شبکه برای سناریوهای پیچیده قوی است و برای اهداف تحقیق این مقاله قابل استفاده است.
۲٫۲٫۱٫ بهبودهایی در ستون فقرات
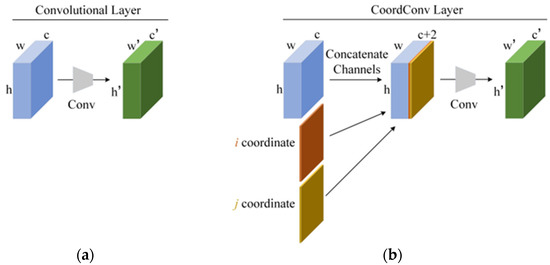
شبکه ستون فقرات YOLOv5 عمدتا از ماژول های Focus، Conv، C3 و هرم فضایی (SPP) تشکیل شده است. در میان این ماژول ها، ماژول Conv ( شکل ۳ الف)، به عنوان یک ماژول کلیدی برای تبدیل دو نمایش فضایی (مختصات مکانی دکارتی (i, j) و مختصات مکانی پیکسل)، دارای نقص است، زیرا مختصات موقعیت خاص در به دست نمی آید. ورودی. ماژول C3 ( شکل ۳ ب) به عنوان یک ماژول کلیدی برای شبکه برای یادگیری ویژگی های بیشتر عمل می کند. از آنجایی که ساختار داخلی مطابق با ویژگیهای تابلوهای فروشگاهی و ویژگیهای تصویر طراحی نشده است، تنها از کانولوشن هسته ۳×۳ برای استخراج ویژگیها استفاده میشود که در نتیجه کسب ویژگی محدود است. وابستگی های جهانی/راه دور بسیاری از وظایف بینایی کامپیوتر را انجام می دهند [ ۴۶]، اما میدان پذیرش محدود پیچیدگی مانع از مدلسازی چنین روابط تعاملی از راه دور میشود. ماژول SPP ( شکل ۳ ج) می تواند میدان دریافتی را تا حد زیادی افزایش دهد و مهم ترین ویژگی های زمینه ای را از هم جدا کند. با این حال، برای اشیاء مستطیلی در این مطالعه، یک پنجره ادغام بیش از حد بزرگ نه تنها مقدار محاسبات را افزایش میدهد، بلکه میتواند اطلاعات نامربوط دیگری را نیز در خود جای دهد. با توجه به مشکلات فوق، ما تحقیقات طراحی ماژول را انجام دادیم.
- (۱)
-
محل توجه
تابلوهای راهنمای فروشگاه ها بیشتر در وسط تصاویر نمای خیابان متمرکز شده اند. به عنوان یک ماژول کلیدی برای تبدیل فضای مختصات، ساختار کانولوشن استاندارد دارای ویژگی های عالی مانند معادل سازی ترجمه، اتصال محلی و اشتراک وزن است. بهعنوان بلوک اصلی مدلهای مختلف، موفقیت زیادی در زمینههای بینایی کامپیوتری مختلف به دست آورده است. برخی از دستاوردهای اخیر در بینایی ماشین بر روی هم قرار دادن تعداد زیادی ساختار کانولوشن متکی است. با این حال، در کار مدلسازی مختصات شی، پیچیدگی عمومی نمیتواند اطلاعات مختصات موقعیت خاصی را به دست آورد، و نمیتواند عملکرد صاف بین فضای دکارت و فضای پیکسل را بیاموزد [ ۴۷ ].
به منظور بهبود اثر کانولوشن و بهبود عملکرد آگاه از مکان، لایه CoordConv [ ۴۷ ] را برای جایگزینی لایه پیچشی در ستون فقرات معرفی میکنیم. یعنی کانال های i- coordinate و j -coordinate به ورودی اضافه می شوند. ساختار دقیق لایه CoordConv در شکل ۴ نشان داده شده است . لایه CoordConv دو ویژگی اصلی لایه کانولوشن را حفظ می کند: پارامترهای کمتر و راندمان محاسباتی بالا. همچنین این قابلیت را دارد که پیکسل های یک تصویر را از طریق یک شبکه تشخیص هدف مشاهده کند و کارایی جعبه مرزی خروجی را در سیستم مختصات دکارتی بهبود بخشد.
- (۲)
-
محدودیت ویژگی مستطیلی
همانطور که در شکل ۱ نشان داده شده است اکثر تابلوهای راهنمای فروشگاه ها به شکل مستطیل های چند مقیاسی هستند . برای درک ویژگی های مستطیلی چند مقیاسی، زمینه مقیاس بیشتری مورد نیاز است. روش های مقیاس شامل پیچیدگی خالی و ادغام جهانی است. اطلاعات متنی ناهمسانگرد به طور گسترده ای در سناریوها وجود دارد، و برای تابلوهای فروشگاهی مستطیلی شکل، استفاده از هسته کانولوشن مربعی برای گرفتن اطلاعات، اطلاعات مناطق نامرتبط را ادغام کرده و انعطاف پذیری را از دست می دهد.
برای به تصویر کشیدن زمینه مقیاس در اطلاعات متنی، ما بهبودهایی را بر اساس ماژول C3 معرفی کردیم و از یک ماژول ادغام نواری (SP) [ ۴۸ ] برای جایگزینی لایه کانولوشن ۳ × ۳ زیرماژول گلوگاه در ماژول C3 استفاده کردیم. همانطور که در شکل ۵ نشان داده شده است ، یک شکل هسته بلند ابتدا در امتداد یک بعد فضایی مستقر شده است. سپس یک شکل هسته باریک در بعد فضایی دیگر حفظ می شود. چنین ساختاری میتواند به ثبت ویژگیهای ساختار باند دوربرد تابلوهای فروشگاه کمک کند و از تداخل مناطق نامرتبط با پیشبینی برچسب جلوگیری کند.
- (۳)
-
بازسازی توپولوژیکی
همانطور که در شکل ۱ نشان داده شده است ، تابلوهای راهنمای فروشگاه ها معمولا در وسط تصاویر نمای خیابان قرار دارند و به راحتی توسط درختان مسدود می شوند و در نتیجه اطلاعات هدف ناقص است. اطلاعات متنی برای یادگیری توپولوژی های قابل اعتماد و پایدار بسیار مهم است، بنابراین باید اطلاعات زمینه ای بیشتری را از نزدیک ترین همسایگان در نظر بگیریم. توجه به خود به طور گسترده در شبکه های عصبی عمیق برای گرفتن همبستگی داخلی ویژگی ها و ایجاد روابط توپولوژیکی صحیح استفاده می شود [ ۴۹ ]. با این حال، مکانیسم سنتی توجه به خود تنها تبادل اطلاعات را در حوزه فضایی انجام می دهد و از اطلاعات زمینه ای غنی بین همسایگان نزدیک غفلت می کند.
با تمرکز بر اطلاعات متنی بین همسایگان، ما بهبودهایی را بر اساس ماژول C3 معرفی کردیم و از یک ماژول ترانسفورماتور متنی (CoT) [ ۴۹ ] برای جایگزینی لایه کانولوشن ۳ × ۳ زیرماژول گلوگاه در ماژول C3 استفاده کردیم. ماژول CoT ( شکل ۶) ابتدا کلیدهای ورودی را با پیچیدگی ۳×۳ رمزگذاری می کند تا نمایش متنی استاتیک ورودی را به دست آورد و سپس کلیدهای کدگذاری شده را با پرس و جوی ورودی متصل می کند. ماتریس پویای توجه چند سر با دو انحراف متوالی ۱×۱ آموخته می شود و ماتریس توجه در مقادیر ورودی ضرب می شود تا نمایش زمینه پویا ورودی به دست آید. خروجی این ماژول حاصل ادغام بیان زمینه ایستا و بیان زمینه پویا است. این ماژول استخراج اطلاعات متنی و یادگیری خودتوجهی را در یک چارچوب یکپارچه ادغام می کند، اطلاعات زمینه ای همسایگان نزدیک را کاوش می کند، روابط توپولوژیکی درستی ایجاد می کند و مشکل تکه تکه شدن شی را تا حدی حل می کند.
- (۴)
-
استخراج اطلاعات در مقیاس چندگانه
با توجه به مسئله چند مقیاسی موضوع تحقیق این مطالعه، یک مدول توجه فشاری هرمی (PSA) [ ۵۰ ] معرفی شده است، همانطور که در شکل ۷ نشان داده شده است.آ. این ماژول جایگزین پیچیدگی ۳×۳ گلوگاه در ماژول C3 می شود و ماژول جدید C3 ماژول C3_P نامیده می شود. با استفاده از ساختار پیچشی هرمی چند مقیاسی برای ادغام اطلاعات نقشه ویژگی ورودی، می توان اطلاعات مکانی مقیاس های مختلف را از نقشه ویژگی هر کانال استخراج کرد. با استخراج وزنهای توجه نقشههای ویژگی چند مقیاسی، تعامل متقاطع تحقق مییابد. از یک سو، اطلاعات مکانی مقیاسهای مختلف برای غنیسازی فضای ویژگی جمعآوری میشود. از سوی دیگر، پیچیدگی گروهی همراه با توجه کانال به استخراج اطلاعات ویژگی های پنهان بیشتر کمک می کند. زیر ماژول گلوگاه در ماژول C3_P همانطور که در شکل ۸ نشان داده شده است طراحی شده است .
ماژول SPP بیشتر یک میدان گیرنده چند مقیاسی را ادغام می کند. در ترکیب با تنوع مقیاس و ویژگی های مستطیلی اشیاء تحقیق، استفاده از یک پنجره ادغام بزرگ، بار محاسباتی را افزایش می دهد و می تواند اطلاعات نامربوط دیگر را ادغام کند. اگر دو لایه ترکیبی با ۳ × ۳ هسته را روی هم قرار دهیم، میدان دریافت موثر ۵×۵ پیکسل است [ ۵۱ ]. به طور مشابه، یک پشته تلفیقی با چهار هسته ۳ × ۳، ۹ × ۹ پیکسل است و یک پشته تلفیقی با شش هسته ۳ × ۳، ۱۳ × ۱۳ پیکسل است. مقدار محاسبه برای یک هسته ۵ × ۵ ۲۵/۹ = ۲٫۷۸ برابر برای یک هسته ۳ × ۳ با همان تعداد فیلتر است. بنابراین، به منظور بهبود عملکرد مقیاس آگاه، یک پشته تلفیقی از هستههای کوچک طراحی شد و ماژول IFSPP پیشنهاد شد، همانطور که در نشان داده شده است.شکل ۹ . علاوه بر کاهش پیچیدگی محاسباتی، ادغام هسته با اندازه کوچک دارای غیرخطی بیشتر (لایههای بیشتر توابع غیرخطی) است که تابع تصمیم را حیاتیتر میکند و به عنوان منظمسازی ضمنی عمل میکند و قابلیت تعمیم مدل را بیشتر بهبود میبخشد.
- (۵)
-
طراحی معماری موازی
عمق بیان شبکه را افزایش می دهد و به یادگیری بیشتر و بیشتر ویژگی های انتزاعی کمک می کند. با این حال، یک شبکه عمیق تر بدون اشکال نیست [ ۵۲]. یک شبکه عمیق تر منجر به پردازش متوالی بیشتر و تاخیر بیشتر می شود که موازی سازی آن را سخت تر می کند و برای برنامه هایی که نیاز به پاسخ سریع دارند مناسب تر است. در رویکرد پیشنهادی، یک شبکه فرعی موازی برای کاهش عمق و حفظ عملکرد بالا با در نظر گرفتن ویژگیهای هندسی و ساختار موقعیتی تابلوهای فروشگاه طراحی شد. ما یک معماری گلوگاه موازی در نمودار ویژگی کم عمق، که در اولین ماژول C3 است، طراحی کردیم و نام این ماژول را ماژول C3_SC گذاشتیم. این نقشه ویژگی موقعیت مکانی دارای وضوح بالاتری است، به طوری که می توان اطلاعات بافتی بیشتر و واضح تری به دست آورد. در نتیجه، اطلاعات ویژگی های مفیدتری را می توان به طور موثر و مناسب استخراج کرد و یک رابطه توپولوژیکی پایدار ایجاد کرد. زیر ماژول گلوگاه در ماژول C3_SC مطابق شکل طراحی شده استشکل ۱۰ .
۲٫۲٫۲٫ بهبود در ناحیه گردن
یک راه اساسی برای به دست آوردن ویژگی های قابل اعتماد، طراحی ساختار ستون فقرات بر اساس ویژگی های هدف تحقیق است. علاوه بر این، هنوز باید از کفایت و دقت استفاده از ویژگی اطمینان حاصل کنیم. ساختار گردن ویژگیهای معنایی، از همجوشی سطح بالا تا سطح پایین را درک میکند و نقشههای ویژگی جدیدی تولید میکند. با این حال، در این فرآیند، اطلاعات مهم ممکن است از دست بروند. با توجه به این موضوع، ما تحقیق زیر را انجام دادیم: تابلوهای فروشگاهی متعلق به اهداف چند مقیاسی هستند و ویژگی های همجوشی چند مقیاسی دقیق پیش نیازی برای به دست آوردن نتایج تشخیص دقیق است. مطالعات نشان داده اند که توجه کانال، توجه فضایی، یا هر دو می توانند به طور قابل توجهی توانایی بازنمایی ویژگی را بهبود بخشند [ ۵۳ ، ۵۴]. بر اساس تحقیق در مورد مکانیسم های توجه توسط Woo et al. [ ۵۵ ]، ما توجه فضایی و کانالی نقشه ویژگی را با هم ترکیب کردیم و آن را مجدد کالیبره کردیم تا تشخیص هرم فعلی را بهبود بخشیم. بنابراین، ما یک ماژول توجه را در هر مرحله از ساختار تجمیع مسیر ادغام میکنیم تا ویژگیهای هرمی را با وزندهی به نقشه ویژگی ذوبشده، تقویت کنیم. ماژول توجه ابتدا وابستگی ویژگی هر لایه از نقشه ویژگی هرم را مدل می کند، بردار اهمیت ویژگی را بیشتر مطالعه می کند، نقشه ویژگی را مجددا کالیبراسیون می کند و بر ویژگی های مفید تأکید می کند. ماژول توجه شامل دو بخش اصلی است: (۱) بلوک توجه کانال (CAB). و (۲) یک بلوک توجه فضایی (SAB) ( شکل ۱۱ ).
- (۱)
-
بلوک توجه کانال
CAB بر تقویت ویژگیها در امتداد کانال هر سطح هرم تمرکز دارد. ابتدا به صراحت وابستگی ویژگی ها را در امتداد کانال مدل می کند و یک توصیفگر خاص کانال را از طریق روش فشرده سازی و تحریک می آموزد. سپس بر کانالهای مفید برای بیان اطلاعات جهانی کارآمدتر نقشههای ویژگی در هر سطح هرم تأکید میکند. CAB را می توان به صورت زیر بیان کرد:
ورودی یک مشخصه F از H × W × C است. ما ابتدا یک ادغام میانگین جهانی و یک ادغام حداکثر در فضا را انجام می دهیم و دو توصیف کانال ۱ × ۱ × C را به دست می آوریم که σ یک واحد خطی اصلاح شده (ReLU) است. عملکرد فعال سازی سپس اینها به یک شبکه عصبی دو لایه وارد می شوند، که تعداد نورون های لایه اول C/r، تابع فعال سازی ReLU، و تعداد نورون ها در لایه دوم C است. این عصبی دو لایه است. شبکه به اشتراک گذاشته شده است سپس ضریب وزنی M C با افزودن دو ویژگی و عبور تابع فعال سازی سیگموئید به دست می آید. در نهایت، ویژگی جدید را می توان با ضرب ضریب وزن در ویژگی اصلی F بدست آورد.
- (۲)
-
بلوک توجه فضایی
مشابه CAB، بلوک توجه فضایی (SAB) ویژگی ها را همراه با مکان فضایی هر سطح هرم افزایش می دهد، که بر پیکسل های موثر تأکید می کند و پیکسل های بی اثر یا کم اثر را سرکوب می کند. فرآیند SAB را می توان به صورت زیر بیان کرد:
با توجه به یک مشخصه F از H × W × C، ابتدا استخر و حداکثر بعد کانال را به طور میانگین جمع می کنیم تا دو توصیف کانال H × W × ۱ را به دست آوریم و سپس آنها را به هم وصل می کنیم. سپس، از طریق یک لایه کانولوشن ۷ × ۷، σ تابع فعال سازی سیگموئید است و ضریب وزنی M S به دست می آید. در نهایت، ویژگی جدید را می توان با ضرب ضریب وزن و ویژگی F به دست آورد.
به طور خلاصه، تمرکز ماژول توجه کانال یادگیری اطلاعات کانال از ترکیب ویژگی های ناهمگن است و تمرکز ماژول توجه فضایی یادگیری اطلاعات مکانی از ترکیب ویژگی ها است. این بهبود ویژگی مبتنی بر توجه میتواند بهطور خودکار اهمیت سطوح مختلف ویژگیها را بررسی کند، به طور موثر مناطق ناهمگن را در ابعاد کانال ادغام کند، و اهمیت هر موقعیت پیکسل را در ابعاد فضایی برای نزدیکتر شدن به منطقه مورد نظر دوباره تنظیم کند. بنابراین، از قضاوت نادرست ناشی از تاری ویژگی جلوگیری می کند و توانایی ماژول تشخیص را برای تشخیص تابلوهای فروشگاه و پس زمینه بهبود می بخشد.
۳٫ نتایج
۳٫۱٫ راه اندازی آزمایشی
۳٫۱٫۱٫ تولید مجموعه داده
تا جایی که نویسندگان می دانند، هیچ مجموعه داده عمومی برای تشخیص تابلوهای فروشگاهی وجود ندارد. حتی مجموعه داده چینی Text in Wild (CTW) [ ۵۶ ] هیچ نمونه ای از برچسب گذاری تابلوهای فروشگاهی ندارد. به منظور تأیید عملکرد و استحکام الگوریتم پیشنهادی، ما دو مجموعه داده را برای ارزیابی روش توضیح دادیم. تصاویر منتخب نمای خیابان از دو منبع داده بدست آمدند: CTW [ ۵۶] و بایدو. تصاویر نمای خیابان CTW عمدتاً از داده های تصویر نمای خیابان Tsinghua Tencent 100k و Tencent تشکیل شده است. نمای خیابان Baidu عمدتاً بر اساس داده های تصویری است که از اینترنت خزیده شده است. تصاویر نمای خیابان دو منبع داده، مناطق وسیعی را در مناطق مختلف با وضوح تصویر متفاوت پوشش میدهند، و هر دو مجموعه داده شامل صحنههایی با شرایط نوری متعدد، درجات متعدد انسداد و همپوشانی هدف هستند.
به منظور آموزش یک مدل قوی تر با استفاده از مجموعه داده های کوچک به دست آمده از شرایط محیطی پیچیده، از روش برچسب گذاری آنچه می بینید (LWYS) [ ۵۷ ] برای برچسب گذاری استفاده شد و تنها اهداف تصویربرداری نمای جلو در نظر گرفته شد، تا موارد تشخیص اشتباه و تشخیص نادرست را کاهش دهید. ما ۶۴۷ تصویر نمای خیابان CTW را انتخاب کردیم. تابلوهای فروشگاهی طبق استانداردهای ذکر شده در بخش ۲ به سه دسته تقسیم شدند-۱٫ در مجموع ۲۹۹۵ هدف با استفاده از LWYS مشخص شدند که نسبت هدف تابلوهای فروشگاه بدون انسداد، تابلوهای فروشگاه با انسداد جزئی و تابلوهای فروشگاه با انسداد سنگین ۱:۲:۲ بود. نیازی به در نظر گرفتن طبقه بندی در کار تشخیص واقعی نیست، اما آموزش چند طبقه بندی می تواند تابلوهای فروشگاه و پس زمینه را تا حد زیادی از هم جدا کند. بنابراین، هنگامی که ما دقت را ارزیابی می کنیم، اهداف شناسایی شده را با توجه به الزامات وظیفه واقعی، به عنوان مثال، تابلوهای راهنما ذخیره می کنیم.
تولید یک مدل تشخیص هدف مبتنی بر یادگیری عمیق بر اساس آموزش با حجم زیادی از داده های تصویری محقق می شود. بنابراین، تصاویر نمای خیابان ۶۴۷ CTW نیاز به بهبود داشتند و یک تصویر اصلی به ۴ ارتقا یافت. روش های بهبود تصویر شامل افزایش و کاهش روشنایی تصویر، آینه کاری افقی، بزرگنمایی، ترجمه و غیره بود. علاوه بر این، در فرآیند گرفتن تصویر، تکان دادن دستگاه اکتساب یا شاخه های درخت می تواند باعث تار شدن تصویر شود، بنابراین ما یک فیلتر گاوسی برای شبیه سازی این نوع پدیده تاری اضافه کردیم. به منظور افزایش تنوع تصاویر ورودی و استحکام بیشتر مدل نسبت به تصاویر به دست آمده در محیط های مختلف، ۲۴۱ تصویر از بین تصاویر نمای خیابان CTW همزمان با تصاویر اصلی برش داده شد و آموزش داده شد.
ما از داده های تصویر CTW برچسب دار برای انجام آموزش استفاده کردیم. پس از بهبود داده ها، کتابخانه نمونه از ۳۶۳۷ تصویر نمای خیابان، شامل ۱۳۲۴۴ شی تابلوی فروشگاه تشکیل شد. اندازه های تصویر شامل ۲۰۴۸ × ۲۰۴۸ و ۱۲۰۰ × ۱۰۲۴ بود و نسبت مجموعه آموزشی، مجموعه تأیید و مجموعه تست ۸:۱:۱ بود. به منظور بررسی قابلیت تعمیم مدل، از ۳۰۰ تصویر نمای خیابان بایدو در اندازه های مختلف برای ارزیابی دقت مدل، از جمله ۱۶۴۳ تابلوی فروشگاه استفاده شد.
۳٫۱٫۲٫ آموزش شبکه
آزمایشها بر روی یک رایانه Dell با پردازنده Core (TM) i7-9700 @ 3.00 گیگاهرتز، ۲۸ گیگابایت رم و یک پردازنده گرافیکی NVIDIA GeForce RTX 2060 انجام شد. چارچوب یادگیری عمیق PyTorch در ویندوز ۱۰ اجرا شد و کد برنامه به زبان پایتون نوشته شد. کتابخانه های CUDA، CuDNN، OpenCV و دیگر کتابخانه ها برای آموزش و آزمایش مدل های تشخیص هدف استفاده شدند.
از آنجایی که اندازه ورودی مورد نیاز برای شبکه YOLOv5 ثابت است، اندازه تصویر را به اندازه یکنواخت ۶۴۰ × ۶۴۰ تنظیم کردیم. لایه (BN). مومنتوم روی ۰٫۹۳۷ و نرخ کاهش وزن روی ۰٫۰۰۰۵ تنظیم شد. تعداد جلسات تمرین ۵۰۰ جلسه تعیین شد و پس از پایان آموزش فایل وزن مدل تشخیص ذخیره شد و عملکرد مدل با استفاده از مجموعه تست مورد ارزیابی قرار گرفت.
۳٫۱٫۳٫ شاخص های ارزیابی
در این مقاله، عملکرد مدل بر روی مجموعههای داده مختلف با استفاده از دقت، یادآوری، تقاطع روی اتحاد (IoU)، امتیاز F1 و دقت متوسط (AP) ارزیابی میشود. فرمول این شاخص ها به شرح زیر است. IoU به عنوان منطقه تقاطع پیش بینی و حقیقت زمین تقسیم بر مساحت مجموعه اتحادیه تعریف می شود. AP میانگین تقاطع مقادیر ۱۰ IoU را با آستانه ۰٫۵۰ تا ۰٫۹۵ و اندازه گام ۰٫۰۵ محاسبه می کند.
که در آن TP ، FP ، TN ، و FN به ترتیب پیکسل های مثبت واقعی، مثبت کاذب، منفی درست و منفی کاذب را نشان می دهند. امتیاز F1 برای مبادله فراخوانی و دقت برای نشان دادن عملکرد کلی مدل آموزش دیده استفاده می شود و AP برای نشان دادن عملکرد کلی مدل تحت آستانه های اطمینان مختلف استفاده می شود.
بر اساس شاخصهای ارزیابی بالا، ما یک معیار ارزیابی جدید را پیشنهاد میکنیم تا قضاوت کنیم که آیا چارچوب پیشبینی فعلی با محدود کردن حداقل مقدار ناحیه همپوشانی با مقدار واقعی، معیارهای تشخیص کار واقعی را برآورده میکند یا خیر. در کار تشخیص تابلوی فروشگاه واقعی، اگر دقت طبق استاندارد ارزیابی تشخیص هدف موجود محاسبه شود، یعنی دقت با توجه به پیکسل های همپوشانی بدون محدودیت محاسبه شود، با پیش بینی واقعی مطابقت ندارد. به عنوان مثال، اگر چارچوب پیشبینی فقط ۵۰ تا ۶۰ درصد با مقدار واقعی همپوشانی داشته باشد [ ۵۸]، پس نباید این چارچوب پیش بینی را در کار واقعی به عنوان صحیح طبقه بندی کنیم. بنابراین، با محدود کردن ناحیه همپوشانی بین قاب پیشبینی و مقدار واقعی طبق مقررات دپارتمان مربوطه، درست بودن یا نبودن چارچوب پیشبینی فعلی را تعیین میکنیم.
که در آن S pre ناحیه همپوشانی است، S pre ناحیه پیش بینی، S true ناحیه زمین-حقیقت است، و t آستانه دو نسبت است (یکی منطقه همپوشانی به ناحیه پیش بینی، و دیگری منطقه همپوشانی به منطقه حقیقت زمین). مقدار آستانه را روی ۰٫۸ قرار دادیم که برای تعیین صحیح قاب پیشبینی فعلی استفاده شد. چنین معیار ارزیابی از یک طرف دقت تشخیص تابلوهای فروشگاهی را تضمین می کند و از طرف دیگر شباهت چارچوب پیش بینی به مقدار واقعی را کاملاً در نظر می گیرد که در اصل منطقی تر است.
۳٫۱٫۴٫ انتخاب روش مقایسه
برای نشان دادن اثربخشی روش پیشنهادی برای تشخیص تابلوهای فروشگاه، روش را روی مجموعه داده CTW خود برچسبگذاری شده و مجموعه داده نمای خیابان Baidu خود برچسبگذاری شده ارزیابی کردیم و آن را به صورت کمی با روشهای مورد استفاده در [ ۳۹ ]، EfficientDet_d0 مقایسه کردیم. [ ۵۹ ]، R-CNN_resnet50 سریعتر [ ۶۰ ]، YOLOX_s [ ۶۱ ]، YOLOv4 [ ۶۲ ] و YOLOv5_l. مطالعه یوان و همکاران. [ ۵۶ ] متن روی تابلوهای فروشگاهی را هدف گرفته بود که با موضوع تحقیق ما سازگاری ندارد. مطالعه لیو و همکاران. [ ۶۳] با هدف تابلوهای تبلیغاتی غیرقانونی در معابر و وسط پیاده رو بود، بنابراین باز هم تفاوت اساسی بین این دو کار وجود دارد. بنابراین، روش های ارائه شده در این دو مقاله نمی توانند به عنوان روش های تجربی مقایسه ای مورد استفاده قرار گیرند. در مطالعه موررا و همکاران. [ ۳۹ ]، SSD [ ۵۱ ] و YOLOv3 [ ۶۴ ] به عنوان روش های مقایسه مورد استفاده قرار گرفتند، بنابراین این دو الگوریتم برای مقایسه تجربی در این مقاله انتخاب شدند. روشهای مقایسه شامل طبقهبندیکنندههای یکمرحلهای و طبقهبندیکننده دو مرحلهای، و همچنین چندین نسخه از خانواده you only look one (YOLO) بود. YOLOv5_l اساس مدل بهبود یافته ارائه شده در این مقاله است.
۳٫۲٫ نتایج تجربی و تجزیه و تحلیل
۳٫۲٫۱٫ نتایج تجربی تطبیقی و تجزیه و تحلیل
نتایج ارزیابی کمی در جدول ۲ و جدول ۳ فهرست شده است. بهترین نتایج با خط پررنگ مشخص شده و دومین نتایج برتر زیر آنها خط کشیده شده است.
جدول ۲ نشان می دهد که روش پیشنهادی بالاترین امتیازات را برای هر پنج معیار در مجموعه داده CTW خود برچسب دار به دست می آورد، که نشان می دهد الگوریتم پیشنهادی می تواند تعادل بین دقت و یادآوری را حفظ کند. نمرات دقت و یادآوری مربوطه به ترتیب ۸۲٫۷% و ۸۷٫۶% می باشد که نشان می دهد ۸۲٫۷% از عناصر شناسایی شده تابلوهای فروشگاه در تصاویر آزمایشی هستند و ۸۷٫۶% از کل عناصر تابلوی فروشگاه در تصاویر به درستی شناسایی شده اند. امتیاز F1 روش پیشنهادی ۸۲٫۴ درصد است که ۶٫۰-۳۳٫۸ درصد بیشتر از روش های دیگر است که نشان دهنده برتری روش پیشنهادی است. IoU روش پیشنهادی ۷۸٫۱ درصد است که ۱۶٫۳ درصد بیشتر از YOLOv5_l رتبه دوم است. نتایج کمی نشان میدهد که روشهای YOLOv3 و SSD شرح داده شده در [ ۳۹] نمی تواند وظیفه تشخیص این مقاله را تکمیل کند. علاوه بر این، روش بهبودیافته ما در مقایسه با YOLOv5_l اصلی، نرخ فراخوان را تا ۷٫۵ درصد و دقت را ۱٫۹ درصد بهبود میبخشد، که نشان میدهد تابلوهای راهنمای فروشگاههای بیشتری در نتایج روش ما نسبت به روش اصلی YOLOv5_l با موفقیت شناسایی شدند.
برای آزمایش بیشتر عملکرد مدل پیشنهادی تحت منابع دادههای مختلف، آزمایشهایی را نیز بر روی مجموعه داده نمای خیابان بایدو انجام دادیم. مجموعه داده مشروح Baidu شامل ۳۰۰ تصویر نمای خیابان بود و مانند مجموعه داده CTW، شامل صحنههایی با پیچیدگیهای مختلف بود، با این تفاوت که اندازههای تصویر متفاوت بود. از جدول ۳ ، مشخص است که روش پیشنهادی از نظر دقت، یادآوری، امتیاز F1، IoU و AP در رتبه اول قرار دارد. امتیاز AP روش پیشنهادی ۱۶٫۴-۳۰٫۰ درصد بیشتر از روش های دیگر است و IoU 10.7-34.6 درصد بیشتر از روش های دیگر است. امتیاز کلی YOLOv5_l پایین است، اما دقت روشهای YOLOv3 و SSD مورد استفاده در [ ۳۹] نیز در مجموعه داده جدید کاهش می یابد، که نشان می دهد ما توانایی تعمیم مدل را بهبود بخشیده ایم.
شکل ۱۲ چهار نتیجه بصری را برای روشهای آزمایش شده در مجموعه داده CTW خود برچسبگذاری شده نشان میدهد، از جمله صحنههایی با شرایط نوری مختلف و سطوح انسداد متفاوت. حدود ۰٫۲۲ ثانیه طول کشید تا با استفاده از OSO-YOLOv5 پیشنهادی، ۲۰۴۸ × ۲۰۴۸ پیکسل برای هر تصویر آزمایشی استنتاج شود. کل تصویر دارای نه سطر و چهار ستون است. ستون ها تصاویر چهار نمونه معرف از مجموعه داده آزمایشی و نتایج تشخیص روش های مختلف هستند. سطرها حاوی تصاویر برچسبگذاری شده و نقشههای پیشبینی تولید شده توسط هشت روش تست هستند. کادر زرد رنگ در هر یک از این تصاویر یک ناحیه بزرگنمایی شده محلی را نشان می دهد.
همانطور که در شکل ۱۲ مشاهده می شود ، بزرگترین مشکل برای تشخیص خودکار در مجموعه داده CTW این است که تابلوهای فروشگاه در تصاویر توسط درختان پوشیده شده و در نتیجه مرزهای تار یا حتی غیرقابل مشاهده ایجاد می شود. در مقایسه با سایر روش های آزمایش شده، الگوریتم پیشنهادی کمتر تحت تأثیر قرار می گیرد. در شکل ۱۲ ، ستون اول پلات، تابلوهای فروشگاهی در مقیاس بزرگ را بدون انسداد نشان می دهد، و ستون های دوم تا چهارم، تابلوهای فروشگاه را با درجات انسداد فزاینده نشان می دهد، یعنی استخراج خودکار آنها روز به روز دشوارتر است. برای تابلوهای فروشگاهی در مقیاس بزرگ بدون مانع نشان داده شده در ستون اول شکل، روش ما، دو روش مورد استفاده در [ ۳۹]، و چهار روش دیگر می توانند نتایج استخراج کامل را به دست آورند، به جز YOLOv5. با این حال، این روش ها در مورد انسداد عملکرد متفاوتی دارند. همانطور که از نمودار ستون دوم مشاهده می شود، تنها روش پیشنهادی، EfficientDet و YOLOX می توانند تابلوهای فروشگاه در مقیاس کوچک و نیمه مسدود شده را استخراج کنند، اما مرزهای استخراج شده توسط EfficientDet و YOLOX چندان دقیق نیستند. برای تابلوهای فروشگاهی به شدت مسدود شده نشان داده شده در نمودارهای ستون سوم و چهارم، نتایج استخراج شده از روش پیشنهادی در مقایسه با سایر الگوریتمهای آزمایششده، مطابقت بیشتری با مناطق تابلوی فروشگاه واقعی در تصاویر دارد، که نشان میدهد تابلوی فروشگاه OSO-YOLOv5 شبکه استخراج پیشنهاد شده در این مقاله میتواند به طور موثری دقت تشخیص را بهبود بخشد و تأثیر انسداد را بر استخراج تابلوهای فروشگاه از بین ببرد.۳۹ ] برای تشخیص علائم ایستگاه اتوبوس خوب هستند، اما برای تابلوهای فروشگاهی که در این مقاله مورد بررسی قرار گرفته اند، چندان خوب نیستند. به طور کلی، میتوان نتیجه گرفت که روش پیشنهادی میتواند اطلاعات چند مقیاسی را درک کند، قسمتهای مسدود شده را از طریق اطلاعات متنی استنتاج کند و دقت تشخیص بالاتری را به دست آورد.
۳٫۲٫۲٫ نتایج و تجزیه و تحلیل برای آزمایش های ابلیشن
آزمایشهای مقایسهای اثربخشی روش پیشنهادی را در شرایط پیچیده مانند تابلوهای فروشگاه در شرایط انسداد سایه/درخت و تابلوهای فروشگاه چند مقیاسی نشان دادند. در مقایسه با الگوریتم اصلی YOLOv5_l، روش پیشنهادی امتیاز F1 را ۶٫۰٪ و IoU را ۱۶٫۳٪ در مجموعه داده CTW بهبود می بخشد. از آنجایی که چارچوب طراحی شده یک چارچوب چندوظیفه ای است، بهینه سازی ماژول های فردی لزوماً بهبود عملکرد مدل را تضمین نمی کند. بنابراین، ما آزمایشهای فرسایشی گستردهای را برای بررسی تأثیر هر یک از ماژولهای روش پیشنهادی انجام دادیم. ما همچنین پیشرفتهای حاصل از ترکیب همه ماژولها را نشان میدهیم تا نشان دهیم که این اجزای ترکیبی همه مکمل یکدیگر هستند.
مجموعه داده ها و شاخص های ارزیابی انتخاب شده برای آزمایش های شرح داده شده در این بخش مانند بخش ۳٫۲٫۱ است. نتایج ارزیابی کمی در شکل ۱۳ نشان داده شده است.
همانطور که از شکل ۱۳ مشاهده می شودa،b، هر خط یک معیار ارزیابی را نشان می دهد، و دقت، یادآوری، امتیاز F1 و IoU به طور کلی روند افزایشی را با اضافه شدن ماژول های مختلف نشان می دهد. از مشاهدات عمودی در شکل، میتوان به وضوح مشاهده کرد که روش ادغام همه ماژولها بالاترین امتیاز را در هر چهار معیار به دست میآورد. بر این اساس، میتوان نتیجه گرفت که ادغام ماژولهای مختلف منجر به بهبود خاصی در دقت تشخیص میشود، اما ترکیب همه ماژولها منجر به بالاترین دقت تشخیص میشود. معرفی یک ماژول منفرد منجر به درجات مختلف بهبود در مقادیر دقت یا یادآوری می شود. این یافتهها برای نشان دادن این نکته کافی است که ماژولهای مختلف استخراج ویژگیهای مستطیلی چند مقیاسی در وسط تصاویر را بهبود میبخشند و مشکل تکه تکه شدن هدف را حل میکنند. تا حدی این نتایج همچنین نشان میدهد که اجزا مکمل یکدیگر هستند و عملکرد YOLOv5_l اصلی را از دیدگاههای مختلف بهبود میبخشند.
۴٫ نتیجه گیری
با عناصر زیاد، ساختارهای پیچیده و تغییرات پویا در سیستمهای شهری، استخراج سریع و دقیق تابلوهای فروشگاهی از تصاویر نمای خیابان به یک نقطه تحقیقاتی کلیدی برای مدیریت هوشمند اجزای شهری تبدیل شده است. استخراج نادرست اطلاعات تابلوی فروشگاه مشکل اصلی روش های اصلی تشخیص هدف است. در این مطالعه، ما به طور کامل ویژگیهای هر نوع تابلوی فروشگاهی را در نظر گرفتیم، از تداخل متقابل بین انواع تابلوهای فروشگاهی جلوگیری کردیم، آموزش مدل تولید و استخراج نمونه را بسیار دشوارتر کردیم، و سپس یک محدودیت ویژگی مستطیلی، یکپارچهسازی مکان را پیشنهاد کردیم. توجه و بازسازی توپولوژی در شبکه OSO-YOLOv5، برای حل مشکل تشخیص هوشمند تابلوهای فروشگاه در صحنه های پیچیده واقعی.
این چارچوب، گردش کار چند مرحلهای سنتی را به یک معماری یادگیری عمیق پایان به انتها برای نظارت نیمه خودکار بر اجزای شهری تبدیل میکند. گردش کار کلی روش پیشنهادی بر اساس ساختار اصلی ستون فقرات + گردن YOLOv5 است. ستون فقرات بهبود یافته برای بهبود درک ویژگیهای مستطیلی چند مقیاسی و درک مختصات استفاده میشود، و همچنین ساختار روابط توپولوژیکی را افزایش میدهد. گردن بهبود یافته برای افزایش قابلیت بیان ویژگی استفاده می شود. در زمینه ساخت شهر هوشمند، ما معتقدیم که این روش پتانسیل زیادی برای کاربرد در نقشه برداری و به روز رسانی سناریوها خواهد داشت. ما همچنین معتقدیم که این تحقیق گلوگاه فنی تشخیص اطلاعات شهری را می شکند، و می تواند برای ارتقای توسعه با کیفیت بالا شهرها مورد استفاده قرار گیرد. به طور خاص، این مطالعه را می توان به کشف بیلبوردهای غیرقانونی تعمیم داد. همچنین هدف ما این است که روی تطبیق نام مکان ها و آدرس ها کار بیشتری انجام دهیم. تابلوهای راهنما شناسایی شده در این تحقیق را می توان به عنوان داده های POI در نظر گرفت و هنگامی که با فناوری OCR ترکیب می شود، می توان از این اطلاعات برای اختصاص ویژگی های مربوط به نام فروشگاه به هر نقطه مورد علاقه استفاده کرد تا تطابق نام مکان ها و آدرس ها را درک کند.
ما تصاویر نمای خیابان را در مجموعه داده عمومی CTW غربال کردیم، مدل را آموزش دادیم و سپس توانایی تعمیم مدل را با تصاویر نمای خیابان از منبع داده بایدو آزمایش کردیم. نتایج ارزیابی کمی بهدستآمده در هر دو مجموعه داده نشان داد که روش پیشنهادی از دقت بالاتری برخوردار است. روش پیشنهادی همچنین دقت محلی سازی بالاتری را در مورد توزیع متمرکز و آرایش فشرده اهداف نشان داد. این روش همچنین می تواند عملکرد را در موارد پیچیده ای که اهداف دارای تنوع مقیاس هستند یا مسدود شده اند، بیشتر بهبود بخشد. در واقع محدودیتهایی برای این تحقیق وجود دارد، مانند: (۱) الگوریتم فعلی به دستگاه نسبتاً سطح بالایی نیاز دارد، بنابراین ما نیاز به توسعه یک مدل سبک وزن داریم که بتواند مستقیماً روی تلفن همراه مستقر شود. (۲) الگوریتم باید در مورد یک پسزمینه یکنواخت و طرحبندی تابلوی فروشگاه بدون مرز، که یک «چشمانداز چینی» معمولی است، بیشتر بررسی شود. (۳) الگوریتم فعلی تأثیر خوبی در تشخیص تابلوهای فروشگاه در نمای جلویی دارد، اما دقت تشخیص تابلوهای فروشگاه در تصاویر گرفته شده با زاویه رضایت بخش نیست.
در کار آینده خود، قصد داریم چارچوب را از طریق جنبه های زیر بهبود دهیم: (۱) معرفی مدل های سبک وزن به ستون فقرات یا ماژول تشخیص. (۲) بهینه سازی بیشتر یادگیری بومی سازی، مانند طراحی تابع از دست دادن مرزی جدید. و (۳) معرفی اطلاعات ذخیره بیشتر و ایجاد یک نمودار دانش، که در نهایت با ترکیب تکنیک های تشخیص شی در بینایی کامپیوتر با یک نمودار دانش، به دقت تشخیص بهبود یافته ای دست خواهد یافت.