۱٫ مقدمه
نمودار دانش (KG) شامل توصیفات غنی از مفاهیم، اشیاء/مکان ها، رویدادها و روابط آنها در دنیای فیزیکی در قالب نمادها است. همانطور که در شکل ۱ نشان داده شده استبه عنوان مثال، سه قلو <دریای ایونی، خروجی، دریای مدیترانه>. نمودار دانش جغرافیایی (GeoKG) ابزار مناسبی در زمینه جغرافیا برای توصیف دانش جغرافیایی، به تصویر کشیدن روابط بین اشیاء و بیان اطلاعات جغرافیایی فراهم می کند. در میان اجزای یک GeoKG، یک موجودیت جغرافیایی (از اینجا به بعد) یک شی با مفهوم مکان را در دنیای واقعی نشان می دهد. یک رابطه جغرافیایی (روابط جغرافیایی از این پس) به رابطه بین موجودات جغرافیایی و موجودات مرتبط اشاره دارد که عمدتاً شامل رابطه فضایی (مثلاً مجاورت فضایی، جدایی، جهت گیری و رابطه شمولیت) و معنایی آنها (مثلاً نوع، جزء) است. رابطه [ ۱]. حجم وسیعی از اطلاعات معنایی جغرافیایی موجود در اینترنت، تحقیقات مرتبط با GeoKG، از جمله استخراج اطلاعات جغرافیایی [ ۲ ]، ادغام اطلاعات جغرافیایی [ ۳ ]، ساخت و ساز GeoKG [ ۴ ، ۵ ] و استدلال GeoKG [ ۶ ] را ترویج می کند.]. موجودیتها و روابط با کیفیت بالا پیش نیازهای مهمی برای محاسبه و استدلال هوشمند مبتنی بر KG هستند، مانند شبکههای کانولوشنال کالیبراسیون مجدد برای یادگیری تعبیه KG، یادگیری تعبیه KG با شبکههای توجه رابطه ناهمگن، و شبکههای کانولوشنال پویا چند مقیاسی برای تعبیه KG. با این حال، با توجه به محدودیتهای معناشناسی مبهم، انواع سبکها و ساختار ناقص عبارات زبان طبیعی، پایگاههای دانش مرتبط با جغرافیا (به عنوان مثال، DBpedia [ ۷ ]، Ownthink، OSM [ ۸ ]، و Geonames [ ۹ ]]) نه تنها شامل موجودیت های جغرافیایی عظیم هستند، بلکه دارای روابط نهادی پراکنده هستند و به طور کلی داده های گم شده ای دارند. این منجر به یک ساختار رابطه ناقص، اطلاعات نادرست یا به موقع بودن ضعیف می شود که به طور جدی بر استدلال و محاسبات هوشمند GeoKG حاصل تأثیر می گذارد [ ۱۰ ]. از این رو، تکمیل روابط جغرافیایی به چالش اصلی تحقیقات GeoKG تبدیل شده است.
تکمیل روابط جغرافیایی با پیشبینی رابطه در GeoKG محقق میشود. به عنوان مثال، به دست آوردن مقدار “r” در سه گانه <دریای ایونی، r، دریای مدیترانه> از طریق مدل سازی پیش بینی رابطه، یا پیش بینی مقدار “h” در <h، خروجی، دریای مدیترانه> یا مقدار “t” ” در <دریای ایونی، خروجی، t>. روشهای پیشبینی رابطه موجود شامل روشهای استنتاج مبتنی بر استدلال قیاسی، استدلال استقرایی و یادگیری بازنمایی است. روشهای مبتنی بر استدلال قیاسی [ ۱۱] برای تکمیل رابطه «حاوی» بین دسته استان و شهر، نیاز به اطلاعات قبلی کاملاً تعریف شده، مانند تعریف قوانین بدیهی (استان، شامل، شهر) و (کشور، شامل، استان) و سپس (استان، شامل، شهر) است. موجودیت های موجود در یک KG این نوع روش دارای دقت بالا و همچنین هزینه کار بالا است. روشهای مبتنی بر استدلال استقرایی [ ۱۲] می تواند به طور موثر قوانین بدیهی را با اطمینان بالا از KGهای مقیاس بزرگ استخراج کند، که هزینه تعریف دستی قوانین را تا حد معینی کاهش می دهد و همچنین خطاهای ذهنی بالقوه ایجاد شده توسط قانون گذاران را حذف می کند. با این حال، اعمال این دو نوع روش برای GeoKG های باز که دارای مقیاس بزرگی از داده ها و بسیاری از انواع روابط هستند، دشوار است. روش استدلال مبتنی بر یادگیری بازنمایی میتواند موجودیتها و روابط موجود در یک KG را به فضای برداری ترسیم کند و مسئله پیشبینی روابط جغرافیایی را به محاسبه مستقیم بین بردارها تبدیل کند، که امکان تکمیل روابط بیشتر را در یک KG در مقیاس بزرگ فراهم میکند. .
روش استدلال مبتنی بر یادگیری بازنمایی به یک کانون تحقیقاتی در محاسبات هوشمند و تکمیل رابطه برای KGهای مقیاس بزرگ تبدیل شده است، این روش عمدتاً شامل روش مبتنی بر فاصله، روش مبتنی بر تطبیق معنایی و روش شبکه عصبی است. روش مبتنی بر فاصله (به عنوان مثال، TransE [ ۱۳ ]، TranR [ ۱۴ ]، TransD [ ۱۵ ]) موجودیتهای جغرافیایی و روابط جغرافیایی را در فضای برداری با ابعاد پایین نگاشت میکند و روابط را به عنوان عملیات ترجمه از موجودیتهای سر به موجودیتهای دنباله در نظر میگیرد. در فضای برداری، به طوری که h +r ≈ t. روش مبتنی بر تطابق معنایی (به عنوان مثال، RESCAL [ ۱۶ ]، DisMult [ ۱۷ ]]) از بردارها برای نشان دادن موجودیت ها و ماتریس ها برای نمایش روابط آنها استفاده می کند. تعامل درونی سه قلوها توسط یک تابع امتیازدهی خود تعریف شده، همانطور که در رابطه (۱۲) نشان داده شده است، نشان داده می شود. روش شبکه عصبی (به عنوان مثال، ProjE [ ۱۸ ]، GNN [ ۱۹ ]، R-GCN [ ۲۰ ]) بیان برداری موجودیت های جدید را با استفاده از موجودیت ها و روابط مرتبط با کمک مدل های شبکه عصبی می آموزد. هدف همه روشهای فوق استخراج ویژگیهای موجودیتهای جغرافیایی و روابط از یک GeoKG موجود است. با این حال، روابط اغلب آنقدر پراکنده هستند که دادههای نمونه نمیتوانند ویژگیهای کافی و جامعی از موجودیتها و روابط جغرافیایی در GeoKGهای مقیاس بزرگ ارائه دهند.
بنابراین، تعداد فزایندهای از محققین دریافتهاند که روشهای فوقالذکر برای استخراج ویژگیهای ساختاری داخلی نمیتوانند با اطلاعات ساختاری ناقص در KG پراکنده مقابله کنند. استفاده از اطلاعات خارجی برای تقویت معنایی موجودیت ها یا روابط، یا مداخله یادگیری ممکن است بیان برداری بهبود یافته موجودیت ها و روابط را ارتقا دهد. TKRL [ ۲۱ ] بیان می کند که انواع مختلف موجودیت ها باید عبارات برداری متفاوتی داشته باشند، بنابراین اطلاعات نوع موجودیت ها به عنوان یک محدودیت اضافه می شود، نوع سلسله مراتبی به عنوان ماتریس طرح ریزی موجودیت ها در نظر گرفته می شود، و از روش مبتنی بر فاصله برای مدل سازی استفاده می شود. انواع مختلف موجودیت TransEA [ ۲۲] بیان می کند که ویژگی های موجودیت به بهینه سازی بیان برداری موجودیت ها کمک می کند. بر اساس استفاده از مدل فاصله برای مدل سازی ساختار سه گانه در بدنه داده ها، از مدل رگرسیون خطی برای مدل سازی ویژگی های کمی موجودیت ها استفاده می شود. DKRL [ ۲۳ ] بیان میکند که موجودیتهای مشابه توصیفهای مشابهی دارند و از یک شبکه کانولوشن برای رمزگذاری اطلاعات توصیف و ادغام آن در یک مدل مبتنی بر فاصله استفاده میکند. تمامی روش های فوق بدون تغییر در ساختار داده های نمونه، بیان کمی موجودیت ها و روابط آنها را با افزایش اطلاعات معنایی خارجی بهینه می کنند. این امر تا حدی بر مشکل پراکنده بودن موجودیت ها و روابط در مجموعه داده های نمونه غلبه می کند.
با این حال، این روش ها مشکلات زیر را دارند:
-
اگرچه روشهای TransE، DisMult، ProjE و سایر روشها میتوانند ویژگیهای موجودیتها، تبدیل رابطه و ساختار نمودار را بیاموزند، موجودیتهای جغرافیایی و روابط جغرافیایی در مجموعه داده GeoKG اغلب دارای ویژگیهای توزیع نامتعادل مشهودی هستند که منجر به مدل شدن میشود. اگر در طول فرآیند یادگیری یک ارتباط رابطه ای صریح نداشته باشند، قادر به دستیابی به ویژگی های مرتبط کافی نیستند، اما در واقع، بسیاری از موجودیت ها با یکدیگر رابطه ضمنی دارند.
-
روشهایی که اطلاعات خارجی را اضافه میکنند (انواع موجودیت، ویژگیهای موجودیت، توضیحات متنی موجودیتها) تنها میتوانند جاسازی موجودیتهای جغرافیایی را از لحاظ نظری بهبود بخشند، مشخص نیست کدام اطلاعات خارجی میتواند بدون اطلاعات معتبر انتخابشده، جاسازی را بهتر یا بدتر کند، و چنین روشهایی هنوز افزایش پیچیدگی و کاهش کارایی یادگیری.
برای پرداختن به مشکلات فوق، یک روش پیشبینی روابط جغرافیایی مبتنی بر شبکههای تقویتشده شباهت چند لایه (MSEN-GRP) پیشنهاد شده است که دارای یک تقویتکننده، رمزگذار و رمزگشا برای کاهش مشکلات ناشی از اتصالات روابط پراکنده بین موجودیتها است. مجموعه GeoKG. این روش دارای مزایای زیر است: (۱) با محاسبه شباهت چند سطحی ژئو موجودیتها، تقویتکننده میتواند به صراحت روابط شباهت چند سطحی بین موجودیتهای جغرافیایی را تا حد معینی حفظ کند، که ارتباط موجودیتها را در ژئو موجودیتها افزایش میدهد. مجموعه داده های آموزشی و همچنین افزایش معناشناسی موثر را در نظر می گیرد. (۲) در رمزگذار، نسبتهای نمونهگیری مختلف را میتوان برای تحقق فرآیند یادگیری شیمی برداری از موجودیتهای جغرافیایی استفاده کرد. تداخل اضافه را حذف کنید و بخش معنایی را تقویت کنید و به جاسازی معنایی بهینه بهبود یافته پی ببرید. علاوه بر این، روش جمعآوری ویژگی مسیر بهتر میتواند ویژگیهای وابستگی مسیر طولانی را بین موجودیتها در KG بدست آورد. ۳) مدل یک روش افزایش معنایی نمایش محدود را اتخاذ می کند، که نه تنها روابط معنایی صریح چند سطحی را بین موجودات جغرافیایی نمایش می دهد و افزایش می دهد، بلکه اثربخشی مدل را در پیش بینی رابطه بهبود می بخشد.
ادامه این مقاله به شرح زیر سازماندهی شده است: بخش ۲ جزئیات روش پیشنهادی را ارائه می دهد. در بخش ۲٫۱ ، ما ساخت شبکههای شباهت چند لایه موجودیتهای جغرافیایی را برای دستیابی به افزایش معنایی یک KG توصیف میکنیم. ما فرآیند تحقق بیان بردارسازی موجودیتهای جغرافیایی را در بخش ۲٫۲ شرح میدهیم و پیشبینی روابط جغرافیایی را بر اساس بردارسازی موجودیتهای جغرافیایی در بخش ۲٫۳ معرفی میکنیم. در بخش ۳ ، آزمایشهای مقایسهای را گزارش میکنیم که اثربخشی روش را اثبات میکند. ما در مورد سودمندی روش و محدودیت های آن در بخش ۴ بحث می کنیم و کار خود را در بخش ۵ خلاصه می کنیم..
۲٫ روش تحقیق
توزیع دم طولانی و پراکندگی موجودیت ها و روابط در GeoKG در مقیاس بزرگ به طور جدی بر آموزش مدل تأثیر گذاشته است. ما فرض میکنیم که افزودن روابط بالقوه بین موجودیتهای جغرافیایی به KG با اطلاعات مرجع خارجی توضیحی نه تنها میتواند اتصال موجودیتهای جغرافیایی پراکنده را بهبود بخشد، بلکه میتواند سوگیری برداری ناشی از کمبود داده در مدل را تا حدودی اصلاح کند. . موجودیتهای جغرافیایی با ویژگیهای بسیار مشابه، معانی کلمات، فضا و ساختار به احتمال زیاد عبارات برداری مشابهی دارند.
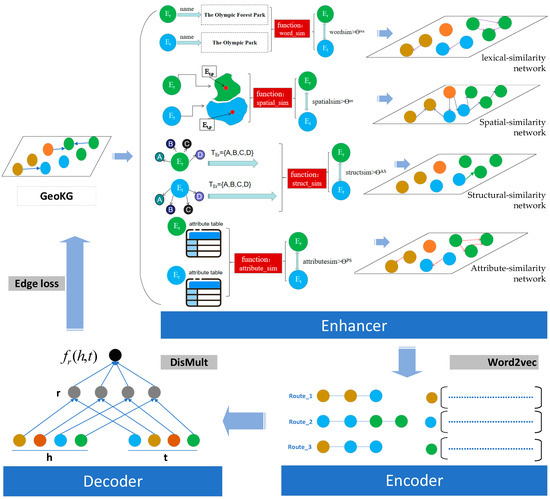
از این رو، روش MSEN-GRP (نشان داده شده در شکل ۲ ) به سه بخش اصلی تقسیم می شود: (۱) تقویت کننده: شبکه شباهت موجودیت های جغرافیایی. با توجه به ویژگیهای موجودیتهای جغرافیایی، شبکه واژگانی-شباهت، شبکه فضایی-شباهت، شبکه ساختاری-شباهت و شبکه ویژگی-شباهت برای تقویت روابط بالقوه میان موجودیتهای جغرافیایی ساخته میشوند. (۲) رمزگذار: جاسازی ترکیبی مسیر geo-entity. تولید مسیر بر اساس تولید مسیر سرگردان تصادفی برای لایههای مختلف شبکه و نمونهبرداری مسیر ترکیبی و Word2vec است [ ۲۴ ]روش ] برای پیشآموزش موجودیتها برای مسیرهای ترکیبی استفاده میشود. (۳) رمزگشا: پیش بینی رابطه جغرافیایی. با ترکیب بردارهای پیشآموزشی موجودیت سر و دم، با کمک مدل DisMult، پیشبینی روابط جغرافیایی در GeoKG به دست میآید.
۲٫۱٫ تقویت کننده: ژئو نهاد شباهت ساخت و ساز شبکه
برای کاهش تأثیر موجودیتها و روابط پراکنده در GeoKG در مقیاس بزرگ بر روی یک مدل پیشبینی روابط جغرافیایی، ما روابط استعاری بین موجودیتهای جغرافیایی را با ساخت یک شبکه واژگانی-شباهت، شبکه فضایی-شباهت، ساختاری به عبارات رابطه مرتبط صریح تبدیل میکنیم. -شبکه شباهت، و شبکه صفت-شباهت برای پیوست کردن اطلاعات خارجی، بنابراین اتصال بین موجودیت های جغرافیایی در GeoKG های پراکنده را غنی می کند و مدل را قادر می سازد تا نمایش برداری موثرتری از موجودیت های جغرافیایی و روابط آنها را به دست آورد. ساخت هر شبکه در بخش ۲٫۱٫۱ ، بخش ۲٫۱٫۲ توضیح داده شده است . بخش ۲٫۱٫۳ و بخش ۲٫۱٫۴ در زیر.
۲٫۱٫۱٫ شبکه واژگانی- تشابهی
شباهت واژگانی موجودیت های جغرافیایی نشان دهنده وجود برخی ارتباط معنایی بین آنهاست. به عنوان مثال، موجودیت های جغرافیایی «رود گداوری» و «رود آلگنی» . تنوع عبارات زبان طبیعی اغلب محاسبه شباهت کلمات موجود را دشوار می کند. برای پرداختن به مشکلات فوق، از تابع word_sim در شکل ۲ برای محاسبه شباهت معانی کلمات موجودات جغرافیایی استفاده شده است ( شکل ۳).) دوگانه است: (۱) هنگامی که نام موجودیت های جغرافیایی حاوی برخی از کلمات مشابه باشد، از روش ژاکارد برای اندازه گیری شباهت واژگانی موجودیت ها با محاسبه همزمانی کلمات تشکیل دهنده استفاده می شود، که اجازه می دهد تا محاسبه سریع و درشت شباهت از طریق ترکیب کلمات موجودیت؛ (۲) در مورد ترکیبهای مختلف کلمات موجودیت که معانی مشابهی دارند، مانند موجودیتهای جغرافیایی “Hochfeiler” و “Hochvogel” ، یک Word2vec از پیش آموزشدیده شده از کلمه به محدوده بزرگتری از محاسبات واژگانی-شباهت موجودیت دست مییابد.
اولاً کلمات geo-entity Erبرای تشکیل مجموعه کلمه تقسیم می شوند دبلیوr={دبلیوr،۱،دبلیوr،۲،دبلیوr،من،…،دبلیوr،من}برای E={E1،E2،E3،…Er،…،En}∈جی. سپس روش ضریب جاکارد جیاسEr،Eتیدر معادله (۱) (JS در شکل ۳ ) برای محاسبه سریع تشابه موجودیت هایی که کلمات آنها همزمان خوبی دارند استفاده می شود. علاوه بر این، شباهت معانی کلمه موجودیت تیاسEr،Eتی(TS در شکل ۳ ) بر اساس بردار کلمه از پیش آموزش داده شده محاسبه شده است دبلیوVErاز ویکی داده برای حل مورد کلمات مختلف با معنی یکسان (معادله (۲)); در نهایت، روش قضاوت آستانه دبلیواسEr،Eتینشان داده شده در معادله (۳) (WS در شکل ۳ ) برای انتخاب استراتژی بهینه برای محاسبه شباهت کلمه موجودیت، برای به دست آوردن کلمه معقول تر به معنای نتایج اندازه گیری شباهت استفاده می شود. شباهت واژگانی هر جفت در مجموعه موجودیت ( Er،Eتی،دبلیواسEr،Eتی) را می توان با استفاده از معادلات (۱) – (۳) زیر و یک آستانه تشابه محاسبه کرد θدبلیواستنظیم شده است تا روابط بالقوه موجودات با شباهت کم را فیلتر کند، این شبکه واژگانی-شباهت را به دست می آورد. جیدبلیواساز Eو یک رابطه صریح “lexical_sim” بین آن اضافه می کند Er و Eتیبه عنوان سه قلو < Er،واژگانی_سیم کارت،Eتی>
۲٫۱٫۲٫ شبکه شباهت فضایی
موجودیتهای جغرافیایی در یک GeoKG دارای ویژگیهای توزیع فضایی آشکاری هستند و روابط فضایی بین موجودیتهای جغرافیایی میتواند شباهت بالقوه آنها را تا حدی منعکس کند. فواصل اقلیدسی و روابط توپولوژیکی معمولاً برای تعیین کمیت روابط فضایی بین اشیاء جغرافیایی استفاده می شود. با این حال، ویژگیهای مقیاس فضایی موجودیتهای جغرافیایی، امکان داشتن مقیاسهای مختلف در بیان هندسی را ممکن میسازد. به عنوان مثال، هنگام تلاش برای قضاوت در مورد رابطه توپولوژیکی آنها و فاصله اقلیدسی موجودیت های جغرافیایی “شهرستان Xingguo” و “Beijing-Kowloon Railway Line”، اولی ممکن است یک موجود از نوع نقطه یا منطقه باشد، در حالی که دومی یک موجودیت نوع خط در GIS است. موجودیتهای جغرافیایی از انواع شیهای جغرافیایی مختلف معمولاً در GeoKGهای مقیاس بزرگ وجود دارند، که منجر به مشکل در ساخت شباهت فضایی بین موجودیتهای جغرافیایی مذکور در شکل ۲ میشود .
بنابراین، اولین عملکرد “spatial_sim” در شکل ۲ ، شناسایی موجودیت های جغرافیایی به عنوان یک نوع شی جغرافیایی مناسب (به عنوان مثال، نقطه، منطقه، خط) است. پس از شناسایی انواع شی هندسی متناظر از موجودیت های جغرافیایی درگیر در محاسبه شباهت فضایی، یک چارچوب محاسباتی در جدول ۱ برای به دست آوردن حالت محاسبه شباهت موجودیت داده شده استفاده می شود. چارچوب محاسبه شباهت فضایی موجودیت های جغرافیایی در جدول ۱ نشان داده شده است که در آن Dمدل فاصله فضایی دو موجودیت جغرافیایی را نشان می دهد. محاسبات فاصله فضایی بین انواع مختلف ژئو شی با روابط توپولوژیکی متفاوت الگوهای متفاوتی دارد. نوع Point–Point روابط توپولوژیکی از جمله «متقاطع» ، «حاوی» یا «داخل» را ندارد. نوع Point-Line روابط توپولوژیکی از جمله “تقاطع” یا “معادله” را ندارد. زمانی که دو موجودیت جغرافیایی از نوع Point-Line یا Point-Region باشند، فاصله مکانی اغلب صفر است. این مورد برای انواع Line-Region یا Line-Line با رابطه توپولوژیکی “Contains” یا “Within” نیز صادق است.و همچنین در انواع Point–Point، Point–Region یا Line–Line با رابطه توپولوژیکی «Equation» .
زمانی که فاصله مکانی در مدل های مختلف فاصله فضایی صفر نباشد، Dپ-پ، Dپ-L، Dپ-آر، Dآر-آر،و DL-آرباید مستقیماً با استفاده از مختصات نقاط نماینده محاسبه شود. موجودیتهای جغرافیایی نوع نقطه، نقطه را به عنوان نقطه نماینده آن میسازند و مختصات آنها را میتوان مستقیماً پیدا کرد، برای مثال، «ایستگاه راهآهن پکن» را میتوان بیشتر به عنوان یک موجودیت نوع نقطهای، با مکان و مجموعهای از مختصات خاص مشاهده کرد. . با این حال، برای دیگر انواع ژئو شیء، لازم است یک نقطه نماینده برای محاسبه فاصله مکانی انتخاب شود. به عنوان مثال، موجودیت جغرافیایی “پکن “ احتمالاً به عنوان یک موجودیت نوع منطقه ای بهتر دیده می شود، بنابراین روش رایج انتخاب مختصات دولت پکن به عنوان مختصات نقطه نماینده آن است. البته، نقطه مرکزی یک شی جغرافیایی نوع خط یا منطقه به عنوان نقطه نماینده راحت ترین راه است (شکل ۴ ). به عنوان مثال، موجودیت جغرافیایی نوع خط Eتینشان داده شده در شکل ۴ ب، انتخاب نزدیکترین نقطه Eتی،پروی خط. در شکل ۴ ج، انتخاب نقطه مرکزی Eتی،پدر منطقه به عنوان نقطه نماینده اگر Eتیاز نوع منطقه ای است. علاوه بر این، انتخاب نزدیکترین نقطه به عنوان نقطه نماینده برای Eتییا Erدر انواع مختلف اغلب به مدل در شکل ۴ f,g اعمال می شود، در حالی که نقطه مرکزی را به عنوان نقطه نماینده انتخاب می کنیم. Eتییا Er که در ناهمسان انواعمعمولاً در مدل شکل ۴ d-i دیده می شود.
پس از کسب امتیاز نماینده Er،پو Eتی،پبرای Er و Eتی، به ترتیب با مختصات آنها LonEr،پ( LonEتی،پ) و LآتیEr،پ( LآتیEتی،پ) فاصله مکانی DEr،Eتیمحاسبه از Er و Eتیاز مختصات استفاده می کند LonEr،پ( LonEتی،پ) و LآتیEr،پ( LآتیEتی،پ) به عنوان ورودی معادله (۴)؛ شباهت فضایی موجودیت های جغرافیایی اساسEr،Eتیسپس می توان از طریق رابطه (۵) محاسبه کرد. علاوه بر این، اتصال شبکه شباهت فضایی بین موجودیتها در GeoKG توسط پارامتر آستانه تنظیم میشود. θسسبرای ساخت شبکه شباهت فضایی جیاساساز E . رابطه “spatial_sim” بین Er و Eتیسپس به مجموعه GeoKG اضافه می شود.
۲٫۱٫۳٫ شبکه ساختاری شباهت
انواع موجودیت های متصل در یک GeoKG می تواند تا حدی منعکس کننده شباهت های بالقوه بین موجودیت های جغرافیایی باشد. همانطور که در شکل ۲ و شکل ۵ نشان داده شده است ، انواع موجودات در مجاورت نهادهای جغرافیایی “دریای ایونی” ( Er) و «دریای آدریاتیک» ( Eتی( _ تیErو تیEتی) که نشان دهنده تشابه ساختاری بالایی بین آنهاست.
بنابراین، شبکه تشابه ساختاری بر اساس وضعیت فعلی اتصال و برچسبهای نوع موجودیتها از GeoKG موجود طبق فرآیند شکل ۵ ساخته میشود . در مرحله اول، مجموعه ای از برچسب های نوع شی متصل لیست می شود تیErو تیEتیبرای یک شیء موجودیت جغرافیایی به دست می آید Er و Eتی. سپس، مدل یک کیسه-کلمه داغ برای تحقق بردارسازی برچسب موجودیتهای جغرافیایی معرفی میشود. در وکتورهای کیسه-کلمه بدبلیوEr و بدبلیوEتیاز Er و Eتی،بعد برداری نام برچسب است و مقدار آن تعداد برچسب های ظاهر شده است. و سپس، شباهت ساختاری دو ژئو موجودیت Er و Eتیبا استفاده از رابطه (۶) محاسبه می شود. علاوه بر این، شبکه تشابه ساختاری جیآاستوسط پارامتر آستانه تنظیم می شود θآاس. در نهایت، رابطه “structural_sim” بین Er و Eتیبه مجموعه GeoKG اضافه شده است.
۲٫۱٫۴٫ شبکه ویژگی-شباهت
ویژگیهای موجودیتهای جغرافیایی شامل توصیف دقیق ویژگیهای موجودیت مذکور است. هر چه شباهت موجودیت های جغرافیایی از نظر مجموعه ویژگی هایشان بیشتر باشد، ارتباط بالقوه بین آنها قوی تر است. معیارهای تشابه صفت باید عبارات مختلف نام ویژگی و مقادیر مشخصه موجودیتهای جغرافیایی را در نظر بگیرند، مانند مواردی که برای «شیکاگو» و «چین» در جدول ۲ ارائه شده است. ابتدا باید انواع ویژگی های موجود را تراز کرد و سپس شباهت مقدار مشخصه منطبق آنها را محاسبه کرد.
اول از همه، برای مجموعه ای از نام های ویژگی پLEr و پLEتیبه دست آمده برای Er،Eتیمعادلات (۱)-(۳) برای محاسبه شباهت واژگانی نام ویژگی های موجودیت و به دست آوردن مجموعه ای از نام های ویژگی تراز شده استفاده می شود. پLآEr،Eتی; و سپس نسبت تراز نوع ویژگی پLآ_rآتیهمحاسبه می شود (معادله (۷)).
در مرحله بعد، نام های صفت تراز شده بر اساس نوع ارزش ویژگی مربوطه به ویژگی های نوع رشته ای (SAT) و ویژگی های نوع عددی (VAT) تقسیم می شوند. برای مثال، نام ویژگی “name” یک SAT است و “مساحت کل” یک VAT در جدول ۲ است. صفت مجموعه می شود پLآEr،Eتی،سآتی و پLآEr،Eتی،vآتیبدین ترتیب شکل می گیرند. شباهت SAT روشی مشابه با آنچه در معادلات (۱) – (۳) بالا نشان داده شده است، اتخاذ می کند. از آنجا که یک موجودیت ممکن است چندین SAT داشته باشد، یک محاسبه شباهت جامع اسمنمترسآتیEr،Eتیبا استفاده از شباهت واژگانی محاسبه می شود دبلیواسEr،پمن،Eتی،پمن(معادله (۸)).
محاسبه شباهت مالیات بر ارزش افزوده موجودیت های جغرافیایی باید بزرگی و توزیع ارزش ویژگی را در نظر بگیرد. الگوریتم گسسته سازی ایزومتریک برای گسسته کردن مقادیر پیوسته و یکسان کردن مقادیر مشخصه در اندازه یکسان برای کاهش تأثیر تفاوت شباهت ویژگی های مختلف استفاده می شود. الگوریتم گسسته گسترده، ناحیه بندی فضای مقدار را با توجه به تعداد مجموعه انجام می دهد کبا یافتن حداقل و حداکثر مقادیر مشخصه، همانطور که در جدول ۳ نشان داده شده است.
پس از بدست آوردن فاصله پارتیشن مقدار مشخصه، شباهت صفت با استفاده از مقدار گسسته ویژگی در معادله (۹) محاسبه می شود. در نهایت، مقادیر ویژگی نوع رشته و نوع عددی برای محاسبه شباهت ویژگی ادغام می شوند پاسEr،Eتیاز نهاد Er،Eتیبا استفاده از رابطه (۱۰). پس از به دست آوردن شباهت ویژگی های موجودیت، ارتباط بالقوه بین موجودیت ها بر اساس آستانه تشابه ویژگی تعیین می شود. θپاس، بنابراین شبکه تشابه ویژگی را می سازد جیپاسمجموعه جغرافیایی E . در نهایت، رابطه “ویژگی_sim” بین Er و Eتیبه مجموعه GeoKG اضافه شده است.
۲٫۲٫ رمزگذار: جاسازی ترکیبی مسیر مسیر جغرافیایی
رمزگذار برای دستیابی به بیان بردار موجودیت های جغرافیایی در GeoKG طراحی شده است. رمزگذار به DeepWalk اشاره می کند [ ۲۵ ] اشاره دارد، یک روش یادگیری بازنمایی مبتنی بر ویژگی مسیر، که ویژگیهای رابطهای را در میان موجودیتهای جغرافیایی با تولید مجموعهای از دنبالههای مسیر شبکههای شباهت لایههای مختلف از طریق استراتژیهای پیادهروی تصادفی یاد میگیرد. روش Word2vec برای پیشآموزش این توالی مسیرها و در نهایت به دست آوردن بردارهای موجودیت های جغرافیایی معرفی شده است.
اساس روش رمزگذار، GeoKG پیشرفته، از جمله شبکه اصلی است جیب، شبکه واژگانی- تشابهی جیدبلیواسشبکه شباهت فضایی جیاساس، شبکه تشابه ساختاری جیآاسو شبکه صفت-شباهت جیپاسکه در بخش ۲٫۱ ساخته شدند . همانطور که در شکل ۶ نشان داده شده است ، شبکه جیباز GeoKG در شکل ۱ و بخش ارتقا یافته شبکه انتزاع شده است(جیدبلیواس،جیاساس،جیآاس، و جیپاس)با بخش های قرمز، سبز، بنفش و آبی در قسمت مرکزی شکل ۶ نشان داده شده است. سپس هر لایه از شبکه از یک راهپیمایی تصادفی استفاده میکند، که در آن هر مرحله از راهپیمایی از لبه متصل به گره فعلی از یک گره خاص حرکت میکند و در طول یال انتخابشده به طور مکرر به گره بعدی حرکت میکند. برای مثال، {route_1,route_2,route_3,……} در شکل ۶ نشان داده شده است. در طول فرآیند، تعداد مسیرهای پیاده روی تصادفی n و طول هر مسیر لمورد نیاز هستند. از این رو ، مجموعه مسیرهای پیاده روی تصادفی چهار لایه موجودیت R ، RB ، RW ، RS ، RA و RP برایجیب، جیدبلیواس،جیاساس،جیآاس، و جیپاس، به ترتیب.
سپس، یادگیری بازنمایی گرهها (جئوانیتها) در مجموعه مسیر با استفاده از روش پیشآموزشی کلمه (Word2vec) بر اساس مجموعهای از دنبالههای مسیر پیادهسازی میشود. روش پیشنهادی به طور کامل از وابستگیهای دوردست بین موجودیتها استفاده میکند، که بسیار قابل تفسیر و درک آسان است و برای گرفتن ویژگیهای رابطهای موجودیتها در KGهای پراکنده مناسب است. مفهوم پارامترهای نمونهگیری چند لایه برای بررسی دخالت شبکههای شباهت لایههای مختلف در یادگیری بازنمایی معرفی شده است. نسبت نمونه گیری بر ساخت مدل پیش آموزش فعال Word2vec تأثیر می گذارد. برای کنترل نسبت دادههای نمونه از لایههای مختلف در پیشآموزش فعال Word2vec، میگیریم λب، λدبلیو، λاس، λآ، و λپبه عنوان پارامترهای متناسب نمونهبرداری مسیر از لایههای فوق، و در نهایت مجموعه مسیر R شبکههای شباهت چند لایه را با استفاده از رابطه (۱۱) تشکیل میدهند. چه زمانی λب:λدبلیو:λاس:λآ:λپ=۱:۰:۰:۰:۰، این با روش رایج DeepWalk در حال حاضر مطابقت دارد، که فقط ارتباط مستقیم بین موجودات در یک GeoKG را در نظر می گیرد.
همانطور که در شکل ۶ نشان داده شده است ، مدل پیش آموزش موجودیت MSEN-GRP دنباله مسیر را به عنوان مجموعه داده مسیر ورودی می گیرد، که از روش DeepWalk الهام گرفته شده و الگوریتم Word2vec را معرفی می کند، و در نهایت یادگیری بازنمایی بردار موجودیت های گره را متوجه می شود. از طریق آموزش بدون نظارت Word2vec را می توان هم از طریق Skip-gram و هم از طریق کیسه کلمات (BOW)، Skip-gram برای زمینه پیش بینی گره فعلی، و BOW برای گره فعلی پیش بینی زمینه، هر دو دارای یک تابع فعال سازی هستند و هر دو در نهایت این را به یک ترجمه می کنند. نوع خاصی از بیان بردار در نهایت. پارامترهای کلیدی برای آموزش Word2vec شامل تنظیم پنجره نمونهبرداری w و بعد بردار خروجی d است.
۲٫۳٫ رمزگشا: پیش بینی روابط جغرافیایی
رمزگشا در MSEN-GRP مدل DisMult را همانطور که در شکل ۲ نشان داده شده است ، معرفی می کند که از بردارهای موجودیت جغرافیایی از پیش آموزش دیده استفاده می کند. yه۱و yه۲به عنوان ورودی از رمزگذار بالا، که در آن بردار موجودیت head-end به عنوان کل بردار ویژگی ورودی ترکیب می شود. بازنمایی رابطه عمدتاً توسط آrتیو بrدر تابع امتیازدهی DisMult عمدتاً تابع تبدیل خطی اولیه را اتخاذ می کند grآو تابع تبدیل دوخطی grبدر معادله (۱۲) به عنوان تابع امتیازدهی. تابع امتیازدهی برای محاسبه امتیاز رابطه متعلق به دسته خاصی در سه گانه استفاده می شود.
بردار از yه۱،yr1، و yه۲می توان با استفاده از تابع ضرر در معادله (۱۳) یاد گرفت و به روز کرد. تابع ضرر برای ارزیابی تفاوت بین رابطه پیش بینی شده و رابطه واقعی مدل استفاده می شود. یک تابع ضرر بهتر برابر با عملکرد بهتر مدل است. معادله (۱۳) روابط یا سه گانه های نمونه مثبت را تشویق می کند تا نمرات اطمینان بالاتری نسبت به روابط یا سه گانه های نمونه منفی دریافت کنند. معمولاً نمونه های آموزشی داده شده، داده های نمونه گیری مثبت فرض می شوند. مدل نمونه مثبت به منفی را می سازد (ه۱،r،ه۲)از طریق فساد توسط نمونه مثبت (ه۱″،r،ه۲″)برای تولید مجموعه داده نمونه منفی مربوطه T ‘ مجموعه داده نمونه مثبت T . تابع امتیاز T است f(ه۱،r،ه۲)، و T است f(ه۱″،r،ه۲″)در معادله (۱۳).
۳٫ طراحی آزمایشی و نتایج
مجموعه داده GeoKG مورد استفاده برای آزمایش با استفاده از دانش مکانی استخراج شده از KG عمومی در مقیاس بزرگ تشکیل شد. در مرحله بعد، شبکههای شباهت چند لایه موجودیتهای جغرافیایی و مسیرهای نمونهبرداری تصادفی تولید شده و ترکیبی در شبکه چند لایه را به عنوان ورودی برای آموزش مدل برداری برای به دست آوردن بردار موجودیت جغرافیایی ساختیم. در نهایت، بردار روابط جغرافیایی توسط DisMult رمزگشایی شد. ما مقایسههای تجربی الگوهای نمونهگیری مختلط مسیر مختلف را برای بررسی اثرات تقویتکنندههای شبکه شباهت لایههای مختلف بر تکمیل رابطه ارائه میکنیم. علاوه بر این، ما روش MSEN-GRP را با مدل متداول مبتنی بر فاصله (TransE، TransD) و روش مبتنی بر تطبیق معنایی (RESCAL، DisMult) و روش شبکه عصبی ProjE و TKRL مقایسه میکنیم تا اثربخشی این روش را نشان دهیم.
۳٫۱٫ تجزیه و تحلیل مجموعه داده های تجربی
مجموعه داده تجربی GeoDBpedia21 موجودیت های جغرافیایی و روابط آنها را از مجموعه داده DBpedia تجزیه کرد. جدول ۴ تعداد موجودیتها و روابط جغرافیایی را نشان میدهد، ۲۱ رابطه جغرافیایی و ۳۹۷۷۰ موقعیت جغرافیایی وجود دارد. جدول ۵ معنای هر رابطه جغرافیایی را شرح می دهد.
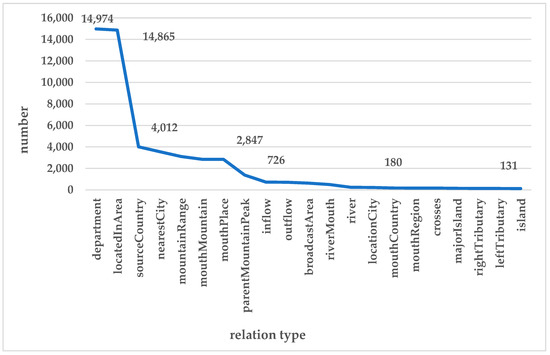
جزئیات روابط جغرافیایی در مجموعه داده GeoDBpedia21 در شکل ۷ نشان داده شده است که در آن توزیع نامتعادلی از انواع روابط وجود دارد. روابط “دپارتمان” (۱۴۹۷۴)، “واقع در منطقه” (۱۴۸۶۵) و “کشور مبدا” (۴۰۱۲) بیشترین ظاهر را دارند و چندین رابطه جغرافیایی کمتر از ۱۰۰۰ بار ظاهر می شوند (به عنوان مثال، “ورودی”، “خروج” ، “منطقه پخش”، “مصف رودخانه”، “رودخانه”، “شهر موقعیت”، “کشور جنوبی”، “منطقه دهانه”، “صلیب ها”، “جزیره اصلی”، “شاخه سمت راست”، “شاخه چپ” و ” جزیره»).
جزئیات موجودیت های جغرافیایی در مجموعه داده GeoDBpedia21 در شکل ۸ نشان داده شده است . ۲۵۸۷۲ ژئو موجودیت فقط یک درجه دارند که نشان دهنده تعداد دیگر موجودیت های جغرافیایی متصل به موجودیت داده شده از جنبه KG و همچنین تعداد یال های متصل به این گره از جنبه گرافیکی است. بیشتر موجودیت های جغرافیایی دارای درجه کمتر از ۸ هستند، و تعداد آنها از ۱۰ تا ۱ در زمانی که درجه بیش از ۲۰ باشد، متفاوت است. بنابراین، توزیع نامتعادل روابط جغرافیایی و اتصال ضعیف بین موجودیتهای جغرافیایی به طور عینی در مجموعه داده GeoDBpedia21 وجود دارد. الگوی مشابهی برای GeoKG در مقیاس بزرگ که دادههای آن از منابع پیچیده اینترنت است، انتظار میرود. این توزیع نامتعادل روابط در شکل ۹ نشان داده شده است، که در آن مشاهده می شود که بسیاری از موجودیت های جغرافیایی ارتباط کمی با سایر موجودیت های جغرافیایی در اطراف مرز در نمودار دارند.
۳٫۲٫ طراحی آزمایشی و پارامترها
این آزمایش از طریق تقویت کننده، رمزگذار و رمزگشا برای مجموعه داده GeoKG GeoDBpedia21 انجام شد. در این فرآیند، آستانه تشابه θدبلیواس، θاساس، θآاس، و θتیاسباید روی مقادیر معقول تنظیم شود. از آنجایی که محدوده مقادیر شباهت متفاوت بود، در نهایت ۱۰ درصد از بیشترین شباهت داده های نمونه در هر لایه انتخاب شدند. در نمونه برداری مسیر مختلط، تنظیم نسبت نمونه λب: λدبلیو: λاس: λآ: λتیمربوط به نسبت مسیرهای نمونه هر شبکه شباهت شرکت کننده در آموزش بود. شش حالت نمونهگیری مسیر برای انجام مقایسه اثر اثرات مدل قبل از آموزش تحت حالتهای نمونهگیری مختلف اتخاذ شد. پارامترهای Word2vec در طول فرآیند پیش آموزش مدل به صورت n = ۱۰۰، l = ۵، w = ۵، و d = ۱۰۰ تنظیم شد. شبکههای شباهت در تکمیل دانش، اثر تکمیل دانش را با استفاده از نتایج پیشبینی رابطه جغرافیایی ارزیابی کردیم. مدل DisMult برای پیشبینی دستهبندی موجودیت جغرافیایی استفاده شد. تعداد مجموعه داده های آموزشی، مجموعه داده های آزمایشی و مجموعه داده های اعتبارسنجی نشان داده شده استجدول ۴ .
۳٫۳٫ تجزیه و تحلیل نتایج تجربی
برای ارزیابی تأثیر پیشبینی روابط جغرافیایی از شاخص میانگین رتبهبندی متقابل (MRR) استفاده شد. محاسبه به صورت فرمول (۱۴) است، که در آن S مجموعه سه گانه است، |اس|تعداد مجموعه های سه گانه است، rآnکمنرتبه پیشبینی پیوند سهگانه i را نشان میدهد. یک شاخص بزرگتر معادل یک مدل MESEN-GRP بهتر است.
علاوه بر این، HITS@n برای نشان دادن میانگین نسبت سه قلوها < n در پیش بینی استفاده شد. شاخصهای رایج رایج فعلی عبارتند از hits@1 ، hits@3 ، hits@5 و hits@10. فرمول محاسبه در معادله (۱۵) نشان داده شده است:
که در آن نمادهای مشابه در معادله (۱۴)، و من تابع نشانگر را نشان می دهد (مقدار تابع اگر شرط ۱ باشد، در غیر این صورت ۰).
MSEN-GRP از روش نمونه گیری ترکیبی برای مقایسه اثرات افزایش لایه های مختلف شبکه استفاده کرد. جیب،جیدبلیواس،جیاساس،جیآاس، و جیپاس، نسبت ها λب: λدبلیو: λاس: λآ: λپدر جدول ۶ به همراه نتایج پیش بینی روابط جغرافیایی آنها نشان داده شده است. مشخص شد که شبکههای شباهت واژگانی و شبکههای شباهت فضایی ساختهشده در GeoDBpedia21 مشهودترین سهم را در اثر بهبود ارائه میکنند. شبکه تشابه واژگانی بالاترین نتیجه Hits@10 را با حدود ۵۴ درصد افزایش نسبت به شبکه پایه دارد و شبکه شباهت فضایی Hits@10 ۵۵٫۸۲ درصد است. شبکه تشابه ساختاری از ساختار شبکه پایه چیزهای زیادی یاد گرفته است. بنابراین بازدید @ ۱۰افزایش یافته است اما به دلیل اتصال ضعیف در GeoKG نسبت به شبکه تشابه واژگانی کمتر است. در میان آنها، اثر تقویت شبکه شباهت صفت آشکار نیست، عمدتاً به این دلیل که به دست آوردن شباهت بالا و جامع بین موجودیت های جغرافیایی تحت شرایط چند بعدی دشوار است. ویژگی ها در KG پراکنده در مقیاس بزرگ.
علاوه بر این، آزمایشهای این مقاله روش پیشنهادی MSEN-GRP را با روشهای رایج آموختهشده از ویژگیهای داخلی (استفاده شده از TransE مبتنی بر فاصله، روش مبتنی بر تطبیق معنایی Rescal، روش شبکه عصبی ProjE) و ادغام روش اطلاعات خارجی TKRL مقایسه میکند. همانطور که نتایج تجربی در جدول ۷ نشان میدهد ، بیشتر MRR MSEN-GRP بالاتر از روشهای TransE، Rescal، DisMult، ProjE، TKRL است و MRR قسمت خام بیشتر از قسمت فیلتر کمتر است (حذف کنید بخشی از مجموعه داده آموزشی از مجموعه داده آزمایشی). بهترین شاخص Hits@10 MSEN-GRP به ۰٫۵۷۵۹، بالاترین نرخ افزایش ۵۷٫۵۷ درصد و کمترین نرخ افزایش ۲۴٫۶۱ درصد بهبود یافته است.
ما پیشبینی رابطه جغرافیایی بین «کوههای وویی» و «شانگرائو» را از نتیجه آزمایش نشان میدهیم، موجودیت «کوههای وویی» و «شانگرائو» رابطه جغرافیایی صریح را در DBpedia ندارند، اما میدانیم که بخشی از «وویی» کوهها در «شانگرائو» قرار دارند به طوری که در واقع رابطه همسایگی فضایی دارند. ما میتوانیم نتیجه پیشبینی رابطه جغرافیایی مورد مذکور را همانطور که در جدول ۸ نشان داده شده است، دریافت کنیم، رابطه جغرافیایی دقیق « http://dbpedia.org/ontology/nearestCity » (دسترسی در ۱۴ سپتامبر ۲۰۲۲) رتبه اول را کسب کند. نتیجه پیش بینی رابطه جغرافیایی رابطه جغرافیایی ” http://dbpedia.org/ontology/locatedInArea” (دسترسی در ۱۴ سپتامبر ۲۰۲۲) امتیاز بالایی را در این مورد رابطه جغرافیایی دریافت کنید زیرا این نوع رابطه جغرافیایی توزیع عدد بالایی را دریافت می کند همانطور که در شکل ۷ نشان داده شده است.
۴٫ بحث
در حال حاضر، روشهای اصلی تکمیل دانش (مانند TransE، RESCAL، ProjE، TKRL) همگی بر اساس ویژگیهای اتصال بین موجودیتهای موجود برای به دست آوردن یک نمایش برداری قابل اعتماد و مؤثر از موجودیتها هستند، که سپس برای تکمیل دانش اعمال میشود. بنابراین، اتصال موجودیتها ارتباط نزدیکی با یادگیری بازنمایی یک KG دارد. بنابراین، هنگامی که آن روشهایی مانند TransE و DisMult در GeoDBpedia21 برای آزمایش استفاده شدند و MRR کمتر از ۰٫۲ بود، Hits@10 کمتر از ۰٫۳۳ است و اثر کلی ایدهآل نبود [ ۲۶ ]]. روش پیشنهادی MSEN-GRP با ساخت شبکههای شباهت چند لایه، روابط جغرافیایی ضمنی بین موجودیتهای جغرافیایی را به روابط جغرافیایی صریح با معنای خاص تبدیل میکند، که اتصال ضعیف بین موجودیتهای جغرافیایی را جبران میکند و اثر یادگیری جغرافیایی را بهبود میبخشد. بازنمایی نهاد (تا زمانی که دقت تکمیل دانش بر اساس یادگیری بازنمایی بهبود یابد). نتایج تجربی نشان داده شده در جدول ۷ کارایی روش پیشنهادی MSEN-GRP را در بهبود پیش بینی روابط جغرافیایی تایید می کند.
روش MSEN-GRP تلاش میکند تا آن شبکههای شباهت را بسازد، که از نظر تئوری تأثیر یادگیری بازنمایی را افزایش میدهد، اما تفاوتهایی در مشارکت لایههای مختلف شبکههای شباهت در یادگیری بازنمایی موجودیتهای جغرافیایی وجود دارد. بنابراین، روش MSEN-GRP همچنین یک روش نمونهگیری ترکیبی برای آزمایش اثر روش MSEN-GRP تحت حالتهای نمونهگیری مختلف، و ارزیابی تأثیر سطوح مختلف شبکههای شباهت بر یادگیری نمایش نهادهای جغرافیایی ارائه میکند. نتایج تجربی ( جدول ۶) نشان می دهد که شبکه واژگانی-شباهت و شبکه شباهت فضایی سهم بیشتری در پیش بینی روابط بین موجودیت های جغرافیایی دارند. این عمدتا به این دلیل است که ویژگیهای فضایی و ویژگیهای شباهت ساختاری موجودیتهای جغرافیایی نسبتاً مشهود است. با این حال، به دلیل پیچیدگی انواع ویژگی های موجودیت جغرافیایی، تأثیر شبکه شباهت ویژگی نامشخص است. اثر خوب شبکه تشابه ساختاری تأیید میشود که ویژگی ساختاری سادهشده و گرفته شده GeoKG به تعبیه موجودیت جغرافیایی کمک میکند. روش MSEN-GRP می تواند نسبت نمونه برداری را با توجه به سهم هر لایه از شبکه شباهت در تکمیل رابطه تنظیم کند تا بهینه سازی کارایی و اثر حاصل شود. از این رو،
با این حال، روش MSEN-GRP هنوز دارای محدودیتهایی است: (۱) با بزرگتر شدن مقیاس KG، پیچیدگی زمانی تقویتکننده افزایش مییابد. برای کاربردهای GeoKG در مقیاس بزرگ، ساخت یک شبکه شباهت موجودیت جغرافیایی نیاز به محاسبه شباهت بین هر جفت از موجودیتهای جغرافیایی دارد. (۲) بازنمایی بردار روابط جغرافیایی هنوز نیاز به بهبود دارد. اگرچه این روش از DisMult در رمزگشا برای تحقق بیان بردار روابط جغرافیایی بین موجودیتهای جغرافیایی استفاده میکند، فاصله محاسبهشده توسط بردارها نمیتواند برای ارزیابی شباهت روابط جغرافیایی به دلیل توزیع ناهموار آنها در مجموعه دادههای GeoKG استفاده شود.
۵٫ نتیجه گیری ها
برای حل مشکل تکمیل روابط جغرافیایی GeoKG در معرض اثر یادگیری ضعیف بازنمایی دانش ناشی از روابط پراکنده، ما یک مدل پیشبینی روابط جغرافیایی بر اساس شبکههای تقویتشده شباهت چند لایه (MSEN-GRP) پیشنهاد میکنیم. برای تکمیل روابط جغرافیایی این روش نقص اتصال ضعیف موجودیتهای جغرافیایی در GeoKG را با ساخت شبکههای شباهت چند لایه، به صراحت شامل معنی کلمه، فضا، ساختار و ویژگی برای هر موجودیت جغرافیایی جبران میکند. این امر یادگیری بهتر را با ویژگی های واضح تر و متعادل تر در مدل های مختلف تسهیل می کند. علاوه بر این، الگوریتم DeepWalk که در بخش رمزگذار مدل معرفی شده است، از روش نمونهگیری مسیر ترکیبی برای یادگیری وابستگیهای رابطه با فواصل طولانی استفاده میکند. آزمایش پیشبینی روابط جغرافیایی بر اساس مجموعه دادههای GeoDBpedia21 ثابت میکند که مدل MSEN-GRP بهتر از بسیاری از روشهای فعلی در تکمیل روابط جغرافیایی عمل میکند. به عنوان مثالHits@10 مدل MSEN-GRP 57.57% بیشتر از DisMult و ۲۴٫۶۱% بیشتر از TransE است که ثابت می کند افزودن اطلاعات صریح موثر است. آزمایشها با استفاده از حالتهای نمونهگیری مختلف نشان میدهند که شبکه شباهت فضایی، یادگیری بازنماییهای موجودات جغرافیایی را با Hits@10 به بیشترین درجه بهبود میبخشد.افزایش ۳۰ درصدی در مقابل، اثر تقویت شبکه صفت-شباهت آشکار نیست، و این واقعیت را برجسته می کند که اثرات شبکه های شباهت مختلف به طور گسترده ای متفاوت است. ما همچنین دریافتیم که موجودیتهای جغرافیایی در GeoKG شباهت فضایی ضمنی قوی دارند. در آینده، ما یک مکانیسم وزندهی جغرافیایی را برای بهبود نمایش بردار مبتنی بر موقعیتهای جغرافیایی و روابط آنها در GeoKGهای مقیاس بزرگ در نظر خواهیم گرفت.