Heri-Graphs: چارچوب ایجاد مجموعه داده برای یادگیری ماشینی چندوجهی بر روی نمودارهای ارزش ها و ویژگی های میراث با رسانه های اجتماعی


چکیده

ارزش ها (چرا باید حفظ کرد) و ویژگی ها (چه چیزی را باید حفظ کرد) مفاهیم اساسی میراث فرهنگی هستند. مطالعات اخیر از رسانه های اجتماعی برای ترسیم ارزش ها و ویژگی های انتقال یافته توسط مردم به میراث فرهنگی استفاده کرده اند. با این حال، به ندرت می‌توان روش‌های ناهمگون تصاویر، متون، مکان‌های جغرافیایی، مُهرهای زمانی و ساختارهای شبکه‌های اجتماعی را برای استخراج ویژگی‌های معنایی و ساختاری آن‌ها به هم متصل کرد. این مطالعه یک چارچوب روش‌شناختی برای ساخت چنین مجموعه‌های داده چندوجهی با استفاده از پست‌ها و تصاویر در فلیکر برای وظایف یادگیری ماشین مبتنی بر نمودار (ML) در مورد ارزش‌ها و ویژگی‌های میراث ارائه می‌کند. پس از پیش پردازش داده ها با استفاده از مدل های ML از پیش آموزش دیده، اطلاعات چندوجهی محتوای بصری و معنایی متنی به عنوان ویژگی ها و برچسب های گره مدل می شوند. در حالی که روابط اجتماعی و زمینه‌های مکانی-زمانی آنها به‌عنوان پیوندهایی در نمودارهای چندگانه مدل‌سازی می‌شوند. این چارچوب در سه شهر حاوی ویژگی‌های میراث جهانی یونسکو – آمستردام، سوژو و ونیز – آزمایش شده است که مجموعه‌های داده‌ای با ثبات بالایی برای وظایف یادگیری نیمه‌نظارت‌شده به دست می‌دهد. کل فرآیند به طور رسمی با نمادهای ریاضی توصیف شده است، آماده به کارگیری در وظایف موقت هم به عنوان مسائل ML با ارتباط فنی و هم به عنوان سوالات مطالعه شهری/میراث با علایق اجتماعی. این مطالعه همچنین می‌تواند به درک و نقشه‌برداری ارزش‌ها و ویژگی‌های میراث برای تحقیقات آینده در موارد جهانی، با هدف شیوه‌های مدیریت میراث فراگیر کمک کند. علاوه بر این، چارچوب پیشنهادی را می توان به عنوان ایجاد نمودارهای نسبت داده شده از منابع داده های رسانه های اجتماعی بدون ساختار خلاصه کرد.

کلید واژه ها:

میراث جهانی ؛ فلیکر ؛ مجموعه داده چند وجهی ; ساخت گراف ; ماشین و یادگیری عمیق

۱٫ مقدمه

در چارچوب کنوانسیون میراث جهانی یونسکو (WH)، «ارزش‌ها» (چرا باید حفظ شود) و «ویژگی‌ها» (چه چیزی را باید حفظ کرد) به طور گسترده برای جزئیات اهمیت فرهنگی میراث استفاده شده است [ ۱ ، ۲ ]. در همین حال، محققان به ترتیب مقوله‌ها و طبقه‌بندی‌هایی را برای ارزش‌ها و ویژگی‌های میراث ارائه کرده‌اند [ ۳ ، ۴ ، ۵ ]. هر دو مفهوم برای درک اهمیت و معنای میراث فرهنگی و طبیعی و برای تدوین برنامه های مدیریت جامع تر ضروری هستند [ ۵ ]]. با این حال، ارزش‌ها و ویژگی‌های میراث تنها برای تعریف اهمیت ارزش جهانی برجسته (OUV) در زمینه خاص فهرست میراث جهانی (WHL) نیستند، بلکه همه انواع اهمیت، از فهرست‌شده تا فهرست‌نشده، طبیعی تا فرهنگی، ملموس به ناملموس، و از جهانی به ملی، منطقه ای و محلی [ ۴ ، ۶ ، ۷ ، ۸ ، ۹ ]. علاوه بر این، توصیه یونسکو در سال ۲۰۱۱ درباره منظر شهری تاریخی (HUL) تاکید کرد که میراث نیز باید از طریق دریچه دید شهروندان محلی، گردشگران و کارشناسان شناسایی شود و ابزارهایی برای مشارکت مدنی و مستندسازی دانش را خواستار شد [ ۸ ، ۹ ، ۱۰ ]].
پس از آن، در دهه گذشته، تحلیل‌هایی بر روی محتوای تولید شده توسط کاربر (UGC) از پلتفرم‌های رسانه‌های اجتماعی برای جمع‌آوری فعال نظرات عمومی [آنلاین] و ترسیم ارزش‌ها و ویژگی‌های میراث منتقل شده توسط سهامداران مختلف در محیط‌های شهری انجام شده است [ ۱۱ ]. ، ۱۲ ]. در ادبیات یادگیری ماشینی (ML)، یک روش به عنوان « روشی که در آن چیزی اتفاق می‌افتد یا تجربه می‌شود » تعریف می‌شود، که می‌تواند شامل زبان طبیعی، محتوای بصری، سیگنال‌های صوتی و غیره باشد [ ۱۳ ]. بیشتر مطالعاتی که ارزش‌ها و ویژگی‌های میراث را از UGC ترسیم می‌کنند، تنها بر روی چند روش مجزا متمرکز شده‌اند، مانند موضوعات متنی نظرات و/یا برچسب‌ها [ ۱۴ ، ۱۵ ،۱۶ ، محتوای بصری صحنه های به تصویر کشیده شده [ ۱۷ ، ۱۸ ]، تعاملات اجتماعی [ ۱۹ ، ۲۰ ، ۲۱ ]، و توزیع جغرافیایی پست ها [ ۲۲ ، ۲۳ ].
با این حال، اطلاعات چندوجهی ناهمگون از رسانه‌های اجتماعی می‌تواند درک پست‌ها را غنی کند، زیرا محتوای متنی و بصری، بافت‌های زمانی و جغرافیایی، و ساختارهای شبکه‌های اجتماعی خط‌دار می‌توانند پیام‌های مکمل و متناقض را نشان دهند [ ۹ ، ۲۴ ]. چند مطالعه روش های مختلف را برای آشکار کردن موضوعات مورد بحث و صحنه های ترسیم شده در مورد میراث فرهنگی تجزیه و تحلیل کرده اند [ ۲۵ ، ۲۶ ]. با این حال، از آنجایی که آنها (بیشتر) رویکردهای آنالوگ را در طول تجزیه و تحلیل تطبیق دادند و اطلاعات چندوجهی به طور صریح با هم جفت، مرتبط و تجزیه و تحلیل نشدند، این مطالعات هنوز نمی توانند به عنوان یادگیری ماشینی چندوجهی (MML) طبقه بندی شوند، با هدف “مدل‌هایی بسازید که می‌توانند اطلاعات را از روش‌های چندگانه پردازش و به هم مرتبط کنند » [ ۱۳ ] تا نتیجه‌گیری‌هایی را که به راحتی با روش‌های مجزا به دست نمی‌آیند غنی کنند. از سوی دیگر، کراندال و همکاران. [ ۲۷ ] یک مجموعه داده جهانی جمع آوری شده از فلیکر با ویژگی های بصری و متنی و همچنین مکان های جغرافیایی پیشنهاد کرد. نمودارها با اطلاعات چند وجهی برای نقشه‌برداری، خوشه‌بندی و بازیابی نماینده‌ترین تصاویر شاخص برای شهرهای بزرگ جهانی ساخته شدند. گومز و همکاران [ ۲۸] مدل‌های نمایش چند وجهی از تصاویر، زیرنویس‌ها و محله‌ها با داده‌های اینستاگرام از درون بارسلون، قادر به بازیابی مرتبط‌ترین عکس‌ها و موضوعات برای هر منطقه شهرداری است که برای تفسیر ویژگی‌های شهری محله‌های مختلف استفاده می‌شود. اخیراً، خط تحقیقات مستمر در کانگ و همکاران نشان داده شده است. [ ۲۹ ] و چو و همکاران. [ ۳۰ ] یادگیری انتقال کاربردی [ ۳۱] تکنیک‌هایی برای طبقه‌بندی تصاویر برچسب‌گذاری‌شده جغرافیایی به دسته‌های صحنه سلسله مراتبی و مرتبط کردن فعالیت‌های توریستی به تصویر کشیده شده با محیط‌های شهری که این فعالیت‌های فرهنگی در آن انجام می‌شد. اگرچه همه آنها به طور صریح به میراث اشاره نکردند، اما این مطالعات می تواند اطلاعات مفیدی را برای محققان و متخصصان به منظور جمع آوری دانش از عموم در مورد ارزش ها و ویژگی های میراث درک شده در محیط های شهری، همانطور که توسط HUL [ ۹ ، ۱۰ ] پیشنهاد شده است، ارائه دهد. در میان پنج چالش اصلی MML که توسط Baltrusaitis و همکاران خلاصه شده است. [ ۱۳ ]، نمایش ( برای ارائه و خلاصه کردن داده‌های چندوجهی در یک فضای مشترک یا هماهنگ ) و ادغام ( برای پیوستن به اطلاعات برای پیش‌بینیبا توجه به (۱) بازیابی اطلاعات بصری و/یا متنی مربوط به ارزش‌ها و ویژگی‌های میراث خاص، و (۲) جمع‌آوری پست‌های فردی در سطوح مختلف جغرافیایی و اداری به‌عنوان جمعی، می‌تواند مرتبط‌ترین موارد برای مطالعات میراث و شهری باشد. دانش خلاصه شده از یک مکان
علاوه بر این، طبق قانون اول جغرافیا [ ۳۲ ]، ” همه چیز به هر چیز دیگری مربوط است، اما چیزهای نزدیک بیشتر از چیزهای دور مرتبط هستند “. این استدلال همچنین می‌تواند در اندازه‌گیری‌های فاصله‌ای غیر از اندازه‌گیری‌های جغرافیایی که در آن یک پیاده‌روی تصادفی انجام شود [ ۳۳ ] معتبر است، مانند یک فضای توپولوژیکی انتزاعی از ساختار فضایی [ ۳۴ ، ۳۵ ، ۳۶ ، ۳۷ ] یا یک شبکه اجتماعی. بر اساس منافع مشترک ساخته شده است [ ۳۸ ، ۳۹ ، ۴۰ ، ۴۱]. در این پرتو، ساخت نمودارهایی از پست‌های UGC که در آن تجزیه و تحلیل شبکه اجتماعی (SNA) می‌تواند انجام شود، مفید خواهد بود، که زمینه اجتماعی-اقتصادی و مکانی-زمانی را در میان آنها نشان می‌دهد و ماهیت وابسته به هم مرتبط پست‌ها را منعکس می‌کند [ ۴۲ ]. ]. چنین تعریف مشکلی می‌تواند هم به طبقه‌بندی و هم به وظایف تجمیع ذکر شده در بالا کمک کند، همانطور که توسط برنامه‌های کاربردی در زمینه نوظهور ماشین و یادگیری عمیق در نمودارها به عنوان موثر و قدرتمند نشان داده شده است [ ۴۳ ، ۴۴ ].
این مقاله چارچوب روش‌شناختی ایجاد مجموعه داده‌های مبتنی بر نمودار چندوجهی را درباره ارزش‌ها و ویژگی‌های میراث با استفاده از داده‌های رسانه‌های اجتماعی ساختار نیافته توصیف می‌کند. سوال اصلی از تولید چنین مجموعه‌های داده را می‌توان این‌طور فرمول‌بندی کرد: در حالی که ارزش‌ها و ویژگی‌های میراث به‌طور تاریخی از بازدید سایت و بررسی اسناد توسط متخصصان بازرسی شده‌اند، آیا روش‌های محاسباتی و/یا هوش مصنوعی می‌توانند به فرآیند مستندسازی دانش و مطالعات تطبیقی ​​با نقشه‌برداری و بررسی کمک کنند. استخراج داده های رسانه های اجتماعی چند وجهی؟ حتی اگر سرعت بخشیدن به فرآیندها در اولویت نباشد، ارائه چنین چارچوبی با هدف تشویق به قوام و مشارکت جوامع در گفتمان گرامیداشت، حفاظت و صیانت از میراث فرهنگی است. به عبارت دیگر،۹ ]. آثار اصلی این نسخه را می توان به شرح زیر خلاصه کرد:
  • مجموعه داده‌های شبکه‌های گرافیکی چندوجهی منتسب به دامنه خاص در مورد ارزش‌ها و ویژگی‌های میراث (یا دقیق‌تر، ارزش‌ها و ویژگی‌های منتقل‌شده توسط عموم به میراث فرهنگی شهری) با محتوای تولید شده توسط کاربر از پلتفرم رسانه‌های اجتماعی فلیکر در سه گروه جمع‌آوری و ساختار می‌شوند. شهرهای (آمستردام، سوژو، و ونیز) دارای ویژگی‌های میراث جهانی یونسکو، که می‌توانند از اسناد دانش و نقشه‌برداری برای مطالعات میراث و شهری بهره ببرند، با هدف فرآیند مدیریت میراث فراگیرتر؛
  • چندین مدل یادگیری ماشینی و یادگیری عمیق از قبل آموزش دیده به طور گسترده برای تولید ویژگی‌های چندوجهی و برچسب‌های [شبه] با فرمول‌های کامل ریاضی به‌عنوان تعریف مسئله، استفاده و آزمایش شده‌اند، که یک چارچوب روش‌شناختی قابل تکرار ارائه می‌دهد که می‌تواند در موارد دیگر نیز آزمایش شود. در سراسر جهان؛
  • نمودارهای چندگانه برای انعکاس روابط زمانی، مکانی و اجتماعی بین نمونه داده های محتوای تولید شده توسط کاربر جمع آوری شده ساخته شده اند، آماده آزمایش بیشتر در چندین کار موقت با ارتباط علمی برای یادگیری ماشین چندوجهی مبتنی بر نمودار و تحقیقات شبکه اجتماعی و علایق اجتماعی برای مطالعات شهری، علوم داده شهری و مطالعات میراث.

۲٫ مواد و روشها

۲٫۱٫ چارچوب کلی

قبل از پرداختن به مطالعات موردی دامنه خاص با جزئیات فناوری، این بخش ابتدا فرآیند کلی ایجاد مجموعه داده‌های چندوجهی را به عنوان نمودارهای نسبت داده شده از محتوای اطلاعات داوطلبانه بدون ساختار جمع‌آوری شده از رسانه‌های اجتماعی توصیف می‌کند. این نمودارها ارتباطات بین پست‌های ناشران محتوا در رسانه‌های اجتماعی را رمزگذاری می‌کنند. ارتباطاتی که می توانند به واسطه شباهت ها یا نزدیکی ها در حوزه های مکانی، زمانی یا اجتماعی ایجاد شوند. کل فرآیند از پنج جزء اصلی تشکیل شده است: جمع‌آوری و تمیز کردن داده ( بخش ۲٫۳ )، نمایش ویژگی‌های چندوجهی ( بخش ۲٫۴ )، تولید برچسب [شبه] ( بخش ۲٫۵ )، ساخت نمودار زمینه‌ای ( بخش ۲٫۶ ).و بازرسی و اعتبارسنجی کیفی ( بخش ۳ )، همانطور که در شکل ۱ نشان داده شده است.
همانطور که در Aggarwal [ ۲۴ ] و Bai et al. [ ۹]، تحلیل‌های موجود در رسانه‌های اجتماعی (یا داده‌های شبکه اجتماعی) را می‌توان به عنوان مطالعه محتوای آن (به طور سنتی متون و تصاویر، احتمالاً صوتی و تصویری)، ساختار (پیوندهای اجتماعی بین کاربران که مستلزم تعاملات است) و زمینه (مکانی-زمانی و زمانی) طبقه‌بندی کرد. چندگانه های اجتماعی-اقتصادی). در حالی که اولی عمدتاً در مورد خود نقاط داده تشکیل دهنده است، دو مورد دوم (هر دو اطلاعات متنی تحت سناریوهای مختلف هستند) داده های صریح را در مورد ارتباط بالقوه بین نقاط داده ارائه می دهند. برای هر منبع داده ای (پلتفرم رسانه اجتماعی) مورد علاقه، چارچوب پیشنهادی به دست آوردن هم محتوا و هم اطلاعات زمینه ای برای درک دقیق شبکه اجتماعی را پیشنهاد می کند. پس از جمع‌آوری و پاک‌سازی داده‌ها، داده‌های ورودی بسیار بی‌ساختار و غیراستاندارد خواهند بود و بنابراین وارد شدن به جریان‌های کاری علم داده چالش برانگیز خواهند بود. که باید به صورت قالب‌های قابل خواندن ماشین-احتمالاً بردار- با استفاده از تکنیک‌های خاص نمایش ویژگی تبدیل شوند. برای روش‌های مختلف، تکنیک‌های مختلفی می‌تواند مورد استفاده قرار گیرد: از ویژگی‌های مهندسی شده با دست، تا جاسازی‌های از پیش آموزش‌دیده، و سایر تکنیک‌های انتها به انتها مانند رمزگذارهای خودکار. علاوه بر این، ادغام روش‌های مختلف می‌تواند به اشکال مختلف، از ساده‌ترین الحاق، تا تکنیک‌های پیچیده‌تر با استفاده از شبکه‌های عصبی اتفاق بیفتد.۱۳ ]. اگرچه کاربردهای یادگیری بدون نظارت خوشه‌بندی فضایی و همبستگی خودکار غیرمعمول نیست، هنوز ترجیح داده می‌شود که برچسب‌های معنایی مربوط به موضوعات مختلف مورد علاقه را برای درک بیشتر نقاط داده داشته باشیم. در شرایطی که حاشیه‌نویسی انسانی می‌تواند گران و چالش برانگیز باشد، برچسب‌گذاری نیمه خودکار با یادگیری انتقال، تولید برچسب شبه و/یا یادگیری فعال با استفاده از داده‌های خام یا ویژگی‌های چندوجهی تولید شده می‌تواند برای دور زدن کارآمد این بطری استفاده شود. فرآیند [ ۳۱ ، ۴۵ ، ۴۶ ، ۴۷ ، ۴۸ ، ۴۹]. علاوه بر این، فرآیند ساخت گراف از نزدیکی یا شباهت اطلاعات زمینه ای برای پیوند دادن نقاط داده به عنوان نمودار [چند-] استفاده می کند. زمینه‌سازی نقاط داده و ایجاد تصویری منسجم از مجموعه‌های داده، وظایف ضروری هستند، بدون آن‌ها وظیفه تحلیل داده‌ها در سطح برخورد با کیسه‌ای حاوی نقاط داده پودر مانند باقی می‌ماند. مجموعه داده‌های گراف می‌توانند در کارهای درون یابی و برون یابی ارزش اساسی داشته باشند، به سادگی برای انتشار یا انتقال اطلاعات از همسایگان یک نقطه داده به آن قرار می‌گیرند. در مواردی که برخی از ویژگی های گراف در یک نقطه داده وجود ندارد، یک نمایش گراف می تواند به ایجاد یکپارچگی و انسجام کمک کند. این امر به ویژه برای سناریوهای یادگیری نیمه نظارت شده در داده های رسانه های اجتماعی، که در آن ویژگی های گم شده می تواند بسیار رایج باشد، مهم است [۵۰ ]. قبل از ذخیره سازی نتایج به عنوان مجموعه داده های گراف نسبت داده شده معتبر با ساختارهای گراف ( جی،آ) و ویژگی های گره ( ایکس،Y) مجموعه ای از فرآیندها برای بازرسی کمی و کیفی کیفیت، سازگاری و اعتبار نتایج تولید شده ضروری است. این همچنین احتمالاً شامل انسان‌ها در حلقه می‌شود.
بقیه این دستنوشته هر جزء را به تفصیل با نمونه‌های خاصی که برای استفاده از ارزش‌ها و ویژگی‌های میراث نقشه‌برداری طراحی شده است توضیح می‌دهد (مانند انتخاب سه شهر در بخش ۲٫۲ ، انتخاب فلیکر به عنوان منبع داده در بخش ۲٫۳) . و تصمیمات مدل های ML از پیش آموزش دیده در بخش ۲٫۴ و بخش ۲٫۵ ). با این حال، در اصل، مطالعه موردی نمونه سازی شده و فناوری مورد استفاده را می توان بر اساس موارد استفاده واقعی در طیف گسترده ای از سناریوها، با بهره گیری از مناسب ترین ابزارها و جدیدترین پیشرفت های تکنولوژی، مشخص، تقویت و به روز کرد. . این در بخش ۴٫۲ بیشتر مورد بحث قرار خواهد گرفت.

۲٫۲٫ انتخاب مطالعات موردی

بدون از دست دادن کلیت، این تحقیق سه شهر در اروپا و چین را که مربوط به WH و HUL یونسکو هستند به عنوان مطالعات موردی انتخاب کرد: آمستردام (AMS)، هلند. سوژو (SUZ)، چین؛ و ونیز (VEN)، ایتالیا. هر سه شهر خود به طور کامل یا جزئی در WHL ثبت شده اند، مانند ونیز و مرداب آن ( https://whc.unesco.org/en/list/394 ، دسترسی به ۸ مارس ۲۰۲۲) و منطقه حلقه کانال قرن هفدهم آمستردام در داخل Singelgracht ( https://whc.unesco.org/en/list/1349/ ، قابل دسترسی در ۸ مارس ۲۰۲۲)، یا شامل WHL در چندین بخش از شهر، مانند باغ های کلاسیک سوژو ( http: //whc.unesco.org/en/list/813، در ۸ مارس ۲۰۲۲ مشاهده شد)، گونه‌شناسی فضایی مختلف میراث فرهنگی را در رابطه با بافت شهری آن نشان می‌دهد [ ۵۱ ، ۵۲ ].
همانطور که در جدول ۱ نشان داده شده است ، این سه مورد دارای مقیاس های بسیار متفاوتی هستند، با این حال همه به شدت رابطه بین بافت شهری و سیستم آب را نشان می دهند. جالب توجه است که آمستردام و سوژو به ترتیب توسط رسانه ها و مردم به عنوان ” ونیز شمال/شرق ” شناخته شده اند. علاوه بر این، مفهوم OUV معرفی شده در بخش ۱ اهمیت فرهنگی اصلی خواص WH را نشان می دهد. OUV یک ملک با ده معیار انتخاب توجیه می‌شود، که در آن معیارهای (i) – (vi) ارزش‌های فرهنگی مختلف را نشان می‌دهند و معیارهای (vii) – (x) معیارهای طبیعی [ ۲ ، ۵۳ ، ۵۴ ، ۵۵ ]، همانطور که توضیح داده شد. در جدول پیوست A3. سه مورد منتخب شامل طیف گسترده‌ای از معیارهای انتخاب OUV میراث فرهنگی است که دلالت بر بازنمایی مجموعه داده‌های ساخته‌شده در این مطالعه دارد.

۲٫۳٫ جمع آوری داده ها و پیش پردازش

مطالعات متعددی مجموعه داده‌های منبع باز را از پلتفرم رسانه اجتماعی اشتراک‌گذاری تصویر فلیکر به دلیل داده‌های تصویر با کیفیت بالا، ابرداده‌های قابل جستجو و رابط برنامه‌نویسی کاربردی مناسب (API) جمع‌آوری، حاشیه‌نویسی و توزیع کرده‌اند، اگرچه اشکالات احتمالی آن شامل نسبتاً پایین است. محبوبیت، پوشش اجتماعی و جغرافیایی محدود کاربران، و مقادیر نامتعادل اطلاعات تصاویر و متون [ ۵۶ ، ۵۷ ، ۵۸ ، ۵۹ ]. مجموعه ای از مجموعه داده های مبتنی بر فلیکر می تواند شامل MirFlickr-1M [ ۶۰ ]، NUS-WIDE [ ۶۱ ]، Flickr [ ۶۲ ]، ImageNet باشد .[ ۶۳ ، ۶۴ ]، شیء مشترک مایکروسافت در زمینه ( MS COCO ) [ ۵۷ ]، Flickr30k [ ۶۵ ]، SinoGrids [ ۶۶ ]، و GRAPH Saint [ ۶۷ ]] و غیره. این مجموعه داده ها حاوی یک یا چند مورد از اطلاعات بصری، معنایی، اجتماعی و/یا جغرافیایی UGC به طور گسترده مورد استفاده، آزمایش قرار می گیرند، اما گاهی اوقات توسط جوامع مختلف ML از جمله Computer Vision، Multi-Modal Machine Learning و یادگیری ماشین روی نمودارها با این حال، آن‌ها کم و بیش برای محک زدن وظایف عمومی ML و آزمایش الگوریتم‌های محاسباتی مناسب هستند، که لزوماً برای مطالعات میراث و شهری ساخته نشده‌اند. از سوی دیگر، انگیزه جمع‌آوری داده‌ها در این تحقیق، ارائه مجموعه‌های داده‌ای است که هم می‌تواند مستقیماً برای جوامع ML به عنوان یک بستر آزمایشی قابل استفاده باشد و هم از نظر نظری برای محققان میراث فرهنگی و شهری آموزنده باشد تا در مورد اطلاع‌رسانی به تصمیم‌گیری نتیجه‌گیری کنند. روند. از این رو،بخش ۲٫۱ . احتمالات بیشتر برای ادغام سایر مجموعه داده‌های موجود و داده‌ها از منابع دیگر در پاسخ به محدودیت‌های Flickr به طور خلاصه در بخش ۴٫۲ بررسی خواهد شد .
کتابخانه پایتون FlickrAPI ( https://stuvel.eu/software/flickrapi/ ، دسترسی به ۸ مارس ۲۰۲۲) برای دسترسی به روش API ارائه شده توسط Flickr ( https://www.flickr.com/services/api/ ، قابل دسترسی ) استفاده شد. در ۸ مارس ۲۰۲۲)، با استفاده از مکان‌های جغرافیایی در جدول ۱ به‌عنوان مرکز برای جستجوی حداکثر ۵۰۰۰ شناسه از تصاویر برچسب‌گذاری‌شده جغرافیایی در یک شعاع ثابت که منطقه اصلی شهری را پوشش می‌دهد، تا مجموعه داده‌های قابل مقایسه و سازگار از سه شهر تشکیل شود. از آنجایی که تنها ۴۲۲۹ شناسه در زمان جمع آوری داده ها در سوژو یافت شد که منعکس کننده استفاده نسبتاً اندک از Flickr در چین است. برای آزمایش مقیاس پذیری گردش کار روش شناختی، مجموعه داده بزرگتر دیگری بدون محدودیت شماره شناسه نیز در ونیز (VEN-XL) جمع آوری شده است. فقط تصاویر با aپرچم candownload نشان‌داده‌شده توسط مالک، با رعایت حریم خصوصی و حق نسخه‌برداری کاربران فلیکر، بیشتر بررسی شد. اطلاعات زیر از هر پست جمع آوری شد: شناسه مالک. مکان ثبت شده مالک در فلیکر؛ عنوان، توضیحات و برچسب های ارائه شده توسط کاربر؛ برچسب جغرافیایی تصویر؛ علامت گذاری زمانی که تصویر گرفته شده است، و آدرس های اینترنتی برای دانلود مربع بزرگ (۱۵۰ × ۱۵۰ پیکسل) و کوچک ۳۲۰نسخه های (۳۲۰ × ۲۴۰ پیکسل) تصویر اصلی. علاوه بر این، لیست دوستان عمومی و اشتراک همه مالکان بازیابی شده مورد پرس و جو قرار گرفت، در حالی که تمام اطلاعات شخصی با توجه به خط مشی رازداری فقط به عنوان یک شناسه [نیمه] ناشناس در نظر گرفته شد. روش جمع آوری داده ها به ترتیب از ۲۸ دسامبر ۲۰۲۰ تا ۱۰ ژانویه ۲۰۲۱ و ۱۰ فوریه ۲۰۲۲ تا ۲۵ فوریه ۲۰۲۲ انجام شد. اولین عکس‌های جمع‌آوری‌شده به سال‌های ۱۹۴۶ در AMS، ۲۰۰۷ در SUZ، ۱۹۵۴ در VEN، و ۱۸۷۵ در VEN-XL برمی‌گردد، و برای همه شهرها جدیدترین عکس‌ها در سال‌های ۲۰۲۱-۲۰۲۱ گرفته شده‌اند.
فیلدهای متنی بازیابی شده از توضیحات ، عنوان و برچسب‌ها می‌توانند اطلاعات مفیدی را ارائه دهند، اما همه پست‌ها این فیلدها را ندارند، و همه پست‌ها لزوما برای بیان افکار و به اشتراک گذاشتن دانش در مورد مکان نوشته نشده‌اند (معتبر در زمینه از این مطالعه). پس از ضبط زبان اصلی پست‌ها در سطح جمله با استفاده از Google Translator API از کتابخانه Deep Translator Python، فیلدهای متنی پست‌ها پاک، ترجمه و در یک فیلد متن اصلاح شده به عنوان داده‌های متنی خام انگلیسی ادغام شدند ( https:/ /deep-translator.readthedocs.io/en/latest/، قابل دسترسی در ۸ مارس ۲۰۲۲). علاوه بر این، بسیاری از پست های به اشتراک گذاشته شده توسط یک کاربر به طور همزمان آپلود شدند، بنابراین فیلدهای متنی تکراری یکسانی برای همه آنها وجود داشت. برای رسیدگی به چنین افزونگی، یک مجموعه داده جداگانه از تمام داده های متنی پردازش شده منحصر به فرد در سطح جمله برای هر شهر ذخیره شد، در حالی که شناسه پست اصلی هر جمله علامت گذاری شده بود و به راحتی قابل ردیابی بود.
شرح مفصلی از روش‌های روش‌های پیش پردازش و جمع‌آوری داده‌ها را می‌توان در پیوست A یافت . جدول ۲ تعداد نمونه داده ها (پست ها) و مالکان (کاربران) را برای سه شهر مورد مطالعه در هر مرحله نشان می دهد. توجه داشته باشید که تعداد صاحبان پست در شهرهای مختلف نسبتا نامتعادل است. از نظر شهودی، تعداد بیشتری از مالکان می‌توانند پوشش بهتری از گروه‌های اجتماعی را پیشنهاد کنند و بازنمایی بهتری برای مجموعه داده‌ها ارائه دهند. با این حال، از آنجایی که واحد نقاط داده در این مطالعه یک پست واحد است، نه یک کاربر منحصر به فرد رسانه اجتماعی (ناشر محتوا)، می توان فرض کرد که دومی فقط اطلاعات زمینه ای کافی [اجتماعی] را برای اولی فراهم می کند.
برای توصیف رسمی داده‌ها، تعریف مسئله، و پیشنهاد یک گردش کار قابل تعمیم به عنوان یک چارچوب روش‌شناختی، از نمادهای ریاضی در بقیه این مقاله استفاده می‌شود. از آنجایی که فرآیند یکسان برای هر سه شهر (و احتمالاً برای سایر موارد انتخاب نشده در سراسر جهان) معتبر است و دقیقاً سه بار تکرار شده است، هیچ تمایزی بین شهرها انجام نخواهد شد، به جز اصلی بودن مجموعه‌هایی که اندازه نمونه را منعکس می‌کنند. بگذارید شاخص یک نمونه عمومی از مجموعه داده برای یک شهر باشم ، سپس داده‌های خام آن را می‌توان به صورت چندگانه نشان داد. دمن=(منمن،اسمن،تومن،تیمن،لمن)،دمن∈D={د۱،د۲،…،دک}، که در آن K اندازه نمونه مجموعه داده در یک شهر است (همانطور که در جدول ۲ نشان داده شده است )، منمنیک تانسور سه بعدی در اندازه تصویر با سه کانال RGB است، اسمن={🔻من(۱)،🔻من(۲)،…،🔻من(|اسمن|)}یااسمن=⌀مجموعه ای از جملات انگلیسی بازبینی شده است که همچنین می تواند مجموعه ای خالی برای نمونه ها بدون داده های متنی معتبر باشد، تومن∈Uیک شناسه کاربری است که یک نمونه از مجموعه کاربر است U={μ۱،μ۲،…،μ|U|}، تیمن∈تییک مهر زمانی است که یک نمونه از مجموعه سفارش‌داده‌شده همه مُهرهای زمانی منحصربه‌فرد است تی={τ۱،τ۲،…،τ|تی|}از مجموعه داده در سطح هفته ها و لمن=(ایکسمن،yمن)مختصات جغرافیایی عرض جغرافیایی است ( yمن) و طول جغرافیایی ( ایکسمن) علامت گذاری موقعیت جغرافیایی پست. یک نامگذاری کامل از تمام نمادهای استفاده شده در این مقاله را می توان در جدول A1 و جدول A2 ضمیمه یافت . شکل ۲ جریان داده های یک پست نمونه در ونیز را نشان می دهد که به طور رسمی در بخش های بعدی توضیح داده خواهد شد.

۲٫۴٫ تولید ویژگی چند وجهی

۲٫۴٫۱٫ ویژگی های بصری

Places365 یک مجموعه داده شامل ۱٫۸ میلیون تصویر از ۳۶۵ دسته صحنه است که شامل مجموعه نسبتاً جامعی از مکان های داخلی و خارجی است [ ۶۸ ، ۶۹ ]. مقوله ها می توانند برای مطالعات شهری و میراث برای شناسایی صحنه های به تصویر کشیده شده از تصاویر و برای استنتاج بیشتر ویژگی های میراث آموزنده باشند [ ۵ ، ۲۶ ]. چند مدل شبکه عصبی کانولوشنال (CNN) توسط ژو و همکاران از قبل آموزش داده شده بودند. [ ۶۹ ] با استفاده از ستون فقرات پیشرفته برای پیش بینی صحنه های به تصویر کشیده شده در تصاویر، به دقت بالای ۱ در حدود ۵۵٪ و دقت بالای ۵ در حدود ۸۵٪ می رسد. علاوه بر این، از همان مجموعه مدل های از پیش آموزش دیده برای پیش بینی ۱۰۲ ویژگی صحنه متمایز بر اساس ویژگی SUN استفاده شده است.مجموعه داده [ ۷۰ ، ۷۱ ]، به دقت بالای ۱ در حدود ۹۲٪ [ ۶۹ ]. این ویژگی‌های صحنه از نظر مفهومی با ویژگی‌های میراث متفاوت هستند، زیرا اولی بیشتر صفت‌ها و اجزای فعلی هستند که صحنه و فعالیت‌های در حال وقوع را توصیف می‌کنند. بنابراین، هم ارزش‌ها و هم ویژگی‌های میراث را می‌توان به طور موثر از آن استنباط کرد.

این مطالعه از مدل ResNet-18 آزاد منتشر شده [ ۷۲ ] استفاده کرد که از قبل در Places365 با PyTorch آموزش داده شد ( https://github.com/CSAILVision/places365 ، در ۹ مارس ۲۰۲۲ مشاهده شد). این مدل برای به دست آوردن سه بردار خروجی تنظیم شد: (۱) آخرین لایه softmax مدل ل۳۶۵×۱سبه عنوان logits (به طور رسمی توزیع احتمال) در تمام دسته های صحنه. (۲) آخرین لایه پنهان ساعت۵۱۲×۱vاز مدل؛ (۳) یک بردار ل۱۰۲×۱آبه عنوان لجیت بر روی تمام ویژگی های صحنه. چنین فرآیندی برای هر ورودی تصویر منمنرا می توان اینگونه توصیف کرد:

لمنس،لمنآ،ساعتمنv=fResNet-18(منمن|ΘResNet-18)،

یا ترجیحا در قالب برداری:

Lس،Lآ،اچv=fResNet-18([من۱،من۲،…،منک]|ΘResNet-18)،

جایی که

Lس:=[لمنس]۳۶۵×ک،Lآ:=[لمنآ]۱۰۲×ک،اچv:=[ساعتمنv]512×ک.

با توجه به اینکه مدل ها عملکرد معقولی را در دقت بالای n نشان می دهند ، برای اینکه ویژگی های بصری قابل توضیح باشند، یک فیلتر فعال سازی نرم n- hot وجود دارد.σ(n)بر روی هر دو خروجی لاجیت انجام می‌شود تا n ورودی پیش‌بینی فعال نگه داشته شود، در حالی که همه موارد دیگر بر اساس اطمینان پیش‌بینی‌های برتر هموار می‌شوند .n=5برای دسته بندی صحنه ها Lسو n=10برای ویژگی های صحنه Lآ). اجازه دهید حداکثر(ل،n)نشان می دهد nهفتمحداکثر عنصر یک بردار لاجیت d بعدیل(مجموع تمام ورودی های d ازلبرابر با ۱)، سپس فیلتر فعال سازی σ(n)را می توان اینگونه توصیف کرد:

σ(n)(لد×۱)=ل⊙متر+۱-لتیمترد-n(1د×۱-متر)،
متر:=[مترι]د×۱،مترι=۱اگرلι≥حداکثر(ل،n)0در غیر این صورت،

جایی که متریک بردار ماسک است که موقعیت n ورودی های بالا را نشان می دهد و لتیمتربه طور موثر اطمینان کل مدل برای پیش بینی های برتر است . توجه داشته باشید که این تابع همچنین می تواند یک ماتریس را به عنوان ورودی بگیرد و آن را به عنوان چندین بردار ستون پردازش کند تا به عقب متصل شوند.

علاوه بر این، از آنجایی که مجموعه داده Places365 برای کارهای تشخیص صحنه به جای تشخیص چهره طراحی شده است [ ۶۹ ]]، مدل‌های از قبل آموزش‌دیده‌شده روی آن ممکن است زمانی که یک تصویر جدید عمدتاً از چهره‌هایی به‌عنوان «تصاویر معمولی گردشگری» و عکس‌های خودگرفته تشکیل شده باشد، گیج شوند، که در مطالعات موردی به عنوان مقاصد گردشگری محبوب غیرمعمول نیست. از آنجایی که هدف نهایی از ساخت چنین مجموعه‌ای از داده‌ها پیش‌بینی دقیق صحنه‌ای نیست که هر تصویر به تصویر می‌کشد، بلکه برای کمک به استنتاج ارزش‌ها و ویژگی‌های میراث، صرفاً حذف آن تصاویری که دارای بخش قابل توجهی از چهره‌ها هستند، ناعادلانه خواهد بود. در عوض، وجود انسان ها در تصاویری که فعالیت های آنها را نشان می دهد، نشانه ای قوی از بعد ناملموس ویژگی های میراث است. تحت چنین ملاحظه‌ای، یک مدل Inception ResNet-V1 ( https://github.com/timesler/facenet-pytorch ، دسترسی به ۹ مارس ۲۰۲۲) از قبل در مجموعه داده VGGFace2 [ ۷۳ ] آموزش دیده بود.، ۷۴ ] برای ایجاد ویژگی هایی در مورد چهره های به تصویر کشیده شده در تصاویر استفاده شده است. یک وکتور سه بعدی fمنبرای هر ورودی تصویر به دست آمد منمن، جایی که ورودی اول غیر منفی است f1،من∈نتعداد چهره های شناسایی شده در تصویر، ورودی دوم را می شمارد f2،من∈[۰،۱]اطمینان مدل برای تشخیص چهره و ورودی سوم را ثبت می کند f3،من∈[۰،۱]نسبت مساحت تمام کادرهای مرزی چهره های شناسایی شده را به مساحت کل تصویر محاسبه می کند. به طور مشابه، فرمت برداری می تواند به صورت نوشته شود اف:=[fمن]۳×کدر کل مجموعه داده

در نهایت، تمام ویژگی‌های بصری به‌دست‌آمده به صورت عمودی به هم متصل شدند تا ویژگی بصری نهایی ایجاد شود ایکس۹۸۲×کدر مقابل:

ایکس۹۸۲×کدر مقابل=اچvتی،افتی،σ(۵)(Lس)تی،σ(۱۰)(Lآ)تیتی،

جایی که [·،·]نشان دهنده الحاق افقی ماتریس ها است.

این ماتریس نهایی قرار است در وظایف MML آینده به عنوان توصیفگر بردار محتویات بصری تک وجهی پست‌ها، با ویژگی‌های مخفی انتزاعی‌تر که فقط توسط ماشین‌ها قابل درک است و اطلاعات خاص‌تر در مورد دسته‌های پیش‌بینی‌شده قابل تفسیر توسط انسان، استفاده شود. که در ادبیات MML رایج است [ ۱۳ ]. همه مدل ها روی هر دو تست شده اند ۱۵۰×۱۵۰و ۳۲۰×۲۴۰تصاویر px برای مقایسه سازگاری ویژگی های تولید شده. گردش کار تولید ویژگی های بصری در قسمت بالای شکل ۲ نشان داده شده است.
۲٫۴٫۲٫ ویژگی های متنی
در دهه گذشته، مدل‌های از پیش آموزش‌دیده مبتنی بر توجه و ترانسفورماتور حوزه پردازش زبان طبیعی (NLP) را در اختیار گرفته‌اند و عملکرد مدل‌ها را هم در وظایف کلی یادگیری ماشین و هم در سناریوهای یادگیری انتقالی خاص دامنه افزایش می‌دهند [ ۷۵ ]. ]. به عنوان نسخه اولیه، بازنمایی رمزگذار دوطرفه از ترانسفورماتورها (BERT) [ ۷۶ ] هنوز به عنوان یک مدل پایه قدرتمند برای تنظیم دقیق در مجموعه داده های پایین دستی خاص و برای وظایف مختلف NLP در نظر گرفته می شود. به طور خاص، خروجی در نشانه [CLS] مدل های BERT به عنوان یک نمایش موثر از کل جمله ورودی در نظر گرفته می شود که به طور گسترده برای کارهای طبقه بندی استفاده می شود [ ۷۷ ، ۷۸ ]]. در حوزه مطالعات میراث، بای و همکاران. [ ۷۹ ] BERT را بر روی مجموعه داده WHOSe Heritage که آنها از سند کتیبه میراث جهانی یونسکو ساخته اند، تنظیم دقیق کرد، و به دنبال آن یک طبقه بندی کننده پرسپترون چند لایه (MLP) برای پیش بینی معیارهای انتخاب OUV که یک جمله به آن مربوط می شود، نشان داد: ۱ دقت در حدود ۷۱٪ و دقت بالا ۳ در حدود ۹۴٪.

این مطالعه از مدل BERT منتشر شده به‌خوبی تنظیم شده در WHOSe Heritage با PyTorch استفاده کرد ( https://github.com/zzbn12345/WHOSe_Heritage ، در ۱۰ مارس ۲۰۲۲ مشاهده شد). مدل BERT هر دو مجموعه جملات را در بر گرفت اسمنو جملات فردی مجموعه ها {🔻من(۱)،🔻من(۲)،…،🔻من(|اسمن|)}به ترتیب ورودی‌های سطح پاراگراف و جمله برای مقایسه سازگاری در خروجی‌های پیش‌بینی‌شده این مجموعه داده جدید. علاوه بر این، کل مجموعه جملات را در نظر بگیرید اسمنبه عنوان ورودی، بردار خروجی ۷۶۸ بعدی ساعت۷۶۸×۱برتنشانه [CLS] بر روی نمونه هایی که داده های متنی معتبری دارند بازیابی شد:

ساعتمنبرت=fبرت(اسمن|Θبرت)،جایی کهfبرت(⌀|Θبرت)=۰۷۶۸×۱،

یا ترجیحا در قالب برداری:

اچب=fبرت([اس۱،اس۲،…،اسک]|Θبرت)،جایی کهاچب:=[ساعتمنبرت]۷۶۸×ک.
علاوه بر این، زبان اصلی هر جمله ممکن است اطلاعات اضافی را برای بافت کلامی پست‌ها فراهم کند که برای شناسایی و مقایسه موثر افراد محلی و گردشگران مفید است. یک وکتور سه بعدی oمن∈{۰،۱}۳با Google Translator API به دست آمد. این سه ورودی به ترتیب مشخص می‌کردند که آیا جملاتی به انگلیسی، زبان‌های محلی (به ترتیب هلندی، چینی یا ایتالیایی) و سایر زبان‌ها در مجموعه وجود دارد یا خیر. اسمن. عناصر بردار oمنیا فرم ماتریس O:=[oمن]۳×کمی تواند در محدوده ای از صفرها (زمانی که اصلاً داده های متنی وجود نداشت) تا همه (جایی که پست شامل زبان های مختلف در جملات جداگانه است) باشد.

مشابه ویژگی های بصری، ویژگی های متنی نهایی ایکس۷۷۱×کتکسرا می توان به صورت زیر بدست آورد:

ایکس۷۷۱×کتکس=اچبتی،Oتیتی.
گردش کار تولید ویژگی های متنی در قسمت پایین شکل ۲ نشان داده شده است.
۲٫۴٫۳٫ ویژگی های متنی

همانطور که در بخش ۲٫۳ ذکر شد ، شناسه کاربر تومنو مهر زمانی تیمناز یک پست هر دو نمونه ای از مجموعه مربوطه خود هستند Uو تی، از آنجایی که چندین پست می تواند توسط یک کاربر ارسال شود و چندین تصویر می تواند در طول یک هفته گرفته شود. برای کمک به فرمول‌بندی و تعمیم مسئله تحت عمل پایگاه‌داده رابطه‌ای [ ۸۰ ]، اطلاعات هر دو را می‌توان به عنوان جاسازی‌های تکی تبدیل کرد. U:=[توj،من]|U|×ک∈{۰،۱}|U|×کو تی:=[تیک،من]|تی|×ک∈{۰،۱}|تی|×ک، به طوری که:

توj،من=۱اگرتومن=μj∈U0در غیر این صورت،
وتیک،من=۱اگرتیمن=τک∈تی۰در غیر این صورت.

علاوه بر این، بخش ۲٫۳ و پیوست A نیز مجموعه ای از مخاطبین و گروه های عمومی همه کاربران را ذکر کرده است. μjاز مجموعه U. برای ساده نگه داشتن مشکل، فقط جفت‌های تماس مستقیم برای مدل‌سازی ساختار اجتماعی پشتیبان کاربران در نظر گرفته شد و به طور موثر سایر مخاطبین کاربر را فیلتر کرد. μjبود که در مجموعه مورد علاقه نبود U، منجر به ایجاد یک ماتریس مجاورت در بین کاربران می شود آU:=[آj،j”U]|U|×|U|∈{۰،۱}|U|×|U|،j،j”∈[۱،|U|]نشان دادن دوستی مستقیم آنها:

آj،j”U=1اگرμjوμj”هستندمخاطبیاj=j”0در غیر این صورت.

اجازه دهید من(μj)مجموعه ای از گروه های عمومی یک کاربر را نشان می دهد μjبه شرح زیر است (می تواند یک مجموعه خالی باشد اگر μjهیچ گروهی را دنبال نمی کند) و اجازه دهید IoU(آ،ب)نشان دهنده شاخص جاکارد (اندازه تقاطع بر اندازه اتحادیه) دو مجموعه عمومی آ،ب:

IoU(آ،ب)=|آ∩ب||آ∪ب|+ε،

جایی که εیک عدد کوچک برای جلوگیری از تقسیم صفر است. سپس یک ماتریس مجاورت وزنی دیگر در بین کاربران می تواند ساخته شود: آU”:=[آU”j،j”]|U|×|U|∈[۰،۱]|U|×|U|،j،j”∈[۱،|U|]، علامت گذاری علایق متقابل بین کاربران به عنوان اشتراک گروهی در فلیکر:

آU”j،j”=IoU(من(μj)،من(μj”)).

برای ساده کردن بیشتر مشکل، اگر چه موقعیت جغرافیایی لمن=(ایکسمن،yمن)از هر پست معمولاً در یک فضای جغرافیایی دوبعدی پیوسته توزیع می‌شود، جمع‌آوری و گسسته‌سازی بیشتر توزیع در یک انتزاع توپولوژیکی شبکه فضایی [ ۳۴ ، ۳۵ ، ۸۱ ] سودمند خواهد بود ، که همچنین ثابت شده است که در فضای شهری مؤثر است. تجزیه و تحلیل، شامل اما نه محدود به نحو فضا [ ۸۲ ، ۸۳ ، ۸۴ ، ۸۵ ]. کتابخانه پایتون OSMnx ( https://osmnx.readthedocs.io/en/stable/ ، دسترسی به ۲۸ فوریه ۲۰۲۲) برای بررسی داده های شبکه فضایی ساده شده در OpenStreetMap از جمله تمام وسایل حمل و نقل استفاده شد [ ۸۶] در هر شهر با همان مکان مرکزی و شعاع تشریح شده در بخش ۲٫۳ . این عملیات به طور موثر یک شبکه فضایی را به عنوان یک نمودار وزنی بدون جهت ذخیره کرد جی۰=(V0،E0،w0)، جایی که V0={υ۱،υ۲،…،υ|V0|}مجموعه ای از تمام گره های تقاطع خیابان است، E0⊆V0×V0مجموعه ای از تمام پیوندهایی است که احتمالاً دو گره فضایی را به هم متصل می کند (با انواع مختلف حمل و نقل مانند پیاده روی، دوچرخه سواری و رانندگی)، و w0∈آر+|E0|یک بردار با ابعادی مشابه با کاردینالیته مجموعه لبه است که میانگین زمان سفر مورد نیاز بین جفت گره ها (وزن های عدم تشابه) را نشان می دهد. روش distance.nearest_nodes کتابخانه OSMnx برای بازیابی نزدیکترین گره های فضایی به هر مکان پست استفاده شد. لمن=(ایکسمن،yمن). تنها با حفظ گره‌های فضایی که حداقل یک نمونه داده ارسال شده در این نزدیکی را حمل می‌کنند، و وزن پیوند بین گره‌ها را محدود می‌کند تا زمان سفر در هر پیوند بیش از ۲۰ دقیقه نباشد، که فاصله زمانی راحت را تضمین می‌کند که محله‌ها و جوامع را تشکیل می‌دهد [ ۸۷ ]. ]، یک زیرگراف جی=(V،E،w)از جی۰می تواند ساخته شود، به طوری که V⊆V0،E⊆E0، و w∈[۰،۲۰٫۰]|E|. در نتیجه، یک ماتریس تعبیه شده داغ دیگر اس:=[سل،من]|V|×ک∈{۰،۱}|V|×کمی توان به دست آورد:

سل،من=۱اگررانزدیک ترینگرهبهنقطهلمناستυل∈V0در غیر این صورت.
ویژگی های زمینه ای ساخته شده به عنوان ماتریس/گراف بیشتر در بخش ۲٫۶ برای پیوند دادن پست ها به یکدیگر استفاده می شود.

۲٫۵٫ تولید برچسب شبه

۲٫۵٫۱٫ ارزش های میراث به عنوان معیارهای انتخاب OUV

دسته بندی های مختلفی در مورد ارزش های میراث (HV) توسط محققان ارائه شده است [ ۳ ، ۴ ، ۵۳ ، ۵۴ ]. برای ساده نگه داشتن گام اولیه، این مطالعه به طور دلخواه تعریف ارزش در WHL یونسکو را با توجه به ده معیار انتخاب OUV، همانطور که در جدول A3 پیوست با یک کلاس دیگر فهرست شده است، اعمال کرد.سناریوهایی را نشان می دهد که در آن هیچ معیار انتخاب OUV با محدوده یک جمله مطابقت ندارد (که منجر به یک دسته ۱۱ کلاسه می شود). لازم به ذکر است که معیارهای انتخاب OUV و بیانیه های مربوط به OUV شامل عناصری هستند که می توانند به عنوان ارزش های میراث یا ویژگی های میراث شناسایی و طبقه بندی شوند. بنابراین، آنها لزوما ارزش میراث به خودی خود نیستند، بحث مفصلی که در مورد آن از محدوده این مقاله خارج می شود. با این حال، برای اهداف عمل‌گرایانه نشان دادن یک چارچوب، این مطالعه این تمایز را حذف می‌کند و معیارهای انتخاب OUV را به عنوان یک پروکسی HV در طول تولید برچسب در نظر می‌گیرد. گروهی از مدل‌های ML برای انجام چنین پیش‌بینی‌هایی توسط بای و همکاران آموزش و تنظیم شدند. [ ۷۹ ] همانطور که در بخش ۲٫۴٫۲ معرفی شد. به جز BERT که قبلاً برای تولید ویژگی‌های متنی همانطور که در بالا ذکر شد استفاده شده است، یک تنظیم دقیق مدل زبان جهانی (UMLFiT) [ ۸۸ ] نیز آموزش داده شده و تنظیم شده است، که به عملکرد مشابهی در دقت رسیده است. علاوه بر این، مشخص شده است که میانگین اطمینان هر دو مدل BERT و ULMFiT در کار پیش‌بینی، همبستگی قابل‌توجهی با ارزیابی کارشناسان، حتی در داده‌های رسانه‌های اجتماعی نشان داد [ ۷۹ ]. این نشان می‌دهد که ممکن است بتوان از هر دو مدل آموزش‌دیده برای تولید برچسب‌هایی درباره ارزش‌های میراث در یک محیط یادگیری فعال نیمه‌نظارت‌شده استفاده کرد [ ۴۵ ، ۸۹ ]، زیرا این کار برای کارگران بیش از حد دانش‌بگیر و در عین حال زمان‌بر است. برای کارشناسان [ ۹۰ ].

مرحله تولید شبه برچسب می تواند به صورت زیر فرموله شود:

yمنبرت=gبرت(اسمن|Θبرت)اگراسمن≠⌀۰۱۱×۱در غیر این صورت،
yمنULMFiT=gULMFiT(اسمن|ΘULMFiT)اگراسمن≠⌀۰۱۱×۱در غیر این صورت،
YHV:=[yمنHV]11×ک،yمنHV=yمنبرت+yمنULMFiT2.

جایی که g(∗)یک تابع سرتاسری است که شامل مدل های از پیش آموزش دیده و طبقه بندی کننده های MLP می شود. و yمن(∗)یک بردار لاجیت ۱۱ بعدی به عنوان پیش بینی های برچسب نرم است. اجازه دهید argmx(ل،n)تابعی را نشان دهید که مجموعه شاخص بزرگترین n عنصر یک بردار را برمی گرداندل، همراه با تعریف قبلی حداکثر(ل،n)، اطمینان و [عدم توافق] مدل ها برای پیش بینی های برتر را می توان به صورت زیر محاسبه کرد:

کHV:=[κمنHV]2×ک،κمنHV:=[κمنHV(0)،κمنHV(1)]تی،
κمنHV(0)=∑n0=1nحداکثر(yمنبرت،n0)+حداکثر(yمنULMFiT،n0)2،
κمنHV(1)=IoU(argmx(yمنبرت،n)،argmx(yمنULMFiT،n)).
این ماتریس نشانگر اطمینان کHVاحتمالا می تواند به عنوان فیلتری برای برچسب های ارزش های میراث در نظر گرفته شود YHV، فقط نمونه‌هایی را با توافق بین حاشیه‌نویس (مدل) بالا [ ۴۶ ] به‌عنوان برچسب‌های «حقیقت پایه» [شبه-] نگه دارند، در حالی که بقیه را بدون برچسب [ ۴۹ ، ۹۱ ] در نظر بگیریم.
۲٫۵٫۲٫ ویژگی های میراث به عنوان منظره ترسیم شده
ویژگی‌های میراث (HA) همچنین دارای سیستم‌های دسته‌بندی چندگانه هستند [ ۵ ، ۲۶ ، ۹۲ ، ۹۳ ، ۹۴ ]، و مسلماً مبهم‌تر از HV تعریف شده‌اند. برای سادگی، این مطالعه به طور دلخواه تعاریف ویژگی Veldpaus [ ۵ ] و Ginzarly و همکاران را ترکیب کرد. [ ۲۶ ]، و یک دسته ۹ طبقه از ویژگی های ملموس و/یا ناملموس را از یک تصویر قابل مشاهده نگه داشت. به‌طور دقیق‌تر، این دسته باید به‌عنوان «مناظر ترسیم‌شده» یک تصویر قاب شود [ ۲۶] که احتمالاً می توان ویژگی های میراث را از آن القا کرد. خود صحنه های به تصویر کشیده شده هنوز ویژگی های میراث معتبری نیستند. این بحث معنایی/فلسفی اما از حوصله این نوشتار خارج است. تعاریف ۹ دسته در جدول A4 پیوست آمده است.

مجموعه داده تصویری جمع آوری شده در طرابلس، لبنان و طبقه بندی شده با حاشیه نویسی مبتنی بر متخصص ارائه شده توسط Ginzarly و همکاران. [ ۲۶ ] برای آموزش چند مدل ML برای تکرار رفتار متخصصان در طبقه‌بندی مناظر به تصویر کشیده شده با کتابخانه پایتون Scikit-learn استفاده شد [ ۹۵ ]. برای هر تصویر، یک برچسب کلاس منحصر به فرد ارائه شد که به طور موثر یک کار طبقه بندی چند کلاسه را تشکیل می دهد. همان نمایش بصری ۵۱۲ بعدی اچVمعرفی شده در بخش ۲٫۴٫۱ از تصاویر به عنوان ورودی تولید شد. طبقه‌بندی‌کننده‌هایی از جمله پرسپترون چند لایه (MLP) (شبکه عصبی کم عمق) [ ۹۶ ]، K-نزدیک‌ترین همسایه‌ها (KNN) [ ۹۷ ]، بیز ساده گوسی (GNB) [ ۹۸ ]، ماشین بردار پشتیبان (SVM) [ ۹۹ ]، تصادفی Forest (RF) [ ۱۰۰ ]، و Bagging Classifier [ ۱۰۱ ] با هسته SVM (BC-SVM) ابتدا برای فراپارامترهای بهینه با استفاده از اعتبارسنجی متقاطع ۱۰ برابری (CV) با جستجوی شبکه [ ۱۰۲ ] آموزش و تنظیم شدند. سپس، مدل‌های آموزش‌دیده به‌صورت جداگانه در تنظیمات یادگیری گروهی به‌عنوان رای‌گیری [ ۱۰۳ ] و طبقه‌بندی کننده انباشته [ ۱۰۴ ] قرار گرفتند.]. همه مدل‌های آموزش‌دیده بر روی مجموعه داده‌های اعتبارسنجی و آزمون برای ارزیابی عملکردشان مورد آزمایش قرار گرفتند. جزئیات مدل های یادگیری ماشین در پیوست B آورده شده است. هر دو مدل مجموعه بیشتر در تصاویر جمع آوری شده در این مطالعه استفاده شدند. مشابه برچسب های HV شرح داده شده در بخش ۲٫۵٫۱ ، مرحله تولید برچسب HA می تواند به صورت زیر فرموله شود:

yمنرای=ساعترای(ساعتمنV|Θرای،م،Θم)،
yمنپشته=ساعتپشته(ساعتمنV|Θپشته،م،Θم)،
YHA:=[yمنHA]9×ک،yمنHA=yمنرای+yمنپشته۲٫

جایی که ساعت(∗)یک مدل مجموعه ای است که تمام پارامترها را در بر می گیرد Θماز هر مدل ML در مجموعه م; و yمن(∗)یک بردار لاجیت ۹ بعدی به عنوان پیش بینی های برچسب نرم است. به طور مشابه، اطمینان مدل ها برای پیش بینی top -n است:

کHA=[κمنHA]2×ک،κمنHA=[κمنHA(0)،κمنHA(1)]تی،
κمنHA(0)=∑n0=1nحداکثر(yمنرای،n0)+حداکثر(yمنپشته،n0)2،
κمنHA(1)=IoU(argmx(yمنرای،n)،argmx(yمنپشته،n)).
این ماتریس کHAهمچنین می تواند فیلتر برای برچسب های ویژگی های میراث در نظر گرفته شود YHA.

۲٫۶٫ ساخت چند گراف

سه نوع شباهت/روابط بین پست‌ها برای ایجاد پیوندهایی که گره‌های پست را به هم متصل می‌کنند در نظر گرفته شد: شباهت زمانی (پست‌هایی با تصاویر گرفته شده در همان دوره زمانی)، شباهت اجتماعی (پست‌هایی که متعلق به همان افراد، دوستان و افرادی هستند که متعلق به یکسان هستند. اشتراک علایق متقابل)، و شباهت فضایی (پست هایی با تصاویر گرفته شده در مکان های مشابه یا نزدیک). هر سه را می توان از اطلاعات زمینه ای در بخش ۲٫۴٫۳ استنباط کرد . در نتیجه، یک نمودار چند بعدی وزن دار بدون جهت (همچنین به عنوان نمودار چند بعدی [ ۴۴ ] شناخته می شود) با مجموعه گره های یکسان و سه مجموعه پیوند متفاوت می تواند به عنوان جی=(V،{ETEM،ESOC،Eآبگرم}،{wTEM،wSOC،wآبگرم})، جایی که V={v1،v2،…،vک}مجموعه گره همه پست ها است، E(∗)⊆V×Vمجموعه تمام پیوندهایی است که دو پست از یک نوع شباهت و بردار وزن را به هم متصل می کند w(∗):=[wه(∗)]|E(∗)|×۱∈آر+|E(∗)|قدرت اتصالات را نشان می دهد. چند نمودار جیهمچنین می تواند به راحتی به سه نمودار وزن دار ساده بدون جهت تقسیم شود جیTEM=(V،ETEM،wTEM)، جیSOC=(V،ESOC،wSOC)، و جیآبگرم=(V،Eآبگرم،wآبگرم)در مورد هر نوع شباهت هر یک جی(∗)مربوط به یک ماتریس مجاورت وزنی است آ(∗):=[آمن،من”(∗)]ک×ک∈آر+ک×ک،من،من”∈[۱،ک]، به طوری که:

آمن،من”(∗)=wه(∗)اگرراههفتمعنصرازEاست(vمن،vمن”)،۰در غیر این صورت.
سه ماتریس مجاورت وزنی را می توان به ترتیب به صورت زیر بدست آورد:

۲٫۶٫۱٫ پیوندهای زمانی

اجازه دهید تی|تی|×|تی|یک ماتریس سه‌ضلعی متقارن را نشان می‌دهد که در آن ورودی‌های مورب همه ۱ هستند و ورودی‌های خارج از مورب غیر صفر همه هستند. αتی، جایی که αتی∈[۰،۱)یک اسکالر پارامتریک است:

تی|تی|×|تی|:=۱αتی۰…۰۰αتی۱αتی…۰۰۰αتی۱…۰۰⋮⋮⋮⋱⋮⋮۰۰۰…۱αتی۰۰۰…αتی۱،

سپس ماتریس مجاورت وزنی آک×کTEMبرای پیوندهای زمانی را می توان به صورت زیر فرموله کرد:

آTEM=تیتیتیتی،آTEM∈{۰،αتی،۱}ک×ک،

جایی که تی|تی|×کیک جاسازی یک مهر زمان برای پست های ذکر شده در معادله ( ۱۱ ) است. برای سادگی، αتیروی ۰٫۵ تنظیم شده است. با چنین ساختاری، تمام پست‌هایی که تصاویر در ابتدا از آن‌ها در یک هفته گرفته شده‌اند وزنی برابر خواهند داشت wهTEM=1اتصال آنها به جیTEMو پست هایی با تصاویری که در هفته های نزدیک به ترتیب زمانی گرفته شده اند دارای وزن هستند wه”TEM=0.5. با این حال، توجه داشته باشید که مفهوم « نزدیک » ممکن است لزوماً با هفته‌های زمانی مجاور مطابقت نداشته باشد، زیرا فاصله زمانی مهرهای زمانی که تاریخ عکس‌برداری را مشخص می‌کنند می‌تواند ماه‌ها و حتی سال‌ها در دوره‌های زمانی قبلی باشد. در موارد استفاده حساس به فواصل زمانی، مقدار αتیهمچنین می تواند وزن شود: به عنوان مثال، هر چه فاصله زمانی در واقع طولانی تر باشد، کوچکتر است αتیتبدیل می شود.

۲٫۶٫۲٫ پیوندهای اجتماعی

اجازه دهید U|U|×|U|یک ماتریس متقارن را به عنوان ترکیبی خطی از سه ماتریس نشان دهید که روابط اجتماعی بین کاربران را مشخص می کند:

U|U|×|U|=αU(1)من+αU(2)آU+αU(3)(آU”>βU)αU(1)+αU(2)+αU(3)،

جایی که من∈{۰،۱}|U|×|U|یک ماتریس مورب از ۱ برای رابطه خود است ، آU∈{۰،۱}|U|×|U|ماتریس ذکر شده در رابطه ( ۱۲ ) برای رابطه دوستی است . (آU”>βU)∈{۰،۱}|U|×|U|یک ماسک روی ماتریس است آU”در معادله ( ۱۴ ) برای رابطه نفع مشترک بالای یک آستانه معین معرفی شده است.βU∈(۰،۱)، و αU(1)،αU(2)،αU(3)∈آر+اسکالرهای پارامتریک برای متعادل کردن وزن روابط اجتماعی مختلف هستند. ماتریس مجاورت وزنی آک×کSOCبرای پیوندهای اجتماعی را می توان به صورت زیر فرموله کرد:

آSOC=UتیUU،آSOC∈[۰،۱]ک×ک،

جایی که U|U|×کتعبیه یک طرفه مالک/کاربر برای پست های ذکر شده در معادله ( ۱۰ ) است. برای سادگی، آستانه βUروی ۰٫۰۵ و اسکالرها تنظیم شده است αU(1)،αU(2)،αU(3)همه روی ۱ تنظیم شده اند. با چنین ساختاری، همه پست های آپلود شده توسط یک کاربر وزنی برابر خواهند داشت wهSOC=1اتصال آنها به جیSOC، پست های دوستان با علایق مشترک (از بیش از ۵٪ اشتراک گروه های مشترک) وزنی برابر با wه”SOC=23و پست‌های دوستانی که علایق مشترک کمی دارند یا افراد غریبه با علایق مشترک دارای وزن هستند wه”SOC=13.

۲٫۶٫۳٫ پیوندهای فضایی

اجازه دهید اس:=[سل،ل”]∈[۰،۱]|V|×|V|،ل،ل”∈[۱،|V|]یک ماتریس متقارن محاسبه شده با قوانین ساده را نشان می دهد که نزدیکی (رسانایی) فضایی گره ها را از نمودار فضایی نشان می دهد. جی=(V،E،w)ذکر شده در بخش ۲٫۴٫۳ ، که وزن آن w:=[wه]|E|×۱∈[۰،۲۰٫۰]|E|در ابتدا فاصله گره ها (مقاومت) را نشان داد:

سل،ل”=۲۰-wه۲۰اگرراههفتمعنصرازEاست(υل،υل”)،۰در غیر این صورت.

ماتریس مجاورت وزنی آک×کآبگرمبرای پیوندهای فضایی را می توان به صورت زیر فرموله کرد:

آآبگرم=استیاساس،آآبگرم∈[۰،۱]ک×ک،

جایی که اس|V|×کتعبیه یک داغ مکان مکانی برای پست های ذکر شده در معادله ( ۱۵ ) است. با چنین ساختاری، پست هایی که در همان گره فضایی قرار دارند وزنی برابر خواهند داشت wهآبگرم=۱که در جیآبگرمو پست‌های گره‌های فضایی مجاور بر اساس فاصله در حداکثر زمان حمل ۲۰ دقیقه به صورت خطی کاهش می‌یابند.

علاوه بر این، نمودار چندگانه جیمی تواند به عنوان یک گراف ساده ترکیبی ساده شود جی”=(V،E”)با یک ماتریس مجاورت باینری آ∈{۰،۱}ک×ک، به طوری که:

آ:=(آTEM>0)∨(آSOC>0)∨(آآبگرم>0)،

که دو گره از پست ها را در صورتی که حداقل در یک رابطه متنی متصل و مشابه باشند به هم متصل می کند.

همه نمودارها با کتابخانه پایتون NetworkX [ ۱۰۵ ] ساخته شدند. منطق ساخت نمودارهای مختلف به طور خلاصه در بخش ۱ توضیح داده شد : پست‌های نزدیک به یکدیگر (در زمینه‌های زمانی، اجتماعی یا مکانی) می‌توانند به طور قابل بحث در محتوایشان مشابه باشند، و بنابراین، در ارزش‌ها و ویژگی‌های میراثی نیز ممکن است مشابه باشند. انتقال. به جای اینکه این شباهت‌ها را زائد تلقی کنیم و به عنوان مثال، پست‌های تکراری توسط همان کاربر را حذف کنیم تا از سوگیری در تحلیل جلوگیری شود، مانند Ginzarly و همکاران. [ ۲۶ توضیح داده شد ، این مطالعه قصد دارد تا حد امکان از داده‌های موجود بهره ببرد، زیرا پست‌های مشابه ممکن است اطلاعات را تقویت و تقویت کنند، افزونگی‌ها و/یا تفاوت‌های ظریف را با استفاده از گراف پشتیبان جبران کنند. سازه های. در مراحل بعدی تجزیه و تحلیل، نمودار پست‌ها می‌تواند حتی با روش‌های خوشه‌بندی و تقسیم‌بندی نمودار [ ۴۴ ، ۱۰۶ ، ۱۰۷ ، ۱۰۸ ] درشت شود تا خلاصه‌ای مؤثر از پست‌های احتمالاً مشابه ارائه شود.

۳٫ تجزیه و تحلیل به عنوان بازرسی کیفی

۳٫۱٫ تجزیه و تحلیل سطح نمونه از مجموعه داده ها

۳٫۱٫۱٫ ویژگی های بصری و متنی ایجاد شده است

جدول ۳ سازگاری ویژگی های بصری و متنی ایجاد شده را نشان می دهد. ویژگی‌های بصری پیش‌بینی‌های صحنه و ویژگی را روی تصاویر با اندازه‌های متفاوت (۱۵۰ × ۱۵۰ و ۳۲۰ × ۲۴۰ پیکسل) مقایسه کردند. و ویژگی‌های متنی معیارهای انتخاب OUV را با پیش‌بینی‌های سطح جمله جمع‌آوری (متوسط) در هر جمله از مجموعه مقایسه کردند. {🔻من(۱)،🔻من(۲)،…،🔻من(|اسمن|)}و پیش‌بینی‌های سطح پاراگراف/پس از مجموعه اسمن.
هم برای پیش‌بینی صحنه و هم برای صفت، میانگین شاخص ژاکارد برتر همیشه بالاتر از top- n بود، با این حال، واریانس کوچک‌تر لزوم استفاده از top-n را ثابت کرد .پیش بینی به عنوان ویژگی توجه داشته باشید که هنگام تغییر شکل تصویر، پیش‌بینی ویژگی پایدارتر از پیش‌بینی صحنه بود، این احتمالاً به این دلیل است که ویژگی‌ها معمولاً ویژگی‌های سطح پایینی را توصیف می‌کنند که می‌توانند در چندین بخش در تصویر ظاهر شوند، در حالی که برخی از اطلاعات حیاتی برای قضاوت در صحنه تصویر ممکن است در طول برش و تغییر اندازه در مدل اصلی ResNet-18 گم شده است. با توجه به ثبات نسبتاً بالای عملکرد مدل و هزینه ذخیره‌سازی تصاویر زمانی که مجموعه داده‌ها در نهایت مقیاس می‌شوند (به عنوان مثال، VEN-XL)، تجزیه و تحلیل‌های زیر فقط بر روی تصاویر مربع کوچک‌تر ۱۵۰ × ۱۵۰ پیکسل انجام می‌شود.
شاخص ژاکارد بالای پیش‌بینی‌های OUV نشان داد که میانگین‌گیری ویژگی‌های متنی مشتق‌شده از جملات فرعی یک پاراگراف، عملکرد مشابهی را برای تغذیه مستقیم کل پاراگراف در مدل‌ها به دست می‌دهد، به‌ویژه زمانی که سه پیش‌بینی برتر مورد توجه اصلی باشند. توجه داشته باشید که ثبات بیشتر در سوژو عمدتاً نتیجه نسبت بیشتر پست‌هایی است که فقط از یک جمله تشکیل شده است.
جدول ۴ آمار توصیفی نتایجی را ارائه می‌کند که با سناریوهای مختلف مقایسه نشده‌اند جدول ۳ مقایسه نشده اند.. فقط بخش کوچکی از پست‌ها چهره‌هایی را در آنها شناسایی کرده بودند. در حالی که آمستردام بالاترین نسبت تصاویر چهره (۱۷٫۹٪) را دارد، ونیز دارای میانگین مساحت بزرگ‌تری از چهره‌ها در تصویر است (یعنی بیشتر عکس‌های خودگرفته و عکس‌های توریستی). همچنین فرض می‌شود که این اعداد به ارتباط یک پست با ارزش‌ها و ویژگی‌های میراث مرتبط با فعالیت انسانی کمک می‌کنند. با توجه به زبان پست‌ها، آمستردام تعادلی بین مردم محلی هلندی زبان و گردشگران انگلیسی زبان، ونیز تعادل بین ایتالیایی‌زبان و گردشگران غیرایتالیایی زبان را نشان داد، در حالی که سوژو کمبود پست‌های چینی را نشان داد. این با محبوبیت فلیکر به عنوان رسانه اجتماعی در کشورهای مختلف مطابقت دارد.
۳٫۱٫۲٫ برچسب های شبه برای ارزش ها و ویژگی های میراث
همانطور که در بخش ۲٫۵٫۱ بحث شد ، فرآیند تولید برچسب این مقاله شامل حاشیه نویسان انسانی نمی شد. در عوض، از مدل‌های کاملاً آموزش‌دیده ML به‌عنوان کپی ماشینی از حاشیه‌نویس‌ها استفاده کرد و اطمینان و توافقات آن‌ها را به‌عنوان فیلتری برای حفظ برچسب‌های «کیفیت بالا» به عنوان برچسب‌های شبه در نظر گرفت. عملیات مشابهی را می توان در یادگیری نیمه نظارتی یافت [ ۴۸ ، ۴۹ ، ۹۱ ].
برای ارزش های میراث، میانگین اطمینان بالای ۳ κHV(0)>0.75و توافقنامه برتر ۳ (شاخص جاکارد) از κHV(1)>0.5به عنوان فیلتر برای YHV. این منجر به حدود ۴۰ تا ۵۰ درصد از نمونه‌ها با داده‌های متنی در هر شهر به عنوان “برچسب” و بقیه به عنوان “بدون برچسب” شد. شکل ۳ توزیع داده های “برچسب” را در مورد ارزش های میراث در هر شهر نشان می دهد. برای همه شهرها، ارزش‌های فرهنگی بسیار بیشتر از ارزش‌های طبیعی است که با وضعیت WH فرهنگی آنها سازگار است. با این حال، عناصر مرتبط با ارزش‌های طبیعی هنوز هم یافت می‌شوند و بیشتر مرتبط بودند. OUV واقعی درج شده در WHL ذکر شده در جدول ۱ می تواند به طور قابل توجهی وجود داشته باشد (به عنوان مثال، معیارهای (i)، (ii)، (iv) برای آمستردام) به جز معیار (v) در ونیز و سوژو، که ممکن است باعث شود با استفاده از مثال‌های نسبتاً کمتر و عملکرد ضعیف‌تر در سطح کلاس معیار (v) در مقاله اصلی [ ۷۹]. قابل توجه است که معیار (iii) در آمستردام و معیار (vi) در آمستردام و سوژو به طور رسمی ثبت نشده‌اند، اما به نظر می‌رسد که از رسانه‌های اجتماعی القا می‌شوند و تحقیقات بیشتر در مورد میراث خاص را دعوت می‌کنند. توزیع‌های ونیز و ونیز بزرگ در پیش‌بینی‌های سطح جمله مشابه‌تر بود (واگرایی کول‌بک-لیبلر DKL=0.002، مربع کای χ۲=۳۹٫۵۱۵) از سطح پسا ( DKL=0.051،χ۲=۵۱۸٫۸۹۵) که ممکن است ناشی از مجموعه خاصی از پست‌های نمونه‌برداری شده در مجموعه داده کوچک‌تر باشد.
برای ویژگی های میراث، جدول ۵ عملکرد مدل های ML ذکر شده در بخش ۲٫۵٫۲ و ضمیمه B را نشان می دهد. دو مدل مجموعه با تنظیمات رای گیری و انباشتگی به همان اندازه خوب و به طور قابل توجهی بهتر از سایر مدل ها عمل کردند (به جز دقت CV SVM)، که منطق استفاده از هر دو طبقه بندی کننده برای پیش بینی برچسب ویژگی میراث را اثبات می کند. میانگین بالای ۱ اطمینان از κHA(0)>0.7و top-1 توافق از κHA(1)=1به عنوان فیلتر برای YHA. این فیلتر باعث شد حدود ۳۵ تا ۵۰ درصد از تصاویر در هر شهر به عنوان “برچسب” و بقیه “بدون برچسب” باشند. شکل ۴ توزیع داده های “برچسب” را در مورد ویژگی های میراث در هر شهر نشان می دهد. قابل توجه است که اگرچه مدل‌ها فقط بر اساس داده‌های طرابلس آموزش داده شده‌اند، اما در موارد دیده نشده آمستردام، سوژو و ونیز به‌ترتیب عملکرد خوبی داشتند و به ترتیب صحنه‌های معمولی از ساختمان‌های تاریخی، عناصر معماری، و غذا و غیره را ثبت کردند. اگرچه نیمی از تصاویر جمع‌آوری‌شده به دلیل اطمینان کم به عنوان «بدون برچسب» در نظر گرفته شدند، نمونه‌های منفی لزوماً نادرست نیستند (مثلاً با بناها و بناها ). برای همه شهرها عناصر فرم شهری و فعالیت و انجمن مردمیغالب ترین طبقات هستند، مطابق با این واقعیت که اکثر تصاویر فلیکر در خیابان ها گرفته می شوند. از نمودارهای میله ای در شکل ۴ مشاهده می شود، کلاس ها نسبتا نامتعادل بودند، که نشان می دهد ممکن است تصاویر بیشتری از کلاس های کوچک مورد نیاز باشد یا حداقل در برنامه های آینده افزوده شود. علاوه بر این، توزیع های ونیز و ونیز بزرگ مشابه یکدیگر هستند ( DKL=0.076،χ۲=۱۸۸٫۲۴۱، نشان دهنده یک بازنمایی خوب از مجموعه داده کوچک نمونه برداری شده است.

۳٫۲٫ تجزیه و تحلیل در سطح نمودار مجموعه داده ها

۳٫۲٫۱٫ شبکه جغرافیایی Back-End

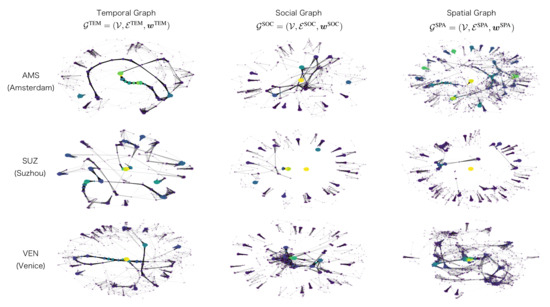
ساختارهای فضایی انتهایی مکان های پست به عنوان نمودار جی=(V،E،w)در شکل ۵ تجسم شدند . آمار نمودارهای بیشتر در همه شهرها در جدول ۶ آورده شده است. بافت شهری در ونیز بیشتر از دو شهر دیگر قابل مشاهده است، زیرا همیشه یک مؤلفه بزرگ غالب وجود دارد که بیشتر گره‌ها را در نمودار به هم متصل می‌کند و گره‌های جدا شده غیر مرتبط کمتری را تنها می‌گذارد. در حالی که در آمستردام، اجزای متصل کوچکتر همراه با یک بزرگ وجود دارد. و در سوژو، نمودار با اجزای کوچکتر حتی بیشتر تکه تکه شده است. این احتمالاً مربوط به توزیع مقاصد گردشگری است، که مجموعاً مناطق گردشگری پایین به بالا (یا ” شهر توریستی ” را همانطور که در Encalada-Abarca و همکاران پیشنهاد شده است، تشکیل می دهند [ ۱۰۹ ] پیشنهاد شده است)، که همچنین با گونه شناسی منطقه بندی اموال WH در مورد آن مطابقت دارد. مورفولوژی شهری [۵۱ , ۵۲]: برای ونیز، جزایر ونیزی همراه با یک تالاب اطراف بزرگتر در ملک WH (که قبلاً به عنوان منطقه اصلی نامیده می شد) گنجانده شده است و به طور کلی به عنوان یک مقصد گردشگری در نظر گرفته می شود. برای آمستردام، ملک WH تنها بخشی از شهر قدیمی است که در آن نقشه برداری شده است، جایی که گردشگران می توانند آزادانه در مناطقی که هنوز به عنوان مقاصد گردشگری جالب فهرست نشده اند، پرسه بزنند و عکس بگیرند. در حالی که برای سوژو، املاک WH خود باغ های تکه تکه شده ای هستند که در شهر قدیمی توزیع شده اند، همچنین نشان دهنده مقاصد اصلی بازدید شده توسط گردشگران (خارجی) هستند.
علاوه بر این، دو نوع نمودار اندازه رتبه‌ای که به ترتیب توزیع درجه و توزیع پست در هر گره را نشان می‌دهند، الگوهای مشابهی را نشان می‌دهند، که دومی دارای دم سنگین‌تر است، یک مشخصه معمولی شبکه‌های پیچیده در مقیاس بزرگ [ ۴۰ ، ۱۱۰ ]. ]، در حالی که شبکه‌های فضایی بک‌اند نسبتا منظم‌تر هستند.
۳٫۲٫۲٫ نمودارهای چندگانه و زیر نمودارهای اطلاعات متنی
جدول ۷ آمار نمودار سه زیر نمودار ساخته شده را نشان می دهد جیTEM،جیSOC،جیآبگرمبا انواع پیوندهای مختلف در چند گراف جی، و نمودار ساده ترکیب شده جی”برای هر شهر، در حالی که شکل ۶ توزیع درجه [وزنی] آنها را به ترتیب ترسیم می کند. نمودارهای چندگانه بیشتر در ضمیمه شکل A1 نمایش داده شده است.
سه نوع پیوند ویژگی‌های ناهمگنی را ارائه می‌دهند: (۱) نمودار زمانی طبق تعریف به هم متصل است، جایی که بالاترین چگالی در آمستردام بیشترین تعداد عکس‌های گرفته‌شده در دوره‌های زمانی متوالی را نشان می‌دهد، در حالی که بزرگترین قطر در ونیز وسیع‌ترین بازه زمانی را نشان می‌دهد. (۲) نمودار اجتماعی بر اساس رابطه کاربران ساختار می‌یابد، جایی که بزرگترین مؤلفه‌های متصل، خوشه‌هایی از پست‌هایی را نشان می‌دهند که توسط همان کاربر به اشتراک گذاشته شده یا توسط کاربرانی که دوست هستند یا دارای علایق متقابل هستند، که اندازه آنها در سوژو کوچک است، زیرا از کمترین کاربران نشان داده شده در جدول ۱; (۳) نمودار فضایی یک الگوی اتصال مشابه با شبکه‌ها/گراف‌های فضایی پشتیبان را نشان می‌دهد، جایی که قطر بسیار کوچک و بزرگ‌ترین چگالی در سوژو به موقعیت‌های تکه تکه شده پست‌ها اطمینان می‌دهد. (۴) اگرچه توزیع درجه سه نمودار فرعی به دلیل ویژگی‌های اجتماعی-اقتصادی و مکانی-زمانی متفاوت شهرهای مختلف در نوسان بود، نمودار ساده ترکیبی الگوهای آرنجی‌شکل مشابه، با چگالی و قطر مشابه را نشان داد. علاوه بر این، ساختارهای گراف ناهمگون نشان می‌دهد که پارامترهای مختلف و/یا مدل‌های ستون فقرات باید با هر نوع پیوند متناسب و دقیق تنظیم شوند، که یک روش معمول برای یادگیری عمیق در چند نمودار است.
از آنجایی که ویژگی‌های ناهمگون نمودارهای چندگانه ساخته‌شده در سه شهر نشان داده می‌شود که از نظر منطقی با واقعیت مطابقت دارند، و کلیت چارچوب روش‌شناختی را اثبات می‌کند، می‌توان از آنها به عنوان اطلاعات زمینه‌ای برای کمک به وظایف طبقه‌بندی نیمه‌نظارت‌شده آینده در رابطه با ارزش‌ها و ویژگی‌های میراث استفاده کرد. .

۴٫ بحث

۴٫۱٫ وظایف موقت برای علوم داده شهری
مجموعه داده های معرفی شده می تواند برای پاسخ به سؤالات از دیدگاه یادگیری ماشین و تجزیه و تحلیل شبکه های اجتماعی و همچنین مطالعات میراث و شهری استفاده شود. جدول ۸ چند کار موقت را ارائه می دهد که می توانند با استفاده از مجموعه داده های جمع آوری شده این مقاله محقق شوند و مجموعه داده های بیشتری با استفاده از همان چارچوب معرفی شده جمع آوری شوند.
این مشکلات از برخی یا همه ویژگی‌های استخراج‌شده (بصری، متنی، متنی)، برچسب‌های تولید شده (مقادیر و ویژگی‌های میراث)، ساختارهای نمودار ساخته‌شده و حتی داده‌های خام به‌عنوان اجزای ورودی و خروجی برای یافتن تابع رابطه بین آنها استفاده می‌کنند. برخی از مشکلات مانند مسائل ML/SNA جالب تر هستند (مانند ۴، ۷ و ۸)، برخی دیگر برای مطالعات میراث و علوم داده شهری (مانند ۰، ۱ و ۶) اساسی تر هستند. در حالی که اولی به سمت انتهای فنی و نظری کل محدوده بالقوه مجموعه داده‌ها می‌رود، دومی به سمت انتهای برنامه تمایل دارد. با این حال، برای رسیدن به یک عملکرد معقول در طول کاربردها و اکتشافات، همانطور که نگرانی و علاقه اصلی برای علوم داده شهری است، بررسی‌های فنی و اعتبارسنجی بیشتر ضروری است.
حتی قبل از انجام چنین وظایف موقتی با مجموعه داده های ایجاد شده با استفاده از چارچوب پیشنهادی در این مطالعه، ایجاد مجموعه داده و فرآیند بازرسی کیفی می تواند حقایق جالب مربوط به مطالعات میراث را آشکار کند، اگرچه آنها در درجه اول برای بررسی کیفیت مجموعه داده های ایجاد شده انجام می شوند. از انسجام و سازگاری آنها. تجزیه و تحلیل نشان داده شده در بخش ۳٫۱٫۲در مورد برچسب‌های کاذب تولید شده برای موضوعات ارزش‌ها و ویژگی‌های میراث، بی‌اهمیت‌ترین سهم را در مطالعات میراث فرهنگی ارائه می‌کند. از یک طرف، نشان می‌دهد که چارچوب پیشنهادی می‌تواند دانش را از مدل‌های از پیش آموزش‌دیده منتقل کند و پیش‌بینی‌های معناداری را به عنوان کپی دیدگاه‌های استبدادی برای توجیه ارزش‌ها و ویژگی‌های میراث ارائه کند. از سوی دیگر، توزیع برچسب‌های تولید شده نتایج مورد انتظار (مانند نمونه‌هایی که در شکل ۳ و شکل ۴ نشان داده شده‌اند) و غیرمنتظره (به عنوان مثال ظاهر قابل توجه معیارهای انتخاب OUV که در اصل در WHL درج نشده بود) را به دست می‌دهد که می‌تواند تحقیقات بیشتری را در مورد میراث انجام دهد. . تجزیه و تحلیل ویژگی های تولید شده نشان داده شده در بخش ۳٫۱٫۱ نشان داده شده استبا این حال، می تواند سرنخ های قوی آموزنده ای برای مطالعات میراث ارائه دهد. همانطور که در بخش ۲٫۴ بحث شد ، هر دو ویژگی انتزاعی قابل خواندن توسط ماشین مانند بردارهای لایه پنهان و دسته بندی های پیش بینی قابل تفسیر توسط انسان به عنوان ویژگی های چند وجهی ذخیره می شوند. در حین انجام آموزش‌های یادگیری ماشینی در آینده، بررسی‌های حساسیت بر روی این ویژگی‌های قابل تفسیر توسط انسان می‌تواند بینش‌هایی در مورد چگونگی و آنچه مدل‌ها یاد می‌گیرند ارائه دهد. برای مثال، می‌توان انتظار داشت که مدلی که ارزش میراث « معیار (vi)—تداعی » و ویژگی‌های میراث « فعالیت و انجمن مردمی » را پیش‌بینی می‌کند، به تعداد و نسبت چهره‌های انسان در تصویر توجه زیادی داشته باشد. و بالعکس .، از این رو ظاهر فوق العاده هر دو دسته در شهر آمستردام است. همانطور که برای تجزیه و تحلیل نمودار در بخش ۳٫۲ ، در حالی که پایه ای برای یادگیری نیمه نظارتی بیشتر مبتنی بر نمودار پست های مشابه در مکان های نزدیک، از همان دوره زمانی، و توسط گروه های اجتماعی مشابه، توزیع مکانی- زمانی و اجتماعی-اقتصادی فراهم می کند. از پست ها (به عنوان نماینده رفتار اجتماعی) از قبل یک داستان را بیان می کند. به عنوان مثال، همانطور که به طور گسترده توسط محققانی مانند بیل هیلیر و همکاران استدلال شده است، اغلب می توان یک تناظر واضح بین “زنگ” یا سرزندگی فعالیت های انسانی در شهرها با توزیع مرکزی ذاتی در بازنمایی شبکه ای فضای زیربنایی پیدا کرد. [ ۸۲ ، ۸۳ ، ۸۴]. وجود دایره‌های بزرگ (تعداد زیاد پست‌ها، در نتیجه سرزندگی بالا) و رنگ‌های گرم (مرکزیت بالا)، و خوشه‌بندی قابل مشاهده رنگ‌های گرم (در اطراف مکان‌هایی با اتصال خوب، مانند پل ریالتو و سن مارکو در ونیز، تایید نتایج بدست آمده توسط Psarra [ ۱۱۱ ]) نشان داده شده در شکل ۵ می تواند چنین یافته هایی را بیشتر نشان دهد. مکان‌های فرهنگی مهم اغلب نه تنها به دلیل ویژگی‌های فردی‌شان بلکه به دلیل تعبیه در بافت‌هایشان مهم هستند، که ناگزیر مطالعات میراث فرهنگی را زمینه‌ای می‌کند.
جدول ۸٫ چند کار موقت با تعاریف رسمی مشکل که می تواند انجام شود. ارتباط علمی و اجتماعی بالقوه برای جامعه یادگیری ماشین، و محققان شهری و/یا میراث، به ترتیب ارائه شده است. متون خاکستری در ستون سوم یک دسته بندی سطح بالا برای هر نوع خاص از کار در زمینه یادگیری ماشین ارائه می دهد.
تجزیه و تحلیل های پیشرفته بیشتر برای پاسخگویی مستقیم به سؤالات دامنه خاص در مطالعات میراث فرهنگی (مانند سؤالات ۳ و ۸ در مورد مکانیسم تأثیر متنی پست ها بر نقشه برداری، استخراج و استنتاج ارزش ها و ویژگی های میراث) در دسته بندی شده اند. جدول ۸ طبقه بندی شده است.. توجه داشته باشید که باید تمایز بیشتری در ارزش‌ها و ویژگی‌های میراث استخراج‌شده انجام شود، زیرا ممکن است اساساً در سه دسته دسته‌بندی شوند: (۱) ارزش‌های میراث اصلی و ویژگی‌هایی که رسماً فهرست شده و به رسمیت شناخته شده‌اند که وضعیت میراث را به طور کامل تعریف می‌کنند. (۲) ارزش‌ها و ویژگی‌های مربوط به عملیات حفاظت و نگهداری؛ (۳) ارزش‌ها و ویژگی‌های دیگری که هنوز به طور خاص به میراث مرتبط نیستند توسط مردم عادی به همان دارایی میراث منتقل می‌شوند. این تمایز باید برای متخصصانی که قصد تصمیم گیری برنامه ریزی بر اساس نتایج حاصل از مطالعه چنین مجموعه داده هایی را دارند، روشن شود.
یکی از مزیت های چارچوب پیشنهادی این است که امکان ایجاد نمودارهای چندگانه از حس های متعدد مجاورت یا شباهت در فضای جغرافیایی، زمانی و/یا فضای اجتماعی را فراهم می کند. در مواردی که نمی توان به راحتی یک حقیقت پایه را پیدا کرد، به عنوان مثال، در تحلیل های اکتشافی، داشتن امکان در نظر گرفتن مجموعه داده به عنوان مجموعه ای از نقاط داده متصل به جای مجموعه ای پودر مانند سودمند خواهد بود. حس شباهت بین نقاط داده به دلیل نزدیکی جغرافیایی/مکانی، مسلماً قدیمی‌ترین نوع ارتباط بین آنهاست. با این حال، زمانی که هیچ حس فیزیکی دقیقی از نزدیکی در یک فضای جغرافیایی وجود نداشته باشد، یا زمانی که سایر اشکال ارتباط، به عنوان مثال، از طریق رسانه های اجتماعی، تأثیرگذار هستند، دانشمندان داده می توانند از سرنخ های دیگری مانند ارتباطات زمانی مرتبط با رویدادها یا ارتباطات اجتماعی مرتبط با ساختارهای جامعه بهره ببرند. همه اینها می تواند به سؤالات احتمالی پاسخ دهد که در مطالعات آینده پاسخ داده می شود.
علاوه بر این، پس از بازیابی دانش ارزش‌ها و ویژگی‌های میراث در شهرهای مورد مطالعه از UGC چندوجهی، به منظور تجسم، ارزیابی و مقایسه در طول فرآیندهای تصمیم‌گیری، دسته‌بندی و تجمیع بیشتر نقاط داده‌ای منفرد، همانطور که به اختصار انجام شد، مطلوب است. در بخش ۱ ذکر شده و همچنین به عنوان سوال ۵ فرمول بندی شده است ذکر شده و در جدول ۸٫ این می تواند با هر سه نوع اطلاعات زمینه ای پیشنهادی که نشان دهنده نزدیکی نقاط داده است انجام شود. دسته بندی و تجمیع داده ها در حوزه فضایی اولین اقدام برای ایجاد نقشه خواهد بود. بسته به موارد استفاده مختلف، این می‌تواند بر روی نمایش‌های وابسته به مقیاس واحدهای جغرافیایی/اداری (مانند جزایر طبیعی تقسیم شده توسط کانال‌ها یا به اصطلاح انجام شود.جزایر یا جوامع محلی در ونیز [ ۱۱۱ ])، یا بر روی خوشه های شناسایی شده بر اساس شبکه های منظم در مقیاس های مختلف (مانند ” مناطق گردشگری ” [ ۱۰۹]). در حالی که استفاده از اولی (یعنی مرزهای بالا به پایین) برای اهداف اداری بی اهمیت است، دومی (به عنوان مثال، خوشه های پایین به بالا) می تواند در موارد دیگر قابل تعمیم تر باشد، که منعکس کننده یک حس جمعی جهانی از مکان است [ ۱۰۹ ]]. دسته‌بندی و تجمیع داده‌ها در حوزه زمانی، ویژگی‌ها و برچسب‌های تولید شده را بر روی یک جدول زمانی مجزا در مقیاس‌های مختلف (مثلاً ماه‌ها، سال‌ها، دهه‌ها و غیره) ترسیم می‌کند، که احتمالاً وضوح کافی برای ثبت پویایی‌های زمانی و تغییرات داده‌ها دارند. به عنوان مثال، ممکن است متوجه شوید که برخی از موضوعات به طور گسترده تنها در یک دوره زمانی کوتاه ذکر می‌شوند، در حالی که برخی دیگر برای بازه‌های طولانی‌تر مربوط می‌شوند، که الگوهای متفاوتی از ادراک عمومی و توجه عمومی را نشان می‌دهد، که همچنین ممکن است به شناسایی رویدادهای مرتبط با میراث کمک کند و به برنامه ریزی و استراتژی های مدیریت بیشتر [ ۹ ، ۴۲]. از سوی دیگر، دسته‌بندی و تجمیع داده‌ها در حوزه اجتماعی می‌تواند به نمایه کردن علایق جوامع کاربر یا گروه‌های کاربری (به عنوان مثال، ساکنان محلی و گردشگران) کمک کند، که برای مثال در ابداع سیستم‌های توصیه مفید است. همانطور که در بخش ۲٫۶ بحث شد ، چندین پست توسط یک کاربر لزوماً در این مطالعه اضافی در نظر گرفته نشد. درعوض، سازگاری و/یا تغییراتی که در محتوای پست شده توسط همان نمایه کاربر [جامعه/گروه] آشکار می‌شود، می‌تواند ترجیحات و نظرات آنها را در رابطه با اهمیت فرهنگی میراث طبقه‌بندی کند [ ۱۱۷ ].

۴٫۲٫ محدودیت ها و گام های آینده

هیچ ارزیابی و حاشیه نویسی انسانی کاملی در طول ساخت مجموعه داده های ارائه شده در این مقاله انجام نشد. این دست‌نوشته راهی برای دور زدن این مرحله با استفاده از اعتماد و [عدم] توافق مدل‌های احتمالاً آموزش‌دیده به‌عنوان نماینده‌ای برای توافق مرسوم‌تر «میان حاشیه‌نویس» برای نشان دادن کیفیت مجموعه‌های داده و تولید [شبه- ارائه می‌کند. ]برچسب ها [ ۴۶ ]. این شبیه ایده استفاده از ثبات، اطمینان و عدم توافق برای بهبود عملکرد مدل در یادگیری نیمه نظارت شده است [ ۴۸ ، ۴۹ ، ۹۱]. به منظور معرفی یک چارچوب کلی که می‌تواند مجموعه‌های داده گراف بیشتری تولید کند، ترجیح داده می‌شود که انسان‌ها از حلقه حذف شوند، زیرا این امر به عنوان یک گلوگاه عمل می‌کند که فرآیند را محدود می‌کند، هم در زمان و منابع پولی و هم در دانش حوزه مورد نیاز. با این حال، برای کاربردهایی که به نتیجه گیری دقیق تری نیاز است، ارزیابی های انسانی در مورد اعتبار، قابلیت اطمینان و انسجام مدل ها هنوز مورد نیاز است. به منظور به دست آوردن حس روشنی از عملکرد قبل از اجرا، بازرسی برخی از نتایج پیش بینی شده یک پیشنهاد محتاطانه است. از آنجایی که مرحله تولید [شبه] برچسب نسبتاً مستقل از سایر مراحل معرفی شده در این مقاله بود، برچسب‌های با کیفیت بالاتر که توسط کارشناسان و/یا کارگران مورد ارزیابی و بررسی قرار گرفته‌اند، همچنان می‌توانند در مراحل بعدی به عنوان تقویت یا حتی جایگزین اضافه شوند. ،۴۵ ، ۴۷ ، ۸۹ ]. برای مثال، از مطالعات آتی دعوت می‌شود تا چارچوب‌های طبقه‌بندی شناخته‌شده‌تری را برای ارزش‌های میراث و ویژگی‌های میراث [ ۳ ، ۴ ، ۵ ]، در پاسخ به عدم دقت احتمالی مفاهیم همانطور که در بخش ۲٫۵ اشاره شد، ادغام کنند.. علاوه بر این، تولید برچسب‌های ارزش‌ها و ویژگی‌های میراث تنها یک انتخاب با انگیزه مورد استفاده بود که برای نشان دادن سودمندی چارچوب برای تحلیل‌های اکتشافی بر روی نمودارهای نسبت داده شده در مواردی که منابع داده‌ها ذاتاً ساختاری ندارند و ارتباطات بین آن‌ها کافی است. نقاط داده ذاتاً چند وجهی هستند. با این حال، همچنین می‌توان از همان چارچوب و همچنین بخش‌هایی از گردش کار پیاده‌سازی‌شده استفاده کرد، در حالی که تنها طبقه‌بندی‌کننده‌های ذکر شده در بخش ۲٫۵ را با ماژول‌های دامنه خاص متناسب با موارد استفاده جایگزین کرد تا به سؤالات اکتشافی دیگر در علم داده‌های شهری پاسخ داده شود. علوم اجتماعی محاسباتی، همانطور که در بخش ۲٫۱ پیشنهاد شده است .
در حین افزایش مقیاس فرآیند ساخت مجموعه داده، مانند از VEN به VEN-XL، باید چند تغییر اعمال شود. برای جمع آوری داده ها، یک استراتژی به روز شده در پیوست A توضیح داده شده است. برای تولید ویژگی‌ها و برچسب‌ها، مینی‌بچ‌ها و محاسبات GPU به طور قابل‌توجهی این روند را تسریع کردند. با این حال، نمودارهای کوچک از شهرهای مورد مطالعه حاوی حدود ۳۰۰۰ گره قبلاً حاوی لبه‌هایی در مقیاس میلیون‌ها بودند، که باعث می‌شود در مواردی مانند VEN-XL، که فهرست مجاورت آن در مقیاس میلیاردها باشد، به چالش کشیده شود. فراتر از محدودیت های حافظه کامپیوتر در نتیجه، VEN-XL هنوز به عنوان یک نمودار چندگانه ساخته نشده است. استراتژی های بیشتر مانند استفاده از ماتریس های پراکنده [ ۱۲۳] و محاسبات موازی باید در نظر گرفته شود. علاوه بر این، موضوع مقیاس پذیری نیز باید برای آموزش شبکه عصبی گراف بعدی در نظر گرفته شود، زیرا نمودارهای چندگانه ساخته شده در این مطالعه می توانند به صورت محلی کاملا متراکم شوند. روش‌های نمونه‌گیری زیرگراف باید برای جلوگیری از “انفجار محله” [ ۴۴ ] اعمال شود.
اگرچه انگیزه ساخت مجموعه داده‌های مربوط به ارزش‌ها و ویژگی‌های میراث از رسانه‌های اجتماعی، ترویج فرآیندهای برنامه‌ریزی فراگیر بود، انتخاب پلتفرم‌های رسانه‌های اجتماعی قبلاً به‌طور خودکار کسانی را که از این پلتفرم استفاده نمی‌کردند، یا حتی از آن آگاه نبودند، حذف می‌کرد، چه رسد به کسانی که از اینترنت استفاده نمی‌کردند. استفاده کمیاب از فلیکر در چین، به عنوان نمونه ای از محدودیت های آن، همچنین نشان می دهد که نتایج حاصل از این مجموعه داده ها ممکن است منعکس کننده دیدگاه های “نگاه توریستی” باشد [ ۱۲۴ ]] به جای جوامع محلی، و بنابراین از دست دادن برخی از نمایندگی و عمومیت. با این حال، هدف اصلی این مقاله ارائه یک چارچوب روش‌شناختی قابل تکرار با تعاریف ریاضی است، نه محدود به فلیکر به عنوان یک نمونه خاص. تصاویر، متون و حتی فایل‌های صوتی و ویدئوها از پلتفرم‌های دیگر مانند Weibo، Dianping، RED و TikTok که در چین محبوب‌تر هستند نیز می‌توانند دیدگاه‌های محلی مکمل را اضافه کنند. با انطباق‌های دقیق، آرشیوها، اسناد رسمی، مقالات خبری، نشریات دانشگاهی، و متن مصاحبه‌ها نیز می‌توانند در قالب‌های مشابه برای مقایسه‌های منصفانه‌تر ساخته شوند، که مجدداً در چارچوب کلی پیشنهاد شده در بخش ۲٫۱ به عنوان نمونه‌های مشخص شده قرار می‌گیرد.

۵٫ نتیجه گیری ها

این مقاله یک چارچوب روش‌شناختی جدید برای ساخت مجموعه داده‌های چند وجهی مبتنی بر نمودار Heri-Graphs معرفی کرد.در مورد ارزش ها و ویژگی های میراث با استفاده از داده های پلت فرم رسانه های اجتماعی فلیکر. مدل‌های یادگیری ماشینی از قبل آموزش‌دیده‌شده برای تولید ویژگی‌های چندوجهی و برچسب‌های کاذب مخصوص دامنه استفاده شد. یک فرمول کامل ریاضی برای فرآیندهای استخراج ویژگی، تولید برچسب و ساخت گراف ارائه شده است. روابط زمانی، مکانی و اجتماعی بین پست‌ها برای ساختن نمودارهای چندگانه استفاده می‌شود که آماده استفاده به‌عنوان اطلاعات زمینه‌ای برای کارهای یادگیری ماشینی نیمه‌نظارت‌شده بعدی هستند. سه شهر مورد مطالعه، یعنی آمستردام، سوژو، و ونیز که دارای ویژگی‌های میراث جهانی یونسکو هستند، با چارچوبی برای ساخت مجموعه داده‌های نمونه آزمایش می‌شوند، که با سازگاری مدل‌ها و بازرسی‌های کیفی ارزیابی و فیلتر می‌شوند. مجموعه داده‌ها در سه شهر نمونه نشان داده شده‌اند که اطلاعات معنی‌داری در مورد توزیع‌های مکانی-زمانی و اجتماعی-اقتصادی ارزش‌ها و ویژگی‌های میراث ارائه‌شده توسط کاربران رسانه‌های اجتماعی ارائه می‌دهند که برای مستندسازی دانش و نقشه‌برداری برای مطالعات میراث و شهری مفید است. چنین درک به شدت با هدف توسعه پایدار (SDG) 11، با هدف نهایی آن که فراگیرتر کردن فرآیندهای مدیریت میراث شهری است، همسو است. مجموعه داده های ایجاد شده از طریق چارچوب پیشنهادی، مبنایی را برای بازبینی یا تعمیم آن فراهم می کند چنین درک به شدت با هدف توسعه پایدار (SDG) 11، با هدف نهایی آن که فراگیرتر کردن فرآیندهای مدیریت میراث شهری است، همسو است. مجموعه داده های ایجاد شده از طریق چارچوب پیشنهادی، مبنایی را برای بازبینی یا تعمیم آن فراهم می کند چنین درک به شدت با هدف توسعه پایدار (SDG) 11، با هدف نهایی آن که فراگیرتر کردن فرآیندهای مدیریت میراث شهری است، همسو است. مجموعه داده های ایجاد شده از طریق چارچوب پیشنهادی، مبنایی را برای بازبینی یا تعمیم آن فراهم می کندقانون اول جغرافیا که توسط توبلر فرموله شده است که شامل حس های جدید نزدیکی یا تشابه ناشی از رفتار جمعیت و سایر ارتباطات اجتماعی از طریق رسانه های الکترونیکی می شود که مسلماً به طور مستقیم به مسائل جغرافیایی مرتبط نیستند. این امر به ویژه مهم است زیرا مطالعات میراث به طور خاص، مطالعات شهری، و علوم اجتماعی محاسباتی به طور کلی تقریباً همیشه با اطلاعات زمینه‌ای سروکار دارند، که مسلماً به بافت جغرافیایی محدود نمی‌شود، بلکه به بافت‌های اجتماعی و زمانی نیز محدود می‌شود. چنین مجموعه‌های داده‌ای این پتانسیل را دارند که هم توسط جامعه یادگیری ماشین و هم دانشمندان داده‌های شهری برای پاسخگویی به سؤالات جالب مرتبط با علمی/فنی و اجتماعی استفاده شوند، که می‌تواند در سطح جهانی با طیف وسیعی از موارد استفاده نیز به کار رود.

اختصارات

در این نسخه از اختصارات زیر استفاده شده است:

Acc دقت
AMS داده های آمستردام، هلند
API رابط برنامه نویسی کاربردی
BC-SVM دسته بندی کیسه ای با SVM ها به عنوان برآوردگرهای پایه داخلی
برت نمایش رمزگذار دو طرفه از ترانسفورماتورها
CNN شبکه عصبی کانولوشنال
CC اجزای متصل
رزومه اعتبار سنجی متقابل
GNB بیز ساده لوح گاوسی
HA ویژگی های میراث
HUL منظر شهری تاریخی
HV ارزش های میراثی
KNN K-نزدیکترین همسایه ها
ML فراگیری ماشین
MLP پرسپترون چند لایه
MML یادگیری ماشین چند وجهی
NLP پردازش زبان طبیعی
OUV ارزش جهانی برجسته
RF جنگل تصادفی
SDG هدف توسعه پایدار
SNA تحلیل شبکه های اجتماعی
SUZ داده های سوژو، چین
SVM ماشین بردار پشتیبانی
UGC محتوای ایجاد شده توسط کاربر
ULMFiT تنظیم دقیق مدل زبان جهانی
یونسکو سازمان آموزشی، علمی و فرهنگی ملل متحد
VEN داده های ونیز، ایتالیا
VEN-XL نسخه فوق العاده بزرگ داده های ونیز
w با
WH میراث جهانی
WHL فهرست میراث جهانی

ضمیمه A. جزئیات جمع آوری مجموعه داده خام

برای هر شهر مورد مطالعه، کتابخانه پایتون FlickrAPI برای دسترسی به روش API photo.search ارائه شده توسط Flickr، با استفاده از مکان‌های جغرافیایی در جدول ۱ به عنوان مرکز برای جستجوی شناسه‌های تصاویر دارای برچسب جغرافیایی در یک شعاع ثابت (۵ کیلومتری) استفاده شد. برای ونیز و سوژو، و ۲ کیلومتر برای آمستردام) که منطقه شهری اصلی متعلق به میراث جهانی یونسکو را پوشش می دهد. برای ساخت مجموعه داده های قابل مقایسه و سازگار از سه شهر، حداکثر ۵۰۰۰ شناسه برای هر شهر به موتور جستجو داده شد، زیرا کاربران فلیکر در چین نسبتاً کمیاب هستند. برای همه شناسه‌های تصویر، فقط آنهایی که دارای پرچم candownload هستندبه منظور احترام به حریم خصوصی و حقوق کپی رایت کاربران فلیکر، توسط مالک نشان داده شده است. این تصاویر بیشتر از طریق روش‌های photo.getInfo و photo.getSizes API برای بازیابی اطلاعات زیر مورد بررسی قرار گرفتند: شناسه مالک. مکان ثبت شده مالک در فلیکر؛ عنوان، توضیحات و برچسب های ارائه شده توسط کاربر؛ برچسب جغرافیایی تصویر؛ مهر زمانی علامت گذاری تصویر هنگام عکسبرداری و آدرس های اینترنتی برای دانلود نسخه های مربع بزرگ (۱۵۰ × ۱۵۰ پیکسل) و کوچک ۳۲۰ (۳۲۰ × ۲۴۰ پیکسل) تصویر اصلی. تصاویری که حاوی برچسب کاربر “شهوانی” بودند از پرس و جو حذف شدند. سپس تمامی تصاویر در هر دو اندازه ذخیره شده و به عنوان داده های بصری خام به فرمت RGB تبدیل شدند.
برای حذف نمادهای HTML و سایر عناصر قالب‌بندی از متون و فیلتر کردن داده‌های متنی که عمدتاً (۱) توصیفی از دوربین استفاده‌شده بود، (۲) نام تصویر پیش‌فرض تولید شده توسط دوربین، از فهرست کلمات توقف استفاده شد. (۳) یک تبلیغ یا یک تبلیغ. Google Translator API از کتابخانه Deep Translator python برای تشخیص زبان پست‌ها در سطح جمله استفاده شد تا مشخص شود آیا جمله به انگلیسی، زبان محلی (به ترتیب هلندی، چینی و ایتالیایی برای سه شهر) نوشته شده است یا خیر. ، یا هر زبان دیگری. از همان API برای ترجمه جملات غیر انگلیسی به انگلیسی استفاده شد. سپس، تمام جملات معتبر از هر فیلد متنی همان پست در یک فیلد جدید به نام Revised Text ادغام شدند.به عنوان داده های متنی خام
علاوه بر این، فهرست‌های مخاطبین عمومی و فهرست‌های گروه (اشتراک) همه مالکان بازیابی شده از طریق روش‌های contacts.getPublicList و people.getPublicGroups API جستجو شد، در حالی که تمام اطلاعات کاربر و گروه فقط به عنوان یک شناسه [نیمه] ناشناس با در نظر گرفته شد. احترام به سیاست حفظ حریم خصوصی
برای آزمایش مقیاس پذیری گردش کار روش شناختی، مجموعه داده بزرگتر دیگری بدون محدودیت حداکثر ۵۰۰۰ شناسه نیز در ونیز (VEN-XL) جمع آوری شد. API فلیکر دارای محدودیت در مقیاس پرس و جو است، که در مواقعی که سرور با مشکلات عملکردی مواجه می شود، خطاهای گاه به گاه را برمی گرداند. این نیاز به یک استراتژی متفاوت در طول جمع آوری داده از مجموعه داده بزرگتر دارد. در این مطالعه، یک شبکه ۲۰×۲۰ در منطقه ونیز (از ۴۲۰۸۵۵/۴۵) کاشی کاری شد. “N 12.291054 “E به ۴۵٫۴۴۸۲۸۶ “N 12.369234 “E) برای جمع‌آوری شناسه‌های پست از مرکز هر کاشی در شعاع ۰٫۳ کیلومتری، که بعداً با حذف شناسه‌های تکراری جمع‌آوری‌شده توسط چندین کاشی جمع‌آوری شدند تا کل مجموعه داده بزرگ را تشکیل دهند، مشابه استراتژی اعمال شده توسط Bekker [ ۱۲۵ ] . مراحل بعدی پاکسازی و پیش پردازش داده ها با مجموعه داده های کوچکتر یکسان باقی ماند.

ضمیمه B. جزئیات مدل های یادگیری ماشین

مجموعه داده ای با ۹۰۲ تصویر نمونه جمع آوری شده در طرابلس، لبنان و طبقه بندی شده با حاشیه نویسی مبتنی بر متخصص ارائه شده در Ginzarly و همکاران. [ ۲۶ ] برای آموزش چندین مدل ML برای تکرار رفتار متخصصان در طبقه بندی مناظر به تصویر کشیده شده استفاده شد. برای هر تصویر، یک برچسب کلاس منحصر به فرد در میان ۹ صحنه نشان داده شده در جدول A4 ارائه شد. در مجموع، ۱۰٪ از تصاویر جدا شده و در طول آموزش به عنوان مجموعه داده آزمایشی دور نگه داشته شدند و ۸۱۲ تصویر باقی مانده برای آموزش مدل‌های ML با کتابخانه پایتون Scikit-learn [ ۹۵ ] استفاده شد. در میان ۸۱۲ نقطه داده، train_test_splitروش کتابخانه بیشتر برای تقسیم یک مجموعه داده اعتبارسنجی با ۲۰۳ نمونه (۲۵٪) استفاده شد. نمایش بصری ۵۱۲ بعدی معرفی شده در بخش ۲٫۴٫۱ از تصاویر به عنوان ورودی مدل‌های ML تولید شد، در حالی که برچسب کلاس به عنوان خروجی طبقه‌بندی تکلیف طبقه‌بندی تک‌لیبلی استفاده شد.
برای هر یک از مدل‌های انتخاب‌شده ML، تابع GridSearchCV با اعتبارسنجی متقاطع ۱۰ برابری استفاده شد تا مدل را با مجموعه‌ای از پارامترهای قابل تنظیم در یک محدوده کوچک انتخاب شود، در حالی که میانگین دقت بالای ۱ به عنوان معیار استفاده شد. انتخاب مدل همه ۸۱۲ نمونه برای تنظیم فراپارامترها به اعتبارسنجی متقابل (CV) وارد شدند، پس از آن مدل‌های آموزش‌دیده با فراپارامترهای بهینه خود بر روی ۲۰۳ نمونه داده اعتبارسنجی و مجموعه داده آزمایشی دیده نشده با ۹۰ نمونه باقی‌مانده آزمایش شدند. برای مراحل آخر، دقت بالای ۱ و میانگین کلان امتیازات F1 (میانگین هارمونیک نمرات دقت و یادآوری) همه کلاس ها به عنوان معیارهای ارزیابی استفاده شد. همه آزمایش‌ها با استفاده از پردازنده مرکزی Intel(R) Core(TM) i7-12700KF نسل دوازدهم انجام شد.
جزئیات پیاده سازی مدل ها به شرح زیر است:

ضمیمه B.1. MLP

مدل از جریمه L2 استفاده کرد ۱×۱۰-۴حل‌کننده نزول گرادیان تصادفی، نرخ یادگیری تطبیقی ​​و توقف اولیه با حداکثر ۳۰۰ تکرار. بر روی نرخ یادگیری اولیه تنظیم شده بود {۰٫۰۵،۰٫۱،۰٫۲}، و اندازه های پنهان یک لایه در {۳۲،۶۴،۱۲۸،۲۵۶}یا دو لایه در {(۲۵۶،۱۲۸)،(۲۵۶،۶۴)،(۲۵۶،۳۲)،(۱۲۸،۶۴)،(۱۲۸،۳۲)}. بهترین مدل دارای دو لایه پنهان (۲۵۶۱۲۸) با نرخ یادگیری ۰٫۰۵ بود.

ضمیمه B.2. KNN

مدل بر روی تعداد همسایگان در محدوده تنظیم شد [۳،۱۱]⊂نو وزنهای یکنواخت، فاصله منهتن یا فاصله اقلیدسی. بهترین مدل شش همسایه در فاصله اقلیدسی داشت.

ضمیمه B.3. GNB

مدل فوق پارامتر قابل تنظیم ندارد.

ضمیمه B.4. SVM

مدل بر روی نوع هسته در تنظیم شد {خطی،چند،rbf،سیگموئید}، پارامتر تنظیم C در محدوده [۰٫۱،۲٫۰]⊂آر، ضریب هسته گاما در {مقیاس،خودکار}و درجه تابع هسته چند جمله ای در محدوده [۲،۴]⊂ن. بهترین مدل از هسته RBF با وزن های مقیاس شده و پارامتر منظم سازی ۱٫۸ استفاده کرد.

ضمیمه B.5. RF

مدل حداکثر عمق درختان را محدود نمی کند. بر روی وزن کلاس در تنظیمات یکنواخت، متعادل و متعادل روی نمونه‌های فرعی و حداقل نمونه‌های مورد نیاز برای تقسیم یک گره درخت تنظیم شد. {۲،۷،۱۲،…،۹۷}. بهترین مدل دارای وزن کلاس متعادل و حداقل ۱۷ نمونه برای شکافتن یک گره درخت بود.

ضمیمه B.6. کوله بری

مدل دارای ۱۰ برآوردگر پایه در مجموعه بود. بر روی تخمین‌گر پایه در طبقه‌بندی‌کننده‌های SVM، Decision Tree و KNN و نسبت حداکثر ویژگی‌های مورد استفاده برای آموزش طبقه‌بندی‌کننده‌های ضعیف داخلی در محدوده تنظیم شده است. [۰٫۱،۱٫۰]⊂آر. بهترین مدل از حداکثر ۵۰ درصد از همه ویژگی‌ها برای جا دادن SVM به عنوان تخمین‌گر پایه داخلی استفاده کرد.

ضمیمه B.7. رای دادن

این مدل، شش مدل آموزش‌دیده اول ذکر شده را به‌عنوان ورودی در مجموعه انتخاب کرد تا به خروجی رأی دهد و بر روی مکانیسم رأی‌دهی سخت (رای‌گیری در پیش‌بینی برتر ۱) و نرم (رای دادن بر روی میانگین لاجیت) تنظیم شد. بهترین مدل از مکانیزم رای گیری نرم استفاده کرد.

ضمیمه B.8. پشتهسازی

این مدل خروجی‌های شش مدل اول آموزش‌دیده فوق‌الذکر را در مجموعه و سپس یک تخمین‌گر نهایی روی هم قرار داد و بر روی انتخاب تخمین‌گر نهایی از بین SVM و رگرسیون لجستیک تنظیم شد. بهترین مدل از رگرسیون لجستیک به عنوان برآوردگر نهایی استفاده کرد.

ضمیمه C. نامگذاری

جدول A1 و جدول A2 یک نمای کلی از نمادها و توابع ریاضی استفاده شده در این مقاله ارائه می دهد.
جدول A1. نامگذاری نمادهای ریاضی استفاده شده در این مقاله به ترتیب حروف الفبا. تمام نویسه‌های ماتریس‌ها صرفاً برچسب‌ها هستند، به استثنای عملگر transpose، نباید با توان و عملیات اشتباه گرفته شوند. □تی.
جدول A2. نامگذاری توابع تعریف شده و استفاده شده در این مقاله به ترتیب حروف الفبا.

ضمیمه د. تعریف مقوله ها برای ارزش ها و ویژگی های میراث

جدول A3 و جدول A4 ، به ترتیب، تعریف دقیقی از ارزش های میراث (از نظر معیارهای انتخاب ارزش جهانی برجسته) و ویژگی های میراث (از نظر صحنه های به تصویر کشیده شده) دسته های اعمال شده در این مقاله ارائه می دهند.
جدول A3. تعریف برای هر معیار انتخاب OUV میراث جهانی یونسکو به عنوان دسته ارزش میراث در این مجموعه داده و موضوع اصلی آن با توجه به محققان قبلی [ ۲ ، ۵۴ ، ۵۵ ].
جدول A4. تعریف مناظر ترسیم شده به عنوان دسته ویژگی میراث در این مجموعه داده و نوع محسوس/ناملموس آن بر اساس پژوهشگران قبلی [ ۵ ، ۲۶ ، ۹۳ ].

پیوست E. تجسم چند نمودار

اجزای مرتبط هر نوع پیوند زمانی، اجتماعی و مکانی در هر شهر مورد مطالعه به ترتیب در شکل A1 نشان داده شده است. برای خروجی نمودارها از الگوریتم Spring_layout کتابخانه پایتون NetworkX با فاصله بهینه بین گره‌های k ۰٫۱ و دانه تصادفی ۱۰۳۹۶۹۵۳ استفاده شده است.
شکل A1. زیرگراف های چند نمودار در هر شهر مورد مطالعه با استفاده از طرح فنری در NetworkX تجسم شدند. اندازه گره و رنگ منعکس کننده درجه و ضخامت پیوند وزن لبه است.

منابع

  1. یونسکو کنوانسیون در مورد حفاظت از میراث فرهنگی و طبیعی جهانی ؛ گزارش فنی؛ یونسکو: پاریس، فرانسه، ۱۹۷۲٫ [ Google Scholar ]
  2. یونسکو رهنمودهای عملیاتی برای اجرای کنوانسیون میراث جهانی ; گزارش فنی؛ مرکز میراث جهانی یونسکو: پاریس، فرانسه، ۲۰۰۸٫ [ Google Scholar ]
  3. Pereira Roders، A. معماری مجدد: بازسازی طول عمر میراث ساخته شده. Ph.D. Thesis, Technische Universiteit Eindhoven, Eindhoven, The Netherlands, 2007. [ Google Scholar ] [ CrossRef ]
  4. تارافا سیلوا، ا. Pereira Roders، A. اهمیت فرهنگی شهرهای میراث جهانی: پرتغال به عنوان مطالعه موردی. در مجموعه مقالات دومین کنفرانس بین المللی میراث و توسعه پایدار (HERITAGE 2010)، اوورا، پرتغال، ۲۲ تا ۲۶ ژوئن ۲۰۱۰٫ صص ۲۵۵-۲۶۳٫ [ Google Scholar ] [ CrossRef ]
  5. Veldpaus، L. مناظر شهری تاریخی: چارچوب‌بندی ادغام برنامه‌ریزی شهری و میراث در حکومت‌داری چند سطحی. Ph.D. پایان نامه، Technische Universiteit Eindhoven، آیندهوون، هلند، ۲۰۱۵٫ [ Google Scholar ]
  6. راکیچ، تی. چمبرز، دی. میراث جهانی: بررسی تنش بین ملی و جهانی. جی. هریت. تور. ۲۰۰۸ ، ۲ ، ۱۴۵-۱۵۵٫ [ Google Scholar ] [ CrossRef ]
  7. Bonci، A.; کلینی، پ. مارتین، آر. پیرانی، م. کواترینی، آر. Raikov، A. سیستم سایبری-فیزیکی هوش مشترک برای ارزش گذاری و استفاده مجدد از میراث فرهنگی. J. Inf. تکنولوژی ساخت و ساز ۲۰۱۸ ، ۲۳ ، ۳۰۵-۳۲۳٫ [ Google Scholar ]
  8. Pereira Roders، A. رویکرد منظر شهری تاریخی در عمل: هشت سال بعد. در شکل دهی مجدد حفاظت شهری ; Springer: برلین/هایدلبرگ، آلمان، ۲۰۱۹؛ صص ۲۱-۵۴٫ [ Google Scholar ] [ CrossRef ]
  9. بای، ن. نوریان، پ. Pereira Roders، A. شهروندان جهانی و میراث جهانی: گنجاندن اجتماعی جوامع آنلاین در برنامه ریزی میراث. بین المللی قوس. فتوگرام حسگر از راه دور اسپات. Inf. علمی ۲۰۲۱ ، XLVI-M-1-2021 ، ۲۳–۳۰٫ [ Google Scholar ] [ CrossRef ]
  10. یونسکو توصیه در مورد چشم انداز تاریخی شهری ; گزارش فنی؛ یونسکو: پاریس، فرانسه، ۲۰۱۱٫ [ Google Scholar ]
  11. لو، دبلیو. Stepchenkova، S. محتوای تولید شده توسط کاربر به عنوان یک روش تحقیق در کاربردهای گردشگری و هتلداری: موضوعات، روش ها و نرم افزار. جی. هاسپ. علامت. مدیریت ۲۰۱۵ ، ۲۴ ، ۱۱۹-۱۵۴٫ [ Google Scholar ] [ CrossRef ]
  12. پیکرینگ، سی. روسی، اس دی؛ هرناندو، ا. باروس، الف. دانش فعلی و دستورالعمل های تحقیقاتی آینده برای نظارت و مدیریت بازدیدکنندگان در مناطق تفریحی و حفاظت شده. J. بازآفرینی در فضای باز. تور. ۲۰۱۸ ، ۲۱ ، ۱۰-۱۸٫ [ Google Scholar ] [ CrossRef ]
  13. بالتروسایتیس، تی. آهوجا، سی. مورنسی، یادگیری ماشین چندوجهی LP: یک بررسی و طبقه بندی. IEEE Trans. الگوی مقعدی ماخ هوشمند ۲۰۱۹ ، ۴۱ ، ۴۲۳-۴۴۳٫ [ Google Scholar ] [ CrossRef ]
  14. مارین-روگ، ای. Anton Clavé، S. Tourism Analytics با محتوای عظیم تولید شده توسط کاربر: مطالعه موردی بارسلونا. جی. مقصد. علامت. مدیریت ۲۰۱۵ ، ۴ ، ۱۶۲-۱۷۲٫ [ Google Scholar ] [ CrossRef ]
  15. آماتو، اف. کوزولینو، جی. دی مارتینو، اس. مازئو، آ. Moscato، V. پیکاریلو، ا. رومانو، اس. Sperlí, G. تحلیل نظرات در شبکه های اجتماعی برای کاربردهای میراث فرهنگی. نوآوری هوشمند. سیستم تکنولوژی ۲۰۱۶ ، ۵۵ ، ۵۷۷-۵۸۶٫ [ Google Scholar ] [ CrossRef ]
  16. لی، اچ. Kang، Y. مقاصد و ترجیحات گردشگران معدن از طریق طبقه بندی متن مبتنی بر LSTM و خوشه بندی فضایی با استفاده از داده های فلیکر. تف کردن Inf. Res. ۲۰۲۱ ، ۲۹ ، ۸۲۵-۸۳۹٫ [ Google Scholar ] [ CrossRef ]
  17. ژانگ، اف. ژو، بی. راتی، سی. لیو، ی. کشف صحنه ها و اشیاء آموزنده مکان با استفاده از عکس های رسانه های اجتماعی. R. Soc. علوم را باز کنید. ۲۰۱۹ ، ۶ ، ۱۸۱۳۷۵٫ [ Google Scholar ] [ CrossRef ]
  18. گیگلیو، اس. برتاچینی، اف. بیلوتا، ای. Pantano، P. استفاده از رسانه های اجتماعی برای شناسایی جذابیت گردشگری در شش شهر ایتالیا. تور. مدیریت ۲۰۱۹ ، ۷۲ ، ۳۰۶-۳۱۲٫ [ Google Scholar ] [ CrossRef ]
  19. Campillo-Alhama، C.; Martinez-Sala، AM Events 2.0 در استراتژی برندسازی Transmedia سایت های میراث فرهنگی جهانی. پروفسور Inf. ۲۰۱۹ , ۲۸ , e280509. [ Google Scholar ] [ CrossRef ]
  20. لیو، میراث فرهنگی مشارکتی CL: داستان استفاده دو نهاد از رسانه های اجتماعی. D-Lib Mag. ۲۰۱۴ ، ۲۰ ، ۱-۱۷٫ [ Google Scholar ] [ CrossRef ]
  21. ویلیامز، NL; اینورسینی، ا. فردیناند، ن. Buhalis، D. eWOM مقصد: یک رویکرد شبکه کلان و میانی؟ ان تور. Res. ۲۰۱۷ ، ۶۴ ، ۸۷-۱۰۱٫ [ Google Scholar ] [ CrossRef ]
  22. گیگلیو، اس. برتاچینی، اف. بیلوتا، ای. پانتانو، پی. یادگیری ماشین و نقطه علائق: شهرهای توریستی معمول ایتالیا. Curr. تور مسائل. ۲۰۱۹ ، ۲۳ ، ۱۶۴۶-۱۶۵۸٫ [ Google Scholar ] [ CrossRef ]
  23. گابریلی، ال. رینزیویلو، اس. رونزانو، اف. ویلاتورو، دی. از توییت‌ها تا مسیرهای معنایی: الگوهای ناهنجار تحرک شهری استخراج. در شهروند در شبکه های حسگر ; نکات سخنرانی در هوش مصنوعی; Nin, J., Villatoro, D., Eds. Springer: برلین، آلمان، ۲۰۱۴; جلد ۸۳۱۳، ص ۲۶-۳۵٫ [ Google Scholar ] [ CrossRef ]
  24. آگاروال، سی سی مقدمه ای بر تجزیه و تحلیل داده های شبکه های اجتماعی. در تجزیه و تحلیل داده های شبکه اجتماعی ؛ آگاروال، سی سی، اد. Springer: برلین/هایدلبرگ، آلمان، ۲۰۱۱; فصل ۱؛ صص ۱-۱۵٫ [ Google Scholar ] [ CrossRef ]
  25. مونتیرو، وی. هنریکس، آر. پاینهو، ام. Vaz, E. Sensing Heritage World Heritage مطالعه اکتشافی توییتر به عنوان ابزاری برای ارزیابی شهرت. در مجموعه مقالات علوم محاسباتی و کاربردهای آن – ICCSA 2014، گیماراس، پرتغال، ۳۰ ژوئن تا ۳ ژوئیه ۲۰۱۴٫ نقطه دوم. جلد ۸۵۸۰، ص ۴۰۴–۴۱۹٫ [ Google Scholar ]
  26. گینزارلی، م. پریرا رادرز، آ. تلر، جی. نقشه برداری ارزش های منظر شهری تاریخی از طریق رسانه های اجتماعی. J. Cult. میراث. ۲۰۱۹ ، ۳۶ ، ۱-۱۱٫ [ Google Scholar ] [ CrossRef ]
  27. کراندال، دی. بکستروم، ال. هاتنلوچر، دی. کلینبرگ، جی. نقشه برداری از عکس های جهان. در مجموعه مقالات هجدهمین کنفرانس بین المللی وب جهانی-WWW’09، مادرید، اسپانیا، ۲۰-۲۴ آوریل ۲۰۰۹; صص ۷۶۱-۷۷۰٫ [ Google Scholar ] [ CrossRef ]
  28. گومز، آر. گومز، ال. گیبرت، جی. کاراتزاس، دی. آموختن از داده‌های اینستاگرام بارسلونا که افراد محلی و گردشگران درباره محله‌های آن پست می‌کنند. در مجموعه مقالات کنفرانس اروپایی در کارگاه های آموزشی بینایی کامپیوتری (ECCV)، مونیخ، آلمان، ۸ تا ۱۴ سپتامبر ۲۰۱۸؛ صص ۵۳۰-۵۴۴٫ [ Google Scholar ] [ CrossRef ]
  29. کانگ، ی. چو، ن. یون، جی. پارک، اس. کیم، جی. آموزش انتقال مدل یادگیری عمیق برای کاوش تصویر شهری گردشگران با استفاده از عکس های دارای برچسب جغرافیایی. ISPRS Int. J. Geo-Inf. ۲۰۲۱ ، ۱۰ ، ۱۳۷٫ [ Google Scholar ] [ CrossRef ]
  30. چو، ن. کانگ، ی. یون، جی. پارک، اس. Kim, J. طبقه‌بندی عکس‌های گردشگران و کاوش تصویر مقصد گردشگری با استفاده از یک مدل یادگیری عمیق. جی. کوال. ایسور. بیمارستان تور. ۲۰۲۲ ، ۱-۲۹٫ [ Google Scholar ] [ CrossRef ]
  31. پان، SJ; یانگ، کیو. نظرسنجی در مورد یادگیری انتقالی. IEEE Trans. بدانید. مهندسی داده ۲۰۰۹ ، ۲۲ ، ۱۳۴۵-۱۳۵۹٫ [ Google Scholar ] [ CrossRef ]
  32. Tobler, WR یک فیلم کامپیوتری شبیه سازی رشد شهری در منطقه دیترویت. اقتصاد Geogr. ۱۹۷۰ ، ۴۶ ، ۲۳۴-۲۴۰٫ [ Google Scholar ] [ CrossRef ]
  33. پیرسون، ک. مسئله پیاده روی تصادفی. Nature ۱۹۰۵ , ۷۲ , ۲۹۴٫ [ Google Scholar ] [ CrossRef ]
  34. Batty, M. The New Science of Cities ; انتشارات MIT: کمبریج، MA، ایالات متحده آمریکا، ۲۰۱۳٫ [ Google Scholar ]
  35. نوریان، ص. Configraphics: روش‌های نظری نمودار برای طراحی و تحلیل پیکربندی‌های فضایی . TU Delft: Delft, The Netherlands, 2016. [ Google Scholar ]
  36. رن، ی. چنگ، تی. Zhang، Y. شبکه های عصبی باقیمانده فضایی-زمانی عمیق برای مدل سازی داده مبتنی بر شبکه جاده ای. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۹ ، ۳۳ ، ۱۸۹۴–۱۹۱۲٫ [ Google Scholar ] [ CrossRef ]
  37. ژانگ، ی. چنگ، تی. مدل یادگیری عمیق نمودار برای نگاشت نقطه کانونی پیشگویانه مبتنی بر شبکه رویدادهای پراکنده فضایی-زمانی. محاسبه کنید. محیط زیست سیستم شهری ۲۰۲۰ ، ۷۹ ، ۱۰۱۴۰۳٫ [ Google Scholar ] [ CrossRef ]
  38. واسرمن، اس. فاوست، ک. تجزیه و تحلیل شبکه های اجتماعی: روش ها و کاربردها . انتشارات دانشگاه کمبریج: کمبریج، بریتانیا، ۱۹۹۴٫ [ Google Scholar ]
  39. لازر، دی. پنتلند، ای. آدامیک، ال. آرال، س. برعباسی، ال. برویر، دی. کریستاکیس، ن. پیمانکار، ن. فاولر، جی. گاتمن، ام. و همکاران علوم اجتماعی. علوم اجتماعی محاسباتی. Science ۲۰۰۹ , ۳۲۳ , ۷۲۱-۷۲۳٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
  40. Barabási، علم شبکه AL. فیلوس ترانس. R. Soc. یک ریاضی فیزیک مهندس علمی ۲۰۱۳ ، ۳۷۱ ، ۲۰۱۲۰۳۷۵٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
  41. پنتلند، الف. فیزیک اجتماعی: چگونه شبکه های اجتماعی می توانند ما را باهوش تر کنند . پنگوئن: نیویورک، نیویورک، ایالات متحده آمریکا، ۲۰۱۵٫ [ Google Scholar ]
  42. چنگ، تی. Wicks, T. تشخیص رویداد با استفاده از توییتر: رویکرد مکانی-زمانی. PLoS ONE ۲۰۱۴ ، ۹ ، e97807. [ Google Scholar ]
  43. ژانگ، ز. کوی، پی. زو، دبلیو. یادگیری عمیق روی نمودارها: نظرسنجی. IEEE Trans. بدانید. مهندسی داده ۲۰۲۲ ، ۳۴ ، ۲۴۹-۲۷۰٫ [ Google Scholar ] [ CrossRef ]
  44. ممکن است.؛ تانگ، جی. یادگیری عمیق در نمودارها . انتشارات دانشگاه کمبریج: کمبریج، بریتانیا، ۲۰۲۱٫ [ Google Scholar ]
  45. پرینس، ام. آیا یادگیری فعال کار می کند؟ بازبینی تحقیق. J. Eng. آموزش. ۲۰۰۴ ، ۹۳ ، ۲۲۳-۲۳۱٫ [ Google Scholar ] [ CrossRef ]
  46. نواک، س. روگر، اس. حاشیه نویسی ها از طریق جمع سپاری چقدر قابل اعتماد هستند. در مجموعه مقالات کنفرانس بین المللی بازیابی اطلاعات چند رسانه ای، فیلادلفیا، PA، ایالات متحده آمریکا، ۲۹ تا ۳۱ مارس ۲۰۱۰٫ صص ۵۵۷-۵۶۶٫ [ Google Scholar ] [ CrossRef ]
  47. حل و فصل، ب. از نظریه ها تا پرسش ها: یادگیری فعال در عمل. در مجموعه مقالات کارگاه آموزشی یادگیری فعال و طراحی تجربی در ارتباط با AISTATS 2010، مجموعه مقالات کارگاه و کنفرانس JMLR، ساردینیا، ایتالیا، ۱۶ مه ۲۰۱۰٫ صص ۱-۱۸٫ [ Google Scholar ]
  48. ژو، ژ. لی، ام. یادگیری نیمه نظارت شده توسط اختلاف نظر. بدانید. Inf. سیستم ۲۰۱۰ ، ۲۴ ، ۴۱۵-۴۳۹٫ [ Google Scholar ] [ CrossRef ]
  49. لی، DH شبه برچسب: روش یادگیری نیمه نظارت شده ساده و کارآمد برای شبکه های عصبی عمیق. در مجموعه مقالات کارگاه چالش ها در آموزش بازنمایی، ICML 2013، آتلانتا، GA، ایالات متحده آمریکا، ۶ تا ۲۱ ژوئن ۲۰۱۳٫ جلد ۳، ص. ۸۹۶٫ [ Google Scholar ]
  50. Kipf، TN; ولینگ، ام. طبقه بندی نیمه نظارت شده با شبکه های کانولوشن گراف. در مجموعه مقالات پنجمین کنفرانس بین المللی بازنمایی یادگیری، ICLR 2017، تولون، فرانسه، ۲۴-۲۶ آوریل ۲۰۱۷٫ صص ۱-۱۴٫ [ Google Scholar ]
  51. پریرا رادرز، A. افشای شهرهای میراث جهانی و طبیعت های متنوع آنها. در مجموعه مقالات دومین کنفرانس بین المللی میراث و توسعه پایدار (HERITAGE 2010)، اوورا، پرتغال، ۲۲ تا ۲۶ ژوئن ۲۰۱۰٫ ص ۲۴۵-۲۵۳٫ [ Google Scholar ]
  52. والس، م. نواردو، اف. Pereira Roders، A. نقشه برداری میراث جهانی در یک سیستم اطلاعات جغرافیایی ساختاریافته مبتنی بر استاندارد. بین المللی قوس. فتوگرام حسگر از راه دور اسپات. Inf. علمی ۲۰۲۰ ، XLIII-B4-2020 ، ۸۱–۸۸٫ [ Google Scholar ] [ CrossRef ]
  53. جوکیلهتو، جی. زیبایی شناسی در زمینه میراث جهانی. در مجموعه مقالات کنفرانس بین المللی ICOMOS، ICCROM و Fondazione Romualdo Del Bianco، فلورانس، ایتالیا، ۲-۴ مارس ۲۰۰۷٫ Polistampa: فلورانس، ایتالیا، ۲۰۰۸; ص ۱۸۳-۱۹۴٫ [ Google Scholar ]
  54. Jokilehto, J. OUV چیست؟ تعریف ارزش جهانی برجسته اموال میراث جهانی فرهنگی ; گزارش فنی؛ ایکوموس: برلین، آلمان، ۲۰۰۸٫ [ Google Scholar ]
  55. بای، ن. نوریان، پ. لو، آر. Pereira Roders، A. “چه چیزی OUV است” تجدید نظر: تفسیر محاسباتی در بیانیه های ارزش جهانی برجسته. ISPRS Ann. فتوگرام از راه دور. حس تفت. Inf. علمی ۲۰۲۱ ، VIII-M-1-2021 ، ۲۵-۳۲٫ [ Google Scholar ] [ CrossRef ]
  56. ون دایک، جی. فلیکر و فرهنگ ارتباط: اشتراک گذاری دیدگاه ها، تجربیات، خاطرات. مم گل میخ. ۲۰۱۱ ، ۴ ، ۴۰۱-۴۱۵٫ [ Google Scholar ] [ CrossRef ]
  57. لین، TY; مایر، م. بلنگی، اس. هیز، جی. پرونا، پی. رامانان، دی. دلار، پی. Zitnick، CL مایکروسافت COCO: اشیاء مشترک در زمینه. در مجموعه مقالات کنفرانس اروپایی بینایی کامپیوتر، زوریخ، سوئیس، ۶ تا ۱۲ سپتامبر ۲۰۱۴٫ Springer: برلین/هایدلبرگ، آلمان، ۲۰۱۴; صص ۷۴۰-۷۵۵٫ [ Google Scholar ]
  58. تنکانن، اچ. دی مینین، ای. هایکینهایمو، وی. هاسمن، ا. هربست، ام. کاجالا، ال. Toivonen، T. Instagram، Flickr، یا Twitter: ارزیابی قابلیت استفاده از داده های رسانه های اجتماعی برای نظارت بر بازدیدکنندگان در مناطق حفاظت شده. علمی Rep. ۲۰۱۷ , ۷ , ۱۷۶۱۵٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
  59. لی، دی. ژو، ایکس. وانگ، ام. تجزیه و تحلیل و تجسم تعاملات فضایی بین گردشگران و افراد محلی: مطالعه فلیکر در ده شهر ایالات متحده. شهرها ۲۰۱۸ ، ۷۴ ، ۲۴۹-۲۵۸٫ [ Google Scholar ] [ CrossRef ]
  60. Huiskes، MJ; Lew، MS ارزیابی بازیابی MIR Flickr. در مجموعه مقالات اولین کنفرانس بین المللی ACM در مورد بازیابی اطلاعات چند رسانه ای، MIR2008، که با کنفرانس بین المللی ACM در سال ۲۰۰۸ در چند رسانه ای، MM’08، ونکوور، BC، کانادا، ۳۰ تا ۳۱ اکتبر ۲۰۰۸ واقع شده است. صص ۳۹-۴۳٫ [ Google Scholar ] [ CrossRef ]
  61. چوآ، تی اس؛ تانگ، جی. هونگ، آر. لی، اچ. لو، ز. Zheng, Y. NUS-WIDE: پایگاه داده تصاویر وب دنیای واقعی از دانشگاه ملی سنگاپور. در مجموعه مقالات کنفرانس بین المللی ACM در مورد بازیابی تصویر و ویدئو، جزیره سانتورینی، یونان، ۸ تا ۱۰ ژوئیه ۲۰۰۹٫ صفحات ۱-۹٫ [ Google Scholar ]
  62. تانگ، ال. لیو، اچ. یادگیری رابطه‌ای از طریق ابعاد اجتماعی پنهان. در مجموعه مقالات پانزدهمین کنفرانس بین المللی ACM SIGKDD در مورد کشف دانش و داده کاوی، پاریس، فرانسه، ۲۸ ژوئن تا ۱ ژوئیه ۲۰۰۹٫ صص ۸۱۷-۸۲۶٫ [ Google Scholar ]
  63. دنگ، ج. دونگ، دبلیو. سوچر، آر. لی، ال جی; لی، ک. لی، F.-F. ImageNet: پایگاه داده تصویر سلسله مراتبی در مقیاس بزرگ. در مجموعه مقالات کنفرانس IEEE 2009 در مورد بینایی کامپیوتری و تشخیص الگو، میامی، FL، ایالات متحده آمریکا، ۲۰-۲۵ ژوئن ۲۰۰۹٫ IEEE: نیویورک، نیویورک، ایالات متحده آمریکا، ۲۰۰۹; صص ۲۴۸-۲۵۵٫ [ Google Scholar ]
  64. کریژفسکی، آ. سوتسکور، آی. هینتون، GE ImageNet طبقه بندی با شبکه های عصبی پیچیده عمیق. در مجموعه مقالات کنفرانس سالانه سیستم‌های پردازش اطلاعات عصبی، دریاچه تاهو، کالیفرنیا، ایالات متحده آمریکا، ۳ تا ۸ دسامبر ۲۰۱۲٫ [ Google Scholar ]
  65. پلامر، کارشناسی; وانگ، ال. سروانتس، سی ام. Caicedo, JC; هاکن مایر، جی. Lazebnik، S. Flickr30k Entities: جمع آوری تناظرهای منطقه به عبارت برای مدل های تصویر به جمله غنی تر. در مجموعه مقالات کنفرانس بین المللی IEEE در بینایی کامپیوتر، سانتیاگو، شیلی، ۷ تا ۱۳ دسامبر ۲۰۱۵٫ صص ۲۶۴۱-۲۶۴۹٫ [ Google Scholar ]
  66. ژو، ی. لانگ، Y. SinoGrids: تمرینی برای داده های شهری باز در چین. کارتوگر. Geogr. Inf. علمی ۲۰۱۶ ، ۴۳ ، ۳۷۹-۳۹۲٫ [ Google Scholar ] [ CrossRef ]
  67. زنگ، اچ. ژو، اچ. سریواستاوا، ا. کنان، ر. Prasanna, V. GraphSAINT: روش یادگیری استقرایی مبتنی بر نمونه گیری نمودار. arXiv ۲۰۱۹ ، arXiv:1907.04931. [ Google Scholar ]
  68. ژو، بی. لاپدریزا، ا. شیائو، جی. تورالبا، ا. Oliva, A. یادگیری ویژگی های عمیق برای تشخیص صحنه با استفاده از پایگاه داده مکان ها. در مجموعه مقالات کنفرانس سالانه سیستم‌های پردازش اطلاعات عصبی، مونترال، QC، کانادا، ۸ تا ۱۳ دسامبر ۲۰۱۴٫ صفحات ۱-۹٫ [ Google Scholar ]
  69. ژو، بی. لاپدریزا، ا. خسلا، ع. اولیوا، ا. Torralba, A. Places: یک پایگاه داده ۱۰ میلیونی تصویر برای تشخیص صحنه. IEEE Trans. الگوی مقعدی ماخ هوشمند ۲۰۱۷ ، ۴۰ ، ۱۴۵۲-۱۴۶۴٫ [ Google Scholar ] [ CrossRef ]
  70. پترسون، جی. Hays, J. SUN Attribute Database: Discovering, Annotating, and Recognizing Scene Attribute. در مجموعه مقالات کنفرانس IEEE 2012 در مورد دید کامپیوتری و تشخیص الگو، پراویدنس، RI، ایالات متحده آمریکا، ۱۶-۲۱ ژوئن ۲۰۱۲٫ IEEE: نیویورک، نیویورک، ایالات متحده آمریکا، ۲۰۱۲؛ صص ۲۷۵۱-۲۷۵۸٫ [ Google Scholar ]
  71. پترسون، جی. خو، سی. سو، اچ. Hays, J. پایگاه داده ویژگی های خورشید: فراتر از دسته بندی ها برای درک عمیق تر صحنه. بین المللی جی. کامپیوتر. Vis. ۲۰۱۴ ، ۱۰۸ ، ۵۹-۸۱٫ [ Google Scholar ] [ CrossRef ]
  72. او، ک. ژانگ، ایکس. رن، اس. Sun، J. یادگیری باقیمانده عمیق برای تشخیص تصویر. در مجموعه مقالات کنفرانس IEEE در مورد دید کامپیوتری و تشخیص الگو، لاس وگاس، NV، ایالات متحده، ۲۷-۳۰ ژوئن ۲۰۱۶٫ صص ۷۷۰-۷۷۸٫ [ Google Scholar ]
  73. شروف، اف. کالنیچنکو، دی. فیلبین، جی. فیس نت: تعبیه یکپارچه برای تشخیص چهره و خوشه بندی. در مجموعه مقالات کنفرانس IEEE در مورد بینایی کامپیوتری و تشخیص الگو، بوستون، MA، ایالات متحده آمریکا، ۷ تا ۱۲ ژوئن ۲۰۱۵٫ صص ۸۱۵-۸۲۳٫ [ Google Scholar ]
  74. کائو، کیو. شن، ال. زی، دبلیو. پرخی، OM; Zisserman، A. VGGFace2: مجموعه داده ای برای تشخیص چهره ها در ژست و سن. در مجموعه مقالات سیزدهمین کنفرانس بین المللی IEEE در سال ۲۰۱۸ در مورد تشخیص خودکار چهره و ژست (FG 2018)، شیان، چین، ۱۵ تا ۱۹ مه ۲۰۱۸؛ IEEE: نیویورک، نیویورک، ایالات متحده آمریکا، ۲۰۱۸؛ صص ۶۷-۷۴٫ [ Google Scholar ]
  75. واسوانی، ع. Shazeer, N. پارمار، ن. Uszkoreit، J. جونز، ال. گومز، AN; قیصر، ال. Polosukhin، I. توجه تمام چیزی است که شما نیاز دارید. در مجموعه مقالات سی و یکمین کنفرانس بین المللی سیستم های پردازش اطلاعات عصبی، لانگ بیچ، کالیفرنیا، ایالات متحده آمریکا، ۴ تا ۹ دسامبر ۲۰۱۷؛ صفحات ۶۰۰۰–۶۰۱۰٫ [ Google Scholar ]
  76. دولین، جی. چانگ، مگاوات؛ تره فرنگی.؛ Toutanova، K. BERT: پیش آموزش ترانسفورماتورهای عمیق دو جهته برای درک زبان. در مجموعه مقالات کنفرانس ۲۰۱۹ بخش آمریکای شمالی انجمن زبان‌شناسی محاسباتی: فناوری‌های زبان انسانی، مینیاپولیس، MN، ایالات متحده آمریکا، ۲ تا ۷ ژوئن ۲۰۱۹؛ انجمن زبان‌شناسی محاسباتی: استرودزبورگ، PA، ایالات متحده آمریکا، ۲۰۱۹؛ جلد ۱ (مقالات بلند و کوتاه)، ص ۴۱۷۱–۴۱۸۶٫ [ Google Scholar ]
  77. کلارک، ک. کهندلوال، U. لوی، او. منینگ، سی دی برت به چه چیزی نگاه می کند؟ در تحلیلی از توجه BERT. در مجموعه مقالات کارگاه ACL 2019 BlackboxNLP: تجزیه و تحلیل و تفسیر شبکه های عصبی برای NLP، BlackboxNLP@ACL ۲۰۱۹، فلورانس، ایتالیا، ۱ اوت ۲۰۱۹؛ انجمن زبان‌شناسی محاسباتی: استرودزبورگ، PA، ایالات متحده آمریکا، ۲۰۱۹؛ صص ۲۷۶-۲۸۶٫ [ Google Scholar ] [ CrossRef ]
  78. سان، سی. کیو، ایکس. خو، ی. Huang, X. چگونه BERT را برای طبقه بندی متن تنظیم کنیم؟ در مجموعه مقالات کنفرانس ملی چین در مورد زبان شناسی محاسباتی چینی، کونمینگ، چین، ۱۸ تا ۲۰ اکتبر ۲۰۱۹؛ یادداشت های سخنرانی در علوم کامپیوتر (از جمله زیر مجموعه یادداشت های سخنرانی در هوش مصنوعی و یادداشت های سخنرانی در بیوانفورماتیک). Springer: Cham، سوئیس، ۲۰۱۹; جلد ۱۱۸۵۶ LNAI، ص ۱۹۴–۲۰۶٫ [ Google Scholar ] [ CrossRef ]
  79. بای، ن. لو، آر. نوریان، پ. Pereira Roders، A. میراث کیست: طبقه بندی بیانیه های میراث جهانی یونسکو با عنوان “ارزش جهانی برجسته” با برچسب های نرم. در یافته های انجمن زبانشناسی محاسباتی: EMNLP 2021 ؛ انجمن زبانشناسی محاسباتی: پونتا کانا، جمهوری دومینیکن، ۲۰۲۱؛ صص ۳۶۶-۳۸۴٫ [ Google Scholar ]
  80. Reiter, R. Towards a Logical Reconstruction of Relational Database Theory. در مباحث سیستم های اطلاعاتی ; Brodie, ML, Mylopoulos, J., Schmidt, JW, Eds.; Springer: نیویورک، نیویورک، ایالات متحده آمریکا، ۱۹۸۴; صص ۱۹۱-۲۳۸٫ [ Google Scholar ] [ CrossRef ]
  81. نوریان، پ. رضوانی، س. سارییلدیز، آی. ون در هوون، F. مدلسازی طیفی برای تحلیل شبکه فضایی. در مجموعه مقالات سمپوزیوم شبیه سازی برای معماری و طراحی شهری (simAUD 2016)، لندن، انگلستان، ۱۶-۱۸ مه ۲۰۱۶٫ صص ۱۰۳-۱۱۰٫ [ Google Scholar ]
  82. هیلیر، بی. هانسون، جی . منطق اجتماعی فضا . انتشارات دانشگاه کمبریج: کمبریج، بریتانیا، ۱۹۸۹٫ [ Google Scholar ]
  83. Penn, A. نحو فضا و شناخت فضایی: یا چرا خط محوری؟ محیط زیست رفتار ۲۰۰۳ ، ۳۵ ، ۳۰-۶۵٫ [ Google Scholar ] [ CrossRef ]
  84. راتی، سی. نحو فضا: برخی ناسازگاری ها. محیط زیست طرح. طرح. دس ۲۰۰۴ ، ۳۱ ، ۴۸۷-۴۹۹٫ [ Google Scholar ] [ CrossRef ]
  85. بلانچارد، پی. ولچنکوف، دی. تحلیل ریاضی شبکه‌های فضایی شهری . Springer: برلین، آلمان، ۲۰۰۸٫ [ Google Scholar ]
  86. بوئینگ، G. OSMnx: روش‌های جدید برای دستیابی، ساخت، تجزیه و تحلیل و تجسم شبکه‌های پیچیده خیابانی. محاسبه کنید. محیط زیست سیستم شهری ۲۰۱۷ ، ۶۵ ، ۱۲۶-۱۳۹٫ [ Google Scholar ] [ CrossRef ]
  87. هاولی، پی. اسکات، ام. ردموند، دی. پایداری در مقابل زیست پذیری: بررسی رضایت همسایگی. جی. محیط زیست. طرح. مدیریت ۲۰۰۹ ، ۵۲ ، ۸۴۷-۸۶۴٫ [ Google Scholar ] [ CrossRef ]
  88. هوارد، جی. Ruder, S. مدل زبان جهانی تنظیم دقیق برای طبقه بندی متن. در مجموعه مقالات پنجاه و ششمین نشست سالانه انجمن زبانشناسی محاسباتی، ACL 2018، ملبورن، استرالیا، ۱۵ تا ۲۰ ژوئیه ۲۰۱۸؛ انجمن زبانشناسی محاسباتی: استرودزبورگ، PA، ایالات متحده آمریکا، ۲۰۱۸؛ جلد ۱: مقالات بلند، ص ۳۲۸-۳۳۹٫ [ Google Scholar ] [ CrossRef ]
  89. زو، ایکس. گلدبرگ، AB مقدمه ای بر یادگیری نیمه نظارتی. مصنوعی. لکت. آرتیف. هوشمند ماخ فرا گرفتن. ۲۰۰۹ ، ۳ ، ۱-۱۳۰٫ [ Google Scholar ]
  90. پوستجوفسکی، جی. استابس، الف. حاشیه نویسی زبان طبیعی برای یادگیری ماشینی: راهنمای ساخت مجموعه برای کاربردها . O’Reilly Media, Inc.: Sebastopol, CA, USA, 2012. [ Google Scholar ]
  91. سون، ک. برتلوت، دی. کارلینی، ن. ژانگ، ز. ژانگ، اچ. رافل، کالیفرنیا؛ Cubuk، ED; کوراکین، آ. Li, CL FixMatch: ساده سازی یادگیری نیمه نظارت شده با ثبات و اطمینان. Adv. عصبی Inf. روند. سیستم ۲۰۲۰ ، ۳۳ ، ۵۹۶-۶۰۸٫ [ Google Scholar ]
  92. ولدپاوس، ال. Roders، AP یادگیری از یک میراث: ونیز تا والتا. چانگ. در طول زمان ۲۰۱۴ ، ۴ ، ۲۴۴-۲۶۳٫ [ Google Scholar ] [ CrossRef ]
  93. Gustcoven، E. ویژگی های شهرهای میراث جهانی، پایداری توسط مدیریت – مطالعه مقایسه ای بین شهرهای میراث جهانی آمستردام، ادینبورگ و کوئرتارو. پایان نامه کارشناسی ارشد، KU Leuven، Leuven، بلژیک، ۲۰۱۶٫ [ Google Scholar ]
  94. یونسکو میراث در بافت شهری: تأثیر پروژه‌های توسعه بر ویژگی‌های میراث جهانی در شهرها . گزارش فنی؛ مرکز میراث جهانی یونسکو: پاریس، فرانسه، ۲۰۲۰٫ [ Google Scholar ]
  95. پدرگوسا، اف. واروکو، جی. گرامفورت، آ. میشل، وی. تیریون، بی. گریزل، او. بلوندل، م. پرتنهوفر، پی. ویس، آر. دوبورگ، وی. و همکاران Scikit-Learn: یادگیری ماشینی در پایتون. جی. ماخ. فرا گرفتن. Res. ۲۰۱۱ ، ۱۲ ، ۲۸۲۵-۲۸۳۰٫ [ Google Scholar ]
  96. هینتون، رویه‌های یادگیری اتصال‌گرای جنرال الکتریک. در یادگیری ماشینی ؛ الزویر: آمستردام، هلند، ۱۹۹۰; صص ۵۵۵-۶۱۰٫ [ Google Scholar ]
  97. آلتمن، NS مقدمه ای بر رگرسیون ناپارامتریک هسته و نزدیکترین همسایه. صبح. آمار ۱۹۹۲ ، ۴۶ ، ۱۷۵-۱۸۵٫ [ Google Scholar ]
  98. Rish، I. مطالعه تجربی طبقه‌بندی‌کننده ساده‌لوح بیز. در مجموعه مقالات کارگاه آموزشی IJCAI 2001 در مورد روشهای تجربی در هوش مصنوعی، سیاتل، WA، ایالات متحده آمریکا، ۴ تا ۱۰ اوت ۲۰۰۱٫ جلد ۳، ص ۴۱-۴۶٫ [ Google Scholar ]
  99. پلات، جی. خروجی های احتمالی برای ماشین های بردار پشتیبان و مقایسه با روش های درستنمایی منظم. Adv. طبقه بندی حاشیه بزرگ. ۱۹۹۹ ، ۱۰ ، ۶۱-۷۴٫ [ Google Scholar ]
  100. بریمن، ال. جنگل های تصادفی. ماخ فرا گرفتن. ۲۰۰۱ ، ۴۵ ، ۵-۳۲٫ [ Google Scholar ] [ CrossRef ]
  101. بریمن، ال. پیش بینی کننده های بگینگ. ماخ فرا گرفتن. ۱۹۹۶ ، ۲۴ ، ۱۲۳-۱۴۰٫ [ Google Scholar ] [ CrossRef ]
  102. آرلوت، اس. سلیس، الف. بررسی رویه‌های اعتبارسنجی متقابل برای انتخاب مدل. آمار Surv. ۲۰۱۰ ، ۴ ، ۴۰-۷۹٫ [ Google Scholar ] [ CrossRef ]
  103. روش‌های گروه ژو، ZH : مبانی و الگوریتم‌ها . CRC Press: Boca Raton، FL، USA، ۲۰۱۲٫ [ Google Scholar ]
  104. بریمن، ال. رگرسیون های انباشته. ماخ فرا گرفتن. ۱۹۹۶ ، ۲۴ ، ۴۹-۶۴٫ [ Google Scholar ] [ CrossRef ]
  105. هاگبرگ، ا. Swart، P. S Chult، D. کاوش ساختار، دینامیک و عملکرد شبکه با استفاده از NetworkX ; گزارش فنی؛ آزمایشگاه ملی لس آلاموس (LANL): Los Alamos, NM, USA, 2008. [ Google Scholar ]
  106. کاریپیس، جی. کومار، V. تجزیه و تحلیل پارتیشن بندی نمودار چند سطحی. در مجموعه مقالات کنفرانس ACM/IEEE 1995 در مورد ابرکامپیوترها-Supercomputing’95، سن دیگو، کالیفرنیا، ایالات متحده آمریکا، ۳-۸ دسامبر ۱۹۹۵; IEEE: نیویورک، نیویورک، ایالات متحده آمریکا، ۱۹۹۵; پ. ۲۹٫ [ Google Scholar ] [ CrossRef ]
  107. لافون، اس. لی، AB Diffusion Maps and Coarse-Graining: چارچوبی یکپارچه برای کاهش ابعاد، پارتیشن بندی نمودار و پارامترسازی مجموعه داده ها. IEEE Trans. الگوی مقعدی ماخ هوشمند ۲۰۰۶ ، ۲۸ ، ۱۳۹۳-۱۴۰۳٫ [ Google Scholar ] [ CrossRef ]
  108. گائو، اچ. جی، اس. گراف U-Nets. در مجموعه مقالات کنفرانس بین المللی یادگیری ماشین، PMLR 2019، لانگ بیچ، کالیفرنیا، ایالات متحده آمریکا، ۹ تا ۱۵ ژوئن ۲۰۱۹؛ ص ۲۰۸۳–۲۰۹۲٫ [ Google Scholar ]
  109. انکالادا-آبارکا، ال. فریرا، سی سی; روشا، جی. سنجش تشدید گردشگری در مقاصد شهری: رویکردی مبتنی بر تحلیل فراکتال. J. Travel Res. ۲۰۲۲ ، ۶۱ ، ۳۹۴-۴۱۳٫ [ Google Scholar ] [ CrossRef ]
  110. Eom، YH; Jo, HH Tail-scope: استفاده از دوستان برای تخمین دم های سنگین توزیع های درجه در شبکه های پیچیده مقیاس بزرگ. علمی Rep. ۲۰۱۵ , ۵ , ۰۹۷۵۲٫ [ Google Scholar ] [ CrossRef ]
  111. Psarra, S. The Venice Variations: Tracing the Architectural Imagination ; UCL Press: لندن، بریتانیا، ۲۰۱۸٫ [ Google Scholar ]
  112. بلوم، ا. میچل، تی. ترکیب داده های برچسب دار و بدون برچسب با آموزش مشترک. در مجموعه مقالات یازدهمین کنفرانس سالانه نظریه یادگیری محاسباتی، مدیسون، WI، ایالات متحده آمریکا، ۲۴-۲۶ ژوئیه ۱۹۹۸; صص ۹۲-۱۰۰٫ [ Google Scholar ]
  113. وانگ، ی. یائو، کیو. Kwok، JT; Ni، LM تعمیم از چند مثال: نظرسنجی در یادگیری چند شات. کامپیوتر ACM. Surv. ۲۰۲۰ ، ۵۳ ، ۱-۳۴٫ [ Google Scholar ] [ CrossRef ]
  114. ولیچکوویچ، پ. کوکورول، جی. کازانووا، آ. رومرو، آ. لیو، پی. Bengio، Y. گراف شبکه های توجه. در مجموعه مقالات ششمین کنفرانس بین‌المللی بازنمایی‌های یادگیری، ICLR 2018، ونکوور، BC، کانادا، ۳۰ آوریل تا ۳ مه ۲۰۱۸؛ صص ۱-۱۲٫ [ Google Scholar ]
  115. میاه، اس جی. Vu، HQ; گامک، جی. مک گراث، ام. روش تجزیه و تحلیل کلان داده برای تحلیل رفتار گردشگران. Inf. مدیریت ۲۰۱۷ ، ۵۴ ، ۷۷۱-۷۸۵٫ [ Google Scholar ] [ CrossRef ]
  116. آدامیک، لس آنجلس; Adar، E. دوستان و همسایگان در وب. Soc. شبکه ۲۰۰۳ ، ۲۵ ، ۲۱۱-۲۳۰٫ [ Google Scholar ] [ CrossRef ]
  117. مجید، ع. چن، ال. چن، جی. میرزا، ح.ت. حسین، من. وودوارد، جی. یک سیستم توصیه مسافرتی شخصی‌شده مبتنی بر برچسب جغرافیایی داده‌کاوی رسانه‌های اجتماعی. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۳ ، ۲۷ ، ۶۶۲-۶۸۴٫ [ Google Scholar ] [ CrossRef ]
  118. پانگ، ی. ژائو، ی. Li, D. Graph Pooling از طریق Coarsened Graph Infomax. در مجموعه مقالات چهل و چهارمین کنفرانس بین المللی ACM SIGIR در مورد تحقیق و توسعه در بازیابی اطلاعات، مجازی، ۱۱ تا ۱۵ ژوئیه ۲۰۲۱؛ صص ۲۱۷۷–۲۱۸۱٫ [ Google Scholar ]
  119. ژانگ، ام. کوی، ز. نویمان، ام. Chen, Y. معماری یادگیری عمیق پایان به پایان برای طبقه بندی نمودار. در مجموعه مقالات سی و دومین کنفرانس AAAI در مورد هوش مصنوعی، نیواورلئان، لس آنجلس، ایالات متحده آمریکا، ۲ تا ۷ فوریه ۲۰۱۸؛ صص ۴۴۳۸-۴۴۴۵٫ [ Google Scholar ]
  120. دوست خوب، من. پوگت آبادی، ج. میرزا، م. خو، بی. وارد-فارلی، دی. اوزایر، س. کورویل، آ. Bengio، Y. شبکه های متخاصم مولد. در مجموعه مقالات کنفرانس سالانه سیستم‌های پردازش اطلاعات عصبی، مونترال، QC، کانادا، ۸ تا ۱۳ دسامبر ۲۰۱۴٫ صص ۲۶۷۲–۲۶۸۰٫ [ Google Scholar ]
  121. ممکن است.؛ رن، ز. جیانگ، ز. تانگ، جی. یین، دی. تعبیه شبکه چند بعدی با ساختار سلسله مراتبی. در مجموعه مقالات یازدهمین کنفرانس بین المللی ACM در جستجوی وب و داده کاوی، لس آنجلس، کالیفرنیا، ایالات متحده آمریکا، ۵ تا ۹ فوریه ۲۰۱۸؛ صص ۳۸۷-۳۹۵٫ [ Google Scholar ]
  122. نگوین، جی اچ. لی، جی بی. روسی، RA; احمد، NK; کوه، ای. کیم، اس. جاسازی‌های شبکه پویا در زمان پیوسته. در مجموعه مقالات مجموعه مقالات کنفرانس وب ۲۰۱۸، لیون، فرانسه، ۲۳ تا ۲۷ آوریل ۲۰۱۸٫ ص ۹۶۹-۹۷۶٫ [ Google Scholar ]
  123. یوستر، آر. Zwick، U. ضرب ماتریس پراکنده سریع. ACM Trans. الگوریتم‌ها ۲۰۰۵ ، ۱ ، ۲-۱۳٫ [ Google Scholar ] [ CrossRef ]
  124. اوری، جی. Larsen, J. The Tourist Gaze 3.0 ; SAGE: Thousand Oaks، CA، USA، ۲۰۱۱٫ [ Google Scholar ]
  125. Bekker, R. ایجاد بینش در گردشگری با عکاسی فلیکر، تجسم و تجزیه و تحلیل الگوهای مکانی و زمانی در ونیز. پایان نامه کارشناسی ارشد، Rijksuniversiteit Groningen، Groningen، هلند، ۲۰۲۰٫ [ Google Scholar ]
شکل ۱٫ چارچوبی برای ایجاد مجموعه داده های یادگیری ماشین چندوجهی به عنوان نمودارهای نسبت داده شده از منابع داده بدون ساختار.
شکل ۲٫ جریان داده فرآیند تولید ویژگی چندوجهی یک پست نمونه در ونیز، در حالی که ساخت نمودار به تمام نقاط داده مجموعه داده نیاز دارد. پست اصلی متعلق به کاربر ۱۷۷۲۶۳۲۰@N03 تحت مجوز CC BY-NC-SA 2.0 است.
شکل ۳٫ نسبت پست ها و جملاتی که به عنوان هر ارزش میراثی (معیار انتخاب OUV) به عنوان پیش بینی های برتر توسط BERT و ULMFiT پیش بینی و برچسب گذاری شده اند. یک جمله معمولی از هر دسته نیز در سمت راست شکل آورده شده است.
شکل ۴٫ نمونه های تصویر معمولی در هر شهر که به عنوان هر دسته ویژگی میراث (صحنه نشان داده شده) و نمودارهای نواری نسبت آنها در مجموعه داده ها (طول نوارهای پس زمینه آبی روشن نشان دهنده ۵۰٪) برچسب گذاری شده است. سه مثال با اطمینان بالا و یک مثال منفی با اطمینان کم (در کادر قرمز) آورده شده است. همه تصاویر ۱۵۰ × ۱۵۰ پیکسل “تصاویر کوچک” هستند که به عنوان “قابل دانلود” پرچم گذاری شده اند.
شکل ۵٫ شبکه های جغرافیایی پشتیبان برای سه مطالعه موردی، به ترتیب، ساختار نمودار، توزیع رتبه بندی درجه، و توزیع رتبه بندی پست ها در هر گره جغرافیایی- فضایی (در مقیاس لگاریتمی) را در آمستردام، سوژو، ونیز و Venice-XL. اندازه گره ها تعداد پست های نزدیک به گره ها را نشان می دهد و رنگ گره ها درجه گره را در نمودار نشان می دهد. هر پیوند دو گره قابل دسترسی را در عرض ۲۰ دقیقه به یکدیگر متصل می کند.
شکل ۶٫ نمودارهای اندازه رتبه توزیع درجه در سه مورد آمستردام، سوژو و ونیز، با توجه به پیوندهای زمانی، پیوندهای اجتماعی، پیوندهای فضایی، و همچنین کل نمودار چندگانه.

دیدگاهتان را بنویسید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *

خانهدربارهتماسارتباط با ما