۱٫ معرفی
با رواج دستگاههای تلفن همراه با قابلیت موقعیتیابی، مانند تلفنهای هوشمند و ساعتها، مقدار زیادی از مسیر حرکت افراد در فضای جغرافیایی جمعآوری شده است. این مسیرها برای کاربردهای مختلف، مانند حمل و نقل هوشمند [ ۱ ] و برنامه ریزی شهری [ ۲ ، ۳ ] ارزشمند هستند. با این حال، از آنجایی که مسیرها حاوی اطلاعات حساسی هستند، انتشار مستقیم یا به اشتراک گذاری آنها ممکن است تهدیدی جدی برای حریم خصوصی افراد باشد. دشمنان می توانند افراد را شناسایی کرده و آدرس خانه، وضعیت سلامت و سرگرمی های آنها را بیشتر استنباط کنند [ ۴ ، ۵ ، ۶ ]] از مسیر حرکت آنها. بنابراین، طراحی روشهای موثر حفاظت از حریم خصوصی برای پاکسازی مسیرها قبل از انتشار یا اشتراکگذاری بسیار مهم است.
تلاشهای زیادی برای حفظ حریم خصوصی انتشار دادههای مسیر انجام شده است. کار اولیه مدلهای حریم خصوصی مبتنی بر پارتیشن [ ۷ ، ۸ ]، مانند k -anonymity [ ۹ ]، l -diversity [ ۱۰ ] و t -closeness [ ۱۱ ] را برای سالمسازی مسیرها اتخاذ میکند. با این حال، مدلهای حفظ حریم خصوصی فوقالذکر از اشکالاتی رنج میبرند که بسته به دانش پیشزمینه دشمنان، آسیبپذیر بودن در برابر حملات مختلف [ ۱۲ ، ۱۳ ]] و ضمانت نظری ناکافی حفظ حریم خصوصی. در نتیجه، حریم خصوصی متمایز به عنوان یک مدل حریم خصوصی دقیق مستقل از دانش پسزمینه پدیدار شد و به طور گسترده در انتشار دادههای خط سیر حفظ حریم خصوصی استفاده میشود [ ۱۴ ، ۱۵ ، ۱۶ ، ۱۷ ، ۱۸ ، ۱۹ ، ۲۰ ].
با این حال، اعمال مستقیم حریم خصوصی دیفرانسیل در داده های مسیر چالش برانگیز است. با توجه به ابعاد ذاتی بالا و فضای بینهایت فضایی (موقعیت) دادههای مسیر، برای اطمینان از حریم خصوصی دیفرانسیل، نیاز به نویز وسیعی دارد که منجر به کاربرد ضعیف مسیر مصنوعی آزاد شده میشود. برای غلبه بر چالشها، تحقیقات موجود بر روی تولید مسیرهای مصنوعی با کاربرد بالا تحت محدودیتهای خصوصی متفاوت متمرکز است. از منظر گسستهسازی فضای فضایی، روشهای تولید مسیر خصوصی متفاوت موجود را میتوان به دو کلاس طبقهبندی کرد، یعنی روشهای مبتنی بر پارتیشن شبکه و روشهای مبتنی بر تعمیم مکان.
روشهای مبتنی بر پارتیشن شبکهای را میتوان بیشتر به دو زیر کلاس تقسیم کرد، به عنوان مثال، روشهای مبتنی بر درخت پیشوند و روشهای مبتنی بر مدل مارکوف. درخت پیشوند رایجترین ساختار شاخص مورد استفاده در مکانیزمهای پاکسازی مسیر خصوصی متفاوت برای پاسخ به پرسشهای شمارش مختلف و تولید مسیرهای مصنوعی است. چن و همکاران [ ۱۵ ] ابتدا درخت پیشوند نویزدار را برای پاکسازی داده های مسیر معرفی کرد. برای بهبود کارایی و کاربرد داده، او و همکاران. [ ۱۷ ] چارچوب DPT را پیشنهاد کرد که یک سیستم مرجع سلسله مراتبی را برای تفکیک دادههای مسیر GPS اتخاذ میکند و از مکانیسم نمونهگیری وزندار جهت برای بهبود بیشتر کاربرد داده مسیرهای مصنوعی استفاده میکند. SafePath [ ۲۱] همچنین مسیرها را در یک درخت پیشوند مدل می کند. اخیراً Cai و همکاران. [ ۲۲ ] روش جدیدی برای ساخت درخت پیشوند پر سر و صدا برای صرفه جویی در بودجه حفظ حریم خصوصی پیشنهاد کرد. مکانیسم های فوق به طور فشرده اطلاعات مسیرهای خام را به صورت فشرده رمزگذاری می کنند و اطلاعات مسیرهای خام را در یک درخت پیشوند پر سر و صدا می شمارند و سپس مسیرهای پاکسازی شده را مطابق با درخت بازسازی و آزاد می کنند. انتظار میرود که مسیرهای ضدعفونیشده، کاربرد بالایی را برای پرسوجوهای شمارش و کارهای مکرر الگوبرداری حفظ کنند. با این حال، تعداد گره ها با رشد درخت پیشوند به شدت کاهش می یابد. در نتیجه، نویز اضافه شده در مقایسه با شمارش نسبتاً زیاد است و در نتیجه دادههای مسیر آزاد شده را از دست میدهد.
برای رفع نواقص روشهای مبتنی بر پارتیشن شبکه و بهبود کاربرد مسیرهای مصنوعی، چندین روش مبتنی بر مدل مارکوف پیشنهاد شدهاند. گوسوری و همکاران [ ۲۳ ] چارچوب DP-Star (ناشر خط سیر مصنوعی خصوصی متفاوت) را پیشنهاد کرد. DP-Star فضای مکان را با شبکههای تطبیقی گسسته میکند و با استفاده از آمار خصوصی متفاوت، از جمله توزیع سفر، توزیع طول مسیر، ماتریس انتقال حالت، مسیرهای مصنوعی تولید میکند. قانع و همکاران [ ۱۹ ] یک مدل مولد گرافیکی، TGM، برای تولید مسیرهای مصنوعی خصوصی متفاوت با حفظ اطلاعات ماندگار طراحی کرد.
روش های ذکر شده در بالا، فضای مکان را با پارتیشن شبکه مستقل از داده فشرده یا گسسته می کند، که حفظ توزیع چگالی فضایی مسیرها را دشوار می کند. برای غلبه بر این نقص، چندین روش مبتنی بر تعمیم مکان پیشنهاد شده است. هوآ و همکاران [ ۲۴ ] اولین الگوریتم تعمیم خصوصی متفاوت را برای رهاسازی مسیرها پیشنهاد کرد که مسیرهای نزدیک به یکدیگر را با استفاده از مکانیسم نمایی خوشه بندی می کرد. برای غلبه بر کاستی های [ ۲۴ ]، لی و همکاران. [ ۲۵] یک مکانیسم انتشار داده های مسیر خصوصی متفاوت مبتنی بر نویز لاپلاس محدود را برای بهبود کاربرد مسیرهای بازسازی شده پیشنهاد کرد. مزیت روش مبتنی بر تعمیم در فشرده سازی جهان مکان آگاه از چگالی وابسته به داده است. با این حال، روش فرعی متفاوت خوشه بندی خصوصی روش های فوق از نظر محاسباتی گران است.
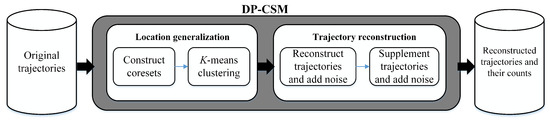
اگرچه کارهای قبلی در مورد انتشار دادههای مسیر خصوصی متفاوت وجود داشته است، این آثار از کاربرد دادههای بهینه و مقیاسپذیری ضعیف رنج میبرند. با انگیزه کارایی بالای هستههای مرکزی در خوشهبندی دادههای بزرگ [ ۲۶ ] و هزینه نویز کمتر مکانیسم راه پله [ ۲۷ ]، ما یک مکانیسم انتشار مسیر خصوصی متفاوت مبتنی بر تعمیم را با استفاده از خوشهبندی مبتنی بر مجموعه هسته و مکانیسم افزایش نویز راه پله پیشنهاد میکنیم. ، به نام DP-CSM، برای ارائه مقیاس پذیری و کاربردی بالا در حین تضمین ϵ-حریم خصوصی متفاوت DP-CSM شامل دو مرحله است: تعمیم مکان و بازسازی مسیر. در مرحله تعمیم مکان، ما یک مجموعه هسته ای برای مکان های مسیرهای اصلی در هر مهر زمانی می سازیم. در مقایسه با روشهای تعمیم مکان موجود، هستههای مرکزی میتوانند کارایی خوشهبندی k-means را تا حد زیادی بهبود بخشند [ ۲۸ ، ۲۹ ] . در مرحله بازسازی مسیر، مکانیسم راه پله به جای مکانیسم لاپلاس به عنوان مکانیسم افزایش نویز انتخاب می شود. این به این دلیل است که مکانیسم راه پله با همان بودجه حفظ حریم خصوصی [ ۲۷ ] سر و صدای کمتری نسبت به مکانیسم لاپلاس اضافه میکند و در نتیجه کاربرد داده بالا را حفظ میکند.
به طور خاص، مشارکت های این مقاله به شرح زیر است.
-
ما خوشهبندی مبتنی بر مجموعه هسته را به مرحله تعمیم مکان معرفی میکنیم تا کارایی و مقیاسپذیری تولید مسیر مصنوعی را بهبود بخشیم. Coresets، به جای مجموعه داده اصلی، برای خوشه بندی استفاده می شود، زیرا آنها به ابزار مشابه و سطح حریم خصوصی مشابه با مجموعه داده اصلی دست می یابند.
-
ما از مکانیسم پلکان، به جای مکانیسم سنتی لاپلاس، برای برهم زدن تعداد مسیرها در مرحله بازسازی مسیر استفاده میکنیم تا از اضافه کردن نویز بیش از حد جلوگیری کنیم، در نتیجه کاربرد دادههای بالا را تحت همان بودجه حفظ حریم خصوصی حفظ میکنیم و به حفظ حریم خصوصی و مبادله ابزار بهتر از روش های موجود
-
ما اثبات نظری ارائه می کنیم که DP-CSM پیشنهادی راضی می کند ϵ-حریم خصوصی متفاوت از آنجایی که بازسازی مسیر حریم خصوصی دیفرانسیل را برآورده می کند، DP-CSM نیز حریم خصوصی دیفرانسیل را برآورده می کند ( برای تجزیه و تحلیل دقیق به بخش ۴٫۴ مراجعه کنید).
-
ما آزمایشهای جامعی را روی سه مجموعه داده مسیر واقعی انجام میدهیم تا عملکرد روش پیشنهادی را از نظر سودمندی و کارایی دادهها ارزیابی کنیم.
۲٫ کارهای مرتبط
تلاش های زیادی برای انتشار متفاوت داده های خصوصی انجام شده است. در این بخش، ما دو نوع کار نزدیک به هم را خلاصه میکنیم – انتشار دادههای مسیر خصوصی متفاوت و انتشار متوالی دادههای خصوصی متفاوت.
۲٫۱٫ انتشار داده های مسیر خصوصی متفاوت
کار موجود بر روی انتشار داده های مسیر خصوصی متفاوت را می توان با توجه به مواد مورد استفاده برای تولید مسیرها به سه دسته تقسیم کرد.
۲٫۱٫۱٫ درخت پیشوند پر سر و صدا
درخت پیشوند پر سر و صدا رایج ترین ساختار داده ای است که برای گرفتن اطلاعات متوالی و شمارش مسیرها استفاده می شود. چن [ ۱۵ ] و همکاران. اولین مکانیسم انتشار مسیر با حریم خصوصی متفاوت را پیشنهاد کرد. آنها از درخت پیشوند پر سر و صدا استفاده می کنند تا دنباله مسیر را با پیشوند یکسان در یک شاخه قرار دهند تا میدان خروجی را کاهش دهند و از بازده زمانی بالای فرآیند انتشار مسیر اطمینان حاصل کنند. آنها از دو مجموعه از محدودیتهای ذاتی درختهای پیشوند برای استنتاج محدودیتها استفاده میکنند که ابزار داده را بهبود میبخشد. با این حال، تعداد دنباله هایی که به یک شاخه تعلق دارند به سرعت با رشد درخت پیشوند کاهش می یابد. بنابراین، ابزار داده کاهش می یابد. چن و همکاران [ ۱۶ ] سپس از متغیر طول n استفاده کردمدل -گرام برای استخراج اطلاعات پایه پایگاه داده مسیر و پردازش داده های مسیر کلی. آنها از درخت جستجوی مبتنی بر مارکوف برای کاهش نویز و بهبود کاربرد داده ها استفاده کردند. اخیراً آثاری در زمینه انتشار خط سیر سنتز انجام شده است. DPT [ ۱۷ ] مسیرها را در وضوح های متعدد با استفاده از سیستم های مرجع سلسله مراتبی گسسته می کند تا حرکات فردی را با سرعت های مختلف ثبت کند، و برای هر وضوح یک درخت پیشوند می سازد.
۲٫۱٫۲٫ آمار خصوصی
برای غلبه بر کمبود روشهای مبتنی بر درخت پیشوند پر سر و صدا، کارهای اخیری وجود دارد که به طور کلی مسیرهای مصنوعی را با استفاده از آمار خصوصی استخراج شده از مسیرهای اصلی تولید میکنند. نمونههای معمولی AdaTrace [ ۱۸ ]، DP-star [ ۲۳ ] و TGM [ ۱۹ ] هستند.]. DP-Star از متریک حداقل طول توصیف برای خلاصه کردن مسیرهای خام با استفاده از نقاط نماینده آنها استفاده می کند، در نتیجه به یک مبادله مطلوب بین دقت و مختصر محتوای اطلاعاتی آنها دست می یابد. AdaTrace یک سینت سایزر مکان مقیاس پذیر است که از سه ویژگی جدید تشکیل شده است: حمله قطعی، حریم خصوصی آماری قابل اثبات و حفظ ابزار قوی. AdaTrace یک مدل تولیدی را از طریق چهار مرحله تولید میکند: استخراج ویژگی، یادگیری خلاصه، کاربرد و تزریق نویز حفظ حریم خصوصی، و تولید مسیر مکانی مصنوعی با حریم خصوصی دیفرانسیل. مسیرهای خروجی اطلاعات کاربردی حیاتی را در مسیرهای اصلی حفظ می کنند و در برابر حملات مسیر موجود قوی هستند. DP-Star چارچوبی برای انتشار مسیرهای خصوصی متفاوت است. DP-Star بر چندین مؤلفه مانند متریک حداقل طول توصیف، شبکه آگاه از چگالی، توزیع سفر و تخمین طول میانه متکی است. TGM ابتدا داده ها را به عنوان یک مدل مولد گرافیکی رمزگذاری می کند و به طور خصوصی مسیرهای مصنوعی را تولید می کند که به کارایی محاسباتی و کاربرد بسیار بالایی دست می یابد.
۲٫۱٫۳٫ مراکز خوشه ای
برای استفاده کامل از توزیع سوگیری مکانها در مسیرها برای فشردهسازی کارآمد جهان مکان، Hua et al. [ ۲۴ ] یک رویکرد مبتنی بر تعمیم برای انتشار مسیرهای خصوصی متفاوت پیشنهاد کرد. ابتدا مسیرها را با ادغام مکانها به طور همزمان تعمیم میدهد و سپس مسیرها را پس از تعمیم به شیوهای خصوصی متفاوت آزاد میکند. برای بهبود کارایی خوشه مکان خصوصی و ابزار داده، لی و همکاران. [ ۲۵] یک مکانیسم انتشار دادههای مسیر مبتنی بر نویز لاپلاس محدود با حریم خصوصی متفاوت پیشنهاد کرد. طراحی این مکانیسم تولید نویز، نویز اضافه شده به تعداد مسیر واقعی را قادر می سازد تا در محدوده قانونی برای افزایش حریم خصوصی دیفرانسیل نمونه برداری شود. علاوه بر این، آنها استراتژی پارتیشن را حذف می کنند که مسیر اصلی را حذف می کند، که باعث بهبود سودمندی داده ها و کارایی انتشار می شود. رویکردهای مبتنی بر تعمیم برای مجموعه داده های مسیر بزرگ مقیاس پذیر هستند.
۲٫۲٫ انتشار متوالی داده های خصوصی متفاوت
تحقیق در مورد انتشار متوالی دادههای خصوصی متفاوت در حال حاضر در دو حالت در نظر گرفته میشود: تنظیم متمرکز و تنظیم چند حزبی. بیشتر آثار بر محیط متمرکز متمرکز بودند. چن و همکاران [ ۳۰ ] الگوریتمی را پیشنهاد کرد که یک درخت پیشوندی از دنباله ها را برای پشتیبانی از پرس و جوهای شمارش و استخراج مکرر رشته آزاد می کند. چن و همکاران [ ۱۶ ] یک مدل n-gram با طول متغیر برای متعادل کردن مبادله حریم خصوصی و ابزار پیشنهاد کرد. با این حال، مصرف بودجه حفظ حریم خصوصی روش فوق به ارتفاع درخت پیشوند پر سر و صدا بستگی دارد. برای جدا کردن بودجه حریم خصوصی از ارتفاع درخت ساخته شده، ژانگ و همکاران. [ ۳۱] مدل PrivTree را پیشنهاد کرد که فقط از مقدار ثابتی از نویز در ساخت درخت پسوند پیش بینی استفاده می کرد. اخیراً، تانگ و همکاران. [ ۳۲ ] انتشار متوالی دادههای چند حزبی خصوصی متفاوت را بررسی کرد و یک درخت پسوند پیشبینی توزیع شده برای حل مشکل پیشنهاد کرد. با این حال، رویکردهای فوق برای انتشار متوالی داده ها به دلیل ناآگاهی آنها از اطلاعات زمانی و همبستگی مکانی-زمانی، نمی توانند مستقیماً روی داده های مسیر اعمال شوند.
۳٫ مقدمات
در این بخش به معرفی چند تعریف اولیه می پردازیم.
تعریف ۱
(مسیر [ ۲۴ ]) . خط سیر یک فرد یک دنباله ترتیب زمانی از جفت زمان-مکان است که می تواند به طور رسمی به صورت تی=(تی۱،ل۱)→(تی۲،ل۲)→⋯→(تی|تی|،ل|تی|)، جایی که تیمنi امین زمان نمونه برداری شده است، لمنموقعیت مکانی (که با مختصات طول و عرض جغرافیایی نشان داده می شود) فرد در آن است تیمن، جایی که ۱≤من≤|تی|، و |تی|طول مسیر است.
مجموعه داده مسیر Dبه مجموعه ای از مسیرهای جمع آوری شده از افراد مختلف اشاره دارد. برای سادگی، ما فرض می کنیم که تمام مسیرهای موجود در مجموعه داده است Dدر یک دنباله از مهرهای زمانی نمونه برداری می شوند، به عنوان مثال، مسیرها به طور همزمان ثبت می شوند و طول یکسانی دارند. مهرهای زمانی نمونه برداری شده از هر مسیر در Dمی تواند به عنوان نشان داده شود تیمنمتره(D)={تی۱،تی۲،⋯،تی|تی|}، جایی که |تی|تعداد مهرهای زمانی نمونه برداری شده است. مکان ها در هر مهر زمانی تیمن∈تیمنمتره(D)می تواند به عنوان یک مجموعه مکان نمایش داده شود Dمن.
تعریف ۲
( ϵحریم خصوصی دیفرانسیل [ ۳۳ ]) . با توجه به یک الگوریتم تصادفی آg، Oآgمجموعه ای از تمام خروجی های ممکن است آg. برای هر دو مجموعه داده مجاور Dو D“(حداکثر در یک رکورد متفاوت است) و هر زیر مجموعه O⊆Oآg، اگر و فقط اگر الگوریتم آgراضی می کند
سپس الگوریتم آgحریم خصوصی ϵ دیفرانسیل را فراهم می کند، جایی که ϵ بودجه حریم خصوصی است و ϵ کوچکتر نشان دهنده سطح حریم خصوصی بالاتر است.
حریم خصوصی دیفرانسیل با مکانیزم بهینه افزایش نویز تضمین شده است. مکانیسم لاپلاس، مکانیسم نمایی و مکانیسم پلکان مکانیسمهای افزایش نویز رایج در آثار موجود هستند. در این مقاله، مکانیسم راه پله را به عنوان مکانیزم اضافهکننده نویز انتخاب میکنیم، زیرا کاربرد دادههای بالاتری را نسبت به سایرین حفظ میکند.
تعریف ۳
(حساسیت پرس و جو [ ۲۷ ]) . تابع query داده شده است f:D→آردکه برمی گردد D-بردارهای عددی بعدی به عنوان خروجی، حساسیت f به صورت تعریف می شود
جایی که Dو D“مجموعه داده های همسایه هستند و ||·||۱هست ℓ۱-هنجار
تعریف ۴
(مکانیسم راه پله [ ۲۷ ] ) . تابع query داده شده است f:D→آرد، حساسیت آن Δfو بودجه حریم خصوصی ϵ، مکانیسم راه پله برای افزودن نویز به نتیجه پرس و جو است، به عنوان مثال،
جایی که g(Δf،ϵ)نویز نمونه برداری از مولد نویز است Dتوزیع احتمال پلکانی بعدی
تابع چگالی احتمال توزیع احتمال پلکانی به صورت زیر تعریف می شود:
جایی که j∈ن، و γ∈[۰،۱]. α(γ)عامل عادی سازی است
🔻🔻⋯🔻آردساعتγ(ایکس)دایکس۱دایکس۲⋯دایکسد=۱،
جایی که ب=ه–ϵ، جj=∑من=۰+∞منjبjو γ=۱۱+هϵ/۲.
۴٫ DP-CSM
۴٫۱٫ چارچوب
با توجه به یک مجموعه داده مسیر D، هدف ما این است که آن را به یک مجموعه داده مسیر خصوصی متفاوت تمیز کنیم D˜در حالی که ابزار داده خود را تا حد ممکن حفظ می کند. برای دستیابی به هدف، ما یک روش جدید با ترکیب یک تعمیم مکان مبتنی بر مجموعه هسته و مکانیسم پلکان به نام DP-CSM پیشنهاد میکنیم. معماری DP-CSM در شکل ۱ نشان داده شده است و از دو مرحله تشکیل شده است. مرحله اول، تعمیم مکان بر حسب زمان است که مجموعه داده های مکان همه مهرهای زمانی را وارد می کند و مجموعه داده های مکان تعمیم یافته مربوطه را خروجی می دهد. مرحله دوم بازسازی مسیرها با توجه به مجموعههای حاصل از مکانهای تعمیمیافته است و در عین حال تضمین میکند که فرآیند بازسازی حریم خصوصی متفاوت را برآورده میکند.
۴٫۲٫ تعمیم مکان مبتنی بر Coreset
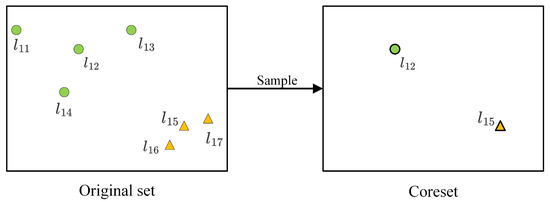
در نتیجه پیچیدگی درجه دوم الگوریتمهای تعمیم مکان مبتنی بر خوشهبندی موجود [ ۲۰ ، ۲۴ ، ۲۵ ]، تعمیم مکان برای هر مهر زمانی، گلوگاه روشهای موجود است. برای بهبود کارایی، ما الگوریتم مبتنی بر مجموعه هسته را پیشنهاد می کنیم. Coresets خلاصههای کوچک و وزنی از یک مجموعه داده بزرگ هستند به طوری که راهحلهای یافت شده بر روی مجموعههای مرکزی با راهحلهای موجود در مجموعه داده کامل رقابت میکنند [ ۲۶ ]. ما به طور رسمی الگوریتم تعمیم مکان مبتنی بر مجموعه هسته را در الگوریتم ۱ توضیح می دهیم. در ادامه، الگوریتم تعمیم مکان مبتنی بر مجموعه هسته را توضیح خواهیم داد.
| الگوریتم ۱: الگوریتم تعمیم مکان مبتنی بر کورست |
|
ورودی : D, k , m
خروجی : L={L1،…،L|تیمنمتره(D)|}
|
| ۱ برای مجموعه داده مکان Dمناز هر مهر زمانی در Dانجام دادن |
| ۲ برای هر مکان l in Dمنانجام دادن |
| ۳ محاسبه کنید س(ل); // محاسبه حساسیت l با توجه به [ ۲۸ , ۲۹ ] |
| ۴ پایان |
| برای هر کدام ۵ عددل∈Dمنانجام دادن |
| ۶ پ(ل)←س(ل)/∑ل“∈Dمنس(ل“); // عادی سازی |
| ۷ پایان |
| ۸ سیمن←نمونه m نقاط وزنی از Dمنجایی که هر نقطه x وزن دارد ۱متر·پ(ل)و با احتمال نمونه برداری می شود پ(ل); |
| ۹ Lمن←k -means را روی کورست ها اجرا کنید سیمنبرای به دست آوردن k مراکز خوشه به عنوان مکان های تعمیم یافته. |
| ۱۰ پایان |
| ۱۱ بازگشت L; |
برای الگوریتم ۱، پارامترهای ورودی مجموعه داده مسیر اصلی هستند D, تعداد مراکز خوشه k و اندازه هسته ها m . برای هر مجموعه مکان Dمناز مهر زمانی تیمنکه در D، الگوریتم تعمیم مکان مبتنی بر مجموعه هسته به طور موثر k مرکز خوشه را به عنوان مکان های تعمیم یافته خروجی می دهد. مراحل ۲-۶ از الگوریتم ۱ نشان دهنده روند ساخت مجموعه هسته به دنبال الگوریتم پیشنهاد شده در [ ۲۸ ، ۲۹ ] است. به طور خاص، ابتدا حساسیت را محاسبه می کنیم س(ل)از هر نقطه ل∈Dمن(حساسیت س(ل)ذکر شده در اینجا با حساسیت در حریم خصوصی دیفرانسیل متفاوت است). پس از محاسبه س(ل)، باید نمونه برداری اهمیت انجام دهیم و هر نقطه l با احتمال نمونه برداری می شود پ(ل). این روند تا زمانی که سیمناز m نقطه تشکیل شده است و هر نقطه نمونه برداری دارای وزن است ۱متر·پ(ل). سپس، k -means را روی هستهها انجام میدهیمسیمنبرای بدست آوردن k مراکز و خروجی. در نهایت روند بالا را تکرار می کنیم |تی|-۱ بار
برای نشان دادن منطق الگوریتم ۱، یک مثال اسباب بازی می آوریم. فرض کنید که ما یک مجموعه مکان داریم که شامل ۷ مکان است، همانطور که در شکل ۲ نشان داده شده است. در شکل ۲ ، می بینیم که الگوریتم ۱ از m مکان ها برای نمایش مجموعه اصلی نمونه برداری می کند. به عنوان مثال، ما از محل نمونه برداری می کنیم ل۱۲برای نشان دادن مکان ها ل۱۱،ل۱۲،ل۱۳،ل۱۴، بنابراین، وزن ل۱۲پس از نمونه برداری ۴ است (زیرا ما از یک مکان برای نشان دادن چهار مکان استفاده می کنیم). در نهایت مکان را اضافه می کنیم ل۱۲و وزن آن ۴ به هسته است. سایر شرایط در جدول ۱ نشان داده شده است.
۴٫۳٫ بازسازی مسیر
مرحله بازسازی مسیر برای بازسازی مسیرهای تفاضلی-خصوصی از مکان های تعمیم یافته الگوریتم ۱ است. ما به طور رسمی این روش را در الگوریتم ۲ توصیف می کنیم. الگوریتم مجموعه داده مسیر اصلی را می گیرد. D، مجموعه های مکان تعمیم یافته Lو بودجه حریم خصوصی ϵبه عنوان ورودی، و خروجی مسیرهای بازسازی شده نهایی با ϵ-تضمین حریم خصوصی متفاوت به طور خاص، الگوریتم بازسازی شامل سه مرحله اصلی است، به عنوان مثال، تولید مسیر نامزد، انتخاب مسیر خصوصی متفاوت، و تکمیل مسیر.
| الگوریتم ۲: الگوریتم بازسازی مسیر |
|
ورودی : D، L={L1،…،L|تیمنمتره(D)|}، ϵ.
خروجی : D˜: مسیرهای بازسازی شده و تعداد نویز آنها.
|
| ۱ D˜←∅; // یک مجموعه مسیر خالی را راه اندازی کنید |
| ۲ تی=L1×L2×⋯×L|تیمنمتره(D)|; //کلیه مسیرهای نامزد ممکن را بسازید |
| ۳ برای هر کاندیدا مسیر بازسازی شده تی˜که در تیانجام دادن |
| ۴ Oتی˜←ستوهry(تی˜،D); |
| ۵ اگر |Oتی˜|>0سپس |
| ۶ nتی˜=|Oتی˜|+g(Δf،ϵ); // صدای راه پله را به شمارش اضافه کنید |
| ۷ D˜=D˜∪{تی˜×nتی˜}; // اضافه کردن nتی˜مسیرهای بازسازی شده تی˜به D˜ |
| ۸ پایان |
| ۹ پایان |
| ۱۰ اگر |D˜|<|D|سپس |
| ۱۱ //مسیرهای تکمیلی |
| ۱۲ نمونه به صورت تصادفی |D|–|D˜|مسیرها از تی–D˜; |
| ۱۳ پایان |
| ۱۴ بازگشت D˜; // خروجی مسیرهای بازسازی شده و تعداد نویز آنها |
مسیرهای نامزد بر اساس مجموعههای مکان تعمیمیافته از طریق عملیات یکسان محصول دکارتی، همانطور که در مرحله ۲ الگوریتم ۲ نشان داده شده است، تولید میشوند، به عنوان مثال، تی=L1×L2×⋯×L|تیمنمتره(D)|. سپس، ما مسیرهای بازسازی شده را انتخاب می کنیم تیبه روش خصوصی متفاوت، همانطور که در مراحل ۳-۹ الگوریتم ۲ نشان داده شده است. اگر یک مسیر نامزد حداقل یک مسیر اصلی را در مجموعه داده مسیر پوشش دهد. D، سپس به عنوان یک مسیر بازسازی شده انتخاب می شود. منظور ما از پوشش یک مسیر اصلی این است که مکان هر مهر زمانی در مکان تعمیم پوشانده شده است. به طور خاص، با توجه به یک مسیر نامزد تی˜={ل۱˜،ل۲˜،…،ل|تی|˜}، و یک مسیر اصلی تی={ل۱،ل۲،…،ل|تی|}، زنگ میزنیم تی˜T را پوشش می دهد ، اگر ∀من∈{۱،۲،…،|تی|}، لمن∈لمن˜. برای سهولت در توصیف، تعریف می کنیم ستوهry(تی،D)به عنوان یک تابع پرس و جو برای جستجوی مسیرهای تحت پوشش برای مسیر بازسازی شده تی˜از جانب D. برای تضمین حریم خصوصی دیفرانسیل، صدای راه پله را به تعداد واقعی مسیرهای تحت پوشش اضافه می کنیم و مقدار متناظر مسیرهای بازسازی شده را ایجاد می کنیم. به طور خاص، تعداد نویز به صورت زیر محاسبه می شود.
جایی که nتی˜تعداد پر سر و صدا مسیر بازسازی شده است.
با اضافه شدن نویز در طول فرآیند انتخاب مسیر بازسازی شده، تعداد مسیرهای بازسازی شده کمتر از مجموعه داده مسیر اصلی خواهد بود. بنابراین، مراحل ۱۰ تا ۱۳ الگوریتم برای تولید مسیرهای تکمیلی طراحی شده است تا مجموعه داده مسیر بازسازی شده دارای تعداد مسیرهای مشابه مجموعه داده اصلی باشد.
به طور خاص، فرض کنید ما استفاده می کنیم D˜={تی˜۱،تی˜۲،⋯،تی˜j}برای نشان دادن مسیرهای بازسازی شده عبور شده توسط مسیرهای اصلی، و بر اساس تعداد نویز آن دسته بندی می شود، یعنی سیnتی۱>سیnتی۲>⋯>سیnتیj،جایی که سیnتیمنتعداد نویز مسیر بازسازی شده را نشان می دهد تی˜من. بعد، از فاصله شروع کنید (سیnتی۲،سیnتی۱]،ما محاسبه می کنیم نتومترمناز مسیر در مجموعه تی–D˜با تعداد نویز در فاصله (سیnتیمن+۱،سیnتیمن]،روش محاسبه به شرح زیر است:
جایی که Δfحساسیت جهانی است، ϵبودجه حفظ حریم خصوصی است، و ساعتγ(ایکس;Δf،ϵ)تابع چگالی احتمال مکانیسم راه پله را نشان می دهد. تعداد مسیر بازسازی شده در مجموعه تی–D˜۰ است (زیرا هیچ مسیر اصلی از آن عبور نکرده است). پس از اضافه کردن نویز که مکانیسم راه پله را برآورده می کند، احتمال اینکه مسیر در آن قرار گیرد تی–D˜در بازه حساب می شود (سیnتیمن+۱،سیnتیمن]است 🔻سیnتیمن+۱سیnتیمنساعتγ(ایکس;Δf،ϵ)دایکس.
برای بازسازی مسیرهای کافی، در نهایت به صورت تصادفی نمونه برداری می کنیم نتومترمنمسیرها از تی–D˜، و آن مسیرها را به مجموعه داده مسیر منتشر شده نهایی اضافه کنید. تعداد نویز آنها مقادیر تصادفی در بازه مربوطه است (سیnتیمن+۱،سیnتیمن]. هنگامی که تعداد کل مجموعه داده مسیری که قرار است منتشر شود به تعداد کل مجموعه داده اصلی برسد، الگوریتم ۲ متوقف می شود.
در ادامه روش الگوریتم ۲ را با ذکر یک مثال ساده توضیح خواهیم داد. ما یک مجموعه داده مسیر شامل هشت مسیر را در نظر می گیریم، همانطور که در شکل ۳ الف نشان داده شده است. از شکل ۳ ب، میتوانیم ببینیم که الگوریتم تعمیم مکان پیشنهادی ما بر اساس هستههای هسته، مکان اصلی را در هر مهر زمان به دو خوشه تقسیم میکند و هر خوشه با یک مرکز خوشه جایگزین میشود. سپس، الگوریتم ۲ مراکز k را در مُهرهای زمانی مختلف به ترتیب زمانی به هم متصل میکند تا مسیر را بازسازی کند و تعداد نویز آن را خروجی کند. مثلاً مراکز را به هم وصل می کنیم ل۱۱، ل۲۱، ل۳۱برای بدست آوردن مسیر بازسازی شده ل۱۱→ل۲۱→ل۳۱. مسیر بازسازی شده ل۱۱→ل۲۱→ل۳۱عبور کرده است تی۱،تی۲، بنابراین، تعداد واقعی از ل۱۱→ل۲۱→ل۳۱۲ است. سپس، صدایی که مکانیسم راه پله را برآورده می کند به تعداد واقعی ۲ اضافه می کنیم. در نهایت، مسیر بازسازی شده را خروجی می کنیم. ل۱۱→ل۲۱→ل۳۱و تعداد نویز آن ۱٫ موقعیت های دیگر در جدول ۲ نشان داده شده است.
۴٫۴٫ تجزیه و تحلیل حریم خصوصی
اکنون ضمانت حریم خصوصی DP-CSM را از منظر نظری تحلیل می کنیم. DP-CSM از دو مرحله اصلی تشکیل شده است. مرحله اول یک خوشه بندی k -means مبتنی بر هسته است که می تواند به عنوان یک الگوریتم بدون حریم خصوصی در نظر گرفته شود. آg1. الگوریتم دوم آg2از مکانیسم راه پله برای اضافه کردن نویز به تعداد مسیرها استفاده می کند. ابتدا قضیه زیر را اثبات می کنیم.
قضیه ۱٫
با توجه به یک مجموعه داده مسیر Dو مجموعه های مکان تعمیم یافته آن L، اجازه دهید نسیتی(D،L)خروجی الگوریتم ۲ را نشان می دهد و پنسیتیمجموعه ای از همه خروجی های ممکن باشد نسیتی(D،L). برای هر دو مجموعه داده مجاور Dو D“(حداکثر در یک رکورد متفاوت است)، دو مجموعه مکان تعمیم یافته Lو L“( Lتولید شده از Dو L“تولید شده از D“) هر خروجی r⊆پنسیتی، الگوریتم ۲ حریم خصوصی ϵ دیفرانسیل را برآورده می کند اگر و فقط اگر:
اثبات قضیه ۱٫
با فرض آن مجموعه داده Dو مجموعه داده D“مجموعه داده های مجاور هستند، یعنی Dو D“فقط یک مسیر متفاوت دارند تیایکس، ما استفاده می کنیم تی˜ایکسبرای نشان دادن مسیر تعمیم یافته مسیر تیایکس، و نسیتیمن(D،L)تعداد پر سر و صدا مسیر تعمیم یافته را نشان می دهد تی˜من∈تی، سپس احتمال اینکه نویز شمارش شود نسیتیمن(D،L)برابر است r={جnتی۱،جnتی۲،⋯،جnتی|D|}است
در مورد سه مورد زیر بحث می کنیم.
- مورد ۱:
-
برای هر مسیر تعمیم یافته تی˜من≠تی˜ایکس، می توانیم آن را استخراج کنیم
- مورد ۲:
-
برای هر مسیر تعمیم یافته تی˜من=تی˜ایکس∧تی˜ایکس∈D˜، شمارش مسیر تعمیم یافته تی˜ایکسبا اضافه کردن نویز که مکانیسم راه پله را بر اساس شمارش واقعی برآورده می کند، به دست می آید. با توجه به مکانیسم راه پله [ ۲۷ ]، می توانیم آن را استخراج کنیم
- مورد ۳:
-
برای یک مسیر تعمیم یافته دلخواه تی˜من=تی˜ایکس∧تی˜ایکس∉D˜، می توان آن را به دو مورد فرعی تقسیم کرد جnتیایکس∈(سیnتیمترمنn،سیnتی۱)و جnتیایکس∉(سیnتیمترمنn،سیnتی۱).
- (آ)
-
جnتیایکس∈(سیnتیمترمنn،سیnتی۱)
با فرض اینکه جnتیایکس∈(سیnتیمن+۱،سیnتیمن)، از تجزیه و تحلیل بخش ۴٫۳ و تابع چگالی احتمال مکانیسم راه پله، می توانیم نتیجه بگیریم که:
به این معنا که:
جایی که ساعتγ(ایکس;Δf،ϵ)تابع چگالی احتمال مکانیسم راه پله را نشان می دهد.
- (ب)
-
جnتیایکس∉(سیnتیمترمنn،سیnتی۱)
ما استفاده می کنیم سیnتیمترمنnبرای نشان دادن حداقل تعداد نویز مسیر در مجموعه داده مسیر خروجی، سپس:
بنابراین ما می توانیم آن را استخراج کنیم پr[نسیتیایکس(D“،L“)=جnتیایکس]=پr[نسیتیایکس(D،L)=جnتیایکس].
با ترکیب این سه حالت می توانیم نتیجه بگیریم پr[نسیتی(D،L)=r]≤پr[نسیتی(D“،L“)=r]·هϵبنابراین، الگوریتم ۲ راضی می کند ϵ-حریم خصوصی دیفرانسیل طبق تعریف ۲٫ □
قضیه ۲٫
ما DP-CSM را به عنوان نشان می دهیم آgو فرض کنید پآgمجموعه ای از تمام خروجی های ممکن است آg. برای هر دو مجموعه داده مجاور Dو D“و هر خروجی O⊆پآg، DP-CSM حریم خصوصی ϵ دیفرانسیل را برآورده می کند اگر و فقط اگر:
اثبات قضیه ۲٫
فرض کنید که Dو D“ما از دو مجموعه داده مجاور استفاده می کنیم آg1برای نشان دادن الگوریتم مکان یابی عمومی پیشنهادی ما و O1برای نمایش خروجی آن؛ ما استفاده می کنیم آg2برای نشان دادن الگوریتم بازسازی مسیر، و O2برای نمایش خروجی آن Ag نمایانگر کل مدل و O نمایانگر خروجی آن است. می توانیم نتیجه بگیریم که:
طبق تعریف ۲ و قضیه ۱ داریم:
با ترکیب معادلات ( ۱۷ ) و ( ۱۸ ) داریم:
در نهایت، ما ثابت می کنیم که DP-CSM راضی می کند ϵ-حریم خصوصی متفاوت با توجه به تعریف ϵ-حریم خصوصی متفاوت □
۴٫۵٫ تحلیل پیچیدگی
هزینه محاسباتی DP-CSM عمدتاً به تعمیم مکان و بازسازی مسیرها مربوط می شود.
در مرحله اول، ما پیچیدگی محاسباتی تعمیم مکان را تحلیل میکنیم، که عمدتاً از ساخت مجموعه هسته و خوشهبندی k – means تشکیل شده است. ساخت مجموعه هسته در هر مهر زمانی انجام می شود و پیچیدگی محاسباتی آن است O(ک|D||تی|)، جایی که |D|تعداد مسیرها است، |تی|طول مسیر، k تعداد خوشه ها است. پیچیدگی اجرای k -means است O(nکمتر|تی|)، که در آن n تعداد تکرارهای k -means است. پیچیدگی زمانی الگوریتم ۱ است O(nکمتر|تی|). علاوه بر این، پیچیدگی زمانی k -means سنتی است O(nک|D||تی|)، به این معنی که الگوریتم ۱ سریعتر از k -means سنتی است ( متر≤|D|).
ثانیاً، ما مرکز هر خوشه را در هر زمان مهر وصل می کنیم. از آنجایی که تعداد مراکز است |D||تی|، پیچیدگی محاسباتی اتصال مراکز است O(|D||تی|). پیچیدگی اضافه کردن نویز و تکمیل مسیرها کمتر از |D|بنابراین، پیچیدگی محاسباتی الگوریتم بازسازی مسیر است O(|D||تی|).
بنابراین، کل پیچیدگی محاسباتی DP-CSM است O(nکمتر|تی|).
۵٫ آزمایش کنید
در این بخش، ما به طور تجربی عملکرد روش DP-CSM خود را از نظر کاربرد داده مجموعه داده های مسیر سالم و مقیاس پذیری برای مقابله با مجموعه داده های مسیر بزرگ ارزیابی می کنیم.
۵٫۱٫ تنظیم آزمایش
ما DP-CSM را با سه اثر معرف (INFOCOM15 [ ۲۴ ]، IS17 [ ۲۵ ] و PCG [ ۲۰ ]) مقایسه می کنیم. ما همه روشها را در پایتون پیادهسازی کردیم، و همه آزمایشها روی رایانهای با CPU Intel Core i7-9700، رم ۱۶G اجرا شد.
۵٫۱٫۱٫ مجموعه داده ها
تی درایو. مجموعه داده شامل مسیرهای GPS 10357 تاکسی در پکن از ۲ فوریه تا ۸ فوریه است. ما مسیر را از ساعت ۸:۳۰ تا ۱۴:۳۰ به عنوان داده های تجربی خود انتخاب کردیم و هر مسیر شامل ۳۲ مکان است. فاصله زمانی بین هر دو مکان مجاور در یک مسیر ۱۰ دقیقه است. پس از پیش پردازش، ما در نهایت ۱۲۰۰۰ مسیر را به عنوان داده های تجربی خود انتخاب کردیم.
ژئولایف. یک مجموعه داده از طریق ثبتکنندههای GPS مختلف و تلفنهای GPS در پروژه Geolife توسط ۱۸۲ کاربر در یک دوره بیش از پنج سال (از آوریل ۲۰۰۷ تا اوت ۲۰۱۲) جمعآوری شد. مجموعه داده مسیر Geolife شامل ۱۷۶۲۱ مسیر با مسافت کلی ۱۲۹۲۹۵۱ کیلومتر و مدت زمان کل ۵۰۱۷۶ ساعت است. پس از پیش پردازش، در نهایت ۱۲۰۰۰ مسیر را به عنوان داده های تجربی خود انتخاب کردیم و هر مسیر شامل ۳۲ مکان است. فاصله زمانی بین هر دو مکان مجاور در یک مسیر ۱۰ ثانیه است.
تاکسی روما مجموعه داده ای حاوی آثار تحرک تاکسی های تاکسی در رم، ایتالیا است. این شامل مسیرهای GPS از ۳۲۰ تاکسی است که طی ۳۰ روز (از ۱ فوریه ۲۰۱۴ تا ۲ مارس ۲۰۱۴) جمع آوری شده است. پس از پیش پردازش، در نهایت ۱۲۰۰۰ مسیر را به عنوان داده های تجربی خود انتخاب می کنیم و هر مسیر شامل ۳۲ مکان است. فاصله زمانی بین هر دو مکان مجاور در یک مسیر تقریباً ۱۵ ثانیه است.
۵٫۱٫۲٫ معیارهای کاربردی داده
در آزمایشها، ما از سه معیار رایج استفاده میکنیم (یعنی شباهت توزیع فضایی، فاصله Hausdorff و اعوجاج پرس و جو) و سه آنتروپی معرفیشده در [ ۴۰ ] برای ارزیابی جامع قابلیت حفظ ابزار دادهای روش پیشنهادی ما از جنبههای مختلف.
شباهت توزیع فضایی شباهت توزیع فضایی بین پایگاه داده مسیر خام و پایگاه داده مسیر پاکسازی شده با نقشه های حرارتی نشان داده شده است. ما فضای فضایی را به شبکه های ۴۰ × ۴۰ تقسیم می کنیم و تعداد مکان هایی که در هر سلول شبکه قرار می گیرند را می شماریم. همانطور که هر نقشه حرارتی را می توان به عنوان یک بردار ۱۶۰۰ بعدی نشان داد (ایکس۱،ایکس۲،⋯، ایکس۱۶۰۰)، جایی که ایکسمنتعداد مکانها در سلول شبکه i- ام است، ما بیشتر شباهت را با شباهتهای کسینوس بین نقشههای حرارتی پایگاهداده مسیر خام و پایگاههای داده مسیر سالمسازیشده مربوطه کمیت میکنیم. پایگاه داده مسیر پاکسازی شده که شباهت توزیع فضایی بالاتری با پایگاه داده مسیر خام دارد، کاربرد داده بالاتری را حفظ می کند.
فاصله هاسدورف فاصله Hausdorff یک متریک رایج برای اندازهگیری کاربرد داده پایگاه داده مسیر سالمسازی شده است. تعریف فاصله هاسدورف به صورت زیر است:
جایی که ساعت(|D|˜،|D|)=حداکثرتی∈|D|˜{دقیقهتی“∈|D|{Dمنستیآnجه(تی،تی“)}}. Dمنستیآnجه(تی،تی“)با مجموع فاصله اقلیدسی هر مهر زمانی بین T و محاسبه می شودتی“. فاصله مسیر بین مجموعه داده اصلی را منعکس می کند Dو مجموعه داده منتشر شده |D|˜و فاصله کمتر دلالت بر سودمندی داده بالاتر دارد.
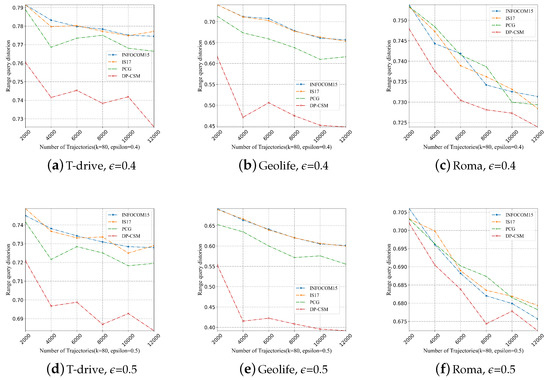
تحریف پرس و جو محدوده ( آرس). اعوجاج پرس و جوی محدوده یکی دیگر از معیارهای رایج مورد استفاده برای کاربرد داده های مسیر منتشر شده است [ ۲۰ ، ۲۴ ، ۴۱ ]. به صورت زیر محاسبه می شود
جایی که س(D)نتیجه پرس و جو در مسیرهای خام است، س(D˜)نتیجه پرس و جو در مسیرهای بازسازی شده است، س(D)–س(D˜)تفاوت مجموعه ای است که مکان ها را در آن برمی گرداند س(D)در حالی که در نیست س(D˜)، و |·|کاردینالیته یک مجموعه را برمی گرداند. اعوجاج پرس و جو با برد بزرگتر نشان دهنده کاربرد کمتر داده است.
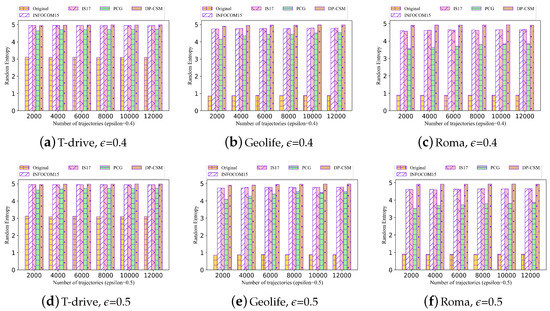
آنتروپی تصادفی اگر هر مکان با احتمال یکسان بازدید شود، آنتروپی تصادفی میتواند میزان پیشبینیپذیری مکان کاربر را به تصویر بکشد [ ۴۲ ]. تعریف آنتروپی تصادفی:
جایی که نمنتعداد مکان هایی است که کاربر i از آنها بازدید می کند.
آنتروپی غیر همبسته زمانی آنتروپی غیرهمبسته زمانی می تواند ناهمگونی الگوهای بازدید را مشخص کند [ ۴۲ ]. تعریف آنتروپی غیرهمبسته زمانی به شرح زیر است:
جایی که پمن(j)احتمال تاریخی است که مکان j توسط کاربر i بازدید شده است.
آنتروپی واقعی آنتروپی واقعی نه تنها به دفعات بازدید بستگی دارد، بلکه به ترتیب بازدید از گره ها و هزینه زمانی در هر مکان نیز بستگی دارد، بنابراین نظم مکانی-زمانی کامل موجود در الگوی تحرک فرد را به تصویر می کشد [ ۴۲ ]. تعریف آنتروپی واقعی:
جایی که پ(تیمن“)احتمال یافتن یک دنباله خاص با ترتیب زمانی است تیمن“در مسیر حرکت تیمن.
۵٫۲٫ مقایسه ابزار داده
در این بخش فرعی، ابتدا کاربرد مسیرهای منتشر شده را با شباهت کسینوس، فاصله هاوسدورف و اعوجاج پرس و جوی محدوده ارزیابی می کنیم. سپس، ما ابزار را با سه آنتروپی معرفی شده در [ ۴۰ ] ارزیابی می کنیم. در نهایت، ما مبادله بین ابزار و حریم خصوصی را ارزیابی می کنیم.
۵٫۲٫۱٫ تشابه توزیع فضایی
شکل ۴ نقشه های حرارتی سه مجموعه داده مسیر واقعی و مجموعه داده های مسیر سالم ایجاد شده توسط چهار مدل را نشان می دهد. برای هر نقشه حرارتی یک مجموعه داده مسیر سالم، شباهت کسینوس آن را با نقشه حرارتی مربوط به مجموعه داده مسیر خام محاسبه میکنیم. تشابه کسینوس بالاتر به معنای حفظ توزیع فضایی بهتر است. از شکل ۴، میتوانیم ببینیم که مجموعه دادههای مسیری پاکسازیشده حاصل از DP-CSM پیشنهادی، نمرات شباهت کسینوس بالاتری نسبت به INFOCOM15 و IS17 دارند. اگرچه نمرات شباهت کسینوس DP-CSM کمتر از PCG است، شکاف آنها کمتر از INFOCOM15 و IS17 است. دلیل کاهش شباهت DP-CSM پیشنهادی این است که هستههای مکان را برای خوشهبندی به جای مجموعههای مکان اصلی اتخاذ میکند و هستهها نوعی فشردهسازی از دست دادن مجموعههای مکان اصلی هستند. این نشان می دهد که DP-CSM ابزار داده قابل قبول را قربانی کارایی می کند. دلیل عملکرد بهتر DP-CSM از INFOCOM15 و IS17 این است که DP-CSM از مکانیسم راه پله به جای مکانیسم لاپلاسی استفاده می کند.
۵٫۲٫۲٫ فاصله هاسدورف
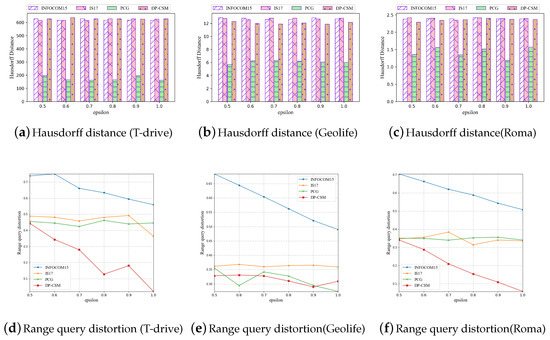
شکل ۵ مقایسه فاصله هاوسدورف بین چهار مدل را در تنظیمات مختلف نشان می دهد. فاصله Hausdorff تفاوت بین مجموعه داده مسیر خام و مجموعه داده مسیر سالم را اندازهگیری میکند، و فاصله کمتر به معنای حفظ ابزار بهتر از مجموعه داده مسیر سالم است. از شکل ۵ ، می بینیم که DP-CSM ما فواصل کمتری نسبت به مدل های INFOCOM15 و IS17 در بیشتر موارد دارد، که به معنای کاربرد بهتر داده نسبت به مدل های INFOCOM15 و IS17 است. مشابه روند نشان داده شده در شکل ۴، DP-CSM فواصل بزرگتری نسبت به PCG دارد. این معقول است زیرا (۱) شمارش مسیرها تأثیری بر مسافت هاسدورف ندارد، به این معنی که صدای راه پله در شمارش بی فایده خواهد بود. (۲) ساخت کورست ها مجموعه داده های مسیر بازسازی شده را تحریف می کند.
۵٫۲٫۳٫ اعوجاج پرس و جوی محدوده
شکل ۶ نتایج مقایسه چهار مدل در مورد اعوجاج پرس و جو محدوده را نشان می دهد. اعوجاج پرس و جوی محدوده کوچکتر حاکی از حفظ ابزار بهتر یک مجموعه داده مسیر پاکسازی شده است. همانطور که در شکل ۶ نشان داده شده است ، DP-CSM ما دارای اعوجاج محدوده پرس و جو کمتری نسبت به سه خط مبنا تحت تنظیمات یکسان است. این نتایج نشان میدهد که اگرچه DP-CSM ما ابزار داده را قربانی کارایی میکند، اما مجموعه داده خام را بیش از حد تحریف نمیکند. علاوه بر این، ما همچنین میتوانیم ببینیم که با افزایش اندازه مجموعه دادهها، اعوجاج پرس و جوی محدوده کاهش مییابد. این بدان معنی است که مجموعه داده های مسیر بزرگتر برای حفظ حریم خصوصی مفید هستند.
۵٫۲٫۴٫ آنتروپی تصادفی
شکل ۷ نتایج مقایسه آنتروپی تصادفی چهار روش را با مجموعه داده خط سیر خام نشان می دهد. از شکل ۷، می توانیم ببینیم که DP-CSM، INFOCOM15 و IS17 می توانند آنتروپی تصادفی مشابهی را بدست آورند که بزرگتر از آنچه PCG در مجموعه داده T-drive به دست می آورد. در حالی که در مجموعه داده های Geolife و Roma، DP-CSM آنتروپی تصادفی بالاتری را نسبت به سایرین نشان می دهد. (تأثیر روی پیش بینی پذیری در مجموعه داده های مختلف به دلیل فواصل زمانی مختلف نمونه گیری متفاوت است. پیش بینی پذیری مسیرهایی با فواصل زمانی نمونه برداری کوچکتر ممکن است حساس تر باشد). این بدان معنی است که قابلیت حفظ قابلیت پیش بینی DP-CSM از روش های دیگر عقب تر است. شایان ذکر است که، از آنجایی که سه مجموعه داده مورد استفاده در آزمایشهای ما در مقایسه با مسیرهای CDR (Call Detailed Record) که در [ ۴۲ ] استفاده میشوند، مسیرهای GPS با دانهبندی ریزتری دارند.]، پیش بینی پذیری آنها ممکن است کمتر از مسیرهای CDR باشد.
۵٫۲٫۵٫ آنتروپی زمانی-غیر همبسته
شکل ۸ نتایج مقایسه آنتروپی غیرهمبسته زمانی چهار روش را با مجموعه داده خط سیر خام نشان می دهد. از شکل ۸ ، می توانیم روندهای مشابهی را که در شکل ۷ وجود دارد، مشاهده کنیم . همچنین نشان میدهد که DP-CSM آنتروپی بیهمبستگی زمانی بالاتری نسبت به روشهای دیگر دارد. بنابراین، DP-CSM قابلیت پیشبینی بیشتری را نسبت به روشهای دیگر از دیدگاه ابزار داده از دست میدهد، اما میتواند حریم خصوصی بالاتری را حفظ کند زیرا پیشبینیپذیری ممکن است باعث افشای حریم خصوصی در برخی شرایط شود.
۵٫۲٫۶٫ آنتروپی واقعی
شکل ۹ نتایج مقایسه آنتروپی واقعی چهار روش با مجموعه داده خط سیر خام را نشان می دهد. همانطور که در شکل ۹ نشان داده شده است ، چهار روش دارای آنتروپی واقعی در تنظیمات مختلف هستند، به این معنی که آنها قابلیت حفظ قابلیت پیش بینی مشابهی دارند. علاوه بر این، شکاف بین آنتروپی مجموعه داده خام و آنتروپی مجموعه داده های پاکسازی شده در مجموعه داده های Geolife و Roma بزرگتر از T-drive است. دلیل ممکن است تفاوت فواصل نمونهگیری باشد و مجموعه داده T-drive فاصله نمونهگیری بیشتری نسبت به مجموعه دادههای Geolife و Roma دارد.
۵٫۲٫۷٫ تاثیرات ϵدر ابزار داده
شکل ۱۰ a-c کاربرد داده روش های مختلف را در سه مجموعه داده مسیر زندگی واقعی نشان می دهد. شکل ۱۰ a-c نتایج حاصل از T-drive، Geolife و Roma را نشان می دهد. شکل ۱۰ a-c نشان می دهد که فاصله Hausdorff DP-CSM بزرگتر از PCG اما نزدیک به INFOCOM15 و IS17 است، که به این معنی است که از دست دادن ابزار داده بیشتر از PCG است اما تلفات ابزار مشابه با INFOCOM15، IS17 است. این معقول است زیرا (۱) شمارش مسیرها تأثیری بر مسافت هاسدورف ندارد، به این معنی که صدای راه پله در شمارش بی فایده خواهد بود. (۲) ساخت کورست ها داده های مسیر را مخدوش می کند.
همانطور که در شکل ۱۰ d-f نشان داده شده است، محور افقی بودجه حریم خصوصی را نشان می دهد ϵ، و محور عمودی اعوجاج پرس و جوی محدوده را نشان می دهد. شکل ۱۰ d-f نشان می دهد که کاربرد مسیرهای بازسازی شده با افزایش ϵو DP-CSM نسبت به سه کار دیگر در بیشتر موارد کاربرد بیشتری دارد. این معقول است زیرا (۱) افزایش بودجه حریم خصوصی به این معنی است که نویزهای کمتری اضافه شده است و بنابراین ابزار بهبود می یابد. (۲) k -means مبتنی بر مجموعه هسته با تکرارهای کمتری همگرا می شود. بنابراین، زمانی که حداکثر تعداد تکرارها ثابت است، k -means مبتنی بر مجموعه هسته، کاربرد بیشتری نسبت به k -means دارند . (۳) در مقایسه با مکانیسم لاپلاس، مکانیسم راه پله می تواند با اجتناب از اضافه کردن نویز بیش از حد به تعداد مسیرها، کاربرد را بهبود بخشد.
۵٫۳٫ مقایسه مقیاس پذیری
ما زمان اجرا را تحت اندازه های مختلف داده و تعداد متفاوت مراکز خوشه مطالعه می کنیم. برای تجزیه و تحلیل جامع تر DP-CSM، ما کل زمان تولید مسیر را تجزیه و تحلیل می کنیم و بازده زمانی DP-CSM را با INFOCOM15، IS17 و PCG مقایسه می کنیم.
۵٫۳٫۱٫ تاثیر |D|در مقیاس پذیری
شکل ۱۱ مقایسه کارایی بین چهار روش را در سه مجموعه داده مسیر زندگی واقعی نشان می دهد. پیچیدگی زمانی INFOCOM15، IS17 و PCG است O(nک|D||تی|)، و پیچیدگی زمانی DP-CSM است O(nکمتر|تی|)، که در آن m = ۰٫۲ |D|. همانطور که در شکل ۱۱ نشان داده شده است ، DP-CSM همیشه بسیار سریعتر از INFOCOM15، IS17 و PCG تحت تنظیمات یکسان است. این نتایج نشان می دهد که کارایی DP-CSM در بین کارهای مقایسه شده بالاترین است. این منطقی است زیرا coreset خلاصه کوچکی از مجموعه داده اصلی است (بنابراین متر<|D|) که زمان اجرای k -means مبتنی بر مجموعه هسته را کاهش می دهد .
۵٫۳٫۲٫ تاثیر k بر مقیاس پذیری
شکل ۱۲ کارایی چهار روش را در سه مجموعه داده مسیر واقعی نشان می دهد. همانطور که در شکل ۱۲ نشان داده شده است ، زمان اجرا تقریباً به صورت خطی با افزایش k افزایش می یابد . این معقول است زیرا زمان k -means به صورت خطی با افزایش k افزایش می یابد و کل زمان اجرا عمدتاً از زمان k -means تشکیل شده است. علاوه بر این، ما همچنین می توانیم ببینیم که DP-CSM همیشه بسیار سریعتر از INFOCOM15، IS17 و PCG است، که به این معنی است که کارایی DP-CSM در بین کارهای مقایسه شده بالاترین است. دلیل آن مانند بخش ۵٫۳٫۱ است.
۶٫ نتیجه گیری
در این مقاله، ما DP-CSM را ارائه میکنیم، یک الگوریتم سنتز مسیر خصوصی متفاوت بر اساس کورستها و مکانیسم پلکان برای انتشار دادههای مسیر. در مقایسه با راهحلهای مبتنی بر مرکز خوشهای موجود، DP-CSM از مجموعه هستهای برای بهبود کارایی استفاده میکند و از مکانیسم پلکانی برای جایگزینی مکانیسم سنتی لاپلاس برای بهبود سودمندی استفاده میکند. DP-CSM عمدتاً از دو مرحله زیر تشکیل شده است: تعمیم مکان و بازسازی مسیر. در مرحله اول، مجموعه هسته مجموعه مکان را در هر مهر زمانی می سازیم. سپس از k استفاده می کنیم-به معنای خوشه بندی برای به دست آوردن مجموعه های مکان تعمیم یافته است. در مرحله دوم، ابتدا مسیرها را بازسازی می کنیم و نویز را به تعداد مسیرهای بازسازی شده اضافه می کنیم. با توجه به تعداد مسیرهای بازسازی شده، ما مسیرها را تکمیل می کنیم و نویز اضافه می کنیم. نتایج تجربی نشان میدهد که DP-CSM کارایی را تا حد زیادی بهبود بخشیده است و در عین حال کاربرد و سطح حریم خصوصی مشابهی را با سه روش رایج مانند INFOCOM15، IS17 و PCG حفظ کرده است.
در آینده، ما امیدواریم که با ساخت مستقیم هستههای با ابعاد بالا بر اساس مسیر اصلی، مرحله بازسازی مسیر را حذف کنیم، بنابراین سودمندی دادهها و کارایی زمان را بیشتر بهبود میبخشیم. علاوه بر این، DP-CSM در حال حاضر فقط میتواند مسیرها را با همان طول پردازش کند – امیدواریم در آینده بر این نارسایی غلبه کنیم.