۱٫ معرفی
با رشد فوق العاده اینترنت اشیا (IoT)، دستگاه های هوشمند و شبکه های اجتماعی (SN)، بار اطلاعات هر روز در حال افزایش است [ ۱ ]. محاسبات سیار همانطور که در [ ۲ ، ۳ ] IoT نشان داده شده است، و دستگاههای حسگر هوشمندتر میشوند به طوری که میتوانند مانند انسانها با یکدیگر تعامل اجتماعی داشته باشند و مقدار زیادی داده را به صورت روزانه تولید کنند [ ۴ ]. پیشرفتهای اخیر در تکنیکهای محلیسازی، SNهای مبتنی بر مکان را به عنوان همگرایی سرویسهای مبتنی بر مکان و SN محبوب کرده است [ ۵ ]]. محتوای مرتبط با مکان با توسعه سریع تولید شده توسط SN های مبتنی بر مکان، تحقیقات را برای توسعه فیلترینگ جدید و کاوش ابزارهایی تحریک کرده است که اطلاعات شخصی بیشتری را در اختیار کاربران قرار می دهد [ ۵ ]. اقیانوس های داده تولید شده توسط دستگاه های هوشمند و SN ها، توسعه سریع سیستم های توصیه گر (RS) را اجتناب ناپذیر می کند [ ۶ ، ۷ ، ۸ ]. RS می تواند به عنوان ابزاری برای فیلتر کردن مواردی استفاده شود که به احتمال زیاد توسط کاربران ترجیح داده می شوند [ ۹ ]. آنها همچنین به عنوان خدمات مدیریت دانش برای تجزیه و تحلیل و فیلتر کردن اطلاعات کارآمد بر روی کاربران پیشنهاد شده اند [ ۱۰]. به دلیل اهمیت آنها در زندگی روزمره کاربران در دهه های اخیر، RS ها به ویژه از سوی جوامع علوم اجتماعی و رایانه مورد توجه قرار گرفته اند [ ۶ ، ۱۱ ].
یک چالش برای RS ها ارائه توصیه های شخصی به کاربران زمانی است که اطلاعات کافی برای توصیف کاربران یا موارد وجود ندارد، که به عنوان مشکل شروع سرد (CSP) نیز شناخته می شود [ ۱۲ ، ۱۳ ، ۱۴ ، ۱۵ ، ۱۶ ، ۱۷ ]. شباهت بین کاربران یا آیتم ها را می توان متداول ترین رویکرد کاربردی برای پرداختن به CSP در نظر گرفت [ ۱۲ ، ۱۸ ]. برای RSهای معمولی، شباهتهای بین کاربران یا توسط نظرات ایجاد شده توسط کاربر یا با رتبهبندی موارد مختلف مشخص شد. با این حال، تحقیقات تجربی نشان داد که تنها ۱۵ درصد از کاربران مشابه را می توان با نظرات یا رتبه بندی های ایجاد شده آنها شناسایی کرد [ ۱۳ ]]. استفاده از روابط اجتماعی برای شناسایی کاربران مشابه برای RS های آگاه اجتماعی را می توان به عنوان یک پیشرفت اخیر در SN ها برای پرداختن به CSP در نظر گرفت [ ۱۲ ، ۱۹ ]. اگرچه استفاده از این رویکرد می تواند تا حد زیادی CSP را حذف کند، اما محدودیت جدیدی را بر RS تحمیل می کند که برای شناسایی کاربران مشابه به SN ها متکی است. علاوه بر این، RSهای آگاه اجتماعی هنوز از فقدان پیوندهای اجتماعی اولیه برای تازه واردان رنج می برند (یعنی CSP هنوز یک گلوگاه برای RS ها است، زمانی که اطلاعاتی برای توصیف تعاملات اجتماعی کاربر وجود ندارد).
جدای از توسعه SN های مبتنی بر مکان و ویژگی های مختلف، CSP همچنان در ارائه توصیه های شخصی سازی شده برای کاربران و مکان های جدید ادامه دارد. استفاده از الگوهای تحرک کاربر و ویژگیهای جغرافیایی مانند مسیر حرکت و بررسیهای معمول، میتواند پیشرفتهای اخیر در یافتن کاربران مشابه برای RSهای مبتنی بر مکان [ ۲۰ ] در نظر گرفته شود. توریجوس و همکاران [ ۲۰]، نشان داد که استفاده از تکنیک تشخیص شباهت بر اساس مسیرهای کاربر می تواند در مقایسه با سایر رویکردهای شباهت مانند در نظر گرفتن رتبه بندی های مشابه به منظور یافتن کاربران مشابه، به توصیه های قابل اعتمادتری منجر شود. با این حال، رویکرد تشخیص شباهت مبتنی بر مسیر از نظر محاسباتی گرانتر از سایر روشهای رقابتی است [ ۲۰ ، ۲۱ ].
علاوه بر CSP، ارائه توصیههای شخصیشدهتر که با اولویتهای کاربر همخوانی بیشتری دارند، میتواند هدف اساسی برای RSهای آگاه اجتماعی در نظر گرفته شود. توصیه اقلام شخصیشدهتر نیاز به درک عمیقتری از رفتارهای پویا کاربران دارد [ ۲۲ ]. ترجیحات کاربر را می توان به طور خودکار با استفاده از دستگاه های هوشمند استدلال و استخراج کرد [ ۲۳ , ۲۴ , ۲۵]. انواع مختلفی از اطلاعات زمینهای از جمله علایق کاربر، فعالیتها، محیطهای فیزیکی، حلقههای اجتماعی، دستگاهها، زمانها و مکانها برای RSهای مختلف در نظر گرفته شده است تا توصیههای شخصیتر ارائه شود. با این حال، جمع آوری دستی تنظیمات برگزیده کاربر نه همیشه ممکن است و نه کافی است. زمینه های بررسی شده در بیشتر مطالعات اخیر محدود به مواردی است که می توان از حسگرهای تعبیه شده در گوشی های هوشمند استخراج کرد [ ۲۶ ]. برای این تحقیق قصد داریم علاوه بر گوشی های هوشمند از دستگاه های هوشمند مختلف برای استخراج خودکار اطلاعات پروفایل استفاده کنیم.
برای این تحقیق، ترکیبی از فنآوریهای مختلف از جمله دستگاههای هوشمند، SN، هوش مصنوعی (AI) و آگاهی از زمینه (CA)، در یک RS ترکیبی برای رسیدگی به CSP و ارائه توصیههای شخصیتر ادغام شدهاند. به طور خلاصه، کمک های اصلی این تحقیق به شرح زیر است:
-
پیشنهاد یک موتور جدید تشخیص شباهت کاربر (USDE) که میتواند شباهتهای بین کاربران را با در نظر گرفتن تعاملات اجتماعی ایجاد شده در دنیای واقعی یا بهطور مجازی از طریق SNs مدلسازی کند.
-
ادغام پتانسیل دستگاه های هوشمند شخصی کاربران با RS ها برای گرفتن طیف گسترده ای از اطلاعات متنی در مورد کاربران و در نتیجه ارائه توصیه های شخصی تر.
-
تجهیز USDE پیشنهادی به یک الگوریتم خوشهبندی کاربر برای فعال کردن RS پیشنهادی برای مواجهه با چالشبرانگیزترین موقعیتهای شروع سرد که برای آنها سایر RSها، از جمله RSهای مبتنی بر مکان، در ارائه توصیههای شخصیشده شکست میخورند.
معماری RS هیبریدی پیشنهادی از چهار لایه مختلف تشکیل شده است. همانطور که در شکل ۱ مشاهده می شودلایه “Data Acquisition and Accumulation” لایه پایینی این معماری است. دستگاههای هوشمند مانند Google Home، پوشیدنیهای هوشمند و تلفنهای هوشمند عمدتاً مسئول جمعآوری دادههایی هستند که میتوان از آنها برای استخراج اطلاعات متنی مربوط به کاربر استفاده کرد. لایه اکتساب داده همچنین شامل انواع مختلفی از SN است که پیوندهای اجتماعی را برای کاربران فراهم می کند که پیوندهای اجتماعی را به کاربران ارائه می دهد که به صورت مجازی از طریق SN ها ساخته شده اند. انواع دادههای رایج مانند رویدادها، مکانها، نکات و اطلاعات چندرسانهای نیز از انواع مختلف SN استخراج میشوند. از آنجایی که دستگاههای هوشمند و حسگرهای مختلف دادههای خود را در قالبهای مختلف صادر میکنند، لایه انباشت وظیفه جمعآوری و ذخیره دادهها را در قالب مورد نیاز در یک مخزن داده مرکزی دارد. سرانجام،
لایه «نمایه کاربر پویا» از الگوریتمهای استخراج متن مختلف برای استخراج زمینههای معنادار از دادههای ارائهشده توسط لایه «اکتساب و انباشت دادهها» استفاده میکند. سپس، نمایه کاربر از طبقهبندی اطلاعات زمینهای مانند فعالیتهای کاربر، علایق کاربر، و سایر مقولههای زمینه مشابه با استفاده از موتور استدلال زمینه ایجاد میشود. به عبارت دیگر، نمایه کاربر خلاصه ای از اطلاعات معنی دار است که به طور صریح یا ضمنی ترجیحات کاربر را بیان می کند. لایه “موتور تشخیص شباهت کاربر” نقش مهمی را برای RS پیشنهادی ایفا می کند. به طور کلی شباهت های کاربر را بر اساس تعاملات اجتماعی بین کاربران و همچنین دستگاه های هوشمند تشخیص می دهد. سرانجام،
ما برای RS پیشنهادی با چندین محدودیت مواجه هستیم. در مرحله اول، فرض بر این است که زیرساخت اینترنت و ذخیره سازی ابری برای تبادل داده و مدیریت داده در دسترس هستند. ثانیاً، تعاملات اجتماعی بین کاربران یکی از معیارهای شباهت برای RS پیشنهادی ما فرض میشود. از این رو، کاربرانی که قصد استفاده از این سیستم پیشنهادی پیشنهادی را دارند باید بدانند که توصیههای آنها تا حدی تحت تأثیر حلقههای اجتماعی آنها است. کیفیت دادهها برای اطلاعاتی مانند ضربان قلب و کیفیت خواب که از پوشیدنیهای هوشمند بهدست میآیند، بر اساس مدلهای مختلف اعمالشده توسط تولیدکنندگان متفاوت است و خارج از محدوده این مقاله است. علاوه بر این، RS پیشنهادی به طور کامل از یک الگوریتم حفظ حریم خصوصی پشتیبانی نمی کند و بنابراین این جنبه نیز خارج از محدوده این مطالعه تحقیقاتی است.
ساختار باقی مانده این مقاله به شرح زیر است: در بخش ۲ این مقاله، به طور خلاصه انواع مختلف RS و اقدامات مشابهی را که اخیراً برای کاهش CSP پیشنهاد شدهاند بررسی میکنیم. در بخش ۳ ، ایجاد و به روز رسانی پروفایل های کاربر با استفاده از دستگاه های هوشمند شخصی توضیح داده شده است. توضیح مفصلی از موتور تشخیص شباهت کاربر پیشنهادی و الگوریتم توصیهگر به ترتیب در بخش ۴ و بخش ۵ ارائه شده است. علاوه بر این، عملکرد RS پیشنهادی ما در دو سناریو مختلف در بخش ۵ بررسی شده است. بخش ۶ نتایج به دست آمده از آزمایش های ما را ارائه می دهد. در نهایت، بخش ۷نتیجه گیری و مسیرهای آینده را مورد بحث قرار می دهد.
۲٫ بررسی ادبیات
الگوریتمهای مبتنی بر محتوا (CB) و فیلترینگ مشارکتی (CF) به عنوان دو رویکرد پرکاربرد توصیه شناخته میشوند [ ۱۳ ، ۲۷ ]. اگرچه هدف اصلی آنها برآورد علاقه کاربر به موارد جدید است، الگوریتم های CB مواردی را توصیه می کنند که مشابه مواردی هستند که قبلاً توسط کاربر ترجیح داده شده است. در حالی که الگوریتم های CF مواردی را بر اساس آنچه افراد همفکر در گذشته ترجیح می دادند توصیه می کنند. ماهیت عمومی CF دلیل اساسی برای دستیابی به موفقیت گسترده تر بود [ ۸ ، ۲۷ ]. الگوریتم های CF به طور گسترده در خدمات وب و اینترنت اشیاء استفاده می شوند [ ۲۸ , ۲۹ , ۳۰]. الگوریتمهای توصیهگر CF را میتوان به رویکردهای مبتنی بر مدل و مبتنی بر همسایگی طبقهبندی کرد. تکنیکهای دادهکاوی، مانند فاکتورسازی ماتریس [ ۳۱ ] بیشتر برای تعیین روابط بین کاربران و آیتمها در رویکردهای مبتنی بر مدل استفاده میشوند. رویکرد همسایگی، در مقایسه، از تکنیک های آماری برای یافتن همسایگی بین کاربران (CF مبتنی بر کاربر [ ۳۲ ]) یا بین آیتم ها (CF مبتنی بر آیتم [ ۳۳ ]) استفاده می کند.
اگرچه الگوریتمهای سنتی CF به موفقیت زیادی دست یافتهاند، CSP هنوز یک چالش است [ ۳۴ ]. این مشکل زمانی به وجود می آید که یک کاربر جدید (که به عنوان “user CSP” نامیده می شود) یا مورد (به عنوان “اقلام CSP”) به RS اضافه می شود و هیچ اطلاعات تاریخی برای بیان صریح یا ضمنی ترجیحات کاربر وجود ندارد [ ۳۵ ]. فقدان اطلاعات کافی برای موارد جدید باعث می شود که آنها در انتهای لیست توصیه ها قرار بگیرند [ ۳۶ ]]. کاربر CSP بر عملکرد RS تأثیر منفی می گذارد تا توصیه های معناداری برای کاربران جدید ارائه دهد. ارائه رتبهبندی قبلی به اقلام جدید توسط کارکنان میتواند تا حد زیادی CSP مورد را حذف کند. با این حال، نگرانیهای مربوط به حریم خصوصی در RS اجازه نمیدهد رویکرد مشابهی برای رسیدگی به CSP کاربر اعمال شود که توجه محققان را به شدت جلب کرده است. توجه داشته باشید که برای بقیه این مقاله، عبارت CSP منحصراً برای کاربر CSP استفاده می شود. رویکردهای رایج برای پرداختن به CSP کاربر را می توان به سه دسته اصلی طبقه بندی کرد: (۱) ارزیابی تعامل بین کاربران و آیتم ها برای شناسایی برجسته ترین گروه های کاربران مشابه [ ۳۰ ]، (۲) با استفاده از برخی اطلاعات زمینه اضافی مانند جمعیت شناسی داده [ ۳۷]، و (۳) استفاده از RS های ترکیبی یا ترکیبی از الگوریتم های توصیه کننده برای افزایش عملکرد روش پیش بینی [ ۳۶ ].
شباهت کسینوس، همبستگی پیرسون و همبستگی رتبه اسپیرمن را می توان به عنوان پرکاربردترین معیار تشابه برای شناسایی کاربران مشابه نام برد [ ۳۰ ]. شباهت کسینوس زاویه بین دو بردار رتبه بندی را اندازه می گیرد و زاویه کوچکتر به معنای شباهت بیشتر بین کاربران است. همبستگی پیرسون به همبستگی خطی بین دو بردار رتبه بندی نگاه می کند. در نهایت، همبستگی رتبه اسپیرمن شباهت بین دو بردار رتبهبندی را با در نظر گرفتن رتبههایی که به اقلام همردهبندی شده توسط کاربران داده شده است، اندازهگیری میکند [ ۳۸ ]. تعاریف معیارهای شباهت بین دو کاربر در جدول ۱ [ ۳۰ ] خلاصه شده است.
پراکندگی داده ها باعث ایجاد محدودیت های متفاوتی برای معیارهای مشابهت فوق می شود. به عنوان مثال، زمانی که تنها یک مورد در مجموعه آیتم های هم رتبه وجود دارد، همبستگی پیرسون قابل محاسبه نیست و شباهت کسینوس “۱” را بدون توجه به تفاوت بین دو رتبه بندی داده شده به یک مورد توسط دو کاربر به دست می آورد. در شرایطی دیگر، زمانی که دو کاربر برای همه موارد دارای رتبهبندی یکسان رتبهبندی میکنند (به عنوان مثال، ( ۳ , ۳ , ۳ )(۳, ۳, ۳)و ( ۵ , ۵ , ۵ )(۵, ۵, ۵)رتبهبندیهایی است که توسط دو کاربر برای سه مورد داده میشود)، همبستگی پیرسون قابل محاسبه نیست و شباهت کسینوس حداکثر شباهت بین کاربران را بدون توجه به تفاوت بین مقادیر رتبهبندی گزارش میکند.
CSP کاربر و پراکندگی داده ها یک مسئله جدی برای اکثر RSهای دنیای واقعی است [ ۳۸ ]. در نظر گرفتن تعاملات تاریخی بین کاربران و آیتم ها برای شناسایی کاربران مشابه می تواند تا حدودی این مشکل را حل کند. با این حال، زمانی که تعداد محدودی از رتبهبندیهای مشترک یا نظرات مشابه معنایی وجود داشته باشد، CSP جدیتر میشود. تحقیقات تجربی نشان داد که تنها ۱۵ درصد از کاربران مشابه را می توان با نظرات ایجاد شده یا رتبه بندی آنها شناسایی کرد [ ۱۳ ]. آزمایشهای ساده با استفاده از مجموعه دادههای MovieLens در دسترس عموم [ ۳۹ ] نشان داد که شباهت کسینوس و معیارهای همبستگی پیرسون میتوانند به ترتیب تنها برای ۲۶٫۲% و ۱۵٫۹% از ۷۶۵۰ جفت کاربر که بهطور تصادفی انتخاب شدهاند قابل اجرا باشند [ ۳۸ ].]. در نتیجه، تنها تکیه بر اطلاعات رتبه بندی برای اعمال معیارهای شباهت برای سناریوهای دنیای واقعی کافی نیست. بنابراین، شناسایی کاربران مشابه برای حل CSP کاربر با استفاده از برخی منابع داده اضافی یک موضوع محبوب در جامعه تحقیقاتی RS است [ ۸ ، ۳۷ ].
اطلاعات متنی نقش مهمی در ارائه اطلاعات اضافی برای شناسایی کاربران مشابه با توجه به ترجیحات کاربر دارد [ ۳۷ ]. الگوریتمهای متنآگاه توصیههای شخصیشدهتری را در اختیار کاربران قرار میدهند [ ۲۷ ]. زمینه تاریخچه مکان [ ۴۰ ] یا شباهت بین مسیرهای کاربران [ ۴۱ ] را می توان به عنوان یکی از زمینه های بیشتر کاربردی ذکر کرد. با این حال، بیشتر الگوریتم های آگاه از زمینه، هزینه محاسباتی گرانی را به RS تحمیل می کنند. با شروع تحقیقات آدوماویسیوس و همکاران. [ ۴۲]، الگوریتمهای آگاه از زمینه تلاش میکنند تا با در نظر گرفتن اطلاعات متنی کاربر/مورد، علایق کاربر را در موارد مختلف تخمین بزنند. استفاده از داده های جمعیت شناختی مانند سن، شغل و جنسیت کاربران یکی از محبوب ترین رویکردها برای شناسایی کاربران مشابه و کاهش CSP کاربر است [ ۳۶ ]. Alliouli YL [ ۳۶ ]، یک رویکرد جدید مبتنی بر استفاده از دادههای جمعیتی و تکنیکهای طبقهبندی برای پرداختن به CSP در یک الگوریتم توصیهکننده CF پیشنهاد کرد. این رویکرد را می توان در سه مرحله خلاصه کرد [ ۳۶]: ساختن C4.5 و طبقهبندی Naïve Bayes با استفاده از دادههای جمعیتی، شناسایی شباهت بین کاربر شروع سرد جدید و همسایگان آن در داخل کلاس، و پیشبینی رتبهبندی برای کاربر جدید بر اساس کاربران آن کلاس. با این حال، تکنیک های طبقه بندی نیاز به دانش قبلی از داده ها دارد. استفاده از تکنیک های خوشه بندی در عوض بر محدودیت رویکردهای طبقه بندی [ ۳۷ ] غلبه می کند. خوشه بندی کاربران مشابه بر اساس اطلاعات زمینه ای آنها جایی است که آگاهی از زمینه نقش مهمی برای غلبه بر CSP مطرح شده در الگوریتم های توصیه گر CF ایفا می کند.
در دسته RS Hybrid، Chatzidimitris و همکاران. [ ۳۷ ]، یک RS تجارت الکترونیکی پیشرفته به نام SMARTBUY را طراحی و پیاده سازی کرد که توصیه های مبتنی بر مکان را برای محصولات و خدمات خرده فروشی به کاربران تلفن همراه ارائه می دهد. CF الگوریتم اصلی توصیه کننده در SMARTBUY است. استفاده از اطلاعات زمینه ای مختلف مانند داده های جمعیتی نه تنها CF را در کاهش CSP توانمند می کند. بلکه توصیه های شخصی تری را نیز ارائه می دهد. کاروالیو و همکاران [ ۳۵]، یک RS هیبریدی را پیشنهاد کرد که از قوانین ارتباط برای شناسایی کاربران مشابه و غلبه بر CSP استفاده می کند. هدف این تحقیق شناسایی افراد همفکر و توصیه به کاربر هدف مواردی است که سایر اعضای خوشه پسندیده اند. فاصله اقلیدسی بر اساس مکان های تاریخی کاربران و همچنین با استفاده از داده های جمعیت شناختی از جمله سن، جنسیت، ملیت و سابقه جستجو در SMARTBUY برای خوشه بندی کاربران مشابه [ ۳۷ ] اعمال شده است. در SMARTBUY [ ۳۷ ]، RS آگاه از زمینه به تلفنهای هوشمند و شبکههای اجتماعی (در اینجا فقط Facebook API) به عنوان تنها منبع برای ارائه اطلاعات متنی متکی است. برای پوشش بخشی از خلأهای تحقیق در روش های فوق الذکر [ ۳۵ ، ۳۷ ، ۴۰ ، ۴۱]، ما یک RS هیبریدی را برای رسیدگی به مسائل زیر پیشنهاد می کنیم:
-
اگرچه استفاده از منابع داده اضافی مانند تنظیمات برگزیده کاربران می تواند به CSP رسیدگی کند، درخواست از کاربران برای ارائه دستی چنین اطلاعاتی همیشه امکان پذیر نیست. علاوه بر این، این اطلاعات در طول زمان در حال تغییر هستند. به عنوان مثال، ژانرهای موسیقی یا فیلم مورد علاقه کاربران می تواند در طول زمان تغییر کند. درخواست از کاربران برای به روز رسانی منظم تنظیمات برگزیده خود، محدودیت برخی از RS هایی است که اخیراً توسعه یافته اند. با رشد فوق العاده دستگاه های هوشمند، ما دیگر محدود به تعداد محدودی از ارائه دهندگان زمینه مانند گوشی های هوشمند و تبلت ها نیستیم. بنابراین، در این تحقیق، ما به طور خودکار مشخصات کاربر را بر اساس دستگاه های هوشمند شخصی وی به روز می کنیم.
-
تکیه بر SN ها برای شناسایی کاربران مشابه اجتماعی، محدودیت جدیدی را برای RS ها تحمیل می کند (یعنی کاربران باید عضو یک SN باشند). علاوه بر این، RS ها هنوز از CSP رنج می برند زمانی که هیچ اطلاعاتی وجود ندارد که به طور صریح یا ضمنی تعامل اجتماعی کاربر را در SN ها بیان کند. در مطالعات قبلی، تنها تعاملات مجازی از SNها برای شناسایی کاربران مرتبط با اجتماعی استخراج شد [ ۱۲ ]. با این حال، در این تحقیق، تعاملات اجتماعی در دنیای واقعی استخراج شده از دستگاه های هوشمند کاربران به USDE ما اضافه شده است. این تعاملات اجتماعی در دنیای واقعی نقش مهمی را به عنوان منبع داده اضافی برای شناسایی شباهت بین کاربران ایفا می کند.
-
معیارهای شباهت همبستگی کسینوس و پیرسون را می توان به عنوان گسترده ترین معیارهای شباهت استفاده شده [ ۳۰ ، ۳۷ ] در RS های مبتنی بر CF ذکر کرد. اقدامات مشابهی که پیشنهاد شده است، استفاده بسیار کم را در شرایط سخت CSP نشان می دهد. در مقایسه با معیارهای شباهت کاربردی، یک معیار تشابه مبتنی بر اعتماد جدید در این تحقیق پیشنهاد شده است. در این مطالعه، یک تکنیک خوشهبندی مبتنی بر ازدحام در USDE استفاده میشود تا RS پیشنهادی برای رسیدگی به CSP قدرتمندتر شود. به عبارت دیگر، USDE پیشنهادی توسط یک الگوریتم خوشهبندی برای شناسایی کاربران مشابه بر اساس تعاملات اجتماعی در دنیای واقعی و اطلاعات متنی موجود در نمایههایشان توانمند است.
۳٫ به روز رسانی نمایه کاربر با استفاده از دستگاه های هوشمند
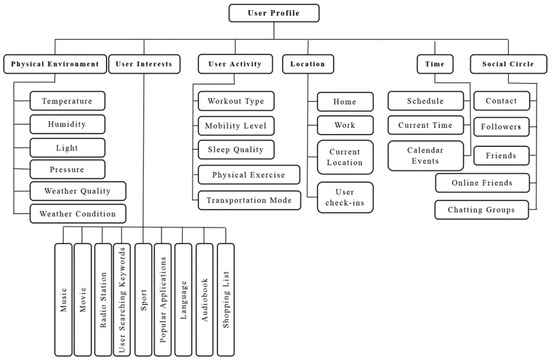
نمایه کاربر نمایه ای است حاوی اطلاعات متنی در مورد هویت، فعالیت، مکان، حلقه اجتماعی و ترجیحات کاربر در جنبه های مختلف مانند رویدادها و فیلم ها. این موارد را می توان به عنوان “زمینه کاربر” نیز در نظر گرفت [ ۴۳ ]. اکثر RSهای فعلی [ ۳۷] به صورت دستی ترجیحات صریح کاربر را جمع آوری می کند که وقت گیر است. علاوه بر این، جنبه های پویا نمایه کاربر (یعنی زمینه ها) قابل رسیدگی نیست. ایجاد خودکار یک نمایه کاربر پویا فرصت های زیادی برای بهبود عملکرد RS ها ایجاد می کند. در مرحله اول، آنها می توانند توصیه های آگاه از زمینه را ارائه دهند که شخصی تر از توصیه های ارائه شده توسط RS های معمولی هستند. ثانیاً، بهروزرسانی پویا نمایههای کاربر میتواند تغییراتی را که ممکن است در طول زمان در اولویتهای کاربر رخ دهد، مدلسازی کند. در نهایت، نمایه های کاربر را می توان به عنوان معیاری برای شناسایی کاربران مشابه در شرایطی که سایر معیارهای شباهت مانند تعاملات اجتماعی در دسترس نیست در نظر گرفت. برای این مطالعه، از اطلاعات زمینه ای برای تشکیل یک نمایه کاربر پویا استفاده خواهد شد.شکل ۲ . طبقهبندی مفهومی پیشنهادی روشی انعطافپذیر و ساختار یافته برای سازماندهی و گسترش زمینهها ارائه میکند.
زمینه های مختلفی را می توان از داده های جمع آوری شده توسط دستگاه های هوشمند کاربران استخراج کرد. به عنوان مثال، یک بلندگوی هوشمند مانند Google Home داده ها را بر اساس دستورات صوتی کاربران ارائه می دهد. برای مثال، پخش یک فیلم Google Play با استفاده از Google Home به Google Chromecast نیاز به دنبال کردن یک فرمان صوتی مشخص دارد (به عنوان مثال، «تماشا/ پخش» ⟨ مo v i e n a m e s u c h a s B e e M o v i e ⟩〈����� ���� ���ℎ �� ��� �����〉بر [ پa r t n e r s u c h a s C h r o m e c a s t ][������� ���ℎ �� �ℎ��������]) که به صراحت توسط Google LLC ( https://support.google.com/googlehome/ ) توضیح داده شده است. با تجزیه و تحلیل چنین اطلاعاتی، ترجیحات کاربران را می توان در جنبه های مختلف مانند ژانرهای فیلم مورد علاقه، سبک های موسیقی، خواننده ها و ایستگاه های رادیویی استخراج کرد. در این تحقیق، سه نوع ارائهدهنده زمینه شامل بلندگوهای هوشمند، دستگاههای پوشیدنی و گوشیهای هوشمند در نظر گرفته شده است.
استخراج زمینه های مورد نظر از بلندگوهای هوشمند (به عنوان مثال، Google Home) به استفاده از الگوریتم های تطبیق رشته ها نیاز دارد [ ۴۴ ، ۴۵ ]. متدولوژی های متن کاوی مختلفی مانند Knuth-Morris-Pratt، Rabin-Karp و brute-force وجود دارد [ ۴۰ ]. ثابت شده است که الگوریتم Knuth-Morris-Pratt یک مشکل تطبیق کلمه کلیدی را حل می کند. O ( m + n )�(�+�)زمان در حالی که دو الگوریتم مشابه دیگر آن را حل می کنند O ( m n )�(mn)زمان، که در آن m و n به ترتیب تعداد کاراکترهای کلمه کلیدی و رشته ورودی هستند [ ۴۶ ]. با توجه به عملکرد بهتر الگوریتم Knuth-Morris-Pratt [ ۴۴ ، ۴۵ ]، این الگوریتم برای استخراج متن از اطلاعات متنی جمع آوری شده توسط بلندگوهای هوشمند استفاده می شود. الگوریتم Knuth-Morris-Pratt برای استخراج نام فیلم ها از اطلاعات متنی جمع آوری شده توسط بلندگوی هوشمند Google Home در جدول ۲ نشان داده شده است .
دستگاههای پوشیدنی مانند ساعتها/بندهای هوشمند، ردیابهای تناسب اندام و هدستهای هوشمند، دومین ارائهدهنده زمینه در نظر گرفته شده در این تحقیق هستند. دستگاه های پوشیدنی به طیف متنوعی از حسگرها مانند دماسنج داخل گوش، سیستم موقعیت یابی جهانی (GPS)، شتاب سنج و ژیروسکوپ مجهز هستند. این حسگرها به کاربران امکان نظارت بر فعالیت های روزانه و اطلاعات مربوط به سلامتی خود را می دهند. در این مطالعه اطلاعات زمینهای مانند تمرین بدنی، سطح تحرک، حالت حملونقل و کیفیت خواب از APIهای دستگاههای پوشیدنی استخراج میشود.
قابلیتهای سنجش و محاسباتی تلفنهای هوشمند و تبلتها [ ۴۷ ] ما را برانگیخت تا از آنها به عنوان سومین ارائهدهنده زمینه استفاده کنیم. زمینه های مختلفی را می توان از حسگرهای گوشی های هوشمند و همچنین برنامه های نصب شده آن ها مانند رسانه های اجتماعی، تلفن، تقویم یا ایمیل استخراج کرد. اطلاعات ورود، نمودارهای اجتماعی کاربران متصل، محیط های فیزیکی، برنامه های روزانه، برنامه های مورد علاقه، و موضوعات جستجوی اینترنتی مورد علاقه از جمله اطلاعات زمینه احتمالی است که می توان از تلفن های هوشمند استخراج کرد [ ۱۸ ]. در این تحقیق یک اپلیکیشن موبایل برای استخراج و دسترسی به زمینه های مورد نظر از گوشی های هوشمند و تبلت ها ایجاد شده است. توضیح بیشتر در مورد برنامه توسعه یافته ما برای استخراج زمینه های مورد نظر در بخش ۶ آورده شده است. به عنوان مثال، برنامه حلقه های اجتماعی کاربر را بر اساس دوستان شبکه اجتماعی، مخاطبین تلفن، دعوت نامه های تقویم، ایمیل ها و پیام های متنی، تماس های تلفنی مکرر استخراج می کند.
در نهایت، زمینه های استخراج شده از هر سه نوع دستگاه هوشمند را می توان در لایه استدلال زمینه ادغام کرد. مسئولیت اصلی این لایه، ادغام دادههای زمینه اولیه (مثلاً نام فیلم، ورود به جلسه و فعالیت کاربر) برای استنتاج بافت سطح بالا کاربر (به عنوان مثال، ترجیحات در ژانرهای فیلم، دسته معنایی مکانها، و سطوح تحرک) است. با ترکیب منابع مختلف اطلاعاتی برای دستیابی به این هدف، یک موتور قانون طراحی و اعمال می شود. تعریف قواعد مختلف مستلزم دانش پایه ای است که از پیشنهادات کارشناسان در زمینه های مختلف حاصل می شود. به عنوان یک قانون مثال، اگر تعداد گامهای روزانه کاربر بیش از ۱۰۰۰۰ باشد، یا اگر تعداد کل مایلهای جابجا شده بیش از چهار مایل در روز باشد، و ضربان قلب کاربر بین ۱۳۵ تا ۱۵۵ ضربه در دقیقه باشد.https://www.verywellfit.com/target–heart–rate–calculator–۳۸۷۸۱۶۰ )، در این صورت کاربر از تحرک بالایی برخوردار است. سه نمونه از قوانین اعمال شده در لایه استدلال زمینه در جدول ۳ برای استخراج زمینه های سطح بالاتر نشان داده شده است.
حریم خصوصی کاربر یک چالش بزرگ در سیستمهای آگاه از زمینه است. بین کارآیی محاسبات آگاه از زمینه و حفظ حریم خصوصی یک مبادله وجود دارد. فناوری می تواند به به حداقل رساندن مبادلات کمک کند، اما نمی تواند آنها را از بین ببرد. اگرچه استفاده از تکنیک های حفاظت از حریم خصوصی خارج از محدوده این مقاله است، برخی ملاحظات برای محافظت از حریم خصوصی کاربر در به روز رسانی پروفایل های کاربر با استفاده از دستگاه های هوشمند در نظر گرفته شده است. ما از یک رویکرد حافظه محلی برای شناسایی زمینه کاربر و بهروزرسانی نمایه استفاده کردیم. اطلاعات دستگاه های هوشمند کاربر به صورت خصوصی در گوشی کاربر ذخیره می شود. برای به اشتراک گذاری داده های هر دستگاه به صورت محلی، هر سرویس از احراز هویت اولیه استفاده می کند و قوانین خط مشی رازداری کاربر را برای محافظت از داده های کاربر درخواست می کند. از کاربران پرسیده می شود که آیا مایل به ترکیب داده های خود برای دریافت توصیه های شخصی تر هستند یا خیر. به عبارت دیگر، به آنها کنترل کامل داده شده است که چه مقدار از دادههایی که میخواهند در فرآیند توصیهها استفاده شوند. در مرحله بعد، RS به کاربران این امکان را می دهد که اگر مایل به اشتراک گذاری هیچ یک از داده های شخصی خود نیستند، تنظیمات برگزیده خود را در نمایه خود به صورت دستی ویرایش کنند. با این حال، اگر کاربر بخواهد اطلاعات نمایه خود را به صورت خودکار جمعآوری کند، اطلاعات شخصی وی پس از استفاده برای موتور استدلال زمینه برای همیشه حذف میشود. برای مثال، ارتباط با دستگاههای Google Home آنها پس از استخراج ژانرهای فیلم ترجیحی آنها حذف میشود. با استفاده از این روش که یکی از رایج ترین تکنیک ها در برنامه های اجتماعی دانشگاهی و صنعتی (مانند فیس بوک، توییتر) است.
۴٫ موتور تشخیص شباهت کاربر
برای در نظر گرفتن تعاملات اجتماعی در دنیای واقعی و دستگاه های هوشمند، از دو الگوریتم برای گروه بندی کاربران مشابه استفاده می شود. این الگوریتمها به USDE اضافه شدند تا RS پیشنهادی در پرداختن به CSP قدرتمندتر شود. اولین روشی که USDE آگاه اجتماعی را ایجاد می کند، بر اساس قدرت پیوندها در تعاملات اجتماعی کاربران تعریف می شود [ ۴۸ ]. در این مؤلفه، هر دو تعامل اجتماعی ایجاد شده در دنیای واقعی یا شبکه های مجازی به عنوان پارامتر شباهت در نظر گرفته می شوند. روش دوم استفاده از یک الگوریتم خوشه بندی برای شناسایی کاربران مشابه بر اساس زمینه های مختلف در پروفایل کاربران است. برای رویکرد تشخیص شباهت پیشنهادی، قابل ذکر است که اگر تعداد قابل توجهی از افراد داشته باشیم (آستانه ۳۰ نفر در نظر گرفته می شود [ ۴۹ ]]) در حلقه اجتماعی، سپس ترجیح کاربر را می توان بر اساس حلقه اجتماعی او استنباط کرد. در غیر این صورت از روش خوشه بندی برای یافتن کاربران مشابه با علایق مشترک استفاده می شود.
چالش دیگر در اینجا نحوه استفاده از USDE در حین محافظت از حریم خصوصی کاربر است. اگرچه تحقیقات دقیق در مورد حریم خصوصی کاربر باید به ویژه در دستگاه های محدود شده با منابع مانند تلفن های همراه انجام شود، در این مقاله از ناشناس سازی پروفایل کاربر برای حمایت از حریم خصوصی کاربر استفاده کردیم. شناسه و نمایه کاربر با استفاده از رویکرد الگوریتم های هش ایمن (SHA)-512 برای حلقه اجتماعی کاربر به اشتراک گذاشته می شود. USDE از لیستی از پروفایل های کاربر (با لیستی که دائماً به روز می شود) با شناسه های کاربر هش شده در فرآیند ارائه توصیه ها استفاده می کند. با استفاده از تکنیک ناشناس سازی، نمایه های کاربر و حلقه های اجتماعی آنها بدون اطلاعات هویت واقعی کاربران در صورت خوشه بندی شباهت کاربر ارائه می شود. به این ترتیب، هویت آنها در سرور ناشناس باقی می ماند در حالی که پروفایل های کاربری مشابه را می توان در RS پیشنهادی استفاده کرد.
۴٫۱٫ طبقه بندی تعامل اجتماعی
شباهت بین کاربران را می توان با تجزیه و تحلیل تعاملات اجتماعی آنها مانند ایمیل ها، گزارش تماس ها و روابط اجتماعی دو طرفه استخراج شده از SN ها شناسایی کرد. با الهام از السسر و پپلاو [ ۴۸]، تعاملات اجتماعی بین کاربران را می توان به دلیل استحکام پیوندهای موجود در تعاملات اجتماعی آنها به دو دسته مختلف طبقه بندی کرد. دسته اول، تعاملات اجتماعی اولیه (PSIs) نامیده می شود که شامل روابط واقعی بین کاربران مانند برقراری تماس و ارسال یا دریافت پیام و ایمیل می شود. تعداد اعضایی که در گروه کاربران مشابه با PSI قرار می گیرند معمولاً کم است و با تعاملات گسترده و واقعی بین اعضای گروه به طور منظم مشخص می شود. دسته دوم، تعاملات اجتماعی ثانویه (SSIs) نامیده می شود که شامل تعاملاتی می شود که در دنیای مجازی مانند روابط بین کاربران در سایت های شبکه های اجتماعی مانند فیس بوک انجام می شود. کاربران مشابه با SSI را می توان با تعداد اعضای تقریبا بیشتر و تعاملات غیر شخصی و مجازی بیشتر مشخص کرد.
با استفاده از این طبقه بندی، کاربرانی که در دایره اجتماعی کاربر هدف قرار می گیرند را می توان به عنوان گروهی از کاربران مشابه با PSI یا SSI مشاهده کرد. دایره اجتماعی کاربر هدف از لیست مخاطبین گوشی هوشمند کاربر، لیست دوستان کاربر در SN ها، فرستنده ها و گیرندگان ایمیل ها و پیام های متنی ایجاد می شود. دفعات و تعداد دفعاتی که کاربر با کاربر هدف تماس می گیرد می تواند قدرت پیوندهای موجود در تعاملات اجتماعی آنها را مشخص کند. اگرچه تعامل اجتماعی را می توان در تحقیقات آینده بیشتر گسترش داد، در این مقاله، ما تنها دو دسته (یعنی PSI و SSI) را بر اساس مفهوم تماس مکرر در نظر گرفتیم. اگر فردی در حلقه اجتماعی کاربر هدف بیش از یک بار در هفته با او تماس بگیرد. سپس، RS این شخص را به عنوان کاربر دارای PSI با کاربر هدف در نظر می گیرد. پس از برچسب گذاری PSI های کاربر هدف، بقیه حلقه اجتماعی کاربر هدف به عنوان کاربران دارای SSI طبقه بندی می شوند. به عنوان مثال، وضعیتی را در نظر بگیرید که {u1 , u ۲ , u ۳ , u ۴ } به عنوان حلقه اجتماعی کاربر هدف X استخراج می شود. اگر u ۲ سه بار در هفته با کاربر X تماس تلفنی برقرار کرده باشد و u ۳ مرتباً برای کاربر ایمیل ارسال کرده باشد. X هفته گذشته، پس، u ۲ و u ۳ به عنوان PSI کاربر هدف X طبقه بندی می شوند. در حالی که u ۱ و u ۴ به عنوان کاربران دارای SSI برچسب گذاری می شوند.
در این مقاله فرض شده است که شباهت بین کاربر هدف و کاربران دارای PSI بیشتر از شباهت کاربران با SSI است. بدیهی است که توصیه های ارائه شده توسط افرادی که در گروه کاربران مشابه با PSI هستند قابل اعتمادتر از توصیه های ارائه شده توسط گروه کاربران مشابه با SSI در نظر گرفته می شوند. بر اساس این فرض، ما اعتماد به توصیههای ارائه شده توسط گروه کاربران مشابه دارای PSI را دو برابر بیشتر از گروه کاربران مشابه دارای SSI در نظر میگیریم. با این حال، اگر تعداد قابل توجهی (یعنی ۳۰ [ ۴۹ ]) از افراد در حلقه اجتماعی نداشته باشیم، از روش خوشهبندی کاربر استفاده میشود و وزن اعتماد دوباره ۱ در نظر گرفته میشود. از این رو، اوزان اعتماد به شرح زیر در نظر گرفته می شود:
این وزن اعتماد می تواند در محاسبه میانگین رتبه برای کاربر جدید بر اساس سایر کاربران مشابه استفاده شود. وزن اعتماد گروهی از کاربران مشابه دارای PSI برای این مقاله دو برابر بیشتر از گروه کاربران مشابه دارای SSI تنظیم شده است، با این حال، اگر کاربران بخواهند به مخاطبین اجتماعی خود بیش از حد اعتماد داشته باشند، میتوانند این مقدار را تغییر دهند. گروه کاربران مشابه آنها اگر کاربر مورد نظر توتی��دو کاربر دارد تو۱�۱و تو۲�۲در حلقه اجتماعی او از کاربران مشابه با SSI و PSI به ترتیب، تأثیر وزن اعتماد بر توصیه آنها را می توان اندازه گیری کرد. مورد آن کاربر را در نظر بگیرید تو۱�۱و تو۲�۲امتیاز ۴ و ۵ را به آیتم داد من�و وزن اعتماد به جای ۲ برای کاربران دارای PSI، در اینجا کاربر روی ۳ تنظیم شده است تو۲�۲. در این شرایط، توصیه نهایی ۹% نزدیک به امتیاز داده شده توسط کاربر خواهد بود تو۲�۲در مقایسه با وضعیتی که وزن اعتماد برای کاربران دارای PSI بر روی ۲ تنظیم شده است. این مقدار ۶% بیشتر از امتیاز کاربر است تو۲�۲در شرایطی که وزن اعتماد برای کاربران دارای PSI به جای ۲ روی ۱٫۵ تنظیم شده است.
۴٫۲٫ خوشه بندی پروفایل کاربر
انواع مختلفی از ویژگی ها را می توان در نمایه کاربر گنجاند تا کاربر را به عنوان اطلاعات زمینه توصیف کند. هرچه تعداد ویژگی های پروفایل بیشتر باشد، درک بهتری از کاربر خواهد داشت. هنگامی که CSP رخ می دهد، یافتن شباهت های ضمنی بین کاربران تطبیق پروفایل و خوشه بندی کاربر را نشان می دهد. خوشهبندی پروفایل کاربر یک فرآیند تحلیلی است که برای کاوش کاربران با کشف الگوهای ثابت و/یا روابط سیستماتیک بین زمینهها طراحی شده و سپس یافتهها را با اعمال الگوهای شناساییشده در زیرمجموعههای جدید کاربران تأیید میکند. به طور کلی، الگوریتم های خوشه بندی را می توان به روش های پارتیشن بندی، روش های سلسله مراتبی، روش های مبتنی بر چگالی، روش های مبتنی بر شبکه و روش های مبتنی بر مدل دسته بندی کرد. یک بررسی عالی از تکنیک های خوشه بندی را می توان در مطالعه ای که توسط Kameshwaran و همکاران انجام شد یافت. [۵۰ ].
با توجه به مجموعه داده ز= {z1،z2, … ,zپ, … ,zنپ}�={�۱,�۲,…,��,…,���}جایی که zپ��الگویی است در ند��-فضای ویژگی های بعدی و نپ��تعداد الگوهای موجود است ز�، سپس خوشه بندی از ز�پارتیشن بندی است ز�به ک�خوشه ها {ج۱، ج۲, … , جک}{�۱, �۲,…, ��}که شرایط زیر را برآورده می کند:
-
هر الگو باید به یک خوشه کاربری اختصاص داده شود، به عنوان مثال، ∪کj = ۱جj= ز∪�=۱���=�.
-
هر خوشه کاربری حداقل یک الگوی زمینه دارد که به آن اختصاص داده شده است، به عنوان مثال، جک≠ ۰ ، k = ۱ ، … ، K ��≠۰, �=۱, …,�.
-
هر الگوی زمینه به یک و تنها یک خوشه کاربری اختصاص داده می شود، به عنوان مثال، جک∩ c j = ۰ ، w h e r e k ≠ j ��∩��=۰, �ℎ��� �≠�.
خوشهبندی فرآیند شناسایی خوشههای کاربران در دادههای نمایه کاربر چند بعدی (زمینهها) بر اساس فضای ویژگی (یعنی موارد نمایه کاربر) از طریق اندازهگیری شباهت است. محبوب ترین راه برای ارزیابی یک اندازه گیری شباهت از طریق استفاده از اندازه گیری های فاصله است [ ۵۱ ]. پرکاربردترین اندازه گیری فاصله، فاصله اقلیدسی است که به صورت زیر تعریف می شود:
اخیراً افزایش زیادی در استفاده از تکنیک های بهینه سازی مبتنی بر Swarm برای خوشه بندی مشاهده شده است [ ۵۲ ]. Swarm Intelligence یک پارادایم هوشمند توزیع شده ابتکاری برای حل مسائل بهینه سازی است که در اصل از نمونه های بیولوژیکی پدیده های ازدحام، گله و گله داری در مهره داران الهام گرفته شده است [ ۵۳ ]. این تکنیکها شامل رفتارهای ازدحامی مشاهده شده در گلههای پرندگان، گلههای ماهی، دستهای از زنبورها یا حتی رفتار اجتماعی انسان میشود که این ایده از آنها پدید آمد [ ۵۴ ، ۵۵ ، ۵۶ ]. آنها همچنین می توانند به ویژه زمانی که روش های دیگر بسیار گران یا دشوار هستند استفاده شوند [ ۵۷]. برای خوشهبندی دادههای پروفایل کاربر عظیم، از الگوریتم کلونی زنبورهای مصنوعی (ABC) به دلیل پتانسیل آن در حل مسائل پیچیده بهینهسازی، انعطافپذیری، سادگی، خود سازماندهی و توسعهپذیری استفاده کردیم [ ۵۳ ، ۵۸ ]. برای ارزیابی عملکرد ABC، عملکرد آن با K-means به عنوان یک الگوریتم خوشه بندی محبوب در داده کاوی مقایسه می شود [ ۵۱ ].
یک کلنی از زنبورهای عسل می تواند خود را در فواصل طولانی برای بهره برداری از تعداد زیادی از منابع غذایی پخش کند [ ۵۳ ]. فرآیند جستجوی غذا در یک کلنی توسط زنبورهای پیشاهنگی که برای جستجوی تکه های گل امیدوار کننده فرستاده می شوند آغاز می شود. تکههای گل با مقادیر زیادی شهد یا گرده که میتوان با تلاش کمتری جمعآوری کرد، معمولاً توسط زنبورهای بیشتری مورد بازدید قرار میگیرد، در حالی که لکههای با شهد یا گرده کمتر از زنبورها بازدید میکنند [ ۵۷ ]. روش خوشهبندی کلونی ازدحام زنبورهای مصنوعی از قابلیت جستجوی الگوریتم زنبور عسل برای غلبه بر مشکل بهینه محلی استفاده میکند. ک�-الگوریتم معنی به طور خاص، وظیفه آن جستجو برای مراکز خوشه مناسب است ( ج۱�۱، ج۲�۲,…, جک��) به طوری که متریک خوشه بندی د�(۲) به حداقل رسیده است. مراحل اساسی این عملیات خوشه بندی در جدول ۴ آمده است.
در مرحله اولیه سازی (مرحله ۱ در جدول ۴ )، مجموعه ای از جمعیت زنبورهای پیشاهنگ ( n�) به طور تصادفی برای تعریف انتخاب شده است ک�خوشه ها فواصل اقلیدسی بین هر الگوی داده پروفایل کاربر و تمام مراکز برای تعیین خوشه اختصاص داده شده به هر پروفایل کاربر محاسبه می شود. به عنوان مثال، در مورد فیلم RS، آیتم های پروفایل کاربر مانند ژانرهای فیلم و حلقه های اجتماعی برای خوشه بندی در نظر گرفته شده است. به این ترتیب، خوشه های اولیه را می توان ساخت. پس از تشکیل خوشه ها، مراکز خوشه اصلی با مرکزهای واقعی خوشه ها جایگزین می شوند تا راه حل خوشه بندی خاصی تعریف شود. ((یعنی زنبور عسل). این فرآیند اولیه سازی هر بار که زنبورهای جدید ایجاد می شوند اعمال می شود.
در مرحله ۲ از جدول ۴ ، فرآیند محاسبات تناسب اندام برای هر مکان بازدید شده توسط یک زنبور با محاسبه متریک خوشه بندی انجام می شود. د�(۲) که رابطه معکوس با تناسب اندام دارد.
مرحله ۳ مرحله اصلی بهینه سازی کلنی زنبور عسل است که با تشکیل جمعیت جدید شروع می شود (مرحله ۳a). در مرحله ۳b، متر�سایت هایی با بالاترین تناسب اندام به عنوان “سایت های منتخب” تعیین می شوند و برای جستجوی محله انتخاب می شوند. در مراحل ۳c و ۳d، الگوریتم جستجوهایی را در اطراف سایت های انتخاب شده انجام می دهد و زنبورهای بیشتری را برای جستجو در منطقه بهترین ها اختصاص می دهد. ه�سایت های. انتخاب بهترین سایت ها را می توان به طور مستقیم با توجه به تناسب اندام آنها انجام داد. متناوبا، از مقادیر تناسب برای تعیین احتمال انتخاب سایت ها استفاده می شود. جستجو در همسایگی بهترین ها ه�سایتها – آنهایی که امیدوارکنندهترین راهحلها را نشان میدهند – با جزئیات بیشتری انجام میشوند. همانطور که قبلا ذکر شد، این کار با استخدام زنبورهای بیشتر برای بهترین ها انجام می شود ه�سایت ها نسبت به سایر سایت های انتخاب شده. همراه با جستجو، این استخدام افتراقی یک عملیات کلیدی الگوریتم زنبور عسل است. در مرحله ۳d، تنها زنبوری که سایتی را با بالاترین تناسب اندام پیدا کرده است (یعنی “مناسب ترین” زنبور) برای تشکیل بخشی از جمعیت زنبورهای بعدی انتخاب می شود. در طبیعت، چنین محدودیتی وجود ندارد. محدودیت در اینجا برای کاهش تعداد نقاط مورد بررسی معرفی شده است. در مرحله ۳e، زنبورهای باقی مانده در جمعیت به طور تصادفی به فضای جستجو اختصاص داده می شوند تا راه حل های بالقوه جدید را جستجو کنند.
در پایان هر حلقه، کلنی دو بخش برای جمعیت جدید خود خواهد داشت: نمایندگانی از سایت های انتخاب شده، و زنبورهای پیشاهنگی که برای انجام جستجوهای تصادفی تعیین شده اند. این مراحل تا زمانی که معیار توقف برآورده شود تکرار می شود.
هر زنبور یک راه حل بالقوه خوشه بندی شباهت کاربر را به عنوان مجموعه ای از نشان می دهد ک�مراکز خوشه، و هر سایت نشان دهنده الگوها یا اشیاء داده پروفایل کاربر است. این الگوریتم نیاز به تنظیم چند پارامتر دارد، به عنوان مثال: تعداد زنبورهای پیشاهنگ ( n�)، تعداد سایت های انتخاب شده برای جستجوی محله ( m�)، تعداد دارای رتبه برتر ( elite�����) سایت ها در میان m�سایت های منتخب ( e�)، تعداد زنبورهای انتخاب شده برای بهترین ها e�سایت های ( n e p���تعداد زنبورهای استخدام شده برای دیگری ( متر�) سایت های منتخب ( n s p���) و معیار توقف برای حلقه. در جدول ۵ ، فهرستی از مقادیر اولیه پارامترها ارائه شده است.
برای مجموعه داده کاربر ارائه شده ( بخش ۶ )، هر یک از ABC و ک�الگوریتم -means 30 بار به صورت جداگانه برای یک راه حل اولیه تصادفی اعمال می شود. پارامترهای همه الگوریتم ها مطابق جدول ۵ تنظیم شده است. مجموع فواصل درون خوشه ای، یعنی فاصله بین بردارهای داده در یک خوشه و مرکز این خوشه، همانطور که در (۲) تعریف شده است، برای اندازه گیری کیفیت یک خوشه استفاده می شود. واضح است که هر چه مجموع فواصل کمتر باشد، کیفیت خوشه بندی بالاتر است. اثربخشی الگوریتم های تصادفی تا حد زیادی به تولید راه حل های اولیه بستگی دارد. برای هر مجموعه داده، الگوریتمها آزمایشهای اثربخشی خود را ۳۰ بار به صورت جداگانه انجام دادند، هر بار با راهحلهای اولیه بهطور تصادفی تولید شده بودند. مقادیر گزارششده میانگینهای مجموع فواصل درون خوشهای و مقادیر تناسب بدترین و بهترین راهحلها هستند که میتوانند دامنه مقادیری را که الگوریتمها در بر میگیرند نشان دهند. جدول ۶فواصل درون خوشه ای و زمان عملکرد روی سرور به دست آمده از همه الگوریتم های مجموعه داده های بالا را خلاصه می کند.
از مقادیر جدول ۶ می توان نتیجه گرفت که نتایج به دست آمده توسط ABC بهتر از یک ک�-به معنای الگوریتم خوشه بندی در هر دو دقت و میانگین زمان (تعداد مراحل تکرار). توزیع نمونه در خوشه بندی کاربر توسط الگوریتم ABC در شکل ۳ نشان داده شده است که در آن نمودارهای خوشه دایره اجتماعی با خطوط نشان داده شده است. همانطور که از شکل ۳ مشاهده می شود ، سرهای خوشه به طور یکنواخت توسط الگوریتم ABC انتخاب می شوند، مشروط بر اینکه خوشه ها دارای مناطقی با اندازه تقریبا برابر باشند.
۵٫ الگوریتم پیشنهادی پیشنهادی
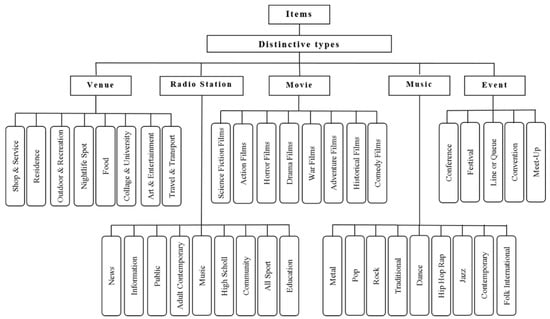
در RS پیشنهادی، دو فضا شامل مجموعه کاربر و آیتم تعریف شده است. اجازه دهید مجموعه کاربر را به عنوان در نظر بگیریم U= {تو۱،تو۲, … ,توn}�={�۱,�۲,…,��}و مورد به عنوان تنظیم شود من= {من۱،من۲, … ,منمتر}�={�۱,�۲,…,��}. تشخیص شباهت بین آیتم ها و کاربران و گروه بندی آیتم ها و کاربران را می توان از کارهای اساسی در نظر گرفت که باید در یک RS انجام شود. در فضای آیتم می توان با در نظر گرفتن ویژگی های توصیفی سلسله مراتبی آنها، کلاس هایی از اقلام مشابه را به صورت ایستا ایجاد کرد. روش طبقه بندی اعمال شده برای طبقه بندی موارد مشابه در شکل ۴ به عنوان یک درخت سلسله مراتبی نشان داده شده است.
برای الگوریتم پیشنهادی پیشنهادی، ما پنج زیر مجموعه مختلف ناهمگن از آیتمها را در مجموعه آیتمهای اصلی شامل فیلمها، مکانها، رویدادها، موسیقی و ایستگاههای رادیویی در نظر میگیریم. بنابراین ترکیب تمامی زیر مجموعه ها به صورت زیر بیان می شود:
که در آن، i ∈ { ۱ , ۲ , … , ۵ }�∈{۱, ۲, …,۵}و منمن��همه موارد را با یک برچسب خاص تعریف کنید من�مانند فیلم، مکان، موسیقی، رویداد و مجموعه ایستگاه های رادیویی. علاوه بر این، متر�تعداد آیتم ها را در یک زیر مجموعه خاص مشخص می کند. اگر سرویس پیشنهادی اقلام فیلم را در نظر بگیریم، همه متر�آیتم های قرار داده شده در مجموعه فیلم بر اساس ژانرهایشان در هشت دسته مختلف طبقه بندی می شوند که در شکل ۴ نشان داده شده است. اگر به صراحت ژانر فیلمی را که برای کاربر هدف جالب است تشخیص دهیم، از الگوریتم توصیهکننده CF برای توصیه به کاربر هدف استفاده میشود. ک�-فیلم های با رتبه بالا در ژانر مورد نظر. اجازه دهید این را در نظر بگیریم ک�-لیست با رتبه بالا از فیلم های پیشنهادی به عنوان ماتریس، آرk × ۱��×۱. با توجه به افرادی که در حلقه اجتماعی کاربر هدف قرار دارند من�به عنوان مجموعه ای که توسط نمن= {توjمن∣∣ j = ۱ , ۲ , … , l ; i ≠ j a n d توj∈ U}��={���| �=۱,۲,…,�;�≠� ��� ��∈�}. با استفاده از رتبه بندی آنها برای آیتم ک�، یک ماتریس رتبه بندی همسایه به صورت زیر تعریف می شود:
که در آن rj kمن����رتبه بندی در نظر گرفته شده برای آیتم است ک�توسط کاربر j�که بخشی از حلقه کاربر مشابه کاربر است من�. برای RS پیشنهادی، اگر تعداد قابل توجهی از افراد داشته باشیم (آستانه ۳۰ نفر [ ۴۹ ] در نظر گرفته می شود) در حلقه اجتماعی، حلقه اجتماعی برای ارزیابی شباهت کاربر استفاده می شود. در غیر این صورت از روش خوشه بندی کاربر برای یافتن کاربران مشابه با علایق مشترک استفاده می شود.
بدیهی است که توصیه های ارائه شده توسط افرادی که در گروه کاربران مشابه با PSI هستند قابل اعتمادتر از توصیه های ارائه شده توسط گروه کاربران مشابه با SSI در نظر گرفته می شوند. بر اساس وزن اعتماد (۱)، رتبه بندی میانگین بر اساس اعتماد برای آیتم ک�تعریف شده است r“ک��′مانند:
جایی که ωj��وزن اعتماد برای کاربر است j�بر اساس (۱). پس از محاسبه میانگین رتبه برای همه موارد، موارد ترجیحی مرتب می شوند. توصیه موارد تکراری که کاربران قبلاً با آنها تعامل داشته اند، توصیه های ناکارآمد در نظر گرفته می شود [ ۵۹ ]. به عنوان مثال، اگر کاربر مورد نظر قبلاً فیلمی را تماشا کرده باشد، توصیه کردن همان فیلم بی اثر است. برای غلبه بر این مشکل، یک مکانیسم پس پردازش مبتنی بر اطلاعات تاریخی را برای حذف موارد تکراری در نظر می گیریم. اگر کاربر قبلاً فیلمی را تماشا کرده باشد، این اطلاعات در پایگاه داده ذخیره می شود. پس از آماده سازی ک�-توصیه های با رتبه بالا، ما لیست توصیه ها را با اطلاعات تاریخی موجود در پایگاه داده مقایسه می کنیم. برای مورد تکراری، آن را با توصیه با رتبه بالا جایگزین می کنیم.
نمونه هایی از سناریوهای چالش برانگیز
در سناریوی اول، وضعیتی را در نظر بگیرید که کاربر هیچ اولویت صریحی در رابطه با ژانرهای فیلم ندارد یا کاربر برای اولین بار در RS ما ثبت نام می کند. این بدان معناست که دادههای جمعآوریشده توسط شبکه شخصی کاربر بهصراحت ترجیحات کاربر را بیان نمیکند. این مشکل به طور گسترده ای به نام CSP شناخته می شود. در این شرایط به جای تکیه بر ترجیحات صریح کاربر، محتمل ترین گزینه ترجیحی از حلقه اجتماعی کاربر استخراج می شود. شایان ذکر است که عملکرد RS های پیشنهادی ما تنها به داده های استخراج شده از SN ها بستگی ندارد. تعاملات اجتماعی بین کاربران را می توان از تعامل اجتماعی آنها در SN (یعنی کاربران دارای SSI) یا تعاملات اجتماعی در دنیای واقعی آنها (یعنی کاربران با PSI) استخراج کرد. هدف ما این است که میانگین ترجیحات حلقه اجتماعی کاربر هدف برای هر دسته از ژانرهای فیلم را پیدا کنیم. اگر دایره اجتماعی کاربر هدف من�به صورت نشان داده شده است نمن��، ترجیحات شخصی آنها از نمایه های پویا استخراج می شود. همانطور که در شکل ۴ مشاهده می شود ، هشت ژانر مختلف فیلم وجود دارد. بنابراین، ماتریس ترجیح کاربر را تعریف می کنیم پنمن���به شرح زیر است:
که در آن g= { ۱ , ۲ , … , ۸ }�={۱, ۲,…, ۸}تعداد ژانرهای فیلم از جمله فیلم های اکشن، ترسناک، جنگی، درام، ماجراجویی، کمدی و تاریخی را مشخص می کند. توجه داشته باشید که پمنj���یک شاخص عددی است که نشان می دهد آیا کاربر j�به ژانر فیلم علاقه مند است من�یا نه. با در نظر گرفتن هر دو گروه کاربران مشابه با PSI و SSI، میتوانیم معیار اعتماد مشابهی را برای محاسبه ترجیح میانگین وزنی به صورت زیر اعمال کنیم:
که در آن ωj��وزن اختصاص داده شده به کاربر را نشان می دهد j�با استفاده از (۱) و پ“g��′میانگین وزنی ترجیح همه کاربران اجتماعی برای ژانر فیلم را نشان می دهد g�. پس از محاسبه ماتریس اولویت میانگین وزنی پ“من��′برای کاربر هدف من�، سپس می توانیم ژانری را که بیشترین اولویت را دارد شناسایی کنیم. در مرحله بعد، ما این ژانر کاوششده را بهعنوان ژانر ترجیحی بیشتر کاربر در نظر میگیریم و میانگین وزنی رتبهبندی موارد مرتبط با این ژانر خاص را محاسبه میکنیم. در نهایت، از الگوریتم توصیهکننده پیشنهادی برای ارائه کاربر هدف استفاده میکنیم من�با ک�فیلم های با رتبه بالا شایان ذکر است که فرآیند توصیه با استفاده از تنظیمات میانگین برای رویارویی با مشکل شروع سرد راه اندازی می شود. با این حال، نمایه کاربر پویا است و میتواند با اولویتهای جدید استخراجشده توسط موتور استدلال زمینه بهروزرسانی شود. به عنوان مثال، هنگامی که کاربر هدف به صراحت علاقه خود را به یک ژانر فیلم خاص نشان می دهد، اطلاعات جدید در فرآیند توصیه استفاده می شود.
برای سناریوی دوم، به عنوان چالش برانگیزترین سناریوی موجود CSP، وضعیتی را در نظر بگیرید که هیچ یک از افراد در دایره اجتماعی کاربر هدف من�هیچ اولویت صریحی با توجه به حوزه فیلم ها ندارند. اگرچه احتمال وقوع چنین وضعیتی ناچیز است، اما سیستم ما می تواند این مشکل را نیز برطرف کند. در این شرایط، هیچ راهی برای استخراج ترجیحات احتمالی کاربر با توجه به منطقه فیلم وجود ندارد. خوشه بندی کاربران مشابه بر اساس نمایه های آنها با استفاده از رویکرد ABC می تواند این مشکل را برطرف کند. بنابراین، افراد در یک خوشه با کاربر هدف قرار می گیرند من�لزوماً افراد حلقه اجتماعی او نیستند. این بدان معنی است که دایره اجتماعی تعامل بین افراد را تعریف می کند، در حالی که افرادی که در یک خوشه قرار می گیرند چنین تعامل و شباهتی ندارند. به عبارت دیگر، ما ABC را برای خوشه بندی همه کاربران بر اساس شباهت های ضمنی آنها از نظر اطلاعات متنی استخراج شده از پروفایل های کاربر پویا اعمال کردیم. ادغام خوشه بندی کاربر ABC در USDE می تواند به عنوان یک راه حل جایگزین برای پرداختن به CSP در شرایطی در نظر گرفته شود که هیچ اطلاعاتی وجود ندارد که به طور صریح اولویت های کاربر را برای شروع فرآیند توصیه بیان کند. پس از شناسایی کاربران مشابه، می توانیم با این سناریو به روشی مشابه سناریوی اول برخورد کنیم.
۶٫ آزمایش ها و نتایج
برای ارزیابی عملکرد RS پیشنهادی، پس از توصیف مجموعه دادهها و دادههای ارائهشده توسط دستگاههای هوشمند کاربر، RS پیشنهادی را در مقایسه با دو الگوریتم توصیهگر دیگر مورد ارزیابی قرار میدهیم. در نهایت، CSP برای بررسی توانایی USDE پیشنهادی در سناریوهای مختلف در نظر گرفته میشود.
۶٫۱٫ به روز رسانی نمایه کاربر
داده های مورد استفاده برای این تحقیق از منطقه جزیره منهتن واقع در شهر نیویورک (NYC) جمع آوری شده و شامل شش منبع داده است که در جدول ۷ توضیح داده شده است. مجموعه داده ها برای حذف داده های پرت و نامربوط نیاز به پاکسازی و پیش پردازش داشتند [ ۶۰ ]. ستون های داده های نامربوط برای کاهش ابعاد داده نادیده گرفته شدند و تنها ویژگی های مرتبط از مجموعه داده های موجود انتخاب شدند [ ۶۰ ].
مجموعه داده های شرح داده شده در جدول ۷ مجموعه داده های همه منظوره در نظر گرفته می شوند که برای ارزیابی عملکرد فیلم پیشنهادی RS و USDE استفاده خواهند شد. مجموعه داده های مختلف در این مقاله را می توان به دو دسته اصلی طبقه بندی کرد. دسته اول توسط گوشی های هوشمند برای استخراج زمینه های دلخواه جمع آوری می شود که به اصطلاح مجموعه داده های مرتبط با زمینه نامیده می شود. سپس از این زمینه ها برای به روز رسانی پروفایل های کاربر استفاده می شود. دسته دوم در پایگاه داده ابری به عنوان اطلاعات فراداده، به اصطلاح مجموعه داده های متا، ذخیره می شود.
۶٫۱٫۱٫ مجموعه داده های مرتبط با زمینه
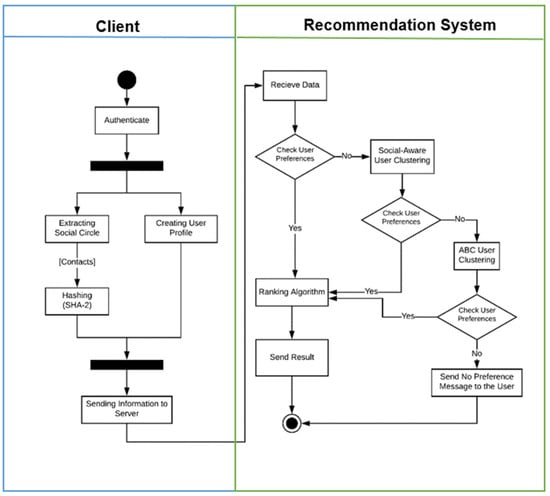
اولین مجموعه داده توسط گوشی های هوشمند جمع آوری شده است. یک اپلیکیشن موبایل اندرویدی توسعه یافته است. در مجموع از ۱۵۰ کاربر به نام “کاربران اپلیکیشن” خواسته شد تا اپلیکیشن توسعه یافته را بر روی تلفن همراه خود نصب کرده و در سامانه ثبت نام کنند. آنها می توانند با استفاده از آدرس ایمیل، ترکیبی از نام و نام خانوادگی یا شماره تلفن خود در سیستم ثبت نام کنند. همانطور که در شکل ۵ مشاهده میشود ، برنامه توسعهیافته عمدتاً وظیفه جمعآوری دادهها، استخراج آیتمهای نمایهای که ترجیحات کاربران را توصیف میکنند، و استخراج حلقههای اجتماعی آنها است. در مرحله بعد اطلاعات هویتی تمامی کاربران در دایره اجتماعی کاربر اپلیکیشن با استفاده از الگوریتم های هش ایمن (SHA)-512 هش می شود و در نهایت یک پیلود JSON به RS ارسال می شود.
در این آزمایش ۶۳ نفر از کاربران اپلیکیشن از بلندگوهای هوشمند گوگل هوم خود استفاده کرده اند. این مجموعه داده، به عنوان مجموعه داده دوم، از ارتباطات کاربران با بلندگوی هوشمند Google Home شخصی آنها تشکیل شده است. پلت فرم My Google Activity ( https://myactivity.google.com/myactivity) فضای ذخیرهسازی ابری Google است که به کاربران کمک میکند تا ترجمههای ارتباط خود را با دستیاران Google خود از جمله بلندگوهای هوشمند Google Home دوباره کشف کنند. ما ۵۶۷۶۹ ردیف اطلاعات را از ۰۱ ژوئیه ۲۰۱۸ تا ۳۰ اوت ۲۰۱۸ از دادههای ارائه شده توسط دستگاههای Google Home استخراج کردیم. علاوه بر این، ۱۳۵ نفر از کاربران اپلیکیشن از ساعت های هوشمند خود استفاده کرده اند. این مجموعه داده، به عنوان مجموعه داده سوم، سپس توسط برنامه توسعه یافته پردازش می شود تا زمینه های مورد نظر مانند سطح تحرک را استخراج کند. در این تحقیق، APIهای Google Fit ( https://developers.google.com/fit) برای دسترسی به داده های تاریخی ارائه شده توسط پوشیدنی های هوشمند جفت شده با دستگاه های Android استفاده می شود. در مجموع ۷۸۳۲ ردیف اطلاعات از ساعتها/بندهای هوشمند کاربران استخراج شده است که شامل ویژگیهای متنوعی از کل کالری سوزانده شده تا ضربان قلب متوسط است. جزئیات بیشتر در مورد داده های جمع آوری شده از ساعت های هوشمند و بلندگوها در جدول ۷ آورده شده است. سپس یک موتور قانون برای استخراج اطلاعات زمینهای مانند فعالیتهای کاربر از دادههای جمعآوریشده توسط ساعتها/باندهای هوشمند اعمال میشود.
خدمات مختلفی در اپلیکیشن موبایل پیشنهادی برای استخراج حلقه اجتماعی کاربر توسعه داده شده است. مجموعه داده حلقه اجتماعی، به عنوان چهارمین مجموعه داده، شامل کاربرانی می شود که یا در لیست مخاطبین تلفن هوشمند کاربر، سابقه گزارش تماس، یا از شبکه های اجتماعی استخراج شده اند (به عنوان مثال، فیس بوک با استفاده از Facebook API [ ۶۱ ]). ما با استفاده از Graph API 2,813,940 پیوند اجتماعی بین ۱۸۹,۱۰۶ کاربر استخراج کردیم [ ۶۱]. این گروه از کاربران «کاربران تماس» نامیده می شوند. به عنوان مثال، اگر کاربر “X” برنامه تلفن همراه را نصب کرده باشد، به این کاربر، کاربر برنامه گفته می شود. به عنوان مثال، کاربر “X” ممکن است مخاطبی مانند “John W: +1 (123) 456-1111” در لیست مخاطبین خود داشته باشد. بنابراین، “John W” به عنوان کاربر مخاطب برای کاربر برنامه “X” شناخته می شود. شایان ذکر است که کاربران موظفند به اپلیکیشن اندروید اجازه دسترسی به هر یک از سرویس های فوق الذکر از فعالیت های گوگل تا داده های ذخیره شده داخلی در گوشی های هوشمند خود را بدهند. در این آزمایش، مجموعاً ۱۸۹۱۰۶ کاربر (شامل ۱۵۰ کاربر اپلیکیشن و ۱۸۸۹۵۶ کاربر مخاطب) با استفاده از اپلیکیشن موبایل پیشنهادی بر روی تلفن همراه تمامی ۱۵۰ کاربر اپلیکیشن استخراج شدند.
مجموعه دادههای Google Home و ساعت هوشمند برای ایجاد و بهروزرسانی نمایه کاربر استفاده میشوند. به عبارت دیگر، آیتم های نمایه به کاربران برنامه اختصاص داده می شود و سپس یک بار JSON شامل نمایه کاربر و حلقه اجتماعی وی توسط کاربران برنامه ارسال می شود. همانطور که کاربر برنامه برای توصیه فیلم درخواست می کند، لیستی از اطلاعات هش شده حلقه اجتماعی کاربر و همچنین اطلاعات پروفایل به روز شده وی به سرور ارسال می شود. سه کلید مختلف برای ایمن کردن هویت کاربر با استفاده از الگوریتم های هش ایمن (SHA)-512 استفاده شده است. این کلیدها می توانند «نام +» «+ نام خانوادگی»، «شماره تلفن» و «آدرس ایمیل» باشند. به عنوان مثال، کاربر “X” به عنوان یک کاربر برنامه ممکن است یک کاربر مخاطب در لیست تماس تلفن هوشمند خود مانند “Y: +1 587 664 XXXX” داشته باشد. در این مورد، هر دو “نام + ‘ ‘ + نام خانوادگی” و “شماره تلفن” به طور جداگانه با استفاده از تابع هش SHA-512 هش می شوند. علاوه بر این، کاربر “Y” به عنوان مثال با استفاده از شماره تلفن خود در سیستم ثبت نام کرد. بنابراین شماره تلفن وی هش می شود و به عنوان شناسه کاربری به کاربر اختصاص می یابد. این شناسه کاربری برای هرگونه ارتباط بیشتر با سرور به کاربر “Y” اشاره دارد. از آنجایی که اطلاعات هویت کاربر “Y” (یعنی شماره تلفن او) با استفاده از عملکرد SHA-512 یکسان در هر دو گوشی هوشمند هش می شود، شناسه کاربری در هر دو مجموعه داده یکسان خواهد بود. پایگاه داده ابری به گونه ای طراحی شده است که وقتی اطلاعات کاربر به ابر ارسال می شود، ابتدا اطلاعات هش شده یکسانی را در هر سه کلید مختلف جستجو می کند. اگر همان اطلاعات هش شده را در هر یک از آن سه کلید پیدا کند، کاربر جدیدی ایجاد نمی کند و فقط اطلاعات را به روز می کند. در غیر این صورت یک کاربر جدید ایجاد می کند و اطلاعات را برای این کاربر ذخیره می کند. استفاده از الگوریتم فوق تضمین می کند که هویت کاربران در پایگاه داده ابری ناشناس باقی می ماند. علاوه بر این، تا زمانی که اطلاعات هش شده آنها یکسان باشد، سیستم می تواند دو یا چند کاربر را به عنوان یک کاربر در بارهای مختلف JSON شناسایی کند.
۶٫۱٫۲٫ مجموعه داده های متا
پنجمین منبع داده توسط Foursquare LBSN ( https://foursquare.com/ ) گردآوری شد. این مجموعه داده با استفاده از مجموعه دادهها برای ورود کاربران در نیویورک طی یک دوره تقریباً ۱۰ ماهه بین ۱۲ آوریل ۲۰۱۲ تا ۱۶ فوریه ۲۰۱۳ ایجاد شده است [ ۱۰ ]. اگرچه این مجموعه داده از اطلاعاتی مانند شناسه کاربر، شناسه مکان و زمان جهانی هماهنگ (UTC) تشکیل شده است، اما برای همه ورودها، ما فقط نام، دسته معنایی و مختصات GPS مکانها را به عنوان اطلاعات مرتبط در نظر گرفتیم. به عبارت دیگر، این مجموعه داده حاوی ابرداده مکانهای واقع در نیویورک است. در نهایت، مجموعه داده فیلم به عنوان ششمین مجموعه داده، از پایگاه اینترنتی فیلم های اینترنتی (IMDb ( https://www.imdb.com/ ) استخراج شد.)) در ژوئن ۲۰۱۸٫ اگرچه این مجموعه داده همه فیلمهای قرن گذشته را پوشش میدهد، تنها فیلمهایی انتخاب شدند که بین سالهای ۲۰۱۶ تا ۲۰۱۸ اکران شدهاند. این پایگاه داده به صورت رایگان در [ ۶۲ ] موجود است و دارای ویژگیهای مختلفی مانند عنوان_فیلم، نام(های) کارگردان، ژانرها، زبان، کشور، سال، نام_بازیگر، نام_بازیگر_۲_نام، نام_بازیگر، و میانگین رتبهبندی کاربران است. به عبارت دیگر، این مجموعه داده حاوی ابرداده فیلم ها است.
اطلاعات نمایه فقط برای کاربران برنامه با استفاده از تلفن همراه خود استخراج و به روز می شود. بنابراین، بدیهی است که هیچ اطلاعات نمایه ای با توجه به بیشترین کاربران تماس در پایگاه داده ابری وجود ندارد. ما از کلمه “بیشترین” استفاده کردیم زیرا برخی از کاربرانی که در دایره اجتماعی کاربران برنامه هستند، کاربران برنامه نیز هستند. به عنوان مثال، “سارا” “استیو” را در حلقه اجتماعی خود دارد. “Steve” یک کاربر برنامه نیز هست. نمایه استیو باید به عنوان کاربر مخاطب در حلقه اجتماعی سارا خالی باشد. با این حال، پروفایل استیو خالی نیست زیرا او در عین حال کاربر اپلیکیشن است.
برای پر کردن اطلاعات نمایه خالی کاربران مخاطب از نظر ترجیحات آنها در ژانرهای فیلم، سایر مجموعه دادههای در دسترس عموم به عنوان مجموعه دادههای متا استفاده میشوند. این مجموعه داده برای پر کردن اطلاعات پروفایل خالی با داده های واقعی استفاده می شود. این مجموعه داده، «مجموعه داده فیلم» نام دارد ( https://www.kaggle.com/rounakbanik/the–movies–dataset) شامل ۲۶ میلیون امتیاز از ۲۷۰۰۰۰ کاربر برای ۴۵۰۰۰ فیلم IMDB و استخراج شده از وب سایت رسمی GroupLens. یک شناسه منحصر به فرد تصادفی بین ۱ تا ۱۸۸۹۵۶ به هر یک از کاربران مخاطب که هیچ اطلاعاتی برای نشان دادن ترجیحات خود در ژانرهای فیلم ندارند اختصاص داده می شود. سپس، تمام فیلمهای رتبهبندیشده در «مجموعه دادههای فیلم» استخراج میشوند که در آن شناسه کاربری برابر با شناسه کاربری منحصربهفرد اختصاص داده شده بهصورت تصادفی برای کاربران مخاطب است. دومین متا مجموعه داده، مجموعه داده ورود کاربران Foursquare (یعنی مجموعه داده های Foursquare) است. فرآیند مشابهی برای پر کردن اطلاعات ورود کاربران برای کاربران تماسی که هیچ اطلاعاتی مبنی بر نمایش اطلاعات ورود آنها ندارند، انجام خواهد شد. با انجام این دو روش، فرض بر این است که اطلاعات نمایه برای کاربران مخاطب با استفاده از داده های واقعی استخراج شده از وب سایت رسمی GroupLens و Foursquare LBSN پر می شود. در نهایت، MySQL به عنوان یکی از محبوب ترین سیستم های مدیریت پایگاه داده رابطه ای منبع باز برای ذخیره داده های جمع آوری شده انتخاب شده است.۲۶ ]. اطلاعات دقیق در مورد مجموعه داده هایی که در این مطالعه استفاده شده است در جدول ۷ خلاصه شده است.
۶٫۲٫ ارزیابی سیستم پیشنهادی پیشنهادی
برای اثبات عملکرد RS پیشنهادی، ما RS خود را با دو مورد از رایجترین الگوریتمهای توصیهگر مقایسه کردیم: CF مبتنی بر رتبهبندی و CF مبتنی بر آیتم. همانطور که در جدول ۸ مشاهده میشود ، برای ارزیابی کیفیت توصیههای فیلم، ۱۰۸۰ کاربر که حداقل ۳۰ فیلم را رتبهبندی کردهاند، از پایگاه داده با هدف عمومی که در بخش ۶٫۱ شرح داده شده است، انتخاب شدند . این شرط نمونه برای انتخاب کاربرانی که حداقل ۳۰ فیلم را رتبه بندی کرده اند برای اجتناب از CSP استفاده می شود. تأثیر CSP موجود در بخش ۶٫۳ بررسی خواهد شد .
برای ارزیابی RS های مختلف، از پنج معیار استفاده کردیم که عبارتند از: میانگین خطای مطلق (۱۰)، میانگین خطای مطلق نرمال شده (۱۱)، دقت (۱۲)، یادآوری (۱۳) و معیارهای بین تنوعی (۱۴) [ ۱۳ ] همانطور که در جدول توضیح داده شده است. ۹ . بیایید توصیه های فیلم را به عنوان یکی از خدمات ارائه شده در نظر بگیریم. سپس می توانیم نشان دهیم k�بهترین فیلم های توصیه شده به کاربر j�توسط Rj��، Mj��به عنوان زیرمجموعه ای از موارد فیلم که قبلاً توسط کاربر هدف رتبه بندی شده است j�در مجموعه اعتبارسنجی، با |A||�|به عنوان اصلی بودن مجموعه A�. فرض کنید M مجموعهای از جفتهای کاربر- آیتم باشد که الگوریتم توصیهگر برای آنها پیشبینی کرده است.
اعتبار سنجی متقاطع یکی از رایج ترین تکنیک های مورد استفاده برای ارزیابی و مقایسه عملکرد الگوریتم های مختلف است [ ۶۴ ]. برای این مطالعه، کیفیت الگوریتم پیشنهادی پیشنهادی، CF مبتنی بر آیتم، و CF مبتنی بر رتبهبندی با تکنیک اعتبارسنجی متقاطع پنج برابری ارزیابی میشود. در این تکنیک، داده های نمونه به زیر مجموعه های مکمل (که در اینجا برابر با پنج است) تقسیم می شوند [ ۶۵ ]. سپس الگوریتم توصیهگر تحلیل خود را بر روی آن انجام میدهد k−۱�−۱مجموعه آموزشی، که به دنبال آن تجزیه و تحلیل اعتبار سنجی بر روی زیر مجموعه باقیمانده دیگر انجام می شود. به عنوان یک قاعده [ ۶۶ ]، اندازه مجموعه اعتبارسنجی باید کمتر از اندازه مجموعه آموزشی باشد. از این رو، ما به ترتیب از ۲۰% و ۸۰% استفاده کردیم. مجموعه داده نمونه ما به هم ریخته و به پنج مجموعه با اندازه مساوی تقسیم شد، S1�۱، S2اس۲، S3اس۳، S4اس۴، و S5اس۵. سپس هر یک از زیرمجموعه های ذکر شده برای تست عملکرد RS در پنج دور قرار گرفتند. پس از پنج دور، پنج نتیجه محاسبه شده برای تولید یک تخمین واحد به طور میانگین محاسبه شدند. به عبارت دیگر، میانگین نتیجه، نتیجه جمع آوری شده از تمام پنج برابر خواهد بود.
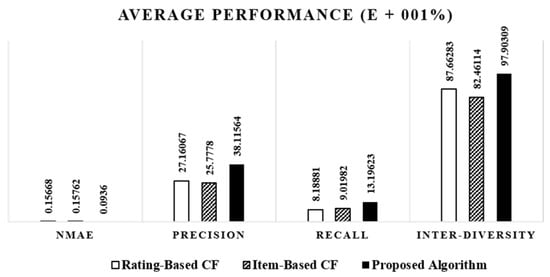
روش اعتبارسنجی متقابل پنج برابری برای ارزیابی RS پیشنهادی استفاده میشود. مجموعه کاربری به طور تصادفی به پنج زیر مجموعه مجزا از ۲۱۶ کاربر تقسیم می شود. برای هر دور، همه کاربران یکی از آن زیر مجموعه ها برای ارزیابی انتخاب می شوند. مقدار متوسط برای تمام پنج دور در اعتبارسنجی متقاطع پنج برابری، عملکرد تخمینی سیستم توصیهکننده است. میانگین نتایج استفاده از اعتبارسنجی متقابل پنج برابری برای ارزیابی عملکرد الگوریتم پیشنهادی، CF مبتنی بر آیتم و CF مبتنی بر رتبه بندی در مورد ۱۰ توصیه فیلم در شکل ۶ نشان داده شده است.
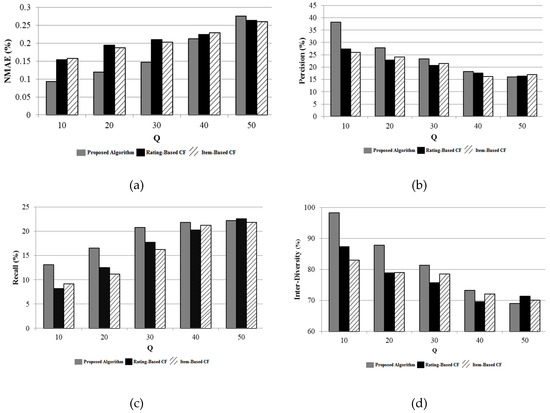
طول لیست توصیه ها نقش مهمی در تحلیل عملکرد ایفا می کند [ ۱۳ ]. در این مقاله، ما عملکرد هر سه RS (یعنی الگوریتم پیشنهادی، CF مبتنی بر آیتم، و CF مبتنی بر رتبهبندی) را با تعداد متفاوتی از آیتمهای پیشنهادی ارزیابی میکنیم (یعنی، Qس). تعداد موارد موجود در لیست توصیه ها از ده تا ۵۰ مورد با فواصل ده متغیر است. شکل ۷ a-c مقایسه دقت بین سه RS را نشان می دهد.
شکل ۷a نشان می دهد که چگونه الگوریتم پیشنهادی NMAE بهتری را زمانی که تعداد موارد توصیه شده کمتر از ۳۰ مورد است به دست می آورد. اگرچه افزایش تعداد موارد توصیه شده منجر به کاهش دقت الگوریتم پیشنهادی ما می شود، دقت الگوریتم پیشنهادی تفاوت قابل توجهی با الگوریتم دیگر ندارد. دو روش ما معتقدیم که دلیل اصلی این کاهش تدریجی دقت الگوریتم پیشنهادی ما در استفاده از ویژگیهای شخصیشدهتر برای یافتن کاربران مشابه است. به عبارت دیگر، وقتی ویژگی های شخصی سازی شده کاربر بزرگتر می شود، تعداد کاربران مشابه شناسایی شده کاهش می یابد. از سوی دیگر، تعداد مورد نظر بیشتر از موارد توصیه، مستلزم یافتن کاربران بیشتری مشابه کاربر هدف است. اگرچه استفاده از ویژگیهای توصیفی شخصیشدهتر برای یافتن کاربران مشابه منجر به سطح بالاتری از شخصیسازی میشود، شناسایی تعداد بیشتری از جمعیت کاربران مشابه نیز دشوارتر است. از این رو با افزایش تعداد موارد مورد انتظار در لیست توصیه ها، دقت روش پیشنهادی به تدریج کاهش می یابد. از آنجایی که هر دو CF مبتنی بر آیتم و مبتنی بر رتبه از یک رویکرد برای شناسایی کاربران مشابه پیروی می کنند، ارزش NMAE برای هر دو مشابه است.شکل ۷ b-c نشان می دهد که دقت الگوریتم پیشنهادی پیشنهادی ما بهتر از سایرین برای زمانی است که Q≤۳۰س≤۳۰. بهترین مقادیر دقت و فراخوان زمانی است که تعداد مورد نظر توصیه شده ده مورد باشد. در این حالت می توان نتیجه گرفت که سه روش حداکثر اختلاف را در دقت خود نشان می دهند. علاوه بر ارزیابی دقت سه RS، شکل ۷ d سطح شخصی سازی RS ها را نشان می دهد. شکل ۷ d نشان می دهد که روش پیشنهادی شخصی ترین توصیه ها را برای کاربران مختلف ارائه می دهد.
۶٫۳٫ ارزیابی USDE پیشنهادی تحت CSP
آزمایشات قبلی در شرایطی انجام شده است که در فرآیند ارزیابی مشکل شروع سرد وجود نداشته باشد. برای مثال، اجازه دهید به وضعیتی نگاه کنیم که در آن سه کاربر در RS پیشنهادی ما وجود دارد، Aآ، Bب، و Cسی. ترجیحات آنها در فیلم ها به وضوح شناسایی شده و در نمایه کاربری آنها مطابق با موارد ذکر شده در جدول ۱۰ ذخیره می شود. در این شرایط، هر سه RS میتوانند لیستی از توصیههای فیلم را برای این سه کاربر ارائه دهند زیرا ترجیحات آنها به صراحت در پروفایل آنها بیان شده است. با این حال، اگر یک کاربر ثبت نام شده جدید، به عنوان مثال، کاربر وجود داشته باشد D�کسانی که هیچ رتبه بندی یا فیلم انتخابی ندارند، با CSP روبرو خواهیم شد.
در این شرایط، الگوریتمهای CF مبتنی بر آیتم و مبتنی بر رتبهبندی میخواهند تکنیک شباهت کسینوس را برای خوشهبندی کاربران مشابه اعمال کنند. با این حال، فقدان اطلاعات توصیفی در مورد کاربر D منجر به یک ماتریس رتبه بندی کاربر-اقلام پراکنده می شود و در نتیجه توصیه ها به صورت تصادفی بدون شخصی سازی برای این کاربر تهیه می شود. با این حال، USDE پیشنهادی ما با CSP بدون هیچ افتی در دقت RS روبرو میشود. به طور خاص، انواع مختلف روابط اجتماعی و اطلاعات متنی در نمایه آنها برای یافتن کاربران مشابه و پیشبینی محتملترین ترجیحات آنها استفاده میشود. با توجه به موقعیتی که در آن تشخیص میدهیم که کاربر D کاربر A را در گروه اصلی خود از کاربران مرتبط اجتماعی دارد، سپس میتوانیم آن کاربر D را پیشبینی کنیم.ترجیحات مشابهی با کاربر A دارد و بنابراین، مانند کاربر A، به احتمال زیاد به ژانرهای فیلم علمی-تخیلی، اکشن و درام علاقه دارد.
برای ارزیابی عملکرد USDE پیشنهادی ما، آن را با سایر معیارهای تشابه رایج (به عنوان مثال، شباهت کسینوس و همبستگی پیرسون [ ۳۰ ]) در مورد CSP موجود و مشکل پراکندگی داده مقایسه خواهد شد. برای گنجاندن روشهای تشخیص شباهت پیشرفتهتر (به عنوان مثال، استفاده از دادههای جمعیتی و تعاملات اجتماعی [ ۳۷ ])، یک موتور تشخیص شباهت آگاه از زمینه (CSDE) نیز با USDE پیشنهادی مقایسه میشود. این معیارهای شباهت مختلف در یک RS مبتنی بر CF اعمال میشوند و برای ارزیابی عملکرد آنها مقایسه میشوند. برای این ارزیابی، مجموعه داده های موجود در دسترس عموم مردم MovieLens [ ۳۹ ] استفاده شد و وضعیت شروع سرد و پراکندگی داده ها به طور مصنوعی ایجاد شد ( جدول ۱۱).). این مجموعه داده از کاربرانی که حداقل ۲۰ فیلم را رتبهبندی کردهاند در ۲۶ سپتامبر ۲۰۱۹ تولید شد. برای مجموعه داده مصنوعی، ما بهطور تصادفی ۴۸۸ کاربر (یعنی ۸۰ درصد کاربران) را انتخاب کردیم و تنها ۱۰ درصد از همه رتبهبندیهای ممکن را در نظر گرفتیم که به معنای سطح پراکندگی است. برای ۸۰ درصد کاربران ۰٫۹ است. برای ۲۰ درصد بقیه کاربران، ۱۰ درصد از کاربران (یعنی ۶۱ کاربر) بدون رتبه بندی به عنوان کاربران شروع سرد در نظر گرفته شدند و تنها یک رتبه به ۱۰ درصد باقی مانده از کاربران اختصاص یافت. تعداد رتبهبندیهای کاربران برای MovieLens اصلی و مجموعه دادههای مصنوعی در شکل ۸ نشان داده شده است .
از آنجایی که دادههای MovieLens دادههای جمعیتشناختی یا تعاملات اجتماعی ندارند، ما آن ویژگیها را بهطور مصنوعی شبیهسازی کردیم. از آنجایی که مجموعه داده MovieLens شامل کاربرانی می شود که حداقل ۲۰ فیلم را رتبه بندی کرده اند، معیار تشابه کسینوس در مجموعه داده MovieLens برای به دست آوردن لیستی از ۱۰ کاربر مشابه برای هر یک از ۶۱۰ کاربر اعمال شده است. با استفاده از لیست ۱۰ کاربر مشابه، تعاملات اجتماعی، داده های جمعیتی و بیشتر ژانر فیلم ترجیحی به طور مصنوعی ایجاد و به کاربران اختصاص داده شده است. شباهت کسینوس و معیارهای همبستگی پیرسون رتبهبندیهای مصنوعی را در نظر میگیرد در حالی که CSDE تعاملات اجتماعی و دادههای جمعیتی را نیز در نظر میگیرد.
در این بخش، میانگین خطای مطلق (MAE) معیارهای مختلف شباهت کاربر مقایسه شده است. نتیجه اعمال هر چهار معیار شباهت در هر دو مجموعه داده های MoveLens و مصنوعی در جدول ۱۲ خلاصه شده است.. برای مجموعه داده MovieLens، CSDE عملکرد کمی بهتر از USDE پیشنهادی ما نشان میدهد. دلیل آن این است که CSDE تعاملات اجتماعی بین کاربران و همچنین داده های جمعیتی را به عنوان اطلاعات اضافی برای یافتن کاربران مشابه در نظر می گیرد. با این حال، USDE پیشنهادی عملکرد بهتری نسبت به شباهت کسینوس و معیارهای همبستگی پیرسون نشان میدهد. از سوی دیگر، USDE پیشنهادی در هنگام استفاده از مجموعه داده مصنوعی از سه معیار مشابهت دیگر بهتر عمل می کند. از آنجایی که تنها یک فیلم در مجموعه فیلم های هم رتبه بین دو کاربر وجود دارد، همبستگی پیرسون قابل محاسبه نیست و شباهت کسینوس کاربران مشابه را بدون توجه به تفاوت بین رتبه ها در نظر می گیرد. نتایج تجربی ما نشان میدهد که USDE پیشنهادی ۲۳% از روش شباهت کسینوس، ۲۵٫۳۳% از همبستگی پیرسون و ۱۷% CSDE بهتر عمل میکند.
۷٫ نتیجه گیری و کار آینده
در این مقاله، ما یک سیستم توصیهکننده موبایل را به عنوان چارچوبی واحد برای ادغام پتانسیل دستگاههای هوشمند با شبکههای اجتماعی پیشنهاد کردیم. استفاده از پتانسیل دستگاه های هوشمند در RS پیشنهادی ما، پنجره های جدیدی از فرصت را برای RS ها باز می کند. با استفاده از زمینه های اولیه ارائه شده توسط دستگاه های هوشمند کاربران، RS پیشنهادی دیگر به تعداد محدودی از ارائه دهندگان زمینه (یعنی تلفن های هوشمند و تبلت ها) متکی نیست. در عوض، همه دستگاه های هوشمند ثبت شده توسط کاربران می توانند روزانه به RS اضافه شوند. ایجاد یک نمایه کاربری به روز شده که حاوی زمینه های استخراج شده از دستگاه های هوشمند کاربران باشد، مزایای متعددی را برای سیستم ما ایجاد می کند. در ابتدا، با استفاده از داده هایی که به طور مداوم توسط دستگاه های هوشمند کاربر به روز می شوند، موضوع تغییر ماهیت ترجیحات کاربر مورد توجه قرار می گیرد. ثانیاً سیستم پیشنهادی قادر به استخراج زمینه (یعنی ضربان قلب کاربر در حین انجام فعالیتهای فیزیکی مختلف) است که کاربران قبلاً قادر به گزارش آن نبودند. در نهایت، استفاده از دستگاه های هوشمند نیاز به هرگونه مداخله انسانی در جمع آوری داده ها را بی نیاز می کند.
ارائه توصیه های شخصی تر و پرداختن به CSP به عنوان چالش برانگیزترین مسائل برای RS ها شناخته می شود. دستیابی به درک بهتر از کاربران می تواند منجر به ارائه توصیه هایی شود که بیشتر با ترجیحات کاربر مطابقت دارند. پیشرفت های اخیر در RS ها که شامل ادغام آگاهی از زمینه با RS های سنتی است، تا حد زیادی عملکرد RS ها را در رابطه با ارائه توصیه های شخصی تر به کاربران بهبود بخشیده است. با این حال، سطح شخصی سازی ارائه شده توسط RS ها می تواند بیشتر بهبود یابد. برای این تحقیق، یک موتور تشخیص شباهت جدید پیشنهاد شده و در RS مبتنی بر CF به منظور بهبود بیشتر عملکرد RS ها ادغام شده است.
در مقایسه با سایر مطالعاتی که صرفاً کاربران مشابه را با در نظر گرفتن تعامل آنها با موارد شناسایی می کنند، معتقدیم که روابط اجتماعی نیز می تواند برای شناسایی کاربران مشابه مورد استفاده قرار گیرد. با استفاده از داده های ارائه شده توسط دستگاه های هوشمند کاربران برای RS پیشنهادی ما، تعریف ما از شباهت از آنچه اخیراً توسط مطالعات قبلی ارائه شده است، پیشی می گیرد. علاوه بر روابط اجتماعی رایج (یعنی روابط اجتماعی دو طرفه در فیس بوک)، ما همچنین روابط نزدیک تری را که کاربران می توانند با تماس های تلفنی و ایمیل داشته باشند، در نظر می گیریم. در مقایسه با سایر مطالعات مشابه، موتور شباهت می تواند شباهت بین کاربران را با در نظر گرفتن روابط نزدیک آنها که با استفاده از داده های ارائه شده توسط دستگاه های هوشمند آنها شناسایی شده است، شناسایی کند. بنابراین، بر خلاف سایر موتورهای تشخیص شباهت مبتنی بر SN، USDE پیشنهادی ما کاربران مشابه را حتی زمانی که کاربر هیچ گونه تعامل اجتماعی در SN ها ندارد شناسایی می کند. نتایج نشان میدهد که USDE پیشنهادی در شرایط شروع سرد و پراکندگی دادهها، ۲۳% از روش شباهت کسینوس، ۲۵٫۳۳% از همبستگی پیرسون و ۱۷٫۶۶% از CSDE بهتر عمل میکند.
در مورد دیگر با یک CSP موجود (یعنی شرایطی که در آن کاربر جدید به تازگی با RS ثبت نام کرده است، ترجیحات او به صراحت مشخص نشده است، و او هیچ رابطه اجتماعی در SN ها ندارد، یا کسانی که از آنها استفاده می کنند. دستگاه های هوشمند)، USDE ما کاربران مشابه را با استفاده از هوش مصنوعی ازدحام شناسایی می کند. موتور تشخیص شباهت با در نظر گرفتن پروفایل های کاربر و به کارگیری روش کلونی زنبورهای مصنوعی، قادر است کاربران مشابه را بر اساس حداقل اطلاعات متنی گزارش شده در پروفایل آنها پیدا کند. مقایسه بین روش خوشهبندی ABC و K-means نشان میدهد که کیفیت خوشهبندی ۹٫۳ درصد افزایش مییابد در حالی که میانگین زمان کاهش مییابد. اثربخشی الگوریتم های تصادفی تا حد زیادی به تولید راه حل های اولیه بستگی دارد. برای هر مجموعه داده،
اگرچه سیستم ما توصیه هایی را برای پنج حوزه مختلف به طور همزمان ارائه می دهد، ما تصمیم گرفتیم عملکرد سیستم خود را در زمینه توصیه های فیلم برای این مقاله ارزیابی کنیم. ما عملکرد الگوریتم پیشنهادی پیشنهادی را با دو الگوریتم توصیهگر پرکاربرد مقایسه کردیم: CF مبتنی بر رتبهبندی و CF مبتنی بر آیتم. در مقایسه با آن RS ها، سطوح دقت و شخصی سازی RS پیشنهادی به ترتیب چهار درصد و ۴٫۵ درصد افزایش یافت.
اگرچه افزایش سطح شخصیسازی منجر به رضایت بیشتر کاربر میشود، یافتن تعداد بیشتری از کاربران مشابه دشوارتر خواهد بود. در نتیجه، زمانی که تعداد موارد توصیه شده افزایش می یابد، عملکرد الگوریتم پیشنهادی تحت تأثیر قرار می گیرد. بنابراین، پیشنهاد یک سطح مناسب از شخصیسازی مرتبط با تعداد موارد پیشنهادی مورد نیاز، موضوعی چالشبرانگیز برای مطالعات آینده در مورد RS آگاه از زمینه خواهد بود. برای این مطالعه، ساده ترین اطلاعات زمینه ای مرتبط با کاربر ( ه . g . ،ه.g.،زمان، مکان و فعالیت کاربر) استخراج می شود. با این حال، با افزودن قوانین پیچیده تر به موتور استدلال زمینه، می توان اطلاعات متنی پیچیده تری را استنتاج کرد. قوانین ارتباط بین کاربران و اطلاعات پویا مربوطه آنها از دستگاه های هوشمند آنها قابل استخراج است. چنین قوانینی قابلیت یادگیری را برای سیستم فراهم می کند که به نوبه خود قابلیت اطمینان و استحکام سیستم را بهبود می بخشد. از آنجایی که کیفیت دادههای ارائهشده توسط پوشیدنیهای هوشمند بسته به تولیدکنندگان مختلف متفاوت است، بهبود روشهای مورد استفاده در [ ۲ ، ۳ ] در USDE و RS برای کارهای آینده متوقف شده است. حریم خصوصی کاربر و حفاظت از رازداری داده ها جهت دیگری برای تحقیقات آینده است، به ویژه در رابطه با حریم خصوصی کاربر در فضای ابری [ ۶۷ ]]. برای اعمال سیستم توصیهکننده پیشنهادی در مقیاس بزرگ و محصولات آماده صنعت، باید یک تحقیق دقیق در مورد حریم خصوصی کاربر مقیاسپذیر بهویژه در دستگاههای ابری و محدود به منابع انجام شود. اگرچه حفاظت از حریم خصوصی خارج از محدوده این مقاله است، ما از تکنیکهای اصلی احراز هویت و حفظ امنیت مجوز و ناشناسسازی شناسه کاربر در جنبههای مختلف RS پیشنهادی استفاده کردیم. بررسی تمام مکانیسمهای امنیتی موجود برای محافظت از حریم خصوصی کاربران نیز برای کارهای آینده متوقف شده است.