۱٫ معرفی
تحت تحولات سریع و مسحورکننده در دنیای فناوری و شبکه های اینترنتی، به ویژه موفقیت تجاری دستگاه های تلفن همراه، زندگی مردم آسان تر و لذت بخش تر شده است. خدمات مبتنی بر مکان (LBS) بخش اصلی اینترنت اشیاء (IoT) را تشکیل می دهد [ ۱ ، ۲ ، ۳ ، ۴ ، ۵ ، ۶ ]، که در آن طیف گسترده ای از برنامه های IoT به LBS، از جمله خودروهای هوشمند، دستگاه های پوشیدنی متکی هستند. (ساعتهای هوشمند، دستبندهای ردیاب خواب، لباسها و غیره)، و برنامههای LBS مبتنی بر پاداش [ ۷ ، ۸ ، ۹ ]]. علاوه بر این، در زمینه e-Health، LBS نقش مهمی در نظارت بر وضعیت سلامت بیمار (ضربان نبض و سطح فشار خون) و اجتناب از بلایا دارد [ ۱۰ ، ۱۱ ]. مزیت دیگر LBS این است که افراد را قادر میسازد تا نقاط مورد علاقه (POI) مانند رستورانها، هتلها، بیمارستانها و کلوپهای ورزشی اطراف را جستجو کنند.
۱٫۱٫ بیان مشکل
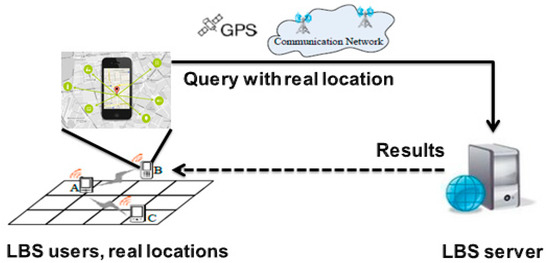
استفاده از LBS مستلزم ارسال پرس و جوها بر اساس موقعیت جغرافیایی واقعی کاربران LBS است، جایی که کاربران LBS مکان واقعی خود را از طریق GPS بدست می آورند. پس از دستکاری این پرسشها از سوی ارائهدهنده خدمات، نتایج به کاربران برگردانده میشوند که در شکل ۱ نشان داده شده است.
این سناریوی ساده و سنتی شامل خطراتی میشود، حتی اگر کاربران از مزایای LBS غافل شوند. دلیل اصلی پشت این خطرات این است که خدماتی که کاربران LBS مایل به استفاده از آنها هستند و مکانهایی که به احتمال زیاد از آنها بازدید میکنند یا سعی میکنند پیدا کنند، جنبههای مهمی را منعکس میکنند که مستقیماً با زندگی شخصی آنها مرتبط است (مانند آداب و رسوم، عادات، یا اقناع مذهبی). علاوه بر این، در پرتو روش های پیشرفته موجود که می توانند برای ردیابی کاربران استفاده شوند، مانند [ ۱۲ ، ۱۳ ]، جمع آوری اطلاعات خصوصی جدی تر شده است. در کار [ ۱۲]، نویسندگان یک نظرسنجی در مورد ردیابی بی سیم داخلی گره های تلفن همراه از دیدگاه پردازش سیگنال ارائه کردند. علاوه بر این، آنها اظهار داشتند که اگر شاهد استفاده گسترده از فناوریهای ردیابی داخلی برای تکمیل و توانمندسازی سیستمهای عابر پیاده و وسایل نقلیه در زمینههای سیستمهای حمل و نقل هوشمند، وسایل نقلیه خودکار، روباتیک و خدمات مبتنی بر مکان باشیم، تعجبآور نخواهد بود. ژانگ و همکاران [ ۱۳ ] مونتاژ را برای ردیابی و بومی سازی تشکیل چند کاربر در زمان واقعی توسعه داد. مونتاژ با ادغام محدودیتهای زمانی و مکانی از تخمین بردار حرکت کاربر و اندازهگیری فاصله، دقت ردیابی بالایی را به دست میآورد. فراتر از ردیابی، نویسندگان در [ ۱۴] نشان داد که میتوان چنین اطلاعاتی را در مورد این جنبههای حساس بهدست آورد، زیرا مهاجمان میتوانند مکانهای کاربران را ردیابی کنند یا درخواستهای آنها را تجزیه و تحلیل کنند. پس از جمعآوری دادههای حساس در مورد قربانی، مهاجم میتواند یک حمله واقعی را به اشکال مختلف مانند دزدی، باجگیری یا دزدی ایجاد کرده و آغاز کند. در بدترین حالت، اگر سرور LBS یا خود نگهدارنده سرور LBS مهاجم باشد، خطر تأثیر منفی بیشتری بر حریم خصوصی خواهد داشت زیرا تمام اطلاعات مربوط به فعالیت های کاربران LBS قابل دسترسی است. بنابراین، حفاظت از حریم خصوصی یک مشکل بسیار مهم است و نیاز به انقلاب در روش های حفاظت از حریم خصوصی ضروری است.
۱٫۲٫ انگیزه
برای رفع این مشکل و محافظت از حریم خصوصی کاربران LBS، محققان چندین رویکرد را پیشنهاد کردهاند. راه حل ها از دیدگاه های مختلف، یعنی سمت سرور، سمت کاربر، و همکاری تعاملی بین هر دو سمت سرور و کاربر مورد بررسی قرار گرفتند. شکل ۲ طبقه بندی رویکردهای حفاظت از حریم خصوصی LBS است که در آن هر دسته دارای اشکالاتی است.
در مورد سمت سرور، ملاحظاتی که در نظر گرفته میشود این است که هنگام دستیابی به مزایای قابلیتهای محاسباتی بالا و فضای ذخیرهسازی عظیم، برخورد با سرور اجتنابناپذیر است. رویکردهای مختلفی برای ارائه حفاظت از حریم خصوصی در سطح سرور ارائه شده است [ ۱۵ ، ۱۶ ، ۱۷ ، ۱۸ ، ۱۹ ، ۲۰ ، ۲۱ ، ۲۲ ، ۲۳ ]. خو و همکاران [ ۲۴] راه جدیدی برای محافظت از حریم خصوصی کاربران LBS با استفاده از ماسک های زمانی-مکانی برای مکان های کاربر پیشنهاد کرد، جایی که سرور به عنوان یک ناشناس عمل می کند. با این حال، با توجه به حساسیت برنامه ای که کاربر LBS استفاده می کند، سرور یک حزب مخرب (یعنی یک مهاجم) در نظر گرفته می شود که توانایی ردیابی مسیر حرکت کاربر LBS و به خطر انداختن حریم خصوصی را دارد. در نتیجه، هیچ تضمینی در رابطه با اتکای کامل و مطلق به سرور LBS وجود ندارد. فراتر از آن، سرور LBS را می توان یک مرکز داده با ارزش از دید مهاجم در نظر گرفت، زیرا تمام اطلاعات مربوط به مسیر حرکت کاربران LBS یا اطلاعاتی که POI ترجیح می دهند در آن ذخیره می شود. به عبارت دیگر،
از دیدگاه کاربر، برای رسیدگی به چنین مسائل مهمی، برخی از محققان انگیزه های خود را تغییر داده اند و بر روی سمت کاربر تمرکز کرده اند (پرهیز از برخورد با شخص ثالث قابل اعتماد (TTP)). از دیدگاه آنها، نکته ای که باید مورد توجه قرار گیرد این است که خود کاربر LBS می تواند سطح حریم خصوصی را تعیین کند یا حتی کنترل کاملی بر آن داشته باشد. کاربر آگاهی بیشتری در مورد مکان و زمان استفاده از سطح حریم خصوصی بالا و درخواست یک POI دارد. بسیاری از رویکردهای پیشنهادی در این جنبه در [ ۲۵ , ۲۶ , ۲۷ , ۲۸ , ۲۹ , ۳۰ , ۳۱ ارائه شده است .]. به طور کلی، حتی این رویکردها از برخورد با TTP ها اجتناب می کنند، اما از مشکلات زیادی در رابطه با محدودیت های ذخیره سازی ظرفیت دستگاه تلفن همراه، قابلیت های محاسباتی کم و عمر باتری کوتاه رنج می برند. به طور خاص، رویکردهای موجود در [ ۳۲ ، ۳۳ ، ۳۴ ، ۳۵ ] مشکل عمده دیگری در رابطه با تولید آدمک دارند که طبق [ ۳۶ ] یک مشکل باز در نظر گرفته می شود.]. در زمینه حفاظت از حریم خصوصی LBS، dummy اصطلاحی است که به مجموعه ای از پرس و جوهایی که بر روی مکان های نادرست ساخته شده اند اشاره دارد. از آنجایی که مسئولیت تولید ساختگی به کاربران LBS واگذار شده است، تولید آدمک های ضعیف آنها را قربانی آسانی می کند، زیرا مهاجم به راحتی می تواند ساختگی های ضعیف را فیلتر کرده و هویت کاربران LBS را تعیین کند. این مشکلات مسیر تحقیق را تغییر داد.
این تاکتیک های جدید به اصل تعامل مشترک بین هر دو کاربر LBS بستگی دارد و سرور LBS در [ ۳۶ ، ۳۷ ] پیشنهاد شده است. در این دسته، کاربر LBS با کمک ارائه شده از جنبه سرور LBS مسئولیت مدیریت حریم خصوصی را بر عهده خواهد گرفت. اگرچه سرور LBS یا با ترتیب دادن داده های قابل حمل در کانال ارسال شده یا ارائه اطلاعات فعالانه در مورد درجه نقض حریم خصوصی کاربر LBS به کاربر LBS کمک می کند، این رویکردها همچنان به سرور LBS و ماموریتی که به آن محول شده بستگی دارد. که به اشکالات مربوط به دسته مبتنی بر سرور اشاره دارد.
یکی از مهم ترین راه های همکاری که در آن کاربران LBS می توانند از برخورد با TTP ها اجتناب کنند، به حداقل رساندن شماره اتصال با سرور LBS است [ ۳۸ , ۳۹ , ۴۰]. ایده کلیدی به حافظه نهان متکی است، جایی که پاسخهای پرسوجوها (RoQ) که قبلاً ذخیره شدهاند برای پاسخگویی به پرسشهای آینده مورد سوء استفاده قرار میگیرند. بنابراین کاربر LBS سعی می کند پاسخ پرسش خود را در حافظه پنهان بیابد و در صورتی که پاسخ پرسش خود را در کش بیابد قابل قبول تلقی می شود. در غیر این صورت کاربر LBS مجبور به اتصال به سرور LBS می شود. با این حال، انتخاب اتصال به سرور LBS همچنان پابرجاست. این به نوبه خود به این معنی است که کاربر LBS در صورت ردیابی طولانی مدت توسط سرور LBS در شرایط بحرانی قرار خواهد گرفت. علاوه بر این، هیچ مبنای اعتماد قوی نمی تواند مانع از روی آوردن کاربران به یک مهاجم شود. علاوه بر این، کیفیت RoQ ممکن است ضعیف باشد و منجر به عملکرد ضعیف پاسخ سیستم شود.
۱٫۳٫ مشارکت
با تمرکز بر رویکردهای مبتنی بر حافظه پنهان، یک رهبر (که به عنوان یک TTP عمل می کند) می تواند اعداد اتصال به سرور LBS را کاهش دهد و همزمان کیفیت RoQ ذخیره شده در کش را بهینه کند. از طریق ایجاد اعتماد بین کاربران LBS و یک رهبر، می توان از اتصال همه کاربران LBS به سرور LBS جلوگیری کرد. پیادهسازی یک رهبر (TTP)، که از طریق آن درخواستهای کاربران LBS به سرور LBS ارسال میشود، به این معنی است که رهبر میتواند از حریم خصوصی خود بدون نیاز به تولید ساختگی محافظت کند. پرس و جوهای واقعی به عنوان dummies در سمت رهبر مورد سوء استفاده قرار می گیرند. علاوه بر این، در مقایسه با RoQ ساخته شده بر روی dummies، پاسخ های این پرس و جوهای سوء استفاده شده نتایج واقعی برای آنچه کاربران LBS به دنبال آن هستند خواهد بود. در نتیجه، حافظه پنهان با اطلاعات ارزشمندی پر می شود که به افزایش احتمال پاسخگویی به سوالات آینده کمک می کند. این به نوبه خود زمان پاسخ سیستم را بهینه می کند زیرا زمان دستکاری پرس و جو را به دلیل مفهوم محلی بودن کوتاه می کند.
در این مقاله راه حلی برای بهینه سازی حفاظت از حریم خصوصی کاربران LBS ارائه شده است. راه حل پیشنهادی از طبیعت الهام گرفته شده است و بستگی به رابطه همزیستی دارد که از منافع متقابلی که می تواند در بین حیوانات رخ دهد (مثلاً پرندگانی که در داخل آرواره های باز شده یک تمساح به دنبال غذا می گردند) استفاده می کند. فرافکنی پدیده سود متقابل منجر به اعتماد زیادی بین اعضای یک خوشه و رهبر خواهد شد. اعضای خوشه قادر خواهند بود از اتصال به سرور LBS (یک حزب مخرب) اجتناب کنند. در همان زمان، رهبر از پرسشهای واقعی با موقعیتهای واقعی بهعنوان آدمکها برای به دست آوردن حفاظت کامل از حریم خصوصی در کنار خود بهرهبرداری میکند. برای اینکه بدانیم چگونه حریم خصوصی رهبر شکسته شده است، معیار حریم خصوصی جدیدی را پیشنهاد کردیم که می تواند به عنوان یک معیار استاندارد در نظر گرفته شود.
به طور کلی سهم این اثر به شرح زیر است:
-
این مقاله یک رویکرد رهبر پیشنهاد میکند تا به طور کامل از اتصال کاربران LBS (اعضای یک خوشه) به طرف غیرقابل اعتماد (سرور LBS) جلوگیری کند. یک رابطه همزیستی برای تشکیل پایه اعتماد بین اعضای خوشه و رهبر آنها استفاده می شود. در نتیجه، رهبر یک TTP قوی در نظر گرفته می شود.
-
این مقاله راه حلی را برای مشکل تولید ساختگی معرفی می کند که به عنوان یک مشکل گران و باز برای دستیابی به حفاظت از حریم خصوصی جامع (یعنی حفاظت از حریم خصوصی مکان و پرس و جو) در نظر گرفته می شود.
-
بسته به آنتروپی مکان، یک معیار حریم خصوصی جدید ارائه شده است. برای اندازه گیری نزدیکی مهاجم به لحظه شروع حمله استفاده می شود.
-
برای نشان دادن استحکام رویکرد پیشنهادی از نظر هزینه ارتباط، مقاومت در برابر حملات استنتاج، و نسبت ضربه حافظه پنهان، سه رویکرد معروف، یعنی بهبود یافته-DLS [ ۳۴ ]، پنهان شدن در یک جمعیت موبایل [ ۳۸ ]، و بهبود یافته- CaDSA [ ۴۰ ] مورد مطالعه و مقایسه قرار می گیرد.
بقیه مقاله به شرح زیر سازماندهی شده است: بخش ۲ شامل بررسی ادبیات است. در بخش ۳ ، ما راه حل پیشنهادی را به دنبال معیارهای ارزیابی در بخش ۴ ارائه می کنیم. بخش ۵ نتایج تجربی ما را با ارزیابی ها جمع آوری می کند. در نهایت، مقاله را در بخش ۶ به پایان میرسانیم .
۲٫ کارهای مرتبط
تحت این تهدید که کاربران LBS در رابطه با قربانی کردن حریم خصوصی خود شکایت می کنند، محققان با ایجاد دفاع در برابر مهاجمان پاسخ دادند. این دفاع ها از طریق رویکردهای پیشنهادی مختلف در حوزه حفاظت از حریم خصوصی LBS بیان شد. تلاشهای زیادی برای طبقهبندی رویکردهای پیشنهادی حفاظت از حریم خصوصی انجام شد، و این طبقهبندیها از دیدگاههای مختلف با توجه به اهداف [ ۱۵ ]، توپولوژیهای مکان [ ۴۱ ] یا ویژگیهای ساختار [ ۱۴ ] گرفته شدند. به عنوان مثال، طبقه بندی ارائه شده در [ ۱۵ ] حفاظت از حریم خصوصی محدود در حفاظت از هویت کاربر، اطلاعات مکانی و اطلاعات زمانی است.
به طور کلی، بررسی ادبیات ارائه شده در این مقاله، تکنیکهای حفاظت از حریم خصوصی را به سه دسته اصلی طبقهبندی میکند، جایی که اساساً به میزان همکاری بین دو جنبه اصلی درگیر در هر سیستم حفاظت از حریم خصوصی LBS (یعنی کاربران LBS و سرور LBS) بستگی دارد. قبل از شروع، لازم به ذکر است که بیشتر تکنیکهای پیشنهادی در یک ریشه تلاقی میکنند که آن هم بهکارگیری مفهوم k-anonymity به روشهای مختلف است. ماهیت اصلی k-anonymity این است که مهاجم را در مورد تعیین هویت صادرکننده پرس و جو در میان سایر کاربران (k-1) سردرگم کند.
۲٫۱٫ گروه اول: بیشتر بار در سمت سرور
در این گروه، سرور LBS عمدتاً مسئولیت اجرای رویکرد حفاظتی را بر عهده دارد، در حالی که مأموریت کاربر فقط ارسال درخواست خود است. این گروه فرض می کند که سرور LBS باید قابل اعتماد باشد.
نویسندگان در [ ۱۶ ] کار خود را بر اساس یک امضا برای حفاظت از حریم خصوصی قرار دادند، جایی که آنها یک الگوریتم امضای پیام را برای رسیدن به هدف خود پیشنهاد کردند. ویژگی اصلی الگوریتم امضای پیام، افزایش کارایی تأیید صحت در تعداد زیادی از پیامهای رد و بدل شده بین کاربران بود. علاوه بر این، یک معماری سرور LBS نیمه قابل اعتماد در [ ۱۷ ] پیشنهاد شد که بر اساس یک الگوریتم زمان بندی مکان (LCA) برای محافظت از مکان واقعی کاربر است. سهم عمده الگوریتم LCR به حداقل رساندن منطقه فضایی ناشناس (ASR) بود. بنابراین، تعداد کاربران واقعی نزدیک به نگه داشته می شود ک-ناشناس بودنحتی اگر چند کاربر در منطقه ناشناس وجود داشته باشد. Gedlik و liu یک رویکرد شخصی سازی ناشناس به نام CliqueCloak [ ۱۸ ] ارائه کردند که در آن سرور LBS به عنوان یک ناشناس با توجه به خواسته های کاربر عمل می کند. برای محافظت از حریم خصوصی، ماسکهای مکانی-زمانی (کلیکها) روی موقعیتهای کاربر با ارائه سطح ناشناس K-کنترلشده اعمال میشوند. ویژگی جذاب رویکرد CliqueCloak این است که به کاربران LBS اجازه میدهد تا محدودیتهای فردی و حداکثری برای ویژگیهای مکانی-زمانی ماسکها (یعنی سطح تحمل فردی) داشته باشند. مشابه [ ۱۸ ، ۱۹] ماسک های مکانی-زمانی را برای کاربرانی که در یک منطقه خاص قرار دارند ارائه می کند. با این حال، تفاوت این بود که این رویکرد بر روی وضوح این ماسک ها با تغییر ابعاد مکانی-زمانی ماسک ها برای برآوردن شرایط خاص و رسیدن به یک ک-ناشناس بودنمفهوم در عین حال بنابراین، سطح تساهل را نادیده گرفت و بر قطعنامه تمرکز کرد. به طور مشابه، نویسندگان [ ۲۰ ] رویکرد شخصی شده دیگری به نام کاسپر را پیشنهاد کردند. در مقایسه با CliqueCloak، شرایط حفاظت از حریم خصوصی از نمایه کاربر LBS هدایت میشود. یکی از قابل توجه ترین تکنیک های مورد استفاده در این گروه در [ ۲۱ ] پیشنهاد شد و به آن مناطق مخلوط می گویند. کاربران واقع در یک منطقه معین در بسیاری از مناطق فضایی (منطقه ها) گروه بندی می شوند و هر منطقه به یک نام مستعار اختصاص داده می شود. سپس، مناطق برای تضمین هر دو شرایط مخلوط می شوند، به این معنی که هیچ به روز رسانی مکان در داخل یک منطقه ترکیبی در طول جابجایی اشیا وجود ندارد و کاربر باید از نام مستعار گروه جدید در هنگام ترک یک منطقه به منطقه دیگر استفاده کند.
رویکرد دیگری که در [ ۲۲ ] ارائه شد، سردرگمی مهاجمان را هدف قرار داد و توانایی او را برای جمعآوری اطلاعات تاریخی مربوط به مسیرهای حرکت کاربران در طول حرکتشان به حداقل رساند. این رویکرد از یک الگوریتم اغتشاش استفاده می کند که از تقاطع های مسیر یا نزدیک به یکدیگر بهره می برد. میروویتز و همکاران با استفاده از رویکرد CacheClock همانطور که در [ ۲۳ ] ارائه شده است، به حفاظت از حریم خصوصی مکان در زمان واقعی دست یافت. رویکرد CacheClock مبتنی بر تقاطع مسیرها برای پیش بینی مسیرهای جدید است، جایی که موقعیت واقعی کاربر LBS در یکی از این مسیرهای پیش بینی شده قرار خواهد گرفت. بنابراین، موقعیت واقعی با مسیرهای دیگر پوشانده می شود.
انگیزه [ ۲۴ ] بر اساس این ایده است که حریم خصوصی در مورد احساس است، و برای کاربران LBS ناخوشایند است که احساس خود را با استفاده از یک عدد مقیاس کنند (یعنی تصمیم گیری یک مقدار k بالا برای مفهوم k-anonymity). بنابراین، به جای تصمیم گیری در مورد مقدار ak، کاربر LBS در مورد محبوبیت منطقه ای که در آن زندگی می کند تصمیم می گیرد. محبوبیت یک منطقه، مراکز خرید به عنوان مثال، حفاظت از حریم خصوصی را تضمین می کند، جایی که ما بازدیدکنندگان یا کاربران LBS زیادی داریم، زیرا مهاجم به اطلاعات شخصی خاص در مورد کاربر LBS نیاز دارد، نه اطلاعات عمومی.
۲٫۲٫ گروه دوم: بیشترین بار در سمت کاربر
در این گروه، تکنیک حریم خصوصی بر روی دستگاه های تلفن همراه کاربران LBS اجرا می شود و مدیریت حریم خصوصی توسط خود کاربران کنترل می شود که در آن سرور LBS یک جزء مخرب در نظر گرفته می شود.
از آنجایی که از سرورهای LBS نامعتبر اجتناب شد، نویسندگان در [ ۲۵ ] با دو مشکل اصلی مواجه شدند. اول، حریم خصوصی کاربر می تواند بر اساس داده های استنباط شده از پرس و جو صادر شده مورد حمله قرار گیرد. دوم سطح حریم خصوصی کاربر است که بین حفاظت از حریم خصوصی و دقت پاسخ LBS معامله می شود. نقشه جغرافیایی ذخیره سازی همراه با حفاظت مبتنی بر اغتشاش برای حل مسئله حریم خصوصی در سمت کاربر پیشنهاد شده است و سپس نقشه برداری منحنی هیلبرت با طول شبکه مختلف (VHC) برای تبدیل دو بعد نقشه ذخیره شده به یک بعد بسته به استفاده می شود. در زمینه همگنی نقشه به عنوان راه حلی برای حفاظت از حریم خصوصی قوی و به عنوان راهی برای حفظ دقت پاسخ LBS.
چارچوبی به نام MobiMimosa در [ ۲۶ ] ارائه شد که به محافظت از داده های حساس ذخیره شده در گوشی های هوشمند کمک می کند. از آنجایی که هزینه فرآیند رمزگذاری و رمزگشایی هزینه محاسباتی بالایی در نظر گرفته می شود، MobiMimosa سعی کرد با ارائه یک رمزگذاری قابل انکار این هزینه را به حداقل برساند. یکی دیگر از رویکردهای مبتنی بر دستگاه تلفن همراه به نام SMILE برای حل مشکل غیرقابل اعتماد سرور LBS از دیدگاه کاملاً اجتماعی پیشنهاد شد [ ۲۷ ]]. برای اندازهگیری و پیکربندی سطح حریم خصوصی کاربران برای استفاده از LBSهای مبتنی بر برخورد، k-anonymity را اعمال کرد. این رویکرد با انتخاب طول پیشوند مقدار هش مکان از حریم خصوصی کاربر محافظت می کند تا از آشکار شدن درگیری با سرورهای غیرقابل اعتماد جلوگیری کند. یک رویکرد جعبههای پنهانسازی ناشناس k در [ ۲۸ ] بر اساس محو کردن مختصات موقعیتهای واقعی کل کاربران فعال برای ساخت چنین جعبههایی ارائه شد. این تحت شرایط غیر قابل اعتماد غیرقابل قبول است. قدرت سیگنال های Wifi دریافتی برای ساخت جعبه های ساعت به جای افشای مختصات واقعی کاربران استفاده می شود. نویسندگان [ ۲۹] بر به حداقل رساندن توانایی مهاجم برای استنتاج اطلاعات خصوصی از الگوهای حرکتی کاربران تکیه کرد و اصطلاح غیر قابل مشاهده M را پیشنهاد کرد. موقعیت کاربر را با نویز می پوشاند که به نوبه خود تشخیص POI هایی را که کاربران بیشتر از آنها بازدید می کنند محدود می کند. آرداگنا و همکاران [ ۳۰ ]، بر اساس یک تکنیک مبهم سازی فضایی، تکنیکی را پیشنهاد کرد تا موقعیت واقعی و واضح کاربر را از نظر ریاضی درشت نشان دهد. حفاظت از حریم خصوصی مکان با ارسال یک آریا دایره ای به جای موقعیت دقیق کاربر LBS حاصل شد. عملیات ریاضی شامل بزرگکردن شعاع، تغییر مرکز، افزایش شعاع، یا اعمال مبهمسازی مضاعف (یعنی اختلاط جابهجایی مرکز با باقیماندهها) بود. به طور مشابه، نویسندگان [ ۳۱] رویکرد سطح مختصات را توسعه داد که به تبدیل مختصات بستگی دارد. مختصات حاصل، موقعیت کاربر جدید را به جای موقعیت واقعی او تشکیل می دهد. سپس، تبدیل های معکوس را می توان به راحتی برای به دست آوردن موقعیت های اصلی در سمت کاربر LBS اعمال کرد.
کیدو و همکاران [ ۳۲ ] ایده ساختگی را برای محافظت از حریم خصوصی کاربر LBS ارائه کرد. ایده اصلی این بود که کاربر بسیاری از موقعیتهای نادرست (دومیم) ایجاد میکند، نمونههایی از پرسوجوی فعلی را با استفاده از هم ساختگیها و هم موقعیت واقعی کاربر میسازد و سپس همه کپیها را به سرور LBS ارسال میکند و همان POI را درخواست میکند. تصادفی کردن موقعیت واقعی در بین آدمک ها حفاظت از حریم خصوصی را تضمین می کند، جایی که سرور LBS نمی تواند موقعیت واقعی را در بین آدمک ها تشخیص دهد. پینگلی و همکاران بحث حفاظت از حریم خصوصی پرس و جو در برابر حملات استنتاجی که می تواند برای پرس و جوهای ارسال شده به سرور LBS اعمال شود [ ۳۳]. منطقه ای که کاربر در آن قرار دارد برای ایجاد پرس و جوهای ساختگی با تغییر ویژگی های پرس و جو واقعی مورد سوء استفاده قرار گرفت. برای ایجاد ساختگیهای قوی، از گزارشهای جستجوی تاریخی مرتبط با سایر کاربران برای وارد کردن ویژگیهای جدید برای کمک به ساختن ساختگیها استفاده شد. بنابراین، تفاوت با [ ۳۲ ] ذخیره همان مکان واقعی کاربر LBS و تغییر ویژگی های خود پرس و جو فعلی بود. نویسندگان [ ۳۴ ] یک الگوریتم انتخاب مکان ساختگی پیشرفته به نام پیشرفته-DLS برای تولید مکان های ساختگی ارائه کردند. تفاوت در دو نقطه بود: ۱) احتمال سوء استفاده از (اطلاعات جانبی) در سمت مهاجم را در نظر گرفت و ۲) انتخاب ساختگی ها با دقت برای به دست آوردن درجه بهینه ای از ناشناس بودن k.. در میان مجموعهای از مکانهای نامزد، انتخاب آدمکها در مکانهای مناسب به یک متریک آنتروپی بستگی داشت. هارا و همکاران [ ۳۵ ] با در نظر گرفتن محدودیتهای فیزیکی دنیای واقعی، رویکرد دیگری را در رابطه با ایده ساختگی پیشنهاد کرد. ویژگی که این کار را متمایز می کرد این بود که مسیرهای آدمک های تولید شده از مسیر حرکت واقعی کاربر LBS عبور می کند. برای محافظت از حریم خصوصی کاربر LBS، فرآیند عبور تحت دو شرط عمل می کند: ۱) اگر ساختگی جلوتر از کاربر وجود نداشته باشد، هیچ تغییری در مقصد آدمک ها ایجاد نمی شود (یعنی هیچ عبوری انجام نمی شود). ii) اگر برخی از آدمک ها جلوتر از کاربر حرکت کنند، فرآیند عبور انجام می شود.
۲٫۳٫ گروه سوم: تعادل بار
در این گروه، کاربر یا بر اساس کمک ارائه شده توسط سمت سرور LBS تصمیم حفاظت از حریم خصوصی خود را می گیرد یا در مواردی که هیچ پاسخ پرس و جو در حافظه پنهان یافت نمی شود با سرور LBS متصل می شود. در این گروه سرور LBS نیز به عنوان یک مهاجم در نظر گرفته می شود.
نویسندگان [ ۳۶ ] دسترسی نقطه به نقطه را همراه با ساختن فهرست شاخص هوا (NPI) در کانال اتصال پذیرفته اند. سرور قبل از پخش، بخش های داده را ایندکس کرد. داده های نمایه سازی اطلاعات مربوط به سلول های منطقه ای را که کاربران در آن قرار دارند، حمل می کند. انتقال دوره ای داده های نمایه شده حفاظت از حریم خصوصی را تضمین می کند. در سمت کاربر، الگوریتم مبتنی بر NPI برای پاسخگویی به پرس و جوها اعمال می شود. یک ساختار سرور LBS پشتیبان حریم خصوصی در [ ۳۷ ] پیشنهاد شد]، به کاربر کمک می کند تا تصمیم خود را برای حفظ حریم خصوصی بگیرد. ایده کلیدی به ساخت یک ساختار سرور LBS بستگی دارد که یک مبادله فوری بین حریم خصوصی و استفاده را فراهم می کند. در این ساختار، سرور LBS اطلاعات کمکی را در اختیار کاربر قرار می دهد تا از تصمیم حریم خصوصی او پشتیبانی کند تا از خطرات مربوط به سطح حریم خصوصی به دست آمده خود آگاه شود. این به کاربر کمک کرد تا پرس و جوهای خود را با دقت ایجاد کند.
شکری و همکاران [ ۳۸ ] ایده همکاری بین کاربران LBS برای اجتناب از برخورد با سرور LBS را پیشنهاد کرد. حفاظت از حریم خصوصی با پاسخ دادن به سؤالات در میان جمعیت تلفن همراه به دست می آید. ایده آنها بر اساس ذخیره پاسخ های پرس و جو در حافظه پنهان هر دستگاه تلفن همراه هر کاربر است. اگر کاربر بخواهد در مورد یک POI پرس و جو کند، سعی می کند با برقراری ارتباط با سایر کاربران پاسخ را دریافت کند. در صورت عدم پاسخگویی توسط سایر همتایان، کاربر مجبور خواهد شد به سرور LBS متصل شود. اشکالات ref. [ ۳۸ ] توسط الگوریتم انتخاب ساختگی پیشرفته (Enhanced-DSA) پیشنهاد شده در [ ۳۹ ] حل می شوند.]. حافظه پنهان دستگاه های تلفن همراه پاسخ های پرسش ها را ذخیره می کند تا تعامل بین کاربران مانع از برخورد آنها با سرورهای LBS غیرقابل اعتماد شود. استفاده از حافظه پنهان برای دستیابی به دو هدف اصلی با Dummies ترکیب شده است. اولین مورد، دستیابی به سطح ناشناس بودن k از طریق Dummies برای محافظت از حریم خصوصی کاربران LBS بود. مورد دوم، به حداقل رساندن احتمال اتصال به سرور LBS نامعتبر با انتخاب مکانهای آدمکهایی بود که سهم بیشتری در حافظه پنهان دستگاههای تلفن همراه دارند. به جای استفاده از حافظه پنهان دستگاه های تلفن همراه، نویسندگان [ ۴۰ ] از نقطه دسترسی (AP) برای نشان دادن حافظه پنهان استفاده کردند. بنابراین، آنها یک الگوریتم انتخاب ساختگی با آگاهی از حافظه پنهان (CaDSA) یکپارچه با حافظه پنهان پیشنهاد کردند. ایده الگوریتم CaDSA مستقیماً از ایده های هر دو الگوریتم DLS بهبود یافته الهام گرفته شده است که در [.۳۴ ] و الگوریتم DSA پیشرفته ارائه شده در [ ۳۹ ]. در مقایسه با الگوریتم های DLS بهبود یافته و DSA بهبود یافته، دو ویژگی اصلی الگوریتم CaDSA عبارتند از: ۱) استفاده از فاصله نرمال شده برای اطمینان از بهینه بودن dummies انتخاب شده، و ۲) استفاده از عبارت تازه سازی داده ها برای حفظ مهمترین موارد. پاسخ های پرس و جوها برای مدت طولانی، که به نوبه خود پاسخگویی به سؤالات آینده را افزایش داد.
۳٫ رویکرد حفاظت از حریم خصوصی پیشنهادی
این بخش سناریوی رویکرد پیشنهادی را بیان میکند که در آن معیارهای انتخاب رهبر برجسته میشود و پاسخ این سؤال را ارائه میدهد: اگر رهبر منتخب به عنوان یک مهاجم رفتار کند، چه؟
۳٫۱٫ رویکرد پیشنهادی (رهبر)
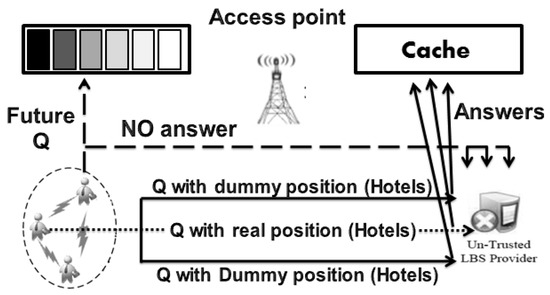
برای یک منطقه معین تقسیم شده به (n×n)سلول ها، تعدادی از کاربران در این منطقه توزیع شده اند به طوری که (g)کاربران در هر سلول قرار دارند و هر سلول شامل (پ)POI. سناریوی کلی، که رویکردهای مبتنی بر حافظه پنهان برای به حداقل رساندن شماره اتصال به سرور LBS نامعتبر دنبال میشوند، در شکل ۳ نشان داده شده است.
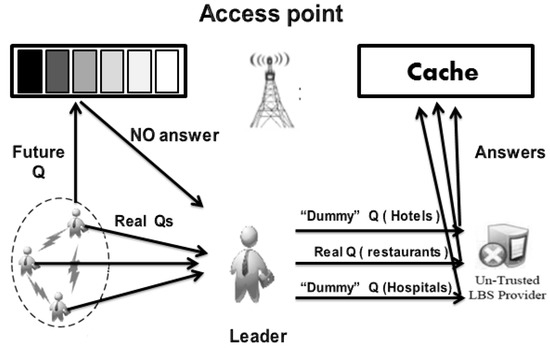
در شکل ۳، روش سنتی (یعنی کاربری که نگران حریم خصوصی نیست) ارسال پرس و جوهای واقعی با موقعیت های واقعی به سرور LBS با تهدید مستقیم حریم خصوصی است که با خط نقطه چین مشخص می شود (پرسیدن از نزدیکترین هتل ها برای مثال). برای محافظت از حریم خصوصی مکان، کاربر LBS عمداً درخواستهای زیادی را با موقعیتهای ساختگی ارسال میکند و از همان POI (یعنی نزدیکترین هتلها) که با خطوط پیوسته مشخص میشود، درخواست میکند. پاسخ های سرور LBS برای به دست آوردن مزایایی از پاسخگویی به سؤالات دریافتی با پیشرفت زمان (یعنی سؤالات آینده) در حافظه پنهان ذخیره می شوند. در مواردی که هیچ پاسخی در حافظه پنهان پیدا نمیشود، کاربر LBS مجبور میشود با ارائهدهنده LBS غیرقابل اعتماد که با خطوط چین مشخص شده است ارتباط برقرار کند. با این حال، حفاظت از حریم خصوصی پرس و جو در جایی که می توان حملات مبتنی بر تحلیل پرس و جو را اعمال کرد، تضمین نمی شود. برای داشتن پیشگیری کامل برای همه کاربران LBS، به جز رهبر، از اتصال به سرور LBS نامعتبر، رویکرد رهبر پیشنهاد شده است. ماهیت ایده ما به سود متقابل بین رهبر و سایر کاربران LBS بستگی دارد. با این حال، کاربرانی که در هر سلول قرار دارند در یک خوشه گروه بندی می شوند. از آنجا برای هر خوشه یک رهبر انتخاب می شود. برای صادرکننده پرس و جو، در صورتی که پاسخ پرس و جو در حافظه پنهان یافت نشد، صادر کننده پرس و جو را به رهبر ارسال می کند (به جای ارسال مستقیم درخواست به سرور LBS). سپس رهبر به نوبه خود آن را به سرور LBS نامعتبر ارسال می کند. پس از دستکاری پرس و جو در سمت سرور LBS، رهبر پاسخ را دریافت می کند و سپس پاسخ دریافتی را به کاربر مورد نظر (یعنی صادر کننده پرس و جو) برمی گرداند. به عبارت دیگر، رهبر از پرس و جوهای واقعی ساخته شده بر روی موقعیت های واقعی (و ارسال شده توسط اعضای خوشه) به عنوان آدمک در کنار خود بهره برداری می کند. سپس، رهبر پرس و جوی واقعی خود را با یک موقعیت واقعی بدون نیاز به تولید ساختگی در سطح مکان یا پرس و جو ارسال می کند. با در نظر گرفتن سه کاربر LBS که برای سه POI مختلف (نزدیکترین هتلها، رستورانها و بیمارستانها) جستجو میکنند.شکل ۴ یک نگاه جامع به مدل سیستم پیشنهادی ارائه می دهد، جایی که پاسخ های پرس و جوها در حافظه پنهان ذخیره می شوند تا بعدا مورد استفاده قرار گیرند.
طبق شکل ۴ ، کاربران LBS از حریم خصوصی خود (هم موقعیت مکانی و هم حریم خصوصی پرس و جو) محافظت می کنند، زیرا حتی اگر پاسخی برای پرس و جوها در حافظه پنهان پیدا نکنند، نیازی به اتصال مستقیم به سرور LBS نیست. بنابراین، آنها تحت هر معیار حریم خصوصی به حفاظت کامل از حریم خصوصی دست خواهند یافت.
بدون نیاز به ایجاد مکانهای نادرست (یعنی مکانهای ساختگی) یا دستکاری ویژگیهای پرس و جو برای ایجاد جستارهای ساختگی، از حریم خصوصی رهبر محافظت میشود زیرا Leader از جستارهای عضو خوشه به عنوان ساختگی سوء استفاده میکند. علاوه بر این، رهبر نیازی به استفاده از فاصله نرمال شده ذکر شده در [ ۴۰ ] ندارد] زیرا کاربران LBS بیشتر در سلولهایی قرار میگیرند که حاوی POI کاربرانی هستند که احتمالاً برای جستجو استفاده میشوند. با این حال، در همه موارد، مهاجم (سرور LBS) در تعیین صادرکننده پرس و جو (رهبر) دچار سردرگمی خواهد شد. علاوه بر این، حتی اگر مهاجم تجزیه و تحلیل را در مورد سؤالات ارسال شده توسط رهبر برای استنباط برخی از اطلاعات کمکی برای شروع حمله خود اعمال کند، تلاش های او بیهوده خواهد بود زیرا این اطلاعات استنباط شده به خود رهبر مربوط نمی شود، بلکه به اعضای خوشه مربوط می شود. برای معیارهای حریم خصوصی مرتبط با رهبر، معیاری پیشنهاد شده است که به معیار حریم خصوصی آنتروپی مکان بستگی دارد (این مورد در بخش بعدی مورد بحث قرار خواهد گرفت)، اما سؤال اصلی به شرح زیر است: معیارهای انتخاب رهبر چیست؟
از عبارتی که می توان از سناریوی موجود در شکل ۳ استنباط کرد ، که بیان می کند “اتصال به سرور LBS همچنان پابرجا است در صورتی که پاسخ پرس و جو در حافظه پنهان یافت نشود”، تعداد معینی از اتصالات به سرور LBS تصور می شود. و این مربوط به هر کاربر LBS در گذشته است.
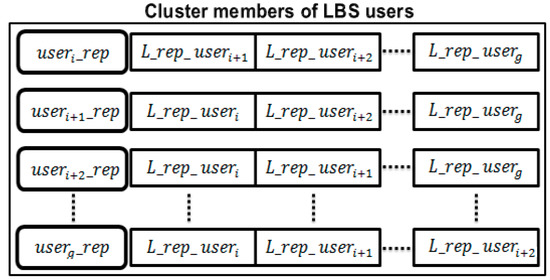
اجازه دهید S مجموعه ای از اتصالات بین کاربران LBS و سرور قبلی را نشان دهد (همانطور که در شکل ۱ نشان داده شده است ).
جایی که سیپآستی(Uمن)تعداد اتصالات به سرور LBS نامعتبر مربوط به است توسهrمن، سیپآستی(Uمن+۱)تعداد اتصالات مربوط به سرور LBS نامعتبر است توسهrمن+۱، و سیپآستی(Ug)تعداد اتصالات به سرور LBS نامعتبر مربوط به است توسهrg.
معیارهای انتخاب رهبر بر اساس حداکثر تعداد اتصالات به سرور LBS خواهد بود. بنابراین، رهبر، کاربری خواهد بود که شرایط زیر را برآورده کند:
دلیل این امر این است که احتمال حمله به او (یعنی کاربری که حداکثر تعداد اتصال به سرور LBS را دارد) در مقایسه با سایر اعضای خوشه بالاترین مقدار را خواهد داشت. حجم اطلاعاتی که در مورد او جمع آوری می شود از طرف مهاجم بیشترین مقدار را خواهد داشت. علاوه بر این، انتخاب کاربری که دارای حداقل تعداد اتصالات LBS باشد (به عنوان Leader) منجر به تأثیر منفی بر روی کاربری که حداکثر تعداد اتصالات LBS را دارد می شود. این مورد، کاربری را که حداکثر تعداد اتصالات سرور LBS را دارد، در موقعیت خطرناکی قرار میدهد، بهویژه زمانی که صحبت از اجبار مکرر اتصال سرور LBS به میان میآید (یعنی در مواردی که هیچ پاسخ پرس و جو در حافظه پنهان یافت نمیشود. ). این به این دلیل است که تعداد اتصالات به سرور LBS (مهاجم) افزایش می یابد، که به نوبه خود به مهاجم اجازه می دهد تا داده های حساس تری را درباره خود جمع آوری کند. به عبارت دیگر، انتخاب کاربر LBS که دارای حداقل تعداد اتصالات به سرور LBS است، به اعضای خوشه برای محافظت از حریم خصوصی در برابر سرور LBS مخرب خدمت نمی کند. در پرتو این بحث، نیاز کاربر LBS، که دارای حداکثر تعداد اتصالات سرور LBS است، به رهبر بودن دقیقاً با نیاز به جلوگیری کامل از اتصال سرور LBS در ارتباط با سایر اعضای خوشه مطابقت دارد. با انگیزه این منفعت متقابل زیربنای رابطه همزیستی، یک TTP قوی (رهبر) پیشنهاد شده است. شایان ذکر است که رویکرد TTP پاسخی بهینه برای سؤال مربوط به فرض TTPهای موجود در تمام کارهای قبلی است.
سوال مهم دیگری که مطرح می شود مربوط به اعتماد این رهبر منتخب است. سوال به شرح زیر است: “چرا باید به رهبر اعتماد کنیم و همزمان به سرور LBS اعتماد نکنیم؟” پاسخ این سوال در بخش فرعی بعدی ارائه شده است.
۳٫۲٫ اعتماد به رهبر
این بخش فرعی مسائل مربوط به اعتماد به رهبر منتخب را مورد بحث قرار می دهد. معیارهای اضافی را ارائه می دهد که به شهرت رهبر منتخب بستگی دارد، با در نظر گرفتن تأثیر شرط قبلی بیان شده توسط (۲).
برای متمایزتر کردن این کار نسبت به کارهای قبلی، پاسخی به سوال قبلی در بالا ارائه شده است تا سطح اعتماد اعضای خوشه به رهبر منتخبشان افزایش یابد. به طور خلاصه، مشکل را می توان با فرض اینکه احتمال تبدیل خود رهبر به مهاجم وجود دارد، توصیف کرد. از آنجایی که هیچ تفاوتی بین رهبر انتخاب شده و سرور LBS به عنوان TTP وجود ندارد، هر کاربر LBS موجود در هر خوشه می تواند انتظار داشته باشد که توسط رهبر ردیابی و مورد حمله قرار گیرد.
برای دستکاری این مشکل، ما چیزها را بر اساس سناریوی پیشنهادی در [ ۳۸ ] قرار دادیم زیرا ایده آنها می تواند به صورت محلی برای اعضای خوشه اعمال شود. هر کاربر LBS که در هر سلول قرار دارد می تواند اطلاعات برخی از POI های بازدید شده خود را در حافظه پنهان دستگاه های تلفن همراه خود ذخیره کند و می تواند این اطلاعات را به عنوان نوعی دست یاری به همسایگان ارسال کند تا از برخورد با اشخاص ثالث غیرقابل اعتماد خودداری کنند. ایده کلیدی ایجاد یک سطح اعتماد برای هر عضو خوشه به شرح زیر است: هر کاربر LBS عمداً یک پرس و جو (که قبلاً پاسخ آن را در حافظه پنهان دستگاه تلفن همراه خود دارد) به نام پرس و جو آزمایشی برای همه اعضای خوشه ارسال می کند. بر اساس پاسخ دریافتی میزان اعتماد مربوط به هر کاربر به جز فرستنده کاهش یا افزایش می یابد.
به طور کلی، اجازه دهید تیLمن(vآلتوه⃛)نشان دهنده مقدار سطح اعتماد a است توسهrمن، جایی که در آن واقع شده است توسهrمن+۱٫ اگر پاسخ دریافتی درست باشد، پس تیLمن(vآلتوه⃛)=تیLمن(vآلتوه⃛+۱). اگر پاسخ دریافتی جعلی است، پس تیLمن(vآلتوه⃛)=تیLمن(vآلتوه⃛-۱). مقدار جدید حاصل شهرت محلی نامیده می شود (توسهr_L_rهپ)مربوط به توسهrمنکه توسهrمن+۱درباره او ساخته شده است. با اعمال هر یک از اعضای خوشه این فرآیند بر روی بقیه، می توان شهرت محلی را به دست آورد. به عبارت دیگر، هر کاربری که در خوشه گنجانده شده است، دارای جفت مجموعه اندازه خواهد بود (g-1)در مورد شهرت محلی مربوط به هر یک از باقیمانده ها، و این شهرت محلی می تواند بسته به اعتبار پاسخ پرسش آزمایشی افزایش یا کاهش یابد. در نتیجه جفت های زیر را بدست می آوریم:
جایی که توسهrمن_L_rهپشهرت محلی ساخته شده در مورد است توسهrمنبا هر دو توسهrمن+۱و توسهrg، توسهrمن+۱_L_rهپشهرت محلی ساخته شده در مورد است توسهrمن+۱با هر دو توسهrمنو توسهrg، و توسهrg_L_rهپشهرت محلی ساخته شده در مورد است توسهrgبا هر دو توسهrمنو توسهrمن+۱٫
با تکیه بر مجموع ارزش های شهرت محلی ساخته شده توسط سایر اعضای خوشه ، شهرتتوسهrمنبه دست آمده است. بنابراین، توسهrمن_rهپ(vآل˜توه)، توسهrمن+۱_rهپ(vآل˜توه)، و توسهrg_rهپ(vآل˜توه)همانطور که در شکل ۵ در زیر نشان داده شده است محاسبه می شوند . توجه داشته باشید که این فرآیند در تمام خوشهها (یا سلولهای) درگیر در مدل سیستم ما تکرار میشود.
بر اساس نمایش در فرمول (۱)، هر یک توسهr_rهپ(vآل˜توه)تعداد معینی از اتصالات سرور LBS در گذشته مربوط به هر یک از اعضای خوشه را به شرح زیر مطابقت می دهد:
با ضرب دو جزء مربوط به هر کاربر در (۴)، شهرت عمومی جی_rهپهر کاربر به صورت زیر محاسبه می شود:
در نتیجه معیارهای جدید انتخاب رهبری عبارتند از:
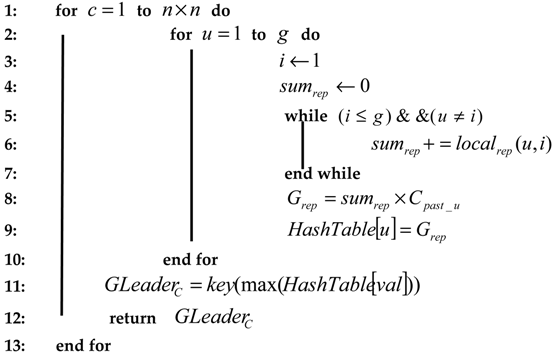
شایان ذکر است که یک مورد خاص ممکن است زمانی رخ دهد که حداکثر شهرت عمومی برای دو کاربر یا بیشتر یکسان باشد. در این صورت رهبر بر اساس همین معیارها به صورت تصادفی انتخاب می شود. پس از انتخاب رهبر بر اساس معیارهای جدید، همه اعضای خوشه برای دریافت پاسخ های واقعی به پرسش های خود که توسط رهبر خودشان به سرور LBS ارسال شده است، مورد اعتماد خواهند بود. شبه کد مربوطه برای انتخاب رهبر در الگوریتم ۱ گنجانده شده است.
| الگوریتم ۱: الگوریتم انتخاب رهبر |
| ورودی: n×n(تعداد سلول ها یا خوشه ها)، g(تعداد کاربران LBS در یک سلول یا خوشه)، سیپآستی_تو(تعداد اتصالات به سرور LBS در گذشته برای کاربر تو) اچآسساعتتیآبله(کهy=توسهr،vآل=جیrهپ). |
| خروجی: جیLهآدهrسی(شهرت عمومی رهبر در سلول ج) |
 |
الگوریتم ۲ شبه کد را برای محاسبه شهرت محلی نشان می دهد.
| الگوریتم ۲: محاسبه شهرت محلی ( محلیهرزه) |
| تابع محلیهرزه(ریکاوری کننده تو.فرستنده من) |
| ورودی: تیساس،آتیساس |
| خروجی: لoجآلrهپ |
| ۱: پاسخها reciever_u = تست i (TQ S ,u) |
| ۲: (نآرآ)=تعداد تطبیق (آnسwهrسrهجمنهvهr_تو،آتیساس) |
| ۳: ( NWA ) = تعداد ( TQ S ) – NRA |
| ۴: جدید (تیLrهجمنهvهr_تو)= قدیمی (تیLrهجمنهvهr_تو)+نآرآ-ندبلیوآ |
| ۵: لoجآلrهپ= جدید (تیLrهجمنهvهr_تو) |
| ۶: بازگشت لoجآلrهپ |
جایی که تیساسپرس و جوهای آزمایشی است، آتیساسپاسخ به سوالات آزمون است، (نآرآ)تعداد پاسخ های درست است، (ندبلیوآ)تعداد پاسخ های اشتباه است و تیLسطح اعتماد گیرنده است.
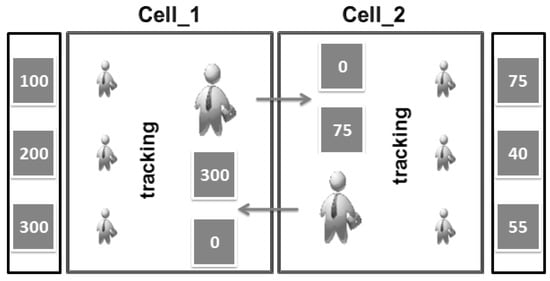
اگرچه انتخاب رهبر به شهرت عمومی او بستگی دارد، اما احتمال تبدیل شدن به یک مهاجم همچنان پابرجاست. به طور خاص، هیچ تضمینی وجود ندارد که اعضای خوشه ردیابی نشوند یا پرس و جوها توسط خود رهبر منتخب تجزیه و تحلیل و سپس مورد حمله قرار گیرند. از یک طرف، این احتمال به حداقل می رسد زیرا هم رهبر و هم اعضای خوشه اجسام متحرک در نظر گرفته می شوند. بنابراین، آنها می توانند خوشه خود را ترک کنند و به خوشه ها یا سلول های دیگر منتقل شوند. از سوی دیگر، اگر شهرت جهانی رهبر را در مواردی که او از خوشه خود خارج میشود، دوباره تنظیم کنیم، میتوانیم اطمینان حاصل کنیم که او دیگر رهبر نخواهد بود. شکل ۶ خلاصه ای از آنچه در این پاراگراف بحث شده است را نشان می دهد.
مطابق شکل ۶ ، دو رهبر بسته به حداکثر شهرت عمومی در بین اعضای خوشه در دو خوشه انتخاب می شوند و این شهرت جهانی برای هر دو رهبر پس از عبور از سلول های آنها بازنشانی می شود. سپس دو رهبر جدید بر اساس معیارهای مشابه انتخاب می شوند و هر عضو خوشه ای که از خوشه خود خارج شود تحت کنترل رهبر منتخب جدید عمل می کند. در نتیجه، نگرانی اعضای خوشه (در مورد عملکرد رهبر آنها به عنوان یک مهاجم) به حداقل می رسد. بنابراین، گام دوم و نهایی ما در مدل پیشنهادی به دست آمده است.
۴٫ معیارهای حریم خصوصی استفاده شده
به طور کلی، حمله نهایی و واقعی (یعنی دزدی، سرقت، تهدید یا باجگیری) که مهاجم علیه قربانی خود ایجاد میکند، پس از بهدستآمدن یک نمایه کامل که مملو از محتوای مخرب است و اطلاعات شخصی حساس را در خود دارد، رخ میدهد. این محتوای مخرب در طول زمان از طریق حملات زیر استنتاج جمع آوری می شود. هر گونه اطلاعات مفیدی که بتواند به مهاجم در تعیین لحظه مناسب حمله واقعی خود کمک کند به محتوای مخرب قبلی اضافه می شود.
۴٫۱٫ حملات استنتاج
در حملات استنتاج، مهاجم به استفاده از شهود خود برای به دست آوردن اطلاعات شخصی در مورد قربانی خود بستگی دارد. برخی از پیشرفته ترین حملات استنتاج به طور خلاصه در این بخش فرعی بررسی می شوند.
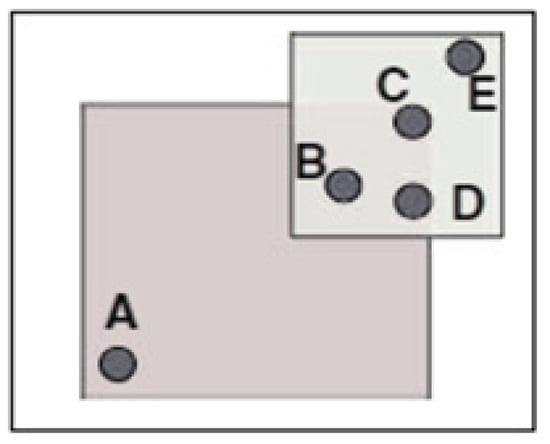
حمله همگنی [ ۴۲ ] به این معنی است که اگر کاربران در مکانی قرار گیرند که نشان دهنده یک نقطه عطف است (آنها موقعیت واقعی خود را از طریق محیط این نقطه عطف پنهان می کنند) مانند یک بیمارستان، مهاجم می تواند استنباط کند که آن کاربران مشکلات مربوط به خود را دارند. سلامت بدون نیاز به شناسایی دقیق موقعیت آنها، همانطور که در شکل ۷ نشان داده شده است.
حمله نمونه پرس و جو [ ۱۵ ، ۴۳ ، ۴۴ ] جایی است که مهاجم از توزیع مکان ناعادلانه کاربران LBS برای اهداف مخرب خود استفاده می کند. همانطور که در شکل ۸ نشان داده شده است، این نوع حمله استنتاج، کاربران ایزوله را در یک منطقه پراکنده هدف قرار می دهد .
حمله مکان معنایی [ ۴۵ ] جایی است که مهاجم می تواند معانی معنایی مربوط به رفتار کاربر را با بهره برداری از مدت زمانی که کاربر در یک مکان می ماند، مانند آزمایشگاه، بانک، یا دانشگاه استنباط کند.
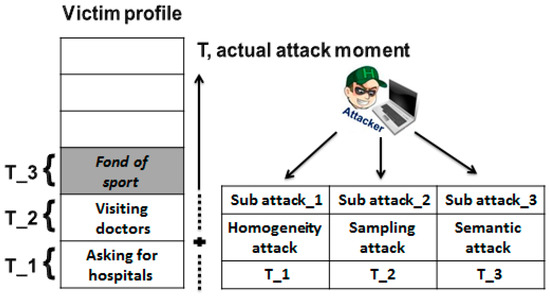
در هر لحظه که یک مهاجم یک حمله استنتاج را اعمال می کند، موفقیت کمی خواهد داشت. این تلاشهای موفقیتآمیز کوچک با بسیاری از حملات استنتاج فرعی مختلف در لحظات مختلف مرتبط است. افزودن این تلاشهای موفقیتآمیز کوچک، مهاجم را قادر میسازد تا به لحظه مناسبی برسد که در آن حمله واقعی را انجام دهد. هنگامی که این اتفاق می افتد، هدف هر رویکرد حفاظت از حریم خصوصی، درج اطلاعات متناقض در نمایه است، همانطور که قبلاً در مورد وضعیت کاربری که نگران حریم خصوصی خود است ذکر شد. همانطور که در شکل ۹ نشان داده شده است، این مهاجم را گیج می کند و مانع از توانایی او برای تعیین حمله واقعی خود می شود .
از شکل ۹ ، واضح است که در طرف مهاجم یک درگیری واضح در مورد اینکه آیا این کاربر LBS مشکل سلامتی دارد و باید در ورزش شرکت کند وجود دارد.
۴٫۲٫ انواع معیارهای حریم خصوصی استفاده شده
بسیاری از معیارهای حفظ حریم خصوصی در نظرسنجی ارائه شده در [ ۱۴ ] مورد بررسی قرار گرفتند]، جایی که این معیارهای حریم خصوصی برای ارزیابی میزان نقض حریم خصوصی کاربر LBS برای حریم خصوصی مکان و پرس و جو ارائه شده است. از آنجایی که هدف دستیابی به حریم خصوصی مکان و پرس و جو است، آنتروپی مکان انتخاب می شود زیرا این معیار می تواند برای هر دو جنبه استفاده شود. برای حفظ حریم خصوصی مکان، آنتروپی مکان عدم قطعیت در شناسایی موقعیت واقعی صادرکننده پرس و جو را با کمی کردن اطلاعات به دست آمده از طرف مهاجم از به روز رسانی های مکان مربوط به مسیر حرکت کاربران LBS اندازه گیری می کند. برای حفظ حریم خصوصی پرس و جو، آنتروپی مکان عدم مشاهده زمانی که کاربر LBS از یک POI بازدید می کند، اندازه گیری می کند. این کار بر محافظت از حریم خصوصی رهبر (هم مکان و هم حریم خصوصی پرس و جو) متمرکز بود زیرا رهبر تنها کاربر LBS در نظر گرفته می شود که به سرور LBS (یک حزب مخرب) متصل می شود.
با توجه به سناریوی پیشنهادی در شکل ۴ ، پرس و جوهای درگیر در سیستم را می توان به دو گروه عمده طبقه بندی کرد. مورد اول شامل پرس و جوهایی است که توسط کش پاسخ داده می شود و دومی شامل پرس و جوهایی است که توسط سرور LBS از طریق لیدر ارسال و پاسخ داده می شود. با توجه به این دو گروه، دو معیار حفظ حریم خصوصی در مدل پیشنهادی مورد نیاز است.
۴٫۲٫۱٫ متریک حریم خصوصی رهبر
از آنجایی که پرس و جوهای واقعی برای رهبر ارسال می شود که به عنوان آدمک در سمت او عمل می کنند، مفهوم ک-آnonyمترمنتیyبه طور خودکار برای محافظت از حریم خصوصی رهبر به دست می آید. اجازه دهید کنشان دادن به ک-آnonyمترمنتیyدر سطح τلحظه). اجازه دهید پمن(من=۱،۲،…،ک)نشان دهنده احتمال تشخیص است منتیساعتمکان به عنوان یک مکان واقعی در میان (ک-۱)آدمک، و اجازه دهید qمناحتمال پرس و جو را نشان می دهد منتیساعتمکان به شرح زیر
بنابراین، آنتروپی مکان در τلحظه را می توان به صورت زیر ارائه کرد:
وقتی همه کمکان های ممکن احتمال پرس و جو یکسانی دارند، E(τ)به حداکثر مقدار می رسد. در این حالت، آنتروپی مکان به صورت زیر خواهد بود:
در نظر بگیرید که E(τ)حداکثر=ب. برای یک معین E(τ)مقدار (برای مثال برابر با ۲) که در آن E(τ)<ب، این E(τ)ارزش را می توان از هر دو دیدگاه خواند (یعنی طرف رهبر و طرف مهاجم). از طرف رهبر، او به عنوان مثال بیان میکند: «من به حفاظت از حریم خصوصی دست یافتهام تا موقعیت واقعیام توسط مهاجمی فاش شود. (۲)ارزش و به اندازه E(τ)ارزش برای حفاظت از حریم خصوصی بالا». برای طرف مهاجم، گفته میشود: «من موقعیت واقعی قربانی خود را شناسایی میکنم (ب-۲)ارزش و به عنوان کم E(τ)وقتی توانستم موقعیت واقعی قربانی خود را به درستی شناسایی کنم، ارزش پیدا می کنم و بنابراین به لحظه شروع حمله نزدیکتر می شوم. به طور کلی، شکل ۱۰ معیار پیشنهادی جدید حریم خصوصی را در یک لحظه خاص از زمان نشان می دهد.
اجازه دهید Γ=(τ۱،τ۲،τ۳،…،τn)به لحظاتی اشاره کنید که در آن رهبر به سرور LBS متصل می شود که در آن برخی از حملات استنتاج اعمال می شوند. بدین ترتیب، λنشان دهنده نزدیکی مهاجم به لحظه شروع حمله است.
با توجه به شکل ۱۰ ، مشخص است که مقدار آنتروپی مکان متفاوت است، از آبه ب، Eنشان دهنده میزان حفاظت از حریم خصوصی در سمت رهبر، و (ب-آ-E)نشان دهنده نزدیکی مهاجم به حمله او علیه رهبر است. در نتیجه، معیار حریم خصوصی جدید را می توان به صورت زیر ارائه کرد:
جایی که τ∈Γ.
توجه داشته باشید که معیار حریم خصوصی پیشنهادی، که برای رهبر تخصصی است، میتواند یک معیار استاندارد در نظر گرفته شود. این معیار حریم خصوصی را می توان برای هر رویکردی که به هر کلاس ارائه شده در بررسی ادبیات تعلق دارد، اعمال کرد. دلیل این امر این است که هر کاربری که در هر سیستم LBS قرار می گیرد می تواند برای خود یک رهبر در نظر گرفته شود.
۴٫۲٫۲٫ متریک حریم خصوصی سیستم
به طور کلی، کاربرانی که پاسخهای پرس و جو خود را در حافظه پنهان پیدا میکنند، تحت هر معیار حریم خصوصی به ارزش کامل حریم خصوصی دست مییابند، زیرا از برخورد با سرورهای LBS غیرقابل اعتماد از طریق Leader جلوگیری میکنند و هیچ اطلاعاتی در مورد موقعیتهای واقعی و هم نمیتوان استنباط کرد. پرس و جوهای واقعی ما از معیار حریم خصوصی پیشنهاد شده در [ ۴۰ ] به نام نسبت ضربه حافظه پنهان (CHR) استفاده کردیم که پرس و جوهای پاسخ داده شده توسط کش را به نسبت تعداد کل پرس و جوهای درگیر در سیستم به صورت زیر اندازه گیری می کند:
۵٫ نتایج تجربی و ارزیابی
در این مقاله از نرم افزار Matlab برای پیاده سازی رویکرد پیشنهادی استفاده شده است. ورودی های شبیه سازی به این صورت فرض می شود که ناحیه مورد نظر به a تقسیم می شود (۱۶۰×۱۶۰)سلول و تعداد کاربران موجود در سیستم برابر است (۱۰۰۰۰). حافظه پنهان از طریق یک پایگاه داده که فقط از یک جدول تشکیل شده است، نشان داده می شود، جایی که اطلاعات مربوط به POI، موجود در سلول ها، از طریق پرس و جوهایی که توسط سرور LBS پاسخ داده می شود، ذخیره می شود. اطلاعات ذخیره شده در حافظه پنهان عمدتاً شامل نوع POI و موقعیت سلولی است که در داخل آن قرار دارد. یک مهر زمانی هم برای اطلاعات ذخیره شده در حافظه پنهان و هم برای پرس و جوها ضمیمه می شود تا از این مُهرهای زمانی، از طریق یک مقایسه ساده، برای دستیابی به عبارت تازگی داده ها استفاده شود. علاوه بر این، مُهرهای زمانی نیز به کاربران LBS متصل میشوند، زیرا آنها به عنوان اجسام متحرک در نظر گرفته میشوند. برای احتمال پرس و جو، به طور تصادفی با کمک ارائه شده توسط Google Maps API ایجاد می شود. POI ها ثابت در نظر گرفته می شوند و ما با پرس و جوهای متحرک سروکار نداشتیم.
سه رویکرد قبلی برای مقایسه با رویکرد پیشنهادی انتخاب شدهاند. آنها شامل DLS بهبود یافته [ ۳۴ ]، مخفی شدن در یک جمعیت سیار [ ۳۸ ] و بهبود یافته-CaDSA [ ۴۰ ] هستند.
۵٫۱٫ ارزیابی نتایج هزینه ارتباطات
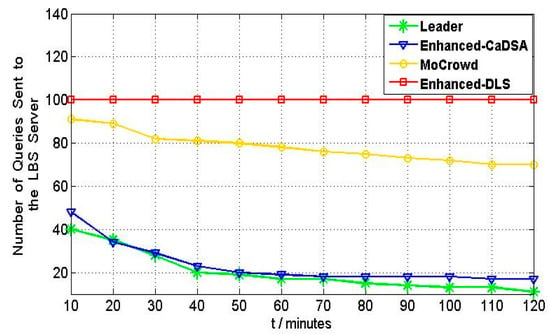
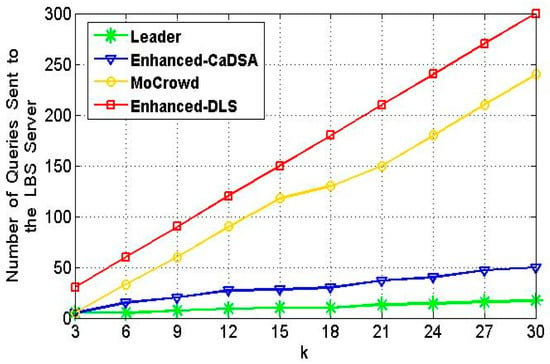
بر اساس هزینههای ارتباطی (تعداد پرسشهای ارسال شده به سرور LBS)، رویکرد پیشنهادی از دو جنبه ارزیابی میشود که عبارتند از تأثیر زمان در حین پیشرفت و تأثیر ک-ناشناس بودنارزش. فیلتر شکوفه برای جستجوی پاسخ سوالات در حافظه پنهان استفاده می شود زیرا به طور موثر زمان جستجو را به حداقل می رساند. با انجام این کار، پاسخ سیستم افزایش مییابد و شکاف پر میشود، زیرا رهبر برای محافظت از حریم خصوصی خود باید مدتی را برای دریافت پرسوجوهای واقعی از برخی از اعضای خوشه خود تلف کند.
شکل ۱۱یک عکس فوری گرفته شده با پیشرفت زمانی ۱۲۰ دقیقه را نشان می دهد. می توان نشان داد که DLS بهبود یافته بدترین عملکرد را در بین روش های دیگر ارائه می دهد. از ذخیره پاسخ پرس و جو استفاده نمی کند. بنابراین، تمام پرس و جوهای مربوط به کاربران به سرور LBS ارسال می شود. در روش های دیگر، تعداد پرس و جوهای ارسال شده به سرور LBS کاهش می یابد زیرا بسیاری از پرس و جوها پاسخ های خود را در حافظه پنهان پیدا می کنند. رویکرد Mobile Crowd نسبت به DLS بهبودیافته به عملکرد بهتری دست یافت، اما عملکرد آن بدتر از CaDSA بهبودیافته بود، در حالی که بهبود یافته CaDSA مکانهای ساختگی را انتخاب میکند که میتوانند سهم بیشتری را در حافظه پنهان بر اساس فاصله نرمال شده و شرایط تازگی دادهها وارد کنند. و جمعیت متحرک هیچ کدام را در نظر نگرفت. رویکرد پیشنهادی با توجه به دوره پیشرفت زمانی از آن پیشی میگیرد.
شکل ۱۲ از نتایج به دست آمده در جنبه اول پشتیبانی می کند (یعنی پیشرفت زمانی)، که در آن تعداد پرس و جوهای ارسال شده به سرور LBS در DLS پیشرفته به صورت خطی افزایش می یابد. کافزایش مییابد، و دوباره DLS بهبود یافته بدترین نتایج را در بین روشهای دیگر میدهد. Enhanced-CaDSA به دلیل طراحی کش خوب، عملکرد بهتری نسبت به DLS بهبود یافته و Mobile Crowd دارد. در مقایسه با CaDSA بهبود یافته، رویکرد پیشنهادی نتایج بهتری به دست میدهد. هر پرس و جو واقعی، که در رویکرد پیشنهادی به عنوان یک “ساختگی” عمل می کند، چندین ساختگی تولید شده در CaDSA پیشرفته را ترسیم می کند. در نتیجه، تعداد نمایش داده شد ارسال شده به سرور LBS، برای دستیابی به ک-ناشناس بودنمفهوم، بدیهی است کمتر خواهد بود.
۵٫۲٫ ارزیابی نتایج مقاومت در برابر حملات استنتاج
دستیابی به بالاتر ک-آnonyمترمنتیyسطح ترجیح داده می شود زیرا نشان دهنده سطح بالاتر حفاظت از حریم خصوصی است. با این حال، این ک-آnonyمترمنتیyسطح با تعداد ساختگی های تولید شده که به پرس و جو اصلی پیوست شده اند نشان داده می شود. این ک-آnonyمترمنتیyسطح به شدت با کیفیت ساختگی های تولید شده (یعنی تولید آدمک های قوی) همراه است. بنابراین، حتی اگر رویکرد رهبر به حداقل ها دست یابد ک-آnonyمترمنتیyدر مقایسه با بقیه، در واقع بهترین سطح حفاظت از حریم خصوصی را تحت عنوان تولید ساختگی به دست آورد. برای شفافتر کردن این ایده، تأثیر اعمال ترکیبی از حملات استنتاج با در نظر گرفتن کاربرد همان مورد بحث قرار میگیرد. ک-آnonyمترمنتیyسطح در هر رویکردی که در مقایسه ما گنجانده شده است.
زیرا معیار حریم خصوصی پیشنهادی جدید λمربوط به رهبران درگیر در سیستم است، ما نزدیکی مهاجم (سرور LBS یا نگهدارنده او) را به لحظه شروع حمله او علیه رهبران در پیشرفت زمانی ارزیابی کردیم. علاوه بر این، از آنجایی که مفهوم k-anonymity به طور خودکار در رویکرد پیشنهادی به دست می آید، کبرای هر خوشه روی ۶ تنظیم شده است (یعنی در هر لحظه، Leader علاوه بر پرس و جو واقعی مربوط به خود Leader، پنج پرس و جو واقعی را به عنوان dummies دریافت می کند تا به سرور LBS ارسال شود). تحت تهدید ترکیبی از حملات استنتاج (یعنی حمله ناهمگن، حمله نمونه گیری پرس و جو و حمله معنایی مکان)، یک عکس فوری در (تی=۱۲۰)گرفته شده است. وضعیت بیست رهبر با در نظر گرفتن آستانه ای برابر ارزیابی می شود (تیساعتr=0.8)، که در آن رهبر در شرایط خطرناک حمله توسط سرور LBS در نظر گرفته می شود. به منظور مقایسه یکسان بین رویکردها، تعداد یکسانی از کاربران LBS (یعنی ۲۰ نفر) به طور تصادفی از هر یک از سه رویکرد قبلی انتخاب می شوند تا تحت شرایط آستانه یکسان ارزیابی شوند. لازم به ذکر است که مدل تهدید ارائه شده در [ ۴۶ ] به عنوان مبنای رویکرد ما استفاده می شود، که در آن هر ۳ دقیقه یک نوع حمله استنتاج متفاوت به صورت دوره ای اعمال می شود. شکل ۱۳ نتایج را نشان می دهد. در نظر گرفته شده است که هر کاربر LBS درگیر در ارتقاء DLS، Mobile Crowd و پیشرفته-CaDSA یک رهبر در نظر گرفته می شود. مقایسه وضعیت خطرناک رهبران در جدول ۱ خلاصه شده است.
میز ۱نشان می دهد که رویکرد پیشنهادی دارای حداقل تعداد کاربران LBS است که به حالت خطرناک رسیده اند. سه چهارم رهبران و بیش از نیمی از رهبران به ترتیب از آستانه در Mobile Crowd و Enhanced-CaDSA فراتر رفتند. برای Enhanced-DLS، همه رهبران از آستانه فراتر رفتند زیرا مجبور هستند به سرور LBS نامعتبر متصل شوند و همیشه در برابر تهدیدات مستقیم آسیب پذیر شوند. از یک سو، به دلیل اینکه شهرت جهانی رهبران در رویکرد پیشنهادی بازنشانی شده است، و با توجه به تداوم بی پایان این ماموریت (یعنی ماموریت رهبر) در رویکردهای دیگر، حداقل تعداد کاربران LBS را به دست آوردیم که بیش از آن است. آستانه تعریف شده این به نوبه خود بدان معنی است که رویکرد رهبر بالاترین مقاومت را در برابر حملات استنتاج استفاده شده دارد. این استحکام را می توان از طریق پنهان کردن اعضای خوشه پشت رهبر خود توجیه کرد. به عبارت دیگر کاربران LBS در مقابل هر گونه حمله استنتاجی در سکوت کامل در چشم مهاجم هستند. بنابراین، کاربر LBS که در یک مکان مجزا قرار دارد (حمله نمونهگیری پرس و جو) یا کاربرانی که برای مدت طولانی در یک POI (حمله همگنی) اقامت دارند (حمله مکان معنایی) در امنیت کامل خواهند بود زیرا درخواستهای خود را به این آدرس ارسال میکنند. یک رهبر که در یک POI متفاوت قرار دارد.
از سوی دیگر و بر اساس این اصل که می گوید «پیشگیری بهتر از درمان است»، کاربران LBS که به وضعیت خطرناکی رسیده اند را می توان تغییر داد تا از ماموریت خود به عنوان رهبر دست بکشند و بنابراین مهاجم را از لحظه واقعی خود دور نگه دارند. راه اندازی حمله در مقایسه با Enhanced-DLS، Mobile Crowd و Enhanced-CaDSA، این قابلیت ارائه نشده است.
جدول ۲ نتایج جمع آوری شده در جدول ۱ را پشتیبانی می کند ، جایی که آستانه در مقادیر مختلف دوباره تعریف شد، شبیه سازی در عکس های فوری مختلف دوباره اجرا شد، رهبران مختلف به طور تصادفی انتخاب شدند و درصد رهبرانی که از آستانه ها فراتر رفتند محاسبه شد.
۵٫۳٫ ارزیابی نتایج نسبت ضربه حافظه پنهان
همانطور که در شکل ۱۴ نشان داده شده استدر زیر، پیشرفته-DLS به مقادیر صفر دست یافت زیرا از کش استفاده نمی کند. برای روشهای دیگر، نسبت ضربه حافظه پنهان در طول پیشرفت زمانی به دلیل وجود حافظه پنهان افزایش مییابد. Enhanced-CaDSA مقادیر نسبت ضربه کش بهتری را در مقایسه با Mobile Crowd ارائه می دهد. این به این دلیل است که مکانهای ساختگی که برای محافظت از حریم خصوصی کاربر LBS ایجاد شدهاند، از فاصله عادی استفاده میکنند که به نوبه خود کیفیت اطلاعات ذخیره شده در حافظه پنهان را بهینه میکند. علاوه بر این، عبارت تازهسازی دادهها، مهمترین اطلاعاتی را که انتظار میرود برای پاسخگویی به پرسشهای آینده استفاده شود، حفظ میکند. علاوه بر این، حافظه پنهان موجود در دستگاه های تلفن همراه کاربران را نمی توان با ذخیره سازی نقاط دسترسی، که نشان دهنده حافظه پنهان در Enhanced-CaDSA است، مقایسه کرد. علیرغم عملکرد خوب Enhanced-CaDSA، رویکرد پیشنهادی مقادیر نسبت ضربه کش بهتری را ارائه می دهد. (پ=۱۰۰)در سیستم در مقایسه با یک POI (پ=۱)مورد استفاده در CaDSA افزایش یافته است. دلیل این امر این است که رویکرد پیشنهادی به موقعیت های واقعی یا واقعی برای تولید ساختگی های ارسال شده به سرور LBS بستگی دارد. این بدان معناست که رویکرد رهبر از مکانهای دقیق کاربران استفاده میکند و از موقعیتهای واقعی آنها که احتمالاً برای جستجوی POI هستند، استفاده میکند. در زندگی روزمره، در مقایسه با انتخاب Dummies با استفاده از فواصل نرمال شده، استفاده از موقعیت های واقعی به عنوان dummies تأثیر بیشتری بر کیفیت اطلاعات ذخیره شده در حافظه پنهان دارد. پاسخ به پرس و جوهای ساختگی منجر به احتمال بیشتری برای پاسخ های پرس و جوی آینده موجود در حافظه پنهان می شود.
۶٫ نتیجه گیری
در این عصر تکنولوژی، حفظ حریم خصوصی یکی از دغدغه های اصلی کاربران دستگاه های تلفن همراه است. هنگامی که نوبت به دستیابی به حفاظت کامل از حریم خصوصی برای کاربران سرویس های مبتنی بر مکان می رسد، رویکرد رهبر مبتنی بر رابطه همزیستی پیشنهاد شده است. در میان گروه کاربران LBS (یک خوشه)، این رهبر بر اساس شهرت جهانی انتخاب می شود. این شهرت جهانی از طریق دو جنبه ارزیابی می شود، که عبارتند از (۱) تعداد اتصالات (که توسط کاربر LBS در گذشته انجام شده است) با سرور LBS و (۲) شهرت محلی که سایر اعضای خوشه برای رهبر ایجاد کرده اند. با این فرض که خود رهبر به عنوان یک مهاجم عمل می کند و برای جلوگیری از رهبر شدن مجدد این رهبر، شهرت جهانی او عمداً هنگام انتقال از یک خوشه به خوشه دیگر بازیابی می شود. افزایش سطح اعتماد اعضای خوشه به رهبر منتخبشان. در مقایسه با رویکردهای قبلی، رویکرد رهبر عملکرد بهتری را از نظر هزینه ارتباط و نسبت ضربه حافظه پنهان ارائه میدهد. علاوه بر این، با توجه به معیار حریم خصوصی جدید (نزدیک بودن مهاجم به لحظه حمله واقعی خود) و تحت ترکیب تهدیدی از حملات استنتاج پیشرفته (حمله همگنی، حمله نمونه پرس و جو، و حمله به مکان معنایی)، رویکرد رهبر بالاترین را دارد. استحکام در برابر حملات قبلی، که سطح بالایی از حفاظت از حریم خصوصی را تضمین می کند.
در کارهای آینده، حفاظت از حریم خصوصی پرسشهای ارسال شده به حافظه پنهان یا مواردی که بین کاربران LBS رد و بدل میشوند، مورد توجه قرار خواهد گرفت. علاوه بر این، بهینهسازی ویژگیهای کیفیت در دسترس بودن و قابلیت اطمینان سیستم با رفع مشکل قطع ارتباطی که میتوانست رخ دهد و مربوط به رهبر است، دستکاری میشود. علاوه بر این، استفاده از بهروزرسانی حافظه پنهان برای حفظ پاسخهای جالب در نظر گرفته میشود.