یک روش تعمیم خودکار برای یک منطقه شبکه جاده متراکم با در نظر گرفتن ویژگی های ساختاری فضایی به عنوان محدودیت


خلاصه

شبکه‌های جاده‌ای عناصر اسکلتی نقشه‌های توپوگرافی در مقیاس‌های مختلف هستند و انتخاب راه پیش‌نیاز اجرای نمایش‌های فضایی چند مقیاسی پیوسته شبکه‌های جاده‌ای است. رویکرد مبتنی بر مش یک روش رایج، پیشرفته و قدرتمند برای انتخاب جاده در مناطق متراکم جاده است که در آن مش‌های کوچک حذف شده و بخش‌های جاده با کمترین اهمیت در هر مش حذف می‌شوند. با این حال، مش های کوچک در نقشه را می توان به دو نوع تقسیم کرد: مش های کوچک جمع شده و مش های کوچک جدا شده. تعداد اولی کم و دومی زیاد است. روش‌های موجود عموماً برای روش دوم قابل اجرا هستند، و برخی یا حتی اکثر ویژگی‌های فضایی زمانی که در مورد اولی اعمال شوند، از بین خواهند رفت. در نتیجه کیفیت انتخاب جاده تحت تاثیر قرار خواهد گرفت. از این رو، به عنوان مکملی برای روش انتخاب مبتنی بر مش، این مقاله یک روش تعمیم خودکار مناطق شبکه جاده‌ای متراکم (مناطق تشکیل‌شده توسط مش‌های کوچک جمع‌آوری شده) را با در نظر گرفتن ویژگی‌های ساختاری فضایی به عنوان محدودیت پیشنهاد کرد. ابتدا نواحی انباشته مش‌های کوچک بر اساس تعداد مش‌های کوچک مجاور شناسایی شدند و مرزهای مناطق تجمع یافته استخراج شده و به عنوان محدودیت‌های سخت در هنگام حذف مش استفاده می‌شوند. دوم، مش های شروع با در نظر گرفتن همزمان ویژگی های لبه و تراکم مش مش های کوچک دوباره تعریف شدند و یک الگوریتم حذف ترتیبی برای حذف مش ها در جهت اتصال سکته مغزی پیشنهاد شد. سوم، انتخاب جاده با شناسایی مش های شروع و پردازش متوالی جفت مش مربوطه اجرا شد. این روند تکراری تا زمانی ادامه یافت که تمام تراکم مش مش های تازه تشکیل شده فراتر از آستانه باشد یا مشکل به یک مشکل حذف ساده تبدیل شود که شامل دو مش کوچک مجاور یا یک مش کوچک جدا شده است. در نهایت، یک نقشه راه توپوگرافی استاندارد ۱:۱۰۰۰۰ برای استان جیانگ سو، چین، برای اعتبارسنجی استفاده شد. نتایج تجربی نشان داد که در مناطق انباشته با دو مش کوچک، ۳۱ درصد از مناطق با استفاده از روش مبتنی بر مش و روش پیشنهادی، نتایج انتخاب یکسانی را به دست آوردند و ۶۹ درصد مابقی نتیجه فشرده تری با روش پیشنهادی به دست آوردند. . علاوه بر این، برای تمام مناطق انباشته با بیش از دو مش کوچک، ساختار توزیع فضایی مش‌های کوچک با روش پیشنهادی بهتر حفظ شد. در نهایت، یک نقشه راه توپوگرافی استاندارد ۱:۱۰۰۰۰ برای استان جیانگ سو، چین، برای اعتبارسنجی استفاده شد. نتایج تجربی نشان داد که در مناطق انباشته با دو مش کوچک، ۳۱ درصد از مناطق با استفاده از روش مبتنی بر مش و روش پیشنهادی، نتایج انتخاب یکسانی را به دست آوردند و ۶۹ درصد مابقی نتیجه فشرده تری با روش پیشنهادی به دست آوردند. . علاوه بر این، برای تمام مناطق انباشته با بیش از دو مش کوچک، ساختار توزیع فضایی مش‌های کوچک با روش پیشنهادی بهتر حفظ شد. در نهایت، یک نقشه راه توپوگرافی استاندارد ۱:۱۰۰۰۰ برای استان جیانگ سو، چین، برای اعتبارسنجی استفاده شد. نتایج تجربی نشان داد که در مناطق انباشته با دو مش کوچک، ۳۱ درصد از مناطق با استفاده از روش مبتنی بر مش و روش پیشنهادی، نتایج انتخاب یکسانی را به دست آوردند و ۶۹ درصد مابقی نتیجه فشرده تری با روش پیشنهادی به دست آوردند. . علاوه بر این، برای تمام مناطق انباشته با بیش از دو مش کوچک، ساختار توزیع فضایی مش‌های کوچک با روش پیشنهادی بهتر حفظ شد. و ۶۹ درصد باقی مانده نتیجه فشرده تری با روش پیشنهادی به دست آوردند. علاوه بر این، برای تمام مناطق انباشته با بیش از دو مش کوچک، ساختار توزیع فضایی مش‌های کوچک با روش پیشنهادی بهتر حفظ شد. و ۶۹ درصد باقی مانده نتیجه فشرده تری با روش پیشنهادی به دست آوردند. علاوه بر این، برای تمام مناطق انباشته با بیش از دو مش کوچک، ساختار توزیع فضایی مش‌های کوچک با روش پیشنهادی بهتر حفظ شد.

کلید واژه ها: 

تعمیم نقشه ; انتخاب شبکه جاده ای ; مناطق جمع شده از مش های کوچک ; محدودیت مرزی ; حذف ترتیبی

۱٫ معرفی

شبکه های جاده ای عناصر اسکلتی نقشه های توپوگرافی در مقیاس های مختلف هستند. برای به دست آوردن نمایش های فضایی چند مقیاسی پیوسته، شبکه های جاده ای نیاز به تعمیم دارند [ ۱ ، ۲ ، ۳ ]. مرحله کلیدی و اصلی در پردازش تعمیم، انتخاب راه است، که هدف آن کاهش سطح جزئیات در یک شبکه جاده‌ای با حفظ جاده‌های مهم و حذف جاده‌های کم‌اهمیت و در عین حال حفظ ویژگی‌های فضایی جاده اصلی و ساختار شبکه است [ ۴ ، ۵ ، ۶ ]، و همچنین خواص معنایی، توپولوژیکی و هندسی ضروری [ ۷]. با این محدودیت‌های انتخاب، حفظ ساختار توزیع فضایی شبکه راه‌ها سخت‌ترین بخش است. از این رو، انتخاب ساختار یافته شبکه‌های جاده‌ای اخیراً به تفصیل مورد مطالعه قرار گرفته است. در میان این مطالعات، رویکرد مبتنی بر مش [ ۸ ] به عنوان یک مدل رایج، پیشرفته و قدرتمند برای تکمیل کار انتخاب جاده در مناطق متراکم جاده گزارش شده است [ ۵ ، ۹ ، ۱۰ ]. تحقیق در این مقاله نیز در این زمینه قرار دارد.
برای به دست آوردن یک نتیجه انتخاب رضایت بخش برای شبکه های جاده ای، تحقیقات زیادی در سراسر جهان انجام شده است. روش های موجود را می توان به سه دسته تقسیم کرد، روش های مبتنی بر نظریه گراف، روش های مبتنی بر ضربه و روش های مبتنی بر مش. برای روش‌های مبتنی بر تئوری گراف، ساختار توپولوژیکی یک شبکه جاده‌ای توسط ساختار گراف [ ۱۱ ، ۱۲ ] گرفته می‌شود. با این حال، ساختارهای نمودار برای حفظ اتصال و یکپارچگی جاده ها مساعد نیستند [ ۱۳ ]. تامسون و همکاران [ ۱۴ ، ۱۵] با در نظر گرفتن اصل تداوم خوب در روانشناسی گشتالت، روشی مبتنی بر سکته را پیشنهاد کرد. بخش های جاده در یک سکته مغزی به عنوان یک واحد در فرآیند انتخاب تلقی می شوند. یعنی به طور همزمان حذف یا انتخاب می شوند. با در نظر گرفتن اهمیت هر جاده، روش مبتنی بر سکته مغزی حذف انتخابی را با حذف کم‌اهمیت‌ترین ضربه جاده به طور مکرر انجام می‌دهد [ ۱۶ ، ۱۷ ]. اتصال و یکپارچگی جاده ها در این روش به خوبی حفظ می شود، و به طور گسترده توسط محققان مورد استفاده قرار گرفت [ ۱۸ ، ۱۹ ]. با این حال، الگوهای هندسی یک شبکه جاده‌ای که معمولاً به صورت الگوهای شبکه‌ای از بخش‌های جاده نشان داده می‌شوند، نمی‌توانند در این روش منعکس شوند. برای رسیدگی به محدودیت‌های روش‌های مبتنی بر سکته مغزی، چن و همکاران. [۸ ] یک روش انتخاب راه را بر اساس تراکم مش شبکه جاده ای پیشنهاد کرد که روش مبتنی بر مش فوق الذکر است. در این روش، تمام مش های کوچک با تراکم مش بیش از مقدار آستانه به ترتیب حذف می شوند و بخش های جاده با کمترین اهمیت در هر مش کوچک حذف می شوند. این روش قادر است به طور موثر خصوصیات کلی شبکه و تغییرات چگالی محلی را در مناطق مختلف منعکس کند. لی و ژو [ ۲۰ ] نشان دادند که رویکرد مبتنی بر مش بهترین عملکرد را برای جاده‌های الگوی منطقه‌ای دارد (یعنی بخش‌های جاده‌ای که یک یا دو مش را تشکیل می‌دهند). وو و همکاران [ ۲۱ ] و Touya [ ۵ ] همچنین رویکرد مبتنی بر مش را برای انتخاب جاده در مناطق شهری به کار بردند و نتایج رضایت بخشی را به دست آوردند.
بر اساس تعداد مش های کوچک مجاور، شبکه راه را می توان به سه نوع تقسیم کرد: (۱) شبکه های کوچک جدا شده، که هیچ مشبک کوچک مجاور ندارند، همانطور که در قسمت خاکستری در شکل ۱ نشان داده شده است . (۲) مش های کوچک جمع شده، که دارای دو یا چند مش کوچک مجاور هستند، همانطور که در قسمت آبی در شکل ۱ نشان داده شده است . و (۳) مش های دیگر، که مش های کوچک نیستند، همانطور که در قسمت زرد در شکل ۱ نشان داده شده است.. مطالعات موجود برای مناطقی با مش های کوچک جدا شده، که اکثریت قریب به اتفاق همه مش های کوچک روی نقشه را تشکیل می دهند، عملی تر و قابل اجرا هستند. با این حال، برخی از مش های کوچک جمع شده در بلوک های مسکونی یا مناطق بزرگ کارخانه وجود دارد. ویژگی‌های فضایی معمول این مناطق که به مورفولوژی مرز خوشه‌ای، آرایش مش و یکنواختی مش اشاره دارد، با استفاده از روش‌های انتخاب مبتنی بر مش از بین می‌رود. اگرچه تعداد کمی از مش های کوچک انباشته شده به طور کلی روی نقشه وجود دارد، این مش ها هنوز نقش مهمی در کیفیت فرآیند انتخاب دارند. بنابراین، به عنوان مکمل روش انتخاب مبتنی بر مش، یک روش تعمیم خودکار مناطق شبکه جاده‌ای متراکم با در نظر گرفتن ویژگی‌های ساختاری فضایی به عنوان محدودیت در این مطالعه پیشنهاد شد.
مقاله بصورت زیر مرتب شده است. بخش ۲ روش پیشرفته انتخاب شبکه جاده مبتنی بر مش را ارائه می‌کند و محدودیت‌های آن را برای تعمیم شبکه جاده‌ای در مناطق شبکه جاده‌ای متراکم تحلیل می‌کند. بخش ۳ یک روش تعمیم خودکار را برای مناطق شبکه جاده ای متراکم با در نظر گرفتن ویژگی های ساختاری فضایی به عنوان محدودیت معرفی می کند. بخش ۴ مجموعه ای از آزمایش ها را برای تأیید اعتبار و برتری روش پیشنهادی ارائه می دهد. نتیجه گیری در بخش ۵ ارائه شده است.

۲٫ آثار مرتبط

۲٫۱٫ روش های انتخاب مبتنی بر مش فعلی

رویکرد سنتی مبتنی بر مش توسط چن و همکاران ارائه شد. [ ۸ ]، که در آن مش به عنوان یک منطقه بسته که توسط چندین بخش جاده احاطه شده است تعریف می شود. مراحل دقیق در این روش به شرح زیر است [ ۸ ، ۱۰ ]:
مرحله ۱: ساخت توپولوژی گره-قوس-چند ضلعی شبکه جاده و شناسایی مش ها بر اساس چند ضلعی های توپولوژیکی.
مرحله ۲: چگالی هر مش در یک شبکه جاده را مطابق رابطه (۱) محاسبه کنید:

D=پآ

که در آن D چگالی مش، P محیط مش، و A مساحت مش است.

مرحله ۳: با استفاده از یک الگوریتم آماری بر اساس داده های نمونه، آستانه چگالی مش را با توجه به مقیاس هدف تعیین کنید.
مرحله ۴: مش هایی را که چگالی فراتر از آستانه دارند، شناسایی کنید، آنها را به عنوان مش های کوچک تعریف کنید، و آنها را به مجموعه کاندید برای پردازش اضافه کنید.
مرحله ۵: مش های کوچک در مجموعه کاندید را به ترتیب نزولی مرتب کنید و اول آن را که بیشترین تراکم مش را دارد مدیریت کنید.
مرحله ۶: اهمیت محدود کردن بخش های جاده را مقایسه کنید و کم اهمیت ترین بخش را حذف کنید. اهمیت هر بخش لبه با معادله (۲) [ ۸ ، ۱۰ ] محاسبه می شود:

من=حداکثر{ω۱سی،ω۲Dاس،ω۳Lاس،ω۴L}

جایی که I شاخص اهمیت هر بخش را نشان می دهد، C کلاس جاده نرمال شده است ، Ds درجه نرمال شده حرکت جاده است که بخش ها در آن قرار دارند، Ls طول نرمال شده مسیر حرکت جاده، L طول نرمال شده است . بخش جاده، max{*} تابعی است برای تعیین اهمیت بخش ها، و ωمن. ( i = ۱، ۲، ۳، ۴) وزن هر پارامتر را نشان می دهد. قبل از محاسبه، این چهار پارامتر از طریق الگوریتم نرمال سازی min-max به (۰، ۱) نرمال می شوند و ω۱، ω۲، ω۳، و ω۴به ترتیب روی ۱۰ ۴ ، ۱۰ ۳ ، ۱۰ ۲ و ۱۰ تنظیم می شوند.

مرحله ۷: بخش های باقی مانده را با مش مجاور ادغام کنید و یک مش جدید تشکیل دهید.
مرحله ۸: چگالی مش جدید را محاسبه کنید و اگر چگالی مش آن از آستانه فراتر رفت، آن را به مجموعه کاندید اضافه کنید.
مرحله ۹: مراحل ۵-۸ را تکرار کنید تا مجموعه مش های کوچک خالی شود.
فرآیند فوق در شکل ۲ نشان داده شده است . در شکل ۲ الف، ابتدا مش با بیشترین چگالی ۰٫۴۲ با مش با چگالی ۰٫۴۰ ادغام شده و بخش نسبتاً بی اهمیت L حذف شده است. سپس چگالی (۰٫۱۶) مش جدید به روز می شود ( شکل ۲ ب). این فرآیند به طور مکرر تکرار می شود تا زمانی که تراکم تمام مش ها از آستانه معین کوچکتر شود، نتیجه حذف نهایی در شکل ۲ c نشان داده شده است.
نمودار جریان در شکل ۳ نشان داده شده است .

۲٫۲٫ محدودیت های روش انتخاب مبتنی بر مش

مش های کوچک در نقشه را می توان به دو نوع تقسیم کرد: مش های کوچک جمع شده و مش های کوچک جدا شده. مطالعات موجود عموماً برای مناطقی با مش های جدا شده کوچک، که اکثریت قریب به اتفاق مش های کوچک روی نقشه را تشکیل می دهند، عملی و قابل اجرا هستند. نتایج انتخاب در این مناطق می تواند با روش های موجود، ساختار فضایی و ویژگی های تراکم شبکه های جاده ای را به خوبی حفظ کند. با این حال، تعداد کمی از مناطق با شبکه های کوچک انباشته در بلوک های مسکونی یا منطقه کارخانه های بزرگ وجود دارد و ویژگی های فضایی معمولی این مناطق با استفاده از روش سنتی انتخاب مبتنی بر مش از بین می رود. اگرچه تعداد مش های کوچک جمع آوری شده روی نقشه کم است، نتایج انتخاب این مناطق همچنان بر کیفیت کل منطقه تأثیر می گذارد.
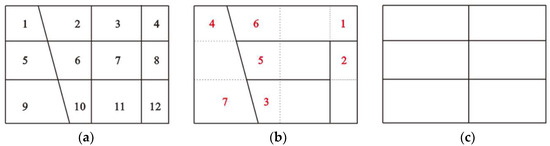
همانطور که در شکل ۴ الف نشان داده شده است، منطقه جمع شده شامل ۱۲ مش کوچک است که با اعداد سیاه مشخص شده اند. شکل ۴ b نتیجه انتخاب روش مبتنی بر مش را نشان می دهد و اعداد قرمز ترتیب حذف را توصیف می کنند. ساختار شبکه منظمی که توسط این ۱۲ مش کوچک تشکیل شده است از طریق این ترتیب حذف به دست نمی‌آید و ویژگی‌های ساختار فضایی داده‌های اصلی به وضوح تغییر می‌کند. در مقابل، نقشه‌بردار انسان با دیدگاهی جهانی به دنبال به دست آوردن خروجی است که در آن ویژگی‌های اصلی این مش‌های کوچک به خوبی انتزاع شوند [ ۴ ]. همانطور که در شکل ۴ ج نشان داده شده است، این نتیجه درک بهتری از ساختار شبکه راه ها ارائه می دهد.

۳٫ روش شناسی

به عنوان مکمل روش انتخاب مبتنی بر مش رایج، یک روش تعمیم خودکار مناطق شبکه جاده‌ای متراکم با در نظر گرفتن ویژگی‌های ساختاری فضایی به عنوان محدودیت در این مقاله پیشنهاد شده‌است. این روش شامل چهار مرحله زیر است: (۱) شناسایی مناطق انباشته برای مش های کوچک و استخراج مرزهای آنها برای ایجاد محدودیت های سخت در طول انتخاب جاده. (۲) تعریف مجدد مش های شروع برای حذف مش با در نظر گرفتن همزمان ویژگی های مرزی و چگالی مش. (۳) ایجاد یک الگوریتم حذف ترتیبی، که در آن مش ها در جهت اتصال سکته مغزی حذف می شوند.

۳٫۱٫ شناسایی مناطق تجمیع شده برای مش های کوچک و استخراج مرزهای آنها

تعیین آستانه چگالی مش یک مرحله اصلی در شناسایی مش های کوچک است. چن و همکاران [ ۸ ] یک الگوریتم آماری نمونه پیشنهاد کرد که در آن مقدار آستانه مناسب بر اساس گره‌های تقسیم منحنی توزیع چگالی مش در دو مقیاس قبل و بعد از تعمیم شبکه جاده تعیین می‌شود. برای مثال، آزمایش‌های عملی ثابت کردند که ۰٫۰۱۶ متر بر متر مربع، مقدار مناسب آستانه چگالی برای تبدیل از داده‌های شبکه جاده‌ای شهری ۱:۱۰۰۰۰ به ۱:۵۰۰۰۰ در نظر گرفته می‌شود [ ۱۰ ].]. به همین ترتیب، مش هایی با تراکم مش بزرگتر از آستانه به عنوان مش های کوچک تعریف می شوند. این مقاله بر عملیات انتخاب جاده در مناطق انباشته از مش های کوچک متمرکز است. رابطه مجاور بین دو مش کوچک بر اساس توپولوژی گره-قوس-چند ضلعی محاسبه می شود. اگر دو مش کوچک (یعنی چند ضلعی) یک بخش مشترک را به اشتراک بگذارند، مجاور یکدیگر در نظر گرفته می شوند.
مطالعات قبلی نشان داده‌اند که ویژگی مرزی پارامتر مهمی است که می‌تواند ساختار فضایی یک شی را در نقشه‌هایی با مقیاس بزرگ توصیف کند. در این مقاله، مرز هر ناحیه انباشته از مش های کوچک با توجه به توپولوژی استخراج شده و به عنوان یک محدودیت سخت استفاده می شود، یعنی مرز مستقیماً حفظ می شود و در طول فرآیند حذف حذف نمی شود.

۳٫۲٫ تعریف مجدد مش های شروع برای حذف مش

برای روش مبتنی بر مش معمولی، مش کوچک با بیشترین تراکم مش به عنوان مش شروع انتخاب می شود. با این حال، اگر مش شروع در وسط یک منطقه انباشته از مش های کوچک قرار گیرد، کنترل نتیجه حذف مش دشوار است و تغییر ساختار توزیع فضایی شبکه اصلی راه آسان است. از این رو، مش شروع را با در نظر گرفتن همزمان ویژگی‌های مرزی و چگالی مش مش‌های کوچک، دوباره تعریف می‌کنیم، مش شروع از یک مش کوچک به یک جفت مش کوچک مجاور تغییر می‌کند. دلیل این کار شرح زیر است. اولا، در مقایسه با پردازش تنها یک مش در یک زمان، پردازش جفت مش های مجاور برای کنترل ساختار فضایی محلی شبکه جاده ها مساعدتر است. دومین، انتخاب جاده از مناطق مرزی به داخل شبکه می تواند از مشکلات ناشی از انتخاب از مرکز شبکه جاده جلوگیری کند. با در نظر گرفتن دو محدودیت فوق، مش های شروع برای حذف مش در این مقاله به عنوان دو مش مجاور با بیشترین تراکم مش و واقع در بیرونی ترین قسمت مناطق تجمع مجدداً تعریف می شوند. اگر دو یا چند جفت مش دارای معیارهای مساوی هستند، بخش های جاده مشترک بین مش های کوچک مجاور در هر جفت مش را شناسایی کنید و اهمیت بخش های جاده را مقایسه کنید. جفت مش با کم اهمیت ترین بخش جاده به عنوان جفت مش شروع در نظر گرفته می شود. مش های شروع برای حذف مش در این مقاله به عنوان دو مش مجاور با بیشترین تراکم مش و واقع در بیرونی ترین قسمت مناطق تجمع مجدداً تعریف می شوند. اگر دو یا چند جفت مش دارای معیارهای مساوی هستند، بخش های جاده مشترک بین مش های کوچک مجاور در هر جفت مش را شناسایی کنید و اهمیت بخش های جاده را مقایسه کنید. جفت مش با کم اهمیت ترین بخش جاده به عنوان جفت مش شروع در نظر گرفته می شود. مش های شروع برای حذف مش در این مقاله به عنوان دو مش مجاور با بیشترین تراکم مش و واقع در بیرونی ترین قسمت مناطق تجمع مجدداً تعریف می شوند. اگر دو یا چند جفت مش دارای معیارهای مساوی هستند، بخش های جاده مشترک بین مش های کوچک مجاور در هر جفت مش را شناسایی کنید و اهمیت بخش های جاده را مقایسه کنید. جفت مش با کم اهمیت ترین بخش جاده به عنوان جفت مش شروع در نظر گرفته می شود.
مجموع چگالی مش دو مش مجاور به راحتی قابل محاسبه است و مکان مش ها با میدان مجاور مرتبه اول آنها تعیین می شود. برای یک مش کوچک، میدان مجاور مرتبه اول آن ناحیه ای است که توسط مش های کوچکی که بخش ها یا گره های مشترکی را با آن به اشتراک می گذارند تشکیل شده است. بدیهی است که مش های کوچک واقع در مرز کمترین تعداد مش های کوچک را در میدان مجاور مرتبه اول دارند.
همانطور که در شکل ۵ الف نشان داده شده است، برای مش با چگالی ۰٫۴۲ (اسطوخودوس)، مش ها در زمینه های مجاور مرتبه اول آنهایی هستند که تراکم ۰٫۴۰، ۰٫۳۸ و ۰٫۲۸ (صورتی) و تعداد مش های کوچک در میدان مجاور مرتبه اول ۳ است. به طور مشابه، در شکل ۵ ب، برای مش با چگالی ۰٫۳۸ (اسطوخودوس)، میدان مجاور مرتبه اول شامل مش هایی با تراکم ۰٫۴۲، ۰٫۴۰، ۰٫۲۸، ۰٫۲۶ و ۰٫۳۴ (صورتی) است. ) و عدد ۵ است. بنابراین، مش با چگالی ۰٫۴۲ نزدیکتر به مرز شبکه قرار دارد تا با چگالی ۰٫۳۸٫ علاوه بر این، جفت مش کوچک تشکیل شده توسط مش ها با تراکم ۰٫۴۲ و ۰٫۴۰ (نارنجی) دارای بیشترین تراکم مش جمع شده است و این مش ها به عنوان مش های شروع انتخاب می شوند.

۳٫۳٫ الگوریتم حذف ترتیبی

همانطور که در بخش ۲٫۲ توضیح داده شد ، ترتیب حذف مش عامل مهم دیگری برای حفظ ساختار فضایی یک شبکه راه است. برای به دست آوردن یک نتیجه حذف بهبود یافته، ما یک الگوریتم حذف ترتیبی را پیشنهاد می‌کنیم که در آن مش‌ها با توجه به جهت‌های اتصال سکته مغزی، به عنوان مثال، جهت اتصال بخش‌های جاده حذف می‌شوند. در این مطالعه، سکته‌ها بر اساس توپولوژی گره قوسی شبکه جاده‌ای با در نظر گرفتن نام و جهت بخش‌های جاده در یک تقاطع ساخته می‌شوند. این فرآیند در مطالعه قبلی ما [ ۲۲ ] به تفصیل شرح داده شد.
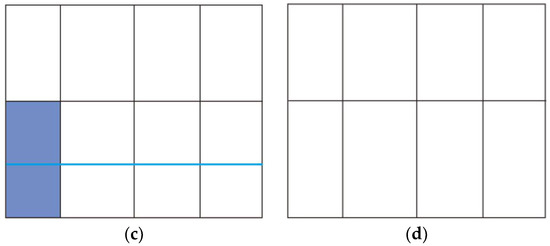
با استفاده از الگوریتم حذف ترتیبی برای یک جفت مش انتخاب شده برای پردازش در مناطق انبوه مش های کوچک، ابتدا بخش مشترک بین مش ها مشخص می شود. سپس، سکته مغزی که در آن بخش مشترک قرار دارد، شناسایی می‌شود و سایر جفت‌های مش که بخش‌های دیگر جاده را در این سکته مشترک دارند، گرفته می‌شوند. برخلاف روش متداول مبتنی بر مش، این روش از فرآیند حذف استفاده می‌کند که بر اساس تراکم مش به ترتیب نزولی نیست، اما در عوض ترتیب اتصال stroke است. مزیت این رویکرد این است که می توان از از دست دادن ساختار فضایی ناشی از برخی ضربه های قدیمی جلوگیری کرد. همانطور که در شکل ۶ نشان داده شده استالف، مش های با تراکم ۰٫۴۲ و ۰٫۴۰ (نارنجی) به عنوان مش های شروع تعریف می شوند و Stroke S (آبی) جایی که بخش مشترک آنها قرار دارد مشخص شده است ( شکل ۶ ب). سایر جفت‌های مش که در سایر بخش‌های جاده مشترک هستند به ترتیب حذف می‌شوند و نتیجه حذف در شکل ۶ ج نشان داده شده است. شکل ۶ d نتیجه حذف را بر اساس در نظر گرفتن چگالی مش به ترتیب نزولی نشان می دهد. واضح است که نتیجه حذف بر اساس ترتیب اتصال سکته مغزی می تواند ساختار فضایی اصلی را بهتر انتزاع کند.

۳٫۴٫ پردازش تکراری

برای از بین بردن تمام مناطق انباشته مش های کوچک، یک الگوریتم پردازش تکراری پیشنهاد شده است. گردش کار برای این الگوریتم شامل مراحل زیر است:
مرحله ۱: تعیین مقدار آستانه چگالی مش و طبقه بندی مش های کوچک با استفاده از یک الگوریتم آماری بر اساس داده های نمونه.
مرحله ۲: مناطق انباشته از مش های کوچک را از شبکه جاده شناسایی کنید و آنها را به مجموعه کاندید برای پردازش اضافه کنید.
مرحله ۳: به طور تصادفی یک منطقه جمع شده را انتخاب کنید، مرز را استخراج کنید، و از نتیجه به عنوان یک محدودیت سخت در طول فرآیند حذف مش استفاده کنید.
مرحله ۴: مش های شروع را در این ناحیه انبوه بر اساس الگوریتم بخش ۳٫۲ شناسایی کنید و ابتدا مش های شروع را مدیریت کنید.
مرحله ۵: بخش مشترک مش های شروع را شناسایی کنید و سکته مغزی مرتبط با بخش مشترک را تشخیص دهید.
مرحله ۶: رابطه فضایی بین سکته مغزی و ناحیه تجمع یافته را تعیین کنید. اگر سکته مغزی از ناحیه انباشته شده عبور کرد، منطقه انباشته شده را بر اساس این ضربه به دو ناحیه زیر انباشته تقسیم کنید و مرحله ۷ را پردازش کنید. در غیر این صورت مستقیماً به مرحله ۷ بروید.
همانطور که در شکل ۷ الف نشان داده شده است، سکته مغزی جاده S1 از منطقه تجمیع شده عبور می کند، و بخش های جاده a و b در داخل منطقه تجمعی هستند. اگر این دو بخش جاده به طور مستقیم حذف شوند، اتصال S1 از بین خواهد رفت. بنابراین، محدودیت زیر باید در فرآیند حذف استفاده شود: اگر یک سکته مغزی از یک منطقه تجمیع شده عبور می کند، منطقه انباشته را بر اساس این سکته مغزی به دو ناحیه زیر انباشته تقسیم کنید و الگوریتم پردازش تکراری را برای هر منطقه زیر تجمعی اجرا کنید. همانطور که در شکل ۷ ب نشان داده شده است، منطقه اصلی تجمع مش های کوچک به دو ناحیه زیر انباشته (سبز و آبی) بر اساس سکته مغزی S1 تقسیم می شود.
مرحله ۷: الگوریتم حذف ترتیبی را در بخش ۳٫۳ پیاده سازی کنید و پردازش جفت های مش را که stroke را به هم متصل می کنند، به پایان برسانید.
مرحله ۸: مش های شروع جدید را بدون در نظر گرفتن مش های تازه تشکیل شده به دست آمده در مراحل ۵-۷ شناسایی کنید.
همانطور که در شکل ۸ الف نشان داده شده است، دو مش کوچک مجاور به رنگ نارنجی مش های شروع در دور اول هستند و مش های تازه تشکیل شده (نارنجی در شکل ۸ ب) در شناسایی مش های شروع در دور دوم شرکت نمی کنند. بنابراین، همانطور که در شکل ۸ ج نشان داده شده است، دو مش کوچک مجاور که به رنگ آبی نشان داده شده اند، مش های شروع دور دوم هستند و نتیجه انتخاب نهایی در شکل ۸ d نشان داده شده است.
مرحله ۹: مراحل ۵ تا ۸ را تکرار کنید تا زمانی که هیچ مش شروع جدیدی شناسایی نشود. در این مرحله، دور اول حذف مش به پایان رسید.
مرحله ۱۰: چگالی همه مش‌های تازه تشکیل‌شده را محاسبه کنید و این مقادیر را با آستانه مقایسه کنید تا مش‌های کوچک جدید را در این ناحیه جمع‌آوری کنید.
مرحله ۱۱: مراحل ۴ تا ۱۰ را تکرار کنید تا زمانی که تراکم مش مش های تازه تشکیل شده از آستانه فراتر رود یا فقط دو مش کوچک در این ناحیه جمع شده وجود داشته باشد.
مرحله ۱۲: بخش مشترک دو مش کوچک را حذف کنید، چگالی مش جدید را محاسبه کنید و این مقدار را با آستانه مقایسه کنید. اگر از آستانه فراتر رفت، به مرحله بعدی بروید.
مرحله ۱۳: این مش کوچک جدید را با استفاده از روش مبتنی بر لبه سکته مغزی پردازش کنید [ ۱۰ ].
مرحله ۱۴: مراحل ۳ تا ۱۳ را تکرار کنید تا زمانی که تمام مناطق جمع آوری شده در مجموعه نامزد پردازش شود.
نمودار جریان در شکل ۹ نشان داده شده است .

۴٫ آزمایش و تجزیه و تحلیل

۴٫۱٫ داده های تجربی و محیط

روش پیشنهادی در این مقاله در ایستگاه کاری نقشه برداری WJ-III که توسط آکادمی نقشه برداری و نقشه برداری چین توسعه یافته است، تعبیه شده است. داده های تجربی از نقشه راه توپوگرافی استاندارد ۱:۱۰۰۰۰ استان جیانگ سو در چین به دست آمده است. محدوده مکانی داده های تجربی ۲۳٫۹۱ × ۱۸٫۶۷ کیلومتر مربع و مقیاس هدف تعمیم ۱:۵۰۰۰۰ است. آستانه چگالی مش روی ۰٫۰۱۶ متر بر متر مربع در مقیاس ۱:۵۰۰۰۰ تنظیم شده است. داده های تجربی اولیه ۱:۱۰۰۰۰ در شکل ۱۰ نشان داده شده است. برای بررسی قابلیت اطمینان و اثربخشی روش پیشنهادی، از روش سنتی مبتنی بر مش برای تحلیل مقایسه ای استفاده شد و نتیجه انتخاب روش مبتنی بر مش سنتی و روش ما در شکل ۱۰ نشان داده شده است.b,c به ترتیب. محیط عملیاتی مورد استفاده برای اجرای سیستم نرم افزاری یک CPU Intel Core I7-3770 با سیستم عامل ویندوز ۷ ۶۴ بیتی، فرکانس اصلی ۳٫۲ گیگاهرتز، ۱۶ گیگابایت حافظه و هارد دیسک ۱۰۲۴ گیگابایتی حالت جامد است.
همانطور که در شکل ۱۰ نشان داده شده است ، نتیجه انتخاب روش پیشنهادی با توجه به دفتر استاندارد چین (GB/T 12343.1—۲۰۰۸) [ ۲۳ ]، مشخصات نقشه ها را در ۱:۵۰۰۰۰ در چین برآورده کرد، که در آن لازم است که موارد مهم و جاده های درجه بالا باید در درجه اول حفظ شوند و توجه به حفظ تفاوت تراکم و ویژگی های شکل شبکه جاده ها مورد توجه قرار گیرد.

۴٫۲٫ تجزیه و تحلیل آماری پایه داده های تجربی

۱۷۸۲ مش در داده های تجربی وجود دارد که شامل ۴۷۱ مش کوچک و ۱۳۱۱ مش غیر کوچک می شود. طبقه بندی دقیق ۴۷۱ مش کوچک در جدول ۱ نشان داده شده است .
جدول ۱ نشان می دهد که ۷۷/۲۳ درصد از مش های کوچک مشبک های کوچک جدا شده هستند و مش های کوچک باقی مانده ۶۴ ناحیه انبوه را تشکیل می دهند. بنابراین، مش های کوچک در منطقه آزمایشی ویژگی های تجمع آشکار را نشان می دهند. در نواحی انباشته مش‌های کوچک، حداقل تعداد مش‌های کوچک ۲ عدد است که نشان می‌دهد برای تشکیل یک منطقه تجمعی به دو شبکه کوچک مجاور نیاز است و بزرگترین سطح تجمعی شامل ۴۷ مش کوچک است.

۴٫۳٫ تجزیه و تحلیل قابلیت اطمینان و اثربخشی

(۱)
تجزیه و تحلیل مقایسه ای مناطق انباشته شده با دو مش کوچک
برای ۳۲ ناحیه انباشته شده با دو مش کوچک، دو روش مختلف ۱۰ ناحیه را با نتیجه انتخاب یکسان به دست آوردند که ۳۱٫۲۵٪ از کل مناطق جمع شده در این مورد را تشکیل می دهد. کم اهمیت ترین بخش هر مش فقط بخش مشترک است، به همین دلیل است که نتایج انتخاب یکسان بود. تعداد مناطق با نتایج انتخابی که بر اساس دو روش مختلف به طور قابل توجهی متفاوت بود، ۲۲ بود که ۶۸٫۷۵٪ از کل مناطق را در این مورد به خود اختصاص داد. دلیل این نتیجه این است که کم‌اهمیت‌ترین بخش هر مش همیشه بخش مشترک این مش‌ها نیست. از تشابه شکل ( SS ) برای ارزیابی کمی نتایج انتخاب استفاده می شود. فرمول به شرح زیر است:

اس اس=من=۱nBAreaمنمن=۱nمنطقه AAمن

که در آن n تعداد کل مش های مربوط به یک منطقه جمع شده را نشان می دهد، i امین مش کوچک است ،بآrهآمننشان دهنده مساحت مش کوچک i قبل از انتخاب جاده است وآآrهآمنناحیه ای از مش را نشان می دهد که پس از انتخاب جاده، مش کوچک اصلی در آن قرار دارد . بدیهی است که وقتی مقدار SS 1 باشد، شباهت شکل مش های جاده قبل و بعد از انتخاب جاده بهینه است.

SS برای هر روش در هر منطقه جمع آوری شده محاسبه می شود. برای مقایسه نتایج دو روش و درک درجه تفاوت بین آنها، نتایج محاسبات در شکل ۱۱ نشان داده شده است.
همانطور که در شکل ۱۱ نشان داده شده است، برای روش مبتنی بر مش، حداقل مقدار SS 0.01 است، به این معنی که یکی از (یا هر دو) دو مش کوچک در این ناحیه به یک مش بسیار بزرگ مجاور و مساحت مش های کوچک اصلی ادغام می شود. به طور چشمگیری تغییر کرد. در مقابل، مقادیر SS مربوط به دو مش کوچک بر اساس روش پیشنهادی ۱ است. این نتیجه نشان می دهد که دو مش کوچک می توانند یک مش جدید با تراکم مش که آستانه را برآورده می کند تشکیل دهند. وضعیت مشابهی برای ۲۱ منطقه جمع شده دیگر رخ می دهد. برای مناطق جمع آوری شده شماره ۲۳–شماره. ۳۲، مقادیر SS دو روش همه ۱ است، که نشان می دهد این دو روش نتایج انتخاب یکسانی را به دست آورده اند و ویژگی های شکل این ۱۰ ناحیه به خوبی حفظ شده است. به عنوان یک نتیجه،شکل ۱۲ دو ناحیه معرف را نشان می دهد: مناطق انبوه با نتایج انتخاب یکسان و مناطق انباشته با نتایج متفاوت.
از شکل ۱۲ a,b، نتایج انتخاب دو روش مختلف برای اولین ناحیه معمولی یکسان است و کم‌اهمیت‌ترین بخش شبکه کوچک فقط بخش مشترک a است. با این حال، همانطور که در شکل ۱۲ c,d نشان داده شده است، کم اهمیت ترین بخش مش همیشه قطعه مشترک a نیست. در نتیجه، این دو روش نتایج انتخاب متفاوتی را برای منطقه معمولی دوم به دست می‌دهند. در مقایسه با روش مبتنی بر مش، روش پیشنهادی یک نتیجه انتخاب ایجاد می‌کند که ساختار فشرده مش‌های کوچک را بهتر حفظ می‌کند و اتصال سکته مغزی را در جایی که بخش جاده b قرار دارد حفظ می‌کند.
(۲)
تجزیه و تحلیل مقایسه ای مناطق تجمع یافته با بیش از دو مش کوچک
برای ۳۲ ناحیه انباشته شده با بیش از دو مش کوچک، شباهت شکل ( SS ) و یک شاخص جدید به نام ضریب تغییرات سطح ( CVA ) برای ارزیابی کمی نتایج انتخاب استفاده می شود. پیشنهاد CVA بر اساس ملاحظات زیر است. به طور معمول، ناحیه هندسی هر مش در مناطق تجمعی همگن است. هنگامی که مقیاس از بزرگ به کوچک تغییر می کند، یک نتیجه تعمیم منطقی باید این مشخصه را حفظ کند، به این معنی که مساحت هندسی هر مش نباید به طور قابل توجهی متفاوت باشد.
فرمول CVA به شرح زیر است:

CVA=σحوزهμحوزه

جایی که σآrهآنشان دهنده انحراف معیار مساحت مش های کوچک در ناحیه انباشته شده و μآrهآمیانگین مساحت مش های کوچک در ناحیه انباشته شده است. CVA برای اندازه‌گیری یکنواختی ناحیه هندسی یک مش کوچک در یک منطقه تجمعی استفاده می‌شود. هر چه مقدار CVA کوچکتر باشد، توزیع مساحت یکنواخت تر است.

SS و CVA هر روش در هر ناحیه انباشته محاسبه شده است و نتایج در شکل ۱۳ نشان داده شده است.
همانطور که در شکل ۱۳ الف نشان داده شده است، مقادیر SS از ۳۲ ناحیه انبوه به دست آمده با روش مبتنی بر مش دارای محدوده [۰٫۰۳، ۰٫۷۸] هستند، که نشان می دهد مساحت تمام مش های کوچک به درجات مختلف تغییر می کند. در مقابل، مقادیر SS این نواحی انباشته‌شده به‌دست‌آمده با روش پیشنهادی همگی ۱ هستند و محدودیت‌های مرزی تضمین می‌کنند که ساختار فضایی منطقه تجمع اصلی به طور کلی تغییر نمی‌کند. علاوه بر این، در مقایسه با مقادیر CVA مناطق انباشته اصلی، مقادیر ۲۷ ناحیه انباشته به‌دست‌آمده با روش پیشنهادی کاهش می‌یابد. در مقابل، مقادیر ۲۶ ناحیه انبوه به دست آمده با روش مبتنی بر مش افزایش می یابد، همانطور که در شکل ۱۳ نشان داده شده است.ب هنگامی که مرزهای مناطق تجمع یافته با روش مبتنی بر مش حذف می شوند، مش های کوچک به مش های مجاور دیگر ادغام می شوند که مش های بزرگ تری را تشکیل می دهند. این باعث افزایش اختلاف سطح بین مش ها می شود و مقدار CVA نیز افزایش می یابد. مقایسه منحنی های مقدار CVA نشان می دهد که توزیع چگالی نتایج انتخاب به دست آمده با روش پیشنهادی یکنواخت تر از نتایج روش مبتنی بر مش است.
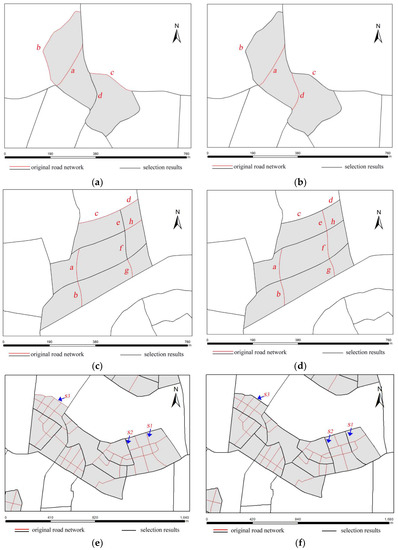
برای ۳۲ ناحیه انباشته شده با بیش از دو مش کوچک، نتایج انتخاب دو روش متفاوت است. تعداد مش های کوچک موجود در این ۳۲ ناحیه انباشته شده در محدوده (۳، ۴۷) قرار دارد. از این رو، این مقاله مناطق انباشته شده با کمترین (۳)، تعداد میانه (۸) و حداکثر تعداد (۴۷) مش های کوچک را به عنوان مناطق معمولی انتخاب می کند تا به صورت بصری نتایج تعمیم دو روش مختلف نشان داده شده در شکل ۱۴ را مقایسه کند.
همانطور که در شکل ۱۴ مشاهده می شود ، تفاوت در سه منطقه معمولی برای مناطق انباشته با بیش از دو مش کوچک به شرح زیر است.
(۱)
برای منطقه تجمیعی با حداقل تعداد مش‌های کوچک، روش مبتنی بر مش، بخش‌های جاده a ، b و c را بر اساس سطوح اهمیت پایین‌تر حذف می‌کند و منجر به تغییر ساختار فضایی شبکه راه در این منطقه می‌شود. در مقابل، روش پیشنهادی تنها سکته‌های جاده‌ای جدا شده a و d را با در نظر گرفتن محدودیت مرزی حذف می‌کند، و یک نتیجه انتخاب معقول‌تر که هدف یک نقشه‌نگار را بهتر منعکس می‌کند.
(۲)
برای منطقه انباشته با تعداد متوسط ​​مش های کوچک، روش مبتنی بر مش بخش های جاده a ، b ، c ، d ، h و g را حذف می کند، که در چهار سکته مختلف قرار دارند، ساختار فضایی در این منطقه ناگزیر تغییر می کند. در مقابل، روش پیشنهادی تنها دو ضربه جاده را حذف می‌کند (یکی توسط بخش‌های a و b و دیگری توسط بخش‌های e ، f و g تشکیل می‌شود.) در داخل منطقه تجمعی با استفاده از الگوریتم حذف ترتیبی. در نتیجه، نتایج انتخاب، ساختار توزیع اصلی را به خوبی حفظ می‌کند.
(۳)
برای منطقه انباشته با حداکثر تعداد مش های کوچک، روش پیشنهادی در این مقاله نسبت به روش سنتی، چگالی توزیع مش را بهتر حفظ می کند. تفاوت آشکار در نتایج انتخاب این دو روش در منطقه ای رخ می دهد که سکته های جاده S1 ، S2 و S3 در آن قرار دارند. واضح است که حفظ سکته مغزی S1 تأثیر مهمی بر یکنواختی چگالی توزیع دارد. به طور مشابه، حفظ سکته مغزی S3 یک طرح کلی واضح به دست می دهد. علاوه بر این، سکته مغزی S2 با روش پیشنهادی کاملاً حفظ می‌شود، که نشان‌دهنده قصد انتخاب نقشه‌نگاران انسانی است.

۵٫ نتیجه گیری ها

روش سنتی انتخاب مبتنی بر مش یک روش تعمیم شبکه جاده ای رایج، پیشرفته و قدرتمند است که در آن مش های کوچک به طور متوالی حذف می شوند و کم اهمیت ترین بخش جاده در هر مش حذف می شود. با این حال، برای مناطقی با شبکه های کوچک جمع شده که بلوک های مسکونی یا کارخانه های بزرگ را در بر می گیرند، ویژگی های فضایی معمولی مربوطه به راحتی از بین می روند. بنابراین، به عنوان مکملی برای روش انتخاب مبتنی بر مش، این مقاله یک روش تعمیم خودکار را برای مناطق شبکه جاده‌ای متراکم با در نظر گرفتن ویژگی‌های ساختاری فضایی به عنوان محدودیت پیشنهاد می‌کند. نتایج زیر از اعتبار سنجی و تجزیه و تحلیل تجربی با استفاده از داده های واقعی استخراج شد.
(۱)
داده‌های تجربی شامل ۱۷۸۲ مش است، تقریباً ۷۴ درصد مش‌ها مش‌های غیر کوچک هستند که نیازی به پردازش در هنگام انتخاب جاده ندارند. به همین ترتیب، ۲۶٪ باقی مانده از مش مش های کوچک هستند. تقریباً ۲۴ درصد از مش های کوچک مشبک های کوچک ایزوله هستند که با روش موجود می توان آنها را به طور منطقی از بین برد.
(۲)
تقریباً ۱۴٪ از مش های کوچک مناطق انباشته شده با ۲ مش کوچک را تشکیل می دهند و دو روش مختلف ۳۱٪ مناطق را با نتایج انتخاب یکسان به دست می دهند. نتایج انتخاب نواحی باقی‌مانده به‌طور قابل‌توجهی متفاوت است و روش پیشنهادی یک مجموعه فشرده را به دست می‌آورد که ساختار فضایی محلی شبکه جاده‌ای را در مقایسه با نتایج روش سنتی بهتر منعکس می‌کند.
(۳)
تقریباً ۶۲٪ از مش های کوچک مناطق تجمع یافته با بیش از دو مش کوچک را تشکیل می دهند، روش پیشنهادی در حفظ تفاوت تراکم و ویژگی های شکل شبکه راه بهتر عمل می کند. از طریق مقایسه منحنی‌های CVA، توزیع چگالی مش ۹۰ درصد از نتایج انتخاب به‌دست‌آمده با روش پیشنهادی یکنواخت‌تر از داده‌های اصلی است.
مش های شروع تصفیه شده و ترتیب حذف جدید در روش ما از خطای تصادفی که در روش سنتی رخ می دهد جلوگیری می کند و برای حفظ ساختار اصلی شبکه راه مفید است. با این حال، روش ما سه محدودیت دارد. ابتدا مقیاس نقشه ای که می توان این روش را در آن اعمال کرد محدود است، این روش برای انتخاب شبکه راه در مقیاس بزرگ (> 1:100000) مناسب تر است. در مقیاس کوچک، ویژگی ساختار فضایی دقیق لازم نیست حفظ شود، و مناطق انباشته ممکن است به طور کلی حذف شوند. دوم، ساختار فضایی در نظر گرفته شده در مقاله ما از یک دیدگاه جهانی می آید، و ساختارهای فضایی دقیق تر را نمی توان دریافت و متمایز کرد. سوم، آستانه انتخاب یک مقدار ثابت در منطقه آزمایشی است. اگر بتوان این مقدار را به صورت تطبیقی ​​با توجه به ویژگی های فضایی منطقه محلی محاسبه کرد، نتیجه انتخاب منطقی تر خواهد بود. از این رو، تحقیقات آتی باید بر دو موضوع متمرکز شود. اول، الگوهای مختلف تجمع، مانند الگوهای شبکه، الگوهای باریک، و الگوهای شعاعی، باید به طور سیستماتیک خلاصه و طبقه بندی شوند زیرا تقسیم دقیق الگوهای تجمع برای حفظ ویژگی های توزیع فضایی شبکه های جاده ای مفید است. دوم، آستانه تراکم مش نقش مهمی در انتخاب جاده ایفا می کند، و تنظیم یک آستانه مناسب در انتخاب جاده برای مجموعه داده های شبکه جاده ای چند مقیاسی و چندگانه نیاز به مطالعه بیشتر دارد. اول، الگوهای مختلف تجمع، مانند الگوهای شبکه، الگوهای باریک، و الگوهای شعاعی، باید به طور سیستماتیک خلاصه و طبقه بندی شوند زیرا تقسیم دقیق الگوهای تجمع برای حفظ ویژگی های توزیع فضایی شبکه های جاده ای مفید است. دوم، آستانه تراکم مش نقش مهمی در انتخاب جاده ایفا می کند، و تنظیم یک آستانه مناسب در انتخاب جاده برای مجموعه داده های شبکه جاده ای چند مقیاسی و چندگانه نیاز به مطالعه بیشتر دارد. اول، الگوهای مختلف تجمع، مانند الگوهای شبکه، الگوهای باریک، و الگوهای شعاعی، باید به طور سیستماتیک خلاصه و طبقه بندی شوند زیرا تقسیم دقیق الگوهای تجمع برای حفظ ویژگی های توزیع فضایی شبکه های جاده ای مفید است. دوم، آستانه تراکم مش نقش مهمی در انتخاب جاده ایفا می کند، و تنظیم یک آستانه مناسب در انتخاب جاده برای مجموعه داده های شبکه جاده ای چند مقیاسی و چندگانه نیاز به مطالعه بیشتر دارد.

منابع

  1. جیانگ، بی. کلارامونت، سی. رویکردی ساختاری به تعمیم مدل شبکه خیابان شهری. GeoInformatica ۲۰۰۴ ، ۸ ، ۱۵۷-۱۷۱٫ [ Google Scholar ] [ CrossRef ]
  2. شومان، دبلیو. Gülgen، F. سلسله مراتب مبتنی بر مرکزیت برای تعمیم شبکه خیابانی در نقشه های چند وضوحی. Geocarto Int. ۲۰۱۷ ، ۳۲ ، ۱۳۵۲–۱۳۶۶٫ [ Google Scholar ] [ CrossRef ]
  3. یو، دبلیو. ژانگ، ی. آی، تی. گوان، کیو. چن، ز. لی، اچ. تعمیم شبکه جاده با در نظر گرفتن الگوهای جریان ترافیک. بین المللی جی. جئوگر. Inf. علمی ۲۰۲۰ ، ۳۴ ، ۱۱۹-۱۴۹٫ [ Google Scholar ] [ CrossRef ]
  4. جیانگ، بی. لیو، سی. نمایش های توپولوژیکی مبتنی بر خیابان و تجزیه و تحلیل برای پیش بینی جریان ترافیک در GIS. بین المللی جی. جئوگر. Inf. علمی ۲۰۰۹ ، ۲۳ ، ۱۱۱۹-۱۱۳۷٫ [ Google Scholar ] [ CrossRef ]
  5. Touya, G. فرآیند انتخاب شبکه جاده ای بر اساس غنی سازی داده ها و تشخیص ساختار. ترانس. GIS ۲۰۱۰ ، ۱۴ ، ۵۹۵-۶۱۴٫ [ Google Scholar ] [ CrossRef ]
  6. کارزنیا، آی. Przychodzeń، M.; Sielicka، K. روش‌شناسی تعمیم خودکار ساختمان‌ها، شبکه‌های جاده‌ای، جنگل‌ها و آب‌های سطحی: مطالعه موردی بر اساس پایگاه داده‌های اشیاء توپوگرافی در لهستان. Geocarto Int. ۲۰۲۰ ، ۳۵ ، ۷۳۵-۷۵۸٫ [ Google Scholar ] [ CrossRef ]
  7. بنز، SA; Weibel, R. انتخاب شبکه جاده برای مقیاس های متوسط ​​با استفاده از الگوریتم ترکیبی مشبک-مش گسترده. کارتوگر. Geogr. Inf. علمی ۲۰۱۴ ، ۴۱ ، ۳۲۳-۳۳۹٫ [ Google Scholar ] [ CrossRef ]
  8. چن، جی. هو، ی. لی، ز. ژائو، آر. منگ، L. حذف انتخابی ویژگی های جاده بر اساس تراکم مش برای تعمیم خودکار نقشه. بین المللی جی. جئوگر. Inf. علمی ۲۰۰۹ ، ۲۳ ، ۱۰۱۳-۱۰۳۲٫ [ Google Scholar ] [ CrossRef ]
  9. لی، ز. ژو، Q. ادغام سلسله مراتب خطی و منطقه ای برای نمایش مداوم چند مقیاسی شبکه های جاده ای. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۲ ، ۲۶ ، ۸۵۵-۸۸۰٫ [ Google Scholar ] [ CrossRef ]
  10. لی، سی. وو، دبلیو. وو، پی. یین، جی. Guo, P. یک روش حذف برای مش های جدا شده در یک شبکه جاده با در نظر گرفتن ویژگی لبه سکته مغزی. PLoS ONE ۲۰۲۰ , ۱۵ , e0239828. [ Google Scholar ] [ CrossRef ] [ PubMed ]
  11. Mackaness، WA; ریش، KM استفاده از نظریه گراف برای پشتیبانی از تعمیم نقشه. کارتوگر. Geogr. Inf. سیستم ۱۹۹۳ ، ۲۰ ، ۲۱۰-۲۲۱٫ [ Google Scholar ] [ CrossRef ]
  12. وانینگ، پی. مولر، JC یک ساختار درختی تصمیم گیری پویا که از تعمیم خودکار شبکه جاده شهری پشتیبانی می کند. کارتوگر. J. ۱۹۹۶ ، ۳۳ ، ۵-۱۰٫ [ Google Scholar ]
  13. Yu, W. کشف مسیرهای حرکت مکرر از داده های مسیر تاکسی با استفاده از شبکه های جاسازی شده فضایی و قوانین انجمن. IEEE Trans. هوشمند ترانسپ سیستم ۲۰۱۹ ، ۲۰ ، ۸۵۵–۸۶۶٫ [ Google Scholar ] [ CrossRef ]
  14. تامسون، آرسی ریچاردسون، دی. اصل “ادامه خوب” سازمان ادراکی برای تعمیم شبکه های جاده ای اعمال می شود. در مجموعه مقالات نوزدهمین کنفرانس بین المللی کارتوگرافی، اتاوا، ON، کانادا، ۱۴ تا ۲۱ اوت ۱۹۹۹; ص ۱۲۱۵-۱۲۲۳٫ [ Google Scholar ]
  15. تامسون، RC مفهوم سکته مغزی، تعمیم و تجزیه و تحلیل شبکه جغرافیایی. Prog. تف کردن Data Handing ۲۰۰۶ , ۱۱ , ۶۸۱-۶۹۷٫ [ Google Scholar ]
  16. لیو، ایکس. آی، تی. لیو، ی. تحلیل تراکم جاده بر اساس تقسیم بندی اسکلت برای تعمیم جاده. ژئو اسپات. Inf. علمی ۲۰۰۹ ، ۱۲ ، ۱۱۰-۱۱۶٫ [ Google Scholar ] [ CrossRef ]
  17. لیو، ایکس. ژان، اف. Ai, T. انتخاب جاده بر اساس نمودارهای Voronoi و ‘Strokes’ در تعمیم نقشه. بین المللی J. Appl. زمین Obs. Geoinf. ۲۰۱۰ ، ۱۲ ، ۱۹۴-۲۰۲٫ [ Google Scholar ] [ CrossRef ]
  18. ژو، Q. لی، زی. مطالعه تطبیقی ​​استراتژی‌های مختلف برای الحاق بخش‌های جاده به ضربه‌ها برای تعمیم نقشه. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۲ ، ۲۶ ، ۶۹۱-۷۱۵٫ [ Google Scholar ] [ CrossRef ]
  19. کیم، ی. فوکویاسو، اچ. یاماموتو، دی. تاکاهاشی، ن. روش تعمیم جاده با استفاده از شبکه های سکته مغزی لایه ای. در مجموعه مقالات سومین کارگاه بین المللی ACM SIGSPATIAL در مورد توصیه های مبتنی بر مکان، شبکه های جغرافیایی اجتماعی و تبلیغات جغرافیایی، شیکاگو، IL، ایالات متحده آمریکا، ۹ سپتامبر ۲۰۱۹؛ صص ۱-۱۰٫ [ Google Scholar ]
  20. ژو، Q. Li, Z. تعیین تجربی پارامترهای هندسی برای حذف انتخابی در یک شبکه جاده. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۶ ، ۳۰ ، ۲۶۳-۲۹۹٫ [ Google Scholar ] [ CrossRef ]
  21. وو، دبلیو. Ma, Z. روش انتخاب خودکار شبکه راه شهری با در نظر گرفتن ویژگی های سازه ای. Proc. ICA ۲۰۱۹ ، ۲ ، ۱۴۶٫ [ Google Scholar ]
  22. لی، سی. یین، ی. وو، پی. Wu, W. روش استخراج خط اسکلت در مناطق با اتصالات متراکم با در نظر گرفتن ویژگی‌های سکته مغزی. ISPRS Int. J. Geo Inf. ۲۰۱۹ ، ۸ ، ۳۰۳٫ [ Google Scholar ] [ CrossRef ]
  23. GB/T 12343.1-2008 ; مشخصات تلفیقی برای نقشه های مقیاس بنیادی ملی—بخش ۱: مشخصات تدوین برای نقشه های توپوگرافی ۱:۲۵ ۰۰۰ ۱:۵۰ ۰۰۰ ۱:۱۰۰ ۰۰۰٫ اداره کل نظارت بر کیفیت، بازرسی و قرنطینه جمهوری خلق چین و استانداردسازی و اداره چین: پکن، چین، ۲۰۰۸٫
شکل ۱٫ طبقه بندی مش.
شکل ۲٫ نمودار شماتیک روش مبتنی بر مش: ( الف ) شبکه اصلی جاده، ( ب ) نتیجه حذف مرحله اول روش مبتنی بر مش و ( ج ) نتیجه حذف نهایی روش مبتنی بر مش.
شکل ۳٫ نمودار جریان رویکرد مبتنی بر مش سنتی.
شکل ۴٫ نمودار شماتیک محدودیت‌های روش انتخاب مبتنی بر مش: ( الف ) منطقه اصلی شبکه جاده با شبکه‌های کوچک جمع‌آوری‌شده. ( ب ) نتیجه انتخاب روش مبتنی بر مش. و ( ج ) خروجی مورد نظر از یک نقشه کش.
شکل ۵٫ نمودار شماتیک تعریف مجدد مش های شروع: ( الف ) میدان مجاور مرتبه اول برای مش با چگالی ۰٫۴۲٫ ( ب ) میدان مجاور مرتبه اول برای مش با چگالی ۰٫۳۸٫ و ( ج ) مش های شروع جدید.
شکل ۶٫ نمودار شماتیک الگوریتم حذف ترتیبی: ( الف ) شبکه اصلی جاده. ( ب ) مش های شروع و سکته مغزی برای بخش مشترک آنها. ( ج ) نتیجه حذف بر اساس ترتیب اتصال سکته مغزی. و ( د ) نتیجه حذف بر اساس تراکم مش به ترتیب نزولی.
شکل ۷٫ حفظ اتصال شبکه جاده در حین حذف بخش های جاده: ( الف ) یک ضربه جاده در سراسر منطقه تجمع یافته. و ( ب ) تقسیم منطقه انباشته به دو ناحیه زیر انباشته بر اساس این ضربه.
شکل ۸٫ شناسایی مکرر مش های شروع و پردازش جفت مش های مرتبط: ( الف ) مش های شروع (نارنجی) و ضربه مربوطه (آبی) در دور اول. ( ب ) نتیجه انتخاب دور اول و مش های تازه تشکیل شده (نارنجی)؛ ( ج ) مش های شروع (آبی) و ضربه مربوط به آن (آبی) در دور دوم. و ( د ) نتیجه انتخاب نهایی.
شکل ۹٫ نمودار جریان روش پیشنهادی.
شکل ۱۰٫ داده های تجربی و نتایج: ( الف ) داده های اصلی شبکه راه. ( ب ) نتیجه انتخاب روش مبتنی بر مش. و ( ج ) نتیجه انتخاب روش پیشنهادی.
شکل ۱۱٫ مقایسه مقادیر SS برای هر روش بر اساس ۳۲ ناحیه انباشته شده با ۲ مش کوچک.
شکل ۱۲٫ مقایسه دو ناحیه تجمعی معمولی با دو شبکه کوچک: ( الف ) نتیجه انتخاب برای اولین منطقه معمولی بر اساس روش مبتنی بر مش. ( ب ) نتیجه انتخاب برای اولین منطقه معمولی بر اساس روش پیشنهادی. ( ج ) نتیجه انتخاب برای دومین منطقه معمولی بر اساس روش مبتنی بر مش. و ( د ) نتیجه انتخاب برای دومین منطقه معمولی بر اساس روش پیشنهادی.
شکل ۱۳٫ ( الف ) مقایسه مقادیر SS برای هر روش در ۳۲ ناحیه انبوه با بیش از دو مش کوچک. و ( ب ) مقایسه مقادیر CVA برای هر روش در ۳۰ ناحیه انباشته با بیش از دو مش کوچک (بدون احتساب ۲ ناحیه انباشته که نتیجه انتخاب نهایی برای آنها یک مش است).
شکل ۱۴٫ مقایسه سه ناحیه معمولی برای مناطق تجمعی با بیش از ۲ مش کوچک: ( الف ) نتیجه انتخاب برای منطقه تجمعی با حداقل تعداد مش های کوچک بر اساس روش مبتنی بر مش. ( ب ) نتیجه انتخاب برای منطقه انبوه با حداقل تعداد مش های کوچک بر اساس روش پیشنهادی. ( ج ) نتیجه انتخاب برای منطقه انباشته با تعداد متوسط ​​مش های کوچک بر اساس روش مبتنی بر مش. ( د ) نتیجه انتخاب برای منطقه انباشته با تعداد متوسط ​​مش های کوچک بر اساس روش پیشنهادی. ( ه ) نتیجه انتخاب برای منطقه انباشته با حداکثر تعداد مش های کوچک بر اساس روش مبتنی بر مش. و ( ف) نتیجه انتخاب برای منطقه انباشته با حداکثر تعداد مش های کوچک بر اساس روش پیشنهادی.

دیدگاهتان را بنویسید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *

خانهدربارهتماسارتباط با ما