
چکیده
تعیین یک واحد تحلیل فضایی معقول یک گام اساسی در تقسیم بندی منطقه عملکردی شهری (UFZ) است که به طور قابل توجهی بر نتایج تأثیر می گذارد. با این حال، بیشتر مطالعات در مورد تقسیم مناطق عملکردی بر اساس واحدهای فضایی بیش از حد بزرگ، مانند بلوکها یا مناطق تحلیل ترافیک (TAZs) است که به راحتی ویژگیهای دقیق مناطق شهری را نادیده میگیرند و سوگیری را به نتیجهگیری تحقیق معرفی میکنند. برای پرداختن به این موضوع، یک روش تقسیمبندی منطقه تصفیهشده، یعنی نمودار Voronoi برای روش چندضلعی، برای تولید واحدهای تحلیل فضایی تصفیهشده پیشنهاد شد. پس از آن، موضوعات عملکردی واحد تحلیل فضایی توسط یک ماشین بردار پشتیبان چند کلاسه (SVM) طبقهبندی شد تا نقشه نهایی UFZ تولید شود. که در آن موضوعات عملکردی هر واحد فضایی با جفت کردن تخصیص دیریکله نهفته (LDA) به دست آمد. برای بررسی اثربخشی روش پیشنهادی، آزمایشهایی در پکن، چین انجام شد. نتایج نشان داد که روش تقسیمبندی پیشنهادی میتواند واحدهای فضایی در مقیاس ریز ایجاد کند و UFZهای ریزدانه و با دقت بالاتر را ارائه دهد (دقت کلی = ۸۴٪؛ کاپا = ۰٫۸۲).
کلید واژه ها:
تقسیم منطقه عملکردی شهری ; نمودار ورونوی ; مدل موضوع LDA ; طبقه بندی کننده SVM چند کلاسه
۱٫ مقدمه
توسعه شهری شکلگیری تدریجی مناطق عملکردی مانند مناطق مسکونی، مناطق تجاری و مناطق صنعتی را در داخل آن برای پاسخگویی به خواستههای متنوع اجتماعی و اقتصادی مردم ترویج میکند [ ۱ ]. به عنوان یک ویژگی جغرافیایی بسیار مهم یک شهر [ ۲ ]، منطقه عملکردی شهری (UFZ) نه تنها توزیع محیط طبیعی- فیزیکی (به عنوان مثال، ساختمان ها و تأسیسات عمومی) شهر را توصیف می کند، بلکه فعالیت های اجتماعی-اقتصادی را نیز توصیف می کند. ، سرزندگی شهر و اقتصاد شبانه) انسان ها [ ۳ ، ۴ ]. الگوی توزیع UFZ با توسعه شهر تغییر می کند و تشکیل UFZ می تواند تحت تأثیر برنامه ریزی دولت، تولید اجتماعی و زندگی ساکنان قرار گیرد [ ۱ ]]. نقشههای دقیق و دقیق مناطق عملکردی درون شهری نقش مهمی در بسیاری از زمینهها مانند برنامهریزی و ساخت و ساز شهری، نوسازی شهری، مدیریت شهری، نظارت بر محیطزیست، و بررسی و پیشگیری از بیماریهای همهگیر دارند [ ۵ ]. با این حال، بسیاری از کشورها به دلیل توسعه سریع شهری و فقدان دادههای جغرافیایی شهری مؤثر، فاقد نقشههای توزیع اخیر و دقیق UFZ هستند [ ۱ ]]. به ویژه، در مراحل بعدی فرآیند شهرنشینی، مناطق عملکردی شهری به طور کلی تحت نوسازی در مقیاس بزرگ قرار نمی گیرند، و برنامه ریزان شهری، مناطق عملکردی را بر اساس کل شهر یا بلوک به بلوک دوباره برنامه ریزی نمی کنند. در عوض، ساخت و ساز و تنظیم عملکردی محلی اغلب با ساختمان ها به عنوان بدنه اصلی انجام می شود. بنابراین، این تحقیق با ادغام دادههای منبع باز مانند ساختمانها و POI، یک روش نقشهبرداری منطقه عملکردی تصفیهشده با ساختمانها به عنوان واحد تحلیل پایه را پیشنهاد میکند.
ادامه این مقاله به شرح زیر سازماندهی شده است. بخش ۲ کارهای مربوط به طبقه بندی عملکرد شهری و تقسیم بندی منطقه را معرفی می کند. بخش ۳ منطقه مورد مطالعه و منبع داده را شرح می دهد. بخش ۴ گردش کار و اجزای کلیدی چارچوب پیشنهادی را معرفی می کند. بخش ۵ نتایج تجربی، از جمله نتایج تقسیم بندی منطقه، نتایج مدل سازی موضوع، و نتایج طبقه بندی را شرح می دهد. در نهایت، چند پارامتر مهم برای استخراج UFZ را مورد بحث قرار میدهیم و در بخش ۶ نتیجهگیری میکنیم.
۲٫ آثار مرتبط
۲٫۱٫ طبقه بندی عملکرد شهری
از آنجایی که یک UFZ یک منطقه شهری ناهمگن است که از چندین شی تشکیل شده است، طبقه بندی UFZ با طبقه بندی اشیاء تصویری متفاوت است. معناشناسی پوشش زمین و الگوهای فضایی نشانه های اساسی برای شناسایی مقوله های ناحیه عملکردی هستند. به عنوان مثال، یک منطقه مسکونی ممکن است شامل ساختمان های مسکونی، تأسیسات عمومی و جاده ها باشد. بنابراین، یک روش “طبقه بندی از پایین به بالا” برای استنباط منطقه عملکردی سطح بالا با استفاده از پوشش زمین در سطح پایین مورد نیاز است. به طور سنتی، سنجش از دور به طور گسترده برای استخراج و تجزیه و تحلیل مناطق عملکردی شهری، که ویژگیهای تصویر دوبعدی (مانند ویژگیهای طیفی، هندسی، و بافتی) را در نظر میگیرند، استفاده میشود [ ۶ ]، اما الگوی توزیع UFZ به شدت با فعالیتهای اجتماعی و اقتصادی انسان مرتبط است. [ ۳ ، ۴، ۷ ]. بنابراین، شناسایی کاربرد تابع شهری بر اساس ویژگیهای موضوعی معمولی با استفاده از مدلهای طبقهبندی سنجش از دور خالص [ ۸ ] دشوار است . برای رفع این شکاف، روشهای طبقهبندی ژئودموگرافیک، که از دادههای جمعیتشناختی اجتماعی مناطق شهری مشتق شدهاند، نیز برای شناسایی ناحیه عملکردی توسعه یافتهاند [ ۹ ، ۱۰ ]]. این روش مزایایی را در مناطق عملکردی خاص (مانند مناطق محل کار و مناطق مسکونی) در مناطق کوچک نشان می دهد. با این حال، جمع آوری داده ها کار فشرده و پرهزینه است و نمی تواند نیازهای فرآیندهای سریع شهرنشینی و توسعه را برآورده کند. یک راهحل ممکن استفاده مشترک از دادههای چندمنبعی جغرافیایی مانند دادههای OpenStreetMap (OSM)، نقاط مورد علاقه (POI)، دادههای کارت هوشمند، و مسیرهای تاکسی برای ارائه ویژگیهای معنایی اجتماعی غنی به عنوان مکملی برای ویژگیهای طبیعی اشیاء زمینی است [ ۱۱ ، ۱۲ ]. نتایج تحقیقات موجود نشان میدهد که دقت کاربرد دادههای اجتماعی دسترسی باز برای استنباط توابع شهری میتواند به حدود ۷۰ درصد برسد [ ۱۳ ]، که عمدتاً به فقدان مدلهای قابل اعتماد نسبت داده میشود [ ۱۴ ].]. کمی کردن رابطه بین توزیع فضایی داده های اجتماعی با دسترسی آزاد و انواع عملکرد شهری دشوار است. علاوه بر این، داده های اجتماعی با دسترسی آزاد معمولاً از نظر دسته بندی و توزیع فضایی نامتعادل و مغرضانه هستند و چالش هایی را در پردازش و تفسیر داده ها ایجاد می کنند.
محققان از فناوری پردازش زبان طبیعی (NLP) برای استخراج توابع شهری استفاده کرده اند [ ۱۵ ، ۱۶ ]. یوان و همکاران توابع را در هر منطقه در یک شهر با مدل استنتاج مبتنی بر موضوع (کشف مناطق توابع مختلف یا DRoF) برای اولین بار استنباط کرد [ ۱۷ ]. گائو و همکاران مدل موضوعی تخصیص دیریکله پنهان (LDA) را به کار برد و دادههای ورود به سیستم بهدستآمده از شبکههای اجتماعی را برای تعیین عملکردهای شهری [ ۳ ] به کار برد. لیو و همکاران تصاویر سنجش از دور یکپارچه و داده های شبکه اجتماعی برای تعیین کاربری زمین با یک مدل موضوع احتمالی (LDA و تحلیل معنایی پنهان احتمالی (PLSA)) [ ۸]. اکثر روشهای مدلسازی فوق به کشف معناشناسی پنهان موجود در دادههای POI کمک میکنند، اما این مدل معمولاً بر اساس روش کیسهی کلمات (BW) است که بافت فضایی کلمات را نادیده میگیرد [ ۴ ]. برای جبران این کمبود، محققان مدلهای تعبیه شبکه عصبی مانند word2vec [ ۵ ]، place2vec [ ۱۵ ] و doc2vec [ ۴ ] را پیشنهاد کردهاند.]. ایده اصلی این مدلها ساخت توالیهای POI با زمینه فضایی از طریق کوتاهترین فاصله، پنجره کشویی یا روش نمونهگیری نقطه تصادفی است، در نتیجه قانون اول جغرافیا را به عنوان یک معیار اتخاذ میکند. در فرآیند مدل سازی، فراوانی نقاط داده و رابطه فضایی بین نقاط داده در نظر گرفته می شود. با این حال، مدل فوق از محدودیت های خاصی در ساخت دنباله POI رنج می برد. به عنوان مثال، روش مبتنی بر کوتاهترین مسیر و نمونهبرداری تصادفی فقط POIها را بر اساس فاصله اقلیدسی مرتب میکند اما توزیع POI واقعی در فضای سهبعدی را در نظر نمیگیرد. علاوه بر این، روش پنجره کشویی ممکن است به دلیل نمونه برداری بیش از حد منجر به بیش از حد برازش مدل شود.
۲٫۲٫ تقسیم بندی منطقه
تجزیه و تحلیل های قبلی UFZ ها عمدتاً بر طبقه بندی عملکردی متمرکز بود اما تقسیم بندی منطقه را نادیده گرفت. این رویکرد غیرعملی است زیرا تنها زمانی که یک واحد تحلیل فضایی معقول انتخاب شود، میتوان چندین ویژگی به دست آمده از تصاویر سنجش از دور یا دادههای فضایی اجتماعی را به تفسیر عملکردهای شهری مرتبط کرد. شکل ۱ چندین روش تقسیم بندی منطقه را نشان می دهد که معمولاً توسط محققان اتخاذ می شود. همانطور که در شکل ۱ الف نشان داده شده است، روش تقسیم بندی مبتنی بر شبکه [ ۱۴ ، ۱۸] شرایط واقعی توزیع و عملکرد سازه زمین در منطقه مورد مطالعه را در نظر نمی گیرد و یک ویژگی سطح ممکن است به دو سلول شبکه تقسیم شود. علاوه بر این، روشهای تقسیمبندی منطقه مبتنی بر شبکه تحت تأثیر اثر مقیاس قرار میگیرند، به این معنی که مقیاسهای شبکه مختلف ممکن است نتایج تقسیم منطقه عملکردی متفاوتی ایجاد کنند. به طور کلی، تحقیق در مورد عملکردهای شهری باید بر اساس واحدهای فضایی پایه نسبتاً پایدار در طول دوره تاریخی مربوطه باشد نه شبکههایی که بهطور تصادفی تولید میشوند. همانطور که در شکل ۱ ب نشان داده شده است، روش های قطعه بندی مبتنی بر جاده [ ۸ ، ۱۹] به راحتی تحت تأثیر کامل بودن و کیفیت دادههای جاده قرار میگیرند و فرآیند انتخاب سطوح مختلف شبکههای جادهای نیز میتواند با مشکل واحد منطقهای قابل تغییر (MAUP) مواجه شود [ ۲۰ ]. همانطور که در شکل ۱ ج نشان داده شده است، روش های تقسیم بندی مبتنی بر بلوک در مقیاس بزرگ [ ۲۱ ] تفاوت های داخلی در توابع جغرافیایی را محو می کند. فرآیند به روز رسانی داده های برداری در بلوک ها با مشکلات خاصی مواجه می شود که ممکن است باعث تضاد بین شبکه های جاده ای و داده های تصویر شود [ ۲۲ ]]. علاوه بر این، روشهای تقسیمبندی منطقهای در مقیاس بزرگ (مناطق تحلیل ترافیک (TAZ) و بلوکها) میتوانند ویژگیهای خاصی را که توسط POI نشان داده شدهاند، تضعیف یا پنهان کنند، به عنوان مثال، ساختمانهای تجاری در مناطق مسکونی. بنابراین، در مطالعه تقسیم ناحیه عملکردی شهری، گزینه یک واحد تحلیل فضایی معقول یک موضوع علمی کلیدی است.
به طور خلاصه، مطالعات موجود با دو محدودیت روبرو هستند. اولاً، نگاشت ریز دانه UFZ به واحدهای نگاشت ظریف نیاز دارد، در حالی که TAZ ها و بلوک ها نمی توانند این تقاضا را به خوبی برآورده کنند. دوم، مشابه نحوه در نظر گرفتن بافت کلمات در NLP هنگام توصیف عملکردهای شهری از طریق تکنیک NLP، لازم است به جای بسامد، رابطه فضایی POI را در نظر بگیریم. بیشتر روشهای موجود برای ساخت دنباله فضایی POI فقط بر اساس فاصله اقلیدسی است، اما توزیع POI واقعی در فضا را در نظر نمیگیرد. با توجه به چالشها و مسائل روشهای تقسیم منطقه عملکردی فعلی، این مقاله قصد دارد (۱) یک روش تقسیمبندی منطقه را برای تولید واحدهای فضایی اساسی برای نقشهبرداری UFZ ریزدانه (در سطح ساختمان) پیشنهاد کند. (۲) دسته بندی دنباله های POI را بر اساس تقسیم بندی منطقه بسازید. علاوه بر این، توزیع موضوع برای هر منطقه با مدل موضوع LDA استخراج میشود. (۳) سپس موضوعات استخراج شده به عنوان ویژگی های معنایی به طبقه بندی کننده ماشین بردار پشتیبان چند کلاسه (SVM) وارد می شوند تا نتایج طبقه بندی نهایی به دست آید.
۳٫ منطقه مطالعه و داده ها
۳٫۱٫ مروری بر منطقه مورد مطالعه
منطقه مورد مطالعه در پکن واقع شده است. از زمان اجرای سیاست اصلاحات و بازگشایی در سال ۱۹۷۸، پکن با افزایش تولید ناخالص داخلی (GDP) و جمعیت [ ۲۳ ]، شهرنشینی سریعی را تجربه کرده است، در نتیجه با مشکلات آلودگی محیط زیست، کمبود مسکن، تراکم ترافیک و نامتعادل مواجه شده است. توسعه منطقه ای. پکن به عنوان پایتخت چین و یکی از بزرگترین شهرهای جهان، میزبان جمعیت دائمی ۲۱٫۸۹۳ میلیون نفر (تا نوامبر ۲۰۲۰) و مساحت ۱۶۴۰۰ کیلومتر مربع است . مساحت کوه ها ۱۰۰۷۲ کیلومتر مربع است۶۱ درصد از کل مساحت پکن. بیشتر جمعیت در مناطق مسکونی شهری که در جاده کمربندی پنجم واقع شده اند متمرکز شده اند، در حالی که مناطق کوهستانی غیرقابل دسترس هستند. پکن به عنوان مرکز سیاسی و فرهنگی چین، باید تغییرات پویا و توسعه ساختار فضایی شهری و مناطق عملکردی خود را برای انجام مدیریت شهری هوشمند و سازگار نظارت کند. بنابراین، ما مناطقی را در داخل جاده کمربندی پنجم به عنوان منطقه مطالعه موردی خود انتخاب کردیم (در داخل خطوط قرمز، همانطور که در شکل ۲ نشان داده شده است ).
۳٫۲٫ داده ها
در محیط شهری، داده های POI شامل مجموعه ای از نقاط مکان مانند سوپرمارکت ها، سینماها، بیمارستان ها، هتل ها و ایستگاه های اتوبوس است [ ۴ ]. دادههای POI میتوانند ویژگیهای اجتماعی-اقتصادی UFZها را در دسترس قرار دهند، دادههای دست اول را در مورد فعالیتهای انسانی و کاربریهای ساختمان تعریف کنند، و فرصتی را برای محققان فراهم کنند تا توزیع عملکردهای شهری را از پایین به بالا بررسی کنند [ ۳ ، ۲۴ ]. در مقابل، دادههای ساختمان شهری میتوانند ویژگیهای فیزیکی پایدار (مانند ویژگیهای توزیع ساختمان و ویژگیهای سهبعدی) یک شهر معین را با جزئیات زیاد در طول یک دوره خاص مشخص کنند. این دو منبع داده می توانند در نمایش کاربری اراضی شهری مکمل یکدیگر باشند و می توانند تقسیم بندی UFZ دقیق تر و دقیق تری را انجام دهند.
۳٫۲٫۱٫ داده های POI
مجموعه داده POI مورد استفاده در این تحقیق از Gaode Maps ( https://www.amap.com/ ) مشتق شده است.، در ۲۰ ژوئیه ۲۰۲۲، یکی از بزرگترین وب سایت های خدمات نقشه الکترونیکی آنلاین در چین (شبیه به نقشه گوگل). این مجموعه داده در آوریل ۲۰۲۰ به روز شد و شامل ۷۸۲۸۱۷ POI در جاده حلقه پنجم در پکن است. هر رکورد POI دارای ویژگی های مفید بسیاری است، از جمله نام، مختصات (طول و عرض جغرافیایی)، دسته، جزئیات آدرس (منطقه اداری و نام خیابان)، و شماره تلفن. در میان این ویژگیها، ویژگیهای دستهبندی با مناطق عملکردی شهری، با یک سلسله مراتب سهلایهای، شامل ۲۳ دستهی سطح اول، ۲۶۷ دستهی سطح دوم، و ۹۰۳ دستهی سطح سوم، ارتباط نزدیکی دارند. این مطالعه دستههای خاص سطح اول (حوادث و رویدادها، امکانات پاس، امکانات داخلی، و نام مکان و آدرس) غیر مرتبط با عملکردهای شهری را حذف کرد و در مجموع ۱۹ دسته سطح اول را به دست آورد.شکل ۳ توزیع فرکانس نسبی کل POI ها را نشان می دهد. توزیع بسامد نسبی POI از قانون Zipf پیروی می کند که یک قانون مهم در زبان ریاضی است. این نشان می دهد که چند دسته POI سهم بزرگی از همه POI ها در پکن را تشکیل می دهند. پنج دسته POI متداول شامل مراکز خرید، خدمات زندگی روزمره، شرکت ها، غذاها و نوشیدنی ها و خانه های تجاری است.
۳٫۲٫۲٫ داده های ساختمان
مجموعه داده ساختمان از Gaode Maps از طریق API باز ایجاد شده است ( https://lbs.amap.com/demo/javascript-api/example/layers/buildings ، در ۲۰ ژوئیه ۲۰۲۲ قابل دسترسی است). این مجموعه داده شامل ۲۰۷۰۵۲ ساختمان در منطقه جاده کمربندی پنجم پکن است که بزرگترین ساختمان آن ۱۹۵۴۴۸٫۷۷ متر مربع مساحت دارد . ایستگاه راهآهن جنوب پکن و کوچکترین ساختمان به مساحت ۳۴٫۴۸ متر مربع . واقع در کوچه نان لو گو ( شکل ۴). در مجموع ۱۹۷۲۱۱ سطح ساختمان با تجمیع سطوح ساختمان و ادغام ساختمانهای اصلی و فرعی در فاصله مجاور کمتر از ۰٫۰۰۱ متر به دست آمد. دادههای نقشه پایه ساختمان عمدتاً شامل ویژگیهای فیزیکی مانند مکان، تعداد طبقات و مساحت است، اما این دادهها فاقد ویژگیهای اجتماعی مانند عملکرد و کاربری (دفاتر، رستورانها و غیره) هستند.
۳٫۲٫۳٫ داده های جغرافیایی پایه شهری
داده های اصلی جغرافیایی شهری عمدتاً شامل داده های فضای سبز پکن، داده های منطقه آب و داده های شبکه جاده است. تحقیقات مربوطه نشان داده است [ ۲۵ ، ۲۶ ] که نوع کاربری اصلی زمین در منطقه جاده کمربندی پنجم پکن، زمین ساخت و ساز است و مناطق وسیعی از فضاهای سبز و بدنه های آبی نیز توزیع شده است. تا پایان سال ۲۰۲۰، سرانه فضای سبز عمومی در پکن به ۱۶٫۵ متر مربع رسید . بنابراین، فضاهای سبز و مناطق آبی باید برای بهبود دقت تقسیم در حین استفاده از دادههای ساختمانی برای تقسیم منطقه گنجانده شوند. داده های طبقه بندی کاربری زمین در سال ۲۰۲۰ در نظر گرفته شده در این مطالعه از مرکز داده ها و علوم منابع و محیط زیست آکادمی علوم چین ( https://www.resdc.cn/ ) دانلود شده است.، قابل دسترسی در ۲۰ ژوئیه ۲۰۲۲). لایههای فضای سبز و فضای آبی در محدوده جاده حلقه پنجم پکن استخراج شد.
۴٫ روش شناسی
در این مطالعه، روشی برای ادغام دادههای ساختمان و POI برای نقشهبرداری تصفیهشده UFZ پیشنهاد شد. به طور کلی، منطقه عملکردی شهری اغلب به طور طبیعی تحت تأثیر کاربری واقعی زمین است. تعیین مرز پهنه عملکردی و شناسایی مقوله آن دو موضوع حیاتی در تقسیم بندی پهنه عملکردی شهری است. اولی برای تقسیم ناحیه عملکردی در حوزه فضایی، و دومی برای طبقه بندی منطقه عملکردی در دامنه ویژگی است. به طور خاص، گردش کار روش پیشنهادی شامل چهار مرحله است ( شکل ۵ ):
(۱) تقسیم بندی منطقه. نمودار Voronoi برای روش چند ضلعی برای تولید واحدهای تحلیل فضایی با ادغام دادههای ساختمان، فضای سبز، سطح آب و شبکه جادهها استفاده میشود.
(۲) تولید واژه و فرهنگ لغت. هر دسته POI به عنوان یک کلمه در نظر گرفته می شود. مجموعه داده همه دستههای POI موجود در یک واحد تحلیل فضایی خاص به عنوان یک فرهنگ لغت در نظر گرفته میشود.
(۳) استخراج ویژگی موضوع. هر واحد تحلیل فضایی به عنوان یک سند در نظر گرفته می شود و ویژگی های معنایی هر واحد تحلیل فضایی با مدل موضوعی LDA برای طبقه بندی بهتر UFZ ها استخراج می شود.
(۴) طبقه بندی UFZ. موضوعات استخراج شده از مدل موضوعی LDA به عنوان ویژگی های معنایی اعمال می شوند. یک طبقهبندیکننده SVM چند کلاسه برای طبقهبندی واحدهای تحلیل فضایی به UFZها آموزش داده شده و اعمال میشود.
۴٫۱٫ تقسیم بندی منطقه
در نقشه برداری UFZ ابتدا باید واحدهای تحلیل فضایی تعیین شوند. TAZ (منطقه تجزیه و تحلیل ترافیک) به عنوان واحد تجزیه و تحلیل فضایی در مطالعات متعددی که شامل تقسیم UFZ، طبقهبندی کاربری زمین شهری و طبقهبندی صحنه است، پذیرفته شده است [ ۵ ، ۸ ، ۱۱ ، ۲۷ ]. با این حال، عملکردهای شهری بسیار مختلط در واقعیت در هر TAZ وجود دارد، و حتی یک ساختمان واحد می تواند دارای عملکردهای متفاوتی باشد [ ۲۸ ]]. ساختمان ها جزء فضایی اساسی مناطق شهری هستند و ساختار فضایی آنها پیوندی بین ساختمان ها و عملکردهای اجتماعی ایجاد می کند. در تئوری، POI در یک ساختمان یک زمینه فضایی قوی تری نسبت به POI در ساختمان های مختلف نشان می دهد. با تقسیم ساختمان ها به واحدها، می توانیم به طور موثر رابطه بین ساختمان ها را در فضا به تصویر بکشیم. به طور دقیق تر، تقسیم فضا به هر ساختمان معنای تأثیر عملکردی بر محیط فضایی اطراف آن را اختصاص می دهد. بنابراین، ما یک روش تقسیمبندی فضایی با ساختمانها به عنوان لنگرهای پایه بر اساس نمودار Voronoi برای تولید یک واحد تحلیل فضایی ریزدانهتر پیشنهاد میکنیم.
۴٫۱٫۱٫ نمودار ورونوی برای نقاط
تقسیم بندی واحدهای تحلیل فضایی، منطقه تحقیق را بر اساس قوانین خاصی تقسیم می کند. هسته روش تقسیم بندی منطقه پیشنهادی نمودار Voronoi (چند ضلعی های Thiessen) است، که یک روش پارتیشن بندی فضا است که یک سری چند ضلعی از مجموعه ای از دانه ها تولید می کند ( شکل ۶ ). این نام به افتخار ریاضیدان مشهور روسی گئورگی ورونوی گرفته شده است. هر نقطه در هر چند ضلعی نزدیکترین نقطه به نقطه بذر در چند ضلعی است، بنابراین هر چند ضلعی را می توان به عنوان ناحیه تأثیر دانه در نظر گرفت. بنابراین، روش تقسیم بندی منطقه بر اساس چند ضلعی های تیسن اهمیت جغرافیایی عملی تری نسبت به روش تقسیم مبتنی بر شبکه ارائه می دهد.
۴٫۱٫۲٫ نمودار Voronoi برای چند ضلعی
مزیت اصلی نمودار ورونوی برای روش چند ضلعی این است که محققان می توانند به طور عینی پارتیشن های فضایی ساختمان های شهری را بر اساس ساختمان های شهری پایدار در طول یک دوره معین و نه از طریق تفسیر ذهنی تعیین کنند. در نتیجه، نمودار Voronoi برای روش چند ضلعی از طریق چهار مرحله زیر تحقق می یابد ( شکل ۷ ):
(۱) ادغام ویژگی های فضایی. این مرحله در دو مورد به فرآیند ترکیب اشاره دارد. یک مورد شامل ترکیب لایهها است که به ترکیب لایههای ویژگی فضایی مختلف (مانند لایههای جاده، ساختمان، سطح آب و فضای سبز) برای تولید یک لایه ویژگی کامل از فضای شهری اشاره دارد. مورد دوم به عملیات ادغام در یک لایه اشاره دارد که مستلزم ادغام ویژگی های مجاور مشابه با فاصله داخلی کمتر از ۰٫۰۰۱ متر است. پیشنهاد شده است که ویژگی های مجاور مشابه در فاصله کمتر از ۰٫۰۰۱ متر، عملکردهای اجتماعی یکسانی را نشان می دهند. به عنوان مثال، ساختمان های اصلی و کمکی یک مجموعه ساختمانی (همانطور که در شکل ۷ الف نشان داده شده است)، به ترتیب B1 و B2، همانطور که در شکل ۷ نشان داده شده است، در B ترکیب می شوند.ب).
(۲) گسسته سازی ویژگی های فضایی به نقاط ( شکل ۷ ج). از آنجایی که نمودار ورونوی را فقط می توان از نقاط تولید کرد، لایه ویژگی فضایی باید به مجموعه ای از نقاط در فواصل معین در امتداد مرز خود گسسته شود.
(۳) تولید نمودارهای ورونوی در اطراف نقاط ( شکل ۷ د). هر نمودار از طریق شناسه با ویژگی های فضایی اصلی مرتبط است.
(۴) استخراج مرز تقسیم بندی بر اساس شناسه ویژگی های فضایی اصلی ( شکل ۷ e).
شایان ذکر است که هنگام استفاده از نمودار Voronoi برای روش چند ضلعی برای تقسیم بندی منطقه، پارامترهایی که ممکن است تأثیر قابل توجهی بر نتایج داشته باشند، باید با جزئیات بیشتری ارزیابی شوند. به طور خاص، در مورد گسستهسازی ویژگیهای فضایی به نقاط (مرحله ۲)، انتخاب یک فاصله گسستهسازی که خیلی زیاد است ممکن است مسائل هندسی «ارهمانند» ناخواسته را بین ساختمانهای مجاور ایجاد کند ( شکل ۸).آ). شهودی ترین پیامد این پدیده این است که خط مورد استفاده برای تقسیم منطقه از ویژگی های فضایی مانند ساختمان ها عبور می کند. در نتیجه، یک ساختمان ممکن است به چندین ناحیه مختلف تقسیم شود که بر دقت تقسیم UFZ ها تأثیر می گذارد. در مقابل، تقاضای محاسباتی به صورت تصاعدی افزایش می یابد که یک بازه گسسته سازی کوچک انتخاب شود. با توجه به اهمیت تنظیم صحیح پارامتر، بخش ۶٫۱ آزمون تعیین فاصله گسسته سازی را ارائه می دهد. بر این اساس، پارامتر بهینه برای تولید واحد تحلیل فضایی در مراحل بعدی اتخاذ میشود.
۴٫۲٫ استخراج ویژگی موضوع
مشابه توزیع کلمات در زبان طبیعی، توزیع دستههای POI از قانون Zipf پیروی میکند [ ۱۵ ، ۱۶ ]. بنابراین، تکنیک LDA مبتنی بر NLP برای استخراج تابع شهری مناسب است [ ۱۵ ، ۱۶ ]. مدل LDA یک مدل موضوعی است که برای استنتاج توزیع موضوعی اسناد استفاده می شود. این مدل می تواند موضوع هر سند را در مجموعه اسناد به شکل توزیع احتمال به دست آورد و این مدل می تواند خوشه بندی موضوع یا طبقه بندی متن را بر اساس توزیع موضوع انجام دهد [ ۲۹ ]]. در این مطالعه، مدل LDA موضوع هر واحد تقسیمبندی شده را با محاسبه ویژگیهای توزیع POI استخراج میکند که ویژگی موضوعی بالاتری را برای مناطق عملکردی شهری فراهم میکند. نتایج رضایت بخشی در خصوصیات ناحیه عملکردی شهری [ ۳۰ ] به دست آمده است. در این روش، هر دسته از POI به عنوان یک کلمه در نظر گرفته می شود، تمام دسته های POI شامل فرهنگ لغت و هر واحد تجزیه و تحلیل فضایی تقسیم شده به عنوان یک سند در نظر گرفته می شود. متغیرهای LDA در این مطالعه در جدول ۱ تعریف شده است.
توزیع تابع θمن= {θمن ، ۱،θمن ، ۲، …θمن ، ک}�من={�من،۱،�من،۲،…�من،ک}را می توان با ادغام معادله (۱) بیش از حد تعیین کرد θ � و z�.
ρ ( θ ، z، w | α ، β) = ρ ( θ | α ) =∏نn = ۱ρ (zn| θ ) ρ (wn|zn، β) ،�(�،�،�|�،�)=�(�|�)=∏�=۱ن�(��|�)�(��|��،�)،
جایی که w�مجموعه ای از دسته بندی های POI را نشان می دهد، z�توابع نهفته استنباط شده را نشان می دهد و θ�نشان دهنده توزیع احتمال توابع در واحدهای تحلیل فضایی به دنبال تخصیص دیریکله با پارامتر است. α�. با توجه به مدل موضوعی LDA می توان دسته تابع واحد تحلیل فضایی و توزیع احتمال آن را به دست آورد.
۴٫۳٫ طبقه بندی UFZ
روابط بسیار به چند بین توزیع موضوع و مقولههای منطقه عملکردی شهری برای هر واحد تقسیمبندی وجود دارد. تعیین دستی دسته بندی مناطق عملکردی شهری که هر واحد تقسیم بندی به آن تعلق دارد منجر به حجم کاری زیادی می شود. تعیین دسته بندی پهنه های عملکردی شهری که توسط هر بردار نشان داده می شود از طریق یک الگوریتم طبقه بندی علمی ضروری است. SVM الگوریتمی است که می تواند برای جستجوی ابرصفحه ها در فضای ویژگی های با ابعاد بالا برای حل مشکلات خطی جدا نشدنی استفاده شود [ ۳۱] که دقت و دقت بالایی را در بین الگوریتم های طبقه بندی نشان می دهد. بنابراین، پس از استفاده از LDA برای به دست آوردن توزیع موضوع برای هر واحد تحلیل فضایی، یک طبقهبندی کننده SVM برای طبقهبندی UFZها اعمال میشود. طبقهبندی کننده SVM با بسته libsvm ( https://www.csie.ntu.edu.tw/~cjlin/libsvm/ ، دسترسی به ۲۰ ژوئیه ۲۰۲۲) پیادهسازی شده است. نسبت مجموعه دادههای آموزش و آزمایش بر اساس آزمایشها تعیین میشود [ ۸ ، ۳۰ ]. هفتاد درصد از نمونههای UFZ انتخاب شده بهعنوان مجموعه دادههای آموزشی، که موضوعات آن در یک طبقهبندی کننده SVM چند کلاسه وارد شد، استفاده شد. ۳۰٪ باقیمانده از نمونه های UFZ انتخاب شده به عنوان مجموعه داده آزمایشی استفاده شد. ضریب پنالتی C و پارامتر کرنل γ�دو پارامتر دقیق تنظیم شده در مدل SVM هستند. برای تعیین بهترین پیکربندی پارامتر، ما ۲۵٪ از مجموعه داده آموزشی را به عنوان یک مجموعه داده اعتبار سنجی اعمال کردیم و دقت را از طریق چندین ترکیب برای به دست آوردن پارامترهای بهینه تأیید کردیم. سپس، ما از مجموعه داده آموزشی برای آموزش مدل SVM بهینه شده استفاده کردیم و مدل بهینهسازی شده را برای ارزیابی دقت در مجموعه داده آزمایشی اعمال کردیم.
۵٫ نتایج تجربی
استاندارد طبقه بندی UFZ اتخاذ شده در این مطالعه با ارجاع به کد طبقه بندی کاربری زمین شهری و استانداردهای برنامه ریزی زمین های توسعه یافته (GB 50137-2011، جزئیات استاندارد را می توان در https://sthjj.jiujiang یافت) فرموله شد. gov.cn/zwgk_215/zcjd/202006/P020200623535114893887.pdf ، قابل دسترسی در ۲۰ ژوئیه ۲۰۲۲). با توجه به ویژگی های کاربری زمین پکن، همراه با سیستم طبقه بندی بر اساس دسته های اولیه و ثانویه GB 50137-2011، UFZ را به ۵ دسته اولیه و ۱۰ طبقه بندی ثانویه تقسیم کردیم. سیستم طبقه بندی در جدول ۲ فهرست شده است.
۵٫۱٫ نتایج تقسیم بندی منطقه
بر اساس دادههای ساختمان، فضای سبز، سطح آب و شبکه جادهای بهدستآمده، منطقه مورد مطالعه را به مجموعهای از واحدهای تحلیل فضایی تقسیم کردیم. یک منطقه معمولی (دانشگاه پکن) برای نشان دادن اثربخشی روش تقسیم بندی منطقه پیشنهادی با مقایسه با روش MT [ ۳۲ ] و روش تقسیم بندی منطقه مبتنی بر جاده [ ۱۱ ] انتخاب شد ( شکل ۹ ).
در نتایج تقسیمبندی، همه ساختمانها کاملاً قطعهبندی شدند، در نتیجه لبهها را بهطور مناسب حفظ کردند، بهویژه در نواحی با ساختمانهایی که به طور منظم توزیع شدهاند ( شکل ۹ a). در مقایسه با روش MT که تنها از ساختمانها برای تقسیمبندی منطقه استفاده میکند، روش ما توزیع جادهها، فضاهای سبز و آب را برای از بین بردن این پدیده در نظر میگیرد که مناطق تقسیمبندی شده ممکن است تقاطعها، فضاهای سبز یا مناطق آبی باشند ( شکل ۹ b A و B. ). در مقایسه با مناطق تقسیمبندی شده مبتنی بر جاده ( شکل ۹ج)، واحدهای تحلیل فضایی تولید شده با روش تقسیمبندی ما برای نقشهبرداری تصفیهشده UFZ مناسبتر هستند، زیرا یک واحد تجزیه و تحلیل فضایی ممکن است به دلیل پراکندگی جادهها دارای توابع مختلط باشد، که یک مسئله اصلی بر دقت نقشهبرداری تأثیر میگذارد [ ۳۳ ]. بنابراین، روش تقسیمبندی بهبودیافته بهتر از MT عمل میکند، و روشهای تقسیمبندی مبتنی بر جاده هنگام در نظر گرفتن جادهها، فضاهای سبز و مناطق آبی انجام میشود. واحدهای تجزیه و تحلیل فضایی تقسیمبندیشده در این مطالعه انتظار میرود پتانسیل زیادی برای کار نقشهبرداری عملکردی شهری تصفیه شده داشته باشند.
۵٫۲٫ نتایج مدلسازی موضوع
با در نظر گرفتن هر واحد تحلیل فضایی به عنوان یک سند، تعداد موضوعات را ۲۱ و هایپرپارامتر را ۱٫۱ برای مدل سازی موضوع قرار می دهیم. شکل ۱۰ ۲۱ موضوع و احتمال توزیع کلمه هر موضوع را نشان می دهد. در اینجا، هر موضوع با تمام دسته بندی های POI در نظر گرفته شده نشان داده شد. همانطور که در شکل ۱۰ نشان داده شده است ، داده های POI و مدل موضوعی LDA را می توان برای ترسیم نوع عملکردی واحدهای تحلیل فضایی به کار برد. منطقه مورد مطالعه ما در پکن واقع شده است، جایی که UFZ های بسیار مخلوط به عنوان اسناد ترکیبی با موضوع خدمت می کردند، که مدل LDA را قادر می ساخت تا نتایج طبقه بندی دقیقی را ارائه دهد.
با تجزیه و تحلیل توزیع احتمال کلمه در ۲۱ موضوع فوق، به پدیده های قابل توجهی دست یافتیم. (۱) بیشتر موضوعات تحت سلطه تعداد کمی از کلمات بودند. به عنوان مثال، به جز مبحث ۹، ۱۷، ۱۹ و ۲۰، هر موضوع دیگری تحت سلطه کلمه ای با احتمال بالاتر از ۰٫۶ بود و بالاترین احتمال می تواند به ۱ برسد. این ممکن است منعکس کننده عملکرد واحد و استفاده از ساختمان ها در پکن باشد. . (۲) POI های مربوط به فروشنده خودرو و خدمات موتور سیکلت فقط توزیع احتمال بسیار کمی را در موضوعات ۷، ۱۲ و ۲۱ اشغال کردند و توزیع احتمال در موضوعات باقی مانده به ۰ رسید که ممکن است مربوط به مقررات محدودیت ترافیک وسیله نقلیه اجرا شده باشد. در پکن، که منجر به رکود نمایندگیهای خودرو و صنعت خدمات موتورسیکلت شد.۳۴ ]. (۴) مبحث ۱۵ به توزیع موضوع منحصربفردی دست یافت و کلمات POI “خانه های تجاری” تنها کلمات را تشکیل می دادند. احتمال به ۱ رسید، که نشان می دهد مبحث ۱۵ واقعاً بر کلمات POI “خانه های تجاری” تکیه دارد. این بیشتر نشان دهنده فقدان امکانات تجاری، حمل و نقل و سایر خدمات در نزدیکی خانه های تجاری در پکن است. به طور کلی، استفاده از مدل موضوعی LDA برای استخراج توزیع موضوعی دستههای مختلف UFZها کمک زیادی به شناسایی UFZ کرد.
۵٫۳٫ نتایج طبقه بندی
ویژگی معنایی هر واحد تحلیل فضایی با یک بردار ۲۱ بعدی نشان داده شد. جدول ۳ نتایج طبقه بندی به دست آمده با طبقه بندی کننده SVM چند کلاسه را فهرست می کند. هر موضوع با سه کلمه اول با احتمال بالا نشان داده شد. همانطور که در جدول ۳ و شکل ۹ نشان داده شده است، موضوعات ۳، ۸ و ۱۱ موضوعات برتر در مناطق تجاری بودند و در بین این موضوعات، کلمات POI مانند خرید، خدمات زندگی روزمره و غذا و نوشیدنی به بالاترین احتمال دست یافتند. در مناطق تجاری، موضوعات ۲، ۱۳، و ۱۹ شامل کلمه POI “شرکت ها” بود، که نشان می دهد کلمه POI “Enterprises” برای شناسایی منطقه سازمانی مهم است.
نتایج طبقه بندی UFZ به دست آمده در شکل ۱۱ نشان داده شده است و دو منطقه معمولی برای نشان دادن دقت روش ما انتخاب شدند. مناطق تجاری بیش از یک چهارم منطقه مورد مطالعه را پوشش می دادند و بیشتر مناطق تجاری، عمدتاً شامل مواد غذایی و نوشیدنی، در کنار جاده ها قرار داشتند. بیشتر مناطق آموزشی در مناطق ساخته شده شمال غربی واقع شده بودند، در حالی که مناطق میراثی عمدتاً در داخل جاده کمربندی دوم قرار داشتند. بیشتر مناطق تفریحی در میان فضاهای سبز و مناطق آبی و بیشتر مناطق باقی مانده در داخل مدارس قرار داشتند.
۶٫ بحث
۶٫۱٫ تجزیه و تحلیل حساسیت پارامتر از تقسیم بندی منطقه
برای تعیین تنظیم بهینه برای فاصله گسسته سازی ( بخش ۴٫۱٫۲ )، آزمایشی بر روی ساختمان های داخل جاده حلقه پنجم در پکن انجام شد. چندین تنظیمات از فاصله گسسته سازی از ۰٫۰۱ تا ۱ متر در نظر گرفته شد، و یک فاصله گسسته نسبتا بزرگ بدون تأثیر بر نتیجه تقسیم تنظیم شد، زیرا مستقیماً بر تقاضای حافظه تأثیر می گذاشت. همانطور که در شکل ۱۲ نشان داده شده است، به نظر می رسد که فاصله گسسته سازی اثر نمایی بر تعداد نقاط تولید شده دارد. برای مقادیر گسسته سازی بیشتر از ۰٫۳ متر (دم توزیع)، تقاضای محاسباتی نسبتاً پایدار باقی ماند، در حالی که برای مقادیر بالاتر (سر توزیع)، به شدت رشد کرد، بیش از دو برابر در هر مرحله. بنابراین فواصل گسسته سازی ≥۰٫۳ متر به عنوان موثرتر محاسباتی ترجیح داده شد. فاصله گسسته سازی کمتر از ۳/۰ متر بر نتایج تأثیر معنی داری نداشت. در مقابل، یک بازه گسسته > 3 یک هندسه “اره مانند” ایجاد کرد که ۲٫۱٪ را به خود اختصاص داد که تأثیر آشکارتری بر تقسیم بندی منطقه داشت. بنابراین، برای متعادل کردن تقاضای حافظه و دقت نتایج تقسیمبندی، ۲ متر به عنوان فاصله گسستهسازی بهینه برای مشارکت در تقسیمبندی ناحیه انتخاب شد.
۶٫۲٫ تجزیه و تحلیل حساسیت پارامتر LDA
در این بخش، دو پارامتر روش پیشنهادی خود شامل تعداد موضوعات و هایپرپارامتر را ارزیابی می کنیم α�در مدل LDA اعمال می شود. هنگام تجزیه و تحلیل تأثیر تعداد موضوعات، α�روی ۱٫۱ تنظیم شد و هنگام تجزیه و تحلیل تأثیر α�تعداد موضوعات ۲۱ عنوان شد.
- (۱)
-
تعداد موضوعات
همانطور که در جدول ۴ نشان داده شده است ، تعداد موضوعات بر نتایج طبقه بندی تأثیر گذاشت. تعداد کمی از موضوعات توانایی تمایز ویژگی ها را در تشخیص UFZ های مختلف کاهش داد. وقتی تعداد موضوعات به ۶۰ رسید، همه ۱۰ نوع تابع از پیش تعریف شده تحت سلطه یک دسته POI خاص قرار گرفتند. وقتی تعداد موضوعات بیشتر از ۲۱ بود، هیچ توابع جدیدی ظاهر نشد. بنابراین، پیشنهاد می کنیم که وقتی تعداد موضوعات ۲۱ باشد، همه عملکردهای شهری قابل تشخیص هستند.
- (۲)
-
فرا پارامتر
مطالعات قبلی نشان داده اند که هایپرپارامتر α�تأثیر جزئی بر نتایج طبقه بندی دارد. بزرگتر α�مقدار می تواند توزیع موضوع را بین UFZ های مختلف جمع کند. همانطور که در شکل ۱۳ نشان داده شده است ، زمانی که α�محدوده بین ۰٫۵ تا ۲٫۰، دقت کلی بین ۰٫۸۱ تا ۰٫۸۴ بود. علاوه بر این، زمانی که α�۱٫۱ تعیین شد، بهترین نتیجه بدست آمد.
۶٫۳٫ تایید نتایج طبقه بندی
- (۱)
-
ارزیابی واحدهای نقشه برداری UFZ
برای بررسی اثرات منطقهبندی، غنا و تنوع کلاس POI را بین روش پیشنهادی و روش تقسیمبندی مبتنی بر جاده مقایسه کردیم. در میان آنها، غنای کلاس POI به تعداد کلاس های موجود در یک واحد اشاره دارد. شاخص تنوع کلاس POI توسط شاخص تنوع شانون محاسبه شد که نشان دهنده تنوع کاربری های کاربردی شهری است. جدول ۵نشان می دهد که واحدهای مقیاس کوچک تولید شده با روش پیشنهادی دارای شاخص تنوع پایین و شاخص غنای پایینی هستند. در مقایسه با مقیاسهای کوچک، میانگین تنوع و شاخصهای غنا در واحدهای تقسیمبندی مبتنی بر جاده بیشتر بود، زیرا واحدهای بزرگتر شامل میزان بیشتری با توابع متفاوت بودند. با این حال، این مشکل استخراج کاربری کاربردی شهری را افزایش داد زیرا واحدها حاوی اطلاعات POI بسیار زیادی بودند.
علاوه بر این، شکل ۱۴ نتایج طبقه بندی مختلف به دست آمده توسط روش های تقسیم بندی مختلف در منطقه انتخاب شده را نشان می دهد. همانطور که در شکل ۱۴ a-c نشان داده شده است، نتایج طبقه بندی منطقه عملکردی منطقه کیو در Z-Park نشان می دهد که علامت شماره ۱ به عنوان یک منطقه کاملاً مسکونی در نتایج بر اساس روش قطعه بندی جاده نمایش داده می شود. نتایج طبقهبندی بر اساس روش پیشنهادی در مطالعه ما نشان میدهد که کاربردهای عملکردی ترکیبی از جمله مسکونی، تأسیسات تجاری، تسهیلات تجاری، تحقیقات آموزشی و علمی، خدمات حملونقل و فضای اداری اداری دارد. همانطور که در شکل ۱۴ نشان داده شده استd-f، نتایج طبقهبندی منطقه عملکردی Wangfujing نشان میدهد که علامت شماره ۲ به عنوان یک منطقه تجاری خالص در نتایج بر اساس روش تقسیمبندی جاده نمایش داده میشود. نتایج طبقهبندی بر اساس روش پیشنهادی در تحقیق ما نشان میدهد که اگرچه عمدتاً یک منطقه تجاری است، اما تعداد کمی از کاربردهای ترکیبی دیگر از جمله میراث، خدمات حملونقل، مسکونی، تسهیلات تجاری، فضای اداری اداری و عمومی نیز دارد. سرویس. نتایج نشان میدهد که در مقایسه با روش تقسیمبندی مبتنی بر جاده، استفاده از واحدهای تحلیل فضایی بهدستآمده با روش پیشنهادی برای شناسایی UFZها در مقیاس ریزدانه معقولتر و مؤثرتر بود.
- (۲)
-
ارزیابی دقت
از آنجایی که بدست آوردن عملکرد واقعی همه UFZ ها دشوار است، در مجموع ۵۰۰ UFZ با عملکردهای مختلف به صورت دستی به عنوان مرجع شناسایی شدند که با کمک دانش محلی، نقشه های Gaode و تحقیقات میدانی کمک می شود. ماتریس سردرگمی مرتبط در شکل ۱۵ نشان داده شده است . در روش پیشنهادی، دقت کلی ۰٫۸۴ با مقدار کاپا ۰٫۸۲ و در روش مبتنی بر جاده، دقت کلی ۰٫۷۶ با مقدار کاپا ۰٫۷۶ به دست آمد. به طور کلی، استراتژیهای تقسیمبندی منطقهای پیشنهادی میتواند به طور قابلتوجهی نتایج طبقهبندی را برای به دست آوردن نقشههای منطقه عملکردی شهری تصفیهشده بهبود بخشد.
۶٫۴٫ اثربخشی و محدودیت ها
همانطور که در بالا مورد بحث قرار گرفت، هدف اصلی این مطالعه ایجاد نقشه برداری UFZ تصفیه شده از طریق نمودار Voronoi پیشنهادی برای روش چندضلعی بود. توجیه اصلی و استدلالهای علمی این تحقیق این است که نمودار ورونوی میتواند واحدهای تقسیمبندی فضایی معنیدارتری (در مقایسه با TAZ) تولید کند. به طور خاص، این مطالعه به طور عینی واحدی از تجزیه و تحلیل را تعریف کرد که میتواند کوچکترین و احتمالاً اساسیترین سطح تقسیمبندی فضایی را به دست آورد و یک روش قابل اعتماد و قابل تکرار برای تولید و اندازهگیری آن ایجاد کرد. نوآوری های اصلی این مقاله به شرح زیر است:
(۱) روش نمودار ورونوی موجود، تقسیمات نقشه را بر اساس نقاط به جای چند ضلعی ایجاد می کند. ساختمان ها داده های چند ضلعی هستند که نمی توانند مستقیماً برای تقسیم بندی نقشه استفاده شوند. در روش پیشنهادی، مرزهای ساختمان به نقاط گسسته، ردیابی نقطهای مکانی انجام میشود، و تقسیمبندی نقشه تصفیهشده از طریق چند ضلعیها ایجاد میشود. روش نمودار Voronoi از این رو از وابستگی داده های مکانی یک بعدی به فضای دو بعدی گسترش یافته است.
(۲) نمودار Voronoi برای روش چند ضلعی مفید است و چشماندازهای کاربردی گستردهای دارد زیرا به طور یکنواخت کل فضای یک منطقه مطالعه مجموعه را پوشش میدهد، که توپولوژی فضای پیوسته را قادر میسازد تا در سطح نمودار گرفته شود. در واقع، از آنجایی که همه واحدهای تحلیل بر اساس مجاورت تعیین میشوند، میتوان از نمودار ورونوی برای روش چندضلعی برای تحلیلهایی استفاده کرد که بر اساس فواصل توپولوژیکی (تعداد مجموعهای از مراحل توپولوژیکی بین سلولها) به جای فاصلههای جغرافیایی (یک فاصله متریک مجموعهای در اطراف عناصر هستند) استفاده میشود. ، یا در امتداد شبکه خیابانی).
(۳) در فرآیند مدلسازی با استفاده از POI، روشهای مبتنی بر کوتاهترین مسیر و نمونهگیری تصادفی فقط POI را بر اساس فاصله اقلیدسی مرتب میکنند اما توزیع POI واقعی در فضای سه بعدی را در نظر نمیگیرند. روش پنجره کشویی ممکن است منجر به بیش از حد برازش مدل به دلیل نمونه برداری بیش از حد شود. در این مطالعه، در نظر گرفتن ساختمانها و دامنه نفوذ آنها به عنوان واحد تحلیل اساسی میتواند از بلایای احتمالی ناشی از توزیع نابرابر دستههای POI جلوگیری کند. به عنوان مثال، انواع خاصی از POI به دلیل اندازه کوچک به راحتی نادیده گرفته می شوند و برخی از مناطق کاربردی مهم (مانند اداره پست در کنار یک مرکز خرید) نادیده گرفته می شوند.
با این حال، چندین محدودیت هنوز وجود دارد. به عنوان مثال، از آنجایی که روش تقسیم بندی نقشه، هر ویژگی فضایی را به عنوان یک ورودی جداگانه برای تقسیم در نظر می گیرد، ویژگی های فضایی نباید از چند قسمت تشکیل شده باشد. دوم، زمان مصرف ساخت نمودار ورونوی در فرآیند تقسیم نقشه با تعداد ساختمان های شهر و فاصله نقاط گسسته ارتباط قابل توجهی دارد. پیچیدگی زمانی است O ( n log n )�(�ورود به سیستم�)، و پیچیدگی فضا است O ( n log n )�(�ورود به سیستم�). محاسبات موازی یا بلوکی باید برای محاسبات در مقیاس بزرگ استفاده شود. در نهایت، ممکن است هیچ مجموعه داده ساختمانی کاملی برای برخی از کشورهای در حال توسعه وجود نداشته باشد، و فنآوریهای سنجش از دور [ ۳۵ ، ۳۶ ] برای استخراج ساختمانها برای به دست آوردن مجموعه دادههای مفید برای تقسیمبندی نیاز به استفاده دارند.
۷٫ نتیجه گیری
UFZ ها منعکس کننده ویژگی های توزیع واقعی ساختار فضایی شهری و اقتصاد اجتماعی هستند. نقشه توزیع UFZ در مقیاس خوب برای تصمیم گیران و برنامه ریزان شهری بسیار مهم است. با این حال، روند سریع شهرنشینی منجر به تنوع UFZ و عوارض درون شهرها می شود که چالش بزرگی برای نقشه برداری دقیق و موثر UFZ ایجاد می کند. این مطالعه چارچوبی را برای ترسیم UFZ ها در سطح ساختمان با در نظر گرفتن ویژگی های معنایی استخراج شده از POI ایجاد کرد. ابتدا، نمودار Voronoi برای روش تقسیمبندی چند ضلعی برای تولید واحدهای تحلیل فضایی با ادغام دادههای ساختمان، فضای سبز، منطقه آب و شبکه جادهای پیشنهاد شد. متعاقباً، POIهای مبتنی بر Gaode طبقهبندیشده و مدل LDA برای استخراج ویژگیهای معنایی معرفی شدند. سرانجام، ما تمام ویژگی های معنایی را در یک طبقه بندی کننده SVM چند کلاسه وارد می کنیم که برای به دست آوردن نقشه UFZ اعمال می شود. نتایج نشان داد که مدل پیشنهادی می تواند به طور موثر منطقه مورد مطالعه را برای به دست آوردن UFZ های تصفیه شده با دقت طبقه بندی بالاتر تقسیم کند (دقت کلی = ۸۴٪؛ کاپا = ۰٫۸۲).
در کار آینده، سایر داده های باز (مانند تصاویر سنجش از راه دور و داده های موقعیت یابی تلفن همراه) برای بهبود دقت تقسیم UFZ معرفی خواهند شد.
منابع
- دو، اس. دو، اس. لیو، بی. ژانگ، ایکس. نقشهبرداری مناطق عملکردی شهری با مقیاس بزرگ و ریزدانه از تصاویر VHR با استفاده از یک شبکه تقسیمبندی معنایی چند مقیاسی و رویکرد مبتنی بر شی. سنسور از راه دور محیط. ۲۰۲۱ ، ۲۶۱ ، ۱۱۲۴۸۰٫ [ Google Scholar ] [ CrossRef ]
- جوکار ارسنجانی، ج. هلبیچ، ام. باکیالله، م. هاگناور، جی. Zipf، A. به سمت نقشه برداری الگوهای کاربری زمین از اطلاعات جغرافیایی داوطلبانه. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۳ ، ۲۷ ، ۲۲۶۴-۲۲۷۸٫ [ Google Scholar ] [ CrossRef ]
- گائو، اس. یانوویچ، ک. کوکللیس، اچ. استخراج مناطق عملکردی شهری از نقاط مورد علاقه و فعالیت های انسانی در شبکه های اجتماعی مبتنی بر مکان. ترانس. GIS ۲۰۱۷ ، ۲۱ ، ۴۴۶-۴۶۷٫ [ Google Scholar ] [ CrossRef ]
- نیو، اچ. سیلوا، EA تعیین استفاده عملکردی شهری از دادههای مورد علاقه با تعبیه شبکه عصبی: مطالعه موردی در لندن بزرگ. محاسبه کنید. محیط زیست سیستم شهری ۲۰۲۱ ، ۸۸ ، ۱۰۱۶۵۱٫ [ Google Scholar ] [ CrossRef ]
- یائو، ی. لی، ایکس. لیو، ایکس. لیو، پی. لیانگ، ز. ژانگ، جی. Mai، K. سنجش توزیع فضایی کاربری زمین شهری با ادغام نقاط مورد علاقه و مدل Google Word2Vec. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۷ ، ۳۱ ، ۸۲۵-۸۴۸٫ [ Google Scholar ] [ CrossRef ]
- هوانگ، ایکس. یانگ، جی. لی، جی. Wen, D. نقشهبرداری منطقه عملکردی شهری با ادغام نور شبانه با وضوح فضایی بالا و تصاویر چند نمای روز. ISPRS J. Photogramm. Remote Sens. ۲۰۲۱ , ۱۷۵ , ۴۰۳–۴۱۵٫ [ Google Scholar ] [ CrossRef ]
- تو، دبلیو. هو، ز. لی، ال. کائو، جی. جیانگ، جی. لی، کیو. لی، کیو. به تصویر کشیدن مناطق عملکردی شهری با جفت کردن تصاویر سنجش از دور و داده های سنجش انسانی. Remote Sens. ۲۰۱۸ , ۱۰ , ۱۴۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- لیو، ایکس. او، جی. یائو، ی. ژانگ، جی. لیانگ، اچ. وانگ، اچ. Hong, Y. طبقه بندی کاربری زمین شهری با ادغام داده های سنجش از دور و رسانه های اجتماعی. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۷ ، ۳۱ ، ۱۶۷۵-۱۶۹۶٫ [ Google Scholar ] [ CrossRef ]
- مارتین، دی. کاکینگ، اس. Harfoot, A. توسعه یک چارچوب جغرافیایی برای داده های محل کار سرشماری. JR Stat. Soc. سر. A (Stat. Soc.) ۲۰۱۳ ، ۱۷۶ ، ۵۸۵-۶۰۲٫ [ Google Scholar ] [ CrossRef ]
- Longley, P. سیستمهای اطلاعات جغرافیایی: رنسانس ژئودموگرافیک برای ارائه خدمات عمومی. Prog. هوم Geogr. ۲۰۰۵ ، ۲۹ ، ۵۷-۶۳٫ [ Google Scholar ] [ CrossRef ]
- یوان، نیوجرسی؛ ژنگ، ی. Xie، X. وانگ، ی. ژنگ، ک. Xiong، H. کشف مناطق عملکردی شهری با استفاده از مسیرهای فعالیت پنهان. IEEE Trans. بدانید. مهندسی داده ۲۰۱۵ ، ۲۷ ، ۷۱۲-۷۲۵٫ [ Google Scholar ] [ CrossRef ]
- تو، دبلیو. کائو، جی. یو، ی. شاو، اس ال. ژو، ام. وانگ، ز. چانگ، ایکس. خو، ی. لی، کیو. اتصال داده های تلفن همراه و رسانه های اجتماعی: رویکردی جدید برای درک عملکردهای شهری و الگوهای روزانه. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۷ ، ۳۱ ، ۲۳۳۱-۲۳۵۸٫ [ Google Scholar ] [ CrossRef ]
- آهنگ، جی. لین، تی. لی، ایکس. پریشچپوف، نقشه برداری AV مناطق عملکردی شهری با ادغام تصاویر سنجش از دور با وضوح بسیار بالا و نقاط مورد علاقه: مطالعه موردی Xiamen، چین. Remote Sens. ۲۰۱۸ ، ۱۰ ، ۱۷۳۷٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
- هو، ی. Han, Y. شناسایی مناطق عملکردی شهری بر اساس دادههای POI: مطالعه موردی منطقه توسعه اقتصادی و فناوری گوانگژو. پایداری ۲۰۱۹ ، ۱۱ ، ۱۳۸۵٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
- ژای، دبلیو. بای، ایکس. شی، ی. هان، ی. پنگ، Z.-R. Gu, C. Beyond Word2vec: رویکردی برای استخراج و شناسایی منطقه عملکردی شهری با ترکیب Place2vec و POI. محاسبه کنید. محیط زیست سیستم شهری ۲۰۱۹ ، ۷۴ ، ۱-۱۲٫ [ Google Scholar ] [ CrossRef ]
- Li, W. متنهای تصادفی توزیع فراوانی کلمهای شبیه به قانون Zipf را نشان میدهند. IEEE Trans. Inf. نظریه ۱۹۹۲ ، ۳۸ ، ۱۸۴۲-۱۸۴۵٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- یوان، نیوجرسی؛ ژنگ، ی. Xie, X. کشف مناطق عملکردی در یک شهر با استفاده از حرکات انسانی و نقاط مورد علاقه. در تحلیل فضایی و مدل سازی مکان در سیستم های شهری و منطقه ای ; Thill, J.-C., Ed. Springer: برلین/هایدلبرگ، آلمان، ۲۰۱۸; صص ۳۳-۶۲٫ [ Google Scholar ]
- چی، جی. جیائو، ال. دونگ، تی. گو، ی. Ma، Y. شناسایی کمی و تجسم منطقه عملکردی شهری بر اساس دادههای POI. جی. ژئومات. ۲۰۱۶ ، ۴۱ ، ۶۸-۷۳٫ [ Google Scholar ] [ CrossRef ]
- هو، تی. یانگ، جی. لی، ایکس. Gong, P. نقشه برداری کاربری زمین شهری با استفاده از تصاویر Landsat و داده های اجتماعی باز. Remote Sens. ۲۰۱۶ , ۸ , ۱۵۱٫ [ Google Scholar ] [ CrossRef ]
- Openshaw, S. مغالطه های زیست محیطی و تجزیه و تحلیل داده های سرشماری منطقه ای. محیط زیست طرح. A ۱۹۸۴ ، ۱۶ ، ۱۷-۳۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- وانگ، ن. لی، دبلیو. تائو، آر. Du، Q. تشخیص تغییر شهری در سطح بلوک مبتنی بر نمودار با استفاده از سری زمانی Sentinel-2. سنسور از راه دور محیط. ۲۰۲۲ ، ۲۷۴ ، ۱۱۲۹۹۳٫ [ Google Scholar ] [ CrossRef ]
- ژو، دبلیو. مینگ، دی. Lv، X.; ژو، ک. بائو، اچ. Hong, Z. SO-CNN بر اساس تقسیم بندی دقیق منطقه عملکردی شهری با تصویر سنجش از دور VHR. سنسور از راه دور محیط. ۲۰۲۰ ، ۲۳۶ ، ۱۱۱۴۵۸٫ [ Google Scholar ] [ CrossRef ]
- لیو، ی. ژانگ، ی. جین، ST; لیو، ی. الگوی فضایی فعالیت های اوقات فراغت در میان ساکنان پکن، چین: بررسی تأثیرات محیط شهری. حفظ کنید. جامعه شهرها ۲۰۲۰ ، ۵۲ ، ۱۰۱۸۰۶٫ [ Google Scholar ] [ CrossRef ]
- نیو، اچ. سیلوا، EA داده کاوی جمعسپاری شده برای فعالیت شهری: بررسی منابع داده، کاربردها و روشها. ج. طرح شهری. توسعه دهنده ۲۰۲۰ , ۱۴۶ , ۰۴۰۲۰۰۰۷٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- لی، ایکس. هو، تی. گونگ، پی. دو، اس. چن، بی. لی، ایکس. دای، کیو. نقشه برداری از مقوله های کاربری اراضی شهری ضروری در پکن با روش مبتنی بر منطقه سریع علاقه (AOI). Remote Sens. ۲۰۲۱ , ۱۳ , ۴۷۷٫ [ Google Scholar ] [ CrossRef ]
- سان، ز. لی، ایکس. فو، دبلیو. لی، ی. تانگ، دی. اثرات بلندمدت تغییر کاربری/پوشش زمین بر رواناب سطحی در مناطق شهری پکن، چین. J. Appl. Remote Sens. ۲۰۱۳ , ۸ , ۰۸۴۵۹۶٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- ژائو، ال. Li, Y. مطالعه بر روی بخش ترافیک شبکه جاده شهری بر اساس تجزیه و تحلیل خوشهبندی. در مجموعه مقالات کنگره اتوماسیون چین ۲۰۱۸ (CAC)، شیان، چین، ۳۰ نوامبر تا ۲ دسامبر ۲۰۱۸؛ صص ۳۵۵۶–۳۵۶۰٫ [ Google Scholar ]
- چن، ی. لیو، ایکس. لی، ایکس. لیو، ایکس. یائو، ی. در آغوش گرفتن.؛ خو، X. Pei، F. ترسیم مناطق عملکردی شهری با دادههای رسانههای اجتماعی در سطح ساختمان: یک روش تابخوردگی زمانی پویا (DTW) مبتنی بر فاصله k-medoids. Landsc. طرح شهری. ۲۰۱۷ ، ۱۶۰ ، ۴۸-۶۰٫ [ Google Scholar ] [ CrossRef ]
- Blei، DM; نگ، ا. جردن، MI تخصیص دیریکله نهفته. جی. ماخ. فرا گرفتن. Res. ۲۰۰۳ ، ۳۰ ، ۹۹۳-۱۰۲۲٫ [ Google Scholar ] [ CrossRef ]
- دو، اس. دو، اس. لیو، بی. ژانگ، ایکس. Zheng, Z. نقشهبرداری منطقه عملکردی شهری در مقیاس بزرگ با ادغام تصاویر سنجش از دور و دادههای اجتماعی باز. GISci. Remote Sens. ۲۰۲۰ , ۵۷ , ۴۱۱–۴۳۰٫ [ Google Scholar ] [ CrossRef ]
- کورتس، سی. Vapnik، V. پشتیبانی-بردار شبکه. ماخ فرا گرفتن. ۱۹۹۵ ، ۲۰ ، ۲۷۳-۲۹۷٫ [ Google Scholar ] [ CrossRef ]
- فلیشمن، ام. فلیچیوتی، آ. رومیس، او. پورتا، اس. بافت مورفولوژیکی به عنوان روشی برای پارتیشن بندی فضا: بهبود ثبات در مورفولوژی شهری در مقیاس طرح. محاسبه کنید. محیط زیست سیستم شهری ۲۰۲۰ , ۸۰ , ۱۰۱۴۴۱٫ [ Google Scholar ] [ CrossRef ]
- ژانگ، ی. لی، کیو. هوانگ، اچ. وو، دبلیو. دو، X. وانگ، اچ. استفاده ترکیبی از داده های سنجش از دور و سنجش اجتماعی در نقشه برداری کاربری زمین شهری با دانه بندی ریز: مطالعه موردی در پکن، چین. Remote Sens. ۲۰۱۷ , ۹ , ۸۶۵٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- دنگ، ی. لیو، جی. لو، ا. وانگ، ی. خو، اس. رن، اف. Su، F. عدم تطابق فضایی بین عرضه و تقاضای خدمات اوقات فراغت شهری با داده های باز چندمنبعی. ISPRS Int. J. Geo-Inf. ۲۰۲۰ ، ۹ ، ۴۶۶٫ [ Google Scholar ] [ CrossRef ]
- جی، اس. وی، اس. Lu, M. شبکههای کاملاً کانولوشنال برای استخراج ساختمانهای چند منبعی از مجموعه دادههای تصویری هوایی و ماهوارهای باز. IEEE Trans. Geosci. Remote Sens. ۲۰۱۹ , ۵۷ , ۵۷۴–۵۸۶٫ [ Google Scholar ] [ CrossRef ]
- چن، ک. فو، ک. گائو، ایکس. یان، م. سان، ایکس. ژانگ، اچ. استخراج ساختمان از تصاویر سنجش از راه دور با یادگیری عمیق به روشی نظارت شده. در مجموعه مقالات سمپوزیوم بین المللی زمین شناسی و سنجش از دور IEEE 2017 (IGARSS)، فورت ورث، تگزاس، ایالات متحده آمریکا، ۲۳ تا ۲۸ ژوئیه ۲۰۱۷؛ صفحات ۱۶۷۲-۱۶۷۵٫ [ Google Scholar ]
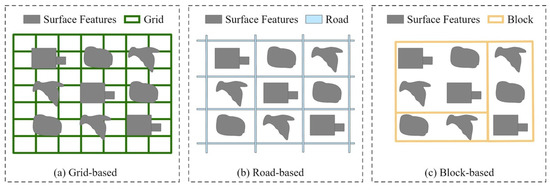
شکل ۱٫ نمونه هایی از روش های تقسیم بندی منطقه های مختلف.

شکل ۲٫ منطقه مورد مطالعه: پکن (در داخل خطوط قرمز).

شکل ۳٫ نمودار رتبه-فرکانس برای POI. ( الف ) نمودار فرکانس نسبی. ( ب ) نمودار ثبت فرکانس نسبی.
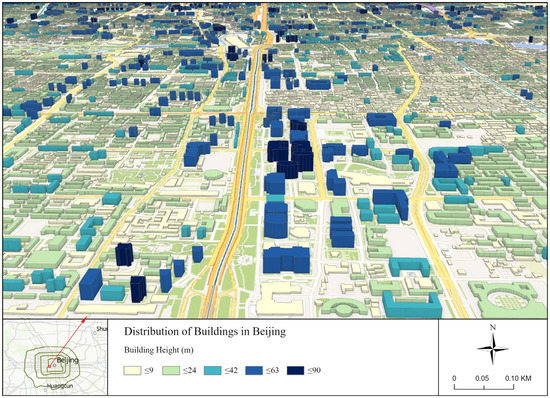
شکل ۴٫ نمونه ای از توزیع ساختمان در پکن (تصویر بزرگ شده شی دان را نشان می دهد).

شکل ۵٫ نمودار جریان روش.

شکل ۶٫ چند ضلعی های تیسن بر اساس نقاط تصادفی.

شکل ۷٫ نمودار ورونوی برای روش چند ضلعی.

شکل ۸٫ تصویری از اثر فاصله گسسته سازی که باعث هندسه “اره مانند” در مرز بین ساختمان های مجاور ( a ) در مقایسه با ترکیب ایده آل ( b ، c ) می شود.

شکل ۹٫ نتایج تقسیم بندی منطقه. ( الف ) روش پیشنهادی. ( ب ) روش MT. ( ج ) روش مبتنی بر جاده.

شکل ۱۰٫ بیست و یک مبحث و کلمه احتمال در هر مبحث.
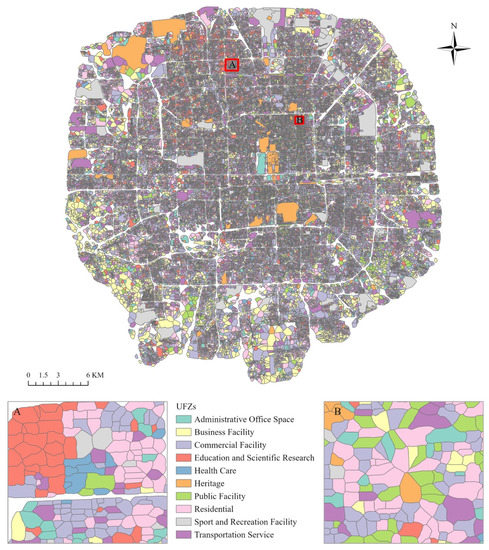
شکل ۱۱٫ نتایج طبقه بندی UFZ (روش پیشنهادی).

شکل ۱۲٫ رابطه فاصله گسسته سازی و تعداد نقاط تولید شده.

شکل ۱۳٫ تجزیه و تحلیل تاثیر پارامتر با هایپرپارامتر α.
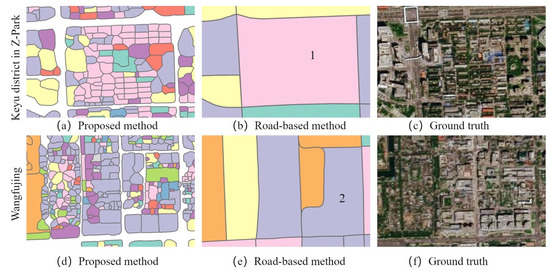
شکل ۱۴٫ تصویری از نتایج نقشه برداری UFZ با استراتژی های مختلف تقسیم بندی منطقه. ( الف ، د ) روش پیشنهادی، ( ب ، ه ) روش مبتنی بر جاده، ( ج ، و ) حقیقت زمین.

شکل ۱۵٫ ماتریس سردرگمی نتایج طبقه بندی.