نقشه‌برداری مناسب فضایی جهانی سیستم‌های بادی و خورشیدی با استفاده از یک رویکرد مبتنی بر هوش مصنوعی قابل توضیح


چکیده

ارزیابی مناسب بودن سایت برای نیروگاه های بادی و خورشیدی یک گام استراتژیک به سمت حصول اطمینان از پروژه ای کم هزینه، با عملکرد بالا و پایدار است. با این حال، این مسائل اغلب در مقیاس محلی با استفاده از رویکردهای تصمیم گیری سنتی که شامل وزن دهی های مغرضانه و غیرقابل تعمیم است، رسیدگی می شود. این مطالعه یک رویکرد نقشه برداری جهانی باد و خورشید را بر اساس هوش مصنوعی قابل توضیح (XAI) ارائه می کند. با توجه به دانش نویسنده، مطالعه حاضر اولین تلاش برای ایجاد نقشه های جهانی برای مکان یابی سیستم های انرژی بادی و خورشیدی در خشکی و فرموله کردن وزن های جدید برای معیارهای تصمیم گیری است. در مجموع ۱۳ عامل شرطی (متغیرهای مستقل) تعریف شده از طریق مرور ادبیات جامع و تجزیه و تحلیل چند خطی مورد ارزیابی قرار گرفتند. تجربیات انرژی های تجدیدپذیر در دنیای واقعی (بیش از ۵۵، ۰۰۰ نیروگاه بادی و خورشیدی در محل در سراسر جهان برای آموزش سه الگوریتم یادگیری ماشین (ML) به نام‌های جنگل تصادفی (RF)، ماشین بردار پشتیبانی (SVM) و پرسپترون چند لایه (MLP) مورد بهره‌برداری قرار می‌گیرند. سپس خروجی مدل‌های ML با استفاده از توضیحات افزودنی SHapley (SHAP) توضیح داده شد. RF بهتر از SVM و MLP در مدل‌سازی بادی و خورشیدی با دقت کلی ۹۰% و ۸۹%، ضریب کاپا ۰٫۷۹ و ۰٫۷۸ و سطح زیر منحنی ۰٫۹۶ و ۰٫۹۵ عمل کرد. مقوله‌های تناسب بالا و بسیار بالا ۲۳٫۲% (~۲۶٫۸۴ میلیون کیلومتر) را تشکیل می‌دهند RF بهتر از SVM و MLP در مدل‌سازی بادی و خورشیدی با دقت کلی ۹۰% و ۸۹%، ضریب کاپا ۰٫۷۹ و ۰٫۷۸ و سطح زیر منحنی ۰٫۹۶ و ۰٫۹۵ عمل کرد. مقوله‌های تناسب بالا و بسیار بالا ۲۳٫۲% (~۲۶٫۸۴ میلیون کیلومتر) را تشکیل می‌دهند RF بهتر از SVM و MLP در مدل‌سازی بادی و خورشیدی با دقت کلی ۹۰% و ۸۹%، ضریب کاپا ۰٫۷۹ و ۰٫۷۸ و سطح زیر منحنی ۰٫۹۶ و ۰٫۹۵ عمل کرد. مقوله‌های تناسب بالا و بسیار بالا ۲۳٫۲% (~۲۶٫۸۴ میلیون کیلومتر) را تشکیل می‌دهند۲ ) نقشه تناسب سایت برای نیروگاه های بادی. علاوه بر این، آنها مناطق دلگرم‌کننده‌تر (به ترتیب ۲۴٫۰ و ۱۹٫۴ درصد، معادل ۵۰٫۳۱ میلیون کیلومتر مربع) را در نقشه جهانی برای میزبانی مزارع انرژی خورشیدی پوشش دادند . تفاسیر SHAP با شاخص جینی سازگار بود که نشان دهنده تسلط وزن عوامل فنی و اقتصادی بر ارزیابی فضایی مورد بررسی است. این مطالعه از تصمیم گیرندگان در جهت برنامه ریزی قدرت پایدار در سراسر جهان پشتیبانی می کند.

کلید واژه ها:

گیاهان بادی ؛ نیروگاه های خورشیدی ; مناسب بودن سایت ; XAI ; GIS

۱٫ مقدمه

امروزه، جهان با چالش هایی در تامین تقاضای فزاینده انرژی مرتبط با انفجار جمعیت و تلاش برای کاهش انتشار گازهای گلخانه ای همراه با این فعالیت ها مواجه است [ ۱ ]. خوشبختانه، توسعه انرژی های تجدیدپذیر (RE) به عنوان یک عنصر ضروری از یک استراتژی برای کاهش تغییرات آب و هوایی به طور گسترده مورد توافق قرار گرفته است [ ۲ ]. پیش‌بینی می‌شود که سهم RE در تولید برق جهانی از برآورد فعلی ۲۶% به ۸۶% تا سال ۲۰۵۰ افزایش یابد [ ۳ ]. جالب توجه است که انرژی بادی و خورشیدی بالغ‌ترین و محبوب‌ترین منابع انرژی سبز هستند که در سطح جهان به دلیل درجه تمیزی، در دسترس بودن، ضریب ظرفیت و هزینه ساخت در مقایسه با سایر منابع انرژی پاک مورد بررسی قرار می‌گیرند [ ۴ ].]. با این حال، زمین های وسیع با مشخصات ویژه برای اطمینان از موفقیت مزارع فتوولتائیک خورشیدی (PV) در مقیاس بزرگ مورد نیاز است [ ۵ ]. به طور مشابه، توسعه نیروگاه های بادی مستلزم اکتشاف دقیق سایت ها برای برآورده کردن شرایط عملیاتی استاندارد است [ ۶ ]. بنابراین، ارزیابی مناسب بودن سایت که بسیاری از جنبه‌ها را در نظر می‌گیرد، در چرخه حیات سیستم‌های بادی و خورشیدی برای آینده‌ای با کربن کم بسیار مهم است.
به طور سنتی، مناسب بودن سایت برای نیروگاه های بادی و خورشیدی با استفاده از تکنیک های تصمیم گیری چند معیاره (MCDM) مانند فرآیند تحلیل سلسله مراتبی (AHP) [ ۷ ، ۸ ، ۹ ]، تکنیک برای ترتیب اولویت بر اساس شباهت به راه حل ایده آل، ارزیابی می شود. TOPSIS) [ ۱ ، ۱۰ ] و منطق فازی [ ۱۱ ، ۱۲ ]. در ارزیابی مبتنی بر MCDM، معیارها اغلب به صورت ذهنی یا عینی وزن داده می شوند [ ۱۳]. از یک طرف، وزن دهی ذهنی شامل سوگیری است، به ویژه در مناطقی که فاقد بلوغ دانش کافی از تجربیات دنیای واقعی RE هستند تا کارشناسان محلی را قادر به قضاوت آگاهانه کنند. از سوی دیگر، وزن‌دهی عینی با ناتوانی آن در تعمیم مشخص می‌شود، زیرا تنها می‌تواند برای جایگزین‌های از پیش تعیین‌شده اعمال شود. علاوه بر این، هنگامی که یک جایگزین اضافه یا حذف می شود، وزن ها تغییر می کنند [ ۱۴ ]. بر این اساس، رویکردهای مختلفی که راه حل های قابل اعتماد و قابل تعمیم ارائه می کنند باید اتخاذ شوند.
اخیراً، تکنیک‌های یادگیری ماشین (ML) و سیستم‌های اطلاعات جغرافیایی (GIS)، همراه با داده‌های سنجش از راه دور (RS)، به عنوان یکی از مناسب‌ترین رویکردها برای نقشه‌برداری تناسب فضایی و حساسیت به خطر در حال ظهور هستند. مدل‌های ML با موفقیت در بسیاری از زمینه‌ها برای حل مسائل مکان‌یابی، مانند پیش‌بینی مکان‌های مناسب برای سدها [ ۱۵ ]، بیمارستان‌ها [ ۱۶ ]، دفن زباله‌های جامد [ ۱۷ ]، احیای کشاورزی [ ۱۸ ] و زیستگاه‌ها [ ۱۹ ] اجرا شده‌اند.]. در همین حال، تلاش‌های جالبی برای استفاده از تکنیک‌های ML در انتخاب مکان‌های بهینه برای مزارع RE و پیش‌بینی منابع تجدیدپذیر آن‌ها پیدا شده است. برای مثال، یک رویکرد ترکیبی از وزن‌های AHP و طبقه‌بندی مناسب الگوریتم پرسپترون چند لایه (MLP) برای مکان‌یابی نیروگاه‌های بادی/خورشیدی در آذربایجان شرقی، ایران استفاده شد [ ۲۰ ]. این مطالعه گزارش داد که با استفاده از این روش، افزودن یک نامزد جدید بر نمرات مناسب بودن گزینه‌های دیگر تأثیر نمی‌گذارد. جانی و همکاران [ ۲۱] یک روش منحصر به فرد مبتنی بر ML برای انتخاب مکان های موثر برای همزمانی خورشیدی و باد پیشنهاد کرد. در کار دیگری که ایالات متحده آمریکا را پوشش می‌دهد، عملکرد پنج الگوریتم ML، یعنی K-نزدیک‌ترین همسایگان (k-NN)، ماشین بردار پشتیبان (SVM)، درخت تصمیم (DT)، جنگل تصادفی (RF) و MLP مورد تجزیه و تحلیل قرار گرفت. مکان های بهینه را در برابر سه نوع انرژی پاک (بادی، خورشیدی و زمین گرمایی) پیدا کنید [ ۲۲ ]]. تجزیه و تحلیل نشان داد که الگوریتم RF بهترین عملکرد را با دقت کلی ۹۲٪ دارد. علی‌رغم توصیه‌های کار قبلی برای اتخاذ ML به عنوان یک جایگزین مناسب برای روش‌های MCDM، در دسترس بودن نمونه‌های حقیقت زمینی یک عامل کلیدی برای آموزش موفقیت‌آمیز مدل‌های هوشمند است. بنابراین، استفاده از این تکنیک های جدید برای مکان یابی نیروگاه های بادی و خورشیدی اغلب در کشورهای در حال توسعه که به تازگی برنامه ریزی برای تکیه بر منابع انرژی سبز را آغاز کرده اند ممکن نیست. یکی دیگر از موانع استفاده قابل اعتماد از مدل‌های ML در تصمیم‌گیری در دنیای واقعی، عدم شفافیت و توضیح‌پذیری خروجی‌های مدل‌ها است زیرا این مدل‌ها مدل‌های جعبه سیاه هستند [ ۲۳ ].
در چند سال اخیر، جعبه سیاه مدل‌های ML با انتقال الگوریتم‌های هوش مصنوعی قابل توضیح (XAI) مانند SHapley Additive Explanations (SHAP) شکسته شده است. XAI به الگوریتم های هوش مصنوعی اشاره دارد که در آن انسان ها می توانند خروجی را در سطح قابل قبولی به طور منطقی تفسیر کنند [ ۲۴ ]. توضیح‌پذیری درک تأثیر و سهم هر ویژگی ورودی بر خروجی مدل‌های هوش مصنوعی را تسهیل می‌کند [ ۲۵ ]. علاوه بر این، XAI توانایی تشخیص سوگیری در مجموعه داده های آموزشی را دارد، در نتیجه بی طرفی در تصمیم گیری را تضمین می کند [ ۲۶ ]. XAI به طور فزاینده ای در زمینه پیش بینی فضایی خشکسالی [ ۲۷ ، ۲۸ ] و زمین لغزش [ ۲۹ ] استفاده شده است.]، نقشه برداری از آسیب ساختمان های ناشی از زلزله [ ۲۵ ] و نقشه برداری پوشش گیاهی شهری [ ۳۰ ]. اکثر این مطالعات به این نتیجه رسیدند که XAI نه تنها می‌تواند بینشی در مورد خروجی مدل‌های هوشمند ارائه دهد، بلکه درک ما را از استفاده از مدل‌های مبتنی بر ML برای تصمیم‌گیری آگاهانه نیز تغییر می‌دهد [ ۲۸ ]]. با توجه به چالش‌ها و فرصت‌های فوق، هدف این مقاله انجام یک ارزیابی جهانی مبتنی بر GIS با استفاده از تکنیک‌های ML و XAI برای شناسایی مناطق مناسب برای توسعه ایستگاه‌های بادی و خورشیدی خشکی است. با چشم انداز کل نگر، تجربیات RE در محل در سراسر جهان می تواند به نقشه برداری مناسب فضایی در سراسر سیاره، از جمله در کشورهای در حال توسعه کمک کند. چنین تجربیاتی همچنین می تواند وزن های بی طرفانه ای را برای معیارهای تصمیم گیری ایجاد کند که می تواند در سراسر جهان اعمال شود. طبق دانش نویسندگان، این مطالعه اولین مطالعه ای است که در مقیاس جهانی موضوع مناسب بودن سایت برای سیستم های انرژی خورشیدی و بادی را بررسی می کند. اهداف خاص عبارت بودند از (۱) ایجاد یک چارچوب ترکیبی XAI-GIS برای انتخاب مناسب ترین مکان ها برای تاسیسات RE، با در نظر گرفتن ژئوتکنیکی، اقتصادی، و عوامل تهویه محیطی؛ (ii) چارچوب پیشنهادی را برای تولید نقشه های جهانی مناسب بودن سایت برای تاسیسات بادی و خورشیدی انجام دهد. و (iii) کشف وزن عامل موثر بر مکان بهینه.

۲٫ مواد و روشها

روش توسعه یافته برای ارزیابی مناسب بودن مکان برای نیروگاه های بادی و خورشیدی شامل سه مرحله اصلی است که در شکل ۱ نشان داده شده است.. اول، تلاش‌ها به مکان‌یابی نمونه‌های RE در دنیای واقعی و تولید لایه‌های موضوعی معیارهای شرطی‌سازی تا استخراج مجموعه داده‌های آموزشی اختصاص دارد. مرحله دوم بر پیش پردازش داده ها متمرکز است، که شامل پالایش و بهینه سازی مجموعه داده و تقسیم آن به مجموعه قطار، مجموعه اعتبار سنجی و مجموعه آزمایشی است. در نهایت، عملکرد سه الگوریتم ML، یعنی RF، MLP و SVM مورد ارزیابی قرار می‌گیرد. مدل با متریک های دقیق بالا برای نقشه برداری مناسب فضایی مزارع بادی و خورشیدی در نظر گرفته شده است. علاوه بر این، از تکنیک‌های XAI برای تفسیر نتایج و استخراج وزن‌های جهانی برای عوامل اتخاذ شده استفاده می‌شود. بخش‌های فرعی زیر روش‌شناسی را به تفصیل مورد بحث قرار می‌دهد.

۲٫۱٫ جمع آوری و آماده سازی داده ها

دو نوع داده جمع آوری و تهیه شد: نقشه موجودی نیروگاه های خورشیدی و بادی موجود در سطح جهانی و لایه های موضوعی عوامل تهویه. هدف آموزش یک مدل پیش‌بینی فضایی برای مزارع RE است.

۲٫۱٫۱٫ موجودی نمونه

در دسترس بودن نمونه های آموزشی بر اساس تجربیات دنیای واقعی برای اطمینان از موفقیت هر مدل ML بسیار مهم است [ ۳۱ ]. بر این اساس، تاسیسات خورشیدی و بادی در محل در سراسر جهان نمونه‌هایی برای آموزش یک مدل ارزیابی فضایی مبتنی بر ML در نظر گرفته می‌شوند. برای این منظور، از داده های مکانی منتشر شده و در دسترس عموم در Figshare با عنوان “global_wind_solar_2020” برای فهرست بندی مکان های مورد نظر استفاده می شود [ ۳۲]. این مجموعه داده ها در قالب geopackages و shapefiles برای ارائه مکان های جغرافیایی توربین های بادی و پنل های خورشیدی به صورت جداگانه یا به صورت گروهی در دسترس هستند. توضیحات سایت ها، چه شهری و چه در کنار/روی بدنه آبی، در فراداده این پایگاه داده گنجانده شده است. با توجه به دامنه این مطالعه، مکان‌هایی که به عنوان شهری یا روی بدنه آبی توصیف می‌شوند، مستثنی می‌شوند. همه مکان های بالای ۶۰ درجه شمالی یا کمتر از ۶۰ درجه عرض جغرافیایی جنوبی نیز حذف شده اند. تعداد کل مکان های انرژی بادی و خورشیدی در نظر گرفته شده در این مطالعه به ترتیب ۳۱۵۷۱ و ۲۴۰۴۸ است که در شکل ۲ نشان داده شده است.
۲٫۱٫۲٫ عوامل تهویه
معیارهای منابع طبیعی، مانند سرعت باد (WS) و تابش خورشیدی (SR)، عوامل کلیدی در هنگام انتخاب مکان‌های مزرعه بادی و خورشیدی هستند [ ۳۳ ]. با این حال، سایر پارامترهای زیست محیطی و اقتصادی به همان اندازه در تصمیم گیری قرار دادن سیستم های RE اهمیت دارند [ ۳۴ ]. بنابراین، رایج‌ترین عواملی که دامنه جهانی این مطالعه را تقلید می‌کنند، بر اساس بررسی گسترده نشریاتی که به ارزیابی مناسب بودن سایت ایستگاه‌های بادی و خورشیدی برای مناطق مختلف در سراسر جهان می‌پردازند، به دست آمده‌اند [ ۱ ، ۵ ، ۶ ، ۷ ، ۱۲ ، ۲۰ ، ۳۵ ، ۳۶ ، ۳۷ ،۳۸ , ۳۹ , ۴۰ , ۴۱ , ۴۲ , ۴۳ , ۴۴ , ۴۵ , ۴۶ , ۴۷ , ۴۸ , ۴۹ , ۵۰ , ۵۱ , ۵۲ , ۵۳ , ۵۴ , ۵۵ , ۵۶ , ۵۹ , ۵ _ _]. بر این اساس، WS و چگالی باد (WD) عوامل فنی برای مکان‌یابی ایستگاه‌های بادی در نظر گرفته شدند. با این حال، آنها با SR، دمای هوا (AT) و شاخص ابر (CI) در هنگام ارزیابی مناسب بودن سایت مزارع خورشیدی جایگزین شدند. علاوه بر این، هشت شاخص دیگر در ارزیابی هر دو نوع انرژی شرکت کردند، یعنی شیب (S)، ارتفاع (E)، پوشش زمین (LC)، نزدیکی به جاده (PR)، نزدیکی به شبکه (PG)، نزدیکی به شهر (PC) ، بلایای طبیعی (ND) و تراکم جمعیت (PD) که جنبه های اقتصادی، زیست محیطی و اجتماعی را پوشش می دهد. برای جزئیات بیشتر در مورد اهمیت این معیارها، به ادبیاتی که به طور جامع مورد بحث قرار گرفته اند مراجعه کنید [ ۳۵ ، ۴۳ ، ۴۶ ، ۴۷ ، ۵۹ ، ۶۰ ،۶۱ ].
همانطور که در سطح جهانی بررسی می‌کنیم، پایگاه‌های اطلاعاتی فضایی آنلاین در دسترس عموم از منابع قابل اعتماد برای جمع‌آوری مجموعه داده‌های جهانی برای معیارهای مورد بررسی در نظر گرفته شدند. داده های WS و WD در ارتفاع ۱۰۰ متری از پایگاه داده Global Wind Atlas v3.1 دانلود شد تا نیازهای فنی یک توربین بادی مدرن را برآورده کند. برای فناوری‌های PV خورشیدی، Global Solar Atlas v2.6 برای جمع‌آوری مجموعه داده‌های فضایی AT و تابش افقی جهانی (GHI) استفاده شد، که SR کلی دریافت‌شده در سطح افقی روی زمین است [ ۴۶ ]. قابل ذکر است که داده‌های Global Wind Atlas و Global Solar Atlas، بر اساس داده‌های آب و هوایی تحلیل‌شده مجدد، به طور گسترده در فرمول‌بندی عوامل فنی برای مکان‌یابی نیروگاه‌های RE استفاده می‌شوند [ ۵ ، ۶ ، ۳۵ ]]. علاوه بر این، داده های عامل CI از پایگاه داده پروژه EarthEnv، که بر اساس ۱۵ سال مشاهدات ابری مشتق شده از تصاویر ماهواره ای MODIS دو بار در روز است، به دست آمد [ ۶۲ ]. علاوه بر این، محصولات مدل دیجیتال ارتفاع SRTM 90m v4.1 موجود بر روی پلت فرم EarthEnv دارای گواهی برای نشان دادن فاکتورهای E و S هستند [ ۶۳ ]. در همین حال، داده‌های برداری برای مکان شهرها، شبکه‌های جاده‌ای و شبکه‌های برق در سراسر جهان از یک مجموعه داده منتشر شده جمع‌آوری شد. کیفیت آنها از طریق مقایسه با تصاویر ماهواره ای با وضوح بالا تأیید می شود [ ۶۴ ]. در مرحله بعد، از داده های برداری برای فرموله کردن شاخص های PC، PR و PG استفاده می شود. میز ۱منابع داده LC، ND و PD و جزئیات بیشتر در مورد ویژگی های مجموعه داده های در نظر گرفته شده را ارائه می دهد.
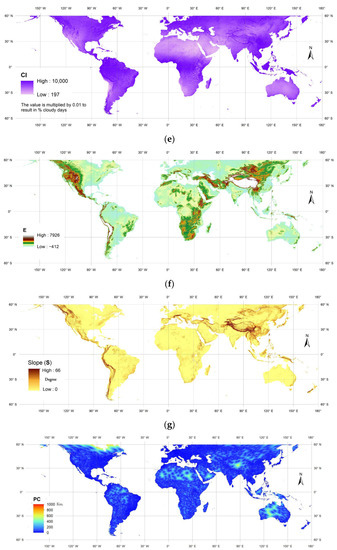
مجموعه داده‌های جمع‌آوری‌شده از نظر ارجاع جغرافیایی، نمونه‌برداری مجدد، و فضای کاری (در خشکی بین عرض جغرافیایی ۶۰ درجه شمالی تا ۶۰ درجه جنوبی) استاندارد شده‌اند. مجموعه داده های برداری با استفاده از ابزار فاصله اقلیدسی به لایه های شطرنجی تبدیل می شوند. در نهایت، همانطور که در شکل ۳ نشان داده شده است، لایه های موضوعی برای عوامل شرطی با نمادشناسی مناسب تولید می شوند .
۲٫۱٫۳٫ استخراج مجموعه داده های آموزشی
بر اساس موجودی نمونه (موقعیت نیروگاه های بادی و خورشیدی) و لایه های موضوعی معیارهای مورد بررسی، دو مجموعه داده آموزشی تولید شد. اولین مجموعه داده برای مکان یابی مزارع بادی خشکی، با ۱۰ عامل ارزیابی/متغیر مستقل اختصاص داده شد: WS، WD، S، E، LC، PR، PG، PC، ND، و PD. در مقابل، مجموعه داده دوم برای ارزیابی مناسب بودن سایت برای مزارع خورشیدی در برابر ۱۱ عامل تأثیرگذار / متغیر مستقل (به عنوان مثال، RR، AT، CI، S، E، LC، PR، PG، PC، ND، و PD) استفاده می‌شود. در مورد متغیرهای وابسته، نمونه های خورشیدی در مجموعه داده اول به عنوان غیربادی اختصاص داده شدند، در حالی که نمونه های باد در مجموعه داده دوم به عنوان غیر خورشیدی تعیین شدند.

۲٫۲٫ پیش پردازش مجموعه داده

به طور معمول، داده‌های دنیای واقعی می‌توانند ناقص (شامل مقادیر گمشده)، نادرست (شامل مقادیر پرت و شدید) و ناسازگار باشند [ ۶۵ ]. بنابراین، پیش پردازش یک مرحله اجتناب ناپذیر برای تمیز کردن، سازماندهی و قالب بندی مجموعه داده های خام است و آنها را برای مدل های ML قابل اجرا می کند. در کار حاضر، دو مجموعه داده که قبلا ذکر شد با استفاده از مراحل متوالی زیر پیش پردازش شدند:
  • مدیریت مقادیر از دست رفته: همه مقادیر از دست رفته، چه برای ویژگی های اسمی یا عددی، با ابزارها و حالت های داده های آموزشی جایگزین می شوند.
  • مقادیر پرت حذف و مقادیر شدید: فیلتری بر اساس محدوده‌های بین چارکی اعمال می‌شود تا نقاط پرت و مقادیر شدید را که خارج از حد انتظار است شناسایی و حذف کند.
  • متعادل سازی داده ها: برای اینکه الگوریتم های ML به صورت بی طرفانه عمل کنند، تعداد نمونه ها باید برای هر متغیر وابسته متعادل باشد [ ۶۶ ]. برای انجام این کار، مجموعه داده‌های ما با استفاده از روش نمونه‌برداری بیش از حد اقلیت مصنوعی (SMOTE)، که در آن نمونه‌های اقلیت بر اساس جمعیت داده‌های اقلیت تکرار می‌شوند، مجدداً نمونه‌برداری شدند.
  • عادی سازی: از آنجایی که واحدهای داده متغیرهای مستقل به طور گسترده ای متفاوت هستند، مقیاس بندی یا عادی سازی ویژگی برای عملکرد صحیح مدل های ML ضروری است [ ۶۷ ]. بر این اساس، تمام مقادیر ویژگی های مورد بررسی در مقیاس استاندارد شده از ۰ تا ۱ نرمال سازی شدند.
  • تقسیم داده ها: یک تکنیک موثر برای درک عملکرد مدل های ML، تقسیم مجموعه داده ها به مجموعه آموزشی، اعتبار سنجی و آزمایش است. مطابق با کار قبلی [ ۱۶ ، ۲۲ ، ۳۱ ]، مجموعه داده ما به ۷۰٪ مجموعه قطار، ۱۵٪ مجموعه اعتبارسنجی و ۱۵٪ مجموعه آزمایش تقسیم می شود. در فرآیند آموزش، مجموعه آموزشی برای جداسازی زیرمجموعه اعتبارسنجی با استفاده از یک رویکرد اعتبارسنجی متقاطع ۱۰ برابری نمونه‌برداری می‌شود. زیرمجموعه آموزش و اعتبارسنجی به تنظیم پارامترهای مدل کمک می کند، در حالی که مجموعه آزمایشی به ارزیابی دقت مدل آموزش دیده اختصاص داده شده است.

تجزیه و تحلیل چند خطی

از آنجایی که متغیرهای مستقل اضافی وجود دارند، محاسبات الگوریتم‌های ML سنگین‌تر و زمان‌برتر هستند و حتی عملکرد پایین‌تری دارند [ ۶۸ ]. علاوه بر این، چند خطی بودن بین پارامترها بر دقت نتایج آموزشی تأثیر خواهد گذاشت [ ۶۹ ]. بنابراین، تجزیه و تحلیل چند خطی یک روش حیاتی برای رسیدگی به این مسائل است. برای این منظور، تحلیل رگرسیون خطی انجام شد که در آن مقدار مربع ضریب همبستگی ( ۲ ) از طریق نرم افزار SPSS محاسبه شد. سپس، R2 برای محاسبه ضریب تورم تحمل و واریانس (VIF) برای متغیرهای ورودی مورد بررسی با استفاده از معادلات (۱) و (۲) [ ۷۰ ] استفاده شد.]:

تیمن = ۱ – آرمن۲،
VIF = ۱تیمن.
اگر T کمتر از ۰٫۱ و/یا VIF بزرگتر از ۱۰ باشد، تجزیه و تحلیل یک مسئله چندخطی بین معیارهای در نظر گرفته شده را نشان می دهد [ ۷۱ ]. بنابراین، طراحی سیستم معیارها باید مورد بازنگری قرار گیرد.

۲٫۳٫ مدل سازی مبتنی بر ML

مدل‌های ML، که توانایی یادگیری از مجموعه داده‌های بزرگ را دارند، به دنبال انجام کار خاصی بدون استفاده از دستورالعمل‌های صریح هستند [ ۷۲ ]. ML از دو نوع تکنیک استفاده می کند: یادگیری تحت نظارت برای مقابله با مسائل طبقه بندی و رگرسیون و یادگیری بدون نظارت برای حل مسائل خوشه بندی [ ۱۵ ]. الگوریتم‌های یادگیری نظارت شده توانایی خود را برای رسیدگی به پیچیدگی و غیرخطی بودن در بسیاری از تحلیل‌های تناسب سایت و حساسیت نشان داده‌اند [ ۶۸ ]. در این مطالعه، سه الگوریتم نظارت شده (RF، SVM، و MLP) با استفاده از زبان برنامه نویسی پایتون با بسته Scikit-Learn ( http://scikit-learn.org )، در ۱۵ مارس ۲۰۲۲ مشاهده شد) برای طبقه بندی مناسب بودن سایت نیروگاه های بادی و خورشیدی در مقیاس جهانی مورد بهره برداری قرار می گیرند. کد برنامه نویسی پایتون در مواد تکمیلی ارائه شده است .

۲٫۳٫۱٫ الگوریتم های پیاده سازی شده

RF به دلیل سادگی، دقت و انعطاف پذیری یکی از پرکاربردترین مدل ها برای مسائل طبقه بندی و رگرسیون است. الگوریتم RF، یک نسخه ارتقا یافته از رویکرد درخت تصمیم، چندین درخت تصمیم را در یک ساختار واحد به نام جنگل ترکیب می کند [ ۱۵ ، ۷۳ ]. با درختان بیشتر، جنگل در برابر سر و صدا، بیش از حد برازش و ویژگی های غیر همبسته مقاوم می شود [ ۱۸ ]. بنابراین، تعداد و عمق درختان باید به دقت مشخص شود تا الگوریتم RF به طور موثر اجرا شود [ ۳۱ ].
SVM یک الگوریتم قدرتمند ML است که مفهوم کاهش ریسک ساختاری را اعمال می کند و بر مبنای نظری یادگیری آماری ساخته شده است [ ۷۴ ]. مدل SVM این توانایی را دارد که با استفاده از توابع هسته که داده های ورودی را به فضای ویژگی با ابعاد بالا تبدیل می کند، بر هر رابطه غیرخطی پیچیده غلبه کند [ ۱۵ ]. رویه‌های سازمان‌یافته برای تعریف پارامترها در الگوریتم SVM حیاتی هستند، زیرا دقت عملکرد مدل را تعیین می‌کنند [ ۷۵ ].
MLP یک کلاس از شبکه‌های عصبی مصنوعی پیش‌خور است که از الگوریتم پس‌انتشار برای آموزش نظارت شده استفاده می‌کند [ ۷۶ ]. شبکه‌های عصبی MLP از سه ساختار اصلی تشکیل شده‌اند: لایه‌های ورودی، پنهان و خروجی. یک لایه از گره های ورودی برای دریافت فاکتورهای تصمیم مربوطه اختصاص داده می شود و یکی دیگر برای خروجی نتایج طبقه بندی شده است. در مقابل، یک یا چند لایه پنهان میانی به عنوان موتور محاسباتی برای الگوریتم MLP اختصاص داده شده است [ ۱۶ ، ۷۷ ].
فراپارامترهای الگوریتم های فوق الذکر (یعنی RF، SVM و MLP) برای دستیابی به حداکثر دقت طبقه بندی به خوبی تنظیم شده اند. بهترین تعداد درخت برای اجرای طبقه‌بندی کننده RF 100 بود، با حداکثر عمق پنج به همراه سایر تنظیمات پیش‌فرض بسته Scikit-Learn [ ۷۸ ]. برای مدل SVM، تابع پایه شعاعی (RBF) بهترین نوع هسته با مقادیر C و گاما به ترتیب ۰٫۱ و ۰٫۰۰۱ بود. در نهایت، دقت MLP با ۴ لایه پنهان، نرخ یادگیری ۰٫۱ و ۱۰ دوره تثبیت شده است.
۲٫۳٫۲٫ ارزیابی عملکرد الگوریتم

ارزیابی عملکرد بخش مهمی از مدل‌سازی است که در آن دقت نقشه‌های پیش‌بینی با استفاده از مجموعه داده‌های دنیای واقعی که مدل‌ها قبلاً ندیده‌اند، آزمایش می‌شود . در این مطالعه، یک ماتریس سردرگمی برای استخراج معیارهای عملکرد طبقه‌بندی‌کننده، یعنی حساسیت ( ببینید)، اختصاصی ( Sp)، دقت کلی ( پo، ضریب کاپا ( ک*، و منطقه زیر منحنی (AUC). ببینیدو Spبه ترتیب برای ارزیابی توانایی مدل برای تشخیص صحیح وجود و عدم وجود مزارع RE اجرا می شوند [ ۳۱ ، ۷۵ ]. پoو ک*برای ارزیابی دقت طبقه‌بندی مدل‌های ما به‌عنوان کاپا، به‌ویژه، این قابلیت را دارد که یک پیش‌بینی صحیح را که تصادفی اتفاق می‌افتد رد کند [ ۱۷ ] استفاده شد. معیارهای فوق الذکر را بهتر می توان به صورت زیر توصیف کرد:

ببینید = TPTP+FN،
Sp = TNTN+FP،
پo = TP+TN(TP+FP+TN+FN)،
په = [(TP+FP)(TP+FN)+(FN+TN)(FP+TN)](TP+FP+TN+FN)2،
ک* = پo-په۱-په.

که در آن TP نمونه های مثبت واقعی کلاس مثبت پیش بینی شده است. FP نمونه های مثبت کاذب کلاس مثبت پیش بینی شده است. TN نمونه های منفی واقعی کلاس منفی پیش بینی شده است و FN نمونه های منفی کاذب کلاس منفی پیش بینی شده است [ ۱۸ ]. پoهمچنین دقت مشاهده شده را نشان می دهد، در حالی که پهدقت مورد انتظار است.

در نهایت، AUC، که نشان دهنده ناحیه زیر منحنی مشخصه عملیاتی گیرنده (ROC) است، به دلیل توانایی آن در تشخیص طبقه بندی های باینری در نظر گرفته می شود [ ۷۵ ]. منحنی ROC بر روی یک گرافیک دو محوره رسم شده است. محور x نرخ مثبت کاذب را نشان می دهد و محور y نشان دهنده نرخ مثبت واقعی است. مساحت زیر منحنی ROC از ۰٫۵ تا ۱ است که بالاترین AUC موثرترین مدل را بیان می کند [ ۶۸ ، ۷۹ ].
۲٫۳٫۳٫ کالیبراسیون مدل
کالیبراسیون در آموزش مدل‌های ML که هدفشان تبدیل پیش‌بینی‌های مدل به احتمالات کلاس پسین است، حیاتی است [ ۸۰ ]. به عبارت دیگر، کالیبراسیون برای تقریب احتمالات پیش‌بینی‌شده به احتمالات واقعی کار می‌کند و در نتیجه پیش‌بینی‌هایی را به دست می‌آورد که با دنیای واقعی سازگارتر هستند [ ۸۱ ]. ایجاد یک نمودار کالیبراسیون (همچنین به عنوان نمودار قابلیت اطمینان شناخته می شود) رایج ترین روش برای آزمایش کالیبراسیون مدل ها است. چنین نموداری هرگونه تفاوت بین احتمال پیش‌بینی‌شده مدل ( محور x ) و احتمال تجربی در داده‌ها ( محور y ) را نشان می‌دهد [ ۸۲]. هرچه منحنی ترسیم به خط مورب نزدیکتر باشد، کالیبراسیون بهتری انجام می شود. به عنوان یک روش رایج برای کالیبراسیون مدل ها، در این مطالعه از رگرسیون ایزوتونیک استفاده شده است. این یک روش کالیبراسیون ناپارامتریک برای طبقه‌بندی‌کننده‌های دوتایی است که در آن پیش‌بینی‌های کالیبره‌شده با استفاده از تبدیل نقشه‌برداری ایزوتونیک تولید می‌شوند [ ۸۱ ]. برای جزئیات بیشتر در مورد رویکرد رگرسیون ایزوتونیک، خوانندگان به Leathart [ ۸۳ ] ارجاع داده می شوند.
۲٫۳٫۴٫ هوش مصنوعی قابل توضیح
XAI مجموعه ای از الگوریتم ها و نمودارهایی است که به انسان کمک می کند تا خروجی مدل های ML را درک و تفسیر کند [ ۸۴ ]. XAI اطلاعاتی را نشان می دهد که اقدامات مبتنی بر آن است و در نتیجه عملکرد مدل های هوشمند را بهبود می بخشد. به عنوان محبوب ترین رویکرد XAI، الگوریتم SHAP در این کار انجام شده است.

الگوریتم SHAP برای اولین بار توسط Shapley [ ۸۵ ] برای شناسایی سهم تک تک بازیکنان در نتیجه یک بازی تیمی همکاری [ ۲۷ ] توسعه یافت. سپس، لوندبرگ و همکاران. [ ۸۶ ] اخیراً این مفهوم را برای اندازه‌گیری مشارکت و تأثیر پارامترها در فرمول‌بندی خروجی‌های مدل‌های ML معرفی کرده است. مقادیر SHAP بزرگی و جهت هر پارامتری را که به خروجی مدل کمک می کند، تخمین می زند و آنها را در انواع مختلف نمودارهای قابل تفسیر ارائه می کند [ ۲۷ ]. مقدار Shapley با در نظر گرفتن میانگین سهم حاشیه ای در تمام ترکیبات پارامترهای قابل تصور، همانطور که در زیر توضیح داده شده است، محاسبه می شود [ ۲۵ ]:

∅من = ∑اس⊆ن{من}|اس|!(n-|اس|-۱)!n![v(اسU{من})-v(اس)]،

جایی که ∅منسهم پارامتر i است. N مجموعه تمام پارامترها است. n تعداد پارامترها در N است. S زیرمجموعه N است که شامل پارامتر i نیست و v ( N ) مقدار پایه است که نتیجه پیش‌بینی‌شده برای هر پارامتر در N را بدون اطلاع از مقادیر پارامتر نشان می‌دهد [ ۲۸ ].

شاخص SHAP معمولاً به روش های مختلفی مانند Tree SHAP، Deep SHAP و Kernel SHAP تخمین زده می شود. این مطالعه از Tree SHAP استفاده می‌کند، شکلی از SHAP که برای مدل‌های ML مبتنی بر درخت (به عنوان مثال، درخت‌های تصمیم، RF، XGBoost و CatBoost) طراحی شده است [ ۸۷ ]. Tree SHAP مدل های مبتنی بر درخت را برای تولید مقادیر SHAP در یک ماتریس با اندازه یکسان با مجموعه داده ورودی در نظر می گیرد [ ۸۸ ]. مقادیر SHAP می تواند تعیین کند که آیا سهم هر پارامتر ورودی مثبت یا منفی است. در این سناریو، تجزیه و تحلیل SHAP درک و شناسایی ویژگی‌هایی را که بیشترین تأثیر را در پیش‌بینی مکان‌های بهینه برای تأسیسات RE دارند، تسهیل می‌کند.
در این مطالعه، توضیح دهنده Shapley برای به دست آوردن تفاسیر جهانی و محلی از مدل ML اتخاذ شد. هدف این توضیح جهانی تخمین سهم کلی هر یک از عوامل تهویه در تهیه نقشه تناسب فضایی مزارع بادی و خورشیدی است. تأثیر عوامل به عنوان میانگین مقادیر مطلق SHAP در کل مجموعه داده محاسبه می شود [ ۲۹ ]. توضیح محلی، از جنبه ای دیگر، عواملی را برجسته می کند که سهم قابل توجهی در پیش بینی داشته اند و ما را قادر می سازد تا تأثیر هر عامل را بر طبقه بندی پیکسل های منفرد در نقشه تناسب شناسایی کنیم [ ۲۵ ، ۲۹ ].]. این قابلیت به ما درک عمیق تری از مدل و مجموعه داده می دهد. اهمیت جهانی و محلی عوامل را می توان به ترتیب با استفاده از نمودار خلاصه SHAP و نمودار نیروی SHAP نشان داد.

۳٫ نتایج

۳٫۱٫ خطی بودن عوامل تهویه

تجزیه و تحلیل چند خطی برای دستیابی به قابلیت اطمینان پیش بینی بالا و عدم بارگذاری بیش از حد مدل های آموزش دیده با پارامترهای اضافی انجام شد. نتایج تجزیه و تحلیل نشان داد که تمام معیارهای مورد استفاده در هر دو مجموعه داده این مطالعه مقادیر VIF کمتر از ۱۰ و مقادیر T بیش از ۰٫۱ را به دست می‌دهند، همانطور که در جدول ۲ ارائه شده است. نتایج همخطی نشان می دهد که هیچ همبستگی قوی بین عوامل وجود ندارد. بنابراین، عوامل شرطی‌سازی (متغیرهای مستقل) همه به الگوریتم‌های در نظر گرفته شده برای استخراج وزن‌های کلی آنها و ترسیم مناسب بودن سایت برای نیروگاه‌های بادی و خورشیدی تغذیه شدند.

۳٫۲٫ نتایج ارزیابی و کالیبراسیون

نتایج ارزیابی عملکرد با استفاده از مجموعه داده‌های آزمایش ۳۰ درصد نشان داد که این سه الگوریتم قابلیت‌های امیدوارکننده‌ای برای پیش‌بینی تناسب فضایی برای میزبان نیروگاه‌های بادی و خورشیدی دارند. جدول ۳ ارزیابی RF، SVM و MLP را نشان می دهد ببینید، Sp، پo، ک*و معیارهای AUC در مقایسه، مدل RF حساس‌ترین و خاص‌ترین در طبقه‌بندی مجموعه داده‌های مکانی مزارع بادی به دنبال MLP و SVM بود که در آن ببینیدو Spمقادیر به ترتیب (۰٫۸۸، ۰٫۹۱)، (۰٫۷۹، ۰٫۸۱) و (۰٫۷۰، ۰٫۷۵) بود. ترتیب مشابهی در مجموعه داده های خورشیدی ثبت شد، که توانایی مدل RF را برای تشخیص صحیح وجود و عدم وجود نیروگاه های بادی و خورشیدی نشان داد. بالاترین دقت کلی در پیش‌بینی مکان‌های مناسب برای نیروگاه‌های بادی و خورشیدی هنگام استفاده از طبقه‌بندی کننده RF (به ترتیب ۹۰ و ۸۹ درصد) و پس از آن طبقه‌بندی کننده MLP (به ترتیب ۸۰ و ۷۳ درصد) بود. در مقابل، طبقه بندی کننده SVM کمترین مقدار را ارائه می کند پo(به ترتیب ۷۴ و ۷۲ درصد). از نظر آماری، ک*شاخص‌های مدل‌سازی باد و خورشید با استفاده از الگوریتم RF (به ترتیب ۰٫۷۹ و ۰٫۷۸) در مقایسه با سایر الگوریتم‌های مورد بررسی بالا بود. این نتیجه توافقات اساسی بین خروجی مدل و حقیقت زمین را نشان می دهد. علاوه بر این، عملکرد RF در مدل‌سازی باد و خورشید بهترین دقت را در متریک AUC (به ترتیب ۰٫۹۶ و ۰٫۹۵) داشت که توسط MLP و SVM ردیابی می‌شد. این یافته دلالت بر هیچ نشانه ای از برازش بیش از حد در مدل RF ندارد. شکل ۴ نمودار AUC مدل RF را نشان می دهد که در آن منحنی های ROC به گوشه سمت چپ بالای نمودار نزدیک می شوند. این مورد به این معنا تفسیر می شود که AUC به ۱ نزدیکتر است و دقت کلی بالاتر است [ ۱۶ ].
با توجه به مقایسه های ذکر شده، طبقه بندی کننده RF بالاترین دقت را در تمام معیارهای عملکرد در نظر گرفته شده به دست آورد. مزایای آن شامل توانایی مدیریت روابط غیرخطی و تعصب کم است [ ۱۸ ، ۸۹ ]. بنابراین می توان الگوریتم RF را به عنوان بهترین الگوریتم برای پیش بینی مناسب بودن سایت برای تاسیسات انرژی بادی و خورشیدی پیشنهاد کرد.
مدل های RF برای به دست آوردن پیش بینی های سازگار با رویدادهای دنیای واقعی کالیبره شدند. شکل ۵ a,b نمودارهای کالیبراسیون را برای مدلسازی تناسب فضایی نیروگاه های بادی و خورشیدی به ترتیب نشان می دهد. منحنی کالیبراسیون آزمایشی (خط آبی) دارای شکل منحنی S است که موازی با خط کالیبراسیون کامل (خط خاکستری مورب) در مدل باد و خورشید طبقه‌بندی کننده RF است. با این حال، کالیبراسیون مدل ها با استفاده از روش رگرسیون ایزوتونیک (خط قرمز) به طور قابل توجهی عملکرد پیش بینی را بهبود بخشید.

۳٫۳٫ نقشه برداری جهانی مناسب

RF برای پردازش بیشتر برای تولید نقشه‌های مناسب فضایی برای شناسایی مکان‌های بالقوه در سراسر جهان برای استقرار تجهیزات انرژی بادی و خورشیدی انتخاب شد. نقشه های تناسب با وضوح فضایی ۱۰ کیلومتر تولید شد. در هر نقشه، درجه تناسب با استفاده از روش طبقه بندی فاصله مساوی به پنج کلاس طبقه بندی می شود: بسیار کم (۰٫۰-۰٫۲)، کم (۰٫۲-۰٫۴)، متوسط ​​(۰٫۴-۰٫۶)، زیاد (۰٫۶-۰٫۸) و بسیار بالا (۰٫۸-۱٫۰). شکل ۶ نتایج نقشه های تناسب سایت برای نیروگاه های بادی و خورشیدی را نشان می دهد.
تجزیه و تحلیل کمی در جدول ۴ نشان می دهد که برای نقشه باد، مقوله های تناسب زیاد و بسیار بالا ۲۳٫۲% (~۲۶٫۸۴ میلیون کیلومتر مربع) را پوشش می دهد .) از زمین، در مناطق بالای ۳۰ درجه در نیمکره شمالی و زیر ۳۰ درجه در نیمکره جنوبی متمرکز شده است. آمریکا، آرژانتین، روسیه، قزاقستان و چین از جمله کشورهایی هستند که مناطق قابل توجهی از شاخص‌های مناسب قرمز و نارنجی را نشان داده‌اند. در همین حال، طبقه متوسط ​​(۱۷٫۳٪) در سراسر نقشه مناسب بودن سایت انرژی بادی پراکنده است، در حالی که ۶۰٪ از منطقه در نظر گرفته شده در جهان برای استقرار توربین بادی کم تا بسیار کم است. در مورد نقشه جهانی برای میزبانی نیروگاه های خورشیدی، امتیازهای مناسب بالا و بسیار بالا (به ترتیب ۲۴٫۰٪ و ۱۹٫۴٪) دلگرم کننده تر بود و مساحت وسیعی از زمین، ~۵۰٫۳۱ میلیون کیلومتر مربع را پوشش داد .. قلمروهای دو طرف خط استوا، مانند آفریقا، شمال آمریکای لاتین، شمال استرالیا و بخش‌هایی از خاورمیانه و جنوب آسیا، مناسب‌ترین مناطق برای کشت پانل‌های PV خورشیدی هستند. علاوه بر این، طبقه بسیار پایین درصد نسبتاً کمی از مساحت را با ۱۳٫۸ درصد به ثبت رساند و پس از آن طبقه پایین با ۱۸٫۹ درصد قرار گرفت که در مجموع ۳۷٫۸۴ میلیون کیلومتر مربع زمین را تشکیل می دهد که از برنامه ریزی پروژه های خورشیدی حذف می شود.
به طور کلی، یک رفتار مخالف برای توزیع مقوله‌های مناسب در نقشه‌های انرژی بادی و خورشیدی مشاهده می‌شود. این اختلاف به دلیل الگوهای فضایی مختلف عوامل منابع طبیعی در نظر گرفته شده در این مطالعه است، مانند WS و SR. با این حال، مناطق قابل توجهی از سیاره را می توان با مناسب بودن امیدوارکننده برای هر دو نوع انرژی، همانطور که در بخش بعدی مورد بحث قرار گرفت، یافت.

۳٫۴٫ توضیح مدل پیش بینی کننده

تکنیک SHAP برای درک بهتر سهم عوامل و وابستگی‌های آنها در فرمول‌بندی خروجی پیش‌بینی استفاده شد. توضیحات Shapley به صورت گرافیکی در این قسمت به صورت جهانی و محلی ارائه شده است.
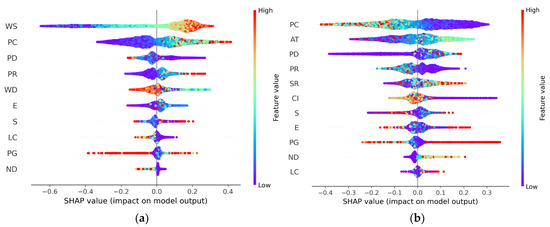
در سطح جهانی، تأثیر عوامل بر خروجی پیش‌بینی با استفاده از نمودار خلاصه Shapley، همانطور که در شکل ۷ نشان داده شده است، بررسی شد . محور x مقدار SHAP را نشان می دهد. یک مقدار مثبت حاکی از تأثیر بر جهت رو به جلو است، در حالی که یک مقدار منفی حاکی از تأثیر در جهت عقب به سمت دستیابی به نتایج پیش بینی است. محور y عوامل را به ترتیب اهمیت رتبه بندی می کند. هر نقطه نشان دهنده یک مشاهده از مجموعه داده اصلی است. ارزش هر مشاهده در مقیاس رنگی از کم تا زیاد نمایش داده می شود. شکل ۷a نشان می دهد که WS و PC بیشترین تأثیر را در طبقه بندی نقشه تناسب مکانی برای سیستم های بادی خشکی دارند. با نگاهی عمیق، غلظت نقاط قرمز در سمت راست خط مبنا نشان می دهد که مقادیر بالای مشاهده این عوامل، پتانسیل سایت را برای میزبانی از توربین های بادی افزایش می دهد. به عبارت دیگر، مناسب‌ترین مکان‌ها برای استقرار نیروگاه‌های بادی، مکان‌هایی با WS بالا و فاصله زیاد از شهرها هستند. از جنبه دیگر، PC و AT به ترتیب رتبه اول و دوم را در تفسیر تأثیر پارامترهای دخیل در مناسب بودن مکان نقشه برداری برای سیستم های خورشیدی دارند، همانطور که در شکل ۷ نشان داده شده است.ب رنگ آبی برای رایانه شخصی و رنگ سبز مایل به آبی برای AT در سمت راست خط مبنا توضیح می‌دهد که مکان‌های نزدیک شهرها و آن‌هایی که دمای متوسط ​​دارند به احتمال زیاد روی انرژی PV خورشیدی سرمایه‌گذاری می‌کنند. در مقابل، PG، LC و ND کمترین تأثیر را بر خروجی مدل‌های بادی و خورشیدی داشتند. در مجموع، تأثیر بالای عوامل فنی و اقتصادی را می توان به هزینه سایر عوامل محیطی و اجتماعی ثبت کرد.
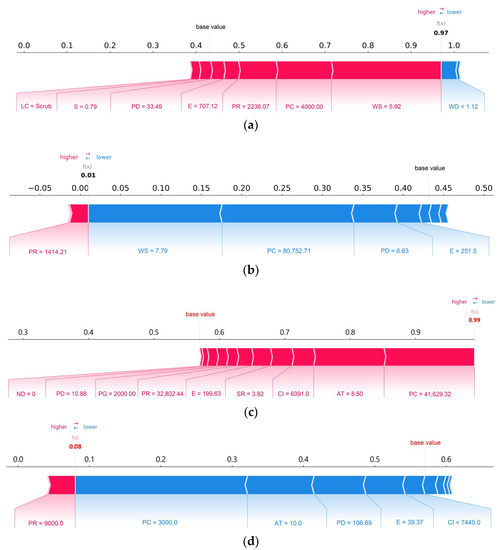
به صورت محلی، نمودار نیرو برای تفسیر تأثیر عوامل بر طبقه بندی پیکسل های خاص استفاده شد ( شکل ۸). توضیح نشان می‌دهد که چگونه عوامل متعددی با هم تعامل دارند تا خروجی مدل را از مقدار پایه به مقدار احتمال پیش‌بینی اولیه سوق دهند. همانطور که نشان داده شده است، مدل RF می تواند پیکسل های (a) و (c) را به ترتیب با احتمال ۹۷% و ۹۹% مناسب بودن برای میزبانی نیروگاه های بادی و خورشیدی به درستی طبقه بندی کند. در مقابل، مدل پیش‌بینی کرد که پیکسل‌های (b) و (d) از نظر مکانی برای سیستم‌های خورشیدی و بادی با احتمال ۱٪ و ۸٪ نامناسب هستند. هر مقدار SHAP با یک فلش در نمودار نمایش داده می شود. عواملی که ارزش یک طبقه بندی مثبت (از نظر مکانی مناسب) را افزایش می دهند با رنگ قرمز در سمت چپ نشان داده می شوند، در حالی که عواملی که ارزش یک طبقه بندی منفی (از لحاظ مکانی نامناسب) را کاهش می دهند با رنگ آبی در سمت راست نشان داده شده اند. در شکل ۸به عنوان مثال، WS، PC و PR نقش مهمی در افزایش پیش‌بینی مثبت سیستم‌های بادی دارند، در حالی که WD پیش‌بینی منفی را کاهش می‌دهد. علاوه بر این، مقادیر فاکتورهای WS، PC و PD یک معیار تعیین‌کننده در تخصیص نامناسب بودن پیکسل بودند، همانطور که در شکل ۸ ب نشان داده شده است. از جنبه ای دیگر، شکل ۸ c,d سهم قابل توجه عوامل PC و AT را در طبقه بندی مناسب بودن مشاهدات برای توسعه مزرعه خورشیدی نشان می دهد.
شکل ۹ نمودارهای وابستگی را برای درک بیشتر عواملی که تأثیر قابل توجه یا پویا بر خروجی پیش بینی دارند نشان می دهد. چنین نمودارهایی ارزش SHAP ویژگی ها را در برابر ارزش ویژگی همه نمونه های مورد بررسی نشان می دهد. در شکل ۹ a,b برهمکنش های بین WS و PC به ترتیب برای کلاس های فضایی مناسب و نامناسب تاسیسات برق بادی ترسیم شده است. مقادیر واقعی اولین فاکتور (WS) در محور x نشان داده می شود ، در حالی که محور y سمت چپ مقدار SHAP مرتبط با ضریب را نشان می دهد. مقادیر مثبت نشان می دهد که عوامل به طور مثبت در طبقه بندی نقش دارند و بالعکس. رنگ ها مقادیر SHAP داده شده به فاکتور دوم (PC) را نشان می دهند.شکل ۹ a نشان می دهد که مقادیر SHAP با افزایش WS و PC بزرگتر می شوند که منجر به پیش بینی مثبت مناسب بودن سایت برای سیستم های بادی می شود. همانطور که در شکل ۹ ب نشان داده شده است، وابستگی بین این عوامل در طبقه بندی کلاس های نامناسب الگوی مخالفی دارد . به عنوان تأثیرگذارترین عوامل در طبقه‌بندی تناسب فضایی ایستگاه‌های خورشیدی، تعامل بین AT و PC با استفاده از همان رویکرد گرافیکی ذکر شده در بالا نشان داده شد. شکل ۹ c,d نمودارهای وابستگی را برای پیش بینی پیکسل های مناسب و نامناسب برای استقرار پنل خورشیدی PV نشان می دهد. این نمودارها نشان داد که مقادیر AT بین ۱۰ درجه سانتیگراد و ۲۰ درجه سانتیگراد با فاصله کمتر تا شهرها، مقادیر SHAP را کنترل می‌کنند و در نتیجه نتایج پیش‌بینی را فرموله می‌کنند.

۳٫۵٫ وزن عوامل تهویه

وزن نسبی هر عامل شرطی در مدل‌سازی مبتنی بر الگوریتم RF با توجه به میانگین کاهش ناخالصی (MDI) محاسبه می‌شود که گاهی اوقات «اهمیت جینی» نامیده می‌شود [ ۹۰ ]. شکل ۱۰وزن و سهم هر یک از عوامل مورد استفاده در مدل سازی و پیش بینی تناسب زمین برای نیروگاه های بادی و خورشیدی را نشان می دهد. بر این اساس، تأثیرگذارترین پارامتر در مدل‌سازی فضایی باد WS (373/0) و پس از آن PC (149/0) بود. E، WD و PD به ترتیب با وزن های ۰٫۱۱۱، ۰٫۰۸۶ و ۰٫۰۷۷ در رتبه های سوم، چهارم و پنجم قرار گرفتند. در همین حال، فاکتورهای PR و S امتیاز وزنی برابر ۰۶۱/۰ را به دست آوردند. علاوه بر این، به نظر می‌رسد که ND هیچ سهم روشنی در نقشه‌برداری مناسب مزرعه بادی ندارد و در رتبه دهم (۰٫۰۱۷) قرار گرفت. از نظر نقشه تناسب جهانی نیروگاه های خورشیدی، تجزیه و تحلیل وزن برای عوامل اختصاصی رتبه بندی زیر را نشان داد: PC (0.180)، AT (0.149)، PD (0.129)، SR (0.101)، E (0.097)، CI. (0.090)، PR (0.082)، S (0.074)، PG (0.049)، LC (0.027) و ND (0.027).

۴٫ بحث

ارزیابی‌های مرسوم تناسب مکان برای نیروگاه‌های RE اغلب شامل چالش‌هایی است که در طراحی یک سیستم معیارهای تصمیم‌گیری، شناسایی وزن معیارها و ترسیم تناسب مربوطه نشان داده می‌شود. با این حال، در دسترس بودن داده‌های فضایی دنیای واقعی برای سیستم‌های انرژی بادی و خورشیدی به همراه مجموعه داده‌های RS برای عوامل شرطی‌سازی بحرانی منجر به فرمول‌بندی راه‌حل‌های مبتنی بر ML بالغ‌تر و کم‌تعصب‌تر شده است. معیارهای ارزیابی عملکرد در نظر گرفته شده در این مطالعه شواهد علمی از استحکام الگوریتم‌های RF، SVM و MLP در پیش‌بینی مکان‌های بهینه برای میزبانی مزارع بادی و خورشیدی ارائه می‌کنند. اگرچه سه مدل به دقت کلی بیش از ۷۰ درصد دست یافتند، RF در مدل‌سازی باد و خورشید با عملکرد رضایت‌بخشی عمل کرد. پoمقادیر ۹۰% و ۸۹% به ترتیب. بهترین ک*و نتیجه AUC با استفاده از طبقه بندی کننده RF و به دنبال آن MLP و SVM پیدا شد. بدیهی است که الگوریتم RF مناسب‌ترین و پایدارترین الگوریتم برای پیش‌بینی کلاس‌های تناسب زمین برای استقرار تجهیزات انرژی سبز است. این نتیجه با یافته های کار قبلی که عملکرد کارآمد الگوریتم RF را نشان می داد مطابقت دارد [ ۱۵ , ۱۸ , ۲۲]. در همین حال، تجزیه و تحلیل اهمیت پارامتر با روش RF نسبت وزن قابل توجهی را برای WS (37٪)، PC (15٪)، E (11٪) و WD (9٪) در مناسب بودن مکان نقشه برداری برای مزارع بادی نشان داد. در مقابل، پارامترهای PC (18٪)، AT (15٪)، PD (13٪)، و SR (10٪) بیشترین تأثیر را در انتخاب مکان بهینه برای ایستگاه های بادی داشتند. این وزن ها نشان می دهد که عوامل فنی و اقتصادی بر انتخاب مکان غالب بوده و مطابق با توصیه های بسیاری از محققین است [ ۹۱ ، ۹۲ ، ۹۳ ، ۹۴ ].
درصد نمونه‌های موجودی نیروگاه بادی و خورشیدی بر اساس کلاس‌های تناسب فردی برای ارزیابی کیفیت نقشه‌های تناسب سایت تولید شده توسط مدل RF، همانطور که در شکل ۱۱ نشان داده شده است، تجزیه و تحلیل می‌شود.. بر این اساس، بیش از ۸۰ درصد از نمونه‌های موجودی در مناطق «بالا» و «بسیار بالا» قرار می‌گیرند که نشان‌دهنده اعتبار نقشه‌های مناسب بودن ما است. به طور کلی، ۲۳٫۲ درصد از زمین‌ها در سراسر جهان عمدتاً در شرایط «بالا» و «بسیار بالا» برای ساخت نیروگاه‌های بادی قرار داشتند، در حالی که این نسبت برای راه‌اندازی مزارع انرژی خورشیدی به ۴۳٫۴ درصد دو برابر شد. این نتیجه پتانسیل فنی و اقتصادی فراوان سیاره ما را برای سرمایه گذاری در انرژی خورشیدی در مقایسه با نیروی باد برجسته می کند. با این حال، مزارع PV خورشیدی در مقیاس بزرگ عامل اصلی تخریب زمین و از بین رفتن زیستگاه، در میان سایر انرژی های پاک هستند [ ۹۵ ].
برای اینکه نتایج ما با نتایج کارهای قبلی قابل مقایسه باشد، یک نقشه استاندارد شده از مناسب بودن مکان برای نیروگاه های بادی، خورشیدی و باد-خورشیدی ایجاد شده است، همانطور که در شکل ۱۲ نشان داده شده است. در نقشه کلی، مناطق با درجه تناسب مکانی برای سیستم های بادی، بین ۰٫۵ تا ۱، به رنگ فیروزه ای نشان داده شده اند که ۲۲٫۳۵٪ از مساحت زمین را تشکیل می دهند. به طور مشابه، رنگ نارنجی نشان دهنده مناطق موجود برای سرمایه گذاری در انرژی خورشیدی (۴۷٫۴۸ درصد از زمین های جهان) با امتیاز مناسب بیش از ۰٫۵ است. مکان هایی که هر دو شرایط بالا را برآورده می کنند با رنگ قرمز رنگ شده اند و ۸٫۵۳ درصد از زمین را پوشش می دهند و برای گیاهان هیبریدی بادی، خورشیدی و باد-خورشید مناسب هستند. نقشه ما همچنین نشان داد که ۲۱٫۶۴ درصد از زمین های مورد مطالعه برای هر سیستم انرژی مورد بررسی نامناسب است.
نقشه فعلی ( شکل ۱۲ ) مطابق با نتایج مطالعات قبلی است که کشورها یا مناطق جداگانه را پوشش می دهد، همانطور که در شکل ۱۳ مشخص شده است. به عنوان مثال، مناطق جنوب شرقی و جنوب غربی ایالات متحده با حمایت از گزارش شهاب و همکاران، مناسب بودن خود را برای میزبانی مزارع خورشیدی نشان دادند. [ ۲۲ ]. علاوه بر این، غرب چین مناطق امیدوارکننده ای را برای سرمایه گذاری در انرژی خورشیدی نشان داده است. این نتیجه با نقشه های مطالعه مرتبط انجام شده در این کشور مطابقت دارد [ ۹۶ ]. در همین حال، یافته‌های ما با گزارش یک مطالعه اخیر که مناسب بودن مکان برای نیروگاه‌های بادی و خورشیدی در کل قاره آفریقا را بررسی می‌کند هماهنگ است [ ۹۷ ]]. هر دوی ما اظهار داشتیم که کل قاره برای نیروگاه‌های خورشیدی مناسب است، در حالی که کشورهای شمالی بیشترین احتمال را داشتند که توربین‌های بادی را در کنار پانل‌های PV خورشیدی مستقر کنند. علاوه بر این، در خاورمیانه، نتایج با توصیه های جهانگیری و همکاران قابل مقایسه بود. [ ۹۸ ].
این روندها سیاست های فضایی توسعه انرژی بادی و خورشیدی را تحت محدودیت های مختلف فنی، اقتصادی و زیست محیطی برجسته می کند. از آنجایی که هزینه سرمایه گذاری در RE همچنان کاهش می یابد، سیاست گذاران و ذینفعان باید فرصت های فضایی مناسب را برای میزبانی از سیستم های هیبریدی باد-خورشید برای تامین انرژی پایدار، کاهش مصرف زمین و کاهش تغییرات آب و هوا در نظر بگیرند. علاوه بر نقشه‌برداری از تناسب فضایی نیروگاه‌های بادی و خورشیدی در سطح جهانی، کار تحقیقاتی فعلی مجموعه‌ای از کاربردهای عملی بالقوه را ارائه می‌کند. بررسی‌های ریز سیستم‌های بادی و خورشیدی را می‌توان با وضوح فضایی بالا (به عنوان مثال، ۱ کیلومتر) برای قاره‌ها یا کشورهای خاص با استفاده از چارچوب پیشنهادی مبتنی بر ML انجام داد. علاوه بر این، وزن دهی جهانی گزارش شده به تصمیم گیرندگان کمک می کند.

۵٫ نتیجه گیری ها

در این مطالعه، سه الگوریتم ML (یعنی RF، SVM، و MLP) برای انجام ارزیابی تناسب سایت جهانی برای نیروگاه‌های بادی و خورشیدی با استفاده از ۵۵۶۱۹ نمونه واقعی و ۱۳ عامل شرطی‌سازی مورد آزمایش قرار گرفتند. نتایج بررسی برتری الگوریتم RF را در تمامی معیارهای عملکرد نشان داد. ببینید =۰٫۸۸/۰٫۹۱، Sp =۰٫۹۱/۰٫۸۸، پo =۰٫۹۰/۰٫۸۹، ک* =۰٫۷۹/۰٫۷۸ و AUC = 0.96/0.95)؛ بنابراین، این الگوریتم می تواند به عنوان یک مدل معقول برای نقشه برداری تناسب زمین تاسیسات بادی و خورشیدی پیشنهاد شود. تجزیه و تحلیل اهمیت مبتنی بر XAI تأثیر بالایی از معیارهای فنی و اقتصادی را بر تصمیم‌گیری فضایی با بالاترین وزن برای مکان‌یابی نیروگاه‌های بادی (WS = 0.373، PC = 0.149، E = 0.111 و WD = 0.086) و مزارع خورشیدی (PC) نشان داد. = ۰٫۱۸۰، AT = 0.149، PD = 0.129 و SR = 0.101). نقشه‌های جهانی تناسب سایت توسعه‌یافته در این کار، ۲۲٫۳۵ درصد و ۴۷٫۴۸ درصد از زمین‌های جهان را به‌ترتیب برای میزبانی نیروگاه‌های بادی و خورشیدی خشکی نشان می‌دهند. هر دو نوع انرژی می توانند در کنار هم در ۸٫۵۳ درصد از مساحت سیاره مورد مطالعه مستقر شوند.
به عنوان یک ارزیابی مفید در سراسر جهان، یافته های مطالعه نقطه شروعی برای محققان برای انجام تحقیقات دقیق تر در مورد فرصت های جدید اعلام شده است. علاوه بر این، نتایج فعلی می‌تواند به طور بالقوه ذینفعان را برای ایجاد سرمایه‌گذاری‌های فرامرزی جدید در بخش RE تحریک کند. مقاله حاضر دارای محدودیت هایی است. این مطالعه بر کاوش مناطق مناسب برای مزارع بادی و خورشیدی PV خشکی در برابر مجموعه‌ای از عوامل ارزیابی رایج تمرکز دارد. برای غربالگری آینده، نقشه های تناسب فضایی را می توان بر اساس منطقه محدودتر غربال کرد. ارزیابی فضایی جهانی باد دریایی و انرژی خورشیدی متمرکز یکی دیگر از راههای بالقوه برای تحقیقات آینده است.

منابع

  1. ردیسک، جی. سیلوک، JCM; مایکلز، ال. ریگو، PD; رزا، CB; Cugler، G. مدل تصمیم گیری چند معیاره برای ارزیابی مزارع بزرگ فتوولتائیک در برزیل. Energy ۲۰۲۰ , ۱۹۷ , ۱۱۷۱۶۷٫ [ Google Scholar ] [ CrossRef ]
  2. لی، ام. ویرگز، ای. شان، آر. تیان، جی. گائو، اس. Patiño-Echeverri، D. داده های با وضوح بالا نشان می دهد که منابع انرژی باد و خورشیدی چین برای پشتیبانی از یک سیستم برق کربن زدایی شده ۲۰۵۰ کافی است. Appl. Energy ۲۰۲۲ , ۳۰۶ , ۱۱۷۹۹۶٫ [ Google Scholar ] [ CrossRef ]
  3. کاپیکا، جی. کانالز، FA; Jurasz, J. اطلس جهانی منابع خورشیدی و باد مکمل زمانی. مبدل انرژی مدیریت ۲۰۲۱ ، ۲۴۶ ، ۱۱۴۶۹۲٫ [ Google Scholar ] [ CrossRef ]
  4. Adedeji، PA; Akinlabi، SA; مادوشله، ن. Olatunji، OO پیش بینی منابع عصبی فازی در ارزیابی مناسب بودن سایت برای انرژی باد و خورشید: یک بررسی کوچک. جی. پاک. تولید ۲۰۲۰ ، ۲۶۹ ، ۱۲۲۱۰۴٫ [ Google Scholar ] [ CrossRef ]
  5. Rogna, M. سیاست کاربری زمین روش غربالگری مرحله اول برای انتخاب مکان نیروگاه های خورشیدی در مقیاس بزرگ با کاربرد در ایتالیا. خط مشی استفاده از زمین ۲۰۲۰ , ۹۹ , ۱۰۴۸۳۹٫ [ Google Scholar ] [ CrossRef ]
  6. امجد، ف. شاه، لس آنجلس شناسایی و ارزیابی مکان‌ها برای توسعه مزارع خورشیدی با استفاده از GIS و تکنیک خوشه‌بندی مبتنی بر چگالی – موردی از پاکستان. تمدید کنید. انرژی ۲۰۲۰ ، ۱۵۵ ، ۷۶۱-۷۶۹٫ [ Google Scholar ] [ CrossRef ]
  7. برزه کار، م. Parnell، KE; مبارکایی دینان، ن. برودی، جی. ابزارهای پشتیبانی تصمیم برای انتخاب مکان مزرعه بادی و خورشیدی در استان اصفهان، ایران. تکنولوژی پاک محیط زیست سیاست ۲۰۲۰ ، ۲۳ ، ۱۱۷۹-۱۱۹۵٫ [ Google Scholar ] [ CrossRef ]
  8. البوشی، بی. الویتایشی، م. Aly، RMH; Zalhaf، AS یک نقشه‌برداری مناسب برای مزارع خورشیدی PV در مصر بر اساس GIS-AHP برای بهینه‌سازی امکان‌سنجی چند معیاره. مهندس عین شمس J. ۲۰۲۲ , ۱۳ , ۱۰۱۶۱۸٫ [ Google Scholar ] [ CrossRef ]
  9. حداد، ب. دیاز-کوواس، پی. فریرا، پی. جبلی، ع. Pérez, JP Mapping Concentrated Solar Power Site Suitance در الجزایر. تمدید کنید. انرژی ۲۰۲۱ ، ۱۶۸ ، ۸۳۸-۸۵۳٫ [ Google Scholar ] [ CrossRef ]
  10. Diemuodeke، EO; آدو، ا. اوکو، COC؛ مولوگتا، ی. Ojapah، MM نقشه برداری بهینه سیستم های انرژی تجدیدپذیر ترکیبی برای مکان ها با استفاده از الگوریتم تصمیم گیری چند معیاره. تمدید کنید. انرژی ۲۰۱۹ ، ۱۳۴ ، ۴۶۱-۴۷۷٫ [ Google Scholar ] [ CrossRef ]
  11. Dhunny، AZ; Doorga، JRS; علام، ز. Lollchund، MR; Boojhawon, R. شناسایی مکان‌های بهینه باد، خورشیدی و ترکیبی باد-خورشیدی با استفاده از مدل‌سازی منطق فازی. Energy ۲۰۱۹ , ۱۸۸ , ۱۱۶۰۵۶٫ [ Google Scholar ] [ CrossRef ]
  12. Feng, J. انتخاب سایت مزرعه بادی از دیدگاه پایداری: رویکرد طراحی مبهمی فازی مبتنی بر درجه رضایت. بین المللی J. Energy Res. ۲۰۲۱ ، ۴۵ ، ۱۰۹۷-۱۱۲۷٫ [ Google Scholar ] [ CrossRef ]
  13. گائو، جی. گوا، اف. ما، ز. Huang, X. چارچوب تصمیم گیری چند معیاره برای انتخاب محل پروژه فتوولتائیک پشت بام بزرگ بر اساس مجموعه های فازی شهودی. Appl. محاسبات نرم. ۲۰۲۱ ، ۱۰۲ ، ۱۰۷۰۹۸٫ [ Google Scholar ] [ CrossRef ]
  14. زرداری، NH; احمد، ک. شیرازی، س.م. روش‌های وزن‌دهی یوسف، زی‌بین و تأثیر آن‌ها بر نتایج مدل تصمیم‌گیری چند معیاره در مدیریت منابع آب . Springer: Cham, Switzerland, 2014; شابک ۹۷۸-۳-۳۱۹-۱۲۵۸۵-۵٫ [ Google Scholar ]
  15. الروزوق، ر. شانبله، ع. یلماز، AG; Idris, A. Dam Suitability Site Mapping and Analysis with a Integrated GIS and Machine Learning Approach. Water ۲۰۱۹ ، ۱۱ ، ۱۸۸۰٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
  16. Almansi، KY; شریف، ARM; عبدالله، اف. اسماعیل، ارزیابی مناسب بودن سایت بیمارستان SNS با استفاده از سه رویکرد یادگیری ماشینی: شواهدی از نوار غزه در فلسطین. Appl. علمی ۲۰۲۱ ، ۱۱ ، ۱۱۰۵۴٫ [ Google Scholar ] [ CrossRef ]
  17. الروزوق، ر. عبدالله، م. شانبله، ع. آلانی، س. عبید، ل. تجزیه و تحلیل تناسب فضایی Gibril، MBA Waste to Energy با استفاده از رویکرد یادگیری ماشین چند معیاره ترکیبی. محیط زیست علمی آلودگی. Res. ۲۰۲۱ ، ۲۹ ، ۲۶۱۳-۲۶۲۸٫ [ Google Scholar ] [ CrossRef ]
  18. تقی زاده مهرجردی، ر. نبی اللهی، ک. رسولی، ل. کری، آر. Scholten، T. ارزیابی تناسب زمین و پایداری تولید کشاورزی با استفاده از مدل‌های یادگیری ماشین. Agronomy ۲۰۲۰ , ۱۰ , ۵۷۳٫ [ Google Scholar ] [ CrossRef ]
  19. بوگر، آر. صالحی، ح. پورقاسمی، HR; Blaschke، T. پیش بینی مناسب زیستگاه و حفظ گونه Juniperus. زیستگاه با استفاده از تکنیک‌های یادگیری ماشینی SVM و حداکثر آنتروپی. Water ۲۰۱۹ ، ۱۱ ، ۲۰۴۹٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
  20. اسدی، م. پورحسین، ک. مدلسازی مکان مزرعه بادی/خورشیدی مبتنی بر شبکه عصبی: مطالعه موردی آذربایجان شرقی. بین المللی J. Sustain. انرژی ۲۰۲۰ ، ۴۰ ، ۱-۲۲٫ [ Google Scholar ] [ CrossRef ]
  21. جانی، هنگ کنگ؛ کچواها، اس.اس. ناگابابو، جی. Das، A. ارزیابی همزمانی زمانی و مکانی منابع انرژی باد-خورشید در هند با روش تحلیل آماری و یادگیری ماشینی خوشه‌بندی. Energy ۲۰۲۲ , ۲۴۸ , ۱۲۳۵۸۶٫ [ Google Scholar ] [ CrossRef ]
  22. شهاب، ع. سینگ، MP تحلیل مقایسه ای الگوریتم های مختلف یادگیری ماشین در طبقه بندی مناسب بودن منابع انرژی تجدید پذیر. در مجموعه مقالات کنفرانس بین المللی ۲۰۱۹ در زمینه ارتباطات و پردازش سیگنال (ICCSP)، ملمارواتور، هند، ۴ تا ۶ آوریل ۲۰۱۹؛ صص ۳۶۰-۳۶۴٫ [ Google Scholar ] [ CrossRef ]
  23. چاکرابورتی، دی. Başağaoğlu، H.; Winterle، J. مدل‌های یادگیری ماشینی قابل تفسیر در مقابل غیرقابل تفسیر برای مدل‌سازی فرآیند هیدرو-اقلیمی مبتنی بر داده. سیستم خبره Appl. ۲۰۲۱ ، ۱۷۰ ، ۱۱۴۴۹۸٫ [ Google Scholar ] [ CrossRef ]
  24. عدادی، ع. Berrada، M. Peeking Inside the Black-Box: A Survey on Expenable Artificial Intelligence (XAI). دسترسی IEEE ۲۰۱۸ ، ۶ ، ۵۲۱۳۸–۵۲۱۶۰٫ [ Google Scholar ] [ CrossRef ]
  25. متین، اس اس; پرادان، ب. نقشه‌برداری ساختمان‌های ناشی از زلزله با استفاده از Ai قابل توضیح (Xai). Sensors ۲۰۲۱ , ۲۱ , ۴۴۸۹٫ [ Google Scholar ] [ CrossRef ]
  26. باردو آریتا، آ. دیاز رودریگز، ن. دل سر، جی. بنتوت، ا. تبیک، س. باربادو، آ. گارسیا، اس. گیل لوپز، اس. مولینا، دی. بنجامین، آر. و همکاران هوش مصنوعی قابل توضیح (XAI): مفاهیم، ​​طبقه بندی ها، فرصت ها و چالش ها نسبت به هوش مصنوعی مسئول. Inf. فیوژن ۲۰۲۰ ، ۵۸ ، ۸۲-۱۱۵٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  27. دیکشیت، ا. پرادان، بی. هوش مصنوعی قابل توضیح در پیش بینی خشکسالی. ماخ فرا گرفتن. Appl. ۲۰۲۱ ، ۶ ، ۱۰۰۱۹۲٫ [ Google Scholar ] [ CrossRef ]
  28. دیکشیت، ا. پرادان، ب. مدل هوش مصنوعی قابل تفسیر و توضیح (XAI) برای پیش‌بینی خشکسالی فضایی. علمی کل محیط. ۲۰۲۱ ، ۸۰۱ ، ۱۴۹۷۹۷٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
  29. کالینی، ای. پالسی، LAI; نسی، پ. پانتالئو، جی. نوسنتینی، ن. Rosi، A. پیش بینی و درک رویدادهای زمین لغزش با هوش مصنوعی قابل توضیح. دسترسی IEEE ۲۰۲۲ ، ۱۰ ، ۳۱۱۷۵–۳۱۱۸۹٫ [ Google Scholar ] [ CrossRef ]
  30. عبدالهی، ع. پرادان، ب. نقشه برداری پوشش گیاهی شهری از تصاویر هوایی با استفاده از هوش مصنوعی قابل توضیح (XAI). Sensors ۲۰۲۱ , ۲۱ , ۴۷۳۸٫ [ Google Scholar ] [ CrossRef ]
  31. العبادی، AM نقشه‌برداری حساسیت سیل در یک منطقه خشک جنوب عراق با استفاده از طبقه‌بندی‌کننده‌های یادگیری ماشینی مجموعه: یک مطالعه تطبیقی. عرب جی. ژئوشی. ۲۰۱۸ ، ۱۱ ، ۲۱۸٫ [ Google Scholar ] [ CrossRef ]
  32. دانت، اس. سوریچتا، ا. تیلور، جی. Eigenbrod، F. مجموعه داده های جهانی هماهنگ مکان ها و نیرو مزرعه بادی و خورشیدی. علمی داده‌های ۲۰۲۰ ، ۷ ، ۱-۱۲٫ [ Google Scholar ] [ CrossRef ]
  33. علی، س. تاویکن، ج. تکاتو، ک. وائوساک، جی. Gyawali، S. ارزیابی مناسب بودن سایت مبتنی بر GIS برای مزارع بادی و خورشیدی در Songkhla، تایلند. تمدید کنید. انرژی ۲۰۱۹ ، ۱۳۲ ، ۱۳۶۰–۱۳۷۲٫ [ Google Scholar ] [ CrossRef ]
  34. انورزی، م. ناگاساکا، K. پتانسیل قابل اجرا در مقیاس سودمند انرژی های باد و خورشید برای افغانستان با استفاده از تجزیه و تحلیل تصمیم گیری چند معیاره GIS. تمدید کنید. حفظ کنید. Energy Rev. ۲۰۱۷ , ۷۱ , ۱۵۰-۱۶۰٫ [ Google Scholar ] [ CrossRef ]
  35. منتیس، دی. سیال، SH; کورکوولوس، ا. هاولز، ام. ارزیابی جغرافیایی پتانسیل نیروی باد فنی-اقتصادی در هند با استفاده از محدودیت های جغرافیایی. تمدید کنید. انرژی ۲۰۱۶ ، ۹۷ ، ۷۷-۸۸٫ [ Google Scholar ] [ CrossRef ]
  36. ترکان، ای. ایمن، ع. اورفالی، تی. Saracoglu، BO چارچوبی پایدار برای برنامه ریزی فضایی مزارع خورشیدی فتوولتائیک با استفاده از GIS و رویکرد ارزیابی چند معیاره در آناتولی مرکزی، ترکیه. خط مشی استفاده از زمین ۲۰۲۱ ، ۱۰۲ ، ۱۰۵۲۷۲٫ [ Google Scholar ] [ CrossRef ]
  37. کنان، دی. مؤذنی، س. مصطفایی درمیان، س. افراسیابی، ع. رویکرد ترکیبی مبتنی بر روش‌های MCDM و شبیه‌سازی مونت کارلو برای ارزیابی پایدار سایت‌های خورشیدی بالقوه در شرق ایران. جی. پاک. تولید ۲۰۲۱ ، ۲۷۹ ، ۱۲۲۳۶۸٫ [ Google Scholar ] [ CrossRef ]
  38. فین، تی. McKenzie, P. یک شاخص مناسب با وضوح بالا برای مکان مزرعه خورشیدی در مناظر پیچیده. تمدید کنید. انرژی ۲۰۲۰ ، ۱۵۸ ، ۵۲۰-۵۳۳٫ [ Google Scholar ] [ CrossRef ]
  39. حبیب، اس.م. الرعی امام سلیمان، ع. النهری، ق. عبد الرحمن، مدلسازی فضایی EN برای انتخاب مکان بهینه نیروگاه فتوولتائیک خورشیدی در ساحل شمال غربی مصر. Remote Sens. Appl. Soc. محیط زیست ۲۰۲۰ ، ۱۸ ، ۱۰۰۳۱۳٫ [ Google Scholar ] [ CrossRef ]
  40. ابراهیم، ​​GRF; حمید، ع.ا. دروش، UM; رسول، الف. یک فرآیند سلسله مراتبی منطقی-تحلیلی بولی مبتنی بر GIS برای نیروگاه خورشیدی (مطالعه موردی: استان اربیل-عراق). محیط زیست توسعه دهنده حفظ کنید. ۲۰۲۰ ، ۲۳ ، ۶۰۶۶-۶۰۸۳٫ [ Google Scholar ] [ CrossRef ]
  41. مکرم، م. مکرم، م.ج. گیتی زاده، م. نیکنام، ت. آقایی، ج. مکان‌یابی بهینه مزارع خورشیدی با استفاده از تصمیم‌گیری چند معیاره (MCDA) و انتخاب ویژگی. جی. پاک. تولید ۲۰۲۰ ، ۲۶۱ ، ۱۲۱۰۹٫ [ Google Scholar ] [ CrossRef ]
  42. حسن، م. حسن، ع. الدشتی، H. تجزیه و تحلیل مناسب بودن مبتنی بر GIS برای مکان‌یابی نیروگاه‌های خورشیدی در کویت. مصر. J. Remote Sens. Space Sci. ۲۰۲۰ ، ۲۴ ، ۴۵۳-۴۶۱٫ [ Google Scholar ] [ CrossRef ]
  43. محمد، SA کاربرد فرآیند تحلیل سلسله مراتبی جغرافیایی فضایی و تجزیه و تحلیل چند معیاره برای مناسب بودن مکان ایستگاه های خورشیدی نمک زدایی در مصر. جی افر. علوم زمین ۲۰۲۰ , ۱۶۴ , ۱۰۳۷۶۷٫ [ Google Scholar ] [ CrossRef ]
  44. رویز، اچ اس. سونارسو، ا. ابراهیم بثیس، ک. مورتی، SA; Budiarto، I. تجزیه و تحلیل تصمیم گیری چند معیاره GIS-AHP برای مکان بهینه نیروگاه های انرژی خورشیدی در اندونزی. انرژی ، ۲۰۲۰ ، ۶ ، ۳۲۴۹-۳۲۶۳٫ [ Google Scholar ] [ CrossRef ]
  45. گوس، دی. ناسکار، س. شبی الدین; صادق زاده، م. اسد، MEH; نبی پور، ن. مناطق با پتانسیل خورشیدی بالا با استفاده از Q-GIS در بنگال غربی، هند. حفظ کنید. فناوری انرژی ارزیابی کنید. ۲۰۲۰ ، ۴۲ ، ۱۰۰۸۶۴٫ [ Google Scholar ] [ CrossRef ]
  46. سان، ال. جیانگ، ی. گوا، کیو. جی، ال. زی، ی. کیائو، کیو. هوانگ، جی. Xiao, K. یک روش تصمیم گیری چند معیاره مبتنی بر GIS برای ارزیابی پتانسیل و انتخاب مکان های مناسب گیاهان PV و CSP. منبع. حفظ کنید. بازیافت. ۲۰۲۰ , ۱۶۸ , ۱۰۵۳۰۶٫ [ Google Scholar ] [ CrossRef ]
  47. برتسیو، م.م. تئوچاری، AP; Baltas، E. تجزیه و تحلیل چند معیاره و روش‌های سیستم‌های اطلاعات جغرافیایی برای مکان‌یابی توربین‌های بادی در یک جزیره شمالی دریای اژه. علوم انرژی مهندس ۲۰۲۰ ، ۹ ، ۴-۱۸٫ [ Google Scholar ] [ CrossRef ]
  48. مرادی، س. یوسفی، ح. نوراللهی، ی. Rosso, D. سیستم پشتیبانی تصمیم گیری چند معیاره برای انتخاب مکان مزرعه بادی و تحلیل حساسیت: مطالعه موردی استان البرز، ایران. استراتژی انرژی Rev. ۲۰۲۰ , ۲۹ , ۱۰۰۴۷۸٫ [ Google Scholar ] [ CrossRef ]
  49. احمدی، SHR; نوراللهی، ی. قنبری، س. ابراهیمی، م. حسینی، ح. فروزانی، ع. حاجی نژاد، الف. رویکرد تصمیم‌گیری فازی ترکیبی برای انتخاب مکان نیروگاه ذخیره‌سازی پمپ‌شده با نیروی باد: مطالعه موردی. حفظ کنید. فناوری انرژی ارزیابی کنید. ۲۰۲۰ , ۴۲ , ۱۰۰۸۳۸٫ [ Google Scholar ] [ CrossRef ]
  50. خو، ی. لی، ی. ژنگ، ال. کوی، ال. لی، اس. لی، دبلیو. Cai, Y. انتخاب مکان مزارع بادی با استفاده از GIS و روش تصمیم‌گیری چند معیاره در Wafangdian، چین. Energy ۲۰۲۰ , ۲۰۷ , ۱۱۸۲۲۲٫ [ Google Scholar ] [ CrossRef ]
  51. کاندن، TSM؛ دورگا، ج. Lollchund، MR; محدودیت‌های چند سطحی Rughoopoth، SDDV مزارع بادی برای یک زمین پیچیده در یک منطقه گرمسیری با استفاده از رویکرد MCDM همراه با GIS. Energy ۲۰۲۰ , ۲۱۱ , ۱۱۸۵۳۳٫ [ Google Scholar ] [ CrossRef ]
  52. تان، Q. وی، تی. پنگ، دبلیو. یو، ز. وو، سی. مدل ارزیابی جامع انتخاب مکان مزرعه بادی بر اساس عنصر ماده ایده‌آل و خوشه‌بندی خاکستری. جی. پاک. تولید ۲۰۲۰ , ۲۷۲ , ۱۲۲۶۵۸٫ [ Google Scholar ] [ CrossRef ]
  53. اوبان، اچ. ناگای، ی. Asano، K. ارزیابی استفاده از زمین و تضاد بالقوه در انرژی بادی خورشیدی و خشکی در ژاپن. تمدید کنید. انرژی ۲۰۲۰ ، ۱۶۰ ، ۸۴۲-۸۵۱٫ [ Google Scholar ] [ CrossRef ]
  54. آلوارز-آلوارادو، جی.ام. Ríos-Moreno، JG; ونتورا-راموس، ای جی; رونکیلو-لوملی، جی. Trejo-Perea، M. یک روش جایگزین برای ارزیابی مکان‌ها با استفاده از معیارهای اقلیم‌شناسی برای میزبانی گیاهان بادی، خورشیدی و ترکیبی. منابع انرژی بخش A بازیابی. Util. محیط زیست اف. ۲۰۲۰ ، ۱ ، ۱-۱۸٫ [ Google Scholar ] [ CrossRef ]
  55. علی، ت. ناهیان، ای جی; Ma, H. یک رویکرد تصمیم‌گیری چند معیاره ترکیبی برای حل مشکل انتخاب فناوری انرژی‌های تجدیدپذیر برای پناهندگان روهینگیا در بنگلادش. جی. پاک. تولید ۲۰۲۰ ، ۲۷۳ ، ۱۲۲۹۶۷٫ [ Google Scholar ] [ CrossRef ]
  56. آچباب، ای. راین، اچ. معنان، م. Saifaoui, D. توسعه و بکارگیری یک رویکرد به کمک GIS-Fuzzy AHP برای مکان یابی یک سیستم انرژی تجدیدپذیر هیبریدی با پتانسیل بالا: مورد منطقه Dakhla-مراکش. در مجموعه مقالات کنفرانس بین المللی IEEE 2020 ژئوماتیک مراکش، کازابلانکا، مراکو، ۱۱ تا ۱۳ مه ۲۰۲۰٫ [ Google Scholar ]
  57. اونال سیلک، م. گانر، ED; Tekin, S. ترکیبی از فرآیندهای سلسله مراتبی تحلیلی فازی و روش های حداکثر آنتروپی برای انتخاب مکان مزرعه بادی. محیط زیست علمی آلودگی. Res. ۲۰۲۲ ، ۲۰۲۲ ، ۱-۱۶٫ [ Google Scholar ] [ CrossRef ]
  58. رضایی، م. خلیل پور، KR; جهانگیری، م. شناسایی مکان چند معیاره برای تولید هیدروژن مبتنی بر باد/خورشید: مورد پایتخت‌های یک کشور در حال توسعه. بین المللی J. Hydrogen Energy ۲۰۲۰ ، ۴۵ ، ۳۳۱۵۱-۳۳۱۶۸٫ [ Google Scholar ] [ CrossRef ]
  59. صادقی، م. کریمی، M. انتخاب مکان توربین خورشیدی و بادی مبتنی بر GIS با استفاده از تحلیل چند معیاره: مطالعه موردی تهران، ایران. در مجموعه مقالات آرشیو بین المللی فتوگرامتری، سنجش از دور و علوم اطلاعات فضایی – آرشیو ISPRS، تهران، ایران، ۷ تا ۱۰ اکتبر ۲۰۱۷٫ [ Google Scholar ]
  60. الگارنی، HZ; Awasthi، A. Solar PV Power Plants Selection Site: A Review. در پیشرفت در انرژی های تجدیدپذیر و فن آوری های برق ; یحیوی، من.، ویرایش. الزویر: آمستردام، هلند، ۲۰۱۸; ISBN 9780128132173. [ Google Scholar ]
  61. شائو، ام. هان، ز. سان، ج. شیائو، سی. ژانگ، اس. ژائو، ی. مروری بر برنامه‌های تصمیم‌گیری چند معیاره برای انتخاب سایت انرژی‌های تجدیدپذیر. تمدید کنید. انرژی ۲۰۲۰ ، ۱۵۷ ، ۳۷۷-۴۰۳٫ [ Google Scholar ] [ CrossRef ]
  62. ویلسون، AM; جتز، دبلیو. دینامیک ابر جهانی با وضوح بالا برای پیش‌بینی توزیع‌های اکوسیستم و تنوع زیستی. PLoS Biol. ۲۰۱۶ , ۱۴ , e1002415. [ Google Scholar ] [ CrossRef ] [ PubMed ]
  63. آماتولی، جی. دومیش، اس. Tuanmu، MN; پارمنتیه، بی. رانیپتا، ا. Malczyk، J. جتز، دبلیو. توصیفگر داده: مجموعه ای از متغیرهای توپوگرافی با مقیاس جهانی برای مدلسازی محیطی و تنوع زیستی. علمی داده ۲۰۱۸ ، ۵ ، ۱۸۰۰۴۰٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
  64. آردرن، سی. نیکلاس، سی. زورن، سی. Koks، EE داده ها از: نقشه پیش بینی سیستم قدرت جهانی با استفاده از داده های باز. نات. علمی داده‌های ۲۰۲۰ ، ۷ ، ۱-۱۲٫ [ Google Scholar ] [ CrossRef ]
  65. گونزالس زلایا، CV به سمت توضیح اثرات پیش پردازش داده بر یادگیری ماشین. Proc. بین المللی Conf. مهندسی داده ۲۰۱۹ ، ۲۰۱۹ ، ۲۰۸۶–۲۰۹۰٫ [ Google Scholar ] [ CrossRef ]
  66. اسلام، س. سارا، یو. رحمان، ع. کندو، دی. حسن، م. کوثر، ع. دیپتا، دی. رضاول کریم، ANM SGBBA: یک روش کارآمد برای سیستم پیش‌بینی در یادگیری ماشین با استفاده از مجموعه داده‌های عدم تعادل. بین المللی J. Adv. محاسبه کنید. علمی Appl. ۲۰۲۱ ، ۱۲ ، ۴۳۰-۴۴۱٫ [ Google Scholar ] [ CrossRef ]
  67. لیانگ، ز. لیو، ن. مقیاس‌بندی ویژگی کارآمد برای ماشین‌های بردار پشتیبان با هسته درجه دوم. فرآیند عصبی. Lett. ۲۰۱۴ ، ۳۹ ، ۲۳۵-۲۴۶٫ [ Google Scholar ] [ CrossRef ]
  68. کلانتر، بی. اوئدا، ن. سعیدی، و. جانی زاده، س. شعبانی، ف. احمدی، ک. شعبانی، F. شبکه عصبی عمیق با استفاده از مجموعه داده های سنجش از دور برای نقشه برداری حساسیت خطر سیل در بریزبن، استرالیا. Remote Sens. ۲۰۲۱ , ۱۳ , ۲۶۳۸٫ [ Google Scholar ] [ CrossRef ]
  69. کاتروتسا، ا. Strijov, V. مطالعه جامع روشهای انتخاب ویژگی برای حل مسئله چند خطی بر اساس معیارهای ارزیابی. سیستم خبره Appl. ۲۰۱۷ ، ۷۶ ، ۱-۱۱٫ [ Google Scholar ] [ CrossRef ]
  70. منگ، اف. لیانگ، ایکس. شیائو، سی. Wang, G. ادغام GIS، بهبود آنتروپی و روش‌های فاجعه‌آمیز بهبود یافته برای ارزیابی مکان‌های مناسب برای حفاری چاه در دشت‌های خشک و نیمه‌خشک. Ecol. اندیک. ۲۰۲۱ ، ۱۳۱ ، ۱۰۸۱۲۴٫ [ Google Scholar ] [ CrossRef ]
  71. ساها، S. نقشه برداری پتانسیل آب های زیرزمینی با استفاده از فرآیند سلسله مراتبی تحلیلی: مطالعه بر روی بلوک Md. Bazar در منطقه Birbhum، بنگال غربی. تف کردن Inf. Res. ۲۰۱۷ ، ۲۵ ، ۶۱۵-۶۲۶٫ [ Google Scholar ] [ CrossRef ]
  72. هان، اس. جیا، ایکس. چن، ایکس. گوپتا، اس. کومار، ا. Lin, Z. خوب جستجو کنید و عاقل باشید: یک رویکرد یادگیری ماشینی برای جستجوی مکان سودآور. اتوبوس جی. Res. ۲۰۲۲ ، ۱۴۴ ، ۴۱۶-۴۲۷٫ [ Google Scholar ] [ CrossRef ]
  73. یوسف، ع.م. پورقاسمی، HR; پورتقی، ز.س. الکثیری، MM نقشه‌برداری حساسیت زمین لغزش با استفاده از جنگل تصادفی، درخت رگرسیون تقویت‌شده، درخت طبقه‌بندی و رگرسیون، و مدل‌های خطی عمومی و مقایسه عملکرد آنها در حوضه وادی طیه، منطقه عسیر، عربستان سعودی. زمین لغزش ۲۰۱۶ ، ۱۳ ، ۸۳۹-۸۵۶٫ [ Google Scholar ] [ CrossRef ]
  74. اورنلا، ال. تاپیا، E. یادگیری ماشینی نظارت شده و طبقه‌بندی هتروتیک ذرت (Zea Mays L.) با استفاده از داده‌های نشانگر مولکولی. محاسبه کنید. الکترون. کشاورزی ۲۰۱۰ ، ۷۴ ، ۲۵۰-۲۵۷٫ [ Google Scholar ] [ CrossRef ]
  75. مولالو، ع. صادقیان، ع. اسرائیل، جی دی; رشیدی، پ. صوفی زاده، ع. رویکردهای یادگیری ماشینی Glass، GE در مدل‌سازی اکولوژیکی مگس شنی فلبوتوموس پاپاتاسی مبتنی بر GIS، ناقل لیشمانیوز جلدی زئونوز در استان گلستان، ایران. آکتا تروپ. ۲۰۱۸ ، ۱۸۸ ، ۱۸۷-۱۹۴٫ [ Google Scholar ] [ CrossRef ]
  76. ابیرامی، س. Chitra، P. سیستم پشتیبانی مراقبت های بهداشتی در زمان واقعی مبتنی بر لبه انرژی کارآمد. در پیشرفت در کامپیوتر ; الزویر: آمستردام، هلند، ۲۰۲۰؛ ISBN 9780128187562. [ Google Scholar ]
  77. جهانگیر، محمدحسن؛ مهسا، س. رینه، م. ابوالقاسمی، م. پیش بینی فضایی نقشه پهنه بندی Fl Ood در حوضه رودخانه کن، ایران با استفاده از الگوریتم شبکه عصبی آرتی فی سیال. آب و هوا. افراطی ۲۰۱۹ ، ۲۵ ، ۱۰۰۲۱۵٫ [ Google Scholar ] [ CrossRef ]
  78. پدرگوسا، اف. واروکو، جی. گرامفورت، آ. میشل، وی. تیریون، بی. گریزل، او. بلوندل، م. پرتنهوفر، پی. ویس، آر. دوبورگ، وی. و همکاران Scikit-Learn: یادگیری ماشینی در پایتون. جی. ماخ. فرا گرفتن. Res. ۲۰۱۱ ، ۱۲ ، ۲۸۲۵-۲۸۳۰٫ [ Google Scholar ]
  79. یوسفی، س. آوند، م. یاریان، پ. جهانبازی گوجانی، ح. کاستاش، آر. توانگر، س. Tiefenbacher, JP شناسایی مناسب ترین سایت های جنگل کاری توسط گونه Juniperus Excels با استفاده از مدل های یادگیری ماشین: منطقه نیمه خشک فیروزکوه، ایران. Ecol. به اطلاع رساندن. ۲۰۲۱ ، ۶۵ ، ۱۰۱۴۲۷٫ [ Google Scholar ] [ CrossRef ]
  80. Böken, B. در مورد مناسب بودن مقیاس بندی پلات در کالیبراسیون طبقه بندی کننده. Inf. سیستم ۲۰۲۱ ، ۹۵ ، ۱۰۱۶۴۱٫ [ Google Scholar ] [ CrossRef ]
  81. بلا، ا. فری، سی. هرناندز-اورالو، جی. Ramírez-Quintana، MJ در مورد اثر کالیبراسیون در ترکیب طبقه بندی کننده. Appl. هوشمند ۲۰۱۳ ، ۳۸ ، ۵۶۶-۵۸۵٫ [ Google Scholar ] [ CrossRef ]
  82. دانکوفسکی، تی. Ziegler، A. کالیبره کردن جنگل های تصادفی برای تخمین احتمال. آمار پزشکی ۲۰۱۶ ، ۳۵ ، ۳۹۴۹-۳۹۶۰٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  83. بوستروم، اچ. کالیبره کردن جنگل های تصادفی. در مجموعه مقالات هفتمین کنفرانس بین المللی ۲۰۰۸ در مورد یادگیری ماشین و برنامه های کاربردی، سن دیگو، کالیفرنیا، ایالات متحده، ۱۱-۱۳ دسامبر ۲۰۰۸٫ صص ۱۲۱-۱۲۶٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  84. خو، اف. Uszkoreit، H. دو، ی. فن، دبلیو. ژائو، دی. زو، جی. هوش مصنوعی قابل توضیح: بررسی مختصری در مورد تاریخ، حوزه‌های تحقیقاتی، رویکردها و چالش‌ها. لکت. یادداشت ها محاسبه. علمی ۲۰۱۹ ، ۱۱۸۳۹ ، ۵۶۳-۵۷۴٫ [ Google Scholar ] [ CrossRef ]
  85. Shapley، LS ارزشی برای بازی‌های N-Person. مشارکت در نظریه بازی ها. ان ریاضی. گل میخ. ۱۹۵۳ ، ۲ ، ۳۰۷-۳۱۷٫ [ Google Scholar ]
  86. لوندبرگ، اس ام. لی، SI رویکردی واحد برای تفسیر پیش‌بینی‌های مدل. Adv. عصبی Inf. روند. سیستم ۲۰۱۷ ، ۲۰۱۷ ، ۴۷۶۶–۴۷۷۵٫ [ Google Scholar ] [ CrossRef ]
  87. لوندبرگ، اس ام. اریون، جی جی. لی، اس.-آی. انتساب ویژگی های فردی منسجم برای گروه های درختی. arXiv ۲۰۱۸ , arXiv:1802.03888. [ Google Scholar ]
  88. مانگالاتو، اس. هوانگ، SH; جئون، حالت شکست JS و تجزیه و تحلیل اثرات اعضای RC بر اساس رویکرد توضیحی افزودنی شاپلی مبتنی بر یادگیری ماشینی (SHAP). مهندس ساختار. ۲۰۲۰ , ۲۱۹ , ۱۱۰۹۲۷٫ [ Google Scholar ] [ CrossRef ]
  89. پراساد، AM; آیورسون، ال آر. Liaw، A. طبقه بندی جدیدتر و تکنیک های درخت رگرسیون: کیسه بندی و جنگل های تصادفی برای پیش بینی اکولوژیکی. اکوسیستم ها ۲۰۰۶ ، ۹ ، ۱۸۱-۱۹۹٫ [ Google Scholar ] [ CrossRef ]
  90. Boulesteix، AL; بندر، ا. Bermejo، JL; Strobl، C. Random Forest Gini اهمیت SNP ها با فرکانس آللی کوچک کوچک را ترجیح می دهد: تاثیر، منابع و توصیه ها. مختصر. بیوانفورم. ۲۰۱۲ ، ۱۳ ، ۲۹۲-۳۰۴٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  91. دشموک، ر. وو، جی سی؛ Callaway، DS; Phadke، A. تحلیل جغرافیایی و فنی-اقتصادی منابع بادی و خورشیدی در هند. تمدید کنید. انرژی ۲۰۱۹ ، ۱۳۴ ، ۹۴۷–۹۶۰٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  92. کنستانتینوس، آی. جورجیوس، تی. Garyfalos، A. یک روش سیستم پشتیبانی تصمیم برای انتخاب مکان‌های نصب مزرعه بادی با استفاده از AHP و TOPSIS: مطالعه موردی در منطقه مقدونیه شرقی و تراکیه، یونان. سیاست انرژی ۲۰۱۹ ، ۱۳۲ ، ۲۳۲-۲۴۶٫ [ Google Scholar ] [ CrossRef ]
  93. ساراسوات، SK; دیگالوار، AK; Yadav, SS; کومار، جی. MCDM و تکنیک مدلسازی مبتنی بر GIS برای ارزیابی مکان‌های مزرعه خورشیدی و بادی در هند. تمدید کنید. انرژی ۲۰۲۱ ، ۱۶۹ ، ۸۶۵-۸۸۴٫ [ Google Scholar ] [ CrossRef ]
  94. جهانگیری، م. شمس آبادی، ع.ا. مصطفایی پور، ع. رضایی، م. یوسفی، ی. Pomares، LM با استفاده از تکنیک فازی MCDM برای یافتن بهترین مکان در قطر برای بهره برداری از انرژی باد و خورشید برای تولید هیدروژن و الکتریسیته. بین المللی J. Hydrogen Energy ۲۰۲۰ ، ۴۵ ، ۱۳۸۶۲-۱۳۸۷۵٫ [ Google Scholar ] [ CrossRef ]
  95. الفلاحی، MDA; جایاسینگه، SDG; انشایی، ح. مروری بر روش‌های بهینه‌سازی اندازه اخیر برای سیستم‌های انرژی تجدیدپذیر هیبریدی خورشیدی و بادی مستقل. مبدل انرژی مدیریت ۲۰۱۷ ، ۱۴۳ ، ۲۵۲-۲۷۴٫ [ Google Scholar ] [ CrossRef ]
  96. هوانگ، تی. وانگ، اس. یانگ، کیو. لی، جی. یک ارزیابی مبتنی بر GIS از پتانسیل PV در مقیاس بزرگ در چین. Energy Procedia ۲۰۱۸ ، ۱۵۲ ، ۱۰۷۹-۱۰۸۴٫ [ Google Scholar ] [ CrossRef ]
  97. Doorga، JRS; هال، جی دبلیو. ایر، N. تجزیه و تحلیل چند معیاره زمین فضایی برای شناسایی مکان های بهینه باد و خورشید در آفریقا: به سوی کربن زدایی بخش نیرو موثر. تمدید کنید. حفظ کنید. Energy Rev. ۲۰۲۲ , ۱۵۸ , ۱۱۲۱۰۷٫ [ Google Scholar ] [ CrossRef ]
  98. جهانگیری، م. قادری، ر. حقانی، ع. نعمت اللهی، او. یافتن بهترین مکان برای استقرار نیروگاه های خورشیدی-بادی در خاورمیانه با استفاده از GIS: مروری. تمدید کنید. حفظ کنید. Energy Rev. ۲۰۱۶ , ۶۶ , ۳۸-۵۲٫ [ Google Scholar ] [ CrossRef ]
شکل ۱٫ نمودار روش شناسی ارزیابی فضایی مبتنی بر ML و XAI برای مزارع RE.
شکل ۲٫ مکان نیروگاه های بادی و خورشیدی در سطح جهان.
شکل ۳٫ نقشه های موضوعی برای عوامل شرطی. ( الف ) سرعت باد، ( ب ) چگالی باد، ( ج ) تابش خورشید، ( د ) دمای هوا، ( ه ) شاخص ابر، ( f ) ارتفاع، ( گرم ) شیب، ( h ) نزدیکی به شهر، ( i ) نزدیکی به جاده، ( j ) نزدیکی به شبکه، ( k ) پوشش زمین، ( ل ) بلایای طبیعی، و ( m ) تراکم جمعیت.
شکل ۴٫ آزمون AUC پیش بینی فضایی مبتنی بر RF نیروگاه های انرژی باد ( a ) و خورشیدی ( b ).
شکل ۵٫ نمودارهای کالیبراسیون مدل های RF برای پیش بینی مناسب بودن فضایی ( الف ) باد و ( ب ) نیروگاه های خورشیدی.
شکل ۶٫ توزیع فضایی جهانی درجات مناسب بودن سایت برای ( الف ) مزارع بادی و ( ب ) انرژی خورشیدی.
شکل ۷٫ توضیح کلی با استفاده از نمودار خلاصه SHAP برای تأثیر عوامل ( a ) مجموعه داده باد و ( ب ) مجموعه داده خورشیدی بر نتایج پیش‌بینی.
شکل ۸٫ توضیح محلی با استفاده از نمودار نیروی SHAP برای تأثیر عوامل بر روی پیکسل های طبقه بندی شده به عنوان مناسب برای باد ( a )، نامناسب برای باد ( b )، مناسب برای خورشید ( c )، و نامناسب برای خورشید ( d ).
شکل ۹٫ نمودارهای وابستگی SHAP برای تفسیر برهمکنش بین WS و PC برای کلاس های مناسب ( a ) و نامناسب ( b ) تاسیسات برق بادی و تعامل بین AT و PC برای کلاس های مناسب ( c ) و نامناسب ( d ) مزارع خورشیدی
شکل ۱۰٫ وزن و درصد سهم عوامل تهویه در نقشه برداری مناسب بودن سایت برای ( الف ) نیروگاه های بادی و ( ب ) خورشیدی.
شکل ۱۱٫ نمونه های موجودی RE بر اساس درجه تناسب فردی.
شکل ۱۲٫ مکان های مناسب در سراسر جهان برای میزبانی نیروگاه های بادی، خورشیدی و بادی-خورشیدی.
شکل ۱۳٫ مقایسه نتایج مطالعه حاضر با خروجی های گروهی از کارهای دیگر انجام شده در: ( الف ) ایالات متحده آمریکا، ( ب ) چین، ( ج ) قاره آفریقا و ( د ) خاورمیانه.

دیدگاهتان را بنویسید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *

خانهدربارهتماسارتباط با ما