۱٫ معرفی
تقسیم بندی معنایی یکی از مهم ترین روش های تحقیق برای بینایی کامپیوتری است و وظیفه دارد هر پیکسل یا نقطه در صحنه را به کلاس هایی طبقه بندی کند که ویژگی های خاصی دارند [ ۱ ، ۲ ]. در گذشته، بخشبندی معنایی به تصاویر دو بعدی مربوط میشد، اما به دلیل برخی محدودیتهای مربوط به انسداد، روشنایی، وضعیت بدن و سایر مشکلات، تحقیقات به دادههای سهبعدی پرداختند. این تغییر همچنین به لطف انتشار رو به رشد فتوگرامتری و بررسیهای اسکن لیزری رخ داد. در شکل سه بعدی تقسیم بندی معنایی، نقاط منظم یا نامنظم در فضای سه بعدی پردازش می شوند [ ۳ ].
مطمئناً، تفسیر خودکار ابرهای نقطه سه بعدی با تقسیم بندی معنایی در زمینه میراث فرهنگی (CH) یک کار بسیار چالش برانگیز را نشان می دهد. به دست آوردن اسناد دیجیتالی آسان نیست، اما انتشار میراث فرهنگی ضروری است [ ۴ ]. اشکال پیچیده هستند و اشیاء، حتی اگر قابل تکرار باشند، منحصر به فرد، دست ساز و سریالی نیستند. با وجود این، درک صحنه های سه بعدی در CH دیجیتال بسیار مهم است، زیرا می تواند کاربردهای زیادی مانند شناسایی عناصر معماری مشابه در مجموعه داده های بزرگ، تجزیه و تحلیل وضعیت حفاظت از مواد، تقسیم بندی ابرهای نقطه ای در ساختار آن داشته باشد. قطعات مقدماتی برای فرآیندهای اسکن به BIM و غیره [ ۵ ].
در سالهای اخیر، تحقیقات برای تقسیمبندی معنایی ابرهای نقطهای در CH به لطف استفاده از روشهای هوش مصنوعی (AI) پیشرفت چشمگیری داشته است [ ۶ ، ۷ ]. در ادبیات، بیشتر رویکردهای یادگیری ماشین (ML) و یادگیری عمیق (DL) از روشهای یادگیری نظارت شده استفاده میکنند. با توجه به [ ۸ ] در عصر کلان داده، رویکردهای طبقهبندی ML در رویکردهای DL در حال تکامل هستند، زیرا برای مقابله با مقدار زیادی از دادههای مشتقشده از روشهای مدرن و با پیچیدگی ابرهای نقطه سه بعدی، با آموزش مداوم کارآمدتر هستند. و تنظیم توانایی های آنها [ ۹ ، ۱۰ ، ۱۱]. با این حال، از آنجایی که موفقیت آنها به در دسترس بودن مقادیر زیادی از مجموعه داده مشروح شده متکی است، جایگزینی کامل رویکردهای ML در زمینه میراث هنوز ممکن نیست. اشکال عمده روشهای DL این است که به راحتی قابل تفسیر نیستند، زیرا این مدلها مانند جعبه سیاه رفتار میکنند و در ارائه توضیحاتی در مورد پیشبینیهای خود ناکام هستند.
در این زمینه، هدف این تحقیق گزارش مقایسه بین دو رویکرد طبقهبندی مختلف برای سناریوهای CH، بر اساس تکنیکهای یادگیری ماشینی و عمیق است. در میان آنها، چهار الگوریتم پیشرفته ML و DL آزمایش میشوند که امکان ترکیب جنبههای مثبت هر روش را در یک معماری جدید (که بعداً DGCNN-Mod+3Dfeat نامیده شد) برای تقسیمبندی معنایی معماریهای CH 3D برجسته میکند. .
در میان روش های ML، ما از K-Nearest Neighbors (kNN) [ ۱۲ ]، Naive Bayes (NB) [ ۱۳ ]، Decision Trees (DT) [ ۱۴ ] و Random Forest (RF) [ ۱۵ ] استفاده کردیم. آنها با ویژگیهای هندسی و وصلههای حاشیهنویسی کوچک، بهصورت موقت در مطالعات موردی مختلف انتخاب شدهاند.
با توجه به رویکردهای DL، از چهار نسخه مختلف از DGCNN [ ۱۶ ] استفاده میشود که در چندین صحنه از معیار ArCH میراث پیشنهادی جدید [ ۱۷ ]، که از ابرهای نقطهای CH مشروح شده مختلف تشکیل شده است، آموزش دیدهاند. دو مورد از چهار معماری DGCNN پیشنهادی (DGCNN و DGCNN-Mod) قبلاً توسط نویسندگان در مقاله قبلی [ ۱۸ ] آزمایش شده است که در آن، از مقایسه با سایر NN های پیشرفته (PointNet، PointNet++، PCNN، DGCNN). ) DGCNN بهترین معماری برای داده های ما است. بنابراین، در این مقاله، نتایج ارائه شده قبلی با نتایج به دست آمده در معرفی ویژگی های جدید به شبکه ها مقایسه شده است.
ارزیابی روشهای ML و DL انتخاب شده بر روی سه صحنه میراث مختلف متعلق به مجموعه داده ArCH ذکر شده در بالا انجام میشود.
سوالات تحقیق و ساختار مقاله
در زمینه طبقهبندی ابر نقطه مرتبط با CH و روشهای تقسیمبندی معنایی، چهار سؤال تحقیق توسط این مطالعه مورد بررسی قرار میگیرد:
- RQ1
-
آیا میتوان دستورالعملهایی را برای تقسیمبندی خودکار ابرهای نقطه در حوزه CH به جامعه تحقیقاتی ارائه کرد؟
- RQ2
-
کدام الگوریتم های ML و DL برای تقسیم بندی معنایی ابر نقطه سه بعدی میراث بهتر عمل می کنند؟
- RQ3
-
آیا راه حلی برنده بین ML و DL در حوزه CH وجود دارد؟
- RQ4
-
آیا مقایسه نتایج عملکرد الگوریتمهای ML و DL با یک خط لوله درست است؟
ساختار مقاله به شرح زیر است. بخش ۲ شرحی از رویکردهایی را ارائه می دهد که برای تقسیم بندی معنایی ابرهای نقطه ای اتخاذ شده اند. بخش ۳ مجموعه داده و روش مورد استفاده را تشریح می کند. بخش ۴ یک ارزیابی و تحلیل مقایسه ای گسترده از رویکردهای ML و DL ارائه می دهد. بحث مفصلی از نتایج در بخش ۵ ارائه شده است . در نهایت، بخش ۶ نتیجه گیری می کند و مسیرهای آینده را برای این زمینه تحقیقاتی مورد بحث قرار می دهد.
آزمایشهای اضافی در نهایت با روشهای DL بر روی کل مجموعه داده ArCH (که شامل چهار صحنه جدید برچسبدار CH است، در صورت مقایسه با ۱۲ مورد استفاده شده برای آزمایشهای قبلی ارائه شده در [ ۱۸ ]) اجرا شد تا بررسی شود که آیا بزرگترین اندازه مجموعه داده آموزشی به طور موثر عملکردها را بهبود می بخشد ( پیوست A ، جدول A4 و جدول A5 را برای معیارهای دقیق ببینید). نتایج نشاندادهشده در مقاله شامل این چهار صحنه جدید نمیشود، زیرا مقایسه منصفانه با DGCNN-Mod ارائهشده در [ ۱۸ ] را به خطر میاندازد، بنابراین همان تعداد صحنهها حفظ شده است.
۲٫ آثار مرتبط
در ادبیات، تعداد محدودی از برنامههای کاربردی وجود دارد که از روشهای یادگیری ماشین برای طبقهبندی ابرهای نقطه سه بعدی در اشیاء مختلف متعلق به صحنههای میراث فرهنگی استفاده میکنند، حتی اگر طبق [ ۶ ]، این روشها پیشرفت زیادی در این زمینه داشته باشند. در واقع، نویسندگان در مطالعه خود، کاربرد رویکردهای یادگیری ماشینی نظارت شده در میراث فرهنگی را با ارائه یک خط لوله استاندارد برای چندین مطالعه موردی بررسی میکنند.
در این حوزه، تحقیق [ ۱۹ ] دو هدف اصلی دارد: ارائه چارچوبی که عناصر اولیه هندسی را از یک تصویر سنگتراشی استخراج میکند، و استخراج و انتخاب ویژگیهای آماری برای خوشهبندی خودکار سنگتراشی. نویسندگان ابزارهای پردازش تصویر و یادگیری ماشین موجود را برای طبقهبندی مبتنی بر تصویر دیوارهای بنایی ترکیب میکنند و سپس مقایسه عملکردی را بین پنج الگوریتم مختلف یادگیری ماشین برای کار طبقهبندی انجام میدهند. مسئله اصلی این روش این است که هر بلوک دیوار به طور جداگانه مشخص نمی شود.
تحقیق ارائه شده در [ ۲۰ ] می خواهد بر این محدودیت غلبه کند و یک الگوریتم تقسیم خودکار جدید بلوک های بنایی را از یک ابر نقطه سه بعدی به دست آمده با فناوری LiDAR ارائه کند. الگوریتم پردازش تصویر بر اساس بهینهسازی الگوریتم حوضه است، همچنین برای بهبود الگوریتمهای تقسیمبندی در کارهای دیگر [ ۲۱ ، ۲۲ ]، برای تقسیم خودکار ابرهای نقطهای سه بعدی در فضای سهبعدی که هر بلوک سنگی را جدا میکند، استفاده میشود.
در تحقیقات خود، Grilli و همکاران. [ ۲۳ ] راهبردی را برای طبقهبندی مدلهای سهبعدی میراث با اعمال الگوریتمهای طبقهبندی یادگیری ماشین نظارتشده بر روی نقشههای UV پیشنهاد میکند. برای تأیید قابلیت اطمینان روش، نویسندگان طبقهبندیکنندههای مختلف را در سه مطالعه موردی ناهمگن ارزیابی میکنند.
در [ ۲۴ ] نویسندگان رابطه بین ویژگیهای کوواریانس و عناصر معماری را با استفاده از طبقهبندیکننده یادگیری ماشین نظارتشده (جنگل تصادفی) بررسی میکنند، و بهویژه یک همبستگی بین شعاع جستجوی ویژگی و اندازه عنصر پیدا میکنند. تحلیل عمیقتر رویکرد قبلی [ ۲۵ ] توانایی الگوریتم را برای تعمیم سناریوهای مختلف معماری نادیده نشان میدهد. تحقیق انجام شده توسط Murtiyoso و همکاران. [ ۲۶] با هدف کمک به برچسبگذاری ابرهای نقطهای دستی مجموعه دادههای آموزشی بزرگ مورد نیاز از الگوریتمهای یادگیری ماشینی است. علاوه بر این، نویسندگان مجموعهای از توابع را معرفی میکنند که امکان پردازش خودکار برای برخی از مسائل تقسیمبندی و طبقهبندی ابرهای نقطه CH را فراهم میکند. با توجه به پیچیدگی مشکل، پروژه فقط برخی از کلاس های مهم را در نظر می گیرد. جعبه ابزار از یک رویکرد چند مقیاسی استفاده می کند: ابرهای نقطه ای از مجموعه تاریخی تا عناصر معماری پردازش می شوند و آن را برای انواع مختلف میراث مناسب می کنند.
عمدتاً در سالهای اخیر، یادگیری عمیق توجه فزایندهای را از تحقیقات به خود جلب کرده است و با موفقیت برای تقسیم معنایی ابرهای نقطهای سه بعدی در حوزههای مختلف استفاده شده است [ ۳ ، ۲۷ ]. در زمینه میراث فرهنگی هنوز مطالعات کمی وجود دارد که از رویکردهای یادگیری عمیق برای طبقه بندی ابرهای نقطه سه بعدی استفاده می کند. نیاز به داشتن یک مجموعه داده در مقیاس بزرگ می تواند توسعه آن را محدود کند و مانع از انجام تحقیقات در این جهت شود. در برخی موارد این مشکل را می توان با استفاده از مجموعه داده مصنوعی [ ۸ ، ۲۸ ] حل کرد. با این حال، تحقیقات انجام شده تاکنون نتایج دلگرم کننده ای داشته است.
رویکردهای یادگیری عمیق به درستی برای مدیریت مستقیم دادههای خام ابرهای نقطهای بدون در نظر گرفتن یک پردازش میانی که امکان نمایش منظمتری را فراهم میکند، استفاده میشوند. برای این منظور اولین رویکرد در [ ۲۹ ] پیشنهاد شده است. یک نسخه توسعه یافته از شبکه قبلی نه تنها هر نقطه را به طور جداگانه، بلکه همسایگان آن را نیز در نظر می گیرد تا از ویژگی های محلی بهره برداری کند و در نتیجه نتایج طبقه بندی کارآمدتری را به دست آورد [ ۳۰ ].
مالینورنی و همکاران [ ۷ ] از PointNet++ برای تقسیم معنایی ابرهای نقطه سه بعدی مجموعه داده CH استفاده کنید. هدف این مقاله نشان دادن کارایی رویکردهای یادگیری عمیق انتخاب شده برای پردازش ابرهای نقطه ای دامنه CH است. علاوه بر این، این روش بر روی یک مجموعه داده CH ایجاد شده مناسب ارزیابی میشود که به صورت دستی توسط کارشناسان دامنه حاشیهنویسی شده است.
جایگزینی برای این رویکردها مبتنی بر ابرهای نقطه ای شبکه عصبی کانولوشنال (PCNN) [ ۳۱ ] است، یک معماری جدید که از دو عملگر (بسط و محدودیت) استفاده می کند. پسوند توابع تعریف شده روی ابر نقطه را به توابع حجمی ترسیم می کند، در حالی که عملگر محدودیت معکوس را انجام می دهد.
یک رویکرد الهام گرفته از PointNet توسط [ ۱۶ ] پیشنهاد شده است که در آن تفاوت در بهرهبرداری از ساختارهای هندسی محلی با استفاده از یک ماژول شبکه عصبی، EdgeConv است که یک گراف همسایگی محلی میسازد و عملیاتهای کانولوشن مانند را اعمال میکند. علاوه بر این، مدل به نام DGCNN (شبکه عصبی کانولوشنال گراف پویا)، نمودار را بهصورت پویا بهروزرسانی میکند و مجموعه k نزدیکترین همسایگان یک نقطه را از لایهای به لایه دیگر شبکه تغییر میدهد.
در زمینه CH، با الهام از این معماری، Pierdica et al. [ ۱۸ ] پیشنهاد تقسیم معنایی ابرهای نقطه سه بعدی با استفاده از DGCNN تقویت شده با افزودن ویژگی هایی مانند نرمال ها و جزء رادیومتری. هدف این نسخه اصلاح شده ساده کردن مدیریت دارایی های DCH است که دارای هندسه های پیچیده، بسیار متغیر و با سطح بالایی از جزئیات هستند. نویسندگان همچنین یک مجموعه داده جدید در دسترس عموم را برای اعتبار بخشیدن به معماری جدید و مقایسه بین سایر روشهای DL پیشنهاد میکنند.
مطالعه دیگری که از DL برای طبقه بندی اشیاء CH استفاده می کند در [ ۵ ] ارائه شده است. نویسندگان مقایسه عملکردی بین روشهای یادگیری ماشینی و عمیق را در کار طبقهبندی دو مجموعه داده میراث مختلف انجام میدهند. با استفاده از رویکردهای یادگیری ماشین (جنگل تصادفی و یک در مقابل یک) عملکرد تقریباً در تمام کلاسهای شناساییشده عالی است، اما هیچ ارتباطی بین ویژگیها وجود ندارد. با استفاده از رویکردهای DL (1D CNN، ۲D CNN و RNN Bi-LSTM) ابرهای نقطه سه بعدی به عنوان دنباله ای از نقاط در نظر گرفته می شوند. با این حال، رویکردهای ML بر DL غلبه میکنند، زیرا به گفته نویسندگان، روشهای DL پیادهسازیشده خیلی جدید نیستند، و بنابراین سایر معماریها آزمایش خواهند شد.
۳٫ مواد و روشها
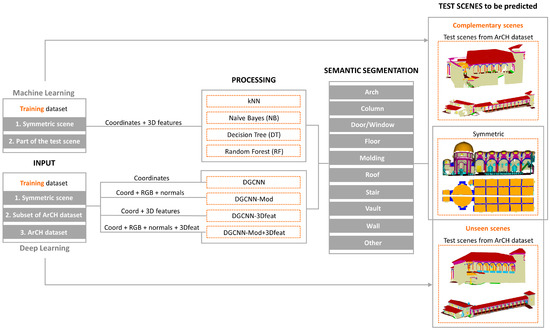
در این بخش گردش کار مقایسه بین دو روش، و همچنین طبقهبندیکنندهها و صحنههای مورد استفاده برای سه آزمایش ارائه شده است ( شکل ۱ ).
همانطور که قبلا ذکر شد، هدف این مقاله مقایسه الگوریتم ها نیست، بلکه رویکردهای طبقه بندی است. در واقع، برای مقایسه عادلانه بین الگوریتم های طبقه بندی، استفاده از داده های آموزشی یکسان ضروری است. در این زمینه، برخی آزمایشهای اولیه با استفاده از تعداد صحنههای یکسان در مراحل آموزشی برای هر دو الگوریتم DL و ML انجام شده است. با این حال، طبقهبندیکنندههای ML در مقایسه با مواردی که با استفاده از بخشهای حاشیهنویسی کاهشیافته صحنههای آزمایشی بهدست آمدند، به نتایج رضایتبخشی دست پیدا نکردند. بنابراین، از آنجایی که هدف مقاله بحث در مورد بهترین رویکردها برای طبقهبندی میراث است، مقایسهای بین رویکردهای ML و DL ارائه میشود که در آن دادههای آموزشی متفاوت است.
سه آزمایش مختلف به شرح زیر انجام شده است. در آزمایش اول، هر دو طبقهبندیکننده ML و DL مختلف در یک بخش از یک صحنه متقارن آموزش داده شدهاند: نیمی از ابر نقطه برای آموزش و اعتبارسنجی، و نیمی برای آزمایش نهایی استفاده میشود. در آزمایش دوم و سوم، نمونه های مورد استفاده برای آموزش طبقه بندی کننده های ML و DL متفاوت است. از یک طرف، برای رویکرد ML، بخش کاهش یافته از صحنه آزمایش حاشیه نویسی می شود و در طول مرحله آموزش استفاده می شود، و بخش باقی مانده را برای مرحله پیش بینی باقی می گذارد. از سوی دیگر، برای رویکرد DL، صحنه های مشروح مختلف برای مرحله آموزش استفاده می شود، در حالی که برای آزمایش داده های کاملاً جدیدی به شبکه ها ارائه می شود. جزئیات بیشتر در بخش های فرعی زیر آورده شده است.
۳٫۱٫ معیار برای تقسیم بندی معنایی ابر نقطه ای
صحنههای مورد استفاده برای آزمایشهای زیر بخشی از معیار ArCH [ ۱۷ ]، گروهی از ابرهای نقطهای معماری هستند که توسط چندین دانشگاه و نهادهای تحقیقاتی با هدف اشتراکگذاری و برچسبگذاری تعداد کافی ابر نقطه برای آموزش و آزمایش روشهای هوش مصنوعی جمعآوری شدهاند. .
این معیار نشاندهنده وضعیت فعلی هنر در زمینه ابرهای نقطهای میراث فرهنگی با ۱۵ ابر نقطه از سناریوهای معماری برای آموزش و دو نقطه برای آزمایش است. اگرچه سایر معیارها و مجموعه دادهها برای طبقهبندی ابرهای نقطهای و تقسیمبندی معنایی از قبل وجود دارد [ ۳۲ ، ۳۳ ، ۳۴ ، ۳۵ ]، مجموعه داده ArCH تنها مجموعهای است که به طور خاص بر روی دامنه CH متمرکز شده و سطح جزئیات بالاتری دارد، بنابراین مورد بررسی قرار گرفته است. برای تست های ارائه شده در اینجا انتخاب شده است.
برای آزمایشات ما، از سه صحنه آزمایشی استفاده شده است ( جدول ۱ ): (۱) ابر نقطه متقارن کلیسای ترومپون، (۲) کاخ پیلاتو از کوه مقدس وارالو – SMV (ساختمان دو طبقه، غیر متقارن). و نه خطی)، و (iii) رواق کوه مقدس غیفا – SMG (صحنه ای ساده تر و کاملاً خطی). برای رویکرد DL، ابر نقطه متقارن برای ارزیابی اولیه ابرپارامترها استفاده میشود. در حالی که دو صحنه دیگر امکان ارزیابی توانایی تعمیم شبکه های عصبی پیشرفته را با آزمایش آنها بر روی موارد مختلف می دهد: یکی پیچیده، SMV، و دیگری ساده تر، SMG.
۳٫۲٫ طبقهبندیکنندههای یادگیری ماشین برای تقسیمبندی معنایی ابر نقطهای
در طول ده سال گذشته، رویکردهای مختلف یادگیری ماشین در ادبیات برای تقسیمبندی معنایی ابر نقطهای مانند k-نزدیکترین همسایه (kNN) [ ۳۶ ]، ماشین بردار پشتیبانی (SVM) [ ۳۷ ، ۳۸ ]، درخت تصمیم (DT) پیشنهاد شده است. ) [ ۳۹ ، ۴۰ ]، AdaBoost (AB) [ ۴۱ ، ۴۲ ]، Naive Bayes (NB) [ ۴۳ ، ۴۴ ] و Random Forest (RF) [ ۴۵ ]. از جمله، در این مقاله، طبقهبندیکنندههای kNN، NB، DT، و RF در پایتون ۳ پیادهسازی شدهاند که از کتابخانه Python Scikit-learn در دسترس شروع میشود [ ۴۶ ].]، به منظور حل وظایف طبقه بندی چند کلاسه. برای هر مطالعه موردی، چهار طبقهبندیکننده از طریق ویژگیهای منتخب و بخشهای کوچک حاشیهنویسی دستی مجموعه دادهها آموزش داده شدهاند.
با توجه به طبقهبندی کننده kNN، مقدار k بسیار وابسته به داده است، چند آزمایش اولیه با مقادیر افزایشی انجام شده است تا بهترین راهحل مناسب را پیدا کنیم. بهترین نتایج با مقادیر کم بدست آمد ک(ک=۵).
طبقه بندی کننده NB مورد استفاده GaussianNB [ ۴۷ ] است، یک گونه از Naive Bayes که از توزیع نرمال گاوسی پیروی می کند و از داده های پیوسته پشتیبانی می کند.
برای DT، حداکثر عمق های مختلف درخت آزمایش شده است. نتایج تأیید کرد که پارامتر پیشفرض max-depth=None ، که توسط آن گرهها تا زمانی که همه برگها خالص شوند، گسترش مییابند، امکان نتایج با دقت بالاتر را فراهم میکند.
در طبقهبندیکننده RF ابتدا دو پارامتر با در نظر گرفتن بهترین امتیاز F1 محاسبهشده در مجموعه ارزیابی تنظیم شدهاند: تعداد درختهای تصمیمی که باید Ntree تولید شوند و حداکثر عمق درخت Mtry [ ۴۵ ]. نتایج گزارش شده به استفاده از ۱۰۰ درخت با حداکثر عمق = هیچ اشاره دارد.
انتخاب ویژگی ها
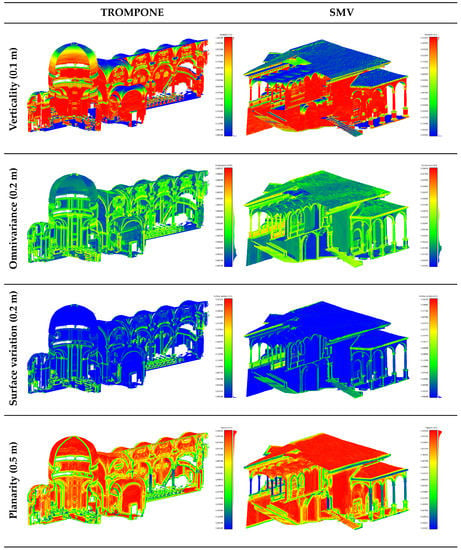
به منظور آموزش مؤثر طبقهبندیکنندههای ML مختلف، ترکیبی از ویژگیهای هندسی سهبعدی، از جمله مبتنی بر نرمال (عمودی)، مبتنی بر ارتفاع (مختصات Z)، و ویژگیهای مبتنی بر مقدار ویژه (همچنین ویژگیهای کوواریانس تعریفشده) استفاده شده است.
ویژگی های کوواریانس [ ۴۸ ] توصیف کننده های شکل هستند که به عنوان ترکیبی از مقادیر ویژه به دست می آیند ( λ۱>λ۲>λ۳) که از ماتریس کوواریانس استخراج می شوند، یک تانسور سه بعدی که توزیع نقطه را در یک محله خاص توصیف می کند. از طریق تجزیه و تحلیل آماری، تجزیه و تحلیل مؤلفه اصلی (PCA)، می توان از این ماتریس سه مقدار ویژه که ساختار سه بعدی محلی را نشان می دهد استخراج کرد. با توجه به Weinmann و همکاران. [ ۴۹ ]، استراتژیهای مختلفی را میتوان برای بازیابی همسایگی محلی برای نقاط متعلق به یک ابر نقطه سه بعدی اعمال کرد. به طور کلی می توان آن را به عنوان یک کره یا یک استوانه با شعاع ثابت محاسبه کرد یا با تعداد kNN توصیف کرد. در این مقاله، با توجه به مطالعات ارائه شده در [ ۲۴ ، ۲۵]، تنها چند ویژگی کوواریانس (Omnivariance، Variation سطح و Planarity) بر روی همسایگیهای کروی در شعاعهای خاص به منظور برجسته کردن مولفههای معماری محاسبه شده است.
همانطور که در شکل ۲ مشاهده می شود، ویژگی های مختلف بر عناصر مختلف تأکید دارند. عمودی بودن تمایز بین سطوح عمودی و افقی را آسان تر می کند و امکان تشخیص دیوارها و ستون ها و همچنین کف، پله ها و طاق ها را فراهم می کند. مسطح بودن ویژگی برای جداسازی ستون ها و عناصر استوانه ای در صورت استخراج در شعاع های نزدیک به ابعاد قطر مفید است. در نهایت، تنوع سطح و همهتغییر، که در یک شعاع کوتاه محاسبه میشود، بر تغییرات در شکلها تأکید میکند که به عنوان مثال، تشخیص قالبها و پنجرهها را تسهیل میکند.
۳٫۳٫ یادگیری عمیق برای تقسیم بندی معنایی ابر نقطه ای
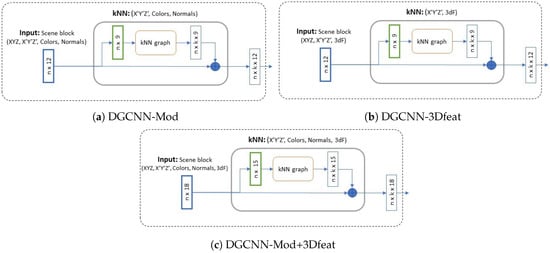
در این مقاله، رویکرد ارائه شده در [ ۱۸ ] اتخاذ شده است، که در آن یک نسخه اصلاح شده از DGCNN، به نام DGCNN-Mod، پیشنهاد شده است. این پیاده سازی شامل چندین پیشرفت در مقایسه با نسخه اصلی است: در لایه ورودی، فاز kNN مختصات نقاط نرمال شده، تبدیل ویژگی های رنگ مانند HSV و بردارهای عادی را در نظر می گیرد. علاوه بر این، عملکرد DGCNN-Mod با دو نسخه جدید این شبکه مقایسه می شود: DGCNN-3Dfeat و DGCNN-Mod+3Dfeat که سایر ویژگی های مهم ذکر شده را در نظر می گیرند. به طور خاص، DGCNN-3Dfeat ویژگی های سه بعدی را به kNN اضافه می کند. در عوض، برای یک مطالعه کامل ابلیشن، DGCNN-Mod+3Dfeat تمام ویژگی های موجود را در بر می گیرد. شکل ۳پیکربندی لایه EdgeConv را با ترکیبات مختلف ویژگی نشان می دهد.
در مقایسه با DGCNN-Mod، دو نوع تکنیک پیش پردازش آزمایش شده است: Scaler1 و Scaler2. Scaler1 ویژگی ها را با حذف میانگین و مقیاس بندی به واریانس واحد استاندارد می کند. نمره استاندارد یک نمونه x به صورت زیر تعیین می شود:
جایی که μمیانگین نمونه های آموزشی و σانحراف معیار نمونه های آموزشی است. در عوض، Scaler2 ویژگیها را با استفاده از آماری که نسبت به موارد پرت قوی هستند، مقیاسبندی میکند. این مرحله پیش پردازش، میانه را حذف می کند و داده ها را با توجه به محدوده چندک (IQR: InterQuartile Range) مقیاس می کند. IQR محدوده بین چارک ۱ (چک ۲۵) و چارک سوم (چرک ۷۵) است. با محاسبه آمار مربوطه بر روی نمونه ها در مجموعه آموزشی، مرکز و مقیاس بندی به طور مستقل در هر ویژگی اتفاق می افتد. سپس محدوده میانی و بین چارکی ذخیره می شود تا در مجموعه آزمایش و اعتبارسنجی استفاده شود. علاوه بر این، شبکه اصلی DGCNN از تلفات آنتروپی متقاطع استفاده می کند. از آنجایی که ما از مجموعه دادههای واقعا نامتعادل استفاده میکنیم، تصمیم میگیریم افت کانونی [ ۵۰ ] را آزمایش کنیم] همچنین. این تابع خاص فقط برای حل مسائل عدم تعادل پیاده سازی شده است.
تمام رویکردهای یادگیری عمیق با استفاده از پایتون ۳ و چارچوب معروف به نام Tensorflow پیاده سازی شده اند. تکنیکهای پیش پردازش روی ویژگیها، یعنی Scaler1 و Scaler2، از طریق کتابخانه Scikit-Learn [ ۴۶ ] که در پایتون نیز پیادهسازی شده است، پیادهسازی شدهاند.
۳٫۴٫ معیارهای ارزیابی عملکرد
در بخش تجربی ( بخش ۴ )، رویکردهای پیشرفته به کار رفته با استفاده از رایجترین معیارهای عملکرد برای تقسیمبندی معنایی مقایسه میشوند. دقت کلی (OA)، همراه با دقت وزنی، یادآوری و امتیاز F1 با توجه به مجموعه تست محاسبه میشود، زیرا اینها شاخصهای عملکرد بسیار خوبی هستند تا بفهمیم آیا رویکردها قادر به تعمیم به روش مناسب هستند یا خیر. لطفاً در نظر بگیرید که OA و Recall مقادیر یکسانی دارند، زیرا معیارها وزن دارند. علاوه بر این، برای هر آزمایش انجام شده، مقایسهای بین کلاسهای مجزای مجموعه آزمایشی نیز انجام میشود: مقادیر دقت، یادآوری، امتیاز F1 و تقاطع بیش از اتحادیه (IoU) برای هر نوع شی محاسبه میشود ( پیوست A را ببینید ) . .
شایان ذکر است که در صحنه هایی که قرار است طبقه بندی شوند، تعداد نقاط بر اساس دو رویکرد متفاوت است. در واقع، با ML تعداد کل نقاط هم در صحنه ورودی و هم در خروجی استفاده می شود، در حالی که با DL، ابر نقطه نادیده نسبت به اصلی، به دلایل محاسباتی زیر نمونه برداری می شود. تعداد نقاط زیرنمونهسازی شده را میتوان بهطور دلخواه تنظیم کرد، بیشترین استفاده برای هر بلوک تجزیهوتحلیلشده ۴۰۹۶ است، اما مقادیر بالاتری را میتوان انتخاب کرد (به عنوان مثال، ۸۱۹۲) با هزینه زمان آموزش. در این مقاله ۴۰۹۶ نقطه در هر بلوک به عنوان پارامتر زیرنمونهبرداری تعیین شده است.
۴٫ نتایج
در این بخش، چندین آزمایش انجام شده با روش های ML و DL ارائه شده قبلی گزارش شده است. آزمایش ارائه شده در بخش ۴٫۱ مربوط به تقسیم بندی صحنه متقارن ترومپون است که از حاشیه نویسی جزئی همان صحنه شروع می شود. در آزمایش دوم و سوم، نمونه های آموزشی بر اساس استراتژی طبقه بندی اتخاذ شده (ML یا DL) تغییر می کنند. با این حال، همان صحنه ها آزمایش می شوند: صحنه SMV برای بخش ۴٫۲ و صحنه SMG برای بخش ۴٫۳ .
۴٫۱٫ آزمایش اول – بخش بندی یک صحنه جزئی مشروح
در این تنظیمات، صحنه ترومپون در ابتدا به دو قسمت تقسیم می شود که یک طرف را برای تمرین و یک طرف متقارن را برای تست انتخاب می کند. سپس، سمت مورد استفاده برای مرحله آموزش بیشتر به مجموعه آموزشی (۸۰٪) و مجموعه اعتبار (۲۰٪) تقسیم می شود. مجموعه اعتبارسنجی برای آزمایش OA در پایان هر دوره آموزشی استفاده می شود در حالی که ارزیابی روی مجموعه آزمایشی انجام می شود. برای این آزمون ۹ کلاس معماری در نظر گرفته شده است. برخلاف آزمایشهای بعدی ( بخش ۴٫۲ و بخش ۴٫۳ )، کلاس “سایر” در طول آموزش مورد استفاده قرار گرفت زیرا میتوان آن را به طور منحصر به فردی با مبلمان کلیسا (عمدتاً نیمکتها و اعترافکنندگان) شناسایی کرد. هیچ نقطه ای از کلاس “سقف” آزمایش نشد، این یک صحنه داخلی است.
DGCNN اصلی از فراپارامترهای استاندارد خود استفاده می کند: مختصات XYZ نرمال شده برای فاز kNN و XYZ + RGB برای فاز یادگیری ویژگی، با ۱×۱اندازه بلوک متر این پارامتر دوم فقط اندازه پایه بلوک را تعیین می کند، زیرا ارتفاع “بی پایان” در نظر گرفته می شود. به این ترتیب می توان کل صحنه را تحلیل کرد و کمترین تعداد بلوک را تعریف کرد. برای سایر رویکردهای مبتنی بر DGCNN، ما از تنظیمات پیش پردازش Scaler1 برای ویژگیها استفاده کردیم، زیرا نتیجه آن بهترین پیکربندی در بین تمام آزمایشهای مختلف انجام شده است. علاوه بر این، برای شبکه DGCNN-Mod+3Dfeat، بهترین نتیجه با استفاده از عملکرد از دست دادن کانونی به دست آمد.
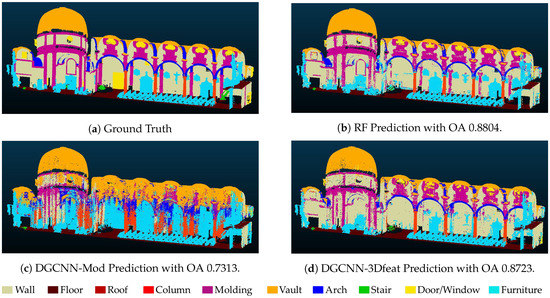
در جدول ۲ ، عملکرد رویکردهای پیشرفته گزارش شده است. همانطور که می بینیم، بهترین بازده از نظر معیارهای دقت از رویکرد RF حاصل می شود. علاوه بر این، روشهای دیگر با دقت بیش از ۰٫۸۰ DT، DGCNN-3Dfeat و DGCNN-Mod+3Dfeat هستند که همگی در استفاده از ویژگیهای سه بعدی مشترک هستند. بنابراین، میتوانیم استنباط کنیم که این نوع ویژگیها امکان بهبود عملکردهای اصلی DGCNN را فراهم میکنند، زیرا آنها بسیار نماینده کلاسهای تحت بررسی هستند.
جدول A1 (به پیوست A مراجعه کنید ) معیارهای دقت (دقت، یادآوری، امتیاز F1 و IoU) را برای هر کلاس از مجموعه آزمایشی ترومپون گزارش میکند. از تجزیه و تحلیل این جدول می توان فهمید که کدام طبقات با رویکردهای مختلف به بهترین وجه تمایز می یابند. در نهایت، شکل ۴ صحنه آزمون مشروح دستی (حقیقت زمین) و نتایج تقسیمبندی خودکار را که با بهترین رویکردها به دست آمدهاند، نشان میدهد. از این نتیجه بصری می توانیم دوباره متوجه مشکلات کلاس Stair (به رنگ سبز) و Window-Door (به رنگ زرد) شویم (به عنوان مثال، در هیچ یک از رویکردها امکان شناسایی درب در مرکز صحنه وجود ندارد) .
۴٫۲٫ آزمایش دوم – بخشبندی یک صحنه نادیده، Sacro Monte Varallo (SMV)
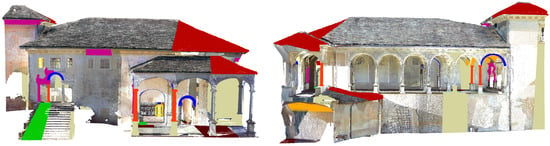
در آزمایش دوم و سوم، همانطور که قبلاً پیش بینی شده بود، نمونه های آموزشی با توجه به استراتژی طبقه بندی اتخاذ شده (ML یا DL) تغییر می کنند. علاوه بر این، بر اساس تجربه [ ۳۰ ]، کلاس “دیگر” از طبقه بندی مستثنی شده است، زیرا اشیاء گنجانده شده بسیار متنوع هستند و NN را گیج می کند. بخشی از صحنه مورد استفاده برای آموزش طبقه بندی کننده های مختلف ML شامل ۲,۵۲۶,۳۹۳اشاره می کند از ۱۶,۲۰۰,۴۴۲نقاط (تقریباً ۱۶٪) ( شکل ۵ )، در حالی که برای NN ها ۱۲ صحنه از مجموعه داده ArCH مطابق آزمایش های قبلی انجام شده در [ ۱۸ ] استفاده شده است.
همان رویکردهای پیشرفته مانند بخش قبل ارزیابی می شود.
در جدول ۳ ، عملکرد کلی برای هر مدل آزمایش شده گزارش شده است، در حالی که جدول A2 (به ضمیمه A مراجعه کنید ) نتایج دقیق را در مورد کلاس های جداگانه صحنه آزمایش گزارش می کند. DGCNN اصلی دوباره با استفاده از فراپارامترهای استاندارد خود آموزش داده شده است. برای سایر رویکردهای مبتنی بر DGCNN، ما بهترین نتایج را با استفاده از:
-
از دست دادن کانونی برای DGCNN-Mod.
-
پیش پردازش Scaler1 برای DGCNN-3Dfeat.
-
از دست دادن کانونی و پیش پردازش Scaler2 برای DGCNN-Mod+3Dfeat.
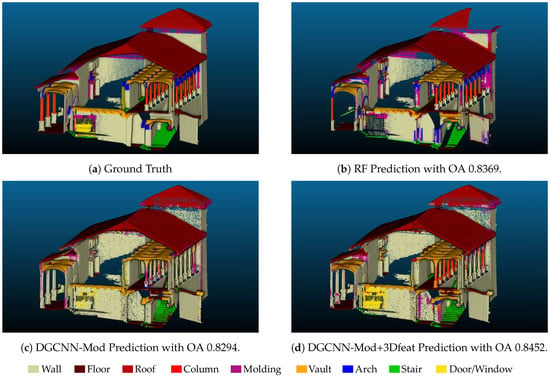
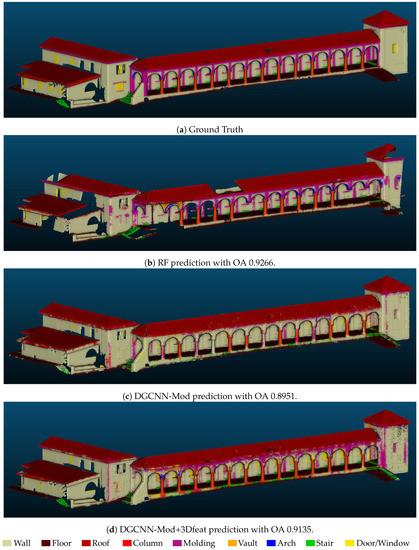
جدول ۳ نشان می دهد که DGCNN-Mod+3Dfeat بهترین رویکرد از نظر OA است که در صحنه آزمایش به ۰٫۸۴۵۲ رسیده است و پس از آن RF با ۰٫۸۳۶۹ قرار دارد. با این حال، با مطالعه نتایج هر کلاس از طریق جدول A2 ، میتوان دریافت که با رویکرد DL، دو کلاس (یعنی Arch و Column) به خوبی شناسایی نشدهاند. برعکس، دومین رویکرد برتر، نتایج بهتری در این کلاسها میگیرد، در حالی که دقت متوسط بالایی را حفظ میکند. شکل ۶ صحنه آزمایش مشروح دستی (حقیقت زمین) و نتایج تقسیم بندی خودکار به دست آمده با بهترین رویکردها را نشان می دهد. می توان متوجه شد که بیشتر کلاس ها به خوبی شناخته شده اند، به جز کلاس Arch در رویکردهای مبتنی بر DGCNN و کلاس Door-Window برای RF.
۴٫۳٫ آزمایش سوم – بخش بندی یک صحنه نادیده، Sacro Monte Ghiffa (SMG)
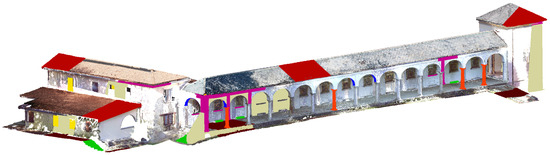
همانطور که در آزمایشهای قبلی، برای رویکردهای ML، حاشیهنویسیهای موقت در امتداد ابر نقطه توزیع شدهاند ( شکل ۷ )، که شامل ۳۵۴۵۹۰۰ نقطه در مجموع ۱۷۷۹۸۰۴۹ نقطه (تقریباً ۲۰ درصد) است.
در جدول ۴ ، عملکرد کلی برای هر مدل آزمایش شده گزارش شده است، در حالی که جدول A3 (به ضمیمه A مراجعه کنید ) نتایج دقیق را در مورد کلاس های جداگانه صحنه آزمایش گزارش می کند. بهترین نتایج با RF و بلافاصله پس از آن شبکه DGCNN-Mod+3Dfeat به دست آمده است. با این حال، در این مورد، با توجه به تقارن بیشتر ابر نقطه، در مقایسه با صحنه SMV، افزایش OA در هنگام استفاده از ویژگی های سه بعدی کمتر است، اما همچنان قابل توجه است. نتایج با آزمون قبلی مطابقت دارند و مشکلسازترین کلاس دوباره Door-Window است، احتمالاً به دلیل عدم تعادل مجموعه دادهها.
در نهایت، شکل ۸ صحنه آزمون مشروح دستی (واقعیت زمین) و نتایج تقسیمبندی خودکار بهدستآمده با بهترین رویکردها را نشان میدهد.
۴٫۴٫ تجزیه و تحلیل نتایج
خلاصه بهترین OA به دست آمده ( شکل ۹ ) نشان می دهد که روش جنگل تصادفی در دو صحنه تقریباً متقارن گیفا و کلیسای ترومپون کمی بهتر است. در این موارد، با حاشیه نویسی دستی، می توان تعدادی نمونه به اندازه کافی نماینده صحنه آزمایش انتخاب کرد و از نتیجه دقیق اطمینان حاصل کرد. از سوی دیگر، به نظر می رسد راه حل های DL در صحنه غیر متقارن بهتر عمل می کنند، بنابراین توانایی تعمیم خوبی را نشان می دهند. به طور کلی، نتایج DL رضایتبخش هستند، زیرا آنها دستیابی به OA مشابه نتایج RF را نشان میدهند، اگرچه مجموعه آموزشی تا حدی محدود است، اگر با سایر موارد موجود در وضعیت هنر مقایسه شود.
شکل ۱۰ امتیاز F1 را نشان می دهد، ترکیبی از دقت و یادآوری، نسبت به کلاس های تک. در این مورد، رویکردهای ML برای برخی از کلاسها مانند Arch، Column، Molding و Floor بهتر از DL عمل میکنند، در حالی که DL نتایج بهتری در تقسیمبندی Door-Window و Roof میدهد. کلاسهای باقیمانده Vault، Wall و Stair به طور مساوی بین نتایج دو تکنیک، با طاقها و دیوارهای متمایل به RF و پلهها به DGCNN-Mod+3Dfeat متعادل میشوند.
۵٫ بحث و گفتگو
در پاسخ به سوال اول تحقیق (RQ1)، می توان گفت که امروزه می توان بهترین شیوه ها را برای تقسیم بندی معنایی ابرهای نقطه در حوزه CH ارائه کرد. در واقع، آزمایشهای انجامشده و نتایج توصیفشده در بالا نشان میدهد که معرفی ویژگیهای سه بعدی منجر به افزایش OA در مقایسه با استفاده ساده از اجزای رادیومتری و نرمالها شده است. این افزایش در تستهای صحنه متقارن (کلیسای ترومپون) حدود ۱۰% است، در حالی که در تستهایی که با صحنههای مختلف به عنوان تمرین و SMV یا SMG به عنوان تست اجرا میشوند، کمتر (تقریباً ۲%) است. با این حال، در مورد دوم، معرفی ویژگیهای سهبعدی، مرتبط با استفاده از ویژگیهای عادی و RGB، تشخیص کلاسهای با امتیاز کمتر را بهبود بخشیده است و قبلاً با معیارهای پایینتری (به عنوان مثال ستون، در-پنجره و پله). همانطور که ممکن است درجدول A1 ، جدول A2 و جدول A3 ، برای همه رویکردها، بدترین کلاسهای شناختهشده عبارتند از Arch، Door-Window و در عوض، Molding یا Stair. این نتیجه احتمالاً به دلیل این واقعیت است که این کلاسها با کمترین تعداد امتیاز در صحنهها هستند.
نتیجهگیری مشابهی را میتوان برای معرفی از دست دادن کانونی انجام داد، که با همان پیکربندی فراپارامترها، منجر به افزایش عملکرد برای کلاسهای قالبگیری، در-پنجره و پله شده است.
با توجه به RQ2، نتایج آزمایش نشان میدهد که RF از دیگر طبقهبندیکنندههای ML بهتر عمل میکند. در عین حال، بهترین نتایج DL با ترکیب تمام ویژگی های انتخاب شده، بدون افزایش زمان محاسباتی به دست آمده است. آزمایشهای قبلی، که در اینجا ارائه نشده بودند، نشان دادند که آنچه در واقع بر این جنبه دوم تأثیر میگذارد، اندازه بلوک و تعداد نقاط زیر نمونه است.
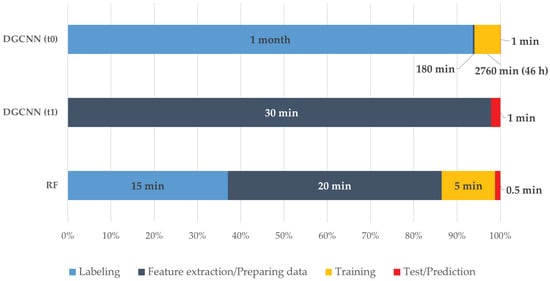
در مورد RQ3، همانطور که در بخش نتایج توضیح داده شد، نویسندگان فکر می کنند که هنوز هیچ راه حل برنده ای بین رویکردهای ML و DL وجود ندارد. OA بهترین روش ML و روش DL کمی متفاوت است. با این حال، اگر طبقات به صورت جداگانه تجزیه و تحلیل شوند، نتایج متضاد برجسته می شوند، جایی که رویکردها می توانند با توجه به نیازها انتخاب شوند. هر دو تکنیک دارای نقاط قوت و ضعف هستند. در مورد ML، سفارشیسازی مجموعه آموزشی با توجه به صحنهای که باید پیشبینی شود وجود دارد، که در حوزه CH بسیار مفید است، در حالی که برای DL امکان قطع کردن حاشیهنویسی دستی، خودکارسازی بیشتر فرآیند وجود دارد. عنصر دیگری که هنگام مقایسه رویکردهای یادگیری ماشینی و عمیق باید در نظر گرفته شود، زمان پردازش است. اگر خط لوله ML به خوبی تعریف شده باشد، در چارچوب DL، لازم است بین دو سناریو ممکن که از نظر زمانی تفاوت قابل توجهی دارند، تمایز قائل شد. در سناریوی اول، زمانی که یک مجموعه آموزشی مشروح در دسترس نیست، لازم است تا حد ممکن صحنهها را به صورت دستی برچسبگذاری کنید (یک کار بسیار زمانبر)، دادهها را از قبل پردازش کنید (مانند نمونهبرداری فرعی، محاسبه نرمال، تمرکز بر روی ۰,۰,۰ امتیاز، ایجاد بلوک و غیره)، سپس از چند ساعت تا چند روز منتظر مرحله آموزش باشید. در سناریوی دوم، میتوان از وزنهای ذخیرهشده شبکهای که از قبل بر روی یک بنچمارک منتشر شده (در این مورد ArCH) آموزش داده شده بود، شروع کرد و بدون هیچ گونه حاشیهنویسی دستی، مستقیماً به تهیه و آزمایش صحنه جدید پرداخت. فاز. بنابراین، بسته به اینکه آیا فرد RF را با سناریوی اول یا دوم مقایسه میکند، سوزن تعادل میتواند به نفع یکی از تکنیکهای دیگر خم شود. که در هنگامی که یک مجموعه آموزشی مشروح در دسترس نیست، لازم است تا حد ممکن صحنهها را بهصورت دستی برچسبگذاری کنید (یک کار بسیار وقتگیر)، دادهها را از قبل پردازش کنید (مانند نمونهگیری فرعی، محاسبه نرمال، تمرکز بر روی ۰،۰،۰). نقطه، ایجاد بلوک و غیره)، سپس برای مرحله آموزش از چند ساعت تا چند روز صبر کنید. در سناریوی دوم، میتوان از وزنهای ذخیرهشده شبکهای که از قبل بر روی یک بنچمارک منتشر شده (در این مورد ArCH) آموزش داده شده بود، شروع کرد و بدون هیچ گونه حاشیهنویسی دستی، مستقیماً به تهیه و آزمایش صحنه جدید پرداخت. فاز. بنابراین، بسته به اینکه آیا فرد RF را با سناریوی اول یا دوم مقایسه میکند، سوزن تعادل میتواند به نفع یکی از تکنیکهای دیگر خم شود. که در هنگامی که یک مجموعه آموزشی مشروح در دسترس نیست، لازم است تا حد ممکن صحنهها را بهصورت دستی برچسبگذاری کنید (یک کار بسیار وقتگیر)، دادهها را از قبل پردازش کنید (مانند نمونهگیری فرعی، محاسبه نرمال، تمرکز بر روی ۰،۰،۰). نقطه، ایجاد بلوک و غیره)، سپس برای مرحله آموزش از چند ساعت تا چند روز صبر کنید. در سناریوی دوم، میتوان از وزنهای ذخیرهشده شبکهای که از قبل بر روی یک بنچمارک منتشر شده (در این مورد ArCH) آموزش داده شده بود، شروع کرد و بدون هیچ گونه حاشیهنویسی دستی، مستقیماً به تهیه و آزمایش صحنه جدید پرداخت. فاز. بنابراین، بسته به اینکه آیا فرد RF را با سناریوی اول یا دوم مقایسه میکند، سوزن تعادل میتواند به نفع یکی از تکنیکهای دیگر خم شود. که در g.، نمونه برداری فرعی، محاسبه نرمال، تمرکز بر نقطه ۰،۰،۰، ایجاد بلوک، و غیره)، سپس برای مرحله آموزش از چند ساعت تا چند روز صبر کنید. در سناریوی دوم، میتوان از وزنهای ذخیرهشده شبکهای که از قبل بر روی یک بنچمارک منتشر شده (در این مورد ArCH) آموزش داده شده بود، شروع کرد و بدون هیچ گونه حاشیهنویسی دستی، مستقیماً به تهیه و آزمایش صحنه جدید پرداخت. فاز. بنابراین، بسته به اینکه آیا فرد RF را با سناریوی اول یا دوم مقایسه میکند، سوزن تعادل میتواند به نفع یکی از تکنیکهای دیگر خم شود. که در g.، نمونه برداری فرعی، محاسبه نرمال، تمرکز بر نقطه ۰،۰،۰، ایجاد بلوک، و غیره)، سپس برای مرحله آموزش از چند ساعت تا چند روز صبر کنید. در سناریوی دوم، میتوان از وزنهای ذخیرهشده شبکهای که از قبل بر روی یک بنچمارک منتشر شده (در این مورد ArCH) آموزش داده شده بود، شروع کرد و بدون هیچ گونه حاشیهنویسی دستی، مستقیماً به تهیه و آزمایش صحنه جدید پرداخت. فاز. بنابراین، بسته به اینکه آیا فرد RF را با سناریوی اول یا دوم مقایسه میکند، سوزن تعادل میتواند به نفع یکی از تکنیکهای دیگر خم شود. که در میتوان از وزنهای ذخیرهشده شبکهای که از قبل بر روی یک بنچمارک منتشر شده (در این مورد ArCH) آموزش داده شده بود، شروع کرد و مستقیماً بدون هیچ مرحله حاشیهنویسی دستی به آمادهسازی و آزمایش صحنه جدید پرداخت. بنابراین، بسته به اینکه آیا فرد RF را با سناریوی اول یا دوم مقایسه میکند، سوزن تعادل میتواند به نفع یکی از تکنیکهای دیگر خم شود. که در میتوان از وزنهای ذخیرهشده شبکهای که از قبل بر روی یک بنچمارک منتشر شده (در این مورد ArCH) آموزش داده شده بود، شروع کرد و مستقیماً بدون هیچ مرحله حاشیهنویسی دستی به آمادهسازی و آزمایش صحنه جدید پرداخت. بنابراین، بسته به اینکه آیا فرد RF را با سناریوی اول یا دوم مقایسه میکند، سوزن تعادل میتواند به نفع یکی از تکنیکهای دیگر خم شود. که دردر شکل ۱۱ ، مقایسه ای بین زمان های مورد نیاز برای آزمایش های انجام شده در این مقاله نشان داده شده است. باید در نظر داشت که تستهای ML روی انویدیا GTX 1050 TI 8 گیگابایت، ۳۲ گیگابایت رم، پردازنده Intel(R) Xeon(R) CPU E5-1650 0 @ 3.20 گیگاهرتز اجرا شدند، در حالی که برای DL یک Nvidia RTX 2080 TI 11 گیگابایت، ۱۲۸ گیگابایت رم، پردازنده Intel(R) Xeon(R) Silver 4214 CPU @ 2.20 GHz استفاده شد.
در نهایت، در مورد RQ4، منصفانه است که بیان کنیم که اشکال اصلی در مقایسه بین الگوریتمهای مختلف، شباهت محدود خط لوله آنها است. در واقع، یک مقایسه مناسب بین الگوریتمها لزوماً به ورودی و/یا خروجی یکسانی نیاز دارد. با توجه به ورودی، با توجه به ماهیت متفاوت الگوریتمها، این به معنای ارائه مقدار زیادی از دادههای حاشیهنویسی به طبقهبندیکنندههای ML است که عملکرد آن را به خطر میاندازد، یا بالعکس، شبکه عصبی را با دادههای کمی در مقایسه با دادههای مورد نیاز آموزش میدهد. به همین دلیل، به منظور تجزیه و تحلیل بهترین رویکردهای طبقه بندی برای سناریوهای میراث، ما ترجیح دادیم از صحنه های آموزشی مختلف برای ورودی ML و DL استفاده کنیم. در مورد خروجی، برای رویکرد DL باید یک درونیابی با صحنه اولیه برای مقایسه با همان تعداد نقاط انجام شود که منجر به کاهش احتمالی OA می شود. با این حال، از آنجایی که عملیات نمونهبرداری فرعی عمدتاً به دلایل محاسباتی است که در آینده نزدیک با ماشینهای عملکرد بیشتر و بیشتر به راحتی حل میشود، مطمئناً سودمندی درونیابی کاهش مییابد و حتی بیمعنی میشود. علاوه بر این، استفاده از الگوریتمهای درون یابی مختلف، عنصر خطای بیشتری را معرفی میکند که خط لوله را کمتر عینی و قابل تکرار میکند.
۶٫ نتیجه گیری و کارهای آینده
این مطالعه به بررسی بخش بندی معنایی ابرهای نقطه سه بعدی پیچیده در حوزه CH پرداخت. برای انجام این کار، تکنیکهای ML و تکنیکهای DL با بهرهبرداری از مجموعه دادههای معیار جدید و قبلاً ناشناخته مقایسه شدهاند.
هر دو الگوریتم ML و DL با داشتن پتانسیل بالایی برای طبقه بندی مجموعه داده های جمع آوری شده با تکنیک های مختلف Geomatics (به عنوان مثال، LiDAR و داده های فتوگرامتری) ارزشمند هستند. هنگام مقایسه عملکرد هر دو رویکرد، به نظر می رسد که راه حل برنده ای وجود ندارد، طبقه بندی کننده ها عملکرد کلی مشابهی داشتند و هیچ یک از آنها بهتر از یکدیگر عمل نکردند. حتی با در نظر گرفتن کلاسهای منفرد مورد مطالعه برای آزمایشها، مشخص میشود که رویکردهای مختلف بسته به کلاس مورد تجزیه و تحلیل بهتر هستند، اما هیچ یک از روشها به نتیجهای نرسیدند که به طور کلی از همه کلاسها بهتر عمل کرد.
به طور کلی، زمان آموزش تکنیک های کلاسیک ML می تواند تا یک مرتبه کوچکتر باشد. در مقابل، با در نظر گرفتن کل مجموعه داده های معیار، می توان یک بهبود کوچک اما قابل توجه در عملکرد را برای تکنیک های DL نسبت به تکنیک های کلاسیک ML مشاهده کرد ( جدول A4). در ML، بهینه سازی یا تنظیم هایپرپارامتر مسئله انتخاب مجموعه ای از فراپارامترهای بهینه برای یک الگوریتم یادگیری است. از ارزش آن برای کنترل فرآیند یادگیری استفاده می شود. در عوض، تکنیکهای DL این مزیت را دارند که اجازه میدهند آزمایشهای بیشتری را با تنظیم مدل انجام دهند. بنابراین استفاده از تکنیکهای DL روی مجموعه دادههایی با این اندازه و برای این نوع مشکل، بهویژه در کاربردهای حیاتی عملکرد، نویدبخش است. از طرف دیگر، مدل DL تا حد زیادی تحت تأثیر فرآیندهای تنظیم پارامترهای ساختاری در هزینه محاسباتی و زمان عملیاتی است. با این حال، با توجه به اینکه موجودیهای پیشرفته در مقیاس بزرگ به سمت طبقهبندیهای مبتنی بر یادگیری عمیق حرکت میکنند، میتوان انتظار داشت که در آینده آینده دسترسی رو به رشد مجموعه داده آموزشی بر چنین محدودیتی غلبه کند. مهندسی ویژگی و استخراج ویژگی بخشهای کلیدی و زمانبر جریان کار ML هستند، زیرا این مراحل دادههای آموزشی را تغییر میدهند و آنها را با ویژگیهای اضافی تقویت میکنند تا الگوریتمهای ML مؤثرتر شوند. DL این فرآیند را تغییر داده است و شبکههای عصبی عمیق به عنوان استراتژیهای مدلسازی جعبه سیاه مورد بررسی قرار گرفتهاند.
میراث نهایی این کار، که با هدف گشودن یک بحث مثبت در میان کارشناسان مختلف حوزه درگیر انجام شد، در جدول ۵ خلاصه شده است ، جایی که جوانب مثبت و منفی هر دو روش ML/DL خلاصه شده است.