۱٫ مقدمه
COVID-19 یک بیماری عفونی است که توسط ویروس کرونای تازه کشف شده SARS-CoV-2 ایجاد می شود. این ویروس برای اولین بار در ووهان چین کشف شد و به سرعت در سراسر جهان گسترش یافت و جمعیت بسیاری از کشورها را آلوده کرد. گسترش COVID-19 ذاتاً یک فرآیند فضایی است. بنابراین، تلاش برای مبارزه با گسترش آن از مدل سازی تعاملات فضایی سود می برد. این مقاله مطالعه قبلی را با استفاده از مدلهای گرانشی برای مدلسازی توسعه فضایی همهگیری COVID-19 در لهستان گسترش میدهد [ ۱ ]]. مطالعه حاضر روش پارامترسازی مدلهای اپیدمیولوژیک، و توسعه مدلهای تعامل فضایی برای شبیهسازی توسعه همهگیری و تعیین توزیع مکانی (و زمانی) تعداد موارد در لهستان را توصیف میکند. داده های مرجع در مورد تعداد موارد در پوویات های فردی (منطقه های اداری در سطح شهرستان) ارائه شده توسط ایستگاه های بهداشتی و اپیدمیولوژیکی، قابلیت اطمینان پیش بینی را تأیید کرده است. با این حال، پیچیدگی عوامل مؤثر بر انتشار SARS-CoV-2 یک چالش است، زیرا درک روابط بین متغیرهای فردی و نتایج اندازهگیری شده بسیار دشوار است. با وجود شباهت به بیماری های ویروسی تنفسی گذشته مانند سارس و مرس و همچنین آنفولانزای فصلی سالانه،۲ ، ۳ ]. همچنین باید توجه داشت که ترافیک بینالمللی و گردشگری در مقایسه با بیماریهای ویروسی ذکر شده در بالا، شیوع این بیماری را در سطح جهانی به شدت افزایش داده است. عفونت نسبتاً بالا و دوره نهفتگی طولانی و دوره ریزش طولانی ویروس به تعداد زیادی از انتقال کمک کرده است که بسیاری از آنها از طریق تماس انسان به انسان با افرادی که هیچ علائمی ندارند یا علائم خفیفی از خود نشان نمی دهند رخ داده است [ ۴ ، ۵ ، ۶ ] ]. این ویژگیهای کووید-۱۹، مدلسازی همزمان شیوع آن در مکانهای فضایی مختلف را دشوارتر از محاسبه تعداد موارد در کل کشور میکند.
رویکردهای کلاسیک به مدلسازی ریاضی گسترش بیماریها، از مدل اپیدمی کرماک-مککندریک (بخشی) تا مدلهای شبکه جدیدتر، و همچنین خانواده مدلهای تصادفی [ ۷ ]]، اختلاط در کل جمعیت را بدون در نظر گرفتن تنوع، تنوع و لایهبندی آن فرض میکنیم. از سوی دیگر، ادبیات تحقیق اپیدمی روشها و مدلهای متعددی را در مورد عوارض و جنبههای فضایی بیماریها ارائه میکند. رویکردهای مکرر از اتوماتای سلولی و شبیهسازیهای چندعاملی (مدلسازی مبتنی بر [چند عاملی) استفاده میکنند، که بهطور مناسب ارتباطات مستقیم بین افراد را منعکس میکند. با این حال، این رویکردها شامل مدلسازی هر فرد است و با بار محاسباتی محدود میشوند. واضح است که تمرکز بر روی زیرجمعیتهای توزیعشده فضایی ممکن است امکان مدلسازی دقیقتری را نسبت به مدلهای اختلاط کامل فراهم کند، در حالی که بار محاسباتی کمتری را نسبت به مدلهای چندعاملی متحمل میشود.
ویلسون [ ۸ ] در ابتدا گروهی از مدلهای تعامل فضایی را در زمینه سیستمهای شهری و منطقهای فرموله کرد، اما مناسب بودن آنها را به عنوان مدلهای اپیدمی در سیستمهای فضایی پیچیده با تعاملات متقابل ثابت کرد [ ۹ ]. خانواده مدلهای جاذبه نیز در اپیدمیولوژی بیماریهای عفونی مورد استفاده قرار گرفتند [ ۱۰ ، ۱۱ ، ۱۲ ].
در حالی که مدل گرانش به یک جفت نقطه مربوط می شود، استوارت [ ۱۳ ] مفهوم پتانسیل را معرفی کرد که تأثیر همه نقاط دیگر را بر یک نقطه خاص در بر می گیرد [ ۱۴ ]. پتانسیل معیاری از تأثیر اندازه جمعیت است که در جای دیگر مقاله به عنوان جرم m که در نقطه ای (مثلاً در وسط یک شهر/منطقه خاص) در فاصله d از این نقطه قرار دارد، نامیده می شود. مفهوم پتانسیل جمعیت به عنوان معیاری برای تعداد تماس بین افراد [ ۱۵ ]، به علاوه با در نظر گرفتن «قانون اول جغرافیا» [ ۱۶ ] استفاده شد. این رویکرد همچنین برای مدلسازی بیماریهای عفونی و اپیدمیها استفاده میشود [ ۱۷]. ویلسون [ ۹ ] مفهوم احتمال چنین تماس هایی را با در نظر گرفتن بعد فضایی (فاصله یا اندازه گیری عملکردی آن، به عنوان مثال، زمان) به مدل سازی تعامل فضایی معرفی کرد. این رویکرد همچنین از معیار آنتروپی استفاده می کند که برای ارزیابی کیفیت برازش مدل استفاده می شود. در ادبیات اخیر، چندین مدل مکانی-زمانی برای COVID-19 پیشنهاد شده است. در بسیاری از آنها [ ۱۸ ، ۱۹ ، ۲۰ ]، تعاملات بین کشورها به حرکت افراد بین مکان ها مرتبط است. این منجر به عدم تقارن می شود که نمی توان مستقیماً با فاصله فیزیکی بین دو مکان توضیح داد. یکی از این رویکردهای موفق برای مدلسازی COVID-19 مدل SIDARTHE [ ۲۱ ] بوده است.
مدلهای فضایی جهانی، ملی و منطقهای جهانی همهگیری با هدف شناسایی و پایش الگوها و روندهای مکانی و زمانی و همچنین دستیابی به درک بهتری از رابطه بین متغیرهای بالقوه مختلف (محیطزیست، اجتماعی-اقتصادی، جمعیتی و غیره) بوده است. ، از جمله اهداف دیگر. سیستم های اطلاعات جغرافیایی (GIS) نقش محوری در درک خوشه بندی فضایی، روند انتقال، و نقشه برداری از گسترش بیماری های عفونی ایفا می کنند. تکنیک های مختلف GIS برای تصمیم گیری توسط مقامات در طول همه گیری COVID-19 اساسی بوده است. آنها همچنین ممکن است به طور قابل توجهی به امنیت سازمانی در دوره پس از همه گیری کمک کنند.۲۲ ، ۲۳ ، ۲۴ ، ۲۵ ، ۲۶ ، ۲۷ ].
علیرغم شباهتها با سایر شیوع ویروسهای تنفسی، COVID-19 از نظر مقیاس جهانی و نرخ بالای عفونت آن متمایز است. مقایسه بین شیوع سارس در سال ۲۰۰۳ در چین، ناشی از یک کروناویروس مشابه، و COVID-19، نشان داد که COVID-19 بسیار قابل انتقال است و تنها در ۳۰ روز از یک شهر به کل کشور سرایت می کند [ ۲۸ ]. تصور میشود که دلایل این تفاوت چندگانه است و ممکن است شامل عوامل اجتماعی و جمعیتی، استراتژیهای مهار دولت محلی و تفاوت در پویایی انتقال بین این دو کروناویروس باشد [ ۲۹ ].]. تلاش های زیادی برای ساخت مدل های رگرسیون چند متغیره برای توضیح تعداد موارد در هر شهرستان در مطالعات در حال انجام شده است. تراکم جمعیت، تراکم شبکه راه ها، ساختمان های صنعتی و مسکونی از جمله متغیرهای مستقل مورد مطالعه در این مدل ها بوده اند. به طور معمول، سه گروه از عوامل خطر که حجم، شدت و پراکندگی فضایی بیماریها را شکل میدهند، هنگام ایجاد مدلها در نظر گرفته میشوند: ریسک فردی، ریسک محیط طبیعی (اقلیمی)، و ریسک اجتماعی و جمعیتی. با این حال، شواهد قانعکنندهای در مورد ترتیب رتبهبندی این که کدام عوامل مهمتر هستند، وجود ندارد.
هدف از این مطالعه ساخت مدلی از انتشار جغرافیایی COVID-19 در لهستان بر اساس مدلهای تعامل فضایی بود. ما این فرضیه تحقیق را مطرح میکنیم که با فرض یک متغیر مستقل: توده جمعیت در واحدهای اداری، میتوان به یک مدل با کیفیت خوب دست یافت. این رویکرد امکان هم افزایی بین مدلها را فراهم میکند و پیشبینی زمانی شمارش موارد (به عنوان مثال، مدل اپیدمیولوژیک کلاسیک SIR) و مدلهای تعاملات فضایی را ممکن میسازد. کاربرد ترکیبی این رویکردها پیشبینی قابل اعتمادی از تعداد افراد آلوده در بخشهای اداری را ممکن میسازد. مدل ما به عنوان یک ابزار حمایتی در نظر گرفته شده است که شامل یک گسترش جغرافیایی برای مفهوم سازی گسترش بیماری است. این می تواند به عنوان یک ابزار پیشینی برای تخمین مکان های فضایی شیوع عفونت، و همچنین راهی برای ارزیابی نرخ عفونت در آینده استفاده شود. مزیت مهم مدل ساخته شده جنبه فضایی آن است. به عنوان مثال، ارزیابی تمایز فضایی بالقوه تعداد افراد آلوده را در مجموعه واحدهای فضایی مشاهده شده (به عنوان مثال، شهرستانها در لهستان)، که به ویژه در مورد COVID-19 و بیماریهای مشابه مهم است، ممکن میسازد.
این رویکرد بینشهای مفیدی را برای شبیهسازی شبکههای فضایی به روشی انعطافپذیر فراهم میکند و بار شبیهسازیها و پیشبینیهای فردی را برای هر مشاهده در سطح فردی کاهش میدهد. در حالی که نشاندهنده سادهسازی گسترش فضایی آلودگی همهگیری است، با این وجود امکان گسترش به مدلهای فراجمعیت و شبیهسازیهای عددی فضایی همهگیریها در شبکههای پیچیده را فراهم میکند [ ۳۰ ، ۳۱ ]. به این ترتیب مدل ها می توانند شامل فاصله ها باشند. همه انواع مدلهای ریاضی از قبل موجود را میتوان برای حل، به حداکثر رساندن یا برآورد با استفاده از رویکرد تحلیل فضایی اتخاذ شده گسترش داد و عدم قطعیت دادههای تجربی را کاهش داد [ ۳۲ ].
۲٫ روش ها
۲٫۱٫ مدل های SIR و SIR-F
مدلهای اپیدمی حساس محفظه قطعی-عفونی-بازیابی شده [ ۳۳ ] مبتنی بر انتقال ویروسی (در این مورد SARS-CoV-2) در یک جمعیت ( N ) از ابتدای قرن بیستم مورد استفاده قرار گرفتهاند و با استفاده از آن توصیف شدهاند. مجموعه ای از معادلات ODE (دیفرانسیل معمولی):
که در آن S ، I و R به ترتیب تعداد افراد مستعد، آلوده و بهبودیافته هستند. N اندازه جمعیت است. نرخ تماس گرفتن «فرکانس تعامل»، نرخ جریان از حساس به آلوده است. نرخ بهبودی، نرخ جریان از آلوده به بهبودیافته یا مرده است. و t نشان دهنده زمان است [ ۳۴ ]. چندین مدل از مدل های پایه SIR مشتق شده است. در این مقاله، ما مدل SIR-F را اعمال میکنیم که جمعیت R (بازیابی شده) را به زیرجمعیتهای بازیابی شده و شکستخورده (درگذشته) تقسیم میکند.
۲٫۲٫ مدل جاذبه
فرمول کلی گرانش جمعیت بین دو نقطه معین به صورت T ij = f (O i ,D j , d ij ) توصیف می شود که در آن T ij حجم برهمکنش ها (تماس ها) است، O i جریانی است که از مبدأ i سرچشمه می گیرد . و نشان دهنده ضریب فشار (به عنوان مثال، گسیل)، Dj جریانی است که به نقطه مقصد j ختم می شود و عامل کشش را نشان می دهد (مثلاً جاذبه)، و d ij فاصله بین i و j است.نشان دهنده جدایی فضایی (به عنوان مثال، فاصله اقلیدسی یا جاده، زمان یا تابع هزینه). با توجه به یک شهرستان، مجموع حجمهای گرانشی منفرد بر روی تمام ستونها یا ردیفها، به ترتیب پتانسیل جمعیت را برای مبدا یا مقصد نشان میدهد ( جدول ۱ ، O : مبدا تماسها، D : مقصد تماسها).
پارامترهای اضافی، مانند تابع فروپاشی فاصله ( d ij β ، که در آن β توان است) بین مبدا (A) و مقصد (B)، برای بهینهسازی مدلهای گرانشی استفاده میکنند. در نظر گرفتن این پارامترها و چارچوب به حداکثر رساندن آنتروپی به فرد اجازه می دهد تا به فرمول های زیر برسیم که تأثیر متغیرهای مستقل را بر “گسترش” (V) و جذابیت (W) تعریف می کند (معادلات (۳) – (۶) [ ۳۵ ]):
فرمول باید بر اساس ضرایب متقابل حاصل از مفهوم گرانش کالیبره شود. برای هر جفت شهرستان i و j ضریب تعامل I ij را به صورت زیر تعیین کردیم:
در حالی که معادله (۷) معادله گرانشی معمولی است با فرض اینکه دو شهرستان در فاصله d ij قرار دارند ، در رابطه (۸)، ما فرض کردیم که ضریب فعل و انفعال I ii تعداد ساکنان تقسیم بر مربع شعاع دایره با مساحت برابر با مساحت شهرستان.
آمار برازش مدل تعامل فضایی از جایگزینی ضریب تعیین (شبه R2 ) بر اساس تابع احتمال و همتای آن و یک ضریب تعیین تعدیل شده (شبه R2 تعدیل شده ) استفاده می کند که می تواند به طور مشابه تفسیر شود – یک مقدار حداکثر نزدیک به ۱ نشان دهنده تناسب بهتر مدل است [ ۳۶ ]. پیچیدگی مدل با استفاده از معیار اطلاعات Akaike [ ۳۷ ] (AIC)، که برای نظریه اطلاعات مشتق شده است، ارزیابی میشود. مقادیر پایین تر AIC نشان دهنده تناسب بهتر مدل به عنوان ارزیابی حجم اطلاعات از دست رفته است [ ۳۷]. پارامتر آماری مورد استفاده معمولاً خطای ریشه میانگین مربع استاندارد شده (SRMSE) حجم مشاهده شده و شبیه سازی شده برهمکنش ها (در این مورد، عفونت ها) است. مقدار بالاتر SRMSE نشان دهنده کاهش ارزیابی مدل است (شروع از صفر به عنوان بهترین تناسب). کتابخانه SpInt از شاخص شباهت سورنسن (SSI) به روشی مشابه SRMSE استفاده می کند. مقادیر SSI می توانند به حداکثر یک برسند که نشان دهنده تناسب کامل مدل است، در حالی که مقادیر نزدیک به صفر بدترین هستند [ ۳۵ ].
برای خودکارسازی فرآیند محاسبات، یک اسکریپت پایتون نویسندگی ایجاد شد که تمام محاسبات را برای ۳۸۰ شهرستان در لهستان انجام میداد.
کتابخانه منبع باز PySal SpInt Python [ ۳۸ ] و داده های رسمی ثبت شده COVID-19 در چارچوب رویکرد پیشنهادی برای ردیابی همه گیری COVID-19 در سطح شهرستان در لهستان استفاده شد [ ۳۹ ].
عملیاتیسازی هرگونه تفکیک مکانی و زمانی و همچنین طبقهبندی جمعیتی را امکان پذیر میسازد.
۲٫۳٫ روش شناسی پذیرفته شده
مدلهای اپیدمی کلاسیک، مانند SIR، SIR-F، و SEIR، پیشبینی قابل اعتماد تعداد افراد مستعد، افراد آلوده و افراد بهبودیافته را در بازههای زمانی خاص و پارامترهای مدل از پیش تعیینشده امکانپذیر میسازند (پارامتر کلیدی نرخ پایه تولید مثل است. ). با این حال، مفروضات و محدودیت های مدل های اپیدمی نوع SIR به خوبی شناخته شده است [ ۷ ]. در حالی که آنها تخمین قابل اعتماد تغییرات زمانی را امکان پذیر می کنند، مدل های نوع SIR امکان تجزیه و تحلیل توزیع فضایی تعداد موارد، مرگ و میر یا موارد شدید را نمی دهند.
شیوع بیماری همه گیر COVID-19 را می توان با استفاده از روش های انتشار فضایی و همچنین مدل های بالقوه (مدل سازی تعامل فضایی) و تجسم با استفاده از نرم افزار سیستم های اطلاعات جغرافیایی، به دلیل ویژگی های آماری زیر مورد تجزیه و تحلیل قرار داد: جمعیت، مدل های فراجمعیت، فواصل مکانی. ، و تعاملات (تماس ها) [ ۴۰ ، ۴۱ ، ۴۲ ]. مخترع مدل سازی تعامل فضایی (A. Wilson) نیز به عنوان متغیرهای مستقل، احتمال تماس ها و بعد فضایی (فاصله یا اندازه گیری عملکردی آن) را معرفی کرد [ ۴۳ ].
مدل برهمکنش فضایی که ما اعمال می کنیم ممکن است به عنوان قیاسی با نظریه برهمکنش گرانشی نیوتن در نظر گرفته شود. در رویکرد «گرانشی»، دو واحد اداری بهطور مستقیم، متناسب با حاصلضرب «تودهها» و به طور معکوس با مجذور «فاصلهها» با هم تعامل دارند. با این حال، مفاهیم “توده” و “فاصله” انتزاعی هستند و نیاز به توضیح در زمینه مدل های همه گیر دارند. به طور کلی، فاصله را می توان به عنوان مسافت جاده یا فاصله زمانی تعبیر کرد که روش های مختلف حمل و نقل (اتومبیل، اتوبوس، قطار) و کیفیت های مختلف جاده یا محدودیت سرعت در جاده ها یا مسیرها را در نظر می گیرد. برای هدف این کار، ما فرض میکنیم که «فاصله» بین شهرستانها با طول قسمتی که مرکز ثقل (مرکز ثقل) شهرستانها در لهستان را به هم متصل میکند، تعریف میشود. به همین ترتیب، راه های زیادی برای تفسیر مفهوم “انبوه” واحدهای اداری فردی وجود دارد. ما چندین معیار از «انبوه» را آزمایش کردیم، از جمله تراکم جمعیت، اندازه نسبی جمعیت، و جذابیت اقتصادی که به عنوان تعداد مشاغل یا بودجه واحدهای اداری منفرد بیان میشود. با این حال، آشکار شده است که حجم جمعیت یک شهرستان، متغیری است که منجر به بالاترین ضریب تعیین کیفیت مدل کل نگر میشود و توزیع مکانی-زمانی تعداد موارد COVID-19 را در شهرستانها توضیح میدهد. و جذابیت اقتصادی به صورت تعداد مشاغل یا بودجه واحدهای اداری فردی بیان می شود. با این حال، آشکار شده است که حجم جمعیت یک شهرستان، متغیری است که منجر به بالاترین ضریب تعیین کیفیت مدل کل نگر میشود و توزیع مکانی-زمانی تعداد موارد COVID-19 را در شهرستانها توضیح میدهد. و جذابیت اقتصادی به صورت تعداد مشاغل یا بودجه واحدهای اداری فردی بیان می شود. با این حال، آشکار شده است که حجم جمعیت یک شهرستان، متغیری است که منجر به بالاترین ضریب تعیین کیفیت مدل کل نگر میشود و توزیع مکانی-زمانی تعداد موارد COVID-19 را در شهرستانها توضیح میدهد.
بر اساس مفهوم گرانش، ضریب تعامل هر جفت شهرستان را به عنوان حاصل ضرب تعداد جمعیت آنها بر مجذور فاصله بین آنها تعیین کردیم. داده های مورد استفاده ۳۸۰ شهرستان و جمعیت آنها را بر اساس سالنامه آماری صادر شده توسط آمار لهستان در بر می گیرد که منجر به ۷۲۳۹۰ (ماتریس مثلثی با مورب) فاصله بین مرکز جمعیت های فردی و ضرایب تعامل متناظر می شود. جمع آوری و پردازش اولیه داده ها، از جمله محاسبه ضرایب متقابل، با استفاده از پایتون در محیط ArcGIS پیاده سازی شد.
سپس، مشابه مفهوم جداول اقتضایی در آمار، جدول احتمالات موارد جدید رخ دادن در شهرستان j را به دلیل تعامل با شهرستان i برای عناصر ردیف i و ستون j برآورد کردیم.از جدول به طور کلی، چنین جدولی ناشناخته است و هدف از کالیبراسیون مدل، ایجاد مجدد جدول احتمالی بر اساس آمار موجود است. بسته به داده های تاریخی موجود که برای کالیبراسیون مدل استفاده می شود، دو مورد ممکن را می توان در نظر گرفت: (۱) فقط تعداد کل موارد در کشور موجود است و (۲) تعداد موارد در هر شهرستان مشخص است. این دو مورد به ترتیب با موارد خاصی از مدلهای تعامل فضایی، به اصطلاح مدل جاذبه نامحدود و مدل جاذبه تولید (مقصد) مطابقت دارند. ما هر دو مورد را در کالیبراسیون دو مدل، دوباره بر اساس داده های آماری جمع آوری شده توسط ایستگاه های بهداشتی و اپیدمیولوژیک در ۳۸۰ شهرستان در نظر گرفتیم. ما چارچوب کالیبراسیون SpInt را در کتابخانه PySal پایتون اعمال کردیم.
ابتدا، این فرضیه را تأیید کردیم که اندازه جمعیت در هر شهرستان یک متغیر توضیحی مناسب است. برای این منظور، مدل مقید مقصد را کالیبره کردیم که از داده های دقیق برای هر شهرستان استفاده می کند. از آنجایی که ممکن است چنین داده های دقیقی شناخته نشده باشند، در مرحله بعدی، یک مدل بدون محدودیت را کالیبره کردیم که فقط شامل تعداد تجمعی موارد است.
ما از مدل اپیدمی SIR-F برای پیشبینی سیر اپیدمی در سطح کشور استفاده کردیم. مدل SIR-F بر اساس داده های جمع آوری شده توسط ایستگاه های بهداشتی و اپیدمیولوژیک کالیبره و آزمایش شد و در وب سایت های دولتی منتشر شد [ ۳۰ ]. کالیبراسیون مدلهای SIR-F و تعامل فضایی برای دادهها از هفته یازدهم سال ۲۰۲۰ تا هفته ششم سال ۲۰۲۱ انجام شد. سپس مدلهای بهدستآمده را برای به دست آوردن پیشبینی زمانی و مکانی تعداد افراد مستعد، افراد مبتلا و افراد بهبودیافته در هفتههای ششم و هفتم سال ۲۰۲۱ بهکار بردیم.
۳٫ داده ها، آزمایش ها و نتایج
۳٫۱٫ داده ها
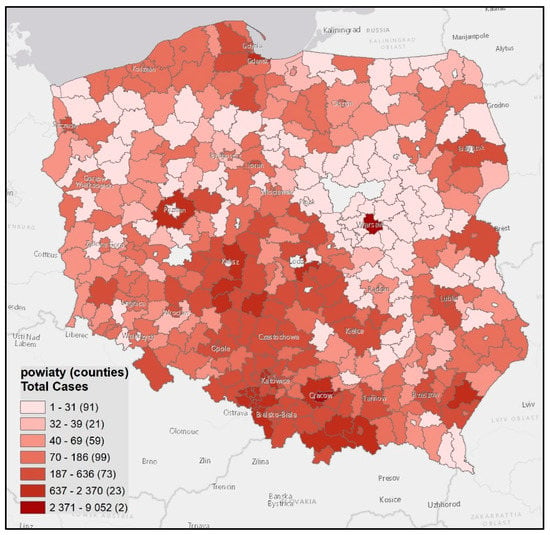
منابع تعداد عفونت های ثبت شده، بهبودیافتگان و مرگ و میرها سه مجموعه داده جمع آوری شده توسط وزارت بهداشت لهستان است. تعداد تجمعی عفونت ها (انباشته شده) بر اساس شهرستان در لهستان از هفته های ۱۱ تا ۴۱ سال ۲۰۲۰ در نمودار و نقشه ها ارائه شده است ( شکل ۱ ، شکل ۲ و شکل ۳ ؛ طبقه بندی نقشه با استفاده از فاصله هندسی).
این ارقام برخی از روندهای فضایی انتشار COVID-19 را در طول زمان مشاهده شده ارائه می دهند. رویدادهای اجتماعی مانند انتخابات ریاست جمهوری، تعطیلات دانش آموزان و کودکان و غیره می توانند به صورت محلی بر میزان آلودگی در شهرستان های مختلف تأثیر بگذارند. علاوه بر این، دوره مطالعه مورد استفاده در این تحقیق با تغییرات عمده در اقدامات مداخله و راهبردهای آزمون مشخص شد. تجزیه و تحلیل داده ها تغییراتی را در تعداد موارد در طول زمان و روندهای مکانی نشان می دهد که نشان دهنده سیاست دولت در ایجاد محدودیت ها و محدودیت ها است. داده هایی که اقدامات دولت را نشان می دهد در وب سایت وزارت بهداشت و توییتر موجود است [ ۴۴ ].
شکل ۳ تغییرات اپیدمی در لهستان را در هفته های ۴۸ تا ۵۲ نشان می دهد (به اصطلاح موج دوم). تمرکز تعداد موارد در شهرهای بزرگ (پایتختهای voivodeships و powiats) قابل مشاهده است. بنابراین، تمایز فضایی توسعه همهگیری COVID-19 در لهستان مشهود است.
شکل ۲ زمان شروع (مارس ۲۰۲۰) و موج اول (بهار) همه گیری COVID-19 در لهستان را نشان می دهد. با شروع از بیمار ۰ در لهستان (شهرستان اسلوبیسه، لهستان غربی، نزدیک مرز آلمان و لهستان)، همه گیری به پرتراکم ترین مناطق سیلزیا و لهستان کوچک (Małopolska) و همچنین در بزرگترین شهرها و تقریباً همه شهرستان ها گسترش یافت. با گذرگاه های مرزی در طول ماههای تعطیلات تابستانی، همهگیری نسبتاً آهسته شد ( شکل ۱ را ببینید )، و مردم عموماً خطر ویروس را دست کم میگرفتند و تحرک بیشتری داشتند و مانند معمول در طول تابستان رفتار میکردند، یعنی از شمال لهستان، مناطق دریاچهای آن دیدن میکردند. و سواحل دریای بالتیک. شکل ۳وضعیت موج دوم (پاییز ۲۰۲۰) را ارائه می دهد. تمام مناطق شهری و مناطق حومه شهرها کانون شیوع بیماری همه گیر بودند و علاوه بر این، مناطق شمالی لهستان، اگرچه جمعیت کمتری دارند، اما مرطوبتر و خنکتر هستند، اما تحت تأثیر شیوع COVID-19 قرار دارند. سایر پدیدههای اجتماعی و سیاسی (تظاهرات ضد و طرفدار سقط جنین) نیز احتمالاً بر پویایی بیماری در بزرگترین شهرهای لهستان در اکتبر و نوامبر ۲۰۲۰ تأثیر گذاشته است، علیرغم سیاستهای رسمی «DDM» (فاصله، ضدعفونی، ماسک).
مدلسازی گسترش همهگیری نیازمند جمعآوری دادههای مکانی (تقسیمات اداری کشور) و دادههای جمعیتی، مشخص کردن جمعیت و سطح تحرک جمعیت بود. این داده ها از دفتر مرکزی ژئودزی و کارتوگرافی [ ۴۵ ] و آمار لهستان [ ۴۶ ] به دست آمد. هر دو ابزار استاندارد GIS (ArcGIS Pro، QGIS) و کتابخانه های برنامه نویسی اختصاصی توسعه یافته در پایتون برای تجزیه و تحلیل داده ها استفاده شدند.
۳٫۲٫ کالیبراسیون مدل SIR-F
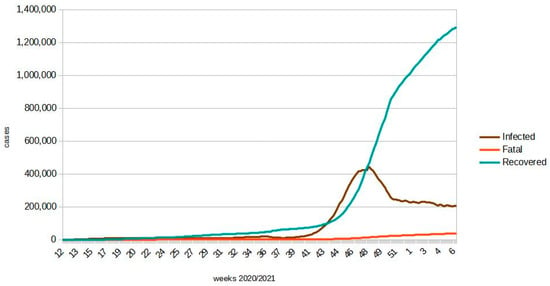
با استفاده از دادههای COVID-19 از لهستان در هفتههای بعدی، که در وبسایتهای دولتی و در کتابخانه CovsirPhy [ ۴۷ ، ۴۸ ] در دسترس قرار گرفت، مقادیر پارامترهای مدل اپیدمیولوژیک SIR-F برآورد شد [ ۴۹ ، ۵۰ ]. اطلاعات مربوط به تعداد موارد COVID-19 در لهستان در سطح ملی در شکل ۴ ارائه شده است .
لازم به ذکر است که داده های مربوط به جمعیت آلوده تنها بخشی از کل جمعیت آلوده را شامل می شود و تنها بخش ثبت شده از جمعیت مورد آزمایش به صورت آماری افشا می شود. بر اساس یک گزارش رسمی منتشر شده روزانه (تا ۷ فوریه ۲۰۲۱)، در مجموع ۲۰۴۰۰۷ نفر واقعاً آلوده شدند (۱۵۵۰۲۵۵ نفر از ۴ مارس ۲۰۲۰)، ۱۳۰۷۱۶۱ نفر بهبود یافتند و ۳۹۰۸۷ نفر ناکام شدند (مرگ، شکل ۵ ).
نمونه نتایج شبیه سازی به دست آمده از مدل SIR-F کالیبره شده در شکل ۵ و شکل ۶ ارائه شده است.
شکل ۵ نشان می دهد که مقادیر واقعی و پیش بینی شده مدل SIR-F از هفته ۴۰ به بعد تقریباً برازش شده است (در مقیاس لگاریتمی). در واقع، از ابتدای اکتبر ۲۰۲۰ یک سازماندهی مجدد کامل در کسب و به اشتراک گذاری داده های COVID-19 صورت گرفت. داده های قبل از ۴۰ هفته مملو از عدم قطعیت هستند و حاوی شکاف هایی هستند.
۳٫۳٫ کالیبراسیون مدل – تعامل فضایی
مدلهای کلی تعامل فضایی مورد استفاده در این مقاله با تعیین پارامترها بر اساس تجزیه و تحلیل دادههای موجود توسط ایستگاههای بهداشتی و اپیدمیولوژیک ناحیه (powiat) کالیبره شدند. تجزیه و تحلیل های انجام شده یک همبستگی قابل اعتماد (از لحاظ آماری) را بین تعداد ساکنان powiats فردی و تعداد موارد نشان داده است.
مدلهای برهمکنش فضایی با استفاده از مدل خطی تعمیمیافته کالیبره شدند و مدل پواسون لگاریتمی به دست آمد. نویسندگان نتایج را با دادههای مرجع مقایسه کردند، به عنوان مثال، تعداد موارد در هفتههای جداگانه در powiats منفرد در لهستان. با این رویکرد، امکان ارزیابی پایایی پارامترهای مدل رگرسیون وجود داشت. نویسندگان رویه مشابهی را برای مدلهای گرانش نامحدود ( جدول ۱ ، مدل I در جدول ۲ ) و مقصد ( جدول ۱ ، مدل جاذبه III در جدول ۲ )، با استفاده از آمار جمعیت به عنوان متغیرهای توضیحی برای دنبالهای از هفتههای انتخابی تصادفی دنبال کردند. در سال ۲۰۲۰
۳٫۴٫ تایید مدل
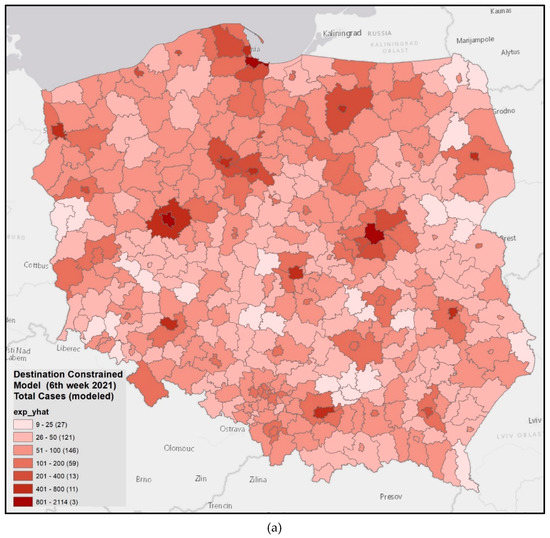
راستیآزمایی مدلهای تعامل فضایی محدود به مقصد برای هفتههای ۶ و ۷ ۲۰۲۱ (۱ تا ۷ فوریه) با استفاده از دادههای تجربی جمعآوریشده عفونتهای COVID-19 بر اساس شهرستان انجام شد. فرمول کلی مدل مقید مقصد (III) برای هفته های ششم و هفتم سال ۲۰۲۱ (معادلات (۹) و (۱۰)):
که در آن T ij تعداد مدلسازیشده عفونتها در تعداد j به دلیل تعامل با شهرستان i است، V i جمعیت شهرستان i است و d ij فاصله بین شهرستان i و j است. برای خود شهرستان، فاصله در نظر گرفته شده شعاع دایره ای با مساحت مساوی تا ناحیه شهرستان بود.
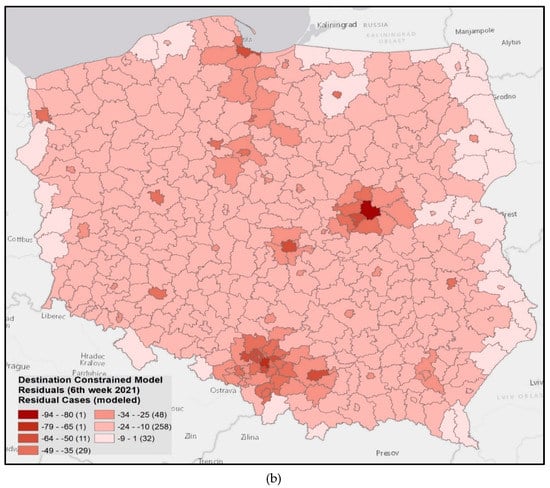
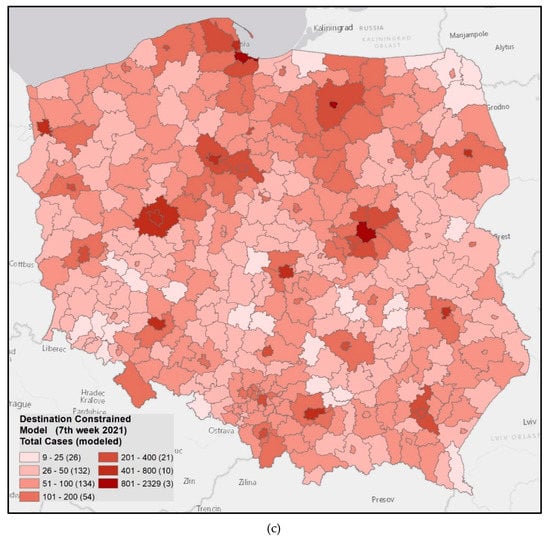
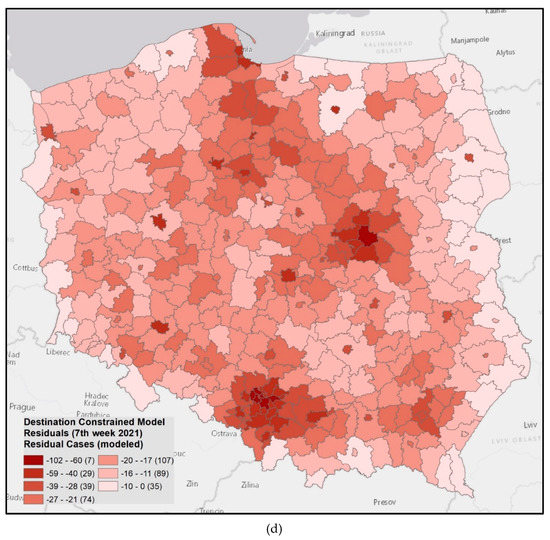
ضریب تعیین R2 برابر با ۰٫۸۵ است، به این معنی که مدل توسعه یافته ۸۵ درصد از واریانس پدیده و تعداد واقعی موارد را توضیح می دهد. بر اساس مدل حاصل، نویسندگان نقشه ای از باقیمانده های رگرسیون تهیه کردند ( شکل ۷ a-d که نشان دهنده نسبتی از تعداد مواردی است که توسط مدل توضیح داده نشده است. جدول ۲ داده هایی را در مورد کیفیت برازش مدل ارائه می دهد. پارامتر β = -۰٫۱۱ نشان می دهد که، در یک powiat معین، افزایش متوسط در بروز به ۱۰٫۴٪، با افزایش جمعیت در واحد فاصله (در هر ۱ کیلومتر) خواهد بود.
نتایج ( شکل ۷ الف) نشان می دهد که مدل توسعه یافته تعداد واقعی عفونت ها را دست کم می گیرد. با این حال، دادههای آماری بهدستآمده نشاندهنده تخمینهای قابلیت اطمینان مشابه مدلهای تعامل فضایی گرانش نامحدود و مقصد محدود است.
این مدلها با آمار در فواصل زمانی مختلف مطابقت دارند تا ثابت کنند که شیوع همهگیری کووید-۱۹ پرجمعیتترین مناطق را در طول زمان هدف قرار داده است. این مقادیر قابل اعتمادتر از داده های مربوط به فواصل یک هفته ای هستند ( جدول ۳ ).
۳٫۵٫ شبیه سازی
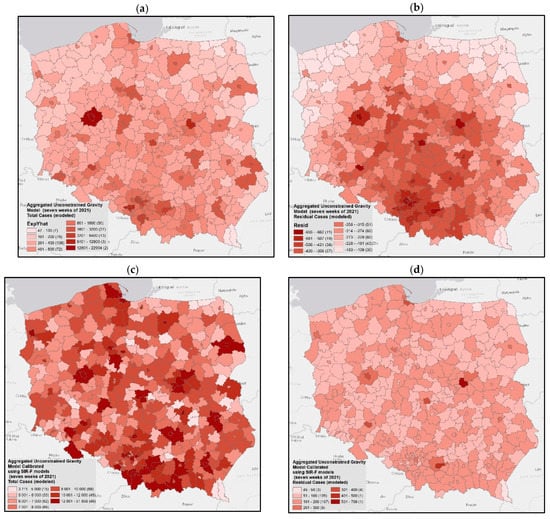
مدل ما را می توان با مدل SIR-F برای پیش بینی های فضایی ترکیب کرد. رویکرد پیشبینی تعداد کل موارد و سپس تفکیک تعداد کل موارد برای به دست آوردن توزیع فضایی است. این ما را به مفهوم جدید ترکیب مدلهای اپیدمی کلاسیک با مدلهای تعامل فضایی که توسط O’Kelly [ ۴۷ ] و Oshan [ ۳۵ ] پیشنهاد و توسعه داده شده است، هدایت میکند.]. نویسندگان از نتایج شبیهسازی پیشبینیکننده بهدستآمده با استفاده از مدل SIR-F در قلمرو لهستان برای تخمین تعداد عفونتها در هر پوویات استفاده کردند. با توجه به تمایز فضایی ناشناخته عفونتها در powiats، نویسندگان از مدل گرانش نامحدود برای این تحلیل استفاده کردند . ۴ . شبیه سازی مدل SIR-F در ۷ فوریه ۲۰۲۱ انجام شد. تخمین مدل گرانش نامحدود در پایان هفته تکمیل شد.
مدلهای گرانش نامحدود برای هفتههای اول (هفتههای ششم و هفتم سال ۲۰۲۱، معادلات (۱۱) و (۱۲) و برای هفت هفته آینده (معادله (۱۳)) شکلهای متفاوتی داشتند. نتایج مدلسازی در نقشهها ارائه شده است ( شکل) ۸ A–D).
که در آن T ij تعداد آلودگی مدل شده است، V i جمعیت شهرستان i است، W j جمعیت شهرستان j ، و d ij فاصله بین شهرستان های i و j است . برای خود شهرستان، فاصله در نظر گرفته شده شعاع دایره ای از مساحت برابر با مساحت شهرستان بود.
۴٫ بحث
هدف این مقاله توسعه یک مدل تعامل فضایی با استفاده از رویکرد “گرانشی” و آزمایش اینکه آیا به اندازه کافی شیوع همه گیر COVID-19 در لهستان را تخمین می زند یا خیر. مدل گرانش، اندازه جمعیت پوویات های فردی و فاصله متقابل آنها را به عنوان متغیرهای توضیحی در نظر گرفت. مدلی که ما ایجاد کردیم دارای مزیت ترکیب مدل SIR اپیدمی با مدل تعاملات فضایی است. مدلهای اپیدمی کلاسیک مانند مدلهای SIR تخمین قابل اعتمادی از تغییرات در طول زمان ارائه میکنند، اما امکان تجزیه و تحلیل فضایی عوارض، مرگ یا موارد شدید را نمیدهند.
نتایج نشان میدهد که مدل جاذبه نامحدود پیشبینی تعداد واقعی عفونتها را ممکن میسازد، همانطور که توسط تجزیه و تحلیل انجامشده برای هفته هفتم سال ۲۰۲۱ تأیید شد. مقادیر بهدستآمده در پیشبینی بسیار بالاتر از گزارشهای رسمی ارائهشده توسط بهداشت و درمان منطقه است. ایستگاه های اپیدمیولوژیک این نشان می دهد که تعداد واقعی موارد چندین برابر (حتی ده برابر) بیشتر از تعداد موارد گزارش شده رسمی است. مرکز بین رشته ای مدل سازی ریاضی و محاسباتی دانشگاه ورشو (ICM UW) نتایج مشابهی را به دست آورده است [ ۵۰ ].
بنابراین، مدل ارائه شده در این مطالعه متناسب با مقادیر تخمینی بهدستآمده با استفاده از مدل SIR-F با قابلیت اطمینان اثباتشده، و در عین حال حفظ تمایز فضایی ارائهشده توسط مدل گرانش نامحدود، کالیبره شد.
قابل توجه، تعداد کل عفونتهای مورد انتظار در لهستان ۴۲۲۰۶ مورد بود ( جدول ۴ ، شکل ۸ د) در هفته هفتم سال ۲۰۲۰٫ مدل کالیبرهشده با استفاده از دادههای رسمی وزارت بهداشت کمتر قابل اعتماد بود (معادله (۱۳)، شکل ۸ الف، ب)، زیرا فرض بر این بود که وضعیت اپیدمیولوژیک در لهستان در دوره مورد تجزیه و تحلیل به سرعت در حال تغییر نیست.
حداقل دو راه برای تأیید پیشبینی تعداد عفونتها در هر پوویات وجود دارد. مدلهای SIR یا SIR-F در هر دو سطح ملی و ناحیه (powiat) مورد استفاده قرار گرفتند و نتایج با استفاده از مدل تعامل فضایی محدود مقصد در سطح منطقه و یک مدل گرانش نامحدود در سطح ملی تأیید شد. نتایج امیدوارکننده این رویکرد ترکیبی این فرضیه را اجازه می دهد که تعداد موارد درمان شده و تعداد موارد واکسینه شده باید متغیرهای اضافی در مطالعات بعدی در نظر گرفته شوند. در نظر گرفتن این مقادیر، کاهش جمعیت مورد مطالعه مستعد ابتلا به عفونت را با تعداد افراد ایمن شده به طور جزئی یا دائم ممکن می سازد. همچنین می توان سایر متغیرهای اجتماعی و جمعیتی مانند گروه های سنی، وضعیت شغلی، و تحرک شغلی ساکنان، از جمله. از جمله تحرک شغلی ممکن است بسیار مهم باشد زیرا تعداد تماس های مرتبط با کار بین واحدهای اداری فردی را نشان می دهد. همچنین در نظر گرفتن سری های زمانی طولانی تر و ارزیابی اعتبار داده های اپیدمیولوژیک رسمی ارائه شده توسط ایستگاه های بهداشتی و اپیدمیولوژیک منطقه برای بهبود کیفیت و اعتبار پیش بینی مفید خواهد بود. یکی از محدودیتهای این مطالعه این است که این مدل شامل مشکلات سلامتی از قبل موجود، مانند بیماریهای قلبی عروقی یا دیابت نمیشود، که هر دو با عفونتهای COVID-19 و به ویژه با بدترین پیامدها مرتبط هستند. گنجاندن چنین عوامل خطر در تحقیقات COVID-19 می تواند مفید باشد [ از جمله تحرک شغلی ممکن است بسیار مهم باشد زیرا تعداد تماس های مرتبط با کار بین واحدهای اداری فردی را نشان می دهد. همچنین در نظر گرفتن سری های زمانی طولانی تر و ارزیابی اعتبار داده های اپیدمیولوژیک رسمی ارائه شده توسط ایستگاه های بهداشتی و اپیدمیولوژیک منطقه برای بهبود کیفیت و اعتبار پیش بینی مفید خواهد بود. یکی از محدودیتهای این مطالعه این است که این مدل شامل مشکلات سلامتی از قبل موجود، مانند بیماریهای قلبی عروقی یا دیابت نمیشود، که هر دو با عفونتهای COVID-19 و به ویژه با بدترین پیامدها مرتبط هستند. گنجاندن چنین عوامل خطر در تحقیقات COVID-19 می تواند مفید باشد [ از جمله تحرک شغلی ممکن است بسیار مهم باشد زیرا تعداد تماس های مرتبط با کار بین واحدهای اداری فردی را نشان می دهد. همچنین در نظر گرفتن سری های زمانی طولانی تر و ارزیابی اعتبار داده های اپیدمیولوژیک رسمی ارائه شده توسط ایستگاه های بهداشتی و اپیدمیولوژیک منطقه برای بهبود کیفیت و اعتبار پیش بینی مفید خواهد بود. یکی از محدودیتهای این مطالعه این است که این مدل شامل مشکلات سلامتی از قبل موجود، مانند بیماریهای قلبی عروقی یا دیابت نمیشود، که هر دو با عفونتهای COVID-19 و به ویژه با بدترین پیامدها مرتبط هستند. گنجاندن چنین عوامل خطر در تحقیقات COVID-19 می تواند مفید باشد [ همچنین در نظر گرفتن سری های زمانی طولانی تر و ارزیابی اعتبار داده های اپیدمیولوژیک رسمی ارائه شده توسط ایستگاه های بهداشتی و اپیدمیولوژیک منطقه برای بهبود کیفیت و اعتبار پیش بینی مفید خواهد بود. یکی از محدودیتهای این مطالعه این است که این مدل شامل مشکلات سلامتی از قبل موجود، مانند بیماریهای قلبی عروقی یا دیابت نمیشود، که هر دو با عفونتهای COVID-19 و به ویژه با بدترین پیامدها مرتبط هستند. گنجاندن چنین عوامل خطر در تحقیقات COVID-19 می تواند مفید باشد [ همچنین در نظر گرفتن سری های زمانی طولانی تر و ارزیابی اعتبار داده های اپیدمیولوژیک رسمی ارائه شده توسط ایستگاه های بهداشتی و اپیدمیولوژیک منطقه برای بهبود کیفیت و اعتبار پیش بینی مفید خواهد بود. یکی از محدودیتهای این مطالعه این است که این مدل شامل مشکلات سلامتی از قبل موجود، مانند بیماریهای قلبی عروقی یا دیابت نمیشود، که هر دو با عفونتهای COVID-19 و به ویژه با بدترین پیامدها مرتبط هستند. گنجاندن چنین عوامل خطر در تحقیقات COVID-19 می تواند مفید باشد [ مانند بیماری های قلبی عروقی یا دیابت که هر دو با عفونت های COVID-19 و به ویژه با بدترین پیامدها مرتبط هستند. گنجاندن چنین عوامل خطر در تحقیقات COVID-19 می تواند مفید باشد [ مانند بیماری های قلبی عروقی یا دیابت که هر دو با عفونت های COVID-19 و به ویژه با بدترین پیامدها مرتبط هستند. گنجاندن چنین عوامل خطر در تحقیقات COVID-19 می تواند مفید باشد [۵۱ ، ۵۲ ].
علاوه بر این، اجرای مدل ما امکان ارزیابی تعداد واقعی عفونتها را فراهم میکند، و بنابراین، میتوان از آن برای پیشبینی حجم آلودگی آینده COVID-19 استفاده کرد، که پیشبینیهای خوبی از یک نمای کلی از شرایط همهگیری آینده ارائه میدهد [ ۵۳ ، ۵۴ ]. به طور خاص، این مدل میتواند توسط دولت مرکزی و محلی برای برنامهریزی و مدیریت فعالیتهای کارآمد برای مقابله با گسترش عفونتهای COVID-19 استفاده شود. این می تواند با ارزیابی و تجسم داده های مکانی در مورد شیوع عفونت به تصمیم گیری و تخصیص منابع بهداشت عمومی کمک کند.
۵٫ نتیجه گیری ها
مطالعه ما نشان داده است که مدلهای تعامل فضایی ابزار مناسبی برای مدلسازی انتشار مکانی-زمانی همهگیری COVID-19 در لهستان و برای تعیین تعداد عفونتها هستند. نتایج را می توان با تحقیقات انجام شده در کشورهای دیگر نیز مقایسه کرد. علاوه بر این، شبیهسازیهای عددی نشان دادهاند که برای تعیین میزان تأثیر متقابل بین مناطق اداری از نظر شیوع بیماری همهگیر، دادههای مربوط به تعداد ساکنان و فواصل بین این واحدها کافی است. مدل توسعه یافته بر اساس این مفروضات تقریباً ۹۰ درصد از تغییرات زمانی و مکانی پدیده را توضیح می دهد.
مجموعه دادههای عفونتهای COVID-19 مورد استفاده شامل سال اول همهگیری در لهستان (۱۲ ماه، یعنی از مارس ۲۰۲۰ تا فوریه ۲۰۲۱) بود، و هیچ اطلاعات اضافی برای تمایز انواع عفونتهای ویروس SARS-CoV-2 وجود نداشت. هدف این مدلسازی تنها تأیید شواهد تجربی اکتشافی ساده از ارتباط بین تعداد بالقوه (بیشینهسازی، شبیهسازیشده) تماسهای احتمالی و تعداد آشکار عفونتها بود. طبق دانش ما، این اولین رویکرد سیستماتیک بود که فقط با هدف یافتن نظم مکانی بیماری همه گیر COVID-19 در لهستان انجام شد. تأیید روندهای فضایی آزمایش شده، معرفی متغیرهای وابسته اضافی (مرگ و میر یا بهبودی) و متغیرهای مستقل (به عنوان مثال، میانگین دمای تابشی، MRT) را ممکن می کند. به نظر می رسد که، هر چه دوره شبیه سازی کوتاه تر باشد، برازش متغیرهای وابسته شبیه سازی شده بیشتر است. از سوی دیگر، همانطور که در بالا ذکر شد، برخی از متغیرها، مانند MRT، تاثیر خود را در طول شبیهسازی طولانیتر نشان میدهند، و برای شبیهسازیهای کوتاهمدت در لهستان، هیچ اهمیتی برای ناهمگونی فضایی عفونتها وجود ندارد (در واقع، MRT یک متغیر مخدوشکننده است. در این دوره های کوتاه).
مدل ما شامل یک مؤلفه فضایی است که امکان ارزیابی تمایز فضایی بالقوه تعداد افراد آلوده را در مجموعه ای از واحدهای فضایی مشاهده شده (به عنوان مثال، شهرستان ها در لهستان) فراهم می کند، که در مورد نظارت COVID-19 ضروری است. . از این رو، مدل ما میتواند به ارزیابی مکانهای فضایی شیوع عفونت و تعیین منظم بودن تکامل مکانی و زمانی همهگیری کمک کند. بنابراین، مدلی که در اینجا ارائه میکنیم میتواند برای سیاستگذارانی که برای تصمیمگیری به پیشبینیهای جغرافیایی شیوع بیماری نیاز دارند، ارزشمند باشد. برای مثال، دانش ممکن است مبنایی برای اجرای محدودیتهای محدود به مناطق جغرافیایی خاص، بر اساس پیشبینیهای انجامشده با مدل، فراهم کند.
در کار آینده، نویسندگان قصد دارند مدل سیاست واکسیناسیون و همچنین دادههایی را در مورد تحرک شغلی ساکنان در طول همهگیری درج کنند.