مدل ارزش گذاری قیمت خانه بر اساس رگرسیون وزنی شبکه عصبی جغرافیایی: مطالعه موردی شنژن، چین


در مواجهه با ناهمگونی فضایی بازار املاک و مستغلات، برخی از تحقیقات سنتی از رگرسیون وزن‌دار جغرافیایی (GWR) برای تخمین قیمت مسکن استفاده کرده‌اند. با این حال، قدرت پیش‌بینی آن هنوز هم فضایی برای بهبود دارد و عملکرد هسته آن در برخی اشکال ساده محدود است. بنابراین، ما یک مدل جدید ارزیابی قیمت مسکن را پیشنهاد می‌کنیم که با رگرسیون وزنی شبکه عصبی جغرافیایی (GNNWR) ترکیب می‌شود تا دقت ارزیابی املاک را با کمک شبکه‌های عصبی بهبود بخشد. بر اساس مجموعه داده قیمت خانه شنژن، این کار به وضوح روابط رگرسیون فضایی متغیر را در مناطق مختلف متغیرهای مختلف نشان می‌دهد که GWR در درک آن مشکل دارد. علاوه بر این، ما بر عملکرد GNNWR تمرکز می کنیم، استحکام و برتری آن را تأیید می کنیم. و فرآیند آزمایش را با اعتبارسنجی متقاطع ۱۰ برابری اصلاح کنید. در مقایسه با مدل حداقل مربعات معمولی (OLS)، مدل ما در اکثر معیارها حدود ۵۰% بهبود می یابد. در مقایسه با بهترین مدل GWR، آزمایش‌های کامل ما نشان می‌دهد که مدل ما میانگین خطای مطلق (MAE) را ۱۳٫۵٪ بهبود می‌بخشد و به کاهش میانگین درصد مطلق خطا (MAPE) به میزان ۱۳٫۰٪ در ارزیابی روی مجموعه داده اعتبار سنجی می‌رسد. این یک روش عملی و قدرتمند برای ارزیابی قیمت مسکن است، و ما معتقدیم که مدل ما می تواند برای سایر مشکلات ارزش گذاری مربوط به داده های جغرافیایی برای ارتقای دقت پیش بینی پدیده های اجتماعی-اقتصادی اعمال شود. در مقایسه با بهترین مدل GWR، آزمایش‌های کامل ما نشان می‌دهد که مدل ما میانگین خطای مطلق (MAE) را ۱۳٫۵٪ بهبود می‌بخشد و به کاهش میانگین درصد مطلق خطا (MAPE) به میزان ۱۳٫۰٪ در ارزیابی روی مجموعه داده اعتبار سنجی می‌رسد. این یک روش عملی و قدرتمند برای ارزیابی قیمت مسکن است، و ما معتقدیم که مدل ما می تواند برای سایر مشکلات ارزش گذاری مربوط به داده های جغرافیایی برای ارتقای دقت پیش بینی پدیده های اجتماعی-اقتصادی اعمال شود. در مقایسه با بهترین مدل GWR، آزمایش‌های کامل ما نشان می‌دهد که مدل ما میانگین خطای مطلق (MAE) را ۱۳٫۵٪ بهبود می‌بخشد و به کاهش میانگین درصد مطلق خطا (MAPE) به میزان ۱۳٫۰٪ در ارزیابی روی مجموعه داده اعتبار سنجی می‌رسد. این یک روش عملی و قدرتمند برای ارزیابی قیمت مسکن است، و ما معتقدیم که مدل ما می تواند برای سایر مشکلات ارزش گذاری مربوط به داده های جغرافیایی برای ارتقای دقت پیش بینی پدیده های اجتماعی-اقتصادی اعمال شود.

کلید واژه ها:

GNNWR ; GWR ; ارزیابی قیمت مسکن ; ناهمگونی فضایی

۱٫ مقدمه

قیمت مسکن ارتباط تنگاتنگی با زندگی ساکنان جدید شهری دارد و همچنین یک شاخص اقتصادی حیاتی را تشکیل می‌دهد که دولت باید به آن توجه زیادی داشته باشد. بررسی الگوی توزیع فضایی قیمت مسکن اهمیت عملی و ارزش راهنما زیادی برای مقررات دولتی، خرید خانه فردی یا ارزش گذاری شخص ثالث دارد.
چین به‌عنوان کشوری با یکی از سریع‌ترین فرآیندهای شهرنشینی، در چند دهه گذشته به‌ویژه در شهرهای بزرگ خود شاهد افزایش قیمت مسکن بوده است. تحت تأثیر همه گیری کووید-۱۹ در سال ۲۰۲۰، اقتصادهای بزرگ جهان وارد چرخه کاهش نقدینگی شدند و قیمت مسکن در بسیاری از شهرهای چین به طور قابل توجهی افزایش یافت [ ۱ ]. بر این اساس، چندین شهر چین مانند شنژن، شیان و چنگدو، قیمت گذاری مرجع معاملات مسکن دست دوم را اعمال کرده اند که برای مهار افزایش قیمت مسکن استفاده می شود. قیمت مرجع برای حباب های خفیف قیمت مسکن، ارزش گذاری معقولی را در اختیار ما قرار می دهد.
در این تحقیق، ما یک مدل جدید ارزش گذاری قیمت مسکن را بر اساس داده های شنژن، چین پیشنهاد می کنیم. در گذشته، مدل‌های مختلفی توسط بسیاری از محققان برای مدل‌سازی و برآورد قیمت مسکن ایجاد شده است. در سال ۱۹۷۲، روزن [ ۲ ] مدل لذت‌گرا را پیشنهاد کرد که هدف آن اندازه‌گیری قیمت ملک با استفاده از تعدادی از عوامل محیطی است. مطالعات اولیه عمدتاً شامل سه مؤلفه بود: ویژگی‌های مکان، ویژگی‌های ساختاری و ویژگی‌های همسایگی، یعنی قیمت مسکن عمدتاً تابعی از این سه ویژگی است و تقریباً به صورت نمایی به صورت خطی مرتبط هستند [ ۳ ].]. تعدادی از مطالعات بعدی اعتبار نسبی این مدل را نشان داده‌اند و اندازه‌گیری‌های این عوامل می‌توانند همبستگی مثبت یا منفی بین هر متغیر مستقل و قیمت مسکن را با دقت بیشتری تخمین بزنند. به عنوان مثال، MoK و همکاران. [ ۴ ] قیمت خانه در هنگ کنگ را در سال ۱۹۹۴ مدل کرد، و نشان داد که قیمت خانه به طور معناداری با سن خانه و فاصله از منطقه تجاری مرکزی همبستگی منفی دارد و به طور قابل توجهی با کف همبستگی مثبت دارد. با گذشت زمان، متغیرهای مستقل بیشتری در نظر گرفته شد و شاخص های آماری بیشتری برای آزمون اعتبار مدل اضافه شد. مطالعات بیشتر تا حدی برنامه ریزی کاربری زمین و همچنین دسترسی از نظر حمل و نقل را شامل می شود [ ۵ ]]. در سال‌های اخیر، مطالعات مربوط به قیمت خانه‌های مسکونی، انواع عوامل محیطی خارجی مانند چشم‌انداز طبیعی و اندازه محله را برای تجزیه و تحلیل تأثیر آنها بر قیمت خانه ترکیب کرده‌اند [ ۶ ].]. با این حال، این مدل ها به طور مداوم در برخورد با ناهمگونی فضایی با مشکلاتی مواجه بوده اند، یعنی همان متغیر مستقل اثرات متفاوتی بر قیمت مسکن در مناطق مختلف دارد. مدل‌های لذت‌گرای معمولی تنها می‌توانند یک متغیر مستقل خاص را با ضرایب ثابت مدل‌سازی کنند، اما وضعیت واقعی اغلب تحت‌تاثیر عوامل فضایی است. به عنوان مثال، در مناطق حومه شهر، شرایط حمل و نقل بر قیمت خانه حاکم است و کیفیت مدارس مجاور اهمیتی ندارد. در مقابل، در نواحی مرکز شهر، کیفیت مدارس در نزدیکی خانه‌ها ممکن است حیاتی‌تر باشد و شرایط حمل‌ونقل در مجاورت نسبتاً کمتر اهمیت دارد. این چیزی است که با مدل‌های لذت‌گرای معمولی قابل تحلیل نیست.
علاوه بر این، با در نظر گرفتن ناهمگونی فضایی عوامل مختلف تأثیرگذار، روش‌های رگرسیون وزن‌دار جغرافیایی (GWR) پیشنهاد شده‌اند که اجازه می‌دهد ضرایب در مکان‌های مختلف تغییر کنند [ ۷ ، ۸ ]. این روش را می توان به عنوان یک رگرسیون خطی وزن محلی برای هر منطقه محلی درک کرد و ضرایب به طور کامل اثرات نقاط داده مجاور را طبق قانون اول جغرافیا پیشنهاد شده توسط توبلر [ ۹ ] در نظر می گیرند. به منظور ایجاد یک مدل رضایت بخش تر برای روابط رگرسیون متغیر جغرافیایی، براندون و فاثرینگهام [ ۱۰ ]] چندین سؤال کلیدی را که GWR با آنها روبرو شده است ذکر کرد: انتخاب متغیرها، پهنای باند، و همبستگی خودکار مکانی خطا. بسیاری از محققان بر این اساس تلاش کرده اند تا این سؤالات را حل کنند. به عنوان مثال، تو و همکاران. [ ۱۱ ] از مدل GWR برای کشف رابطه بین تغییرات فضایی و سواری عمومی شهری در شنژن استفاده کرد. در سال ۲۰۱۱، گنگ و همکاران. [ ۱۲ ] از مدل GWR برای مدلسازی قیمت خانه در شنژن استفاده کرد. در مقایسه با مدل حداقل مربعات معمولی (OLS)، آر۲از ۰٫۵۶ به ۰٫۷۹ بهبود یافته است. ژانگ و همکاران [ ۱۳ ] از رگرسیون ترکیبی وزن‌دار جغرافیایی برای مدل‌سازی رانت در نانجینگ استفاده کرد، به‌عنوان مثال، برخی از متغیرها به صورت محلی با توجه به موقعیت جغرافیایی وزن‌گذاری شدند در حالی که برخی از متغیرها وزن‌بندی جهانی داشتند و نتایج خوبی به دست آمد. لو و همکاران [ ۱۴ و ۱۵ ] فاصله غیر اقلیدسی را به GWR اضافه کرد، و برای برخی از عناصر جغرافیایی که از معیار خطی استاندارد تبعیت نمی کنند، این مدل نتایج بهتری در اندازه گیری مجاورت فضایی لندن به دست آورد و می تواند عملکرد تخمین بهتری برای قیمت خانه داشته باشد.
با این حال، توانایی GWR برای بیان روابط فضایی محدود است. بنابراین، بسیاری از محققان به روش‌های هوش مصنوعی که در سال‌های اخیر به سرعت توسعه یافته‌اند، برای مدل‌سازی قیمت مسکن با استفاده از توانایی فوق‌العاده آن‌ها در تناسب با قیمت خانه متوسل شده‌اند [ ۱۶ ، ۱۷ ]]. اگرچه عملکرد تخمین مدل‌های شبکه عصبی معمولاً از مدل‌های OLS برتری دارد، اما توزیع‌های فضایی به‌دست‌آمده توسط این مدل‌ها کاملاً معقول نیستند و روابط رگرسیونی ساخته‌شده تفسیر مکانی دشوار است، زیرا آنها ویژگی‌های مکانی رگرسیون قیمت مسکن را نادیده می‌گیرند. روابط نقص دیگر این است که برخی از مطالعات در مورد مدل‌سازی قیمت مسکن با کمک شبکه‌های عصبی، مکانیسم اعتبارسنجی ۱۰ برابری را معرفی نکرده‌اند. علاوه بر این، همانطور که برخی از محققان پیشنهاد کرده اند، رویکرد “جعبه سیاه” شبکه های عصبی اهمیت عملی آنها را به طور قابل توجهی در پیش بینی قیمت مسکن و سایر مشکلات اجتماعی-اقتصادی محدود کرده است [ ۱۸ ].]. هر دو مدل رگرسیون چند جمله‌ای و روش‌های شبکه عصبی سنتی از این ساختار خطی خارج می‌شوند و عبارات نسبتاً پیچیده‌ای دارند و تحلیل و پیش‌بینی را بسیار دشوارتر می‌کنند.
در سال های اخیر، بر اساس ایده وزن دهی جغرافیایی GWR، Du et al. [ ۱۹ ] یک مدل رگرسیون وزنی شبکه عصبی جغرافیایی (GNNWR) پیشنهاد کرد که مدل‌های OLS و شبکه عصبی را ترکیب می‌کند. شبکه‌های عصبی به دلیل توانایی‌های یادگیری قدرتمند خود، می‌توانند به طور موثری به غیرایستایی فضایی بالقوه و ویژگی‌های غیرخطی پیچیده در روابط رگرسیونی بپردازند. مفهوم GNNWR شبیه مدل ترانسفورماتور است [ ۲۰]، یک مدل پیشگامانه و محبوب ارائه شده در سال ۲۰۱۷٫ اصل مدل ترانسفورماتور را می توان به طور خلاصه اینگونه خلاصه کرد: “توجه تمام چیزی است که شما نیاز دارید”. مدل GNNWR در همان دوره به عنوان یک رویکرد ساده تر برای ارزیابی شباهت (توجه) بین نقطه تخمینی و مجموعه داده آموزشی پیشنهاد شد. با توجه به کاربرد گسترده مدل‌های توجه در سال‌های اخیر، GNNWR در این مطالعه برای مدل‌سازی محیط اکولوژیکی دریاهای نزدیک ساحل [ ۲۱ ] و برآورد غلظت فضایی PM 2.5 در چین [ ۲۲ ] استفاده می‌شود. عملکرد مدل و قدرت توضیحی رضایت بخش ذکر شده است.
برخلاف پدیده های اکولوژیکی، پدیده های اجتماعی-اقتصادی مانند قیمت مسکن همیشه در فضای فیزیکی مستمر نیستند. به عنوان مثال، مختصات جغرافیایی گسسته هستند و کیفیت های مکان ناپیوسته را نشان می دهند. ما حدس می زنیم که محدودیت های مرتبط با پیچیدگی مشکلات اجتماعی-اقتصادی را می توان به طور بالقوه با استفاده از استراتژی های ارزش گذاری مبتنی بر مدل GNNWR غلبه کرد. ارزش گذاری قیمت مسکن یک مشکل کلاسیک است که شامل داده های جغرافیایی می شود. در این مطالعه، داده‌های شنژن، که یک شهر نماینده در چین است را در نظر می‌گیریم. در ۸ فوریه ۲۰۲۱، مرکز تحقیقات توسعه املاک و مستغلات و ساخت و ساز شهری شنژن قیمت های مرجع معاملات مسکن دست دوم را برای ۳۵۹۵ محله مسکونی شهر منتشر کرد. این مجموعه داده را می توان برای ایجاد یک مدل ارزش گذاری قیمت مسکونی با در نظر گرفتن عوامل مختلف، مانند متغیرهای درون زا ملک، مترو، و شرایط منطقه مدرسه استفاده کرد. در نتیجه، ما از چارچوب GNNWR برای ایجاد یک مدل ارزش گذاری قیمت مسکونی برای پرداختن به ناهمگنی و غیرایستایی فضایی موجود در داده ها استفاده می کنیم.۱۹ ].
به طور خلاصه، هدف این مطالعه معرفی مدل GNNWR در زمینه اجتماعی-اقتصادی برای ایجاد یک مدل ارزش گذاری قیمت مسکونی بر اساس داده های قیمت مرجع معاملات مسکن دست دوم در شنژن است که به طور دقیق با ناهمگنی فضایی و روابط غیرخطی چندگانه تطبیق داده شود. عوامل محیطی و با در نظر گرفتن توزیع فضایی عوامل متعدد و تأثیر آنها بر قیمت مسکن، مدل قیمت گذاری دقیق تری نسبت به روش GWR بدست آورید. به طور خاص، با بهبود این مدل قیمت‌گذاری، می‌توان الگوهای بیشتری استخراج کرد تا اهمیت هر یک از عوامل و تغییرات در وزن عوامل مشخص شود.
از دیدگاه هیبریداسیون روش شناختی، رویکرد پیشنهادی چندین فرصت جدید برای درک جغرافیایی فراهم می کند. همانطور که توسط Benessia و همکاران نشان داده شده است، به عنوان یک پلت فرم برای ارزش گذاری مسکونی، هر هیبریداسیون طیف وسیعی از امکانات جدید را برای هدایت پارادایم به سمت پایداری فراهم می کند. [ ۲۳ ]. مدل پیشنهادی می تواند مرجعی برای ارزش گذاری مسکونی، مزایده زمین و قیمت مرجع معاملات مسکن دست دوم در سایر شهرها باشد. روش پیشنهادی از طریق ادغام آن در یک سیستم پشتیبانی تصمیم گیری ترکیبی، می تواند از بازار املاک و مستغلات و توسعه کاربری پایدار زمین به عنوان یک درمان تشخیصی، به ویژه در سناریوی همه گیر COVID-19 [ ۲۴ ] حمایت کند.

۲٫ حوزه مطالعه، منابع داده و روش تحقیق

۲٫۱٫ مشخصات قیمت خانه شنژن

منطقه ویژه اقتصادی شنژن در سال ۱۹۸۰ تأسیس شد. این منطقه در جنوب مجاور هنگ کنگ است و در غرب مصب رودخانه مروارید در استان گوانگدونگ چین قرار دارد. شنژن به دلیل نزدیکی جغرافیایی به هنگ کنگ و حمایت از سیاست، به عنوان سومین منطقه با تولید ناخالص داخلی بزرگ با ۹ منطقه تحت صلاحیت خود ظاهر شده است. بر اساس داده های هفتمین سرشماری ملی، جمعیت شنژن به ۱۷٫۵۶ میلیون نفر رسیده است. حتی تحت تأثیر کووید-۱۹، تولید ناخالص داخلی منطقه ای شنژن در سال ۲۰۲۰ به ۲۷۶۷٫۰۲۴ میلیارد یوان رسید که ۳٫۱ درصد بیشتر از سال ۲۰۱۹ است.
با افزایش جمعیت، قیمت مسکن در شنژن به دلیل شرایط اقتصادی عالی و محیط تجاری آن در حال افزایش است. مرکز تحقیقات توسعه املاک و مستغلات و ساخت و سازهای شهری شنژن در فوریه ۲۰۲۱ برای جلوگیری از افزایش قیمت مسکن، قیمت های مرجع معاملات مسکن دست دوم را در ۳۵۹۵ محله مسکونی بر اساس قیمت معاملات ثبت شده توسط دولت تعیین کرد. مسکن و قیمت مسکن دست اول اطراف.
در این مطالعه از داده های شنژن با در نظر گرفتن عوامل زیر استفاده شده است. ابتدا، قیمت مرجع معاملات مسکن دست دوم در این منطقه در مقایسه با داده های سایر مناطق به طور گسترده مورد ارزیابی قرار گرفته است. تفاوت‌ها در انواع و طبقات خانه به‌طور میانگین محاسبه می‌شود، قیمت‌های معاملات ثبت شده توسط دولت و قیمت‌های مسکن دست اول اطراف با هم ترکیب می‌شوند، گرمای کوتاه‌مدت و حباب‌ها حذف می‌شوند و می‌توان نتایج ارزیابی دقیقی را برای یک ملک به دست آورد. دوم، توسعه شهری شنژن بیشتر طبیعی است. هیچ مرکز سیاسی مهم، آثار باستانی یا محله های فقیر نشین وجود ندارد که بتواند بر برنامه ریزی شهری تأثیر بگذارد. ثالثاً، قیمت‌های مرجع در یک دسته یکنواخت، با حجم زیادی از داده‌ها و تأثیر قابل توجه معرفی می‌شوند. از این رو،

۲٫۲٫ داده های تجربی

در مجموع، ۲۸۷۱ رکورد داده های اولیه کامل و موثر به دست آمده است که ۲۸۷۱ محله مسکونی در شنژن را پوشش می دهد، همانطور که در شکل ۱ نشان داده شده است. منبع داده https://shenzhen.qfang.com است (در ۲۰ اوت ۲۰۲۱ قابل دسترسی است). رکوردها شامل سه نوع نقطه داده زیر است:
۱٫
طول و عرض جغرافیایی: طول و عرض جغرافیایی به ترتیب بین ۲۲٫۴۸۴۳۱۰ درجه شمالی و ۲۲٫۷۸۸۰۱۱ درجه شمالی و بین ۱۱۳٫۸۱۴۶۰۵ درجه شرقی و ۱۱۴٫۴۹۸۳۴۰ درجه شرقی است. مختصات طول و عرض جغرافیایی مورد استفاده برای GNNWR پس از تبدیل طرح ریزی به سیستم مختصات WGS 1984 50N تبدیل می شود.
۲٫

متغیرهای درون زا: این متغیرها شامل سن ساختمان (AB)، تعداد نقاط پارکینگ (NPS)، هزینه مدیریت (MF)، نسبت سبز (GR) و نسبت قطعه (PR) است. AB به عنوان تفاوت بین سال ۲۰۲۱ و سال ساخت محاسبه می شود. اگر سن ساخت یک محدوده باشد، زمان اتمام در نظر گرفته می شود. اگر MF یک محدوده باشد، به عنوان میانگین کران بالا و پایین محاسبه می شود. GR و PR به شرح زیر تعریف می شوند:

GR=اسVهgهتیآتیمنonاسLآnد
روابط عمومی=اسافلoorاسLآnد

جایی که اسVهgهتیآتیمنonکل منطقه سبز است. اسLآnدمساحت کل زمین است. اسافلoorکل مساحت ساختمان محله است.

۳٫
متغیرهای مرتبط با محیط زیست: این متغیرها شامل فاصله از دریا (SD)، کیفیت مدارس دولتی موجود (QAPS)، تعداد ایستگاه های مترو در شعاع ۱ کیلومتری (NSS) و فاصله تا نزدیکترین ایستگاه مترو (DSS) است. SD با توجه به موقعیت نزدیکترین ساحل محاسبه می شود و DSS بر حسب واحد متر نشان داده می شود. QAPS با استفاده از فرآیند زیر محاسبه می‌شود: ما مدارس را به چهار نوع (مدارس کلیدی استانی، مدارس کلیدی شهر، مدارس کلیدی منطقه و مدارس عادی) تقسیم می‌کنیم و به هر دسته امتیاز می‌دهیم (۱ تا ۴ برای عادی، کلید ناحیه، کلید شهر، و دبیرستان های کلیدی استانی به ترتیب؛ و ۱٫۵، ۲٫۵، ۳٫۵، و ۴٫۵ به ترتیب برای مدارس ابتدایی عادی، کلید ناحیه، کلید شهر و کلید استانی). امتیاز بهترین مدرسه در یک منطقه مدرسه به عنوان QAPS تعیین می شود. QAPS با در نظر گرفتن جنبه های زیر طراحی شده است. اول، طبق آژانس‌های املاک در شنژن و هانگژو، مدارس کلیدی با وزن بالاتری نسبت به مدارس معمولی مطابقت دارند. دوم، آژانس‌های املاک و مستغلات نشان می‌دهند که مدارس ابتدایی با وزن بالاتری نسبت به دبیرستان‌های راهنمایی مطابقت دارند، زیرا والدین در مراحل اولیه رشد کودک احتمال بیشتری برای انتخاب مدرسه بهتر دارند. سوم، با توجه به تحلیل های مقایسه ای، QAPS یک متریک با اهمیت آماری بالا است. آژانس‌های املاک و مستغلات نشان می‌دهند که مدارس ابتدایی با وزن بالاتری نسبت به دبیرستان‌های راهنمایی مطابقت دارند، زیرا والدین به احتمال زیاد مدرسه بهتری را در مراحل اولیه رشد کودک انتخاب می‌کنند. سوم، با توجه به تحلیل های مقایسه ای، QAPS یک متریک با اهمیت آماری بالا است. آژانس‌های املاک و مستغلات نشان می‌دهند که مدارس ابتدایی با وزن بالاتری نسبت به دبیرستان‌های راهنمایی مطابقت دارند، زیرا والدین به احتمال زیاد مدرسه بهتری را در مراحل اولیه رشد کودک انتخاب می‌کنند. سوم، با توجه به تحلیل های مقایسه ای، QAPS یک متریک با اهمیت آماری بالا است.

۲٫۳٫ روش تحقیق

رگرسیون وزنی جغرافیایی (GWR):

بر اساس قانون اول جغرافیا، برخی از محققان با ارائه مدل رگرسیون وزنی جغرافیایی (GWR) سعی در تغییر ضریب رگرسیون از جهانی به محلی و تغییر وزن نقاط مجاور با توجه به فواصل مختلف در چارچوب رگرسیون دارند. مدل GWR غیر ایستایی فضایی را به صورت [ ۷ ، ۲۵ ] تعریف می کند:

yمن=w0(تومن،vمن)×β۰+∑ک=۱پwک(تومن،vمن)×βکایکسمنک+ϵمن

می توانیم ضریب را به صورت نشان دهیم βک(تومن،vمن)=wک(تومن،vمن)×β۰برای جایگزینی مقدار تخمینی مدل حداقل مربعات معمولی β^ک، مقدار تخمینی را می توان به عنوان یک ساختار خطی یکنواخت به دست آورد:

y^من=∑ک=۰پβ^ک(تومن،vمن)ایکسمنک

برآوردگر به صورت ماتریسی می تواند به صورت زیر بیان شود:

y^من=ایکسمنتی(ایکستیدبلیو(تومن،vمن)ایکس)-۱ایکستیدبلیو(تومن،vمن)y

ماتریس وزن فضایی دبلیو(تومن،vمن)را می توان به صورت زیر بیان کرد:

دبلیو(تومن،vمن)≜w1(تومن،vمن)۰⋯۰۰w2(تومن،vمن)⋯۰⋮⋮⋱⋮۰۰⋯wn(تومن،vمن)
در مدل GWR، هسته های وزنی معمولاً از توابع گاوسی، دو مربعی، سه مکعبی و نمایی استفاده می کنند. این توابع می توانند نسبتاً به سادگی رابطه پیچیده بین مجاورت فضایی (مثلاً فاصله مکانی) و غیر ایستایی فضایی (یعنی وزن فضایی) را بیان کنند.
لازم به ذکر است که روش های مختلفی برای انتخاب تابع در ماتریس وزن فضایی وجود دارد و روش های مختلف انتخاب مستقیماً بر دقت مدل سازی نهایی تأثیر می گذارد.

تابع وزنی گاوسی را می توان به صورت زیر بیان کرد:

wمنj=ه-دمنjسب۲

جایی که دمنjسفاصله بین نقاط i و j است. b ، پهنای باند، که اثر کاهشی نسبت به دمنjس، روش های مختلفی برای انتخاب دارد: برای تابع وزن ثابت گاوسی، پهنای باند در هر نقطه یکسان است و در همان مدل ثابت است. برای تابع وزن گاوسی تطبیقی، پهنای باند در هر نقطه متفاوت است و فاصله نقطه نزدیک به نقطه اغلب به عنوان مقدار پهنای باند در نظر گرفته می شود. در هر صورت، تابع وزن گاوسی به یک ورودی متغیر، یعنی محدوده فاصله (پهنای باند ثابت) یا تعداد ویژگی های اصلی مجاور (پهنای باند پویا) نیاز دارد.

تابع وزنی دو مربع را می توان به صورت زیر بیان کرد:

wمنj=[1-(دمنjس/بمن)۲]۲،دمنjس<بمن;۰،رادیگران.

جایی که دمنjسفاصله بین دو نقطه است. بمنپهنای باند است. همچنین طبق روش فوق به نوع ثابت و تطبیقی ​​تقسیم می شود.

این مدل با استفاده از توابع تطبیقی ​​ساخته شده است، به عنوان مثال، یک متغیر ورودی برای انتخاب تعداد عناصر اصلی مجاور مورد نیاز است و آمنسیجمعیار برای تعیین اینکه آیا ارجح تر است استفاده می شود [ ۲۶ ].
رگرسیون وزنی شبکه عصبی جغرافیایی (GNNWR):
به طور مشابه، بر اساس عدم ایستایی در رابطه فضایی، GNNWR فراتر از GWR می رود و سعی می کند با دقت بیشتری نوسانات ناایستایی فضایی را در رابطه رگرسیون در مکان های مختلف دریافت کند. مرحله کلیدی GWR انتخاب و ساخت تابع ماتریس وزن فضایی است. بر این اساس، GNNWR تلاش می کند تا فراتر رفته و تابع ماتریس وزن فضایی مناسب را با کمک شبکه عصبی پیدا کند.

برای برازش دقیق رابطه پیچیده بین فاصله فضایی و وزن فضایی، GNNWR یک شبکه عصبی وزنی فضایی (SWNN) را برای دستیابی به بیان شبکه عصبی عملکرد هسته وزن طراحی می‌کند. به طور خاص، SWNN فاصله فضایی بین نقاط را به عنوان لایه ورودی و ماتریس وزن فضایی را به عنوان لایه خروجی می گیرد و تعداد مناسبی از لایه های پنهان را با توجه به نیازهای مدل سازی انتخاب می کند. محاسبه وزن فضایی نقاط مطابق با:

yمن^=ایکسمنتیβ^(تومن،vمن)=ایکسمنتیدبلیو(تومن،vمن)(ایکستیایکس)-۱ایکستیy

جایی که دبلیو(تومن،vمن)ماتریس وزن فضایی به صورت زیر است:

دبلیو(تومن،vمن)≜w0(تومن،vمن)۰⋯۰۰w1(تومن،vمن)⋯۰⋮⋮⋱⋮۰۰⋯wپ(تومن،vمن)
یعنی این ماتریس نتیجه تابع است دبلیو:آر۲→آر(۱+پ)×(۱+پ). SWNN همچنین وجود یک متغیر میانی را در نظر می گیرد [دمن۱،دمن۲،دمن۳،⋯،دمنn]و ماتریس دبلیو(تومن،vمن)تابعی از متغیر است [دمن۱،دمن۲،دمن۳،⋯،دمنn]، جایی که دمنjفاصله نقطه i تا نقطه نمونه j است. بنابراین، مدل تخمین قیمت مسکن مبتنی بر GNNWR به صورت شکل ۲ نشان داده شده است :

۲٫۴٫ شاخص های عملکرد مدل

این مقاله از معیارهای زیر برای ارزیابی عملکرد مدل استفاده می کند. ابتدا تصحیح معیارهای اطلاعات آکایک ( آمنسیج) [ ۷ ] به شرح زیر است:

آمنسیج=nلn(σ^۲)+nلn(2π)+nn+تیr(اس)n-2-تیr(اس)

بیان ماتریس S در پیوست B نشان داده شده است. این روش برای GWR و GNNWR قابل استفاده است. در عمل، هر چه مقدار کوچکتر باشد، عملکرد مدل بهتر است [ ۲۶ ] و ما استفاده می کنیم آمنسیجبرای انتخاب پارامترهای ورودی مناسب برای مدل GWR. سایر معیارهای عملکرد مدل عبارتند از: ضریب تعیین ( آر۲، ریشه میانگین مربعات خطا (RMSE)، میانگین خطای مطلق (MAE) و میانگین درصد خطای مطلق (MAPE). تعاریف به شرح زیر است:

آر۲=۱-∑من=۱n(yمن-y^من)۲∑من=۱n(yمن-y¯من)۲
RMSE=∑من=۱n(yمن-y^من)۲n
MAE=∑من=۱n|yمن-y^من|n
MAPE=1n∑من=۱n|yمن-y^منyمن|×۱۰۰%
در میان آنها، y¯میانگین مقادیر مشاهده شده است. σ^۲میانگین مربعات خطای مدل و p درجه آزادی موثر مدل است.

۲٫۵٫ طراحی و پیاده سازی شبکه عصبی

مدل GNNWR از یک چارچوب شبکه عصبی کلاسیک استفاده می کند که جریان فرآیند آن در شکل ۲ نشان داده شده است . علاوه بر این، اعتبارسنجی متقاطع ۱۰ برابری برای اطمینان از استحکام و قابلیت اطمینان الگوریتم انجام می شود. تمام لایه‌های شبکه عصبی با وزن فضایی کاملاً به هم متصل هستند و تکنیک انصراف پیشنهاد شده توسط Srivastava و همکارانش. [ ۲۷ ] برای افزایش توانایی تعمیم مدل استفاده می شود. هر لایه پنهان با تکنیک نرمال سازی دسته ای ترکیب می شود، پارامترها با استفاده از روش پیشنهادی He et al. [ ۲۸ ]، و واحد خطی تصفیه شده پارامتری به عنوان تابع فعال سازی استفاده می شود.
OLS، GWR، و GNNWR بر روی داده‌های حداکثر حداقل نرمال شده قیمت مسکن اعمال می‌شوند و اعتبارسنجی متقاطع ۱۰ برابری برای ساخت مدل‌ها روی مجموعه آموزشی انجام می‌شود، همانطور که در شکل ۳ نشان داده شده است. از نتایج مجموعه اعتبارسنجی برای محاسبه ریشه میانگین مربعات خطا (RMSE) به عنوان تابع ضرر و ارزیابی توانایی تعمیم استفاده می شود. نتیجه با بالاترین توانایی تعمیم برای سه روش انتخاب می شود و توانایی پیش بینی مدل بر روی مجموعه آزمون آزمایش می شود. از ۲۸۷۱ رکورد، ۴۳۱ (تقریباً ۱۵٪) مجموعه آزمون را تشکیل می دهند، و ۲۴۴۰ رکورد باقی مانده به طور مساوی به ۱۰ گروه (هر گروه شامل ۲۴۴ رکورد، تقریباً ۸٫۵٪) برای فرآیند اعتبار سنجی متقابل تقسیم می شوند.
با توجه به نتایج آزمایشات اولیه ( جدول ۱ )، از ساختار شبکه عصبی شش لایه ای استفاده می کنیم که شامل: یک لایه ورودی. چهار لایه پنهان با ۵۱۲، ۱۲۸، ۶۴، و ۱۶ نورون. و یک لایه خروجی تعداد نورون های لایه ورودی تعداد نمونه های آموزشی و تعداد نورون های لایه خروجی تعداد پارامترهای مدل رگرسیون خطی (تعداد متغیرهای مستقل به اضافه یک) است.
پس از چندین بار آزمایش، در فراپارامترها، مقدار نرخ یادگیری است ۱۰-۲٫۹۵≈۰٫۰۰۱۱۲،β۱=۰٫۸،β۲=۰٫۹۹۹،دسته ایاندازه=۱۲۸٫ درصد تلفات در لایه ترک تحصیل ۰٫۹ و حداکثر تعداد دوره ها ۹۰۰۰۰ است.
برای انعکاس بهینه سازی در فرآیند تکرار شونده، شکل ۴ تغییر در شاخص های تست یک برابری را در طول آموزش مدل نشان می دهد. در بیش از ۳۰۰۰۰ دوره، اگر تلفات مجموعه اعتبارسنجی پس از ۹۰۰۰ دوره کاهش نیابد، آموزش شبکه عصبی خاتمه می یابد.
برای نشان دادن برتری GNNWR، نتایج OLS، GWR و GNNWR در مجموعه داده قیمت مسکن شنژن مقایسه می‌شوند. روش GWR از روش جستجوی طلایی برای شناسایی مناسب ترین تعداد عناصر همسایه با توجه به معیار اطلاعات آکایک استفاده می کند. آمنسیج).
از آنجایی که متغیرهای NSS و QAPS معمولاً اعداد صحیح کوچک هستند، ماتریس طراحی مورد استفاده در مدل‌سازی GWR ممکن است زمانی که تعداد عناصر مجاور کم است، چند خطی بودن را نشان دهد. بنابراین، کران پایین جستجو به عنوان ۱۰۰ تنظیم می شود (یعنی حداقل ۱۰۰ عنصر همسایه در حل ضرایب رگرسیون محلی درگیر هستند).
طبق یک آزمایش اولیه ساده، تابع دو مربع به طور قابل توجهی از تابع گاوسی به عنوان تابع هسته GWR در مجموعه داده ۱۰ برابری بهتر عمل می کند. پارامترها در جدول A1 پیوست شده در پیوست A ارائه شده است. بنابراین، در تجزیه و تحلیل های بعدی، تابع دو مربع به عنوان تابع هسته وزن برای مدل GWR استفاده می شود. در آزمایش‌ها، ما از OLS به عنوان یک کنتراست ابتدایی استفاده می‌کنیم. هر دو راه حل OLS و GWR بر روی ArcGIS Pro 2.5.2 ساخته شده اند. GNNWR با استفاده از کتابخانه TensorFlow 1.15.0 تحت هسته Python 3.6.13 پیاده سازی شده است.

۳٫ نتایج

۳٫۱٫ تجزیه و تحلیل مجموعه داده ها و آمار توصیفی

جدول ۲ نتایج حاصل از تحلیل همبستگی و آمار توصیفی قیمت مسکن شنژن را با عوامل متغیر مختلف خلاصه می کند.
متغیرها را می توان به ترتیب کاهشی مقادیر مطلق ضرایب همبستگی با قیمت مسکن به صورت زیر رتبه بندی کرد: SD، MF، NSS، DSS، GR، AB، PR، QAPS و NPS. MF، NSS، GR، PR، QAPS و NPS با قیمت مسکن همبستگی مثبت دارند. و SD، DSS و AB با قیمت مسکن همبستگی منفی دارند.
آزمون فرضیه های پایه برای هر متغیر در معادله رگرسیون جهانی با استفاده از زبان R انجام می شود. ضریب هر متغیر در معادله رگرسیون جهانی صفر در نظر گرفته می‌شود و یک آماره آزمون که توزیع t را در هنگام برقراری فرضیه برآورده می‌کند، ساخته می‌شود. به همین ترتیب، مقدار p قابل محاسبه است. با این حال، می توان دریافت که p-value PR در سطح معنی داری ۰٫۰۱ و p معنی دار نیست.-مقدار QAPS در سطح معنی داری ۰٫۰۵ یا حتی ۰٫۱ معنی دار نیست. در صورت استفاده از رگرسیون جهانی، این دو متغیر مستقل باید حذف شوند. با این حال، دو روش مدل‌سازی آماری فضایی، GNNWR و GWR، آنها را در این مطالعه در نظر می‌گیرند و اهمیت هر یک از متغیرها در این مدل را می‌توان با کمک آماره F2 در پیوست B مجدداً آزمایش کرد . با توجه به تجزیه و تحلیل تشخیص غیرایستایی در پیوست B و ضمیمه C ، هر دو متغیر بسیار مهم هستند، زمانی که ضرایب مدل خطی مجاز به تغییر با مختصات جغرافیایی هستند. این نتایج نشان‌دهنده برتری رویکرد مدل‌سازی آماری فضایی نسبت به رویکردهای موجود است.

۳٫۲٫ مقایسه شاخص های مدل های ارزش گذاری قیمت مسکن

مدل ارزش گذاری قیمت مسکن با در نظر گرفتن توانایی برازش بر مجموعه آموزشی و توانایی پیش بینی بر مجموعه آزمون ارزیابی می شود. ما به طور تصادفی ۲۸۷۱ رکورد را به مجموعه های آموزشی و اعتبار سنجی (۲۴۴۰ رکورد در ۱۰ برابر) و یک مجموعه آزمایشی (۴۳۱ رکورد باقیمانده) تقسیم می کنیم.
مدل ها با توجه به R ارزیابی می شوند ۲مقدار، RMSE، میانگین خطای مطلق (MAE)، میانگین درصد مطلق خطا (MAPE)، AICc و ضریب همبستگی پیرسون. برای مجموعه داده تولید شده پس از تقاطع ۱۰ برابری، نتایج زیر پس از ادغام مجموعه های اعتبارسنجی در جدول ۳ به دست می آید .
نتایج نشان دهنده برتری مدل GNNWR است. مدل OLS بدترین پیش بینی را با کمترین R به دست می آورد ۲و بالاترین خطای پیش بینی از نظر RMSE، MAE و MAPE. با توجه به ناپایداری شدید فضایی، مدل OLS نمی تواند روابط ذاتی و نوسانات فضایی بین قیمت مسکن و متغیرهای مستقل را تشخیص دهد. RMSE و MAE مدل GNNWR به ترتیب تقریباً ۱۳٫۰% و ۱۳٫۵% کمتر از مدل GWR هستند. مدل GNNWR نیز از نظر R از مدل های موجود بهتر عمل می کند ۲و مقادیر MAPE. علاوه بر این، میانگین خطای باقیمانده مدل GNNWR 62.2 درصد کمتر از مدل GWR است، که به این معنی است که پیش‌بینی‌های آن بی‌طرف‌تر از پیش‌بینی‌های GWR در این مجموعه داده است. به طور کلی، مدل GNNWR توانایی تعمیم بهبود یافته را در مقایسه با مدل‌های دیگر نشان می‌دهد.
شاخص‌های عملکرد مدل‌های GWR و GNNWR در فرآیند مدل‌سازی در ۱۰ مجموعه آموزشی برای بررسی کیفیت برازش مقایسه می‌شوند. جدول A2 نتایج این شاخص ها را نشان می دهد.
عدد بعد از نتایج GWR به تعداد مناسب‌ترین عناصر همسایه انتخاب شده بر اساس آن اشاره دارد آمنسیجارزش. از آنجایی که مجموعه های آموزشی کمی متفاوت هستند، هر بار که مدل GWR بازسازی می شود، مناسب ترین تعداد عناصر مجاور دوباره انتخاب می شود. در نتیجه، ما از بهترین مدل GWR برای اطمینان از عادلانه بودن مقایسه‌ها استفاده می‌کنیم.
برای همه ۱۰ مجموعه داده، مدل GNNWR به طور قابل توجهی بهتر از مدل GWR برای همه شاخص ها (AICc، RMSE، R2، و ضریب همبستگی پیرسون) عمل می کند. بهبود قابل توجه در AICc نشان می‌دهد که مدل GNNWR می‌تواند با دقت بیشتری قیمت مسکن و ماتریس وزن فضا را بدون افزایش قابل توجهی در پیچیدگی پیش‌بینی کند. در مقابل، مدل GWR در برابر برازش بیش از حد آسیب‌پذیر است، که صحت پیش‌بینی‌ها را در مجموعه‌های اعتبار سنجی کاهش می‌دهد. به طور خلاصه، مدل GNNWR یک تابع هسته توانمندتر از هر مدل GWR تولید می‌کند و می‌تواند به طور موثر جزئیات ناهمگونی فضایی را ضبط کند، وزن‌های فضایی را تخمین بزند و متغیرهای وابسته را پیش‌بینی کند.
علاوه بر این، توانایی تعمیم با پیش‌بینی مجموعه آزمون ارزیابی می‌شود. در این تحلیل، نتایج مدل‌های دارای بهترین قابلیت تعمیم مقایسه شده است. هر دو مدل GNNWR و GWR زمانی که مجموعه داده ۴ به عنوان مجموعه اعتبارسنجی استفاده می شود، بالاترین عملکرد را نشان می دهند و جزئیات سایر شاخص ها در ضمیمه A جدول A3 نشان داده شده است .
مدل GNNWR در پیش‌بینی مجموعه داده آزمایشی از مدل GWR بهتر عمل می‌کند: MAE و MAPE مدل GNNWR به ترتیب ۱۰٫۲% و ۱۰٫۷% کمتر هستند. بنابراین، آژانس‌های املاک و مستغلات می‌توانند تخمین‌های دقیق‌تری نسبت به برآوردهای مرتبط با مدل GWR به دست آورند. علاوه بر این، RMSE مدل GNNWR 6.6٪ کاهش می یابد، مقدار R2 و ضریب همبستگی پیرسون افزایش می یابد، در حالی که میانگین خطا افزایش می یابد. در یک مطالعه اخیر، آزمایش‌هایی بر روی مجموعه داده‌های قیمت مسکن با استفاده از مدل شبکه عصبی مصنوعی وزن‌دار جغرافیایی (GWANN) انجام شد [ ۲۹ ]. RMSE مدل GWANN تنها ۳٫۳ درصد بهتر از مدل GWR برای بهترین دسته در هنگام پیش‌بینی قیمت مسکن بود. این نتیجه همچنین برتری چارچوب پیشنهادی را نشان می دهد.
علاوه بر این، ما برخی از آزمون فرضیه‌ها را در مورد ناایستایی فضایی در ضمیمه B و ضمیمه C انجام داده‌ایم . نتایج آزمایش‌ها و تحلیل‌های نظری اهمیت ایجاد یک مدل رگرسیون با ضرایب متنوع در میان مختصات جغرافیایی را برجسته می‌کند. ما همچنین تجزیه و تحلیل را به نتایج مدل GWR در پیوست D گسترش داده ایم . مقایسه این دو مدل نشان می‌دهد که مدل GNNWR می‌تواند ناهمگونی فضایی را با دقت بیشتری به روشی آسان تشخیص دهد.

۴٫ تحلیل تطبیقی ​​و بحث

۴٫۱٫ مقایسه عملکرد پیش بینی مدل های ارزش گذاری قیمت مسکن

نرخ خطای نسبی برای هر پیش‌بینی در مجموعه‌های اعتبارسنجی و آزمون محاسبه می‌شود. مدل‌های GWR و GNNWR با استفاده از نمودار Q-Q مانند شکل ۵ a,b که با استفاده از MATLAB مشتق شده است مقایسه می‌شوند. لازم به ذکر است که بیش از ۵ درصد از نقاط خارج از این محدوده نشان داده نمی شود.
با ترتیب دادن نرخ های خطای نسبی، می توان دریافت که رابطه بین مقدار k در مجموعه اعتبارسنجی تقریباً است. δجیدبلیوآر(ک)=۱٫۱۲۳δجینندبلیوآر(ک)+۰٫۰۰۳۳٫ رابطه بین مقدار k در مجموعه آزمایش تقریباً است δجیدبلیوآر(ک)=۱٫۱۶۰δجینندبلیوآر(ک)+۰٫۰۰۰۳٫ این خطوط مرجع که توزیع نظری را نشان می دهند دارای انحراف واضحی با y=ایکسکه ما را قادر می سازد برتری مدل های GNNWR را تایید کنیم.
هیستوگرام مدل ها در شکل ۵ c,d نشان داده شده است. در مجموعه اعتبارسنجی، تنظیم مختصات افقی هیستوگرام بین [۰،۱] و عرض bin 0.09، ۹ از ۱۱ bin با نرخ خطا کمتر یا مساوی ۹٫۹٪ شامل داده های بیشتری از مدل GNNWR است. این روند در مجموعه تست نیز مشاهده می شود. به طور مشابه، هنگامی که مختصات افقی هیستوگرام بین [۰،۱] تنظیم می شود، و عرض bin به عنوان ۰٫۱۵ تنظیم می شود، پنج مورد از هفت سطل با نرخ خطا کمتر یا مساوی ۱۰٫۵٪ داده های بیشتری از مدل GNNWR دارند.
داده های پیش بینی مجموعه های اعتبارسنجی برای هر دو مدل در شکل ۵ نشان داده شده است. تعداد نقاط داده در هر دو مجموعه زیر یک آستانه مشخص محاسبه می شود و نسبت دو عدد به صورت یک خط آبی روی نمودار رسم می شود. نسبت تعداد داده‌های پیش‌بینی‌شده از GWR به داده‌های GNNWR زمانی که میزان خطای آماری بالاتر از مقدار معینی باشد به‌عنوان خط نارنجی روی نمودار رسم می‌شود. برای داده ها (دو اجرای پیش بینی بیش از ۲۴۴۰ رکورد) با نرخ خطای نسبی کمتر از ۰٫۲۰۳، تعداد پیش بینی های GNNWR 1.34 برابر بیشتر از GWR است. در مقابل، برای داده‌هایی با نرخ خطای بالاتر از ۰٫۳۷، تعداد پیش‌بینی‌های GWR 1.62 برابر بیشتر از GNNWR است. در نتیجه، پیش‌بینی‌های GNNWR و GWR به ترتیب پیش‌بینی‌های با دقت بالا و پیش‌بینی‌های با خطای بالا را تشکیل می‌دهند.
در مقایسه با سایر آثار [ ۲۲ ]، می توان دریافت که مطالعه دیگری نیز این نتیجه را تایید می کند که GWR می تواند به طور قابل توجهی خطای پیش بینی را در مقایسه با مدل های OLS کاهش دهد، که نشان می دهد ناهمگنی فضایی وجود دارد. در مطالعه دیگری در مورد قیمت خانه شنژن، نویسندگان از مدل GWR برای افزایش R استفاده کردند ۲از ۰٫۵۶ تا ۰٫۷۹ [ ۱۲ ]. برخی از مدل‌های ساده هوش مصنوعی، مانند مدل‌های درخت تصمیم، اگر به درستی طراحی نشده باشند، حتی می‌توانند بدتر از OLS را پیش‌بینی کنند [ ۳۰ ]. در یک مطالعه جداگانه که مدل OLS را با چندین مدل مقایسه کرد، بهترین مدل ماشین بردار پشتیبان گام به گام و تنظیم شده RMSE را ۲۵% کاهش داد، مدل رگرسیون چند جمله ای RMSE را تا ۸٫۳% کاهش داد و حتی شبکه عصبی ساده بهینه انتخاب شده از ۱ را کاهش داد. -۳ لایه پنهان RMSE را ۶۶% افزایش داد [ ۳۱ ]. از دهه ۱۹۹۰، محققان سعی کرده اند از مدل های شبکه عصبی برای پیش بینی قیمت مسکن و مقایسه آنها با مدل های OLS استفاده کنند. برخی از مطالعات برتری رویکرد شبکه عصبی را نشان داده اند [ ۳۲ , ۳۳ ,۳۴ ]، اما دیگران دریافته اند که نیاز زیادی به استفاده از شبکه های عصبی وجود ندارد [ ۳۵ ، ۳۶ ]. با توجه به کاهش ۴۷ درصدی معیارهای RMSE در مقایسه با OLS در این مطالعه، به راحتی می توان دریافت که به سادگی استفاده از توابع پیچیده آموزش داده شده توسط شبکه های عصبی برای تقریب مجموعه داده آموزشی، دقت پیش بینی را بهبود نمی بخشد، و یک چارچوب مبتنی بر GWR می تواند به بهترین شکل ممکن گرفتن اطلاعات در مورد توزیع جغرافیایی اینها نشان می دهد که برآورد دقیق ناهمگونی فضایی بسیار ضروری است.
با توجه به ادبیات [ ۲۲ ]، خطای پیش بینی GWR به طور قابل توجهی کمتر از مدل های OLS است، که نشان دهنده وجود ناهمگونی فضایی است. در مطالعه ای در مورد قیمت مسکن شنژن، مدل GWR برای افزایش R مورد توجه قرار گرفت ۲از ۰٫۵۶ تا ۰٫۷۹ [ ۱۲ ]. قابل‌توجه، مدل‌های ساده هوش مصنوعی، مانند مدل‌های درخت تصمیم، در صورت طراحی نامناسب ممکن است به پیش‌بینی‌های پایین‌تری نسبت به مدل OLS دست یابند [ ۳۰ ]. در مطالعه دیگری، مدل OLS با چندین مدل مقایسه شد. در مقایسه با مدل OLS، بهترین مدل ماشین بردار پشتیبان گام به گام و تنظیم شده به RMSE 25 درصد کمتر، مدل رگرسیون چند جمله ای RMSE 8.3 درصد کمتر و شبکه عصبی ساده بهینه (انتخاب شده از چارچوب هایی با ۱ تا ۳ لایه پنهان) دست یافت. به RMSE 66% بالاتری دست یافت [ ۳۱]. از دهه ۱۹۹۰، محققان به طور مداوم سعی کرده اند از مدل های شبکه عصبی برای پیش بینی قیمت مسکن و مقایسه آنها با مدل های OLS استفاده کنند. اگرچه چندین مطالعه برتری رویکردهای شبکه عصبی [ ۳۲ ، ۳۳ ، ۳۴ ] را نشان داده‌اند، مطالعات دیگر محدودیت‌های آن‌ها را در کاربردهای خاص برجسته کرده‌اند [ ۳۵ ، ۳۶ ]]. با توجه به کاهش ۴۷ درصدی معیارهای RMSE در مقایسه با OLS در این مطالعه، به راحتی می توان دریافت که به سادگی استفاده از توابع پیچیده آموزش داده شده توسط شبکه های عصبی برای تقریب مجموعه داده آموزشی، دقت پیش بینی را بهبود نمی بخشد، و یک چارچوب مبتنی بر GWR می تواند به بهترین شکل ممکن گرفتن اطلاعات در مورد توزیع جغرافیایی این یافته ها اهمیت برآورد دقیق ناهمگونی فضایی را برجسته می کند.

۴٫۲٫ تجزیه و تحلیل متغیرهای مربوط به قیمت مسکن

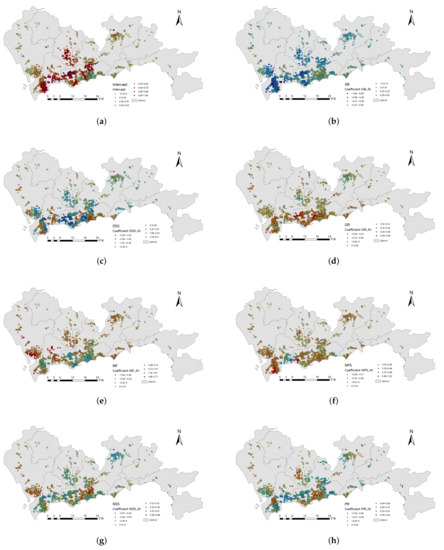
مدل GNNWR بر اساس ساختار رگرسیون خطی است که در آن ضرایب مختلف بر اساس موقعیت مکانی به متغیرهای مختلف اختصاص داده می‌شود تا ناهمگونی فضایی را به تصویر بکشد. همانطور که در شکل ۶ نشان داده شده است، برای مجموعه داده ۱۰ برابری ایجاد شده در این مطالعه، ضرایب متغیرهای مستقل مختلف در هر نقطه پیش‌بینی را می‌توان مشاهده کرد و پس از ادغام مجموعه‌های اعتبارسنجی، خروجی گرفت . در این بخش به تحلیل نوسانات این ضرایب می پردازیم.
از آنجایی که داده ها قبل از استفاده در آموزش GNNWR نرمال می شوند، مقادیر پارامترهای مختلف را می توان مستقیماً مقایسه کرد، همانطور که در جدول ۴ نشان داده شده است.. مقادیر میانگین نشان می دهد که میزان تأثیر هر متغیر مستقل بر قیمت مسکن متفاوت است و پارامترها را می توان به ترتیب نزولی مقادیر مطلق آنها به صورت زیر رتبه بندی کرد: SD، MF، AB، NPS، DSS، GR، NSS، QAPS و PR. هنگامی که ناهمگونی فضایی در نظر گرفته می شود، اثر NPS و AB بر قیمت مسکن قابل توجه تر از آن چیزی است که با استفاده از ضریب همبستگی تخمین زده می شود، و اثر NSS کمتر از آنچه با استفاده از ضریب همبستگی تخمین زده می شود قابل توجه است. روند همبستگی‌های مثبت و منفی با قیمت مسکن همانند تحلیل‌های قبلی است: MF، NPS، GR، NSS، QAPS و PR با قیمت مسکن همبستگی مثبت دارند. و SD، AB و DSS با قیمت مسکن همبستگی منفی دارند. پارامترها را می توان به ترتیب کاهشی انحراف استاندارد ضرایب به صورت زیر رتبه بندی کرد: DSS، MF، SD، AB، NSS، NPS، GR، PR و QAPS. به طور خاص، شرایط حمل و نقل عمومی و شرایط منطقه مدرسه (به ترتیب DSS و QAPS) به ترتیب بیشترین و کمترین درجه ناهمگونی فضایی را مطابق با شهود نشان می‌دهند. در یک تحلیل گسترده تر، توزیع ضرایب هر متغیر در نظر گرفته می شود، همانطور که در شکل های زیر نشان داده شده است. ارقام با استفاده از روش نقطه شکست طبیعی با محدوده های رنگی ناسازگار برای نمودارهای فرعی مختلف رسم می شوند و مرزهای نزدیک به صفر برای برجسته کردن ویژگی های همبستگی مثبت و منفی تنظیم شده اند. با توجه به انحرافات استاندارد کوچک، داده های PR و QAPS بر خلاف هشت سطح سایر متغیرها تنها در شش سطح طبقه بندی می شوند. نتایج مدل‌سازی بر اساس ۱۰ مجموعه آموزشی صاف، با جهش‌ها و نقاط پرت در مجاورت جغرافیایی است. پیش‌بینی‌ها برای توزیع ضرایب برای همه مجموعه‌ها سازگار است.
توزیع رهگیری و متغیرهای به دست آمده از GNNWR برای نشان دادن اهمیت مدل پیشنهادی در تحقیقات اجتماعی-اقتصادی مورد بررسی قرار می‌گیرد.
ابتدا، ما متغیرهای درونزا، به طور خاص، MF، AB، NPS، GR و PR را به ترتیب نزولی از تأثیر آنها بر قیمت مسکن تجزیه و تحلیل می‌کنیم.
قیمت مسکن عمدتاً با MF همبستگی مثبت دارد، با مناطق نماینده شامل جنوب غربی منطقه نانشان و سواحل جنوبی منطقه بائوان. مناطق با همبستگی منفی شامل Huanggang در منطقه Futian در امتداد مرز با هنگ کنگ است. ما حدس می زنیم که مناطق حاشیه ای ممکن است همبستگی مثبت قوی تری بین MF و قیمت مسکن نشان دهند، زیرا MF ممکن است تفاوت بین ویلاها و هتل ها، به عنوان نمونه خانه ها را مشخص کند.
افزایش AB قیمت مسکن در شنژن را محدود می کند. همبستگی منفی بین قیمت مسکن و AB در منطقه ساحلی نانشان با هسته هوهای، منطقه فوتیان مرکزی با ساحل شرقی دریاچه شیانگمی به عنوان هسته، و منطقه لانگ هوا جنوبی با ایستگاه شمالی شنژن به عنوان هسته، قوی‌ترین همبستگی است. همبستگی منفی قوی به عرضه زیاد خانه های جدید با کیفیت بالا در نزدیکی این مکان ها نسبت داده می شود، زیرا املاک قدیمی در برابر بازارهای سرد آسیب پذیر هستند. در مرز ناحیه لوهو و فوتیان، همبستگی بین AB و قیمت مسکن از منفی به مثبت تبدیل می‌شود. به گفته گودمن و همکاران. [ ۳۷]، AB بر قیمت مسکن به صورت غیر خطی تأثیر می‌گذارد، با تأثیر مثبت زمانی که AB بیشتر از یک آستانه خاص باشد، مشاهده می‌شود. مناطق شنژن که با مدل GNNWR کاوش شده‌اند، مناطقی هستند که دارای اولین ساخت‌وساز هستند و این مناطق شامل مکان‌های دیدنی معروف مانند خیابان قدیمی Dongmen و ساختمان Diwang است.
NPS و قیمت مسکن همبستگی مثبت دارند. قوی‌ترین همبستگی‌های مثبت در ناحیه مرکزی نانشان، پارک Xiangmi در ناحیه غربی Futian و در نزدیکی Caiwuwei در منطقه Luohu مشاهده شده است. انتظار می رود سهم NPS در قیمت مسکن بیشترین میزان را در مناطق مسکونی طبقه متوسط ​​و مناطق ثروتمند داشته باشد. نواحی با همبستگی مثبت قوی، که توسط مدل GNNWR بررسی شده است، با چنین مناطقی منطبق است.
افزایش GR قیمت مسکن را افزایش می دهد، به ویژه در ناحیه مرکزی Futian و منطقه مرکزی Luohu، که در بخش مرفه شهر با تقاضای بالاتر برای GR واقع شده اند. در حومه و در امتداد ساحل، GR تمایلی به افزایش قیمت مسکن ندارد و یک همبستگی منفی ضعیف در منطقه Longgang مشاهده می شود.
تغییرات در روابط عمومی کم است و تأثیر آن بر قیمت مسکن از نظر وزن متوسط ​​قابل توجه نیست. با این حال، روابط عمومی و قیمت مسکن در منطقه غربی لوهو همبستگی مثبت دارند. این یافته برخلاف تصور عمومی است، احتمالاً به این دلیل که روابط عمومی در این منطقه ارتباط نزدیکی با ظاهر کلی محله دارد. منطقه لوهو غربی منطقه شهری قدیمی شنژن است. روابط عمومی پایین نشان دهنده ویژگی قدیمی و فرسوده محله است، در حالی که روابط عمومی بالا مربوط به مسکن های بلندمرتبه جدید است. این ویژگی ها دلیل بالقوه همبستگی مثبت در این منطقه بر خلاف سایر نقاط است.
دوم، ما تأثیر متغیرهای محیطی، به طور خاص، SD، DSS، NSS، و QASP را به ترتیب نزولی از تأثیر آنها بر قیمت مسکن بررسی می‌کنیم.
قیمت SD و مسکن با مناطق معمولی از جمله بیشتر مناطق نانشان و لوهو همبستگی منفی دارند. علاوه بر این، یک همبستگی منفی در قطعات داخلی خاص، مانند بخش جنوبی منطقه Longgang و لبه شمالی منطقه Luohu مشاهده می شود. این همبستگی به این واقعیت نسبت داده می شود که SD فاصله از منطقه مرکزی شهری را مشخص می کند.
همبستگی بین DSS و قیمت مسکن به طور قابل توجهی در نوسان است. به طور کلی، فاصله بیشتر از مترو به کاهش قیمت مسکن مربوط می شود. با این حال، یک همبستگی مثبت در منطقه Futian جنوب شرقی، منطقه Luohu جنوبی و منطقه Nanshan جنوبی مشاهده می شود. قابل ذکر است که این مناطق با تمرکز اشتغال بالا مطابقت دارند. منطقه جنوب شرقی Futian بازار Huaqiang North را در خود جای داده است که یکی از بزرگترین بازارهای توزیع قطعات تلفن همراه در سراسر جهان است. مناطق جنوبی لوهو و نانشان به ترتیب دارای منطقه صنعتی روستای شین شیو و منطقه صنعتی شکو هستند. در نتیجه، استنباط های زیر را می توان استخراج کرد: در مناطق مسکونی و حومه شهر، DSS کوچکتر با رفت و آمد راحت تر و در نتیجه قیمت مسکن بالاتر مطابقت دارد. در مقابل، در مناطقی با ورودی مترو متراکم، مانند مناطق تجاری مرکزی یا مناطق صنعتی، DSS بزرگتر ممکن است قیمت مسکن را کاهش دهد. افرادی که در این محله خانه می خرند از قبل به محل کار خود نزدیک شده اند. بنابراین، نیاز به رفت و آمد از طریق کانال های مترو ناچیز است. نزدیکی به ورودی مترو ممکن است باعث تشدید صدا و ازدحام شود.
NSS و قیمت مسکن همبستگی مثبت دارند. برای مناطق Nanshan، Futian و Luohu، توزیع همبستگی های مثبت و منفی برعکس توزیع DSS است. این نتیجه، حدس فوق را تأیید می کند.
QASP و قیمت مسکن همبستگی ضعیفی دارند. به جز منطقه غربی لوهو، که در آن قیمت مسکن به شدت با QASP همبستگی مثبت دارد، تأثیر QASP در سایر مناطق در شنژن قابل توجه نیست. منطقه غربی لوهو نشان‌دهنده شهر قدیمی شنژن است و مناطق مسکونی قدیمی با توجه به مناطق بالغ مدرسه مطلوب هستند که در نتیجه یک همبستگی مثبت قوی ایجاد می‌شود. در مقابل، مسکن جدید با کیفیت بالا در منطقه جدید دارای یک منطقه مدرسه ثابت نیست و قیمت مسکن تحت سلطه عوامل دیگر است. در نتیجه، نفوذ منطقه مدرسه ضعیف است.
توزیع رهگیری ها در مدل رگرسیون را می توان به طور موثر توضیح داد. رهگیری نشان دهنده حق بیمه ذاتی خانه پس از در نظر گرفتن تمام اثرات متغیرهای مستقل است. شکل ۶نشان می دهد که با توجه به قیمت های مرجع برای معاملات مسکن دست دوم معرفی شده توسط دولت، بالاترین حق بیمه ذاتی مربوط به ساحل منطقه نانشان با هوهای به عنوان هسته و وسط منطقه فوتیان با ساحل شرقی دریاچه شیانگمی به عنوان هسته است. . بازار دیوانه وار تلاش می کند تا از کمبود مکان های ممتاز استفاده کند و حق بیمه های بالاتری را به مناطق فوق الذکر اختصاص دهد. در سال ۲۰۲۰، بالاترین قیمت معاملات مسکونی برای این دو سایت (۵۰،۰۰۰ تا ۷۰،۰۰۰ دلار در هر متر مربع) رکورد جدیدی را برای قیمت مسکن در شنژن ایجاد کرد و قیمت‌های مسکن حاشیه‌ای بین ۱۰،۰۰۰ تا ۲۰،۰۰۰ دلار بود. در این زمینه، قیمت‌های مرجع تعریف‌شده توسط دولت به بازتاب توزیع ذاتی حق بیمه و کاهش شکاف بین حق بیمه‌های ذاتی کمک کرد. به همین ترتیب،
توابع رگرسیون مدل‌های GNNWR و GWR مشابه هستند که مدل پیشنهادی را تأیید می‌کند. با این حال، مدل GWR با خطاهای بالاتری همراه است. این تحلیل ها ارزش مدل ارزش گذاری پیشنهادی را در تحقیقات اجتماعی-اقتصادی برجسته می کند.

۵٫ نتیجه گیری ها

بر اساس داده‌های قیمت مسکن شنژن، ما برتری مدل GNNWR را نسبت به مدل‌های OLS و GWR در ارزیابی قیمت نشان می‌دهیم. ما یک رویکرد اعتبار سنجی ۱۰ برابری را معرفی می کنیم و با انجام پیش بینی برای ۱۰ دهم از داده ها در هر برابر، نتایج زیر را به دست می آوریم. RMSE مدل GNNWR به ترتیب ۱۳ و ۴۷ درصد کمتر از مدل های GWR و OLS است. علاوه بر این، GNNWR از نظر سایر معیارها از استراتژی های GWR و OLS بهتر عمل می کند. استحکام مدل GNNWR به صورت تجربی ارزیابی می‌شود. مکانیسم اعتبارسنجی ۱۰ برابری از تداخل تصادفی جلوگیری می کند و نتایج آزمایش بر روی مجموعه آزمون اعتبار مدل پیشنهادی را نشان می دهد. آزمون فرضیه برای تجزیه و تحلیل اهمیت ناهمگونی فضایی انجام می شود. متریک AICc برای مجموعه آموزشی نشان می‌دهد که افزایش دقت برازش مدل GNNWR در مقایسه با مدل GWR (که ناهمگونی فضایی را نیز مدل‌سازی می‌کند) به طور قابل‌توجهی بزرگتر از افزایش پیچیدگی عملکرد هسته است. بنابراین، مدل GNNWR بسیار قوی است. مدل GNNWR در زمینه ناهمگونی فضایی شنژن، توانایی عالی اطلاعات کاوی را نشان می‌دهد.
مشارکت های این مطالعه را می توان به شرح زیر خلاصه کرد. اول، ماتریس وزن فضایی می تواند به اندازه کافی ویژگی های مجموعه داده را منعکس کند. در مقابل، GWR، به عنوان یک روش مدل‌سازی نسبتاً سنتی برای تحلیل فضایی، معمولاً از توابع هسته استفاده می‌کند که انتخاب‌های آن‌ها برای مثال به توابع گاوسی و دو مربعی محدود می‌شود. بنابراین، عملکرد چارچوب های GWR محدود است. دوم، چارچوب پیشنهادی با اصلاح فرآیند آزمایش و کاهش خاصیت جعبه سیاه، بر محدودیت‌های مشابه روش‌های موجود غلبه می‌کند. به طور خاص، مدل GNNWR از شبکه عصبی فقط برای تناسب با عملکرد هسته با دقت بیشتری نسبت به آنچه با استفاده از GWR قابل دستیابی است استفاده می کند و چارچوب معقول GWR (یعنی رگرسیون وزنی فضایی) را ذخیره می کند. از این رو، تابع هسته در مدل GNNWR یک تابع خطی ساده یا یک تابع نمایی پیشینی مشابه آنچه توسط GWR استفاده می شود نیست. در عوض، تابع هسته همبستگی کلی بین فواصل مکانی و وزن را روشن می کند و از داده ها از طریق هوش مصنوعی یاد می گیرد. سوم، مدل ارزشیابی پیشنهادی می‌تواند مختصات جغرافیایی را در مقایسه با سایر روش‌های پیش‌بینی شبکه عصبی که اطلاعات موقعیت جغرافیایی کمتری را در نظر می‌گیرند و در نتیجه عملکردهای ناپایدار را نشان می‌دهند، به طور مؤثرتری تفسیر کند. اگرچه پیش‌بینی‌های شبکه عصبی دقیق‌تر از مدل‌های OLS هستند. تابع هسته همبستگی کلی بین فواصل مکانی و وزن را روشن می کند و از داده ها از طریق هوش مصنوعی آموخته می شود. سوم، مدل ارزشیابی پیشنهادی می‌تواند مختصات جغرافیایی را در مقایسه با سایر روش‌های پیش‌بینی شبکه عصبی که اطلاعات موقعیت جغرافیایی کمتری را در نظر می‌گیرند و در نتیجه عملکردهای ناپایدار را نشان می‌دهند، به طور مؤثرتری تفسیر کند. اگرچه پیش‌بینی‌های شبکه عصبی دقیق‌تر از مدل‌های OLS هستند. تابع هسته همبستگی کلی بین فواصل مکانی و وزن را روشن می کند و از داده ها از طریق هوش مصنوعی آموخته می شود. سوم، مدل ارزشیابی پیشنهادی می‌تواند مختصات جغرافیایی را در مقایسه با سایر روش‌های پیش‌بینی شبکه عصبی که اطلاعات موقعیت جغرافیایی کمتری را در نظر می‌گیرند و در نتیجه عملکردهای ناپایدار را نشان می‌دهند، به طور مؤثرتری تفسیر کند. اگرچه پیش‌بینی‌های شبکه عصبی دقیق‌تر از مدل‌های OLS هستند.۳۲ ، ۳۳ ، ۳۴ ] در این مطالعه، چندین مطالعه تاکید کرده اند که مدل های شبکه عصبی اغلب از مدل OLS و انواع بهبود یافته آن بهتر عمل نمی کنند (به عنوان مثال، مدل های لذت جو که متغیر وابسته را از طریق مدل های log و رگرسیون چند جمله ای تصحیح می کنند) [ ۳۵ ، ۳۶ ]. با این وجود، RMSE چند مدل شبکه عصبی بیش از ۳۰ درصد کمتر از مدل های OLS است.
مدل GNNWR از زمان ابداع آن در حوزه اقتصادی-اجتماعی به کار نرفت و ما این شکاف را پر می کنیم. برای پرداختن به مشکل پیش‌بینی قیمت مسکن، روش‌های پیشرفته معمولاً مدل GWR را به شیوه‌ای درشت اصلاح می‌کنند تا اطلاعات مکانی را بهتر درک کنند. وضوح تصویر به خوبی مدل GNNWR نیست. در کارهای رایج پیش‌بینی قیمت مسکن، به‌عنوان مثال، در رقابت‌های کاگل، داده‌های ورودی فاقد مختصات جغرافیایی هستند تا از گیج شدن داده‌ها در شبکه‌های عصبی و مدل‌های درخت تصمیم جلوگیری کنند [ ۳۸ ، ۳۹ ]. فقط چند مدل شبکه عصبی [ ۲۹] هنگام برخورد با مختصات جغرافیایی عملکرد بالایی از خود نشان می دهند. مدل پیشنهادی از مدل‌های موجود بهتر عمل می‌کند زیرا ما مدل‌های GWR و شبکه عصبی را ترکیب می‌کنیم. به طور خاص، ما از چارچوب GWR برای درک مختصات مکانی و غلبه بر محدودیت های مرتبط با عملکرد هسته با استفاده از یک شبکه عصبی بهره برداری می کنیم. تحقیقات آینده را می توان بر جنبه های زیر متمرکز کرد. ابتدا خصوصیات خطی، همسویی، استقلال و نرمال بودن عبارت خطا در مدل خطی بررسی می شود. اگر این جنبه ها برآورده نشد، متغیر وابسته را می توان با استفاده از روش باکس-کاکس پیش پردازش کرد. دوم، متغیرهای مستقل بیشتری را می توان برای گسترش انتخاب متغیرهای مستقل در نظر گرفت. سوم، آزمایش‌های قابل مقایسه را می‌توان بر روی سایر مجموعه‌های داده انجام داد،

اختصارات

در این نسخه از اختصارات زیر استفاده شده است:

OLS حداقل مربعات معمولی
GWR رگرسیون وزنی جغرافیایی
GNNWR رگرسیون وزنی شبکه عصبی جغرافیایی

ضمیمه A. جداول مربوط به نتایج آزمایش

جدول A1. عملکرد مدل GWR برای انواع مختلف هسته.
جدول A2. شاخص‌های GWR و GNNWR روی مجموعه‌های قطار.
جدول A3. پیش بینی عملکرد ۱۰ مدل GNNWR برای هر مجموعه اعتبار سنجی.

ضمیمه B. شاخص های آمار آزمون معناداری برای ناپایداری فضایی

برای آزمایش اینکه آیا یک رابطه غیرایستایی فضایی قابل توجهی را نشان می‌دهد، ما آزمایش‌های معناداری نتایج مدل‌سازی GNNWR و GWR را با استفاده از مجموع مربع‌های باقی‌مانده و توزیع تقریبی آن استنتاج شده توسط Leung و همکاران انجام می‌دهیم. [ ۴۰ ] و دو و همکاران. [ ۱۹ ]. ما فرمول مدل GNNWR را به عنوان مثال ارائه می کنیم. عبارت GWR می تواند به طور مشابه مشتق شود.

ابتدا، ماتریس کلاه GNNWR به صورت زیر بیان می شود:

اسجینندبلیوآر≜ایکس۱تیدبلیو(تو۱،v1)(ایکستیایکس)-۱ایکستیایکس۲تیدبلیو(تو۲،v2)(ایکستیایکس)-۱ایکستی⋮ایکسnتیدبلیو(توn،vn)(ایکستیایکس)-۱ایکستی
δمن≜تیr{[(من-اس)تی(من-اس)]من}،من=۱،۲⋯

کمیت های آماری اف۱به صورت زیر بدست می آید:

اف۱=آراساسجینندبلیوآر/δ۱آراساسOLاس/(n-پ-۱)
توزیع از اف۱را می توان به عنوان توزیع F تقریب زد، که در آن δ۱۲δ۲درجه آزادی صورتگر است و n-پ-۱درجه آزادی مخرج است. یعنی با توجه به سطح معناداری α، اگر نابرابری اف۱<اف۱-α(δ۱۲δ۲،n-پ-۱)می توان تشخیص داد که رابطه رگرسیون دارای عدم همواری فضایی معنی دار است، در غیر این صورت عدم همواری فضایی معنی دار نیست.

دوم، اهمیت ناپایداری فضایی را نیز می توان برای هر متغیر مستقل تأیید کرد. فرض صفر این است که ضرایب این متغیر مستقل در تمام نقاط فضا هستند. فرضیه جایگزین این است که ضرایب این متغیر مستقل حداقل در یک نقطه در هر قسمت از فضا متفاوت است. ابتدا واریانس ضرایب k امین متغیر مستقل را بر روی n نقطه داده تعریف می کنیم.

Vک۲≜۱n∑من=۱n(β^منک-۱n∑من=۱nβ^منک)۲

علاوه بر این، ما تعریف می کنیم هکبه عنوان یک بردار رتبه n با (ک+۱)عنصر ام ۱ و مجموعه دیگر ۰ است. یک ماتریس مربع از مرتبه n ایجاد می شود که هر عنصر به عنوان ۱ تنظیم می شود.

بک≜هکتیدبلیو(تو۱،v1)(ایکستیایکس)-۱ایکستیهکتیدبلیو(تو۲،v2)(ایکستیایکس)-۱ایکستی⋮هکتیدبلیو(توn،vn)(ایکستیایکس)-۱ایکستی
γمنک≜تیr{[1nبکتی(من-۱nجی)بک]من}،من=۱،۲⋯

کمیت های آماری اف۲به صورت زیر بدست می آید:

اف۲(ک)=Vک۲/γ۱کσ^۲
توزیع از اف۲(ک)را می توان به عنوان توزیع F تقریب زد، که در آن σ^۲میانگین مربعات خطا است، γ۱ک۲γ۲کدرجه آزادی صورتگر است و δ۱۲δ۲درجه آزادی مخرج است. یعنی با توجه به سطح معناداری α، اگر نابرابری اف۲(ک)>افα(γ۱ک۲γ۲ک،δ۱۲δ۲)درست است، فرضیه صفر را می توان رد کرد و متغیر k تعیین می شود که غیر ایستایی فضایی قابل توجهی دارد، در غیر این صورت غیر ایستایی فضایی معنی دار نیست.

پیوست ج. تشخیص غیرایستایی فضایی رابطه رگرسیون قیمت خانه

بر اساس شاخص های تشخیصی ناهمگونی فضایی، نتایج GNNWR را می توان با در نظر گرفتن دو جنبه تجزیه و تحلیل کرد.
ابتدا، بررسی می کنیم که آیا نتایج مدل دارای عدم همواری فضایی قابل توجهی هستند یا خیر. برای داده های ۱۰ برابری، پارامترهای اثر پیش بینی هر مدل GNNWR در مجموعه اعتبارسنجی در جدول A3 ارائه شده است. با استفاده از RMSE به عنوان شاخص، بهترین مدل برازش (مدل ۴) و بدترین مدل برازش (مدل ۳) برای آزمون فرضیه انتخاب شدند. پارامترهای آزمون فرضیه از اشتقاق قبلی به صورت جدول A4 زیر تعیین می شوند .
جدول A4. ۱ آزمون فرضیه.
پس از تعیین اف۱مقدار و توزیع F، p-value برای فرضیه قابل محاسبه است. نتایج نشان می‌دهد که این فرضیه رد می‌شود و ناپایداری مکانی شدید در مدل‌سازی قیمت خانه شنژن وجود دارد.
در مرحله بعد، ما اهمیت را برای هر متغیر مستقل تجزیه و تحلیل می کنیم. فرض صفر این است که ضریب هر متغیر مستقل ثابت است. این فرضیه شامل فرضیه دیگری نیز می شود که ضریب این متغیر در همه جا صفر است. در این زمینه، p -value of اف۲اگر به اندازه کافی کوچک باشد، می تواند هر دو فرضیه را رد کند. نتایج در جدول A5 ارائه شده است.
جدول A5. ۲ آزمون فرضیه.
هر متغیر مستقل به طور قابل‌توجهی بر قیمت مسکن تأثیر می‌گذارد، اما درجه تأثیرگذاری در مناطق مختلف متفاوت است، که نشان‌دهنده ناپایداری فضایی قابل توجه است. این مقایسه ساده نشان می‌دهد که یک مدل بهتر ممکن است به تخمین غیرایستایی فضایی بالاتر برای متغیرها و برآورد غیرایستایی فضایی کمتر برای رهگیری نیاز داشته باشد.

ضمیمه D. مقایسه ضرایب GNNWR و GWR

برای مقایسه مدل‌های GNNWR و GWR، ما نتایج GWR را که با استفاده از ArcGIS Pro با گروهی از پارامترها اجرا شده است، تجسم می‌کنیم که منجر به بهترین عملکرد برازش در همه داده‌ها می‌شود. ضرایب متغیرهای مستقل مختلف در هر نقطه پیش بینی برای مدل GWR در شکل A1 نشان داده شده است و ویژگی های آماری ضرایب مختلف در جدول A6 آمده است. برای اکثر متغیرها به جز QAPS و SD، توزیع وزن GNNWR ( شکل ۶ ) مشابه GWR است ( شکل A1).). ضرایب GWR معمولاً نسبت به مدل GNNWR ناگهانی‌تر نوسان می‌کند. برای چندین متغیر مهم مانند SD، intercept و DSS، مدل GNNWR توزیع نرم‌تری را در مقایسه با GWR ارائه می‌کند. وقتی از مدل GWR استفاده می‌شود، خوشه‌ها و توده‌ها رشد می‌کنند و مشخصه نامطلوب توزیع ضریب روی صفر قابل توجه‌تر می‌شود.
جدول A6 و جدول ۴ نشان می دهد که GNNWR از نظر ویژگی های آماری بهتر از مدل GWR عمل می کند. تفاوت در انحراف معیار متغیرهایی مانند AB، NPS، MF، GR، PR و NSS کمتر از ۰٫۰۲ است که به معنای مشابه بودن درجات نوسانات این متغیرها است. با این حال، انحراف استاندارد سایر متغیرها برای GWR 2 تا ۴ برابر بزرگتر از متغیرهای GNNWR است. این یافته نشان می‌دهد که GNNWR ناهمگونی فضایی را به روشی دقیق‌تر و آسان‌تر مدل‌سازی می‌کند و در مقایسه با مدل GWR کمتر مستعد بیش‌برازش است.
علاوه بر این، تفاوت در توزیع ضرایب SD منعکس کننده محدودیت های مدل GWR است. تابع هسته GWR به شرایط پیشینی نیاز دارد، مانند الگوهای کاهش همبستگی دو مربعی یا نمایی، که به دلیل آن ضرایب مشابه در خوشه‌ها توزیع می‌شوند. قابل توجه است که متغیر SD فاصله از خط ساحلی را مشخص می کند، به این معنی که توزیع وزن SD ممکن است شباهت بیشتری در جهت موازی با خط ساحلی نسبت به جهت عمود بر خط ساحلی داشته باشد. از نظر تئوری، توزیع ضریب باید به صورت نواری موازی با خط ساحلی ظاهر شود. نتایج واقعی نیز با حدس و گمان ما سازگار است، با نتایج GWR شبیه توده ها، و نتایج GNNWR شبیه نوارهای موازی با خط ساحلی.
بنابراین، نتایج مقایسه، استحکام بالای GNNWR را نشان می‌دهد.
جدول A6. آمار توصیفی ضرایب متغیر از GWR.
شکل A1. ضریب توزیع وزن متغیرها برای مدل GWR. ( الف ) رهگیری؛ ( ب ) سن ساختمان (AB). ( ج ) فاصله تا نزدیکترین ایستگاه مترو (DSS)؛ ( د ) نسبت سبز (GR); ( ه ) هزینه مدیریت (MF). ( f ) تعداد نقاط پارکینگ (NPS). ( g ) تعداد ایستگاه های مترو در شعاع ۱ کیلومتری (NSS). ( h ) نسبت قطعه (PR); ( i ) کیفیت مدارس دولتی موجود (QAPS). ( j ) فاصله دریا (SD).

منابع

  1. شاخص قیمت فروش مسکن دست دوم برای ۷۰ شهر بزرگ و متوسط ​​در ماه می ۲۰۲۱٫ املاک چین ۲۰۲۱ ۸۰٫ (به زبان چینی)
  2. روزن، اس. قیمت لذت‌بخش و بازارهای ضمنی: تمایز محصول در رقابت خالص. ج. اقتصاد سیاسی. ۱۹۷۴ ، ۸۲ ، ۳۴-۵۵٫ [ Google Scholar ] [ CrossRef ]
  3. Butler, RV مشخصات شاخص‌های لذت‌بخش برای مسکن شهری. اقتصاد زمین ۱۹۸۲ ، ۵۸ ، ۹۶-۱۰۸٫ [ Google Scholar ] [ CrossRef ]
  4. Mok، HM; چان، پی پی. Cho, YS یک مدل قیمت لذت بخش برای املاک خصوصی در هنگ کنگ. جی. امور مالی املاک و مستغلات. اقتصاد ۱۹۹۵ ، ۱۰ ، ۳۷-۴۸٫ [ Google Scholar ] [ CrossRef ]
  5. باسو، س. Thibodeau، TG تجزیه و تحلیل خودهمبستگی فضایی در قیمت مسکن. جی. امور مالی املاک و مستغلات. اقتصاد ۱۹۹۸ ، ۱۷ ، ۶۱-۸۵٫ [ Google Scholar ] [ CrossRef ]
  6. گلوماک، بی. هررا-گومز، م. لیچرون، جی. شاخص قیمت زمین شهری لذت‌بخش. سیاست کاربری زمین ۲۰۱۹ ، ۸۱ ، ۸۰۲-۸۱۲٫ [ Google Scholar ] [ CrossRef ]
  7. Fotheringham، AS; براندون، سی. چارلتون، ام. رگرسیون وزن‌دار جغرافیایی: تحلیل روابط متغیر فضایی . جان وایلی و پسران: هوبوکن، نیوجرسی، ایالات متحده آمریکا، ۲۰۰۳٫ [ Google Scholar ]
  8. براندون، سی. Fotheringham، AS; چارلتون، ME رگرسیون وزن‌دار جغرافیایی: روشی برای کاوش غیرایستایی فضایی. Geogr. مقعدی ۱۹۹۶ ، ۲۸ ، ۲۸۱-۲۹۸٫ [ Google Scholar ] [ CrossRef ]
  9. Tobler, WR یک فیلم کامپیوتری شبیه سازی رشد شهری در منطقه دیترویت. اقتصاد Geogr. ۱۹۷۰ ، ۴۶ ، ۲۳۴-۲۴۰٫ [ Google Scholar ] [ CrossRef ]
  10. براندون، سی. Fotheringham، AS; چارلتون، ام. نکاتی در مورد آزمون‌های اهمیت پارامتریک برای رگرسیون وزن‌دار جغرافیایی. J. Reg. علمی ۱۹۹۹ ، ۳۹ ، ۴۹۷-۵۲۴٫ [ Google Scholar ] [ CrossRef ]
  11. تو، دبلیو. کائو، آر. یو، ی. ژو، بی. لی، کیو. لی، کیو. تغییرات فضایی در رفت و آمدهای عمومی شهری به دست آمده از مسیرهای GPS و داده های کارت هوشمند. J. Transp. Geogr. ۲۰۱۸ ، ۶۹ ، ۴۵-۵۷٫ [ Google Scholar ] [ CrossRef ]
  12. گنگ، جی. کائو، ک. یو، ال. تانگ، ی. تحلیل فضایی مبتنی بر مدل رگرسیون وزن‌دار جغرافیایی (GWR) قیمت خانه در شنژن. در مجموعه مقالات نوزدهمین کنفرانس بین المللی ژئوانفورماتیک ۲۰۱۱، شانگهای، چین، ۲۴ تا ۲۶ ژوئن ۲۰۱۱٫ صص ۱-۵٫ [ Google Scholar ]
  13. ژانگ، اس. وانگ، ال. لو، اف. بررسی اجاره مسکن با رگرسیون ترکیبی وزن‌دار جغرافیایی: مطالعه موردی در نانجینگ. ISPRS Int. J. Geo-Inf. ۲۰۱۹ ، ۸ ، ۴۳۱٫ [ Google Scholar ] [ CrossRef ]
  14. لو، بی. چارلتون، ام. هریس، پی. Fotheringham، AS رگرسیون وزنی جغرافیایی با متریک فاصله غیر اقلیدسی: مطالعه موردی با استفاده از داده های قیمت خانه لذت بخش. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۴ ، ۲۸ ، ۶۶۰-۶۸۱٫ [ Google Scholar ] [ CrossRef ]
  15. لو، بی. چارلتون، ام. Fotheringhama، AS رگرسیون وزن‌دار جغرافیایی با استفاده از متریک فاصله غیراقلیدسی با مطالعه روی داده‌های قیمت مسکن لندن. Procedia Environ. علمی ۲۰۱۱ ، ۷ ، ۹۲-۹۷٫ [ Google Scholar ] [ CrossRef ]
  16. Limsombunchai، V. پیش بینی قیمت خانه: مدل قیمت لذت بخش در مقابل شبکه عصبی مصنوعی. در مجموعه مقالات کنفرانس انجمن اقتصاد کشاورزی و منابع نیوزیلند، بلنهایم، نیوزلند، ۲۵-۲۶ ژوئن ۲۰۰۴٫ صص ۲۵-۲۶٫ [ Google Scholar ]
  17. سلیم، H. عوامل تعیین کننده قیمت خانه در ترکیه: رگرسیون لذت در مقابل شبکه عصبی مصنوعی. سیستم خبره Appl. ۲۰۰۹ ، ۳۶ ، ۲۸۴۳-۲۸۵۲٫ [ Google Scholar ] [ CrossRef ]
  18. مک کلاسکی، دبلیو. دیویس، پی. هاران، م. مک کورد، ام. McIlhatton، D. پتانسیل شبکه های عصبی مصنوعی در ارزیابی انبوه: مورد مورد بازبینی مجدد. جی. فاینانس. مدیریت ساخت و ساز ۲۰۱۲ ، ۳ ، ۲۷۴-۲۹۲٫ [ Google Scholar ] [ CrossRef ]
  19. دو، ز. وانگ، ز. وو، اس. ژانگ، اف. لیو، آر. رگرسیون وزنی شبکه عصبی جغرافیایی برای تخمین دقیق عدم ایستایی فضایی. بین المللی جی. جئوگر. Inf. علمی ۲۰۲۰ ، ۳۴ ، ۱۳۵۳-۱۳۷۷٫ [ Google Scholar ] [ CrossRef ]
  20. واسوانی، ع. Shazeer, N. پارمار، ن. Uszkoreit، J. جونز، ال. گومز، AN; قیصر، Ł. Polosukhin، I. توجه شما تمام چیزی است که نیاز دارید. در مجموعه مقالات پیشرفت‌ها در سیستم‌های پردازش اطلاعات عصبی، لانگ بیچ، کالیفرنیا، ایالات متحده آمریکا، ۴ تا ۹ دسامبر ۲۰۱۷؛ جلد ۳۰٫ [ Google Scholar ]
  21. وو، اس. دو، ز. وانگ، ی. لین، تی. ژانگ، اف. لیو، آر. مدل‌سازی فرآیندهای غیر ایستا ناهمسانگرد فضایی در محیط‌های ساحلی بر اساس رگرسیون وزنی شبکه عصبی جغرافیایی جهت‌دار. علمی کل محیط. ۲۰۲۰ , ۷۰۹ , ۱۳۶۰۹۷٫ [ Google Scholar ] [ CrossRef ]
  22. دو، ز. وو، اس. وانگ، ز. وانگ، ی. ژانگ، اف. لیو، آر. برآورد غلظت PM2.5 سطح زمین در سراسر چین با استفاده از رگرسیون وزنی شبکه عصبی جغرافیایی. J. Geo-Inf. علمی ۲۰۲۰ ، ۲۲ ، ۱۲۲-۱۳۵٫ [ Google Scholar ]
  23. بنسیا، ا. Funtowicz، S. برادشاو، جی. فری، اف. راز-لونا، EF; مدینه، CP ترکیبی از پایداری: به سوی یک عمل جدید برای مخمصه فعلی بشر. حفظ کنید. علمی ۲۰۱۲ ، ۷ ، ۷۵-۸۹٫ [ Google Scholar ] [ CrossRef ]
  24. Renigier-Biłozor، M.; اشروبک، اس. والاچیک، م. Janowski، A. ترکیبی از روش های ارزش گذاری به عنوان دارویی که از بازار املاک و مستغلات و توسعه کاربری پایدار زمین در طول همه گیری کووید-۱۹ و پس از آن حمایت می کند. خط‌مشی استفاده از زمین ۲۰۲۰ ، ۹۹ ، ۱۰۵۰۷۰٫ [ Google Scholar ] [ CrossRef ]
  25. ز، د. Z، W. S, W. GNNWR: روشی موثر برای تحلیل و پیش‌بینی ناپایداری فضایی با ترکیب شبکه‌های عصبی عمیق و حداقل مربعات معمولی. IEEE Trans. شبکه عصبی فرا گرفتن. سیستم ۲۰۱۸ ، ۱۸۵-۱۹۹٫ [ Google Scholar ]
  26. Fotheringham، AS; چارلتون، ام. Brunsdon، C. اندازه گیری تغییرات فضایی در روابط با رگرسیون وزنی جغرافیایی. در تحولات اخیر در تحلیل فضایی ; Springer: برلین/هایدلبرگ، آلمان، ۱۹۹۷; صص ۶۰-۸۲٫ [ Google Scholar ]
  27. سریواستاوا، ن. هینتون، جی. کریژفسکی، آ. سوتسکور، آی. Salakhutdinov, R. Dropout: یک راه ساده برای جلوگیری از برازش بیش از حد شبکه های عصبی. جی. ماخ. فرا گرفتن. Res. ۲۰۱۴ ، ۱۵ ، ۱۹۲۹-۱۹۵۸٫ [ Google Scholar ]
  28. او، ک. ژانگ، ایکس. رن، اس. Sun, J. عمیق در یکسو کننده ها: پیشی گرفتن از عملکرد سطح انسانی در طبقه بندی شبکه تصویری. در مجموعه مقالات کنفرانس بین المللی IEEE در بینایی کامپیوتر، سانتیاگو، شیلی، ۷ تا ۱۳ دسامبر ۲۰۱۵٫ ص ۱۰۲۶-۱۰۳۴٫ [ Google Scholar ]
  29. هاگناور، جی. Helbich، M. یک شبکه عصبی مصنوعی وزن جغرافیایی. بین المللی جی. جئوگر. Inf. علمی ۲۰۲۲ ، ۳۶ ، ۲۱۵-۲۳۵٫ [ Google Scholar ] [ CrossRef ]
  30. تامارای، م. ملارویزی، اس. مدل‌سازی پیش‌بینی قیمت خانه با استفاده از یادگیری ماشین. بین المللی J. Inf. مهندس الکترون. اتوبوس. ۲۰۲۰ ، ۱۲ ، ۱۵-۲۰٫ [ Google Scholar ] [ CrossRef ]
  31. Phan، TD پیش‌بینی قیمت مسکن با استفاده از الگوریتم‌های یادگیری ماشین: مورد شهر ملبورن، استرالیا. در مجموعه مقالات کنفرانس بین المللی ۲۰۱۸ در زمینه یادگیری ماشین و مهندسی داده (iCMLDE)، سیدنی، استرالیا، ۳ تا ۷ دسامبر ۲۰۱۸؛ صص ۳۵-۴۲٫ [ Google Scholar ]
  32. پترسون، اس. Flanagan، A. مدل‌های قیمت‌گذاری لذت‌گرایانه شبکه عصبی در ارزیابی انبوه املاک و مستغلات. J. Real Estate Res. ۲۰۰۹ ، ۳۱ ، ۱۴۷-۱۶۴٫ [ Google Scholar ] [ CrossRef ]
  33. نگیپ، ن. Al، C. پیش بینی ارزش مسکن: مقایسه تحلیل رگرسیون چندگانه و شبکه های عصبی مصنوعی. J. Real Estate Res. ۲۰۰۱ ، ۲۲ ، ۳۱۳-۳۳۶٫ [ Google Scholar ] [ CrossRef ]
  34. Lin، CC; موهان، SB مقایسه اثربخشی روش‌های ارزیابی انبوه املاک مسکونی در ایالات متحده آمریکا. بین المللی جی. هاوس. علامت. مقعدی ۲۰۱۱ ، ۳ ، ۲۲۴-۲۴۳٫ [ Google Scholar ]
  35. مک گریل، اس. ادیر، ا. مک برنی، دی. پترسون، دی. شبکه های عصبی: پیش بینی ارزش های مسکونی. J. Prop. Valuat. سرمایه گذاری. ۱۹۹۸ ، ۱ ، ۵۷-۷۰٫ [ Google Scholar ] [ CrossRef ]
  36. Rossini, P. کاربرد شبکه های عصبی مصنوعی در ارزیابی املاک مسکونی. در مجموعه مقالات سومین کنفرانس سالانه انجمن املاک و مستغلات اقیانوس آرام، پالمرستون شمالی، نیوزلند، ۲۰ تا ۲۲ ژانویه ۱۹۹۷٫ [ Google Scholar ]
  37. گودمن، ای سی؛ Thibodeau، TG ناهمگونی مرتبط با سن در معادلات قیمت خانه لذت بخش. جی. هاوس. Res. ۱۹۹۵ ، ۶ ، ۲۵-۴۲٫ [ Google Scholar ]
  38. وارما، ا. سرما، ع. دوشی، س. نیر، آر. پیش‌بینی قیمت خانه با استفاده از یادگیری ماشین و شبکه‌های عصبی. در مجموعه مقالات دومین کنفرانس بین المللی ۲۰۱۸ در زمینه ارتباطات اختراعی و فن آوری های محاسباتی (ICICCT)، کویمباتور، هند، ۲۰ تا ۲۱ آوریل ۲۰۱۸؛ صفحات ۱۹۳۶-۱۹۳۹٫ [ Google Scholar ]
  39. وانگ، جی. هو، اس. ژان، ایکس. لو، کیو. یو، کیو. لیو، ز. چن، تی پی; یین، ی. هوساکا، اس. لیو، ی. پیش‌بینی قیمت خانه با شبکه عصبی مصنوعی مبتنی بر ممریستور. دسترسی IEEE ۲۰۱۸ ، ۶ ، ۱۶۵۲۳–۱۶۵۲۸٫ [ Google Scholar ] [ CrossRef ]
  40. لئونگ، ی. Mei، CL; آزمون‌های آماری ژانگ، WX برای ناپایداری فضایی بر اساس مدل رگرسیون وزن‌دار جغرافیایی. محیط زیست طرح. A ۲۰۰۰ ، ۳۲ ، ۹-۳۲٫ [ Google Scholar ] [ CrossRef ]
شکل ۱٫ توزیع نقاط داده محله در شنژن، چین در بین ۱۰ منطقه. ( الف ) ۱۰ برابر. ( ب ) مجموعه تست.
شکل ۲٫ ساختار شبکه برای مدل رگرسیون وزنی شبکه عصبی جغرافیایی.
شکل ۳٫ فرآیند آزمایش اعتبار سنجی ۱۰ برابری.
شکل ۴٫ مجموعه تغییرات عملکرد در قطار (خط نارنجی) و اعتبارسنجی (خط آبی) در فرآیند قطار مدل GNNWR. ( الف ) کاهش آمنسیجدر مجموعه قطار. ( ب ) کاهش میانگین خطای مطلق. ( ج ) کاهش میانگین خطای نسبی. د ) افزایش ضریب تعیین. ( ه ) کاهش ضرر.
شکل ۵٫ تجزیه و تحلیل نرخ خطای نسبی بین مدل GWR و GNNWR. ( الف ) طرح QQ نرخ خطای نسبی در مجموعه اعتبارسنجی ادغام شده. ( ب ) طرح QQ نرخ خطای نسبی در مجموعه آزمایشی. ( ج ) هیستوگرام نرخ های نسبی خطا در مجموعه اعتبارسنجی ادغام شده. ( د ) هیستوگرام میزان خطای نسبی در مجموعه تست. ( ه ) نسبت N برتر بهترین/بدترین پیش بینی از ۲ مدل.
شکل ۶٫ ضریب توزیع وزن متغیرها برای مدل GNNWR در بازار املاک و مستغلات شنژن. ( الف ) رهگیری؛ ( ب ) سن ساختمان (AB). ( ج ) فاصله تا نزدیکترین ایستگاه مترو (DSS)؛ ( د ) نسبت سبز (GR); ( ه ) هزینه مدیریت (MF). ( f ) تعداد نقاط پارکینگ (NPS). ( g ) تعداد ایستگاه های مترو در شعاع ۱ کیلومتری (NSS). ( h ) نسبت قطعه (PR); ( i ) کیفیت مدارس دولتی موجود (QAPS). ( j ) فاصله دریا (SD).

دیدگاهتان را بنویسید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *

خانهدربارهتماسارتباط با ما