۱٫ معرفی
پلتفرم های رسانه های اجتماعی آنلاین، به ویژه پلتفرم های میکروبلاگ مانند Wechat و Weibo، به رویدادهای دنیای واقعی پاسخ می دهند و برای جمع آوری اطلاعات موقعیتی در زمان واقعی مفید هستند [ ۱ ، ۲ ، ۳ ، ۴ ]. مکان های جغرافیایی اغلب در این پیام ها توصیف می شوند. به عنوان مثال، Weibo به طور گسترده در واکنش و نجات در بلایا مانند زلزله، سیل، آتش سوزی و حملات تروریستی استفاده می شود. سنگ بنای کاربرد فوق الذکر ژئوپارسینگ [ ۵ ، ۶ ، ۷ ] نامیده می شود. Geoparsing یک کار دشوار پردازش زبان طبیعی (NLP) است که موارد طبیعی بیان شده را در متن آزاد به صورت مکانی (نوشته شده یا به دست آمده از طریق رونویسی خودکار) تراز می کند.۷ ، ۸ ، ۹ ]. درک تمایز بین تجزیه جغرافیایی و کدگذاری جغرافیایی مهم است. ورودی تجزیه جغرافیایی شامل هیچ اطلاعاتی در مورد مکان های مشخص شده در ورودی نیست. در ژئوکدینگ، یک نمایش متنی معتبر از مکان (آدرس) ورودی است. در نتیجه، geocoder فقط باید مختصات آدرس ارائه شده را در یک روزنامه جستجو کند. ژئوکدینگ به دلیل این واقعیت که با داده های خام زبان طبیعی سروکار دارد دشوار است. در این مقاله، ما پیشرفت اولیه را در ایجاد اولین سیستم تجزیه نام جغرافیایی برای یک زبان چینی نشان میدهیم. برای دستیابی به این هدف، اولین فرآیند فرعی رویکرد ما، شناسایی مکان مطالب ذکر شده است. این فرآیند فرعی در NLP شناسایی موجودیت (NER) نامیده می شود [ ۱۰, ۱۱ , ۱۲ , ۱۳ ].
نامهای مکان تک کلمهای مانند پکن، شانگهای، ژجیانگ و غیره وجود دارد. همچنین نامهای مکان طولانی متشکل از چندین کلمه وجود دارد، مانند Ejin Jinqi Saihantaolai Sumu Township (منطقه خودمختار مغولستان داخلی). با این حال، بیشتر نام مکان ها ۱ تا ۵ کلمه طول دارند. توزیع نویسههای استفاده شده در نامهای مکان چینی نیز نسبتاً پراکنده است، اما ویژگیهای نسبتاً متمرکز نام مکانها در محدوده خاصی وجود دارد. به عنوان مثال، ۳۶۸۵ کاراکتر در روزنامه چین استفاده می شود، و فراوانی خاص استفاده نسبتا پراکنده است. با این حال، برخی از این واژهها و ترکیبهای واژهای آنها تنها در نامهای نامی مانند «گاچا» در مغولستان داخلی ظاهر میشوند، در حالی که بیشتر آنها واژههای رایجی هستند که توانایی کلمهسازی قوی دارند و اغلب در کلمات غیرحجمی ظاهر میشوند. مانند «سوقیان» در «سو» و «کیان». بر اساس نکات فوق، نام مکان های چینی را می توان به طور تقریبی به نام های ساده و پیچیده تقسیم کرد. نامهای ساده به آنهایی اطلاق میشود که طولهای کوتاه (۱ تا ۵ کلمه) و نویسههای رایج دارند، مانند پکن، شهرداری پکن، دشت هتا، مخزن هنگیاشان و غیره. و کلماتی که دورتر هستند. بنابراین، شناسایی دقیق نام مکان های چینی از نظر فنی دشوار است و به یک جهت تحقیقاتی مهم در زمینه اطلاعات جغرافیایی تبدیل شده است. مخزن هنگیاشان و غیره نامهای پیچیده به آنهایی اطلاق می شود که درازا (بیش از پنج کلمه) یا با کاراکترها و کلمات دورتر هستند. بنابراین، شناسایی دقیق نام مکان های چینی از نظر فنی دشوار است و به یک جهت تحقیقاتی مهم در زمینه اطلاعات جغرافیایی تبدیل شده است. مخزن هنگیاشان و غیره. نامهای پیچیده به آنهایی اطلاق می شود که طولانی (بیش از پنج کلمه) یا با کاراکترها و کلماتی که دورتر هستند. بنابراین، شناسایی دقیق نام مکان های چینی از نظر فنی دشوار است و به یک جهت تحقیقاتی مهم در زمینه اطلاعات جغرافیایی تبدیل شده است.
روشهای موجود برای تشخیص نامهای جغرافیایی را میتوان به سه نوع روش تقسیم کرد: روشهای مبتنی بر قانون، روشهای آماری و روشهای یادگیری ماشینی [ ۱۴ ، ۱۵ ].]. روشهای مبتنی بر قواعد به جمعبندی دستی واژهسازیها و قواعد نحوی مختلف و شناسایی با روشهای تطبیق قواعد اشاره دارد. این روش شهودی تر، آسان برای درک و گسترش است، و برای تست پیکره در مقیاس کوچک بهتر و سریعتر کار می کند. با این حال، طراحی قوانین بر دانش زبان حرفه ای و دانش دامنه متکی است، تدوین آن زمان بر است، پوشش جامع آن دشوار است و قابلیت حمل و استحکام ضعیفی دارد. رویکرد مبتنی بر آمار به دانش زبان تخصصی نیاز ندارد، قویتر و انعطافپذیرتر از رویکرد مبتنی بر قاعده است، و بسیار قابل حمل است، اما این سیستم به خوبی جبر زبانی را بیان نمیکند و به یک آموزش با حاشیهنویسی دستی در مقیاس بزرگ و جامعتر نیاز دارد. مجموعه نوشته ها. با انباشت کلان داده ها و بهبود مستمر عملکرد رایانه، روش های استخراج نام مکان مبتنی بر یادگیری عمیق به سرعت توسعه یافته اند. مدلهای یادگیری عمیق کاربردی و قوی هستند و میتوانند بهطور خودکار ویژگیهای کلیدی را یاد بگیرند و از متن استخراج کنند و به نتایج قابلتوجهی در تشخیص نام مکان چینی دست یابند. متداول ترین مدل استفاده شده، حافظه کوتاه مدت دو جهته (LSTM) است که بر اساس تکامل شبکه های عصبی بازگشتی (RNN) است و بر کاستی های RNN در جملات وابسته طولانی غلبه می کند. LSTM دو طرفه از دو لایه پنهان LSTM با جهت مخالف برای حل بیشتر این مشکل استفاده می کند که برچسب گذاری دنباله ای فقط می تواند از اطلاعات بالا استفاده کند نه از پایین. در تحقیق فعلی در مورد تشخیص نام مکان چینی، مشکل اصلی بر شناخت نام مکان های پیچیده چینی متمرکز است. از آنجایی که طول نام مکان های پیچیده معمولا طولانی است و استفاده از کلمات و ترکیب کلمات نسبتاً کم است، مدل های فوق اغلب در تعیین مرزهای نام مکان ها مشکل دارند.
در این مقاله، ما یک مدل شبکه عصبی ترکیبی برای تشخیص نام مکان چینی بر اساس یک رمزگذار دوطرفه نمایشهای رمزگذار دوطرفه لایت از مدل ترانسفورماتور (ALBERTs) برای استخراج کلمه بردار برای بهبود توانایی نمایش بردار متن و شناسایی موثر مکان نامنظم پیشنهاد میکنیم. اسامی و اختصارات نام مکان لایه شبکه عصبی دو جهته بلند و کوتاه مدت (BiLSTM) اطلاعات معنایی را در هر دو جهت در جمله جمع آوری می کند تا مرزهای موجودیت را بهتر تعیین کند. توالی توکن بهینه جهانی توسط لایه میدان تصادفی شرطی (CRF) بدست می آید.
مشارکت های اصلی این تحقیق به شرح زیر است:
(۱) TPCNER، مجموعه بزرگ خود حاشیه نویسی از حوزه های جغرافیایی با هفت دسته و ۶۴۰۶۳ نمونه برچسب، جمع آوری و ساخته شد. این مجموعه دارای مقولههای موجودیت بیشتر و حجم نمونه بزرگتر از مجموعههای قبلی است. کارایی TPCNER که در این مطالعه برجسته شده است با یافته های تجربی ارزیابی در بخش ۵٫۴ بیشتر نشان داده شد .
(۲) یک مدل جدید چینی NER (CNER) برای حوزه جغرافیایی از طریق مدل پیشآموزشی آلبرت بهبود یافته و BiLSTM-CRF پیشنهاد شد. با یادگیری نمایش ویژگی در سطح کلمه از طریق لایه ALBERT و استخراج ویژگی های معنایی متنی متنی از طریق لایه BiLSTM، لایه CRF توالی نشانه بهینه جهانی را به دست می آورد و در نهایت عملکرد کلی مدل پیشنهادی را بهبود می بخشد.
(۳) عملکرد ALBERT-BiLSTM-CRF با استفاده از طیف وسیعی از مدل های استاندارد در TPCNER، MSRA، RenMinRiBao، و بوزون ارزیابی شد. علاوه بر این، چندین جزئیات خاص مانند اثربخشی BiLSTM و استفاده از مکانیسم CRF مورد مطالعه و بحث قرار گرفت. از طریق مقایسههای کامل با سایر مدلهای پیشرفته، یافتههای تجربی جامع بر روی مجموعه دادههای خاص دامنه و عمومی، عملکرد مؤثر مدل پیشنهادی را تأیید کرد.
بقیه مقاله به شرح زیر سازماندهی شده است: کار فعلی در مورد شناسایی موجودیت نامگذاری شده در بخش ۲ توضیح داده شده است . پردازش ایجاد پیکره در بخش ۳ توضیح داده شده است . روش توصیه شده برای شناسایی نهادهای جغرافیایی در بخش ۴ ارائه و شرح داده شده است. بخش ۵ شامل داده ها و نتایج تجربی است. نتیجه گیری و توصیه هایی برای مطالعه بیشتر در بخش ۶ ارائه شده است.
۲٫ کارهای مرتبط
اطلاعات نام نامی حاوی اطلاعات مکان مکانی است، بنابراین تشخیص نام نامی را می توان برای کاهش بلایای اضطراری، نظارت بر افکار عمومی، برنامه ریزی شهری و سایر زمینه ها اعمال کرد [ ۱۶ ، ۱۷ ، ۱۸ ]]. به عنوان مثال، اطلاعاتی مانند نام مکان ها و بلایای طبیعی که در آنجا اتفاق می افتد را می توان از پیام های رسانه های اجتماعی منتشر شده توسط مردم، مانند توییتر استخراج کرد. پیام های رسانه های اجتماعی همچنین می توانند به نظارت و مدیریت افکار عمومی کمک کنند. مدیران می توانند رویدادهای امنیت عمومی اجتماعی را از صفحات وب و متون رسانه های اجتماعی شناسایی کنند و اطلاعات مکانی کلیدی را استخراج کنند، نظارت و هشدار اولیه حوادث امنیت عمومی اجتماعی را درک کنند و کارایی دفع زمانی امنیت اجتماعی و عمومی را بهبود بخشند. برای محافظت از حریم خصوصی عمومی، رسانه های اجتماعی به طور انتخابی مکان کاربر خاص به دست آمده در زمان واقعی را مخفی می کنند، که استخراج اطلاعات موقعیت جغرافیایی را پیچیده تر می کند. در ژوئن ۲۰۱۹، توییتر به طور رسمی ویژگی دقیق برچسب گذاری جغرافیایی را حذف کرد.۱۵ ]. ما عمدتاً اطلاعات توپونیوم متن طولانی را با جزئیات بیشتری شناسایی می کنیم تا ویژگی های آن واضح تر شود و توسعه کارهای بعدی تسهیل شود.
روشهای تشخیص نامهای چینی عمدتاً به سه نوع تقسیم میشوند، یعنی روشهای مبتنی بر فرهنگ لغت و قانون، روشهای یادگیری ماشینی مبتنی بر آمار و روشهای یادگیری عمیق [ ۱۹ ، ۲۰ ، ۲۱ ]. روش مبتنی بر قانون عمدتاً تطبیق و تشخیص نام مکان را با خلاصه کردن دستی قواعد مختلف واژهسازی انجام میدهد (نقایص این روش در بخش ۱ خلاصه شده است.) که می تواند با روش های رایج یادگیری عمیق رایج ترکیب شود تا واژگان حرفه ای را تکمیل کند و استحکام مدل آموزشی را بهبود بخشد. تعداد نامها با سرعتی بسیار سریع با توسعه منطقه افزایش مییابد و اغلب همان مکان با نامهای متعدد نشان داده میشود. بنابراین، ساخت یک روزنامه قطعی نمیتواند محقق شود و بازشناسی خودکار نام مکان هنوز ارزش مطالعه دارد.
روش مبتنی بر آمار انعطافپذیرتر از روش قاعده است، که تشخیص نام مکان را به یک مشکل حاشیهنویسی سریال تبدیل میکند، اما این روش به انتخاب قالبهای ویژگی بستگی دارد و توانایی تعمیم ضعیفی دارد. الگوریتم های رایج یادگیری ماشین شامل مدل پنهان مارکوف (HMM)، مدل مارکوف حداکثر آنتروپی (MEMM) و مدل CRF است. در میان آنها، مدل CRF میتواند الگوریتمهای انتخاب ویژگی و القای ویژگی مؤثر را برای وظایف برچسبگذاری توالی پیادهسازی کند. به این معنی که کاربران می توانند تأثیر ویژگی های تولید شده به طور خودکار بر انتزاع داده ها را ارزیابی کنند. بنابراین، ترکیب یک مدل CRF با مدلهای پیشآموزشی در مقیاس بزرگ بعدی، مانند مدل BERT-CRF، میتواند به نتایج عالی برچسبگذاری توالی دست یابد، بنابراین ایدههایی برای تشخیص دقیقتر نام مکان ارائه میدهد.
رویکرد شناسایی نام نهاد مبتنی بر شبکه های عصبی به لطف رشد سریع یادگیری عمیق، به طور گسترده در استخراج اطلاعات متنی در بخش های متعددی استفاده می شود. متفاوت از الگوریتم های یادگیری ماشین سنتی، مدل آموزش داده شده توسط یک شبکه عصبی عمیق دارای ویژگی های ورودی و خروجی داده انتها به انتها است. این فرآیند آموزش مدل را قادر میسازد تا تداخل مصنوعی را برای تکمیل مستقیم وظایف خاص مطابق با ورودی داده اصلی کاهش دهد و نیازی به تنظیم دستی ویژگیهای داده وجود ندارد [ ۲۲ ].]. RNN به ویژه در پردازش داده های توالی خوب است. شبکههای تکاملیافته LSTM، BiLSTM و واحد بازگشتی دردار دوطرفه (BiGRU) اغلب لایه CRF را برای تحقق بخشیدن به وظیفه شناسایی موجودیت نامگذاری شده ترکیب میکنند. مدل رایجتر BiLSTM–CRF، که مزایای BiLSTM و CRF را ترکیب میکند، نه تنها میتواند اطلاعات زمینه را برای پردازش متن طولانی حفظ کند، بلکه به لطف یک لایه CRF از اطلاعات برچسب سطح جمله نیز به طور کامل استفاده میکند. به طور مشابه، مدل BiGRU-CRF به طور گسترده استفاده می شود.
در سالهای اخیر، مدلهای پیشآموزشی در مقیاس بزرگ به دلیل عملکرد فوقالعادهشان، به سرعت به روش ترجیحی پردازش زبان طبیعی تبدیل شدهاند. بر این اساس، پردازش وظایف پایین دستی می تواند نتایج تشخیص مدل ترکیبی را دقیق تر کند [ ۲۳ ، ۲۴ ]. مدلهای پیشآموزشی متداول شامل ترانسفورماتور پیشآموزشی مولد (GPT)، BERT، نمایش پیشرفته از طریق یکپارچهسازی دانش (ERNIE)، و غیره است .]. ما مدل BERT-wwm را به عنوان مدل پیشآموزشی انتخاب میکنیم که توسط مرکز تحقیقات محاسبات اجتماعی و بازیابی اطلاعات و تحقیقات هوش مصنوعی iFLYTEK در چین آموزش داده شده است. این یک مدل زبان پیشآموزشی چینی منبع باز است که از فناوری پوشش کل کلمه استفاده میکند، که میتواند وظیفه تشخیص نام مکان چینی را بهتر درک کند. بر اساس BERT-wwm، BERT-wwm-ext مجموعه دادههای پیشآموزشی را گسترش میدهد و تعداد تکرارهای آموزشی را در طول آموزش مدل افزایش میدهد.
تشخیص نام نامی یکی از وظایف فرعی شناسایی موجودیت نامگذاری شده است که به وظیفه استخراج اطلاعات تعلق دارد. ما میخواهیم اطلاعات نام مکان را از دادههای متن طولانی استخراج کنیم، اما مدلی که توسط مجموعه عمومی آموزش داده شده است، هنوز از دقت و ریزدانگی تشخیص نام نامها بی بهره است. در پاسخ به مشکلات فوق، ما از یک پیکره چینی که فقط حاوی حاشیه نویسی نام های نامی بود استفاده کردیم و یک شبکه عصبی ترکیبی برای آموزش مدل برای به دست آوردن مدلی طراحی کردیم که در کار تشخیص نام نام های چینی بهتر عمل کند. این مدل بر اثر کلی و دانه بندی کم مدل سنتی تشخیص نهاد نامگذاری شده در تشخیص نام نامی بهبود می بخشد.
۳٫ آماده سازی مجموعه و حاشیه نویسی
برای رسیدگی به پیکره محدود چینی NER، یک پیکره جدید، TPCNER، جمع آوری و ساخته شد. مجموعه داده بر اساس مطالعات قبلی با مقولههای موجودیت بیشتر گسترش یافت و در نهایت شامل ۷ دسته موجودیت و ۶۴۰۶۳ نمونه مشروح شد.
۳٫۱٫ مجموعه برچسب های NER
موجودیتهای نامگذاری شده در حوزه جغرافیایی، مانند سازمانها، سیستمهای آبی و شکلهای زمین، بسیار متفاوت از موجودات در حوزه عمومی هستند. نهادهای جغرافیایی به مقدار زیادی دانش خاص دامنه نیاز دارند، بنابراین حاشیه نویسی را تا حدی دشوار می کند. در این مقاله، بر اساس تحقیقات موجود [ ۲۴ ]، دستههای موجودیت بیشتر به موجودیتهای دانهدارتر، مانند زمینها و تأسیسات مسکونی، شکلهای زمین و سیستمهای آب تقسیم میشوند. برخی از مقوله ها نیز در نظر گرفته شد، مانند حمل و نقل، خطوط لوله، مرزها، و مناطق سیاسی با مناطق دیگر. در نهایت همانطور که در جدول ۱ نشان داده شده است، هفت گروه ریزدانه پدیدار می شوند. برای تضمین یکپارچگی دستههای CNER، دسته «دیگران» را در این کار از پیش تعریف میکنیم تا برخی از موجودیتهای مفهومی و نامطمئن را برای رشد بعدی مشخص کنیم. علاوه بر این، این مقاله منحصراً انواع موجودیتها را در نظر میگیرد که به حوزه جغرافیایی مرتبط هستند (به عنوان مثال، نام نام و سازمان)، به جای موجودیتهای عمومی مانند افراد (به عنوان مثال، نام شخصی). در آینده این مجموعه نیز منتشر خواهد شد. جدول ۲ ، جدول ۳ و جدول ۴ جزئیات بوزون، MSRA و RenMinRiBao را نشان می دهد.
۳٫۲٫ مجموعه مجموعه و حاشیه نویسی
در این مقاله، یک مجموعه حاشیه نویسی در مقیاس بزرگ، TPCNER، با دایره المعارف بایدو و دایره المعارف چینی جغرافیای چینی به عنوان داده های منبع (تقریباً ۲ میلیون کلمه) و با ارجاع به سیستم حاشیه نویسی موجودیت با نام جغرافیایی طراحی شده در این مقاله ایجاد شده است.
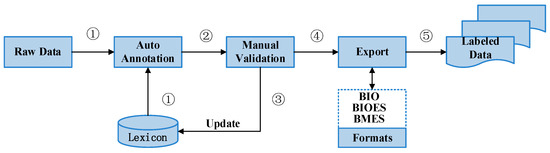
برای اطمینان از سازگاری و دقت، کار در این مقاله در دو حوزه اصلی ارائه شده است. ابتدا یک ابزار حاشیه نویسی جدید TPCNER، ChineseNERAnno، توسعه یافت ( شکل ۱ را ببینید ). روند کامل این ابزار در شکل ۱ نشان داده شده است . تکنیک پیشنهادی از واژگانی از اصطلاحات مرتبط با دامنه جغرافیایی برای حاشیه نویسی خودکار استفاده می کند که به اطمینان از سازگاری موجودیت کمک می کند. دوم، موجودیت های جدید را می توان به صورت پویا در فرهنگ لغت گسترش داد، بنابراین زمان حاشیه نویسی دستی را کاهش داد و سرعت حاشیه نویسی را افزایش داد. یک مجموعه جدید TPCNER در نهایت ساخته شد که شامل ۷ دسته، ۶۵۰۷۲۵ موجودیت و ۶۴۰۶۳ نمونه از پیش پردازش و حاشیه نویسی شده بود. این روش زیر نظر کارشناسان دامنه سه ماه طول کشید. جدول ۵نمونه های خاص TPCNER را با جزئیات بیشتر نشان می دهد. شکل ۲ دادههای مربوط به توزیع آماری موجودیتهای فردی را در TPCNER نشان میدهد، که نشان میدهد توزیع مجموعه آموزشی مشابه توزیع مجموعه اعتبارسنجی است. منطق و کاربرد مجموعه تعیین شده در این کار نیز در بخش ۵٫۴ بحث شده است.
۳٫۳٫ تجزیه و تحلیل ویژگی های بدنه
نام نهادهای جغرافیایی مهمترین تمایز بین موجودات جغرافیایی و در زمینه اطلاعات جغرافیایی است ( جدول ۶ را ببینید ). نام نهادها با اطلاعات مکان، عمدتاً از عناصر اطلاعات جغرافیایی پایه تشکیل شده است، با ابهام و تنوع قابل مشاهده است. در این مقاله با مطالعه استانداردهای ملی و ادبیات مربوطه، ویژگیهای توصیفی موجودیتهای جغرافیایی در متون را تحلیل میکنیم. سپس دستههای موجودیت با نام جغرافیایی و ویژگیهای توصیفی را با ترکیب دستی و ترکیب دادهها با استانداردهای ملی به عنوان معیار ادغام میکنیم. توزیع برای هر دسته در TPCNER در شکل ۲ نشان داده شده است .
توصیف نام نهادهای جغرافیایی در متون چینی با ابهام، عدم قطعیت و تنوع مشخص می شود. در این مقاله به تحلیل ویژگی های توصیفی نام موجودات جغرافیایی در متون می پردازیم. پنج ویژگی اصلی توصیفی به شرح زیر خلاصه می شود:
(۱) نام نهادهای جغرافیایی متنوع است، با کلمات یا عبارات آزاد و پراکنده، اما با پوشش نسبتاً متمرکز، به عنوان مثال، نام جامعه “Daijiashanzhuang”، که در آن “Daijiashanzhuang Phase 1” و “Daijiashanzhuang Phase” وجود دارد. ۲”.
(۲) نام نهادهای جغرافیایی دارای الگوی خاصی است که اغلب با کلمات مشخصی مانند “استان، جاده، کوه” ختم می شود، به عنوان مثال، “استان هوبی” و “جاده لوما، منطقه هونگشان، استان هوبی”.
(۳) نام نهادهای جغرافیایی اغلب با کلمات مکان دنبال می شود. به عنوان مثال، “Huangshan” یک نام مکان است، و “Huangshan North” یک موجودیت نامگذاری جغرافیایی کامل است.
(۴) اسامی بسیاری از موجودات جغرافیایی به صورت اسم است، اما گاهی اوقات آنها به عنوان تعدیل کننده برای اصلاح موجودات دیگر، مانند “باگونگ کوه توفو” استفاده می شود.
(۵) اسامی واحدهای جغرافیایی با نام و بدون نام است. یعنی برخی از نهادهای جغرافیایی نام خاصی ندارند و مکان مکانی آنها باید از طریق رابطه زمینه ای مشخص شود. به عنوان مثال، «استخر» در «استخر در محدوده غرب دانشگاه» نام یک موجود جغرافیایی است، اما موقعیت مکانی آن باید با اطلاعات قبلی مشخص شود.
۴٫ مدل یادگیری عمیق ترکیبی
۴٫۱٫ چارچوب کلی و گردش کار مدل
در این مقاله، ما یک مدل شبکه عصبی ترکیبی برای تشخیص نام مکان چینی پیشنهاد میکنیم. ساختار کلی مدل در شکل ۳ نشان داده شده است و کل مدل به پنج قسمت تقسیم شده است: لایه ورودی، لایه ALBERT، لایه BiLSTM، لایه CRF و لایه خروجی.
ما مدل خود را از پایین به بالا ارائه می کنیم و لایه های شبکه عصبی را مشخص می کنیم. لایه ورودی حاوی کلمات جداگانه یک پیام است که به عنوان ورودی مدل استفاده می شود.
لایه بعدی با استفاده از رویکرد پیشآموزشی، هر کلمه را به عنوان بردار نشان میدهد. از جاسازی کلمات از پیش آموزش دیده برای نمایش کلمات در دنباله ورودی استفاده می کند. به طور خاص، ما از ALBERT استفاده می کنیم که معنای متفاوت یک کلمه را در زمینه های مختلف نشان می دهد. توجه داشته باشید که تعبیههای واژهای از پیش آموزش داده شده، معنایی کلمات را بر اساس زمینههای استفاده معمولی آنها نشان میدهد و بنابراین بازنمایی ایستا از کلمات را ارائه میدهد. در مقابل، ALBERT یک نمایش پویا برای یک کلمه با مدل سازی جمله خاصی که در آن کلمه استفاده می شود، ارائه می دهد. این لایه چهار جنبه مختلف از یک کلمه را به تصویر میکشد و بردارهای نمایش آنها در یک بردار بزرگ به هم متصل میشوند تا هر کلمه ورودی را نشان دهند. سپس از این بردارها به عنوان ورودی لایه بعدی استفاده می شود که یک لایه BiLSTM متشکل از دو لایه سلول LSTM است:
لایه BiLSTM خروجی های دو لایه LSTM را ترکیب می کند و خروجی ترکیبی را به یک لایه کاملا متصل تغذیه می کند. سپس لایه بعدی یک لایه CRF است که خروجی را از لایه کاملا متصل می گیرد و برچسب گذاری ترتیبی را انجام می دهد. لایه CRF از مدل استاندارد BIEO از تحقیقات NER برای برچسب زدن هر کلمه استفاده می کند اما بر مکان ها تمرکز دارد. بنابراین، یک کلمه به صورت «B–L» (ابتدای عبارت مکان)، «I–L» (داخل عبارت مکان)، «E–L» (پایان عبارت مکان)، یا «O» حاشیهنویسی میشود. (خارج از عبارت مکان).
گردش کار مدل به شرح زیر است:
(۱) ابتدا، مجموعه داده از متن X (X ۱ , X ۲ , …, X n ) تشکیل شده است که به لایه ALBERT وارد می شود، جایی که X i نشان دهنده کلمه i در متن ورودی است.
(۲) دادههای متن ورودی در لایه ALBERT سریالسازی میشوند و مدل بردارهای ویژگی، C i را بر اساس هر کلمه، X i ، در متن ایجاد میکند تا نمایش بردار متن را افزایش دهد و C i را به بردارهای کلمه E تبدیل میکند. = ( E ۱ , E ۲ , …, E n ) با ویژگی های مکان بر اساس ترانسفورماتور (Trm) در لایه نمایش برداری کلمه ALBERT.
(۳) با استفاده از E i به عنوان ورودی هر مرحله زمانی لایه LSTM دو طرفه و انجام محاسبه ویژگی، LSTM F = ( F ۱ , F ۲ , …, F n ) رو به جلو و معکوس LSTM B = ( B ۱ , B ۲ ، …، Bn ) از لایه BiLSTM برای استخراج ویژگی های متنی و تولید ماتریس ویژگی، H = ( H ۱ ، H ۲ ، …، H n استفاده می شود.)، با اتصال موقعیت برای گرفتن اطلاعات معنایی در هر دو جهت در جمله.
(۴) ویژگیهای انتقال بین حاشیهنویسیها را در لایه CRF در نظر بگیرید، وابستگیهای بین برچسبهای مجاور را بهدست آورید، و برچسبهای مربوطه Y ( Y ۱ ، Y ۲ ، …، Y n ) را برای به دست آوردن نتایج حاشیهنویسی نهایی، خروجی بگیرید.
۴٫۲٫ مدل های پیش تمرینی برت و آلبرت
مدل پیشآموزشی پارامتر اولیهسازی بهتری را برای شبکه عصبی فراهم میکند، همگرایی شبکه عصبی را تسریع میکند و توانایی تعمیم بهتری را در کار هدف فراهم میکند. توسعه مدلهای پیشآموزشی به دو مرحله تقسیم میشود: جاسازی کلمه کم عمق و کدگذاری عمیق. مدلهای جاسازی کلمه کم عمق عمدتاً از اطلاعات کلمه فعلی و کلمه قبلی برای آموزش استفاده میکنند. آنها فقط اطلاعات محلی متن را در نظر می گیرند و نمی توانند به طور موثر از اطلاعات کلی متن استفاده کنند [ ۲۲ ، ۲۷ ]. BERT از یک ساختار شبکه ترانسفورماتور دو طرفه با قابلیت معرفتی قویتر برای آموزش بدنه و دستیابی به یک نمایش دو طرفه عمیق برای پیشآموزش استفاده میکند [ ۲۵ ]]. مدل BERT “مدل زبان ماسک شده” (MLM) می تواند زمینه های چپ و راست کلمه فعلی را ترکیب کند. BERT به نتایج قابل توجهی در کارهایی مانند شناسایی موجودیت نامگذاری شده [ ۲۸ ]، طبقه بندی متن، ترجمه ماشینی [ ۲۹ ] و غیره دست یافته است. بردارها
با این حال، مدل BERT شامل صدها میلیون پارامتر است و آموزش مدل به راحتی توسط حافظه سخت افزاری محدود می شود. مدل ALBERT یک مدل زبانی سبک وزن از پیش آموزش دیده است که بر اساس مدل BERT [ ۳۰ ] است. مدل BERT از یک رمزگذار ترانسفورماتور دو طرفه برای به دست آوردن نمایش ویژگی متن استفاده می کند و ساختار مدل آن در شکل ۴ نشان داده شده است . ALBERT تنها ۱۰٪ از تعداد پارامترهای مدل BERT اصلی را دارد اما دقت مدل BERT را حفظ می کند.
ساختار ترانسفورماتور مدل BERT از یک رمزگذار و رمزگشا تشکیل شده است. بخش رمزگذار عمدتاً از شش لایه یکسان تشکیل شده است و هر لایه به ترتیب از دو لایه فرعی تشکیل شده است، مکانیزم خود توجهی چند سر و شبکه تغذیه به جلو کاملاً متصل. از آنجایی که هر لایه فرعی با اتصال باقیمانده و نرمال سازی اضافه می شود، خروجی لایه فرعی را می توان به شکلی که در رابطه زیر نشان داده شده است نشان داد:
مکانیسم خودتوجهی چند سر، سه ماتریس، یعنی Q ، V ، و K را با h تبدیل خطی مختلف به نمایش میگذارد و در نهایت نتایج توجه متفاوت را به هم متصل میکند. معادله اصلی محاسبه در زیر نشان داده شده است:
برای قسمت رمزگشا، ساختار اصلی شبیه به قسمت رمزگذار است، اما با اضافه شدن یک لایه زیرین توجه.
ALBERT از دو روش برای کاهش تعداد پارامترها استفاده می کند: (۱) پارامترسازی تعبیه شده فاکتوریل، که با تجزیه ماتریس جاسازی واژگانی عظیم به دو ماتریس کوچکتر، اندازه لایه پنهان را از اندازه ماتریس جاسازی واژگانی جدا می کند. و (ii) به اشتراک گذاری پارامتر متقابل، که به طور قابل توجهی تعداد پارامترهای مدل را با اشتراک گذاری پارامترهای لایه عصبی مدل بدون تأثیر قابل توجهی بر عملکرد آن کاهش می دهد.
در شکل، C = ( C ۱ , C ۲ , …, C n ) نشان می دهد که هر کاراکتر در دنباله توسط یک رمزگذار ترانسفورماتور دو طرفه چند لایه (Trm) آموزش داده می شود تا در نهایت بردار ویژگی متن را بدست آورد که با E = نشان داده می شود. ( E ۱ , E ۲ , …, E n). پس از اینکه متن ورودی ابتدا با جاسازی کلمه پردازش شد، رمزگذاری اطلاعات موقعیتی (رمزگذاری موقعیتی) هر کلمه در آن جمله اضافه می شود. این مدل ویژگیهای متنی بیشتری را با ترکیب چندین لایهی خودآگاه برای ایجاد توجه چند سر میآموزد. خروجی لایه مبتنی بر توجه چند سر از لایه Add&Nom عبور می کند، که در آن “Add” به معنای افزودن ورودی و خروجی لایه توجه چند سر است و “Norm” به معنای عادی سازی است. نتیجه پس از عبور از لایه Add&Nom به لایه عصبی feed-forward (Feed Forward) منتقل می شود و توسط لایه Add&Norm خروجی می شود.
ALBERT مورد استفاده در این مقاله دارای چندین ویژگی طراحی است که عملکرد آن را در تشخیص نام نامی از پیام های رسانه های اجتماعی افزایش می دهد. ابتدا، ALBERT ارائه شده ما از تعبیههای کلمات از پیش آموزشدیده استفاده میکند که به طور خاص از پیامهای رسانههای اجتماعی مشتق شدهاند. ما مراحل زیر را بر اساس دادههای متنی جمعآوریشده انجام دادیم: (۱) پاکسازی دادهها – کدهای آشفته و جملات ناقص را حذف کردیم تا اطمینان حاصل کنیم که جملات صاف هستند. (۲) برش جملات – ما [CLS]، [SEP]، [MASK]، و غیره را به هر آیتم متن اضافه کردیم تا ۲۵٫۶ گیگابایت داده آموزشی به دست آوریم. و (۳) مجموعه آموزشی – ما به مدت ۴ روز با GPU 3090 آموزش دیدیم، با دوره تنظیم شده روی ۱۰۰۰۰۰ و نرخ یادگیری روی ۵ × ۱۰-۵ تنظیم شده است.
ما از جاسازیهای کلمه GloVe (تعداد نشانهها ۵۴۲۳۸ و حجم فرهنگ لغت ۳۹۹ کیلوبایت است) استفاده کردیم که بر روی ۲ میلیارد متن آموزش داده شد، با ۱۱ میلیارد توکن و ۱٫۸ میلیون مورد واژگان جمعآوری شده از دایرهالمعارف بایدو، ویبو، وی چت و غیره. این جاسازیهای کلمه، که بهطور خاص بر روی یک مجموعه پیامهای رسانههای اجتماعی بزرگ آموزش داده شدهاند، شامل بسیاری از کلمات بومی و کلمات ثبت نشده است که توسط افراد در پیامهای رسانههای اجتماعی استفاده میشود. مدلهای geoparsing و NER قبلی معمولاً از جاسازیهای کلمهای استفاده میکنند که بر روی متنی با قالببندی مناسب، مانند مقالات خبری آموزش داده شدهاند، و بسیاری از کلمات بومی تحت پوشش آن جاسازیها نیستند. وقتی این اتفاق میافتد، معمولاً از جاسازی یک نشانه ناشناخته عمومی برای نشان دادن این کلمه بومی استفاده میشود و در نتیجه معنای واقعی کلمه از بین میرود. دوم، در مقایسه با مدل پایه BiLSTM–CRF،
۴٫۳٫ لایه BiLSTM
شبکه های عصبی تکراری به دلیل توانایی آنها در به خاطر سپردن اطلاعات تاریخی دنباله های متنی، برای کارهای حاشیه نویسی توالی مناسب تر هستند. یک مدل LSTM در ادبیات [ ۳۱ ، ۳۲ ، ۳۳ ، ۳۴ ] پیشنهاد شد که واحدهای حافظه طراحی شده ویژه ای را در لایه پنهان در مقایسه با RNN ها ترکیب می کند و می تواند مشکل انفجار گرادیان یا ناپدید شدن گرادیان را که RNN ها تمایل دارند به عنوان دنباله داشته باشند حل کند. طول افزایش می یابد. ساختار نورون مدل LSTM در شکل ۵ نشان داده شده است .
شبکه LSTM از سه ساختار دروازه و یک واحد حالت تشکیل شده است. این سازههای دروازه شامل دروازههای ورودی، دروازههای فراموشی و دروازههای خروجی است. گیت ورودی تعیین می کند که چه مقدار از ورودی شبکه در لحظه فعلی در حالت سلول ذخیره می شود. دروازه فراموشی به طور انتخابی اطلاعات خاصی را دور می زند. دروازه خروجی مقدار نهایی خروجی را بر اساس وضعیت سلول تعیین می کند. مشکل وابستگی طولانی مدت شبکه های عصبی مکرر را می توان با ساختار سه دروازه ای برای حفظ و به روز رسانی حالت برای عملکرد حافظه بلند مدت بهتر حل کرد. یک ساختار شبکه معمولی LSTM را می توان به طور رسمی در معادلات (۵) – (۱۰) نشان داد:
که در آن x t نشان دهنده کلمه ورودی در لحظه t است. i t نشان دهنده دروازه حافظه است. f t نشان دهنده دروازه فراموشی است. o t نشان دهنده گیت خروجی است. C t نشان دهنده وضعیت سلول است. سی˜تینشان دهنده وضعیت سلول موقت است. h t نشان دهنده خروجی حالت پنهان در هر مرحله زمانی است. h t-1 نشان دهنده حالت پنهان در لحظه قبل است. C t-1 نشان دهنده وضعیت سلول در لحظه قبل است. W i ، W f ، W o و Wc نشان دهنده ماتریس وزن در وضعیت فعلی هستند. و b i , b f , b o و b C به ترتیب نشان دهنده افست وضعیت فعلی هستند.
۴٫۴٫ لایه CRF
مدل میدان تصادفی شرطی یک مدل احتمالی افتراقی است [ ۳۴]. مدل میدان تصادفی شرطی مزایای مدل HMM و حداکثر آنتروپی (MEM) را ترکیب می کند. این به شرایط فرض استقلال دقیق مدل پنهان مارکوف می پردازد، از معایب بهینه محلی و مشکل سوگیری برچسب گذاری مدل حداکثر آنتروپی جلوگیری می کند، برای برچسب گذاری داده های توالی CRF مناسب است، مشکل ترتیبی را در بین برچسب ها در نظر می گیرد، و به دست می آورد. توالی برچسبگذاری بهینه جهانی از طریق رابطه برچسبهای مجاور، اضافه کردن محدودیتها به برچسبهای پیشبینیشده نهایی. به عنوان مثال، برچسبی که با “B” شروع می شود توسط یک تگ کلاس “O” دنبال نمی شود و برچسبی که با “E” شروع می شود را نمی توان به صورت متوالی با تگ “I” مرتبط کرد. با فرض اینکه ورودی مدل، x = ( x ۱ , x ۲ , …,x n )، دارای دنباله ای از تگ ها است، y = ( y ۱ , y ۲ , …, y n ), بردار نمره جمله را می توان با رابطه (۷) محاسبه کرد:
که در آن P i ، yi احتمال برچسب y i کاراکتر، و A ماتریس احتمال انتقال است. همانطور که در رابطه (۸) نشان داده شده است، بردار امتیاز CRF با استفاده از تابع log-lilihood به عنوان تابع ضرر، نرمال و آموزش داده می شود:
در مرحله پیشبینی، مدل شبکه با استفاده از الگوریتم Viterbi برای به دست آوردن دنباله بهینه، همانطور که در رابطه (۹) نشان داده شده است، برچسبگذاری میشود:
۵٫ نتایج و بحث
در چندین مجموعه داده، عملکرد مدل پیشنهادی با سایر مدلهای یادگیری عمیق مقایسه شد. بخشهای زیادی از دادههای تجربی ارزیابی و مورد بحث قرار گرفت. از TensorFlow برای پیادهسازی مدلها بر روی یک پردازنده گرافیکی NVIDIA GeForce RTX 3090 استفاده شد. با توجه به ماهیت تکرار، این نتایج ممکن است تا حدودی نسبت به نسخه های اصلی تغییر کند.
۵٫۱٫ مجموعه داده، معیارهای ارزیابی و فراپارامترها
معیارهای عملکرد : اندازهگیریهای آزمایش دقت (P)، یادآوری (R) و امتیاز F1 (F1) بود. دقت، درصد نامهای بهدرستی شناساییشده (مثبت واقعی، TPs) را در بین تمام نامهای شناختهشده توسط یک مدل، که شامل هر دو مثبت واقعی و مثبت کاذب (FPs) است، اندازهگیری میکند. Recall درصد نامهایی را که بهدرستی شناسایی شدهاند، در میان همه نامهایی که بهعنوان صدق اصلی حاشیهنویسی شدهاند، اندازهگیری میکند که شامل مثبتهای درست و منفیهای کاذب (FNs) میشود. امتیاز F میانگین هارمونیک دقت و یادآوری است [ ۳۵ ]. زمانی که هم دقت و هم یادآوری نسبتاً زیاد باشد، زیاد است و اگر هر یک از این دو پایین باشد، پایین است [ ۳۶ ].
فرآیند آموزش : در این مطالعه، با استفاده از ابزار word2vec از قبل، جاسازیهای کلمه را در پیکره ویکیپدیا آموزش دادیم و کلمات متوالی را برای نشان دادن یک موجودیت در زمانی که موجودیت دارای چندین کلمه بود، به هم متصل کردیم. مهمتر از آن، واژه embeddings به دست آمده توسط word2vec به عنوان نمایش اولیه کلمات استفاده شد. ما آنها را به عنوان پارامتر در نظر گرفتیم و آنها را در فرآیند آموزش اصلاح کردیم که می تواند نمایش بهتری از کلمات ارائه دهد.
روش آزمایش : ما از اعتبارسنجی متقاطع ۱۰ برابری برای آزمایش استفاده کردیم و میانگین امتیاز ۱۰ اجرا مستقل را گزارش کردیم. این منجر به مجموع ۱۰۰ تقسیم مختلف به زیر مجموعه های آموزشی/آزمایی شد.
هر کاراکتر چینی به عنوان یک نشانه در نظر گرفته شد و TPCNER با استفاده از تکنیک برچسب گذاری BIO کدگذاری شد. برای جلوگیری از برازش بیش از حد، افت تحصیلی روی ۰٫۵ تنظیم شد. با توجه به احتمال اتکای متنی بین عبارات همسایه، حداکثر طول نمونهها حداکثر طول آموزش در نظر گرفته شد و ما اشاره کردیم که تقسیم نمونهها ممکن است منجر به از دست دادن معنایی شود. برای کمک به همگرایی همه مدل ها، تعداد دوره ها به ۱۰۰ ثابت شد. در نسبت ۸:۲، همه مجموعه داده ها به طور تصادفی به مجموعه های آموزشی و اعتبار سنجی تقسیم شدند. جدول ۷ TPCNER را با سایر مجموعه داده ها مقایسه می کند و داده های مقایسه ای را ارائه می دهد. جدول ۸ فراپارامترهای باقی مانده را فهرست می کند.
۵٫۲٫ خطوط پایه
برای ارزیابی اثر مدل ارائه شده، روش خود (ALBERT-BiLSTM-CRF) را با شش خط پایه قوی (DBN، DM_NLP، NeuroTPR، CheseBERTTP، ChinaTR و GazPNE2) به صورت تجربی مقایسه کردیم. به منظور تضمین مقایسه نسبتاً منصفانه، برای این خطوط پایه، ما از کدهای منبع منتشر شده عمومی آنها استفاده کردیم و تنظیمات پارامتر گزارش شده در مقالات آنها را دنبال کردیم.
-
DBN یک رویکرد تشخیص نام اقتباس شده مبتنی بر شبکه باور عمیق (DBN) با بررسی دو موضوع کلیدی است: نمایش کلمه و تفسیر مدل ارائه شده توسط [ ۳۷ ].
-
DM_NLP یک مدل کلی بر اساس BiLSTM–CRF است که توسط [ ۳۸ ] پیشنهاد شده است.
-
NeuroTPR یک مدل Neuro-net ToPonym Recognition است که به طور خاص با در نظر گرفتن این بی نظمی های زبانی طراحی شده است که توسط [ ۳۹ ] پیشنهاد شده است.
-
ChineseBERTTP یک شبکه عصبی عمیق به نام BERT-BiLSTM-CRF است که یک مدل پایه شبکه عصبی بازگشتی دوطرفه (BiLSTM) را با نمایش رمزگذار دو طرفه پیشآموز از نمایش ترانسفورماتورها (BERT) گسترش میدهد تا وظیفه تشخیص نام نامی را در متن چینی انجام دهد [ ۴۰ ].
-
ChinaTR یک معماری تشخیص نام نامی چینی با نظارت ضعیف است که از ایجاد کننده مجموعه داده های آموزشی استفاده می کند که مجموعه داده های آموزشی را به طور خودکار بر اساس مجموعه های کلمات و بسامدهای کلمه مرتبط از متون مختلف و یک شناساگر پسوندی ایجاد می کند که از یک شبکه عصبی بازگشتی دو طرفه اولیه بر اساس ویژگی های خاص طراحی شده برای توپونیم استفاده می کند. به رسمیت شناختن پیشنهاد شده توسط [ ۴۱ ].
-
GazPNE2 یک رویکرد کلی برای استخراج نام مکان ها از توییت ها است که GazPNE2 نام دارد. این روزنامه جهانی (به عنوان مثال، OpenStreetMap و GeoNames)، یادگیری عمیق، و مدل های ترانسفورماتور از پیش آموزش دیده (به عنوان مثال، BERT و BERTweet)، که نیاز به داده های دستی شرح داده شده را ترکیب می کند [ ۴۲ ].
۵٫۳٫ آزمایشات روی TPCNER
در این مطالعه HMM، CRF، BiLSTM–CRF، IDCNN–CRF، IDCNN–CRF2، BiLSTM–Attention–CRF، BERT–BiLSTM–CRF، BERT–BiGRU–CRF، ALBERT–BiLSTM، ALBERT old –BiLSTM–CRF ( مدلهای ALBERT اصلی)، و مدلهای ALBERT ما -BiLSTM-CRF (ALBERT ارائهشده ما) برای آزمایش مجموعه داده TPCNER مورد استفاده قرار گرفتند و عملکرد شناسایی موجودیت نامگذاری شده توسط چهار شاخص ارزیابی شد: دقت، دقت، یادآوری، و امتیاز F1. نتایج تجربی در جدول ۹ نشان داده شده است. نتایج زیر قابل مشاهده است:
(۱) در مقایسه با مدل های غیر شبکه عصبی (یعنی HMM و CRF)، مدل های شبکه عصبی عملکرد را به طور قابل توجهی بهبود می بخشند، زیرا عملکرد اولی به سرعت بدتر می شود، در حالی که دومی می تواند عملکرد معقولی را حفظ کند. این به دلیل این واقعیت است که بیشتر ویژگیهای مورد استفاده در مدلهای غیر شبکه عصبی از ویژگیهای طراحیشده توسط انسان میآیند، که از خطاهای انباشتهای رنج میبرند که ممکن است منجر به کاهش عملکرد شود.
(۲) می بینیم که این یازده مدل عملکرد خوبی در مجموعه داده TPCNER به دست آوردند و دقت، دقت، فراخوانی و امتیازات F1 آنها اغلب از ۸۰% فراتر رفت. در میان آنها، مدل ALBERT ours –BiLSTM–CRF بهترین اثر تست را دارد و دقت، دقت، یادآوری و امتیاز F1 آن به ترتیب ۹۷٫۸٪، ۹۶٫۱٪، ۹۶٫۲٪ و ۹۶٫۱٪ است. در مقایسه با ۹ مدل دیگر، این مدل تأثیر بهتری در تشخیص نهاد نامگذاری شده بر روی مجموعه داده TPCNER دارد. به ویژه، مدل ALBERT دوباره آموزش دیده ما در مقایسه با مدل ALBERT اصلی ۷٫۸٪ بهبود یافته است.
(۳) علاوه بر این، IDCNN-CRF2 عملکرد بهتری نسبت به IDCNN-CRF به دست آورد، و IDCNN-CRF و BiLSTM-CRF تقریباً عملکرد یکسانی را به دست آوردند. هر دوی این نتایج نشان میدهند که IDCNN از پیچش گشاد شده برای افزایش سرعت تمرین استفاده میکند و ویژگیهای توالی را برای بهبود عملکرد افزایش نمیدهد.
ما آزمایشات خود را با مقایسه ALBERT-BiLSTM-CRF با شش مدل مبتنی بر یادگیری عمیق ادامه دادیم. عملکرد این مدل ها بر روی مجموعه داده TPCNER در جدول ۱۰ گزارش شده است. ما مشاهدات زیر را انجام دادیم:
(۱) ALBERT-BiLSTM-CRF بالاترین دقت را با فراخوانی یکسان ارائه می دهد. علاوه بر این، ALBERT-BiLSTM-CRF نسبت به ChineseBERTTP که در حال حاضر بهترین نتایج گزارش شده در این مجموعه داده را با دقت بالاتر برای همان فراخوانی دارد، بهبود ثابت و قابل توجهی را به دست می آورد. ما بر این باوریم که ترکیبی از ویژگیهای ALBERT که بهویژه طراحی شدهاند، ویژگیهای مهمتری را تشکیل میدهند و استخراجکننده را برای پیشبینی دقیق ترغیب میکنند.
(۲) در مقایسه با مدل پایه BiLSTM–CRF، ALBERT–BiLSTM–CRF در هر سه معیار بهتر عمل میکند، بنابراین ارزش طرحهای بهبودیافته ما، از جمله لایههای ALBERT ویژه طراحیشده را نشان میدهد. در مقایسه با DM_NLP و NeuroTPR، ALBERT–BiLSTM–CRF دقت بالاتر، امتیاز F1 بالاتر و یادآوری مشابهی را نشان میدهد.
همانطور که از جدول ۶ و جدول ۷ انتظار می رود ، برای همه مجموعه داده ها، ALBERT متعلق به ماست–BiLSTM–CRF بهترین امتیاز F1 یعنی ۹۶٫۱% را کسب می کند. در مقایسه با دو مدل یادگیری عمیق با نظارت ضعیف (NeuroTPR و GazPNE2)، مدل ارائهشده ما در هر سه معیار بهتر عمل میکند، بنابراین ارزش طراحی بهبودیافته ما را نشان میدهد که حاوی یک ALBERT دقیق تنظیم شده است. دلیل این امر این است که متون چینی اغلب شامل تعداد قابل توجهی از نامهای مکان هستند که ممکن است توسط BERT اصلی پوشش داده نشود، از جمله بسیاری از کلمات بومی (مانند “کوههای منگلیانگ” و “فلات”) و اختصارات (مانند “دیدا” و “CUG”) توسط افراد اعمال می شود. وقتی این اتفاق میافتد، معمولاً از جاسازی رمز ناشناخته عمومی برای نشان دادن کلمه بومی استفاده میشود و معنای واقعی کلمه از بین میرود.
۵٫۴٫ آزمایشات روی مجموعه داده عمومی
برای بررسی بهتر عملکرد مجموعه داده و مدل TPCNER، این مقاله همچنین از BiLSTM–CRF، IDCNN–CRF، IDCNN–CRF2، BiLSTM–Attention–CRF، BERT–BiLSTM–CRF، BERT–BiGRU–CRF، ALBERT–BiLSTM استفاده میکند. و مدل های ALBERT–BiLSTM–CRF برای آزمایش بر روی مجموعه داده Boson، مجموعه داده MSRA و مجموعه داده RenMinRiBao و از دقت، یادآوری و امتیازات F1 برای ارزیابی عملکرد شناسایی موجودیت نامگذاری شده استفاده می کند. نتایج تجربی در جدول ۱۱ نشان داده شده است. نتایج تجربی نشان می دهد که این هشت مدل به نتایج خوبی در این سه مجموعه داده دست می یابند. در مقایسه با هفت مدل دیگر، مدل ALBERT–BiLSTM–CRF بهترین عملکرد را دارد. دقت، فراخوانی و امتیاز F1 آن از سه مجموعه داده بالاتر از مدل های دیگر است. در مقایسه با سه مجموعه داده عمومی، اثر شناسایی موجودیت نامگذاری شده مجموعه داده TPCNER اساساً یکسان است و به بیش از ۹۵٪ می رسد. علاوه بر این، این مقاله همچنین امتیاز F1 مدل های BERT-BiLSTM-CRF، BERT-BiGRU-CRF، ALBERT-BiLSTM، و ALBERT-BiLSTM-CRF را پس از تنظیم فراپارامتر، همانطور که در شکل ۶ نشان داده شده است، شمارش و تجسم می کند . به وضوح می توان از شکل مشاهده کرد که امتیاز F1 مدل ALBERT-BiLSTM-CRF به طور قابل توجهی بالاتر از چهار مدل دیگر است.
در مجموع ۳۶ آزمایش کنترل شده برای تعیین بهترین تعداد عبارات برچسبگذاری شده از مجموعه داده ایجاد شده و تجزیه و تحلیل اندازه مجموعه داده برچسبگذاری شده انجام شد. اولین کارآزمایی از ۱۰۰۰ جمله استفاده کرد، در حالی که آزمون های باقیمانده از محدوده ۲۰۰۰ تا ۹۰۰۰ جمله (با اندازه گام ۱۰۰۰) استفاده کردند. شکل ۷ نتایج تجربی را از نظر میانگین دقت و یادآوری نشان می دهد.
همانطور که در شکل ۷ مشاهده می شود ، زمانی که از ۹۰۰۰ جمله استفاده شد، الگوریتم پیشنهادی به میانگین امتیاز F1 96.2% دست یافت. BERT-BiLSTM-CRF، BERT-BiGRU-CRF، و ALBERT-BiLSTM (پایه) فقط به ترتیب به امتیازات F1 92.1٪، ۹۴٫۴٪ و ۹۵٫۳٪ رسیدند. این نشان می دهد که الگوریتم NER پیشنهادی از خط پایه بهتر عمل می کند.
۵٫۵٫ تجزیه و تحلیل فرسایش
برای تأیید اثربخشی پیشآموزش روی رویکردمان، مدلهای مختلف زیر را طراحی کرده و آزمایشهایی را روی مجموعه دادههای ساختهشده انجام میدهیم ( جدول ۱۲ را ببینید ).
جدول ۹ نتایج تجربی BiLSTM-CRF را به عنوان یک روش پایه نشان می دهد. در جدول ۹ ، عملکرد BiLSTM-CRF در تمام معیارهای ارزیابی در مقایسه با سایر مدلها ضعیف است. علاوه بر این، از نمره کل مدل F1 در جدول ۹ ، دریافتیم که استفاده از لایه BERT یا استفاده از لایه ALBERT بالاتر از روش پایه است. این پدیده اثربخشی ترکیب مدل پیشآموزشی را نشان میدهد.
در مقایسه با BiLSTM–CRF، مقدار F1 مدل را میتوان با استفاده از مدل پیشآموزشی (BERT) در جدول ۹ بهبود بخشید . دلیل ممکن است این باشد که پیشآموزش، توصیف بهتر ویژگیهای توالی متن را ممکن میسازد. این پدیده اثربخشی استفاده از مدل پیشآموزشی را نشان میدهد.
در مقایسه با Bi-LSTM-CRF، مدلی که از توجه فضایی استفاده میکند از نظر امتیاز P، R و F1 در جدول ۹ بهبود یافته است . دلیل ممکن است این باشد که مدل های از پیش آموزش دیده دامنه می توانند ویژگی های متن جغرافیایی را بهتر مشخص کنند و سپس توانایی استخراج ویژگی های رمزگذاری BiLSTM را بهبود می بخشند. این پدیده اثربخشی استفاده از مدل پیشآموزشی جغرافیایی را نشان میدهد.
۵٫۶٫ بحث
۵٫۶٫۱٫ مطالعه ابلیشن
ما بر تجزیه و تحلیل مجموعه داده های ساخته شده (TPCNER) تمرکز کردیم. ما نمونه ای از مجموعه TPCNER را بررسی کردیم تا ببینیم آیا مدل ارائه شده می تواند موارد را در حوزه جغرافیایی بهتر تشخیص دهد. در این مثال، نهاد “بیمارستان گولو دانشگاه مهندسی هاربین” تنها دو بار در مجموعه آموزشی ظاهر شد. نهاد “بیمارستان گولو دانشگاه مهندسی هاربین” توسط مدل BERT-BiLSTM-CRF به عنوان دو نهاد، “دانشگاه مهندسی هاربین” و “بیمارستان گولو”، همانطور که در جدول ۱۳ نشان داده شده است، شناخته می شود.. از آنجایی که این دو مورد در مجموعه آموزشی فراوانتر هستند، تشخیص بدون اطلاعات تقویتی فریبنده خواهد بود. به دلیل اطلاعات مرزی نادرست، مدل BERT-BiLSTM-CRF به اشتباه “بیمارستان گولو دانشگاه مهندسی هاربین” را به عنوان یک موجودیت طبقه بندی می کند. از آنجایی که اطلاعات تقویت گسترده تری در مدل پیشنهادی ما گنجانده شده است، پیش بینی های دقیقی را ارائه می دهد. علاوه بر این، اصطلاحات “دانشگاه مهندسی هاربین” و “بیمارستان گولو” در نمونه مشابه هستند، که دلالت بر رابطه تنگاتنگتر بین ویژگیهای واحد تجاری دارد.
۵٫۶٫۲٫ تجزیه و تحلیل خطا
ما جملات زیادی را از مجموعه تست انتخاب کردیم و اشتباهات نمونه آنها را برای ارزیابی خروجی واقعی مدلهای مختلف ارزیابی کردیم. شکل ۸ نتایج تشخیص مدل های BERT-BiLSTM-CRF، BERT-BiGRU-CRF، ALBERT-BiLSTM، و ALBERT-BiLSTM-CRF را در متون نمونه نشان می دهد، که در آن کاراکترهای قرمز نشان دهنده خطا هستند.
همانطور که در شکل ۸ نشان داده شده است، مدل ما از نظر تشخیص بهتر از بقیه بود، در حالی که مدل BERT-BiLSTM-CRF نتوانست موجودیت های تودرتو را تشخیص دهد. به عنوان مثال، ALBERT–BiLSTM–CRF «Yang Xinhe» را بهعنوان یک موجودیت در مورد ۱ شناسایی کرد، اما مدلهای دیگر نمیتوانند این موجودیت را تشخیص دهند، زیرا نام مکانی است که از نام یک شخص تشکیل شده است و الگوریتمهای زیادی نام فرد را تشخیص میدهند. در مورد ۲، BERT–BiLSTM–CRF «Horqin» را بهعنوان یک موجودیت شناسایی میکند، اما شخصیتهای مرتبط «Right Wing Front Banner Debs Town» که در فاصلهای طولانی در بافت قرار داده شدهاند، از قلم افتاده است. مدل ALBERT–BiLSTM–CRF با موفقیت موجودیتهای تودرتوی ریزدانه «شهرک دیبز، بنر جلوی جناح راست هورکین» را در مورد ۲ شناسایی کرد.
با تجزیه و تحلیل نتایج تشخیص، دریافتیم که (۱) دلیل تأثیرگذاری بر دقت مدل این است که برخی از نامها در دادهها حاوی کلمات توپونیمی هستند که در نتیجه یادآوری نادرست است، به عنوان مثال، «Yang Xinhe» و «Li Qingxian». ; (۲) دلیل کم یادآوری این است که برخی از نامهای پیچیده به درستی تشخیص داده نمیشوند، به عنوان مثال، “Deebs Town of Horqin Front-wing Front Benner” به درستی شناسایی نشده است. به عنوان مثال، در «فاجعه باد و تگرگ باعث ریزش محصول در شهرک دبس از سمت راست بنر جلویی هورقین شد»، «بلند جلوی جناح راست شهرک دبس هورقین» به درستی شناسایی نشد. در مواجهه با باران و سیل، Qiongzhong Li و شهرستان خودمختار Miao فوراً جابجا شدند. نام «شهرستان خودمختار چیونگ ژونگ لی و میائو» به درستی در «۳۵ نفر» شناسایی نشده است. دلیلش طولانی بودن نام مکان است،
۵٫۶٫۳٫ تجزیه و تحلیل کیفیت مشروح
BiLSTM-CRF و IDCNN به عنوان اساسیترین مدلها در نظر گرفته میشوند و برای ارزیابی کیفیت مجموعه مشروح، با استفاده از اعتبارسنجی متقابل ۱۰ برابری سلسله مراتبی استفاده شدند [ ۳۶ ، ۳۷ ]. در سطح کلان، نتایج تجربی دقیق ارائه شده در جدول ۶نشان می دهد که BiLSTM-CRF و IDCNN به ترتیب به امتیازات F1 86% و ۸۷% می رسند. در سطح خرد، BiLSTM-CRF و IDCNN عملکرد عالی را برای ترافیک، سیستمهای آب و سازمان نشان میدهند، بنابراین سهولت شناسایی این دستهها را نشان میدهند. به طور خاص، برای آژانس های سازمانی، امتیاز F1 هر دو مدل به ترتیب ۹۲٫۱۶٪ و ۹۳٫۷۹٪ است. به دلیل عدم تطابق ایجاد شده به دلیل عدم وجود ویژگی های مرزی و استفاده ترکیبی از نویسه ها، اعداد و حروف، تشخیص برخی چیزها مانند نام مکان های بسیار مشخص، نام مکان های مختلط و نام مکان های ادغام شده، دشوار است. شکل ۲ نشان می دهد که چگونه کمبود داده برای برخی دسته ها بر عملکرد تأثیر می گذارد. علاوه بر این، همانطور که در شکل ۵ نشان داده شده است، چندین اشتباه پیش بینی را ذکر کردیم. به طور کلی، یافتههای ارزیابی نشان میدهد که مجموعه شرحدادهشده در این مطالعه قابل اعتماد است و ممکن است برای شناسایی موجودیتهای حوزه جغرافیایی مورد استفاده قرار گیرد.
ماتریس سردرگمی در شکل ۹ و شکل ۱۰ تعداد نامهایی را نشان میدهد که با استفاده از الگوریتم پیشنهادی از مجموعه داده استخراج شدهاند، و همچنین تعداد حاشیهنویسیهای استاندارد طلایی را برای هر کلاس توپونیوم نشان میدهد. شکل ۱۰ نشان می دهد که الگوریتم پیشنهادی دقت نسبتاً کمتری برای کلاس های نام های TRA دارد. این را می توان به عدم تعادل داده نسبت داد. عدم تعادل در تعداد موجودیت باعث میشود که الگوریتم بر روی حداقل کردن خطاهای طبقهبندی برای موجودیتهای دارای تعداد بیشتر تمرکز کند، در حالی که خطاها را برای موجودیتهایی با تعداد کمتر در نظر نمیگیرد.
۶٫ نتیجه گیری و کار آینده
در این مقاله، ما یک روش شبکه عصبی ترکیبی برای تشخیص نام مکان چینی پیشنهاد میکنیم که مشکلات فوق را با یادگیری نمایش ویژگیهای سطح کلمه در لایه ALBERT، استخراج ویژگیهای معنایی متنی در لایه BiLSTM، و تولید دنبالههای برچسب بهینه در لایه حل میکند. لایه CRF نتایج تجربی نشان می دهد که روش تشخیص نام نامی پیشنهادی عملکرد خوبی در تمامی شاخص های ارزیابی دارد. ما ALBERT-BiLSTM-CRF را با استفاده از یک مجموعه داده مشروح شده توسط انسان و سه مجموعه داده عمومی آموزش می دهیم. ما چندین روش آموزشی را آزمایش کردیم و متوجه شدیم که ترکیبی از دادههای حاشیهنویسی شده توسط انسان، بهترین نتایج را ایجاد میکند. آزمایشهای ارزیابی بر اساس سه مجموعه داده آزمایشی، یعنی Boson، MSRA و RenMinRiBao، عملکرد بهبود یافته ALBERT-BiLSTM-CRF را در مقایسه با مجموعه ای از مدل های یادگیری عمیق نشان می دهد. این کار تلاش کرد تا به عنوان منبعی برای مطالعات شناسایی موجودیت نامگذاری شده در مناطق مختلف جغرافیایی باشد. ما روی اضافه کردن ویژگی های بیشتر و ایجاد تغییرات معقول تر در وزن این ویژگی ها در آینده کار خواهیم کرد.