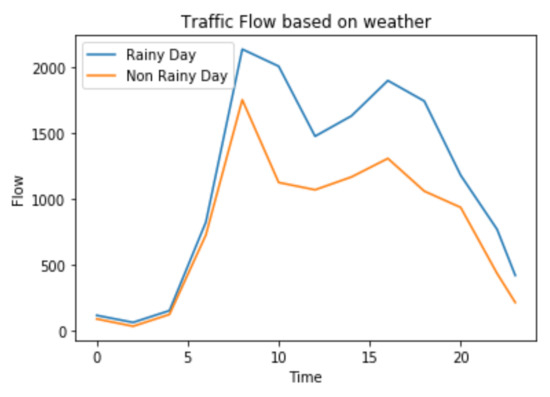
چکیده
کلید واژه ها:
فضایی و زمانی توجه ؛ عوامل خارجی ؛ رمزگذار – رمزگشا ; پیش بینی ترافیک ؛ همجوشی داده ها
۱٫ مقدمه
-
طراحی یک رمزگذار و رمزگشای دقیق مبتنی بر منطقه برای گرفتن وابستگی های مکانی و زمانی چند مقیاسی در فضای غیر اقلیدسی.
-
طراحی یک مدل فیوژن تصمیم با الحاق خروجی رمزگشا با عوامل خارجی مانند آب و هوا، تعطیلات و نقاط مورد علاقه برای پیشبینی جریان ترافیک آینده در یک افق.
۲٫ کارهای مرتبط
-
مدلهای مدل محور یا پارامتریک بر اساس چندین فرض و پیششرط هستند که شامل مدل میانگین متحرک یکپارچه خودکار (ARIMA)، فیلتر کالمن و شبکههای بیزی میشود. مدل ARIMA برای پیشبینی جریان ترافیک تصادفی شناخته شده است. انواع مدل ARIMA بر اساس جریان ترافیک Kohonen ARIMA، زیر مجموعه ARIMA، ARIMA فصلی و سری زمانی ARIMA یکپارچه برای پیشبینی ترافیک کوتاهمدت هستند [ ۵ ، ۶ ، ۷ ]. مدل ARIMA یک چارچوب شناخته شده و موثر برای پیش بینی ترافیک است. با این حال، مدلهای پارامتری نمیتوانند به طور کامل غیرخطی بودن ترافیک را نشان دهند و ویژگیهای مکانی-زمانی را استخراج کنند.
-
مدلهای مبتنی بر داده یا ناپارامتریک از هوش مصنوعی برای مدیریت دادههای بزرگ در زمانی که جریان ترافیک بهصورت پویا تغییر میکند، استفاده کردهاند [ ۱ ، ۲ ]. در ابتدا، روشهای ناپارامتریک مبتنی بر یادگیری ماشین بودند. برای پیش بینی ترافیک، جنگل تصادفی، ماشین بردار پشتیبان [ ۲۰ ] و k-نزدیکترین همسایه (KNN) [ ۲۱ ] استفاده شد. اخیراً مدلهای یادگیری عمیق، مانند شبکههای عصبی [ ۲ ، ۲۲ ]، شبکههای باور عمیق (DBN) [ ۲۳ ، ۲۴ ، ۲۵ ، ۲۶ ]، CNN [ ۲۷ ، ۲۸ ]، شبکههای عصبی مصنوعی (ANN) [ ۲۹ ]] و RNN، [ ۳۰ ، ۳۱ ، ۳۲ ] در پیش بینی ترافیک کوتاه مدت موفق بوده اند. برای غلبه بر محدودیتهای ناشی از شیب ناپدید شدن و مشکلات گرادیان انفجاری که در RNN رخ میدهند، یک شبکه LSTM [ ۱۴ ، ۳۳ ، ۳۴ ، ۳۵ ] مستقر شد و مشخص شد که دارای پیشبینی عالی است. اگرچه این مدلها ماهیت غیرخطی و تصادفی جریان ترافیک را در نظر گرفتهاند، اما برای پیشبینی بلندمدت مؤثر نیستند. با این حال، ترافیک طولانی مدت با استفاده از LSTM در [ ۱ ] و شبکه عصبی عمیق در [ ۲ ] پیشبینی میشود.]. به طور خاص، چالشها در تعیین دقت و قابلیت اطمینان سیستمهای غیرخطی، پیچیده و متغیر با زمان وجود دارند. با این وجود، ادبیات اخیر بر فضای غیر اقلیدسی متمرکز شده است تا به طور موثر ویژگیهای مکانی-زمانی را به تصویر بکشد. نویسندگان در [ ۱۵ ] یک شبکه عصبی زمانی دورهای مبتنی بر توجه را با استفاده از LSTM برای پیشبینی ترافیک در فضای غیراقلیدسی پیشنهاد کردهاند. شبکه کانولوشن چند گراف [ ۱۶ ] وابستگی های مکانی و زمانی را با کاربردهای گسترده خود در GCN به دست آورده است. با این حال، عوامل خارجی و آب و هوا در نظر گرفته نمی شود.
-
مدلهای ترکیبی یا ترکیبی، مدلهای جداگانه را با هم ترکیب میکنند تا مزایای هر دو مدل را در صورت ترکیب برای بهبود دقت تخمین فراهم کنند. قابل توجه است که مدل های هیبریدی در پیش بینی جریان لحظه ای ترافیک دقیق تر و موثرتر هستند. نویسندگان در [ ۱۱ ] از DBN و یادگیری چند وظیفه ای همراه با ترکیب داده ها برای آب و هوا برای افزایش دقت پیش بینی استفاده کرده اند. ادغام دادهها را قادر میسازد که اطلاعات از چندین منبع با هم ترکیب شوند تا قابلیت اطمینان بالایی ایجاد کنند. ARIMA و LSTM برای پیشبینی ترافیک کوتاهمدت ترکیب شدند و به دقت بهتری در [ ۱۲ ] دست یافتند. به همین ترتیب، [ ۹ ] به طور مشترک CNN و LSTM را بر اساس فاصله اقلیدسی مدلسازی کرده است. علاوه بر این، در [ ۸ ، ۹ ،۱۰ ]، ویژگی های مکانی و زمانی بدون در نظر گرفتن عوامل خارجی مورد مطالعه قرار می گیرند. علاوه بر این، یک مدل ترکیبی با CNN و LSTM برای پیشبینی دمای هوای ساعتی در [ ۱۷ ] استفاده شده است. به همین ترتیب، GCN دو جزئی توجه چند بردی [ ۱۸ ] و شبکه عصبی کانولوشنی بازگشتی انتشار (DCRNN) [ ۱۹ ] فضای غیراقلیدسی را با انواع CNN و GRU بررسی کرده اند. بنابراین، مدلهای ترکیبی نسبت به روشهای مبتنی بر مدل، دقت را بهبود بخشیدهاند و برای تحلیل ترافیک بلادرنگ مناسب هستند.
۳٫ فرمول مسئله
یک ناحیه آردارای N پیوند است که توسط اتصالات برای ایجاد یک شبکه به هم متصل می شوند. هر پیوند یک سری زمانی از حجم ترافیک را در زمان t ایجاد می کند که با نشان داده شده است ایکسمن= (ایکسمن۱،ایکسمن۲، ⋯ ،ایکسمنتی⋯ایکسمنتی) ∈آرتی. ماتریس حجم ترافیک با الحاق بردارهای سری زمانی همه N پیوندهای منطقه به دست می آید.آردر طول زمان T :
به طور کلی، جریان ترافیک تحت تأثیر عوامل خارجی مانند آب و هوا است. وضعیت آب و هوای هر پیوند N در زمان t با نشان داده می شود ایکسمنتی= (ایکس۱تی،ایکس۲تی، ⋯ ،ایکسnتی) ∈آرتی. بنابراین، نشان دهنده شرایط آب و هوایی همه N پیوندها در آر، به عنوان یکی از پارامترهای ورودی، ماتریس آب و هوا تولید می شود:
هدف این است که حجم ترافیک را برای افق های K آینده پیش بینی کنیمآرهمانطور که در رابطه ( ۳ )، که تلفیقی از مشاهدات تاریخی جریان ترافیک و آب و هوا است. ایکسˆتی=ffتو نیستی _ _ _(ایکسنتی،Eنتی):
۴٫ شبکه فضایی-زمانی غیر اقلیدسی مبتنی بر توجه (ANST)
- (من)
-
رمزگذار برای مدلسازی وابستگیهای فضایی: رمزگذار از اجزای LSTM برای استخراج وابستگیهای مکانی از دادههای ترافیک ورودی تاریخی استفاده میکند. بردارهای وزن توجه فضایی (α۱تی،α۲تی، ⋯ ،αنتی)همانطور که در شکل ۳ نشان داده شده است، با پشتیبانی از یک لایه پرسپترون چند لایه (MLP) محاسبه می شوند . بردار وزن هتیدر زمان t از آخرین حالت پنهان به دست می آیدساعتt – ۱و حالت سلولی جt – ۱. حالت های پنهان فضایی غیر اقلیدسی مبتنی بر توجه ( ساعت۱،ساعت۲، ⋯ ،ساعتتی) از رمزگذار یاد می شود و به عنوان ورودی رمزگشا LSTM برای گرفتن وابستگی های زمانی تغذیه می شود.
- (II)
-
رمزگشا برای مدلسازی وابستگیهای زمانی: رمزگشا از واحدهای LSTM برای جاسازی حالتهای پنهان فضایی استفاده میکند. بردار وزن زمانی βتی“در زمان به دست می آید تی“از آخرین حالت پنهان ساعت“t – ۱و حالت سلولی ج“t – ۱. زمینه زمانی yتی“مجموع وزن های اندازه گیری شده توسط لایه MLP و حالت های پنهان غیر اقلیدسی است ( ساعت۱،ساعت۲، ⋯ ،ساعتتی) از رمزگذار، همانطور که در شکل ۴ نشان داده شده است.
- (iii)
-
ادغام داده ها برای مدل سازی آب و هوا و عوامل خارجی: ادغام داده ها داده ها را از منابع متعدد برای غنی سازی کیفیت اطلاعات یکپارچه می کند. همجوشی تصمیم گیری، تصمیم گیری با داده های آب و هوا از معادله ( ۲ )، همراه با خروجی رمزگشا LSTM ( ۱۶ )، برای به دست آوردن یک پیش بینی پیشرفته انجام می شود.
۴٫۱٫ مدل سازی ویژگی های فضایی با رمزگذار توجه
پیشبینی جریان ترافیک برای یک منطقه به پیوندها بستگی دارد. به طور کلی، هر پیوند جداگانه در نظر گرفته می شود، یا وزن های مساوی به همه پیوندها اختصاص می یابد. با این حال، ترافیک در هر لینک یکسان نیست، در طول زمان تغییر می کند و به عوامل خارجی بستگی دارد. علاوه بر این، پیوندها وابستگی های فضایی را نشان می دهند. به عنوان مثال، جریان ترافیک پایین دست به جریان ترافیک در تقاطع ها و پیوندهای بالادست، همراه با رویدادهای خارجی بستگی دارد. به طور کلی، ساختار فضایی منطقه شناسایی شده به عنوان یک ماتریس فرموله می شود که در آن هر ورودی مربوط به مناطق مستطیلی است. در نتیجه معنایی و فاصله ایستا بین گره ها، ساختار اقلیدسی به دست می آید. با این حال، فاصله ایستا بهدستآمده نادرست است و منجر به نتایج نادرست میشود. از این رو، مکانیسمهای توجه برای گرفتن همبستگیهای فضایی با یادگیری وزنهای تعیینشده به کار گرفته میشوند. ANST از لایههای انباشته شده LSTM برای گرفتن وابستگیهای فضایی جهانی و محلی چند مقیاسی با استفاده از وزنهای توجه پویا مشتق شده از حالت سلول قبلی استفاده کرده است. جt – ۱∈آرمبرای هر پیوند i با استفاده از معادله ( ۴ ). برای دقیق تر، مدل توجه فضایی توسعه یافته وابستگی های فضایی را با LSTM و MLP محصور می کند:
جایی که vس∈آرL، بس∈آرL، دبلیوس∈آرL × ۲ M، Uس∈آرL × Tپارامترهای مدل هستند. Tanh به دلیل عملکرد آن در مدیریت مشکل گرادیان ناپدید شدن غالب به عنوان تابع فعال سازی استفاده می شود. وزن توجه فضایی به دست آمده αمنتیبا استفاده از تابع softmax در معادله ( ۵ ) تطبیق یافته و نرمال می شود به طوری که مجموع وزن های توجه یک است:
یک تغییر قابل توجه در جریان ترافیک در زمان t در فضای غیر اقلیدسی با الحاق وزن های توجه فضایی برای تولید یک بردار ستون به دست می آید:
مدل پایه LSTM برای سازگاری با وزن مکانیسم توجه بهبود یافته است هتی. معادلات اصلاح شده LSTM با پارامترها wf،wمن،wo،wج∈آرم× ( م+ ۲ N)، و بf،بمن،بo،بج∈آرمبرای فراموشی گیت، گیت ورودی، گیت خروجی و سلول حافظه با σبه عنوان تابع فعال سازی در معادلات ( ۷ )-( ۱۲ ) آورده شده است:
۴٫۲٫ مدلسازی ویژگیهای زمانی با رمزگشای توجه
به طور کلی، رمزگشای LSTM افق آینده را با استفاده از حالت های پنهان پیش بینی می کند. یک رمزگشای دقیق برای یادگیری وزن ها از حالت های پنهان کدگذاری شده فرموله شده است. ساعت۱،ساعت۲، ⋯ ،ساعتتی) برای تولید مجموع وزنی وابستگی های زمانی. به طور دقیق تر، ترافیک به موقع است تی“بر اساس وضعیت سلول قبلی است ج“تی“– ۱∈آرپو حالت پنهان ساعت“تی“– ۱∈آرپهمانطور که در رابطه ( ۱۳ ) با استفاده از MLP به دست می آید . وزن ها به صورت تطبیقی به دست می آیند و بدیهی است که جریان ترافیک به حالت زمانی قبلی بستگی دارد و روندهای ساعتی، روزانه و هفتگی را ایجاد می کند. وجود چندین بلوک LSTM به یادگیری شباهت بین الگوهای تناوبی زمانی برای گرفتن وابستگی های بلندمدت کمک می کند. پارامترهای مدل هستند vد∈آرس، بد∈آرس، دبلیود∈آرQ × ۲ Pو Uد∈آرس×پ.
وزن زمانی بدست آمده βتی”،تیدر معادله ( ۱۴ ) با استفاده از تابع softmax نرمال می شود به طوری که مجموع تمام وزن های توجه یک است:
βتی”،تی=هایکسپ(دتی”،تی)∑تی”=۱تیهایکسپ(دتی”،تی””)
بردار زمانی yتی”از مجموع وزنی حالات پنهان مانند معادله ( ۱۵ ) اندازه گیری می شود:
yتی”=∑تی=۱تیβتی”،تیساعتتی
مراحل در رمزگشا LSTM شبیه معادلات ( ۷ )-( ۱۲ ) است. آخرین حالت پنهان رسیور با الحاق خروجی نهایی رسیور اندازه گیری می شود. ایکس^تی”-۱با حالت پنهان ساعتتی””با معادله ( ۱۶ ):
ساعتتی””={Lاستیم}دهجoدهrساعتتی””،[ایکس^تی”-۱;yتی”]
۴٫۳٫ ادغام داده های سطح تصمیم عوامل خارجی
در ترافیک گسترده منطقه، این امکان وجود دارد که دو جاده مختلف الگوهای ترافیکی مشابهی را نشان دهند. با این حال، بر اساس معنایی جاده، مانند محدودیت سرعت، تعداد خطوط، نوع جاده، و طول، جریان ترافیک به صورت پویا متفاوت است. مشابه آب و هوا، یک رمزگذاری داغ برای تبدیل ویژگی های جاده به یک بردار باینری استفاده می شود. به همین ترتیب، تعداد نقاط مورد علاقه مانند غذا، عبادتگاه، سرگرمی، و امکانات رفاهی در ۲۰۰ متری بخش جاده از Google Places API بدست میآید. با این حال، نمایش پراکنده یک کدگذاری داغ منجر به عدم همبستگی بین عوامل خارجی می شود. برای نشان دادن زمینه عوامل خارجی به عنوان یک بردار پیوسته، یک بردار تعبیه شده ایکسهمتربهددمنng=fهمتربهددمنng(ایکسonه-ساعتoتی)ساخته شده است، جایی که ایکسهمتربهددمنngبردار تعبیه آموزش دیده عوامل خارجی و ایکسonه-ساعتoتییک عبارت داغ است. برای انتخاب عوامل خارجی که برای جریان ترافیک مهم هستند، از رابطه ( ۱۷ ) برای محاسبه ضریب همبستگی پیرسون (PCC) استفاده می شود. ρ:
ρایکس،Y=جov(ایکس،Y)σایکسσY=E[(ایکس-μایکس)(Y-μY)]σایکسσY
عواملی که دارای PCC مثبت هستند به عنوان ماتریس عامل خارجی E فرموله می شوند که به عنوان بردار تغییر شکل می یابد. Eتین. وقتی تعداد لینک ها زیاد باشد، هزینه محاسباتی بالاست. معادله ( ۱۸ ) بردار طول ثابت را ایجاد می کند g”با دبلیوهو بهبه عنوان پارامترهای قابل یادگیری:
ه”=f(دبلیوهه+به)
پیشبینی نهایی جریان ترافیک از رابطه (۱۹) به دست میآید ، که یک لایه کاملاً متصل (FCL) را برای ترکیب عوامل خارجی از معادله ( ۱۸ )، همراه با خروجی رمزگشا از معادله ( ۱۶ )، که در آن فعالسازی میشود، مستقر میکند. تابع ReLu و است دبلیوایکس∈آرن×(م+پ)و بایکس∈آرنپارامترهای مدل هستند:
ایکس^تی”=آرهLتو(دبلیوایکس[yتی”;ساعتتی”;هتی”]+بایکس)
۴٫۴٫ آموزش
شبه کد الگوریتم ANST پیشنهادی در الگوریتم ۱ نشان داده شده است.
| الگوریتم ۱: الگوریتم ANST |
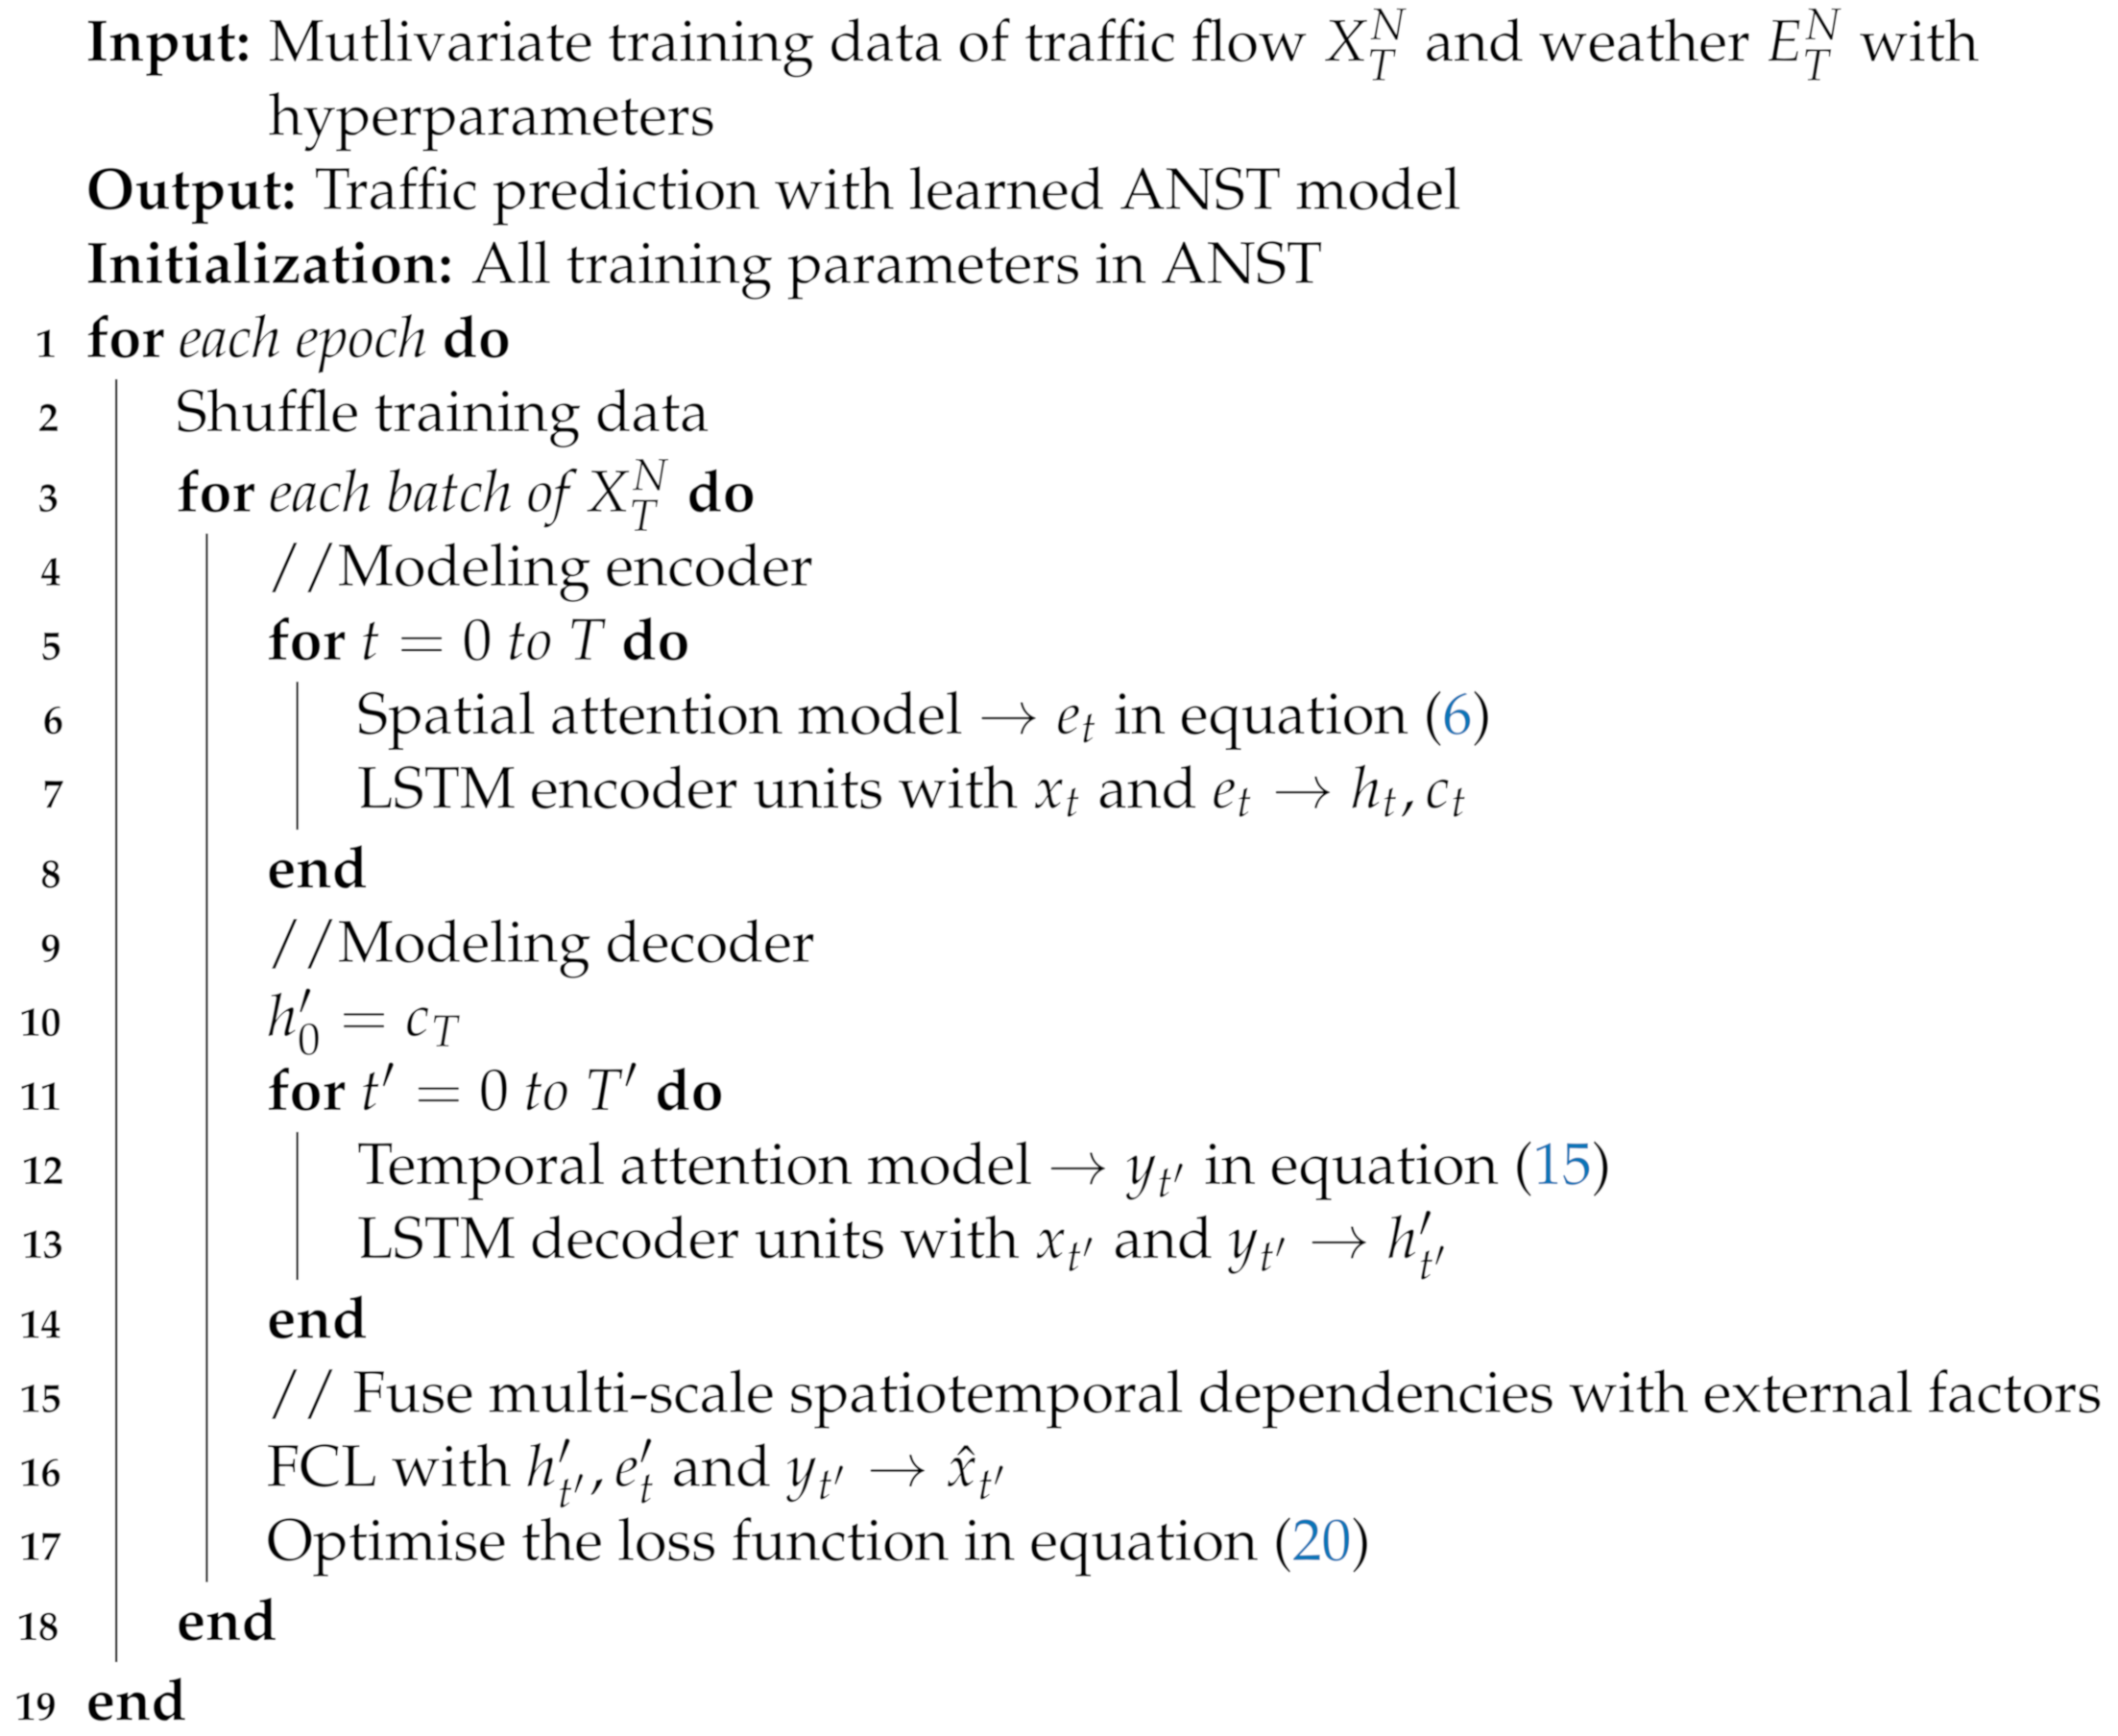 |
مدل آموزش داده شده است و از یک بهینه ساز Adam برای به حداقل رساندن میانگین مربعات خطا (MSE) در تابع ضرر استفاده می شود. به طور خاص، بهینه سازی Adam یک روش نزولی گرادیان تصادفی است که از نظر محاسباتی کارآمد است و حداقل نیاز به حافظه دارد. برای مدل هایی که دارای تعداد زیادی پارامتر هستند مناسب است. الگوریتم Adam برای تنظیم دقیق نرخ یادگیری برای هر پارامتر و بهینه سازی تنظیم پارامتر استفاده می شود. تابع ضرر Θدر معادله ( ۲۰ ) پارامترهای مدلی که باید در طول آموزش یاد بگیرند را نشان می دهد که شامل vس∈آرL، بس∈آرL، دبلیوس∈آرL×۲م، و Uس∈آرL×تیاز رمزگذار فضایی ( ۴ ); vد∈آرس، بد∈آرس، دبلیود∈آرس×۲پ، و Uد∈آرس×پاز رمزگشای زمانی ( ۱۳ ); و دبلیوایکس∈آرن×(م+پ)و بایکس∈آرناز FCL ( ۱۹ )، که در آن ایکس^تی”ندنباله پیش بینی شده است و ایکستی”نحقیقت زمینی است:
Loسس(Θ)=۱نتی”ایکس^تی”ن-ایکستی”ن۲
۵٫ نتایج و بحث
۵٫۱٫ تنظیمات آزمایشی
۵٫۲٫ معیارهای ارزیابی
عملکرد مدل بر اساس معیارهای استاندارد زیر ارزیابی میشود: میانگین خطای مطلق (MAE)، ریشه میانگین مربع خطا (RMSE) و میانگین درصد مطلق خطا (MAPE)، که تفاوت بین حقیقت زمین را اندازهگیری میکند. ایکسمنو پیش بینی ایکس^منبرای مجموعه تست N :
مآE=1ن∑من=۱نایکس^من-ایکسمن۱،
آرماسE=1ن∑من=۱ن(ایکس^من-ایکسمن)۲،
مآپE=1ن∑من=۱نایکس^من-ایکسمنایکسمن×۱۰۰،
۵٫۳٫ تنظیمات فراپارامتر
۵٫۴٫ ارزیابی مدل
۵٫۵٫ مدل های مقایسه
-
شبکه عصبی برگشتی کانولوشن انتشار (DCRNN): RNN را با شبکه های کانولوشن از طریق انتشار ترکیب می کند تا نمودار شبکه را بر اساس فاصله بین گره ها ایجاد کند. وابستگی مکانی از طریق پیادهرویهای تصادفی دو طرفه در نمودار بهدست میآید، و وابستگی زمانی از طریق چارچوب رمزگذار-رمزگشا با نمونهبرداری به دست میآید.
-
شبکههای کانولوشن چند نموداری فضایی-زمانی با دادههای مصنوعی (MGCN-SD): یک شبکه متخاصم مولد را برای تولید حجم ترافیک مصنوعی به همراه یک شبکه کانولوشن چند گراف برای استخراج ویژگیهای فضایی غیر اقلیدسی مستقر میکند.
-
شبکه کانولوشن گراف دو جزئی توجه چند بردی (MRA-BGCN): یک گراف گره بر اساس شبکه جاده و یک نمودار لبه عاقلانه برای الگوهای تعامل بین یال ها به کار می گیرد. مکانیسم توجه چند دامنه، اطلاعات گرههای همسایه را جمعآوری میکند تا تعامل را به هم مرتبط کند.
-
شبکه عصبی دورهای-زمانی مبتنی بر توجه (APTN): وابستگیهای مکانی و زمانی را با استفاده از رمزگذار-رمزگشا با مکانیسمهای توجه مدلسازی میکند.
۶٫ نتیجه گیری
اختصارات
در این نسخه از اختصارات زیر استفاده شده است:
| ITS | سیستم حمل و نقل هوشمند |
| ANST | شبکه فضایی-زمانی غیر اقلیدسی مبتنی بر توجه |
| CNN | شبکه عصبی کانولوشن |
| GCN | شبکه عصبی پیچیدگی نمودار |
| RNN | شبکه عصبی مکرر |
| LSTM | حافظه کوتاه مدت بلند مدت |
| GRU | واحد بازگشتی دردار |
| آریما | میانگین متحرک یکپارچه رگرسیون خودکار |
| KNN | k-نزدیک ترین همسایه |
| DBN | شبکه باور عمیق |
| ANN | شبکه های عصبی مصنوعی |
| DCRNN | انتشار شبکه عصبی کانولوشن بازگشتی |
| MGCN-SD | شبکه های کانولوشن چند گراف فضایی-زمانی با داده های مصنوعی |
| MRA-BGCN | شبکه کانولوشن گراف دو جزئی توجه چند بردی |
| APTN | شبکه عصبی تناوبی-زمانی مبتنی بر توجه |
| MLP | پرسپترون چند لایه |
| PCC | ضریب همبستگی پیرسون |
| FCL | لایه کاملا متصل |
| MSE | میانگین مربعات خطا |
| MAE | به معنای خطای مطلق |
| RMSE | ریشه میانگین مربعات خطا |
| MAPE | میانگین درصد خطای مطلق |
منابع
- وانگ، ز. سو، ایکس. Ding، Z. پیشبینی ترافیک طولانیمدت بر اساس معماری رمزگذار-رمزگشا LSTM. IEEE Trans. هوشمند ترانسپ سیستم ۲۰۲۱ ، ۲۲ ، ۶۵۶۱-۶۵۷۱٫ [ Google Scholar ] [ CrossRef ]
- کو، ال. لی، دبلیو. لی، دبلیو. ما، دی. وانگ، ی. پیشبینی جریان ترافیک درازمدت روزانه بر اساس یک شبکه عصبی عمیق. سیستم خبره Appl. ۲۰۱۹ ، ۱۲۱ ، ۳۰۴–۳۱۲٫ [ Google Scholar ] [ CrossRef ]
- ژنگ، جی. هوانگ، ام. پیشبینی جریان ترافیک از طریق تحلیل سریهای زمانی بر اساس یادگیری عمیق. دسترسی IEEE ۲۰۲۰ ، ۸ ، ۸۲۵۶۲–۸۲۵۷۰٫ [ Google Scholar ] [ CrossRef ]
- قوش، بی. باسو، بی. O’Mahony، M. چند متغیره پیش بینی جریان ترافیک کوتاه مدت با استفاده از تحلیل سری زمانی. IEEE Trans. هوشمند ترانسپ سیستم ۲۰۰۹ ، ۱۰ ، ۲۴۶-۲۵۴٫ [ Google Scholar ] [ CrossRef ]
- ویلیامز، بی.ام. Hoel، LA مدلسازی و پیش بینی جریان ترافیک وسایل نقلیه به عنوان یک فرآیند ARIMA فصلی: مبنای نظری و نتایج تجربی. J. Transp. مهندس ۲۰۰۳ ، ۱۲۹ ، ۶۶۴-۶۷۲٫ [ Google Scholar ] [ CrossRef ]
- کوسدویدی، ا. سوآ، ر. Karray، F. بهبود پیش بینی جریان ترافیک با اطلاعات آب و هوا در اتومبیل های متصل: یک رویکرد یادگیری عمیق. IEEE Trans. وه تکنولوژی ۲۰۱۶ ، ۶۵ ، ۹۵۰۸-۹۵۱۷٫ [ Google Scholar ] [ CrossRef ]
- Voort، MVD؛ دوگرتی، م. Watson, S. ترکیب نقشه های کوهونن با مدل های سری زمانی ARIMA برای پیش بینی جریان ترافیک. ترانسپ Res. قسمت C Emerg. تکنولوژی ۱۹۹۶ ، ۴ ، ۳۰۷-۳۱۸٫ [ Google Scholar ] [ CrossRef ]
- وانگ، ی. جینگ، سی. شبکه کانولوشنال نمودار فضایی-زمانی برای پیش بینی ترافیک چند مقیاسی. ISPRS Int. J. Geo-Inf. ۲۰۲۲ ، ۱۱ ، ۱۰۲٫ [ Google Scholar ] [ CrossRef ]
- گوا، اس. لین، ی. لی، اس. چن، ز. Wan, H. شبکههای عصبی کانولوشنال سه بعدی زمانی عمیق برای پیشبینی دادههای ترافیک. IEEE Trans. هوشمند ترانسپ سیستم ۲۰۱۹ ، ۲۰ ، ۳۹۱۳–۳۹۲۶٫ [ Google Scholar ] [ CrossRef ]
- زنگ، دی. لینگ، جی. وی، ز. تانگ، ک. چنگ، جی. پیشبینی طولانیمدت سرعت ترافیک بر اساس شبکه یادگیری ویژگیهای مکانی-زمانی چندمقیاس. IEEE Trans. هوشمند ترانسپ سیستم ۲۰۱۹ ، ۲۰ ، ۳۷۰۰–۳۷۰۹٫ [ Google Scholar ] [ CrossRef ]
- تسلنتیس، دی. ولاهوگیانی، EI; Karlaftis، MG بهبود پیش بینی های کوتاه مدت ترافیک: ترکیب مدل ها یا عدم ترکیب. IET Intel. ترانسپ سیستم ۲۰۱۵ ، ۹ ، ۱۹۳-۲۰۱٫ [ Google Scholar ] [ CrossRef ]
- لو، اس. ژانگ، Q. چن، جی. Seng, D. یک روش ترکیبی برای پیشبینی جریان ترافیک کوتاهمدت بر اساس شبکه عصبی مکرر. الکس. مهندس J. ۲۰۲۱ ، ۶۰ ، ۸۷-۹۴٫ [ Google Scholar ] [ CrossRef ]
- چن، ک. دنگ، م. Shi, Y. یک شبکه پیچیدگی نمودار جهتدار زمانی برای پیشبینی ترافیک با استفاده از دادههای مسیر تاکسی. ISPRS Int. J. Geo-Inf. ۲۰۲۱ ، ۱۰ ، ۶۲۴٫ [ Google Scholar ] [ CrossRef ]
- هوکرایتر، اس. Schmidhuber, J. حافظه کوتاه مدت طولانی. محاسبات عصبی ۱۹۹۷ ، ۹ ، ۱۷۳۵-۱۷۸۰٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
- شی، ایکس. چی، اچ. شن، ی. وو، جی. یین، ب. رویکرد توجه مکانی – زمانی برای پیشبینی ترافیک. IEEE Trans. هوشمند ترانسپ سیستم ۲۰۲۱ ، ۲۲ ، ۴۹۰۹-۴۹۱۸٫ [ Google Scholar ] [ CrossRef ]
- زو، ک. ژانگ، اس. لی، جی. ژو، دی. دای، اچ. شبکه های کانولوشن چند گراف فضایی-زمانی با داده های مصنوعی برای پیش بینی حجم ترافیک. سیستم خبره Appl. ۲۰۲۲ ، ۱۸۷ ، ۱۱۵۹۹۲٫ [ Google Scholar ] [ CrossRef ]
- هو، جی. وانگ، ی. ژو، جی. تیان، Q. پیش بینی دمای هوای ساعتی بر اساس CNN-LSTM. Geomat. نات خطر خطرات ۲۰۲۲ ، ۲۰۲۲ ، ۱۹۶۲-۱۹۸۶٫ [ Google Scholar ] [ CrossRef ]
- چن، دبلیو. چن، ال. زی، ی. کائو، دبلیو. گائو، ی. Feng, X. شبکه کانولوشن گراف دو جزئی توجه چند بردی برای پیش بینی ترافیک. در مجموعه مقالات سی و چهارمین کنفرانس AAAI در مورد هوش مصنوعی (AAAI-20)، نیویورک، نیویورک، ایالات متحده آمریکا، ۷ تا ۱۲ فوریه ۲۰۲۰؛ صص ۳۵۲۹–۳۵۳۶٫ [ Google Scholar ]
- لی، ی. یو، آر. شهابی، ج. لیو، ی. شبکه عصبی تکراری کانولوشنال انتشار: پیشبینی ترافیک مبتنی بر داده. Proc. بین المللی Conf. ماخ فرا گرفتن. ۲۰۱۸ ، arXiv:1707.01926، ۱۴۷–۱۵۵٫ [ Google Scholar ]
- مینگنگ، ز. یائوبائو، ز. گانگونگ، اچ. Gang, C. پیش بینی دقیق جریان ترافیک چند مرحله ای بر اساس SVM. ریاضی. مشکل مهندس ۲۰۱۳ ، ۲۰۱۳ ، ۱-۸٫ [ Google Scholar ] [ CrossRef ]
- سان، بی. چنگ، دبلیو. گوسوامی، پ. بای، جی. پیشبینی ترافیک کوتاهمدت با استفاده از k-نزدیکترین همسایههای خودتنظیم. IET Intel. ترانسپ سیستم ۲۰۱۸ ، ۱۲ ، ۴۱-۴۸٫ [ Google Scholar ] [ CrossRef ]
- Xie، DF; نیش، ZZ; جیا، بی. او، Z. یک مدل تغییر مسیر مبتنی بر داده مبتنی بر یادگیری عمیق. ترانسپ Res. قسمت C Emerg. تکنولوژی ۲۰۱۹ ، ۱۰۶ ، ۴۱-۶۰٫ [ Google Scholar ] [ CrossRef ]
- لی، ال. کین، ال. Qu، X. ژانگ، جی. وانگ، ی. Ran, B. پیشبینی جریان ترافیک روز آینده بر اساس یک شبکه باور عمیق بهینهسازی شده توسط الگوریتم ازدحام ذرات چند هدفه. بدانید. سیستم مبتنی بر ۲۰۱۹ ، ۱۷۲ ، ۱-۱۴٫ [ Google Scholar ] [ CrossRef ]
- کنگ، اف. لی، جی. جیانگ، بی. Song, H. پیشبینی جریان ترافیک کوتاهمدت در سیستم چند رسانهای هوشمند برای اینترنت وسایل نقلیه بر اساس شبکه باور عمیق. ژنرال آینده. محاسبه کنید. سیستم ۲۰۱۹ ، ۹۳ ، ۴۶۰-۴۷۲٫ [ Google Scholar ] [ CrossRef ]
- ژائو، ال. ژو، ی. لو، اچ. فوجیتا، اچ. روش محاسبات موازی شبکه های باور عمیق و کاربرد آن در پیش بینی جریان ترافیک. سیستم مبتنی بر دانش ۲۰۱۹ ، ۱۶۳ ، ۹۷۲-۹۸۷٫ [ Google Scholar ] [ CrossRef ]
- ژانگ، ی. هوانگ، جی. مدل پیشبینی جریان ترافیک بر اساس شبکه باور عمیق و الگوریتم ژنتیک. IET Intel. ترانسپ سیستم ۲۰۱۸ ، ۱۲ ، ۵۳۳-۵۴۱٫ [ Google Scholar ] [ CrossRef ]
- سان، اس. وو، اچ. Xiang، L. پیش بینی جریان ترافیک در سطح شهر با استفاده از یک شبکه عصبی پیچیده عمیق. Sensors ۲۰۲۰ , ۲۰ , ۴۲۱٫ [ Google Scholar ] [ CrossRef ]
- ما، ایکس. دای، ز. او، ز. ما، جی. وانگ، ی. Wang, Y. ترافیک یادگیری به عنوان تصاویر: یک شبکه عصبی پیچیده عمیق برای پیش بینی سرعت شبکه حمل و نقل در مقیاس بزرگ. Sensors ۲۰۱۷ , ۱۷ , ۸۱۸٫ [ Google Scholar ] [ CrossRef ]
- شارما، بی. کومار، اس. Tiwari، P. ANN بر اساس پیشبینی کوتاهمدت جریان ترافیک در بزرگراه دو خطه. J. Big Data ۲۰۱۸ , ۵ , ۴۸٫ [ Google Scholar ] [ CrossRef ]
- هو، آر. Chiu، YC; Hsieh, CW Crowding پیشبینی بر روی سیستمهای حمل و نقل سریع جرم با استفاده از یک شبکه عصبی بازگشتی دو طرفه وزنی. IET Intel. ترانسپ سیستم ۲۰۲۰ ، ۱۴ ، ۱۹۶-۲۰۳٫ [ Google Scholar ] [ CrossRef ]
- Xiangxue، W. لونهوی، ایکس. Kaixun، C. پیشبینی کوتاهمدت مبتنی بر داده برای ترافیک شبکه جادهای شهری بر اساس پردازش دادهها و LSTM-RNN. عرب J. Sci. مهندس ۲۰۱۹ ، ۴۴ ، ۳۰۴۳-۳۰۶۰٫ [ Google Scholar ] [ CrossRef ]
- دوویس، دی. وانگ، جی. کیم، جی. پیش بینی حرکات عابر پیاده با استفاده از شبکه های عصبی مکرر: کاربرد داده های نظارت بر جمعیت. Sensors ۲۰۱۹ , ۱۹ , ۳۸۲٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
- دو، بی. پنگ، اچ. وانگ، اس. Bhuiyan، MZA; وانگ، ال. گونگ، کیو. لیو، ال. لی، جی. LSTM باقیمانده پیچیده نامنظم عمیق برای پیشبینی جریانهای مسافربری ترافیک شهری. IEEE Trans. هوشمند ترانسپ سیستم ۲۰۲۰ ، ۲۱ ، ۹۷۲-۹۸۵٫ [ Google Scholar ] [ CrossRef ]
- مو، ال. ژائو، پی. زی، اچ. Chen, Y. T-LSTM: یک شبکه عصبی حافظه کوتاه مدت که توسط اطلاعات زمانی برای پیشبینی جریان ترافیک تقویت شده است. دسترسی IEEE ۲۰۱۹ ، ۷ ، ۹۸۰۵۳–۹۸۰۶۰٫ [ Google Scholar ] [ CrossRef ]
- تیان، ی. ژانگ، ک. لی، جی. لین، ایکس. یانگ، بی. پیشبینی جریان ترافیک مبتنی بر LSTM با دادههای از دست رفته. محاسبات عصبی ۲۰۱۸ ، ۳۱۸ ، ۲۹۷-۳۰۵ . [ Google Scholar ] [ CrossRef ]