۱٫ معرفی
سیستم دستیار راننده پیشرفته (ADAS) و رانندگی خودکار (AD) اجزای مهم یک جامعه ترافیکی ایمن هستند. ADAS از فنآوریهای حسگر مختلف برای ارائه اطلاعات، هشدارها و کمک به راننده برای بهبود توانایی او در واکنش به خطرات جاده از طریق رابط انسان و ماشین استفاده میکند. علاوه بر این، AD به وسایل نقلیه اجازه می دهد تا بدون هیچ گونه مداخله انسانی بر اساس سیستم های ادراک، برنامه ریزی، تصمیم گیری و کنترل اساسی رانندگی کنند. در میان مناطق ADAS و AD یک هدف مشترک و اساسی وجود دارد: رانندگی ایمن. پیش بینی حرکت طولانی مدت وسیله نقلیه (LVMP) یک فناوری مهم برای رانندگی ایمن است. ۱] به دلیل توانایی آن در پیش بینی وضعیت خودرو از قبل؛ بنابراین می توان خطر آتی را شناسایی کرد. با این حال، LVMP به دلیل عدم قطعیت های مربوط به دینامیک خودرو و پیچیدگی های محیط، هرگز کار بی اهمیتی نیست.
برای دههها، روشهای مختلفی برای توضیح تکامل حرکت وسیله نقلیه در بازه زمانی طولانی پیشنهاد شده است [ ۲ ]. پنج ژانر اصلی در مطالعات LVMP وجود دارد: (۱) روشهای مبتنی بر مدل فیزیکی که از عبارات ریاضی صریح برای توصیف تکامل حرکت وسیله نقلیه استفاده میکنند، مانند [ ۳ ، ۴ ]. (۲) روشهای مبتنی بر تطبیق مسیر که مسیرهای وسایل نقلیه را به الگوهای حرکتی معمولی برای دستیابی به پیشبینی حرکت درازمدت ترسیم میکنند، مانند [ ۵ ]. (۳) روشهای مبتنی بر یادگیری ماشینی که مدلهای پیشبینی را از دادههای تاریخی یاد میگیرند، مانند [ ۶ ، ۷ ، ۸ ، ۹]؛ (۴) روشهای به کمک نقشه که از دادههای نقشه، بهویژه هندسههای نقشههای با وضوح بالا (HD)، برای تحقق پیشبینی حرکت درازمدت استفاده میکنند، مانند [ ۱۰ ]. (۵) روش های ترکیبی که حداقل از دو روش فوق استفاده می کنند، مانند [ ۱۱ ].
این روش ها سعی می کنند با عدم قطعیت ها و پیچیدگی های موجود در LVMP از دیدگاه های مختلف کنار بیایند. با این حال، هر نوع روش دارای مزایا و معایب است و برخی از چالش ها باقی می ماند. روش های مبتنی بر مدل فیزیکی ساده و کارآمد هستند. با این حال، یک وسیله نقلیه نه تنها توسط قوانین فیزیکی، بلکه یک انسان و محیط های ترافیکی، به عنوان مثال، شرایط جاده و علائم ترافیکی نیز کنترل می شود. کار قبلی ما نشان داد که یک مدل فیزیکی منفرد قادر به پیشبینی بلندمدت قابل اعتماد نیست [ ۱۲]. روشهای مبتنی بر تطبیق مسیر و یادگیری ماشینی به دلیل استفاده از حجم عظیمی از دادههای تاریخی از پیش آماده شده، پیشبینیهای معقولی دریافت میکنند. بنابراین آنها از نظر محاسباتی گران هستند و داده مصرف می شوند. دقت پیشبینی به شدت به غنای دادههای تاریخی جمعآوریشده وابسته است. روشهای به کمک نقشه هم کارایی و هم کارایی را در نظر میگیرند. با تولید انبوه نقشه های HD، برخی از روش های معمولی به کمک نقشه در سال های اخیر پیشنهاد شده اند، مانند [ ۱۰ ، ۱۱ ، ۱۳ ].]. با این حال، اینها فاقد پایه های معقول برای ترکیب داده های نقشه ایستا هستند که توسط سازندگان نقشه با حرکت پویا وسیله نقلیه تعریف شده است. ترکیب اجباری آنها باعث می شود پیش بینی به داده ها/ویژگی های نقشه ایستا همگرا شود و دینامیک وسیله نقلیه مطمئناً از بین می رود، به عنوان مثال، پیش بینی مسیر آنها به خط مرکزی خط و سرعت پیش بینی شده به سرعت ثابت همگرا می شود. ویژگی ها در نقشه ها
یک مسیر خاص را می توان به عنوان نتیجه تعامل بین یک وسیله نقلیه خاص و راننده در محیط های خاص در نظر گرفت. به عنوان سوابق حرکات دینامیکی وسیله نقلیه، داده های مسیر حرکتی فضایی وسایل نقلیه، مانند موقعیت، سرعت، انحراف، سرعت انحراف و شتاب، در واقع رفتارهای فضایی وسایل نقلیه را از چندین جنبه منعکس می کنند. به عنوان مثال، موقعیت نزدیک به سمت راست یک خط نشان می دهد که وسیله نقلیه به راست خواهد پیچید. سرعت ها و شتاب ها در امتداد بخش های مختلف جاده بازتابی از سبک های رانندگی در فضاهای مختلف بود. در پیشبینیهای حرکت خودرو که پر از عدم قطعیت هستند، این اطلاعات برای اصلاح پیشبینیهای مدلهای ریاضی بسیار مهم است. به منظور غلبه بر معایب ژانرهای ذکر شده در LVMP، این مقاله در اقدامی بدیع،
مشارکت های اصلی این مقاله در زیر خلاصه می شود:
-
یک روش LVMP شخصی جدید مبتنی بر پایگاه داده فضایی و داده های مسیر حرکتی پیشنهاد شده است. متفاوت از روشهای مبتنی بر دادههای تاریخی موجود که دانش را از حجم عظیمی از دادهها یاد میگیرند، روش ما اطلاعات مربوطه را بر اساس روابط فضایی از طریق یک پایگاه داده فضایی سازمانیافته بازیابی میکند. علاوه بر این، عوامل شخصی نادیده گرفته شده در روش های حاضر، مانند اطلاعات راننده و خودرو، در این مقاله در نظر گرفته شده است.
-
یک سیستم پایگاه داده فضایی در ابتدا در یک چارچوب کلاسیک KF تعبیه شده است. این ترکیب سیستم ما را سبک وزن می کند و استفاده از جستجوی فضایی باعث می شود که الگوریتم ما بتواند به سرعت بیشترین داده های مرتبط با فضایی را پیدا کند.
-
در این مقاله دقت و کارایی الگوریتم ها مورد بحث قرار گرفته است.
ادامه این مقاله به شرح زیر سازماندهی شده است. برخی از کارهای مرتبط در بخش ۲ بررسی شده است . سپس یک نمای کلی از سیستم ما در بخش ۳ ارائه شده است و روش شناسی این مقاله به طور مفصل در بخش ۴ ارائه شده است . آزمایش ها در بخش ۵ مورد بحث قرار می گیرند . کار آینده در بخش ۶ خلاصه شده و مقاله در بخش ۷ نتیجه گیری شده است .
۲٫ کارهای مرتبط
پیشبینی بلندمدت حرکت وسیله نقلیه یک حوزه تحقیقاتی مهم در میان AD و ADAS است. در [ ۱۲ ]، مدلهای نرخ و سرعت چرخش ثابت (CTRV) و سرعت چرخش و شتاب ثابت (CTRA) مستقیماً برای پیشبینی حرکت خودرو در چارچوب KF حلقه باز بدون هیچ گونه اصلاح اطلاعات خارجی استفاده شدند. نتایج نشان می دهد که یک مدل ریاضی تنها برای LVMP مناسب نیست. اگرچه یک مدل حرکت خودروی فیزیکی مستقل نمیتواند به طور قابل اعتماد پیشبینی کند، تغییر بین مدلهای حرکتی مختلف در صحنههای مختلف با استفاده از سیستم استدلال Dempster-Shafer میتواند یک پیشبینی کامل ایجاد کند [ ۴ ]]. با این حال، تا به امروز، مطالعات کمی تنها از مدلهای فیزیکی برای انجام LVMP استفاده کردهاند، زیرا برخی از فرضیههای ثابت اجتنابناپذیر مدلهای حرکتی در بازه زمانی طولانی غیرمنطقی هستند. یک جبران، در نظر گرفتن کامل عدم قطعیت ها در پیش بینی ها، مانند [ ۱۴ ، ۱۵ ، ۱۶ ] است.
استفاده از داده های تاریخی برای پیش بینی حرکت وسیله نقلیه در محدوده زمانی طولانی یک روش رایج و غالب است. یک مطالعه اولیه را می توان به سال ۲۰۰۹ برمی گرداند [ ۵ ]. نویسندگان یک روش حرکت طولانی مدت را پیشنهاد کردند که طبقه بندی مسیر و یک چارچوب فیلتر ذرات را ترکیب می کرد. این یک روش به اصطلاح مبتنی بر تطبیق مسیر بود. آنها از یک متریک متداول متوالی متداول و طولانیترین متداول چرخشی مبتنی بر کواترنیون برای اندازهگیری شباهت مسیر استفاده کردند. پروفیل های سرعت و زمان به عنوان ارائه محیط های اطراف در [ ۱۷ ] معرفی شدند]، که در آن از فیلتر ذرات برای ترکیب اطلاعات محیط ها و مدل های حرکت استفاده شده است. با این حال، الگوریتم فقط موقعیت های یک بعدی را در طول مسیرها پیش بینی می کرد. هوش مصنوعی (AI) یک پارادایم قدرتمند برای پیش بینی ترافیک است [ ۱۸ ]. فرآیند گاوسی برای یادگیری پارامترهای مسیرهای خودرو در [ ۱۹ ] استفاده شد. علاوه بر این، برای در نظر گرفتن تعاملات وسایل نقلیه، یک شبکه بیزی پویا در [ ۲۰ ] استفاده شد. در [ ۲۱ ، ۲۲ ، ۲۳ ]، شبکه های عصبی نموداری برای مدل سازی تعاملات پیچیده بین وسایل نقلیه و زیرساخت های کنار جاده استفاده شد. شبکههای عصبی عمیق نیز برای پیشبینی مسیرهای خود-خودرو با استفاده از مشاهده محیط در [.۲۴ ]. شبکههای حافظه کوتاهمدت بلند مدت (LSTM) بهطور گسترده در کارهای توالی مانند پیشبینی ترافیک و مسیر استفاده میشوند. در [ ۷ ]، یک شبکه LSTM برای پیش بینی مسیر وسایل نقلیه در بزرگراه ها استفاده شد. مکانیسمهای توجه مکانی و زمانی به شبکههای LSTM در [ ۸ و ۹ ] معرفی شدند]. یک اشکال رایج روش های فوق این است که آنها باید مقادیر زیادی از داده های تاریخی را برای آموزش از قبل جمع آوری کنند و هزینه محاسبات آنها بسیار بالاتر است. در این مقاله، ما آن را داده و محاسبات مصرفی (DCC) می نامیم. علاوه بر این، این روش ها داده های مسیر از رانندگان و وسایل نقلیه مختلف را یکسان در نظر می گیرند که غیر منطقی است. به عنوان مثال، استفاده از داده های مسیر رانندگان قدیمی برای پیش بینی حرکت وسیله نقلیه یک راننده جوان قابل اجرا نیست. همچنین استفاده از مشخصات سرعت خودروهای اسپرت برای پیشبینی سرعت اتوبوس مدرسه نادرست است. ویژگی های شخصی، مانند اطلاعات راننده و وسیله نقلیه وی، باید در نظر گرفته شود.
تجاری سازی نقشه های HD راه حل جدیدی برای LVMP ارائه می دهد و امکان سنجی آن در برخی مطالعات تایید شده است. در [ ۱۰ ]، یک فیلتر کالمن توسعه یافته (EKF) برای به روز رسانی پیش بینی انجام شده توسط یک مدل دوچرخه سینماتیکی با استفاده از اطلاعات به دست آمده از نقشه های HD، مانند موقعیت، عنوان، و سرعت به کار گرفته شد. در این مقاله، مجذور فاصله ماهالانوبیس برای تعیین خط ترافیک به عنوان دسترسی به داده های نقشه استفاده شد. به طور مشابه، در [ ۱۳ ]، یک EKF برای ترکیب یک مدل حرکت شتاب یکنواخت و مدل سرعت که بر اساس نقشه HD و سرعت های مشاهده شده ساخته شده بود، استفاده شد. در [ ۱۱]، نویسندگان یک روش دوخت آگاه از عدم قطعیت را پیشنهاد کردند که مسیرهای کوتاهمدت پیشبینیشده توسط مدلهای آموختهشده را با اهداف بازیگر بلندمدت مشتق شده از خطوط مرتبط ترکیب میکرد. روشهای به کمک نقشه ترکیبی از حرکات پویا وسیله نقلیه با دادههای نقشه استاتیک را مجبور میکنند، که باعث از بین رفتن دینامیک در LVMP میشود.
در این مقاله، یک روش LVMP جدید پیشنهاد شده است. مقایسه بین روش پیشنهادی و برخی مطالعات معمولی که از پنج ژانر فوق انتخاب شده اند در جدول ۱ ارائه شده است.. از جدول میتوان دریافت که: (۱) روش ما به پنج ژانر تعلق ندارد. به طور جدید، آن را در یک چارچوب KF شامل یک پایگاه داده فضایی پیاده سازی شده است. متفاوت از روشهای قبلی که نیاز به جمعآوری حجم عظیمی از دادههای آموزشی و یادگیری مدلهای پیشبینی بر اساس دادهها دارند، که DCC است، روش ما مستقیماً اطلاعات را بر اساس روابط فضایی در فرآیند پیشبینی بازیابی میکند. فرآیند آموزش مورد نیاز نیست. (۲) در مقایسه با روشهای به کمک نقشه که دینامیک وسیله نقلیه را در پیشبینیها از دست میدهند، روش ما از دادههای مسیر حرکتی فضایی راننده برای پیشبینی حرکات وسیله نقلیه استفاده میکند. پیشبینیهای ما با سبکهای رانندگی شخصی راننده در فضاهای مختلف همگرا میشوند و پویایی حفظ میشود. (۳) علاوه بر این، پیش بینی ما شخصی است.
۳٫ نمای کلی سیستم
الهامبخش روش پیشنهادی اولین قانون جغرافیایی توبلر است: همه چیز با هر چیز دیگری مرتبط است، اما چیزهای نزدیک بیشتر به یکدیگر مرتبط هستند [ ۲۵ ]. در زمینه ما، ما فرض می کنیم که در بیشتر موارد رفتارهای وسیله نقلیه از نظر فضایی همبستگی دارند. به عنوان مثال، در یک بخش خاص، وسایل نقلیه همیشه سرعت های مشابهی از خود نشان می دهند و هنگامی که به یک تقاطع یا پیچ نزدیک می شوند، باید سرعت خود را کاهش دهند. بر اساس این شهودها، ما بیشتر فرض میکنیم که در بیشتر موارد، بهعنوان بازنمایی رفتارهای وسیله نقلیه، حالتهای خودرو از نظر فضایی همبستگی دارند. این باعث می شود LVMP در جایی و زمانی که داده های مسیر حرکتی فضایی در دسترس باشد امکان پذیر باشد. سیستم ما در شکل ۱ نشان داده شده است .
اجزای اصلی سیستم ما در زیر فهرست شده است:
-
یک برآوردگر ایالت UKF. در مطالعات دنیای واقعی، قبل از پیشبینی حرکت، یک برآوردگر وضعیت خودرو در زمان واقعی برای کاهش صداهای حسگر ضروری است. در سیستم ما، یک فیلتر کالمن بدون بو (UKF) که با یک مدل CTRA همکاری می کند، استفاده شده است. UKF اطلاعات مدل CTRA و حسگرهای داخلی را برای برآورد وضعیت خودرو در زمان واقعی در ۱۰ هرتز ترکیب می کند.
-
پایگاه داده فضایی برای مدیریت داده های مسیر حرکتی پایگاه داده فضایی که دادههای مسیر حرکتی و نقشههای HD را حفظ میکند یک جزء حیاتی است. دادههای مسیر حرکتی، که حاوی اطلاعات مکانی هستند، در پایگاه داده فضایی ذخیره میشوند تا از یک جستجوی فضایی سریع برای تحقق LVMP در زمان واقعی استفاده کنند. دادههای سینماتیکی به نقشههای HD پیوند داده میشوند تا پرس و جوی فضایی را تسهیل کنند.
-
الگوریتم سبک وزن LVMP. استفاده از پایگاه داده فضایی و EKF روش ما را سبک می کند. توابع جستجوی سریع فضایی پایگاه داده، مرتبط ترین اطلاعات مکانی را به الگوریتم ما ارائه می دهد و بنابراین ما نیازی به یادگیری دانش از حجم عظیمی از داده ها نداریم. EKF کارآمد پردازش داده ها را در زمان واقعی تضمین می کند.
همانطور که در شکل نشان داده شده است، یک برآورد وضعیت فعلی خودرو که توسط UKF انجام شده است به عنوان حالت اولیه به الگوریتم LVMP ارسال می شود. سپس وضعیت طبق یک مدل CTRV به لحظه بعدی تبدیل می شود. در موقعیت پیشبینیشده، نقاط مسیر حرکتی اطراف از پایگاه داده فضایی پرس و جو شده و اندازهگیریهای مجازی محاسبه میشوند. در نهایت، پیشبینیها توسط EKF با استفاده از اندازهگیریهای مجازی تصحیح میشوند. این فرآیند ۵۰ بار برای رسیدن به LVMP 5 ثانیه تکرار می شود.
۴٫ روش شناسی
۴٫۱٫ برآورد وضعیت خودرو
برای پیشبینی حرکت وسیله نقلیه، لازم است که وضعیت یک وسیله نقلیه در زمان فعلی، مانند تخمینهای دقیق موقعیت و سرعت، استخراج شود. در این مقاله، یک UKF [ ۲۶ ] در برآورد وضعیت خودرو در زمان واقعی اتخاذ شده است.
برای اختصار، ما در این بخش تنها دو تابع کلیدی در تخمین حالت ارائه می دهیم. یعنی فرآیند و توابع مشاهده. مدل CTRA زیر به عنوان مدل فرآیند در سیستم ما انتخاب شده است:
در این مدل، ایکسک=[ایکس،y،θ،v،آ،ω]تیوضعیت خودرو در لحظه k است. (ایکس،y)مختصات موقعیت را نشان می دهد. v و a سرعت و شتاب هستند. θو ωهستند و نرخ انحراف. T فاصله زمانی بین k-1 فوری و k است .
توابع مشاهده در معادله ( ۲ ) آورده شده است. قابل توجه است که این توابع وابسته به حسگر و سیستم هستند.
جایی که پررنگ ها زیرنویس می شوند ایکسو yبه ترتیب، وضعیت سیستم و بردار مشاهده را نشان می دهد. حروف فوق x و y اجزاء را در جهت x و y نشان می دهند. جزئیات تنظیمات الگوریتم UKF در [ ۱۲ ] موجود است. برآورد وضعیت خودرو ایکس^کجتیrآخروجی UKF در پیشبینی حرکت خودرو زیر استفاده میشود.
۴٫۲٫ پیش بینی حرکت خودرو
۴٫۲٫۱٫ پایگاه داده مسیر حرکتی فضایی
مجموعه داده مسیر حرکتی فضایی کتی={پمن}من=۰مبه عنوان دنباله ای از نقاط مسیر حرکتی تعریف می شود پمن=ایکسyθvآω، که در آن نویزها تا حد امکان از طریق فناوری های فیلتر یا صاف کردن کاهش یافته است. M عدد نقطه است. علاوه بر دادههای سینماتیکی، که حاوی اطلاعات فضایی نقطه هستند، انواع دیگری از ویژگیها به نقاط مسیر حرکتی ما متصل/پیوند میشوند:
PostGIS [ ۲۷ ] برای توسعه سیستم پایگاه داده ما انتخاب شده است، که در آن سه جدول: جدول نقطه مسیر حرکتی (ktp)، جدول مسیر حرکتی (kt) و جدول جاده نقشه های HD عمدتاً استفاده می شود، همانطور که در شکل ۲ استفاده می شود.نشان می دهد. جدول ktp اطلاعات سینماتیکی کلیدی این نقاط را ذخیره می کند. اطلاعات توپولوژیکی نقاط سینماتیکی نیز در این جدول حفظ شده است. به عنوان مثال، شناسه جاده ای که یک نقطه سینماتیکی در آن قرار دارد را می توان به راحتی از جدول ktp شناخت. مشخصه id_ro برای بررسی نقاط نامرتبط در جستجوی فضایی زمانی که وسیله نقلیه در جاده در حال رانندگی است استفاده می شود. این امر به درخواست های ما سرعت می بخشد. علاوه بر این، نمایههای درخت جستجوی تعمیمیافته بر روی جدول ktp برای تسریع بیشتر پرسوجوها ساخته میشوند. از id_kt برای پیوند جدول ktp به جدول kt استفاده می کنیم که در آن آمار مسیرها و اطلاعات معنایی نقاط سینماتیک ذخیره می شود. جدول راننده و وسیله نقلیه اطلاعات شخصی/خصوصی رانندگان و وسایل نقلیه ثبت شده را حفظ می کند.
در این مقاله، ما فرض می کنیم که یک مسیر جهانی از قبل برنامه ریزی شده است. بنابراین تمام جاده هایی که یک وسیله نقلیه از آنها عبور خواهد کرد را می توان شناخت. در یک پرس و جو، فقط داده های مرتبط با جاده ها اسکن می شوند.
۴٫۲٫۲٫ الگوریتم بازیابی فضایی تطبیقی (ASRA)
نقاط مسیر حرکتی به طور یکنواخت در فضا توزیع نشده اند. بنابراین، استفاده از آستانه فاصله ثابت در جستجوهای فضایی نامناسب است. یک الگوریتم بازیابی فضایی بازگشتی پیشنهاد شده است. الگوریتم به طور تطبیقی فاصله جستجو را تنظیم می کند تا اطمینان حاصل شود که حداقل دو نقطه مسیر حرکتی مرتبط را می توان یافت. شبه کدهای آن در شکل ۳ نشان داده شده است.
بر اساس قانون اول جغرافیای توبلر، ASRA سعی می کند نزدیک ترین نقاط سینماتیک مرتبط را بیابد. یعنی، در اطراف یک موقعیت مشخص (ps. x ، ps. y )، نقاط مسیر حرکتی مرتبط باید با قوانین زیر مطابقت داشته باشند:
-
قوانین فضایی: نقاط باید در فاصله معینی ۰٫۵ m * k قرار داشته باشند، جایی که k < 5، و اختلاف عنوان باید کمتر از π/۲; در غیر این صورت، امتیازات حذف می شوند. اگر k ≥ ۵ باشد و عدد نقطه کمتر از ۲ باشد، جستجو با شکست مواجه می شود.
-
قوانین توپولوژیکی: نقاط باید در جاده ای قرار داشته باشند که وسیله نقلیه در آن حرکت می کند. در غیر این صورت، امتیازات حذف می شوند.
-
قواعد معنایی: نقاط باید توسط همان وسیله نقلیه ای تولید شوند که توسط همان شخص هدایت می شود. در غیر این صورت، امتیازات حذف می شوند.
قوانین توپولوژیکی بسیاری از نقاط غیرمرتبط را برای سرعت بخشیدن به جستجو حذف می کند. قوانین فضایی تمام نقاط اطراف را که دارای زاویه سمت نزدیک در یک فاصله مشخص هستند انتخاب می کند. قوانین معنایی تضمین می کند که فقط داده های خصوصی انتخاب می شوند. از یک طرف، این از حریم خصوصی رانندگان محافظت می کند. از سوی دیگر، کلید پیش بینی های شخصی است. عملیات نقاط سینماتیک جستجو شده برای محاسبه اندازهگیریهای مجازی در الگوریتم پیشبینی زیر استفاده میشود. جزئیات را می توان در بخش “(فرآیند ۲) جستجوی فضایی و محاسبه اندازه گیری مجازی” یافت.
۴٫۲٫۳٫ چارچوب EKF برای یکپارچه سازی داده های مسیر حرکتی
همانطور که در کار قبلی ما گزارش شد [ ۱۲ ]، عملکرد دقت EKF و UKF تقریباً یکسان است. با این حال، EKF سریعتر است. پیش بینی حرکت محاسباتی مصرف می شود. کارایی یک الگوریتم باید به طور جدی مورد بررسی قرار گیرد. بنابراین، یک EKF که با مدل CTRV همکاری می کند در پیش بینی حرکت خودرو استفاده می شود.
در مدل CTRV، یک حالت تخمینی خودرو در لحظه k به صورت تعریف شده است ایکس^ک=ایکسyθvωتی. در سیستم ما، برآورد وضعیت فعلی خودرو ایکس^کجتیrآ، که توسط UKF خروجی می شود، به ایکس^کجتیrvبه عنوان حالت اولیه پیش بینی کننده EKF ما از طریق:
از این پس، اشاره می کنیم ایکس^کجتیrvمانند ایکس^کبرای اختصار
(فرآیند ۱) پیش بینی
اول، حالت اولیه ایکس^کو کوواریانس مربوطه پکبه حالت لحظه بعدی تکامل یافته اند ایکس^ک+۱-و کوواریانس پک+۱-از طریق معادلات ( ۴ )–( ۶ ).
wکنویز فرآیند است. جیافو سکماتریس ژاکوبین تابع را نشان می دهد افجتیrvو به ترتیب ماتریس کوواریانس نویز فرآیند. برای جزئیات بیشتر در مورد ماتریس های ژاکوبین و کوواریانس، [ ۱۲ ] را ببینید.
(فرآیند ۲) جستجوی فضایی و محاسبه اندازه گیری مجازی
در مرحله دوم، ما سعی می کنیم نقاط سینماتیک مرتبط را در اطراف موقعیت پیش بینی شده پیدا کنیم و از این نقاط برای محاسبه یک اندازه گیری مجازی استفاده کنیم.
ASRA در اطراف راه اندازی می شود ایکس^ک+۱-و نقاط مسیر حرکتی مرتبط با عملیات ASRA بازیابی می شوند. سپس از op برای ساخت ماتریس زیر استفاده می شود:
که در آن n عدد عنصر op است و ما از آن استفاده می کنیم (op)منبرای نشان دادن ستون i از op . هر ستون مربوط به یک نقطه سینماتیک مرتبط است. سه تابع وزنی زیر برای وزن های محاسبه شده برای هر نقطه سیر سینماتیکی پیشنهاد شده است.
جایی که دjفاصله اقلیدسی بین است ایکس^ک+۱-و (op)j، در معادله ( ۹ ) تعریف شده است.
سه تابع وزن دهی در شکل ۴ نشان داده شده است . ما می توانیم آن را ببینیم w2یک روش وزن دهی متوسط (AW) است. هر دو w1و w3روشهای وزن دهی معکوس فاصله (IDW) هستند، در حالی که w1خطی است و در عین حال w3غیر خطی است سپس وزن ها از طریق رابطه ( ۱۰ ) نرمال می شوند.
با استفاده از وزن های محاسبه شده wمنj، میانگین وزنی نقاط مسیر حرکتی مرتبط مورد بررسی به عنوان یک اندازه گیری مجازی در نظر گرفته می شود. zک+۱vمنrتیتوآل، همانطور که در معادله ( ۱۱ ) بیان شده است.
بدیهی است که تابع اندازه گیری ما این است:
جایی که هک+۱نویز اندازه گیری است.
(فرآیند ۳) به روز رسانی
در نهایت، اندازه گیری مجازی به دست آمده از فرآیند ۲ برای به روز رسانی پیش بینی انجام شده توسط فرآیند ۱ در این فرآیند استفاده می شود. اول از همه، سود نزدیک به بهینه کالمن جیک+۱محاسبه می شود:
جایی که جیاچ=منو آرک+۱ماتریس کوواریانس است هک+۱٫ سپس، پیشبینی حالت توسط اندازهگیری مجازی از طریق:
و ماتریس کوواریانس تخمین پسینی به وسیله:
فرآیند فوق، از معادله ( ۴ ) تا معادله ( ۱۵ )، ۵۰ بار برای پیشبینی حرکت خودرو در ۵ ثانیه در آینده تکرار میشود.
۵٫ آزمایشات
۵٫۱٫ تنظیمات آزمایشی
آزمایش های دنیای واقعی در محوطه دانشگاه ناگویا با استفاده از Toyata PRIUS PHV نشان داده شده در شکل ۵ انجام شد. LiDAR (Velodyne HDL-64ES3) و IMU (واحد اندازه گیری اینرسی، Xsens MTi-300) نصب شده بر روی خودرو در آزمایشات ما استفاده شد. سنسورها به پلتفرم Autoware [ ۲۸ ، ۲۹ ، ۳۰ ] وصل شدند و سیستم ما مشترک پیامهای ROS (سیستم عامل روبات) [ ۳۱ ] شد که توسط گرههای حسگر برای تخمین وضعیت خودرو و پیشبینی حرکت خودرو منتشر شد.
قابل توجه است که آزمایشات ما در یک فضای عمومی انجام شد که در آن جاده ها منحنی و شیب دار بودند و عابران پیاده، دوچرخه و سایر وسایل نقلیه همزیستی داشتند. این رفتارهای رانندگی ما را پیچیده کرد. برای مثال، زمانی که عابران پیاده از جاده عبور میکردند، مجبور میشدیم خودروی خود را متوقف کنیم و هنگامی که خودرویی در کنار جاده پارک میشد، از خط برنامهریزی شده خارج میشدیم. در آزمایشهای ما، دادههای سینماتیکی سه درایو، در مجموع ۱۲۱۱۲ نقطه، در پایگاه داده ذخیره شد و دیگری برای کپی کردن رانندگی واقعی، همانطور که در [ ۱۴ ] انجام داده بودیم، دوباره پخش شد.
سیستم ما بر اساس C++ و ROS پیاده سازی شد. جزئیات پیکربندی خودروهای آزمایشی، حسگرها و KFها را می توان در [ ۱۲ ] یافت.
۵٫۲٫ دقت ارزیابی عملکرد
دو عاملی که ممکن است بر عملکرد دقت الگوریتم ما تأثیر بگذارد – تابع وزن استفاده شده و اندازه مجموعه داده ها – در این بخش بررسی می شوند.
۵٫۲٫۱٫ متریک های مورد استفاده
عملکرد دقت روش ما به صورت کمی با استفاده از میانگین خطای اقلیدسی (AEE) و معیارهای خطا حداکثر ارزیابی میشود. AEE برای تجزیه و تحلیل عملکرد کلی پیش بینی الگوریتم ما استفاده می شود و به صورت زیر تعریف می شود:
جایی که (ایکستیمنj،yتیمنj)موقعیت پیش بینی شده در زمان است تیمندر طول jتیساعتمسیر پیش بینی شده (ایکستیمنr،yتیمنr)موقعیت واقعی مربوطه است. N تعداد کل مسیرهای پیش بینی شده است. خطاهای پیشبینی سرعت نیز با روش AEE محاسبه میشوند. اما تک بعدی است:
به همین ترتیب، vتیمنjو vتیمنrسرعت واقعی و پیش بینی شده در زمان هستند تیمندر طول jتیساعتمسیر پیش بینی شده، به ترتیب.
حداکثر خطا، حداکثر خطای پیش بینی در طول یک مسیر پیش بینی شده است. حداکثر خطا منعکس کننده بدترین عملکرد در یک پیش بینی مسیر است. بنابراین، میتواند برخی از عوامل تحت پوشش مقادیر میانگین را که از پیشبینیهای کلی مشتق شدهاند، آشکار کند. بیش از ۱۰۰۰۰ مسیر در هر یک از آزمایشهای بعدی پیشبینی شد و خطاهای پیشبینی آنها به تفصیل مورد بحث قرار گرفت.
۵٫۲٫۲٫ استفاده از توابع مختلف وزن دهی
به منظور بررسی تأثیر توابع وزندهی مختلف، عملکرد دقت پیشبینی سه پیشبینیکننده که از توابع وزن متفاوت استفاده میکردند، w1، w2و w3، مقایسه شدند. در این آزمایش، از تمام داده های مسیر حرکتی جمع آوری شده در پایگاه داده ما استفاده شد. نتایج تجربی در شکل ۶ و شکل ۷ نشان داده شده است.
یک روند آشکار را می توان یافت – سه تابع وزن دهی تفاوت مشخصی در جنبه دقت، هم برای پیش بینی موقعیت و هم برای سرعت ایجاد نکرده اند. با این حال، روش های IDW ( w1و w3) کمی بهتر از روش AW هستند ( w2) در پیش بینی موقعیت یا سرعت. این به این دلیل است که شعاع جستجوی ما کوچک است (شعاع اولیه ۰٫۵ متر و حداکثر شعاع جستجو بیش از ۲ متر نیست). بنابراین، تفاوتهای فضایی بین نقاط سیر سینماتیکی جستجو شده اندک است. بنابراین، توابع وزن دهی مختلف نمی توانند منجر به تفاوت های آشکار از نقطه نظر آماری شوند. در مقایسه با روش پیشرفته در [ ۱۳ ] که خطاهای پیشبینی موقعیت و سرعت آن به ترتیب بیش از ۴ متر و ۱٫۵ متر بر ثانیه در ۴ ثانیه است، عملکرد روش ما قابل قبول است.
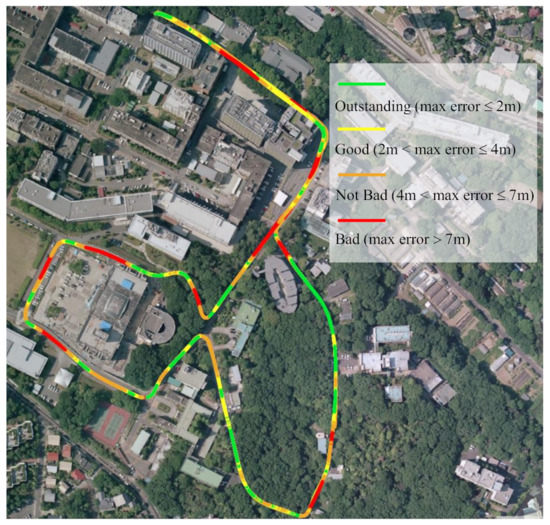
برای بررسی بیشتر و دقیق خطاهای پیشبینی، حداکثر خطای پیشبینی آنها تحلیل میشود. توابع توزیع تجمعی حداکثر خطاها (CDF) زمانی که از سه تابع وزنی مختلف استفاده می شود در گوشه سمت چپ بالا در شکل ۶ ترسیم شده است. حداکثر خطاهای پیشبینی را به چهار گروه تقسیم میکنیم: برجسته (حداکثر خطا ≤ ۲ متر)، خوب (۲ متر < حداکثر خطا ≤ ۴ متر)، نه بد (۴ متر < حداکثر خطا ≤ ۷ متر) و بد (حداکثر خطا > 7). متر). حداکثر توزیع فضایی چهار گروه خطا را می توان در شکل ۸ یافت .
از CDFها در شکل ۶ ، میتوان دریافت که پیشبینیهای خوب، از جمله پیشبینیهای برجسته، بیش از ۶۰% را با استفاده از هر یک از تابعهای وزنی تشکیل میدهند، همانطور که فلش سیاه نشان میدهد. این بدان معناست که نرخ پیشبینی خوب روش ما در فضای پیچیده آزمایشی ما بیش از ۶۰ درصد است. همچنین قابل توجه است، جایی که فلش قرمز نشان می دهد، که w3(قرمز) نرخ بالاتری (تقریباً ۳۴ درصد) از پیش بینی های برجسته را به همراه دارد. بنابراین، برای به دست آوردن پیش بینی های برجسته تر، w3توصیه می شود.
۵٫۲٫۳٫ استفاده از مجموعه داده های مختلف
همانطور که قبلا ذکر شد، روشهای مبتنی بر یادگیری، دادههای تاریخی زیادی را مصرف میکنند. عملکرد مدل با اندازه HDT تعیین می شود. آزمایشهای زیر برای پاسخ به دو سؤال طراحی شدهاند: (۱) وقتی دادههای تاریخی قابل استفاده محدود هستند، روش ما چگونه عمل میکند؟ به عنوان مثال، در شرایطی که فقط یک مسیر در دسترس است. (۲) وقتی اندازه داده های تاریخی افزایش می یابد، روش ما چگونه عمل می کند؟ سوال اول نشان دهنده بدترین عملکرد روش ما در شرایط بد است. سوال دوم پتانسیل عملکرد روش ما را در شرایط خوب ارزیابی می کند.
ما سه مجموعه داده مسیر حرکتی را جمع آوری کرده بودیم {کتی۱،کتی۲،کتی۳}در پایگاه داده ما هر مجموعه داده مسیر با یک درایو در مسیر در شکل ۸ در محوطه دانشگاه ما مطابقت دارد. برخی از اطلاعات در مورد مسیرها در جدول ۲ فهرست شده است. استفاده کردن w3، روش ما بر روی مجموعه داده های مختلف از جمله یک مجموعه داده آزمایش شد {{کتی۱}،{کتی۲}،{کتی۳}}که شامل سه آزمایش، دو مجموعه داده است {{کتی۱،کتی۲}،{کتی۱،کتی۳}{کتی۲،کتی۳}}که شامل سه آزمایش و سه مجموعه داده است {{کتی۱،کتی۲،کتی۳}}که شامل یک آزمایش است. میانگین خطاهای پیش بینی آنها در شکل ۹ خلاصه شده است.
برای سوال دوم، شکل ۹ به وضوح نشان می دهد که با افزایش اندازه مجموعه داده های استفاده شده، دقت پیش بینی موقعیت و سرعت بهبود می یابد. این شکل کاربرد امیدوارکننده روش ما را در آینده نشان میدهد که دادههای مسیر جمعآوری شده به طور قابلتوجهی افزایش مییابد. می توان استنباط کرد که در صورت استفاده از مجموعه داده های بیشتر، عملکرد دقت می تواند بیشتر بهبود یابد. از این گذشته، برای دستیابی به آن عملکرد دقت قابل توجه، حداکثر تنها از سه مجموعه داده استفاده شد.
برای سوال اول، در شکل ۹ ، نکته مهمی که باید به آن توجه داشت این است که در بدترین مواردی که فقط از یک مجموعه داده استفاده شده است، عملکرد پیشبینی روش ما (منحنیهای آبی) در مقایسه با دقت گزارششده قابل قبول بود. [ ۱۳ ]. این همچنین ثابت می کند که روش ما از داده مصرف نمی شود. هرچه مجموعه داده های بیشتری استفاده شود، رویکرد ما بهتر عمل می کند.
۵٫۳٫ ارزیابی عملکرد کارایی
در بیشتر مطالعات ارائه شده، کارایی الگوریتمها به ندرت مورد بحث قرار گرفت، زیرا اکثر روشهای LVMP مبتنی بر یادگیری سبک وزن نیستند. در کار قبلی ما، پیشبینی شد که با افزایش مقدار محاسبات، EKF که تقریباً همان دقت UKF را دارد، ممکن است به طرز قابلتوجهی از UKF در کارایی بهتر عمل کند [ ۱۲ ]. این آزمایش برای بررسی کارایی روش ما طراحی شده است. از سوی دیگر، ما می خواهیم پیش بینی قبلی خود را تأیید کنیم. در آزمایشهای زیر، هر دو پیشبینیکننده EKF و UKF اجرا شدند. آنها با همان مدل CTRV همکاری کردند و w3تابع وزن دهی و بر روی همان سه مجموعه داده آزمایش شدند. هر آزمایش سه بار تکرار شد و آمار زمان محاسبه در شکل ۱۰ ارائه شده است.
همانطور که شکل ها نشان می دهد، پیش بینی کننده EKF (میانگین زمان محاسبه: ۸۵ میلی ثانیه) آشکارا سریعتر از پیش بینی کننده UKF (میانگین زمان محاسبه: ۱۲۷ میلی ثانیه) است. از آنجایی که برآوردگر وضعیت خودروی ما در فرکانس ۱۰ هرتز کار میکند، از روی شکلها، تقریباً میتوان فهمید که ۷۰٪ پیشبینیهای EKF در زمان انجام میشوند (CDF (100 ms) = 70٪، در حالی که فقط ۳۴٪ پیشبینیهای UKF در زمان انجام میشوند. CDF (100 ms) = 34٪.
در عمل، پیشبینیکننده UKF بسیاری از پیشبینیها را در چرخههای تخمین-پیشبینی از دست میدهد، و برای برخی از برنامههای کاربردی ADAS حیاتی، مانند تشخیص برخورد، نبود دادههای پیشبینی یک نقص مهم است. بنابراین UKF در سیستم ما توصیه نمی شود.
۶٫ کار آینده
این مقاله مقدماتی برای پیاده سازی سیستم پیشنهادی است. چندین کار باقی مانده برای مطالعه آینده.
در مرحله اول، همانطور که آزمایش های بالا نشان می دهد، دقت پیش بینی با افزایش اندازه مجموعه داده های استفاده شده بهبود می یابد. بنابراین، دقت فوق العاده روش ما باید با افزایش قابل ملاحظه مجموعه داده های ما بررسی شود. علاوه بر این، قابلیت همکاری مجموعه داده ها بین وسایل نقلیه مختلف و رانندگان نیز باید مورد بررسی قرار گیرد.
در مرحله دوم، توزیع فضایی چهار گروه خطا حداکثر در شکل ۸ نشان داده شده است. متأسفانه تاکنون الگوی توزیع فضایی مشخصی پیدا نکرده ایم. به منظور بهبود عملکرد روش ما، الگوهای توزیع فضایی و مسائلی که بر عملکرد روش ما تأثیر میگذارند باید مورد مطالعه قرار گیرند.
در نهایت، با افزایش چشمگیر اندازه داده های جمع آوری شده در آینده، یک چارچوب محاسباتی جدید مورد نیاز است، همانطور که در [ ۱۴ ] انجام دادیم.
۷٫ نتیجه گیری
یک روش جدید LVMP سبک وزن در این مقاله پیشنهاد شد. داده های مسیر حرکتی نتیجه تعامل بین انسان، وسایل نقلیه و محیط بود. داده های مسیر حرکتی به طور مستقیم در روش LVMP ما استفاده شد و آنها توسط یک پایگاه داده فضایی مدیریت شدند. یک چارچوب جدید KF که با سیستم پایگاه داده فضایی همکاری می کرد برای دستیابی به LVMP در زمان واقعی پیشنهاد شد. روش ما در دنیای واقعی تایید شد. روشهای IDW پیشنهادی در مقایسه با روش AW مزیت جزئی در دقت نشان دادند. اندازه مجموعه داده های استفاده شده بر عملکرد دقت روش ما تأثیر می گذارد. آزمایشها نشان داد که با افزایش مجموعه دادههای مورد استفاده، دقت پیشبینی بهبود یافته است و روش ما از دادهها استفاده نمیکند. با توجه به جنبه کارایی، روش ما می تواند الزامات پیش بینی بلادرنگ را برآورده کند.