۱٫ معرفی
حاشیه نویسی متن جغرافیایی نوعی از حاشیه نویسی نقشه است که می تواند عناصر نقشه را با استفاده از متون بدون ساختار توصیف کند، بر خلاف حاشیه نویسی سنتی که از کلمات یا اعداد ساختاریافته تشکیل شده است. ژئومتن دو جزء ضروری دارد: متن بدون ساختار و مکان. متن بدون ساختار می تواند یک جمله، پاراگراف، فصل یا مقاله باشد. امروزه بسیاری از خدمات حاشیه نویسی متن جغرافیایی مبتنی بر مدل های جمع سپاری اخیراً توسط پلتفرم های نقشه وب ارائه شده است [ ۱ ]. داده های ژئومتن ارائه شده توسط داوطلبان اغلب برای غنی سازی داده های جغرافیایی پایه استفاده می شود [ ۲ ، ۳ ، ۴ ، ۵ ، ۶]. داوطلبانی که این دادهها را روی پلتفرمهای نقشه آپلود میکنند، فرصتهایی نیز دارند تا افکار، احساسات و نظرات خود را از طریق متون، تصاویر و ویدیوهای بدون ساختار بیان کنند. تا حدی، به دلیل موقعیت حاشیهنویسی متن جغرافیایی، هر متنی که کاربر مشارکت میدهد میتواند با اطلاعات جغرافیایی باشد تا عملکرد نقطه را منعکس کند. دو نوع مهم حاشیه نویسی، POI (نقطه مورد علاقه) حاشیه نویسی متن جغرافیایی و حاشیه نویسی متن جغرافیایی شخصی، اکنون در خدمات نقشه وب گسترده شده است. به طور مفصل، متن جغرافیایی POI [ ۷ ] به بازخورد کاربران در مورد کالاها، مکانها و خدمات آنلاین، مانند نظرات رستوران ارسال شده توسط مشتریان از طریق بایدو یا نقشههای گوگل، هر چند متن جغرافیایی شخصی، اشاره میکند [ ۸ ، ۹ ]] اشاره به نظرات یا توضیحاتی دارد که به موقعیتهای جغرافیایی خاصی پیوست شده و توسط داوطلبان برای بیان تجربیاتشان به اشتراک گذاشته میشود، مانند برچسبهای شخصی ارائهشده توسط Google Earth [ ۱۰ ] و متن جغرافیایی از توییتر ارائهشده در OpenStreetMap [ ۱۱ ].]. مهم نیست که در یک برنامه نقشه به کدام نوع متن جغرافیایی تعلق دارد (به طور مستقیم برچسب گذاری شده یا به طور غیرمستقیم تبدیل شده است)، به عنوان یک نوع توصیف معنایی موقعیت جغرافیایی، ژئوتکست با اطلاعات مختصات توانایی توصیف محیط جغرافیایی را دارد و بیشتر به کاربران در توصیف یک محیط در محیط با جزئیات بیشتر از آنچه که ممکن است با وجود عناصر کارتوگرافی محدود. بنابراین، ژئومتن میتواند توصیفات فضایی را با تکمیل متن ساختاریافته با متن بدون ساختار فراوان، به طور قابل توجهی بهبود بخشد.
اگرچه حاشیهنویسیهای متنی جغرافیایی فراوان هستند، اما آنها نیز نامرتب هستند. در حال حاضر، تقریباً ۶۰۰ میلیون نفر تنها در چین، دادهها را از طریق نقشههای تلفن همراه راحت به اشتراک میگذارند، و نظارت و مدیریت سرویسهای متن جغرافیایی برای این سطح از استفاده ناکافی است. متنهای جغرافیایی که بهطور تصادفی یا مخرب توسط کاربران اضافه میشوند، کیفیت دادههای سرویس نقشه را تا حد زیادی کاهش میدهند، و تحلیلهای جامع دادهها باید قبل از اجازه دادن به متن جغرافیایی برای آپلود، معنایی و رقابت فضایی یک ژئومتن را به شرح زیر در نظر بگیرند. نقشه.
معنای ژئومتن باید با متن های جغرافیایی همسایه [ ۷ ] مرتبط باشد. تعداد زیادی از متنهای جغرافیایی موجود، همبستگی خودکار معنایی را در یک منطقه ممکن میسازد، و زمانی که یک ژئومتن جدید با همبستگیهای خودکار معنایی موجود همبستگی نداشته باشد، متنهای جغرافیایی باید قبل از آپلود فیلتر شوند. به عنوان مثال، یک متن جغرافیایی مربوط به یک مزرعه باید قبل از اضافه شدن به نقشه یک منطقه تجاری متشکل از مغازه ها و رستوران های مختلف در یک شهر فیلتر شود.
اگرچه تحقیقات گسترده ای در مورد چگونگی به دست آوردن متن جغرافیایی [ ۱۲ ، ۱۳ ، ۱۴ ، ۱۵ ] و استفاده از متن های جغرافیایی [ ۱۶ ، ۱۷ ، ۱۸ ، ۱۹ ، ۲۰ ] انجام شده است، آزمایش های کمی برای مهار جغرافیای نامرتبط انجام شده است. -متون قبل از اضافه کردن آنها به نقشه های وب. در مقایسه با متون غیرقانونی، متن های جغرافیایی رایج تر هستند و ممکن است حاشیه نویسی های نامربوط را به نقشه های وب اضافه کنند. برای جلوگیری از افزودن متنهای جغرافیایی نامربوط، اطلاعات معنایی در حاشیهنویسیهای ژئومتن و خودهمبستگیهای فضایی در محلهها باید بر اساس اصول زیر بررسی شود:
(۱) معنای ژئومتن با روش طبقهبندی خودکار متن اندازهگیری میشود. روشهای طبقهبندی خودکار متن معمولاً بالغ هستند و یک فرآیند یکپارچه را تشکیل میدهند [ ۲۱ ]، و بنابراین، میتوانند برای ایجاد یک بردار نوع امکان برای حاشیهنویسی متن جغرافیایی استفاده شوند [ ۲۲ ، ۲۳ ].
(۲) همبستگیهای خودکار فضایی ایجاد شده توسط حاشیهنویسیهای متن جغرافیایی نزدیک باید سایر متنهای جغرافیایی ارسالی جدید نامرتبط را رد کند. یک روش آماری که می تواند مجاورت فضایی را مورد بررسی قرار دهد، برای شناسایی مناطق مناسب خودهمبستگی فضایی کلیدی است.
مجاورت فضایی را می توان با استفاده از اندازه گیری های مبتنی بر فاصله یا مبتنی بر توپولوژی ارزیابی کرد. روشهای اندازهگیری مبتنی بر فاصله شامل روش فاصله برد [ ۲۴ ] و k-نزدیکترین همسایه [ ۲۵ ] است و این روشها برای مدلسازی دادههای پیوسته مناسب هستند. با این حال، روش فاصله برد تنها تأثیر فاصله را در نظر میگیرد و روابط مجاورت را نادیده میگیرد و در نتیجه ویژگیهای فاصله مشابه و مجاورت متفاوت را دارای تأثیر یکسان میداند که الزامات این مطالعه را برآورده نمیکند. مدل K-نزدیکترین همسایه بدون در نظر گرفتن جهت توزیع داده ها، نزدیکترین نقاط را به عنوان همسایه در نظر می گیرد. روشهای مبتنی بر توپولوژی، مجاورت را با پیوند دادن یک نقطه مشترک به یک لبه مشترک، مانند روش فاصله rook-queen-bishop در نظر میگیرند.۲۶ ، ۲۷ ، ۲۸ ، ۲۹ ]، مثلث سازی دلونی [ ۳۰ ] و نمودارهای ورونوی [ ۳۱ ]. روش فاصله روک-ملکه-اسقف از محدوده ۰-۱ برای ساخت یک ماتریس وزنی استفاده می کند. اندازهگیریهای مثلثسازی Delaunay، مرکز عناصر را برای تعیین مجاورت اختصاص میدهد. به عنوان مثال، اگر هر نقطه یا مرکز یک گره مثلثی باشد، گره های متصل شده توسط اضلاع مثلث به عنوان گره های مجاور در نظر گرفته می شوند [ ۳۰ ]]. با این حال، مثلث سازی دلونی نمی تواند انزوای فضایی را بیان کند و هنگام تعیین کمیت محله های بزرگتر با مشکل مواجه می شود. نمودارهای Voronoi همچنین ویژگیهای نقطهای یا مراکز ویژگی را اختصاص میدهند و مرزهایی را بین اشیاء جدا شده ایجاد میکنند، و مجاورت هندسی بین ویژگیهای جدا شده را بر اساس اشتراک مرزی تعریف میکنند [ ۳۱ ]. این روش می تواند به طور خودکار برای تفاوت های فضایی بین نقاط داده توزیع نامنظم و تراکم های ناهموار تنظیم شود و بنابراین برای ایجاد یک محله برای حاشیه نویسی های متن جغرافیایی ارسال شده جدید مناسب است.
خودهمبستگی فضایی در نظر می گیرد که یک نقطه مشاهده تحت تأثیر سایر نقاط مشاهده مجاور قرار می گیرد [ ۲۷ ، ۳۲ ]. آمار همبستگی فضایی کلاسیک شامل I موران [ ۳۳ ، ۳۴ ]، C Geary [ ۳۵ ] و G Getis [ ۳۶ ] است. خود همبستگی فضایی مثبت نشان دهنده خوشه بندی مقادیر مشابه است و خودهمبستگی فضایی منفی نشان دهنده توزیع فضایی گسسته است. Moran’s I و Geary’s C آمارهای خودهمبستگی فضایی جهانی هستند که میزان خودهمبستگی فضایی مجموعه داده کلی را تخمین می زنند. مقادیر Local Moran’s I تخمین هایی را در سطح واحد فضایی ارائه می دهد [ ۳۷]، و G Getis درجه خودهمبستگی را با مقایسه همسایگی با میانگین جهانی محاسبه می کند. علاوه بر این، مطالعات بسیاری نیز در مورد اهمیت آماری ترکیبات خودهمبستگی فضایی موران I انجام شده است [ ۳۸ ، ۳۹ ]، و روش های خودهمبستگی فضایی به طور گسترده در بسیاری از زمینه ها استفاده می شود [ ۳۹ ، ۴۰ ، ۴۱ ، ۴۲ ، ۴۳ ].
کیفیت داده ها در نقشه های وب با بارگذاری حاشیه نویسی های متن جغرافیایی نامرتبط کاهش یافته است و فیلتر کردن فقط متن های جغرافیایی غیرقانونی برای اصلاح مشکل کافی نیست. اگرچه متنهای جغرافیایی که از خشونت، مواد مخدر غیرقانونی، پورنوگرافی و سایر فعالیتهای اجتماعی نامطلوب حمایت میکنند باید به وضوح فیلتر شوند، این موضوعات در جای دیگری مورد بررسی قرار گرفتهاند [ ۲۳ ، ۴۴ ، ۴۵ ]]، و بنابراین در اینجا مورد بحث قرار نخواهد گرفت. بنابراین، این مقاله رویکردی را برای بهبود کیفیت حاشیهنویسیهای متن جغرافیایی پیشنهاد میکند. ابتدا، انواع حاشیه نویسی geo-text با یک روش طبقه بندی خودکار متن شناسایی می شوند و رابطه بین محیط معنایی موجود و یک geo-text جدید می تواند توسط یک الگوریتم تشخیص geo-text همبسته ارزیابی شود. یک پلت فرم نقشه وب ممکن است بسته به رابطه تعیین شده، از آپلود یک متن جغرافیایی خودداری کند.
بقیه این مقاله به شرح زیر تنظیم شده است. بخش ۲ روش طبقه بندی geo-text و الگوریتم فیلتر را ارائه می دهد و بخش ۳ به طور تجربی اثربخشی روش پیشنهادی را تأیید می کند. بخش ۴ بحث نتایج آزمایش را به پایان می رساند و بخش ۵ شامل نتیجه گیری می شود و فرصت های تحقیقاتی آینده را مشخص می کند.
۲٫ روش تشخیص ژئومتن غیرهمبسته
تشخیص ژئومتن های همبسته معنایی باید به دنبال سیگنال های معنایی و موقعیت های مکانی باشد تا (۱) موضوع ژئومتن را مشخص و طبقه بندی کند، معمولاً با پردازش زبان طبیعی و تکنیک های تحلیل معنایی پیچیده. (۲) قضاوت کنید که آیا متن جغرافیایی با دادههای همسایه در سطح معنایی همبستگی دارد یا خیر، و امکان آپلود بر اساس خودهمبستگی فضایی در یک منطقه انبوه فضایی را فراهم میکند. طبق قانون اول جغرافیای توبلر، هر چه فاصله نزدیکتر باشد، ویژگیها همگن و همبستهتر میشوند. تقسیم بندی فضایی، اندازه گیری فاصله، و تجزیه و تحلیل خودهمبستگی فضایی را می توان برای استنباط درجه همبستگی بین یک ژئومتن جدید و همسایگان آن استفاده کرد.
برای توسعه یک روش فیلتر برای متنهای جغرافیایی داوطلبان نامرتبط بر روی نقشههای وب دو بعدی، این بخش طبقهبندیهای خودکار ژئومتن را تجزیه و تحلیل میکند و سپس الگوریتم فیلتر ژئومتن جغرافیایی نامرتبط پیشنهادی را ارائه میکند که درجه همبستگی بین یک جغرافیای منفرد را محاسبه میکند. متن و متن های جغرافیایی همسایه روش کلی در شکل ۱ نشان داده شده است .
۲٫۱٫ طبقه بندی خودکار برای حاشیه نویسی متن جغرافیایی
۲٫۱٫۱٫ انواع متن های جغرافیایی
حاشیه نویسی متن جغرافیایی یک توصیف تحت اللفظی از موجودیت ها است. حتی اگر بدون ویژگی ساختاری to نشان دهد که موجودیت متعلق به چه نوع است، نوع کاربردی ژئومتن با استفاده از تحلیل معنایی متنی قابل استنباط است. با توجه به مجموعه کمیسیون زبان ملی چین و طبقه بندی استاندارد بین المللی صنعتی کلیه فعالیت های اقتصادی، متن را می توان به انواع مختلفی تقسیم کرد. همچنین برای حاشیه نویسی متن جغرافیایی کار می کند.
یک سیستم طبقهبندی دقیق موجودیت جغرافیایی که توسط Baidu Map ارائه شده است، راحتی را برای کاربران نقشه به ارمغان میآورد و الزامات طبقهبندی انواع حاشیهنویسی متن جغرافیایی را برآورده میکند. سطح اول ژئومتن های شهری شامل رستوران ها، هتل ها، خدمات زندگی، نقاط گردشگری، تفریحی، موسسات آموزشی، سازمان های رسانه های فرهنگی، بیمارستان ها، خانه ها، سازمان های دولتی و غیره بود. سطح دوم جزئیات بیشتری داشت و بین رستورانهای سنتی، رستورانهای خارجی، رستورانهای فست فود، کیکفروشیها، کافهها، چایخانهها و بارها در دسته رستورانها متمایز بود. در میان آپارتمان ها، ویلاها، ساختمان های بلند، و ساختمان های چند طبقه در رده مسکن؛ و در میان مؤسسات آموزش عالی، مدارس راهنمایی، مدارس ابتدایی و مؤسسات تحقیقاتی در رده مدارس قرار دارند.http://lbsyun.baidu.com/index.php?%20title=lbscloud/poitags ‘).
۲٫۱٫۲٫ روش طبقه بندی خودکار
حاشیه نویسی جغرافیایی متعارف ( ga ) را می توان به صورت زیر رسمیت داد:
که در آن ( x , y ) به مکان ga اشاره دارد و اصطلاح محتوای حاشیه نویسی ساختار جغرافیایی (یک اصطلاح یا عدد) است. این حاشیه نویسی را می توان به شرح زیر گسترش داد تا شامل حاشیه نویسی متن جغرافیایی ( gta ) شود:
جایی که متن ممکن است یک کلمه، جمله، پاراگراف یا حتی مقاله بدون ساختار باشد. بردار مرتب شده هر کلمه بیانگر کل معنای معنایی جمله یا متن است. از طریق فرآیند تقسیمبندی کلمه، متن بدون ساختار را میتوان به عنوان یک بردار توالی کلمه ساختیافته [ ۴۶ ] توصیف کرد:
در این معادله، یک بردار حاشیه نویسی متن جغرافیایی متشکل از بسامد آماری عبارت های مختلف ، بردار ویژه متن است. روشهای یادگیری ماشینی که معمولاً برای طبقهبندی خودکار متن استفاده میشوند [ ۴۷ ، ۴۸ ] میتوانند نوع حاشیهنویسی متن جغرافیایی را شناسایی کنند. به طور کلی، مراحل طبقهبندی خودکار متن عبارتند از: پیش پردازش با حذف کلمات توقف [ ۴۹ ]، ریشهیابی [ ۵۰ ]، انتخاب ویژگی با استفاده از رویکردهای مختلف آماری یا معنایی [ ۵۱ ، ۵۲ ]، و مدلسازی با استفاده از تکنیکهای یادگیری ماشین مناسب. مانند بیز ساده [ ۵۳ ]، شبکه عصبی [ ۵۴]، ماشین های بردار پشتیبانی [ ۵۵ ] و تکنیک های ترکیبی [ ۵۶ ]. سپس، بردار ویژه فرکانس معکوس فرکانس سند (TF-IDF) برای حاشیه نویسی متن جغرافیایی انتخاب می شود. این یک تکنیک وزن دهی رایج برای بازیابی اطلاعات و داده کاوی است که به موجب آن اهمیت یک کلمه با توجه به فراوانی وقوع آن در اسناد و مجموعه مرتبط ارزیابی می شود [ ۵۷ ]. در نهایت، یک طبقهبندی ساده چند جملهای اعمال میشود. طبقه بندی کننده ساده بیزی مبتنی بر فرض استقلال مشروط در بین ویژگی ها است [ ۲۲ , ۵۸]. از آنجایی که رویکرد ساده بیزی صرفاً آماری است، اجرای آن ساده است و به زمان یادگیری کمتری نیاز دارد و آن را برای طبقهبندی بخشهای متن کوتاه مناسب میکند [ ۲۲ ]. شکل ۲ فرآیند طبقه بندی حاشیه نویسی متن جغرافیایی را خلاصه می کند.
بر اساس ویژگی های متن ایجاد شده توسط ارزیابی، یک طبقه بندی ساده چند جمله ای اتخاذ شده است. بنابراین، بردار V k از حاشیه نویسی geo-text متعلق به کلاس k به شرح زیر است:
که در آن y کلاس gta ، n تعداد عبارت ها، و w ki احتمال تعلق i به کلاس k است که به صورت P ( xi |y ) نوشته می شود. رابطه بین کلاس و بردارهای ویژه مرتبط ( x ۱ , x ۲ , …, x n ) به شرح زیر است:
با توجه به استقلال تحمیل شده توسط شرایط ساده لوحانه،
پایکس۱،…،ایکسnثابت است و بنابراین قوانین طبقه بندی به شرح زیر است:
که در آن P ( y ) بسامد y در مجموعه آموزشی است. حداکثر تخمین پسین برای تخمین استفاده می شود پایکسمن|y. با دانستن اینکه n تعداد y کلاس ها و y k کلاس k است، می توانیم احتمال بردارهای کلمه را در کلاس k محاسبه کنیم.پyک:
سپس مقدار احتمال هر کلاس را محاسبه می کنیم و بردار احتمال vc هر کلاس را پس از نرمال سازی بدست می آوریم:
نوع y^بردار کلمه ( ترم ۱ ، ترم ۲ ، …، ترم n ) به صورت زیر محاسبه می شود:
ژئومتن ها متعلق به نوع در نظر گرفته می شوند y^که برای آن مقدار مؤلفه برداری بزرگترین است. چه زمانی y^به طور قابل توجهی بزرگتر از سایر مقادیر مؤلفه برداری است، طبقه بندی دقیق تر است. برای سهولت در محاسبه، vc ۱۰۰ برابر بزرگنمایی شد.
۲٫۲٫ الگوریتم تشخیص ژئومتن همبسته (CGD)
بر اساس بردار احتمال geo-text مشتق شده، ما یک الگوریتم فیلتر geo-text همبسته مبتنی بر همبستگی خودکار و ترتیب k Voronoi، یعنی الگوریتم تشخیص geo-text همبسته (CGD) پیشنهاد میکنیم. الگوریتم در چهار مرحله زیر ادامه مییابد: (۱) از روشهای مجاور K-order Voronoi برای ایجاد یک محله تودرتو خود رشد برای موقعیتیابی متن جغرافیایی استفاده کنید. (۲) یک روش وزن دهی فضایی مناسب برای همسایگی مرتبه k Voronoi را انتخاب کنید و یک ماتریس وزن فضایی در همسایگی بسازید تا از محاسبه همبستگی فضایی کمی پشتیبانی کند. (۳) تشخیص حداقل همسایگی فضایی بر اساس یک موران جهانی در سطح آماری معنی دار. (۴) درجه همبستگی بین حاشیه نویسی متن جغرافیایی و همسایگی آن را با استفاده از روش ضریب همبستگی پیرسون محاسبه کنید. جریان این الگوریتم در نشان داده شده استشکل ۳ .
۲٫۲٫۱٫ Voronoi k-Order Neighborhood Partition
دو نوع روش برای ارزیابی مجاورت فضایی وجود دارد: روابط فاصله و روابط توپولوژیکی. روشهای مرتبه k Voronoi مبتنی بر روابط توپولوژیکی هستند و برای توصیف دادههای محلی مناسبتر هستند [ ۳۱ ، ۵۷ ]. روش پارتیشن همسایگی مرتبه k Voronoi برای ایجاد یک ساختار همسایگی تو در تو با محوریت حاشیه نویسی متن جغرافیایی و به تدریج گسترش به بیرون استفاده می شود. این ساختار برای یافتن حداقل همگرایی در اطراف متن جغرافیایی مفید است. مجاورت مرتبه k Voronoi به صورت زیر تعریف می شود. برای مجموعه داده فضایی: O = { o ۱ , …, o n } ⊂ R ۲ , ۱ < n < ∞, ∀o i , o j ( i ≠ j ). اگر o i از حداقل مراحل مجاور ورونوی k ( k ∈ N ) عبور کند تا به هدف o j برسد ، o i و o j مرتبه k ورونویی مجاور یکدیگر هستند.
در یک فضای محدود R ۲ ، مجموعه داده نقطه مکانی P = { p ۱ , p ۲ , …, p i , …, p j ,…, p n } و v ( p i ) و v ( p j ) Voronoi هستند. مناطق p ۱ و p ۲ به ترتیب. ورونوی k-order مجاور از پمترسپس به عنوان توصیف می شود
بنابراین، ورونوی k-order مجاور از پمتررا نیز می توان به صورت زیر بیان کرد:
همانطور که در شکل ۴ نشان داده شده است ، با فرض اینکه یک حاشیه نویسی متن جغرافیایی در نقطه ۰ اضافه شده است، ویژگی های مجاور مرتبه ۰ Voronoi (سبز)، ویژگی های مجاور مرتبه اول Voronoi (صورتی)، ویژگی های مجاور مرتبه دوم Voronoi (نارنجی)، و ویژگی های مجاور مرتبه ۳ ورونوی (آبی) بر اساس رابطه (۱۴) به ترتیب: v (۰)، v (۱)، v (۲)، و v (۳) ایجاد می شوند.
همسایگی مرتبه k Voronoi (نوشته شده به عنوان vn ( k )) حاشیه نویسی متن جغرافیایی شامل همه ویژگی ها از مرتبه ۰ Voronoi تا مرتبه k Voronoi است که به دنبال این معادله است: vn ( k ) = v (۰) + v (۱) + … + v ( k ). بنابراین، همانطور که در شکل ۵ نشان داده شده است ، مناطق محله های مرتبه ۱، ۲ و ۳ Voronoi به ترتیب vn (۱)، vn (۲) و vn (۳) هستند.
۲٫۲٫۲٫ ماتریس وزن بر اساس همسایگی K-Order Voronoi
با توجه به اینکه مشارکت متنهای جغرافیایی در موقعیتهای مختلف میتواند ناسازگار باشد، از یک ماتریس وزن برای در نظر گرفتن تمام وزنهای همسایه استفاده میشود. برای این منظور، یک روش وزندهی فاصله معکوس مرتبه k Voronoi که اندازهگیری فاصله را با مجاورت فضایی ترکیب میکند، پیشنهاد شدهاست.
ناحیه ارزیابی vn(k )، فاصله برد بین p i ( xi , y i ) و pj ( xj , yj ) d ( pj , p i ) و فاصله مجاورت Voronoi vd است ( p j ، p i ). همانطور که در شکل ۶ نشان داده شده است ، فاصله برد d ( pj , p i) برابر با ۲۱۸٫۵۳ متر و فاصله مجاورت Voronoi vd ( p j , p i ) برابر با ۳ است. مقدار وزن wمنjمعادله است:
با τکبه عنوان آستانه، زمانی که فاصله مجاورت ورونوی از آستانه فراتر رود، متن جغرافیایی بسیار دور در نظر گرفته می شود تا بر یک حاشیه نویسی متن جغرافیایی جدید تأثیر بگذارد و بنابراین wمن،jروی صفر تنظیم شده است. تمام وزن ها نسبت به نقطه هدف در vn ( k ) نرمال می شوند.∑jwمن،j= 1. در همسایگی مرتبه k Voronoi، ماتریس وزن به صورت W ساخته می شود :
وزن گیری ضد فاصله مرتبه ورونوی-k بین فاصله ضد اقلیدسی و فاصله مجاورت ضد ورونوی است که بیشتر با شناخت انسان همخوانی دارد.
۲٫۲٫۳٫ تشخیص منطقه همگرایی معنایی حداقل مرتبه Voronoi-k-order یک نقطه
آمار موران I شاخص هایی هستند که همبستگی فضایی جهانی را اندازه گیری می کنند [ ۳۶ ]. پس از تعیین ماتریس همسایگی و وزن فضایی متون جغرافیایی، فرمول محاسبه جهانی Moran’s I [ ۴۷ ] به شرح زیر است:
جایی که x i به مقدار بردار احتمال برای متن جغرافیایی در همسایگی اشاره دارد، در مقاله، x i بردار vc است که در معادله (۱۱) نشان داده شده است. z i تفاوت بین x i و میانگین آن است ایکس¯; w ij به وزن ضد فاصله با مرتبه k ورونوی x i و x j از معادله (۱۵) اشاره دارد. N تعداد ویژگی ها است. S ۰ مجموع اوزان در همسایگی است. من موران میتوانم پراکندگی و تجمع فضایی را تنها با اهمیت آماری تفسیر کنم. امتیاز z I به صورت زیر محاسبه می شود:
در شرایطی که p در سطح معنیداری آماری باشد، اگر I > 0 و z > 0 باشد، توزیع فضایی مقادیر بالا یا پایین در مجموعه داده دارای درجه خوشهبندی بالاتر از حد انتظار است. اگر z <0، توزیع فضایی مقادیر بالا یا پایین در مجموعه داده در فضا گسسته تر از حد انتظار است [ ۵۹ ]. اگر I = 0 و z = 0 باشد، فضا به طور تصادفی توزیع می شود. ترکیب محلههای متن جغرافیایی تقسیمبندی شده توسط مجاورت ورونوی و شرایط ( I > 0 و z> 0) از خود همبستگی فضایی، می توان یک منطقه خودهمبستگی معنایی در همسایگی ایجاد کرد. در شرایط رد فرضیه غیر صفر، حداقل همسایگی مرتبه k Voronoi که فضای خودهمبستگی معنایی geo-text را مشخص می کند، یعنی منطقه همگرایی معنایی مرتبه Voronoi-k ( VSCR ) است:
حداقل VSCR به استنباط اینکه مکان جغرافیایی متن جدید چه نوع معنایی است کمک می کند.
وقتی مولفههای یک بردار متن جغرافیایی در همسایگی تقریباً برابر باشند، من موران را نمیتوان محاسبه کرد. به عنوان مثال، نظرات بسیاری در مورد مغازه ها در مرکز خرید ظاهر می شود، در حالی که نظرات مربوط به شرکت ها در پارک های صنعتی و توضیحات گل در باغ ها ظاهر می شود. با توجه به محدودیت خودهمبستگی فضایی، اگر منطقه ای از همان نوع نقاط تشکیل شده باشد، سایر انواع متن های جغرافیایی مستثنی خواهند شد. بنابراین، باید برای شناسایی پدیده واریانت اقدام کنیم.
دو نوع تغییر وجود دارد که باید قبل از جستجوی VSCR -order برای متنهای جغرافیایی اعمال شوند. اول، در توزیع تجمعی با ارزش بالا، هنگام تشخیص مولفه برداری از مرتبه ۱ ورونوی تا مرتبه k Voronoi (k ≥ ۳)، اگر همه انواع مولفه های geo-text داده شده بیشتر از ۷۰٪ باشند (یک تجربی مقدار)، انواع دیگر متن های جغرافیایی طبق قانون همبستگی خودکار فیلتر می شوند. در نوع دوم تغییر، توزیع تجمع کم ارزش، هنگام تشخیص یک منطقه مؤلفه برداری از مرتبه اول Voronoi تا مرتبه Voronoi K Voronoi (k ≥ ۳) عمل کرد، اگر همه اجزای یک نوع معین کمتر از ۲۰٪ (یک مقدار تجربی) باشند، یک توزیع تجمعی کم ارزش تشکیل می شود، و این نوع متن جغرافیایی داده شده از نقشه رد می شود.
۲٫۲٫۴٫ تجزیه و تحلیل شباهت حاشیه نویسی متن جغرافیایی در VSCR
همانطور که در شکل ۷ نشان داده شده است ، دو نوع موقعیت برچسب گذاری وجود دارد: یا حاشیه نویسی متن جغرافیایی جدید در یک محله حاوی انواع مشابه (یک محله تک نوع) یا در یک محله حاوی انواع مختلف قرار می گیرد (یک ترکیب- محله تایپ کنید). حاشیه نویسی محله تک نوع شکل خاصی از حاشیه نویسی ترکیبی است.
هنگامی که حاشیه نویسی متن جغرافیایی جدید در یک محله تک نوع قرار می گیرد، میانگین و واریانس متغیرها در همسایگی تغییر قابل توجهی نخواهد داشت و وضعیت مطابق قانون اول جغرافیا است. در مقابل، برای محلههای نوع مرکب، ژئومتن جدید توزیع اصلی را میشکند، و بنابراین ممکن است در این موقعیت مجاز نباشد، زیرا یک متن جغرافیایی نامرتبط است. به عنوان مثال، در شکل ۷ ، مربع های آبی نشان دهنده رستوران ها و دایره های سیاه نشان دهنده فروشگاه های بزرگ و مثلث های قرمز نشان دهنده مزارع هستند، بسیار آسان است که اجازه دهیم متن جغرافیایی جدید فروشگاه بزرگ به دلیل مطابق با همان، به این نقطه اضافه شود. محله تک نوع در VSCR، و همچنین اضافه کردن متن جغرافیایی مزرعه به دلیل عدم وجود محیط معنایی مزرعه در VSCR آن ممنوع است.
یک هیستوگرام احتمال تبدیل شده از بردار احتمال ژئومتن vc ، نشان داده شده در معادله (۱۲)، به تشخیص همبستگی بین متن های جغرافیایی جدید و همسایگی های بالقوه مرتبط کمک می کند. هیستوگرام احتمال p m در ناحیه vn( k ) Hist ( pm ) است . مجموعه داده های متون جغرافیایی P = { p ۱ , …, p i , …, p j , …, p n } در vn( k ) و مجموعه هیستوگرام آن عبارت است از: Hist p = ( Hist ۱, …, Hist i , …, Hist j , …, Hist P ) که k به دنباله bin هیستوگرام اشاره دارد و Hist i برابر با vc ژئوتکست p i و درجه همبستگی بین ژئومتن جدید و VSCR آن است. با ضریب همبستگی پیرسون محاسبه می شود. توجه داشته باشید، از آنجا که vc پارامترهای ورودی نرمال شده است، ضریب همبستگی پیرسون را می توان برای قضاوت در مورد شباهت بین دو حاشیه نویسی geotext استفاده کرد، همانطور که می توان از آن برای قضاوت در مورد شباهت بین دو هیستوگرام تصویر استفاده کرد.
در داخل اچمنستی¯من=۱ن∑j=1ناچمنستیمنک، N تعداد سطل های هیستوگرام است.
وقتی همبستگی بین pm و VSCR آن بالاتر از آستانه τ باشد، متن جغرافیایی با همسایگی همبستگی دارد. برعکس، زمانی که p m و VSCR با یکدیگر همبستگی ندارند، متن جغرافیایی جدید از نقشه در این p m رد می شود.
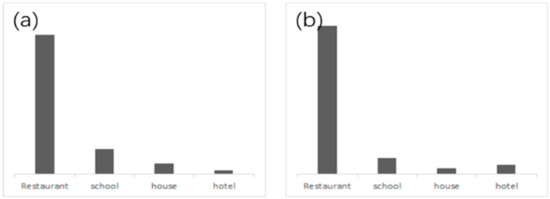
چهار ویژگی وجود دارد، به عنوان مثال، رستوران، مدرسه، خانه و هتل. شکل ۸ a هیست ( p m ) را نشان می دهد ( ۷۸،۱۴،۶،۲ )، که ما یک متن جغرافیایی را مطابق با رابطه (۱۱) به بردار احتمال تبدیل می کنیم، و شکل ۸ b مقدار هیستوگرام هر ژئومتن p را نشان می دهد. i در VSCR (۸۳،۹،۳،۵) است. ضریب همبستگی پیرسون بین pm و p i ۹۹٫۵۲ ٪ است، وقتی آستانه τ ۰٫۹ باشد، geo-text با همسایگی همبستگی دارد و geotext p m را می توان اضافه کرد.
به جای استفاده از نوع مطلق (انتخاب بزرگترین مؤلفه vc به عنوان نوع طبقهبندی) برای جستجوی حاشیهنویسیهای مشابه، روش ضریب همبستگی شخص میتواند برخی موارد شدید را تشخیص دهد. به عنوان مثال، دو حاشیه نویسی با احتمال طبقه بندی vc (۹۰، ۵، ۵، ۰) و vc (۴۹، ۴۸، ۱، ۲) به ترتیب کاملاً متفاوت هستند. اولی به وضوح طبقه بندی شده بود، در حالی که دومی مبهم بود. وقتی آنها با استفاده از روش مقایسه نوع مطلق به عنوان یک نوع طبقه بندی می شوند اشتباه است. با استفاده از روش ضریب همبستگی، شباهت آنها تنها ۵۹٫۶ درصد است که با شناخت واقعی ما همخوانی دارد.
۳٫ اعتبار سنجی آزمایش
آزمایش اعتبار سنجی طبقهبندی خودکار پیشنهادی و الگوریتم CGD را بر روی متنهای جغرافیایی POI گرفتهشده از پلت فرم Baidu Map آزمایش کرد. ما از geo-text های POI استفاده کردیم زیرا این geo-text ها که توسط داوطلبان ارائه می شود بسیار متراکم و فراوان بود. هر ژئومتن جدیدی می تواند VSCR را با متن های جغرافیایی کافی در همسایگی برای تشخیص همبستگی ها بسازد. روش طبقه بندی geo-text و الگوریتم CGD در پایتون ۳٫۶ ایجاد شد و از بسته های jieba، scikit-learn و PySAL در این آزمایش استفاده شد.
منطقه آزمایشی در Xianlin، یک شهر دانشگاهی در منطقه Qixia در نانجینگ قرار داشت که عمدتاً از مدارس، خانهها و رستورانها تشکیل شده بود. ما ۶۳۱ رکورد را از BaiduMap و برنامه نظرات محبوب در منطقه آزمایشی جمع آوری کردیم و نقاط geo-text را به سیستم مختصات طرح ریزی WGS 84 تبدیل کردیم. این نقاط geo-text تبدیل شده سپس بر روی نقشه بایدو ترسیم شدند ( شکل ۹ ).
۳٫۱٫ طبقه بندی خودکار متون جغرافیایی
با توجه به توزیع کلی انواع حاشیه نویسی متن جغرافیایی در منطقه مورد مطالعه، گروه هایی از انواع برای آزمایش تشخیص حاشیه نویسی متن جغرافیایی ناهنجار انتخاب شدند. این گروه ژئومتن آزمایشی شامل رستوران ها، خانه ها، مدارس بود. از آنجایی که رستوران های چینی به عنوان رستوران در نظر گرفته شدند، گروهی که شامل رستوران های چینی، رستوران ها، مدارس، خانه ها بود، در دسترس نبود. پس از شناخت انواع POI در حوزه تحقیق، مرحله بعدی آموزش نمونه است.
۳٫۱٫۱٫ طبقه بندی قطار
پیکره با خزیدن ۱۰۰۰ نمونه geo-text چینی برای هر نوع geo-text که از Baidu Map API انتخاب شده بود ایجاد شد و سپس نقاط geo-text به یک سیستم مختصات طرح ریزی WGS 84 تبدیل شدند. نمونه شامل ۱۰۰۰ متن خانه، ۱۰۰۰ متن رستوران و ۱۰۰۰ متن مدرسه برای آموزش در طبقهبندیکننده ساده و بینظیر چند جملهای بیز استفاده شد. داده های نمونه و آزمون به نسبت ۴:۱ استخراج شد. کوتاه ترین ژئومتن ۳۰ بایت و طولانی ترین ۱۳۷۲ بایت با میانگین طول ۲۰۵ بایت بود. پس از تقسیم بندی کلمات و حذف کلمات توقف، ۴۰۹۵۸ ستون و ۲۷۵۶ ردیف در بردارهای ویژگی های TF-IDF وجود داشت. ششصد حاشیه نویسی متن جغرافیایی برای ارزیابی دقت طبقه بندی کننده ساده چند جمله ای بیز استفاده شد. با توجه به نتایج طبقه بندی، دقت طبقه بندی ۹۷٫۷۸٪ بود. نرخ فراخوان ۹۷٫۷۹% و امتیاز F 96.83% بود. بنابراین، پیکره و طبقهبندی کننده مورد استفاده در این مقاله برای دستیابی به طبقهبندی مؤثر برای ژئومتن در نظر گرفته شد.
۳٫۱٫۲٫ فرآیند طبقه بندی ژئومتن
سه متن جغرافیایی A، B، و C، که بهطور تصادفی از POIهای خانه، POI مدرسه و رستوران در نقشه بایدو خزیده بودیم، برای تأیید فرآیند طبقهبندی متن جغرافیایی اعمال شد. ژئومتن چینی A، B و C در شکل ۱۰ نشان داده شده است. ژئوتکست A به این صورت به انگلیسی ترجمه شد: «این دهکده بسیار زیبا در شهر دانشگاهی Xianlin است که در منطقه ای مرفه واقع شده است. اکنون میانگین قیمت مسکن بیش از ۳۰۰۰۰ یوان است. حمل و نقل آنجا راحت است. مدارس ابتدایی، مهدکودک ها و دانشگاه های اطراف روستا، بنابراین فضای فرهنگی آنجا بسیار خوب است. بردار vcبود (۷۸٫۴۱۹، ۲۱٫۵۸۱، ۰)، و نتیجه این بود که نوع نقطه A یک خانه است. نقطه B به این ترتیب شرح داده شد: «مدرسه شامل هشت بخش جغرافیا، گردشگری، مدیریت زمین، سیستم اطلاعات جغرافیایی، سنجش از دور، علوم و مهندسی محیط زیست و علوم دریایی است. جغرافیا به عنوان رشته درجه یک دوگانه، نقشه برداری و سیستم اطلاعات جغرافیایی به عنوان رشته کلید ملی و رشته کلیدی استان جیانگ سو، و جغرافیای فیزیکی به عنوان رشته کلیدی استان جیانگ سو رتبه بندی شد. vc _(۰، ۹۰٫۳۰۲، ۹٫۶۰۸) بود. بنابراین B مربوط به نوع مدرسه بود. ژئومتن چینی C به این صورت ترجمه شده است: «من اغلب اینجا غذا میخورم، همچنین مقدار غذای خوشمزه، بسیار مقرون به صرفه است. خدمات مغازه دار بسیار گرم است. من استخوان سس، گوشت در قابلمه، مرغ سرخ شده و استخوان سس شمال شرقی را توصیه می کنم. همه آنها بسیار خوشمزه هستند و قیمت آنها متوسط است. vc ( ۱۵٫۳۲، ۱٫۲۹، ۸۳٫۳۹) بود و C یک نوع رستوران در نظر گرفته شد. بزرگترین مؤلفه vc انتخاب شده به عنوان نوع طبقه بندی، ژئومتن های A، B و C به درستی طبقه بندی شدند و بردار احتمال طبقه بندی آنها محاسبه شد.
تمام ژئومتن های موجود در منطقه آزمایشی به طور مشابه طبقه بندی شده و از طریق روش طبقه بندی خودکار متن به بردار تبدیل شدند و ژئومتن های مدرسه، خانه و رستوران به ترتیب در رنگ های قرمز، سبز و آبی ترسیم شدند که در شکل ۱۱ نشان داده شده است. .
۳٫۲٫ آزمایش الگوریتم تشخیص ژئومتن همبسته (CGD).
۳٫۲٫۱٫ فرآیند الگوریتم CGD
به منظور اعتبارسنجی الگوریتم CGD پیشنهادی در این مقاله، حاشیه نویسی geo-text خانه A در P1 قرار داده شد. ابتدا یک محله تودرتو با مرتبه k Voronoi برای p1 ساختیم: vn (۱)، vn (۲)، vn (۳)، vn (۴)، vn (۵)، vn (۶)، که در شکل ۱۲ نشان داده شده است. با توجه به ماتریس وزن فاصله ضد ورونوی، مقادیر I ، p و z از مرتبه ۱ ورونوی تا همسایگی های مرتبه k ورونوی به ترتیب محاسبه شد، همانطور که در جدول ۱ نشان داده شده است. مقادیر I, p,و z سپس با شرایط همگرایی مقایسه شدند (I > 0، z > 0 و p <0.1)، و nv ( k )، که در آن k حداقل مقدار برای رسیدن به نیاز است، به عنوان VSCR انتخاب شد . برای نقطه P1، VSCR به وضوح vn (۲) بود. سپس درجه همبستگی بین نوع بردار vc (۷۸٫۴۱۹، ۲۱٫۵۸۱، ۰) و سایر ژئومتن ها در vn (۲) با استفاده از روش ضریب همبستگی پیرسون محاسبه شد. دو ژئومتن مشابه VSCR وجود داشت که از ۲۱ متن جغرافیایی تشکیل شده بود. بنابراین، A به عنوان مرتبط با همسایگی تشخیص داده شد و اجازه داده شد تا در خدمات نقشه وب آپلود شود. شکل ۱۳Moran’s I را در محلههای مختلف تودرتو با مرتبه k Voronoi نشان میدهد.
نتایج ژئومتن های B و C به طور مشابه محاسبه شد و هر دو از نظر مکانی در vn (۲) همبستگی خودکار داشتند. به عبارت دیگر، VSCR آنها vn (۲) بود، که در آن هفت ژئومتن از ۲۱ ژئومتن با B و ۱۲ از ۲۱ ژئومتن با C همبستگی داشتند. بنابراین، B و C به عنوان همبستگی با همسایگی و همسایگی شناسایی شدند. مجاز به آپلود در نقشه وب شکل ۱۴ روند مقادیر I، p و z را برای A، B و C با افزایش همسایگی های تودرتو با مرتبه k Voronoi نشان می دهد.
۳٫۲٫۲٫ تشخیص پدیده های مختلف
همانطور که شکل ۱۵ نشان می دهد که از آنجایی که مولفه های برداری نوع خانه ژئومتن بین (۷۲، ۹۰) توزیع شده است، ژئومتن های نوع خانه یک منطقه تجمعی با ارزش بالا را در P7 از محله مرتبه اول Voronoi تا محله درجه ۳ ورونوی. هنگامی که k بین ۴ و ۶ بود، شامل انواع دیگری از متن های جغرافیایی به همسایگی اضافه شد و مولفه های برداری نوع خانه بین (۰، ۹۰) توزیع شد، و موران I را می توان به طور معمول محاسبه کرد. بنابراین، vn (۳) یک منطقه توزیع تجمعی با ارزش P7 بود و سایر انواع متنهای جغرافیایی حذف شدند. در نوع دوم تغییر، همانطور که در شکل ۱۶ نشان داده شده است، مقدار کم معمولاً بین ۰ تا ۱۲ است که به طور قابل توجهی کمتر از ۲۰ است. محله های مرتبه اول Voronoi تا محله های مرتبه ۳ Voronoi از توزیع تجمعی کم ارزش تبعیت می کنند و بنابراین P7 باید انواع رستوران از متن های جغرافیایی را حذف کند.
۳٫۳٫ تجزیه و تحلیل نتایج تجربی
۳٫۳٫۱٫ نتایج طبقه بندی ژئومتن
شباهت بین VSCR و متن جغرافیایی ورودی تعیین می کند که آیا حاشیه نویسی اضافه شده با همسایگی همبستگی دارد یا خیر. بنابراین، اجزای یک بردار طبقه بندی، احتمال هر نوع متن جغرافیایی است. در واقع، زمانی که وکتور geo-text، مانند vc (۰٫۵،۰٫۵،۰،۰)، دو سرویس رستوران و هتل را ارائه می دهد، نمی توان گفت که a متعلق به کدام نوع است. با این حال، با توجه به روش در این مقاله، یک ژئومتن مشابه را می توان یافت.
بررسی میدانی در طبقهبندی ۶۳۱ رکورد در منطقه آزمایشی نشان داد که هفت نوع حاشیهنویسی مبهم هستند که به یک نوع تعلق دارند و ۹ نوع آن اشتباه طبقهبندی شدهاند. دقت طبقه بندی ۹۷٫۴۹ درصد بود. پس از تجزیه و تحلیل دقیق آن متن های جغرافیایی، کوتاه بودن طول ژئوتکست و یک ژئومتن با اطلاعات نوع سروال عوامل مهمی بودند که منجر به بروز خطا شدند.
۳٫۳٫۲٫ نتیجه الگوریتم CGD
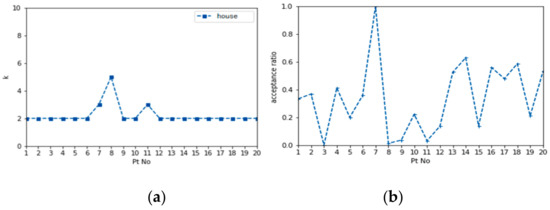
ژئومتن A در ۲۰ موقعیت تصادفی قرار داده شد که در شکل ۱۱ نشان داده شده است تا الگوریتم CGD را تأیید کند. VSCR ها به ترتیب در ۲۰ موقعیت ایجاد شدند، برای هر یک، k همگرا در VSCR ها محاسبه شد، همانطور که در شکل ۱۷ a نشان داده شده است. با t = 0.9 به عنوان حداقل مقدار همگرایی k، عدد geo-text در هر VSCR ، geo-text های همبسته در VSCR ، و نسبت بین geo-متن های همبسته و غیر همبسته در VSCR در جدول ۲ و جدول ۳ نشان داده شده است.
شکل ۱۷ ب نسبت ژئومتن های همبسته به نامرتبط را برای هر VSCR نشان می دهد و درجه همبستگی ایجاد شده از طریق الگوریتم CGD در شکل ۱۸ نشان داده شده است ، که در آن دایره های بزرگتر احتمال بیشتری را نشان می دهد که متن جغرافیایی مجاز بوده است. هنگامی که یک VSCR فاقد یک متن جغرافیایی مرتبط بود، متن جغرافیایی از نقشه رد میشد، به عنوان مثال، نقطه P3. همچنین میتوانیم با تعیین آستانه نسبت، متن جغرافیایی نامرتبط را فیلتر کنیم.
ما همین رویه را با متن های جغرافیایی B و C انجام دادیم و نسبت های مشابهی را به دست آوردیم، همانطور که در شکل ۱۹ نشان داده شده است. از این نتایج، ما چندین نتیجه گرفتیم: P3 فقط مربوط به نوع رستوران بود و سایر انواع متن جغرافیایی را حذف کرد. P7 فقط مربوط به نوع مسکن بود و انواع دیگر فیلتر شدند. P5، P9 و P12 پر از مدارس، با رستوران ها و خانه های پراکنده بودند. P8 و P11 پر از رستورانها بودند و انواع دیگر آنها در اطراف پراکنده بودند. در مکان های دیگر، به نظر می رسد توزیع ها ناهمگن تر هستند.
از طریق مشاهدات میدانی، این توصیفات از ۲۰ منطقه در شکل با وضعیت واقعی مطابقت داشت و کاربرد روش پیشنهادی را نشان داد. با آزمایش در یک محیط سیستم ۶۴ بیتی Win10 با ۸ گیگابایت حافظه، زمان مصرف یک آنالیز geo-text به طور متوسط ۰٫۱۳۶ ثانیه بود، که بنابراین می تواند برنامه های کاربردی واقعی را با کارایی بالا ارائه دهد.
۴٫ بحث
از آنجایی که طول یک متن جغرافیایی به طور کلی کوتاه است، یک طبقهبندی مناسب و دقیق را میتوان بر اساس ویژگیهای TF-IDF و یک مدل طبقهبندی ساده چند جملهای بیز ساخت. با این حال، طبقهبندی خودکار متن معمولاً خطاهایی را ایجاد میکند، عمدتاً از دو منبع: (۱) مجموعهای ناقص از نمونهها (به عنوان مثال، اگر وقتی یک متن جغرافیایی با کلمه کلیدی «KFC» ظاهر میشود، «KFC» در مجموعه گنجانده نشود. ، که geo-text را نمی توان به خوبی طبقه بندی کرد، و (۲) geo-text های فازی را که نمی توان به راحتی بر اساس معناشناسی یا فراوانی کلمات طبقه بندی کرد. به عنوان مثال، یک ژئومتن مربوط به غذا می گوید: “یک پارکینگ در زیر زمین رستوران وجود دارد، ساختمان بسیار جدید است، رضایت کلی بسیار خوب است، قابل توصیه است”.
اگرچه میتوانیم پیکره جامعتر و دقیقتری برای کاهش خطای نوع اول بسازیم، خطای نوع دوم ذاتی توصیف ناهمبستهای از متن جغرافیایی است. بنابراین، ما باید طول، محتوا و شکل متنهای جغرافیایی را برای توصیف دقیق ویژگیها در نقشه محدود کنیم. با این حال، دستیابی به این هدف در یک سرویس نقشه باز دشوار است. طبقه بندی های بسیار زیاد، پیچیدگی همگرایی خودهمبستگی را به دلیل مبهم بودن افزایش می دهد، و طبقه بندی های بسیار کمی برای توصیف توزیع فضای جغرافیایی کافی نیست. به منظور کاهش خطاها، پیشنهاد میکنیم دستههای متن جغرافیایی را به پنج محدود کنید، که فراتر از آن، الزامات کیفیت، طول و سبک دقیقتری باید اجرا شود.
علاوه بر این، از آنجایی که متن انگلیسی را می توان با فاصله و علائم نقطه گذاری تقسیم کرد، فرآیند طبقه بندی ژئومتن انگلیسی ساده تر از چینی است. بنابراین ایده پیشنهاد روش طبقه بندی ژئومتن در این مقاله برای ژئومتن انگلیسی نیز موثر است.
مجاورت طبیعی ورونوی و روش وزن دهی خاص توانایی انتخاب محله همگرا را افزایش می دهد. روش انتخاب مرتبه k Voronoi تفاوت های فضایی بین نقاط داده با توزیع نامنظم و چگالی های ناهموار را حذف می کند. روش های مختلف وزن دهی فاصله اقلیدسی و فاصله مجاور با مکان به طور جامع در نظر گرفته شده اند تا تأثیر فاصله یکسان بر ترتیب متفاوت را متمایز کنند. ترکیب این دو روش ما را قادر میسازد تا کار بعدی تشخیص را تکمیل کنیم.
نتایج تجربی ثابت می کند که روش می تواند متن نامرتبط را که با موقعیت حاشیه نویسی مطابقت ندارد شناسایی کند. با این حال، روش هنوز هم دارای کاستی هایی است. در مرحله اول، ما باید دانش قبلی از توزیع حاشیه نویسی متن جغرافیایی در منطقه تحقیقاتی، یک محدوده نوع معین را بدانیم. فقط از این طریق می توانیم محتوای پیکره خزیده شده را برای آموزش طبقه بندی کننده انتخاب کنیم تا از صحت طبقه بندی اطمینان حاصل کنیم. ثانیاً، الگوریتم در این مقاله یک پیشنهاد همبستگی فضایی برای اضافه کردن یا عدم افزودن حاشیهنویسی ارائه میکند، اما در مهندسی عملی، رد کردن اضافهنویسی فرآیند پیچیدهتری است. تا حدی فقط از منظر همبستگی فضایی از وقوع رویدادها می کاهد. این یک فرآیند جامع است که اجازه می دهد ژئومتن جدید با مراجعه به پیشنهادات ارائه شده توسط روش در این مقاله و ترکیب با وجود واقعی اشیاء هندسی جدید یا تغییر یافته آپلود شود. علاوه بر این، روشی موثر برای حفظ محیط معنایی حاشیهنویسیهای متنی جغرافیایی است.
۵٫ نتیجه گیری ها
به منظور جلوگیری از بارگذاری متن های جغرافیایی نامرتبط در خدمات نقشه وب، این مقاله یک روش طبقه بندی خودکار geo-text و همبستگی معنایی بین geo-متن های جدید و نزدیک را بررسی می کند. بر اساس ویژگی های TF-IDF و یک مدل بیزی چند جمله ای، یک پیکره و طبقه بندی کننده مناسب برای متن های جغرافیایی ساخته شد. بر اساس پارتیشن همسایگی K-order Voronoi و حداقل همگرایی همبستگی همبستگی فضایی، یک الگوریتم تشخیص geo-text همبسته (CGD) اجرا شد. کارایی و دقت این روش در یک آزمایش نشان داده شد. برای انواع حاشیه نویسی داده شده در یک منطقه مورد مطالعه، منطقه همگرای معنایی همسایگی مرتبه k Voronoi ( VSCR) یک متن جغرافیایی می تواند برای هر موقعیتی ایجاد شود. الگوریتم CGD به طور موثر متن های جغرافیایی نامرتبط را شناسایی کرد و پیشنهاد موثری برای جلوگیری از آپلود آنها در محیط نقشه وب ارائه کرد.
با این حال، روش پیشنهادی برای مناطق با تراکم کافی برای فعال کردن همبستگی معنایی مناسب نیست. بسیاری از ساختمانهای غیرجذاب که دارای حاشیهنویسیهای متنی جغرافیایی (یا خالی) هستند، منجر به کاهش تراکم اطلاعات معنایی فضا میشوند. برخی از داده های ساختاریافته دارای دانش معنایی فضایی زیادی هستند، به عنوان مثال، BIM (مدل سازی اطلاعات ساختمان)، CIM (مدل سازی اطلاعات شهر)، داده های کاربری زمین و غیره. از این رو، کار آینده میتواند دادههای ساختاریافته، مانند ردپای ساختمان، کاربری زمین، و تسهیلات ترافیکی، BIM، CIM را برای غنیسازی توصیفات معنایی اضافه کند. علاوه بر این، از آنجایی که روش ما فرض میکند که نقاط geo-text اتصال یکسانی دارند، ما تأثیر جادهها، سیستمهای آبی و ویژگیهای طبیعی را بر تقسیمبندی در نظر نگرفتیم.