کلید واژه ها:
نقشه ; عناصر خط ؛ بردارسازی خودکار ؛ یادگیری عمیق
۱٫ مقدمه
۲٫ داده ها و روش ها
۲٫۱٫ ساخت مجموعه داده نمونه
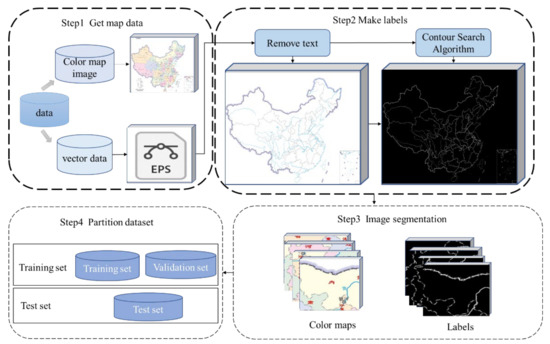
۲٫۱٫۱٫ به دست آوردن داده های نقشه
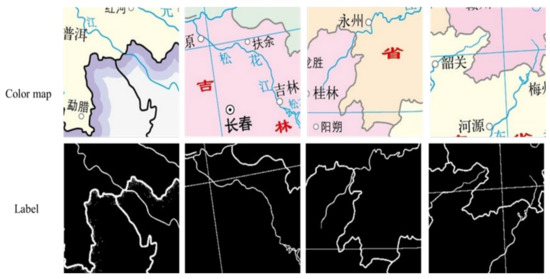
۲٫۱٫۲٫ ساخت لیبل
۲٫۱٫۳٫ تقسیم بندی تصویر
۲٫۱٫۴٫ بخش مجموعه داده
۲٫۲٫ مدل U-Net بهبود یافته
۲٫۲٫۱٫ معماری مدل U-Net بهبود یافته
رمزگذار از ساختار یک شبکه کانولوشن معمولی پیروی می کند. در مجموع شامل چهار بلوک است. هر بلوک در مسیر انقباض شامل دو پیچ ۳×۳ متوالی است که به دنبال آن یک واحد فعال سازی ReLU و یک لایه تجمع حداکثری قرار دارد. با در نظر گرفتن تأثیر تابع فعالسازی ReLU بر توزیع دادههای خروجی، حالت اولیهسازی هسته کانولوشن به عنوان یک مقدار اولیه اولیه He، he_normal تنظیم میشود. همانطور که در رابطه (۱) نشان داده شده است، با انحراف معیار از توزیع نرمال کوتاه شده نمونه می گیرد تا واریانس داده های ورودی و خروجی سازگار باشد. برای اینکه اندازه نمودار مشخصه بدست آمده پس از پیچیدگی بدون تغییر باقی بماند، روش پر کردن نمودار ویژگی به عنوان padding تنظیم می شود. پس از عملیات کانولوشن، یک لایه غیرفعال سازی تصادفی نورون (ترک کردن) بعد از لایه پیچشی اضافه می شود تا از برازش بیش از حد جلوگیری شود. یعنی نسبت مشخصی از هسته های کانولوشن در لایه قبلی به طور تصادفی غیرفعال می شوند تا نتوانند در استخراج ویژگی در این دوره آموزشی شرکت کنند و پارامترهای این مجموعات کانولوشن به روز نمی شوند. نسبت غیرفعال سازی تصادفی نورون ها در این مقاله ۰٫۲ است. سپس، حداکثر عملیات جمع آوری با اندازه استخر ۲ × ۲ و یک مرحله دو وجود دارد. این دنباله چهار بار تکرار میشود و در هر فرآیند نمونهبرداری پایین، تعداد فیلترهای لایه کانولوشن دو برابر میشود و به ترتیب به ۳۲، ۶۴، ۱۲۸ و ۲۵۶ فیلتر میرسد. نسبت معینی از هستههای کانولوشن در لایه قبلی بهطور تصادفی غیرفعال میشوند تا نتوانند در استخراج ویژگی در این دوره آموزشی شرکت کنند و پارامترهای این مجموعهای کانولوشن بهروزرسانی نمیشوند. نسبت غیرفعال سازی تصادفی نورون ها در این مقاله ۰٫۲ است. سپس، حداکثر عملیات جمع آوری با اندازه استخر ۲ × ۲ و یک مرحله دو وجود دارد. این دنباله چهار بار تکرار میشود و در هر فرآیند نمونهبرداری پایین، تعداد فیلترهای لایه کانولوشن دو برابر میشود و به ترتیب به ۳۲، ۶۴، ۱۲۸ و ۲۵۶ فیلتر میرسد. نسبت معینی از هستههای کانولوشن در لایه قبلی بهطور تصادفی غیرفعال میشوند تا نتوانند در استخراج ویژگی در این دوره آموزشی شرکت کنند و پارامترهای این مجموعهای کانولوشن بهروزرسانی نمیشوند. نسبت غیرفعال سازی تصادفی نورون ها در این مقاله ۰٫۲ است. سپس، حداکثر عملیات جمع آوری با اندازه استخر ۲ × ۲ و یک مرحله دو وجود دارد. این دنباله چهار بار تکرار میشود و در هر فرآیند نمونهبرداری پایین، تعداد فیلترهای لایه کانولوشن دو برابر میشود و به ترتیب به ۳۲، ۶۴، ۱۲۸ و ۲۵۶ فیلتر میرسد. حداکثر عملیات ادغام با اندازه استخر ۲ × ۲ و یک مرحله دو وجود دارد. این دنباله چهار بار تکرار میشود و در هر فرآیند نمونهبرداری پایین، تعداد فیلترهای لایه کانولوشن دو برابر میشود و به ترتیب به ۳۲، ۶۴، ۱۲۸ و ۲۵۶ فیلتر میرسد. حداکثر عملیات ادغام با اندازه استخر ۲ × ۲ و یک مرحله دو وجود دارد. این دنباله چهار بار تکرار میشود و در هر فرآیند نمونهبرداری پایین، تعداد فیلترهای لایه کانولوشن دو برابر میشود و به ترتیب به ۳۲، ۶۴، ۱۲۸ و ۲۵۶ فیلتر میرسد.
در اینجا، std مخفف انحراف استاندارد و fa n _ i n�آ�_من�به تعداد واحدهای ورودی در تانسور وزن اشاره دارد.
۲٫۲٫۲٫ ماژول AG در مدل
ایده ماژول AG این است که توانایی یادگیری مدل شبکه عصبی کانولوشن را برای خطوط ویژگیها با افزایش وزن ویژگیهای خط نقشه رنگی، کاهش نویز متن در پسزمینه نقشه و بهبود اثر استخراج نقشه افزایش دهد. ویژگی های خط ( شکل ۴ ). ایکسلمنایکسمنلنمودار ویژگی بدست آمده توسط ماژول رمزگذار را نشان می دهد و gمن�مننمودار ویژگی بدست آمده توسط ماژول رمزگشا را از طریق نمونه برداری بالا نشان می دهد. Xi برای بدست آوردن وزن با ۱ × ۱ پیچیده می شود دبلیوایکسدبلیوایکس، و gمن�منبرای بدست آوردن وزن با ۱ × ۱ در هم می پیچد دبلیوgدبلیو�، و سپس با هم جمع می شوند. qلa t t n�آتیتی�لبا استفاده از تابع فعال سازی ReLU و تابع کانولوشن، ψ، برای یک عملیات پیچیدگی ۱ × ۱ × ۱، و سپس ضریب توجه نهایی به دست می آید. qلa t t n�آتیتی�لبا استفاده از تابع فعال سازی Sigmoid for به دست می آید qلa t t n�آتیتی�ل. در نهایت ضریب توجه به دست آمده در ویژگی ورودی ضرب می شود ایکسلمنایکسمنلبرای به دست آوردن ویژگی خروجی نهایی ایکس^لمن ، جایکس^من،جل. فرمول های محاسبه ضریب توجه مکانیسم توجه در ماژول AG به ترتیب معادلات (۲) و (۳) هستند:
جایی که ΨΨنشان دهنده تابع پیچش اندازه ۱ × ۱ × ۱، σ۱�۱نشان دهنده تابع فعال سازی ReLU است، دبلیوایکسدبلیوایکسمقدار وزن مربوط به ویژگی ورودی است ایکسلمنایکسمنل، ایکسلمنایکسمنلویژگی ورودی است، دبلیوgدبلیو�مقدار وزن مربوط به شماره ارتباط انتخاب شده است gمن�من، gمن�منشماره ارتباط اختیاری است، بgب�مقدار افست سیگنال ارتباطی انتخاب شده است، بΨبΨمقدار بایاس مربوط به تابع پیچیدگی ۱ × ۱ × ۱ است و σ۲�۲تابع فعال سازی سیگموئید است.
۲٫۲٫۳٫ ماژول ASPP در مدل
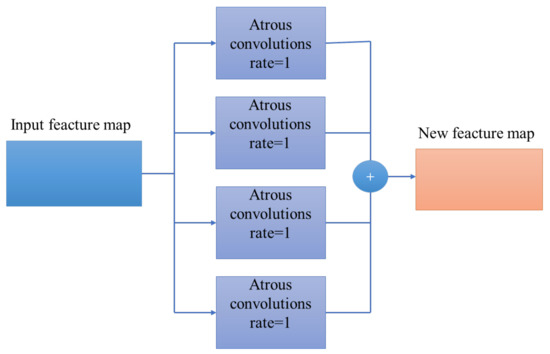
با هدف استخراج ویژگی های خط باریک نقشه، ماژول ASPP به آخرین لایه رمزگذار اضافه می شود. ماژول ASPP حفرههایی را به هسته کانولوشن عمومی اضافه میکند و فضای خالی سطوح مختلف هستههای کانولوشن افزایش میدان پذیرنده را بدون افزایش بار محاسباتی متوجه میشوند ( شکل ۵).). روش محاسبه پیچش گشاد شده در رابطه (۴) نشان داده شده است. در این ساختار از لایههای نمونهگیری مختلف در لایه کدگذاری به عنوان ورودی استفاده میشود و خروجی لایه نمونهبرداری بالایی مربوطه به عنوان ورودی لایه نمونهبرداری بالایی بعدی خلاصه میشود. ساختار پیچش گشاد شده از پیچش گشاد شده با سطوح نمونه برداری ۱، ۲، ۴ و ۸ برای انجام عملیات پیچش روی نمودار ویژگی ورودی استفاده می کند، بنابراین اندازه میدان پذیرنده هر لایه ۳، ۷، ۱۵ و ۳۱ است. به ترتیب. برای محاسبه مدل از نقشههای ویژگی سطوح نمونهگیری مختلف استفاده میشود تا ویژگیهای مقیاس مختلف به دست آید و در نهایت، ادغام بین ویژگیها انجام میشود. اطلاعات فضایی چند مقیاسی نقشه های ویژگی به طور کامل استخراج شده و برای انطباق با استخراج ویژگی خطی نقشه استفاده می شود.
اینجا، y[ من ، ج ]�[من،�]خروجی پیچش گشاد شده است، x [ i ، j ]ایکس[من،�]ورودی است، ω [ k ]�[ک]هسته کانولوشن با اندازه k است و r سطوح مختلف نمونه برداری از هسته کانولوشن را نشان می دهد.
۲٫۳٫ طراحی پارامتر شبکه
۲٫۳٫۱٫ عملکرد از دست دادن
از دست دادن تاس [ ۲۷ ، ۲۸ ] به عنوان تابع ضرر انتخاب شد. ضریب تاس تابعی از اندازه گیری شباهت مجموعه است که معمولاً برای محاسبه شباهت دو نمونه استفاده می شود و مقدار آن از ۰ تا ۱ متغیر است. فرمول محاسبه از دست دادن تاس در رابطه (۵) نشان داده شده است:
اینجا، | ایکس∩ Y|ایکس∩�نشان دهنده تقاطع بین ایکسایکسو Y�، و | ایکس|ایکسو | Y|�نشان دهنده تعداد پیکسل ها در برچسب پیش بینی شده است ایکسایکسو حقیقت زمین Y�، به ترتیب.
۲٫۳٫۲٫ بهینه ساز
۲٫۳٫۳٫ میزان یادگیری
نرخ یادگیری، فراپارامتر وزن شبکه است که توسط گرادیان تابع تلفات تنظیم می شود. نرخ یادگیری اولیه روی ۰٫۰۰۱ تنظیم شده است و پلت فرم ضرر تنظیم شده است. ده بار تمرین در هر تکرار، اگر میزان ضرر تغییر زیادی نداشته باشد، میزان یادگیری کاهش می یابد. کاهش نرخ یادگیری در رابطه (۶) نشان داده شده است و حداقل مقداری که نرخ یادگیری می تواند به آن کاهش یابد ۰٫۰۰۰۰۰۱ تعیین می شود. ما مکانیسم توقف زودهنگام را برای جلوگیری از تجهیز بیش از حد شبکه در طول آموزش تنظیم می کنیم.
اینجا، l rل�نشان دهنده میزان یادگیری است و لr0ل�۰نرخ یادگیری اولیه را نشان می دهد.
۲٫۴٫ روش اعتبارسنجی مدل
ضریب تاس یک شاخص ارزیابی مبتنی بر منطقه است که بر روی همپوشانی بین منطقه مرجع برچسب و نتایج تقسیمبندی خودکار در بعد فضایی تمرکز دارد. نتایج آزمایش ارزیابی DSC، ارزیابیهای سطح پیکسل هستند. ویژگی خط واقعی در ناحیه A ظاهر می شود و ویژگی خط پیش بینی شده توسط مدل شبکه در ناحیه B ظاهر می شود . فرمول ضریب تاس معادله (۷) است:
استخراج ویژگی های خط نقشه یک مشکل دوگانه است. دقت، یادآوری و امتیاز F1 شاخصهای ارزیابی مبتنی بر طبقهبندی پیکسل هستند که بر روی درجه تصادف بین ناحیه مرجع برچسب و کانتور نتیجه تقسیمبندی خودکار تمرکز دارند. اطلاعات ویژگی خط یک نمونه مثبت و اطلاعات پس زمینه یک نمونه منفی است. تمام نتایج پیشبینی را میتوان به چهار دسته تقسیم کرد: مثبت واقعی ( TP ) نشاندهنده تعداد پیکسلهای عناصر در خط طبقهبندی صحیح، منفی واقعی ( TN ) نشاندهنده تعداد پیکسلهای پسزمینه است که به درستی طبقهبندی شدهاند، مثبت کاذب. ( FP) تعداد پیکسل های پس زمینه ای را نشان می دهد که به اشتباه به ویژگی های خط تقسیم شده اند و منفی کاذب ( FN ) نشان دهنده تعداد پیکسل های ویژگی خط است که به اشتباه به عنوان پیکسل های پس زمینه طبقه بندی شده اند. با توجه به این شاخصها، فرمولهای محاسباتی برای دقت ، یادآوری و امتیاز F1 به ترتیب معادلات (۸) – (۱۰) هستند.
۳٫ نتایج تجربی و تجزیه و تحلیل
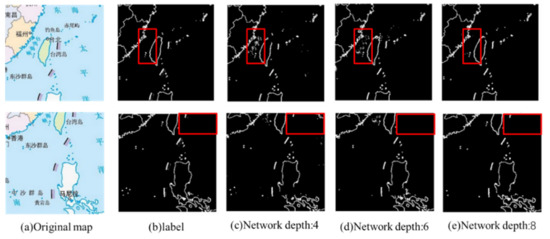
۳٫۱٫ تأثیر عمق های مختلف شبکه بر نتایج استخراج
۳٫۲٫ تأثیر ماژول های مختلف جمع بر نتایج استخراج
۳٫۳٫ تست تصاویر نقشه با زبان های مختلف
۳٫۴٫ تست استحکام مدل U-Net بهبود یافته
۴٫ بحث
۵٫ نتیجه گیری ها
-
شبکه U-Net بهبود یافته ای که ما پیشنهاد کردیم به استخراج خودکار دقیق ویژگی های خط نقشه شبکه دست یافت و دقت DSC نتایج استخراج به ۹۳٫۳ درصد رسید. در مقایسه با مدل سنتی شبکه U-Net، DSC 7.1٪ افزایش یافته است، دقت ۶٫۳۹٪ افزایش یافته است، و نرخ فراخوان ۸٫۱۶٪ افزایش یافته است. در حضور نویز، زمانی که SNR 0.01 بود، دقت DSC تا ۱۷٫۰۵٪ بهبود یافت. هنگامی که SNR 0.02 بود، DSC 15.11٪ افزایش یافت. هنگامی که SNR 0.03 بود، DSC 14.41٪ افزایش یافت. هنگامی که SNR 0.04 بود، DSC 13.18٪ افزایش یافت. هنگامی که SNR 0.05 بود، DSC 14.55٪ افزایش یافت.
-
شبکه بهبودیافته U-Net که در اینجا پیشنهاد شد، توانایی ضد نویز بهتر و استحکام بهتری در استخراج ویژگی های خط نقشه شطرنجی نسبت به شبکه U-Net سنتی داشت، که نشان دهنده قابلیت گسترش برتر آن است.
منابع
- چیانگ، YY; مقدم، س. گوپتا، اس. فرناندس، آر. Knoblock، CA از تصاویر نقشه تا نام های جغرافیایی. در مجموعه مقالات بیست و دومین کنفرانس بین المللی ACM SIGSPATIAL در مورد پیشرفت در سیستم های اطلاعات جغرافیایی، دالاس/فورت ورث، تگزاس، ایالات متحده آمریکا، ۴ تا ۷ نوامبر ۲۰۱۴٫ صص ۵۸۱-۵۸۴٫ [ Google Scholar ]
- یو، آر. لو، ز. چیانگ، YY تشخیص متن در نقشه های تاریخی با استفاده از نقشه های دوره های زمانی متعدد. در مجموعه مقالات بیست و سومین کنفرانس بینالمللی شناسایی الگو (ICPR)، کانکون، مکزیک، ۴ تا ۸ دسامبر ۲۰۱۶ در سال ۲۰۱۶٫ [ Google Scholar ]
- فلچر، لس آنجلس؛ Kasturi، R. یک الگوریتم قوی برای جداسازی رشته متن از تصاویر ترکیبی متن/گرافیک. IEEE Trans. الگوی مقعدی ماخ اینتل. ۱۹۸۸ ، ۱۰ ، ۹۱۰-۹۱۸٫ [ Google Scholar ] [ CrossRef ]
- ژانگ، تی. یین، ییل؛ Liu، XL تشخیص خودکار نمادهای نقطه ای در نقشه های اسکن شده. مهندس Surv. نقشه ۲۰۰۰ ، ۳ ، ۱۵-۱۸٫ [ Google Scholar ] [ CrossRef ]
- Illert، A. دیجیتالی سازی خودکار نقشه های مقیاس بزرگ. در مجموعه مقالات کنوانسیون سالانه Acsm-Asprs 1991، بالتیمور، MD، ایالات متحده آمریکا، ۲۵-۲۹ مارس ۱۹۹۱٫ صص ۱۱۳-۱۲۲٫ [ Google Scholar ]
- اوهساوا، ی. ساکاوشی، م. موراکامی، ا. Kamada، K. شناسایی خودکار اطلاعات جاده ها در نقشه های توپوگرافی مقیاس متوسط. در دسترس آنلاین: https://www.isprs.org/proceedings/XXVII/congress/part3/350_XXVII-part3-sup.pdf (در ۲۶ ژوئیه ۲۰۲۲ قابل دسترسی است).
- ساتوشی، اس. ماکوتو، ک. Toshio, H. Errata: تشخیص خودکار خط کشی نقشه های بزرگ. انتخاب کنید مهندس ۱۹۸۷ ، ۲۶ ، ۸۲۶٫ [ Google Scholar ]
- نگی، جی. سملز، ع. ستز، اس. فیشرز، تی. گاثمان، ای. کالافالا، ک. لی، ال. سیواسوبرامانیام، اس. Xu, Y. خواندن نام خیابان ها از نقشه ها – چالش های فنی. در مجموعه مقالات کنفرانس GIS/LIS، واشنگتن، دی سی، ایالات متحده آمریکا، ۲۰ نوامبر ۱۹۹۸; صص ۸۹-۹۷٫ [ Google Scholar ]
- چیانگ، YY; Knoblock، CA تشخیص متن در نقشه های شطرنجی. Geoinformatica ۲۰۱۵ ، ۱۹ ، ۱-۲۷٫ [ Google Scholar ] [ CrossRef ]
- چیانگ، YY; لیک، اس. نظری، NH; مقدم، س. Tan, TX ارزیابی تأثیر کیفیت گرافیکی بر تشخیص خودکار متن در نقشه های دیجیتال. محاسبه کنید. Geosci. ۲۰۱۶ ، ۹۳ ، ۲۱-۳۵٫ [ Google Scholar ] [ CrossRef ]
- لادوس، جی. والونی، ای. سانچز، جی. مارتی، ای. تشخیص نماد: پیشرفتها و چشماندازهای کنونی. در مجموعه مقالات چهارمین کارگاه بین المللی، GREC 2001، Kingston، ON، کانادا، ۷-۸ سپتامبر ۲۰۰۱٫ [ Google Scholar ]
- چیانگ، ی.-ای. لیک، اس. Knoblock، CA بررسی تکنیک های پردازش نقشه دیجیتال. کامپیوتر ACM. Surv. ۲۰۱۴ ، ۴۷ ، ۱-۴۴٫ [ Google Scholar ] [ CrossRef ]
- مدل های تجسم سه بعدی Beattie، CS به عنوان ابزاری برای بازسازی چشم انداز تاریخی حوضه آبخیز نهر بالونا. China Fiber Insp. ۲۰۱۱ ، ۹۹ ، ۲۹۰-۳۰۰٫ [ Google Scholar ]
- لواچکین، اس. ولاسکز، آ. الکساندروف، وی. خارینوف، ام. تحلیل معنایی و شناخت تصاویر کارتوگرافی رنگی اسکن شده با شطرنجی. در کارگاه بین المللی تشخیص گرافیک ; Springer: برلین/هایدلبرگ، آلمان، ۲۰۰۱; صص ۱۷۸-۱۸۹٫ [ Google Scholar ]
- لیم، YW; سانگ، UL در الگوریتم تقسیمبندی تصویر رنگی بر اساس تکنیکهای آستانهگذاری و c-means فازی. تشخیص الگو. ۱۹۹۰ ، ۲۳ ، ۹۳۵-۹۵۲٫ [ Google Scholar ]
- دو، ج. Zhang, Y. استخراج خودکار خطوط کانتور از نقشه توپوگرافی اسکن شده. در مجموعه مقالات سمپوزیوم بین المللی علوم زمین و سنجش از دور IEEE، انکوریج، آلاسکا، ایالات متحده آمریکا، ۲۰ تا ۲۴ سپتامبر ۲۰۰۴٫ [ Google Scholar ]
- وانگ، اس. ژانگ، ز. Wwn، W. Qiu, Z. تقسیم بندی خودکار رنگ در نقشه ها بر اساس نظریه رنگ و ریخت شناسی ریاضی. گاو نر Surv. نقشه ۲۰۰۱ ، ۱۰ ، ۳۳۴-۳۴۰٫ [ Google Scholar ]
- Budig, B. استخراج اطلاعات فضایی از نقشه های تاریخی: الگوریتم ها و تعامل ; BoD–Books on Demand: هامبورگ، آلمان، ۲۰۱۸٫ [ Google Scholar ]
- لی، دبلیو. Shuai، X. Liu, J. تقسیم بندی نقشه خطوط رنگ بر اساس Matlab. ژئوسپات. Inf. ۲۰۲۱ ، ۱۹ ، ۸۰-۸۲+۸۵٫ [ Google Scholar ] [ CrossRef ]
- LeCun، Y.; بنژیو، ی. هینتون، جی. یادگیری عمیق. طبیعت ۲۰۱۵ ، ۵۲۱ ، ۴۳۶-۴۴۴٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
- دوان، دبلیو. چیانگ، YY; Knoblock، C. جین، وی. دان، اف. Uhl، JH; لیک، اس. تراز خودکار ویژگی های جغرافیایی در داده های برداری معاصر و نقشه های تاریخی. در مجموعه مقالات اولین کارگاه هوش مصنوعی و یادگیری عمیق برای کشف دانش جغرافیایی، لس آنجلس، کالیفرنیا، ایالات متحده آمریکا، ۷ تا ۱۰ نوامبر ۲۰۱۷؛ صص ۴۵-۵۴٫ [ Google Scholar ]
- Uhl، JH; لیک، اس. چیانگ، YY; دوان، دبلیو. Knoblock، CA استخراج ردپای سکونت انسانی از سری نقشه های توپوگرافی تاریخی با استفاده از یادگیری ماشین مبتنی بر زمینه. در مجموعه مقالات ICPRS 2017، هشتمین کنفرانس بین المللی سیستم های تشخیص الگو، مادرید، اسپانیا، ۱۱ تا ۱۳ ژوئیه ۲۰۱۷٫ [ Google Scholar ]
- Uhl، JH; لیک، اس. چیانگ، YY; دوان، دبلیو. Knoblock، CA فضایی سازی عدم قطعیت در تقسیم بندی تصویر با استفاده از شبکه های عصبی کانولوشنال با نظارت ضعیف: مطالعه موردی از پردازش نقشه تاریخی. IET Image Proc. ۲۰۱۸ ، ۱۲ ، ۲۰۸۴–۲۰۹۱٫ [ Google Scholar ] [ CrossRef ]
- پنگ، دی اف. ژانگ، YJ; Guan، تشخیص تغییر سرتاسر HY برای تصاویر ماهواره ای با وضوح بالا با استفاده از بهبود یافته UNet plus. Remote Sens. ۲۰۱۹ , ۱۱ , ۱۳۸۲٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- رونبرگر، او. فیشر، پی. Brox، T. U-Net: شبکه های کانولوشن برای تقسیم بندی تصویر زیست پزشکی. پزشکی محاسبه تصویر. Comput.-Assist. مصاحبه Pt III ۲۰۱۵ ، ۹۳۵۱ ، ۲۳۴-۲۴۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- چن، LCE; زو، YK; پاپاندرو، جی. شروف، اف. آدام، اچ. رمزگذار-رمزگشا با پیچیدگی قابل جداسازی آتروس برای تقسیم بندی تصویر معنایی. لکت. یادداشت ها محاسبه. علمی ۲۰۱۸ ، ۱۱۲۱۱ ، ۸۳۳-۸۵۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- چن، ایکس. ویلیامز، بی.ام. Vallabhaneni, SR; سیزنر، جی. Zheng, Y. یادگیری مدلهای کانتور فعال برای تقسیمبندی تصویر پزشکی. در مجموعه مقالات کنفرانس IEEE/CVF 2019 در مورد دید رایانه و تشخیص الگو (CVPR)، لانگ بیچ، CA، ایالات متحده آمریکا، ۱۵ تا ۲۰ ژوئن ۲۰۱۹٫ [ Google Scholar ]
- بوسمن، ع. انگلبرشت، آ. Helbig، M. تجسم حوضه های جذب برای توابع از دست دادن شبکه عصبی متقابل آنتروپی و خطای مربعی. Neurocomputing ۲۰۲۰ , ۴۰۰ , ۱۱۳۱۳۶٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
- کینگما، دی. با، جی. آدام: روشی برای بهینه سازی تصادفی. arXiv ۲۰۱۴ ، arXiv:1412.6980. [ Google Scholar ]
- وی، ایکس. ژو، زی. دو روش ارزیابی عملکرد برای مسائل طبقه بندی بر اساس منحنی ROC. محاسبه کنید. تکنولوژی توسعه دهنده ۲۰۱۰ ، ۲۰ ، ۴۷-۵۰٫ [ Google Scholar ]
- وو، بی. لین، اس. ژو، جی. ارزیابی کمی شاخصها برای تقسیمبندی مبتنی بر شیء تصویر با وضوح فضایی بالا. J. Geo-Inform. علمی ۲۰۱۳ ، ۱۵ ، ۵۶۷-۵۷۳٫ [ Google Scholar ] [ CrossRef ]