۱٫ معرفی
در فضای نقشه، موجودیت های جغرافیایی مختلف به عنوان نقاط، خطوط، چند ضلعی ها یا دیگر انواع عناصر مدل می شوند. خطوط یکی از فراوان ترین عناصر هستند که نشان دهنده رودخانه ها، جاده ها، مرزهای اداری و خطوط ساحلی هستند. به دلیل ناهمگونی ذاتی در محیط های جغرافیایی، خطوط معمولاً از نظر ویژگی های هندسی و ساختارهای فضایی متفاوت هستند. به طور خاص، یک خط مجزا ممکن است ویژگیهای الگوی شکل متفاوتی داشته باشد، که ویژگیهای توزیع فضایی موجودیت جغرافیایی مرتبط را نشان میدهد. در طول پردازش تعمیم خط، که شکل یک خط را با حذف جزئیات کوچک ناخواسته ساده میکند، مهم است که الگوهای ریختشناسی خطوط را شناسایی کرده و آنها را به بخشهای همگن تقسیم کنیم [ ۱ ، ۲ ], ۳ , ۴ , ۵ , ۶ , ۷ ]. یک مثال ساده در شکل ۱ نشان داده شده است ، که در آن خطی متشکل از دو بخش با ویژگی های الگوی مختلف با استفاده از دو الگوریتم محبوب ساده شده است (یعنی الگوریتم مبتنی بر خم [ ۸ ] و الگوریتم ساده سازی حفظ متعامد [ ۹ ]]). الگوریتم مبتنی بر خم برای سادهسازی بخش I با سلسله مراتب پیچیده خمها مناسب بود، با این حال، نتیجه رضایتبخشی برای بخش II با کاراکترهای متعامد ایجاد کرد. در مقابل، الگوریتم حفظ متعامد به خوبی برای حفظ قائدگی بخش II عمل کرد. با این حال، ساختارهای خم اصلی قطعه I را تحریف کرد. این مثال نشان می دهد که هر الگوریتم تعمیم خط دارای نقاط قوت و ضعف خاص خود برای ویژگی های شکل متفاوت است [ ۱۰ ، ۱۱ ، ۱۲ ].
برای غلبه بر این اشکال، یک راه حل امیدوارکننده، توسعه روش های تعمیم ترکیبی است که به هر قسمت از خط اجازه می دهد با استفاده از الگوریتم مناسب پردازش شود. به طور خاص، برای هر خط ورودی، ابتدا ویژگی های شکل خط شناسایی شده و سپس به بخش های هندسی همگن تقسیم می شوند. در مرحله بعد، تنظیمات الگوریتم و پارامتر مناسب را می توان برای هر بخش با توجه به نوع الگوی آن اعمال کرد. از آنجایی که تعداد زیادی از الگوریتمهای تعمیم خط توسعه یافتهاند، روشهایی برای تشخیص و تقسیمبندی الگوی خط به کانون تحقیقات فعلی تبدیل شدهاند. این ضرورت توسط محققان در طول تعمیم ویژگی های مختلف نقشه، از جمله خطوط کلی ساختمان [ ۱۱ ، ۱۳ ، ۱۴ ، برجسته شده است.]، مرزهای اداری [ ۱۲ ]، خطوط جاده [ ۱۵ ، ۱۶ ، ۱۷ ]، خطوط ساحلی [ ۱۸ ]، و مرزهای کاربری زمین [ ۵ ].
در چند دهه گذشته، برخی از مطالعات به تقسیم بندی خطوط اختصاص یافته است. به طور کلی، این روش ها را می توان به دو دسته تقسیم کرد: روش های مبتنی بر نقطه بحرانی و مبتنی بر تحلیل شکل. نقاط بحرانی، مانند نقاط عطف [ ۱۹ ]، معمولاً به عنوان نقاط شکست شناسایی می شوند، بنابراین نتایج تقسیم بندی را به دست می آورند. علاوه بر این، چندین مطالعه به طور ضمنی با استفاده از مدلهای فشردهسازی نقطهای که در آن نقاط حفظشده بهعنوان نقاط بحرانی استفاده میشد، به تقسیمبندی دست یافتند [ ۳ ، ۲۰ ]. روشهای مبتنی بر تحلیل شکل، بخشهای همگن را با اندازهگیریهای هندسی شناسایی میکنند. به عنوان مثال، در رویکرد ارائه شده توسط Plazanet و همکاران. [ ۴]، یک خط ورودی به صورت بازگشتی تقسیم شد تا زمانی که همه قسمت ها از نظر هندسی همگن شدند. سپس نوع الگوی هر بخش بر اساس اندازهگیری شکل خمها طبقهبندی شد. سامسونوف و یاکیمووا [ ۱۲ ] چندین روش از جمله فیلتر کردن، تقسیم بندی و مربع کردن را برای تجزیه یک خط به بخش های همگن پیشنهاد کردند. آنها بخش های متعامد و غیر شماتیک را بر اساس تجزیه و تحلیل اندازه گیری زاویه و فاصله شناسایی کردند.
روشهای هوشمندی برای تقسیمبندی خطوط بر اساس تحلیل شکل و معیارهای هندسی مورد بررسی قرار گرفتهاند. به عنوان مثال، بالبوآ و لوپز [ ۱۶ ، ۱۷ ] تلاش کردند تا از طریق یک شبکه عصبی مصنوعی پس انتشار (BANN) از تقسیم بندی انسان متخصص برای خطوط جاده تقلید کنند. مجموعه ای از ویژگی های هندسی برای توصیف ویژگی های شکل هر بخش جاده استفاده شد. سپس یک مدل طبقهبندی BANN برای ایجاد نقشه بین ویژگیهای توصیفی و انواع الگو طراحی شد. در نهایت، نتایج تقسیمبندی خط با اعمال طبقهبندیکننده برای پیشبینی کلاس هر جزء مشتقشده از پنجرهای در حال حرکت در امتداد خطوط بهدست آمد. لیو و یانگ [ ۱۸] روش مشابهی را برای تقسیمبندی خط ساحلی ایجاد کرد که ویژگیهای هندسی یک بخش را با استفاده از تحلیل مؤلفه اصلی (PCA) پردازش میکند. آنها مدل بیزی را برای ساخت طبقهبندیکننده برای پیشبینی انواع الگوی بخشهای استخراجشده توسط یک پنجره متحرک، و خروجی نتایج تقسیمبندی با ادغام بخشهای متعلق به کلاسهای یکسان، اتخاذ کردند. اگرچه روش های زیادی برای این منظور توسعه داده شده است، تجزیه و تحلیل موثر و تقسیم بندی خطوط همچنان چالش برانگیز است. اول، آشکار کردن جامع و عینی ویژگیهای شکل یک خط دشوار است و در نتیجه اطلاعات لازم برای تشخیص بخشهایی با ویژگیهای شکل متفاوت وجود ندارد. دوم، روشهای موجود فاقد مکانیزم مؤثر برای در نظر گرفتن اطلاعات زمینهای محلی هستند.
از منظر شناخت بصری، مسئله تقسیم خط شبیه به مسئله تقسیمبندی تصویر است (یعنی ترکیب واحدهایی با ویژگیهای مشابه برای تشکیل ساختارهای همگن پیوسته محلی). در زمینه تقسیمبندی تصویر، شبکههای عصبی کانولوشنال (CNN) دارای ویژگیهای عالی، از جمله درک محلی و خصوصیات چند مقیاسی هستند که آنها را به پیشرفتهترین فناوری برای حل این مشکل تبدیل میکند [ ۲۱ ، ۲۲ ]. اخیراً، CNN ها و انواع آن ها با موفقیت برای پردازش داده های نقشه، از جمله تشخیص و طبقه بندی الگوی جغرافیایی [ ۲۳ ، ۲۴ ، ۲۵ ]، نمایش شکل و طبقه بندی [ ۲۶ ، استفاده شده اند.۲۷ ]، و تعمیم نقشه برداری [ ۷ ، ۲۸ ، ۲۹ ]. در این مطالعه، ما از فناوری CNN برای ساخت روشی برای تشخیص الگو و تقسیمبندی خطوط استفاده کردیم. با این حال، برخلاف دادههای تصویری با ساختارهای شبکهای توپولوژی، هر خط متشکل از دنبالهای از نقاط با توزیع ناهموار بود. فاصله بین دو نقطه مجاور یکسان نبود. بنابراین، واحدهای پردازش ثابت نبودند. بنابراین، ما خطوط را به یک سری از واحدهای خطی متوالی با طول مساوی تقسیم کردیم که به نام لیکسل نیز شناخته می شود [ ۳۰ ].]، که به عنوان واحدهای اصلی تشکیل دهنده یک خط عمل می کنند. بر این اساس، هر خط در فهرستی از لیکسل ها، مرتب شده و به طور مساوی توزیع شده است. به این ترتیب، مسئله تقسیمبندی خط به یک مسئله طبقهبندی لیکسل تبدیل شد، که میتوان آن را با استفاده از تکنیکهای تقسیمبندی تصویر پیشرفته تحلیل و پردازش کرد تا کاستیهای ذاتی روشهای موجود را برطرف کند که شامل وابستگی بیش از حد به ویژگیهای دستساز و در نظر گرفتن ناکافی اطلاعات زمینهای است.
ما یک توصیفگر زمینه شکل شبکه (GSCD) برای توصیف ویژگیهای زمینهای هر lixel و همسایگان آن پیشنهاد میکنیم. این توصیفگر یک محاسبات استاندارد شده برای ویژگیهای زمینهای با توجه به هر لیکسل ارائه میکند، در نتیجه تأثیر ذهنی ویژگیهای تعریفشده دستی را که در روشهای قبلی با آن مواجه میشد کاهش میدهد. متعاقباً با اشاره به معماری کلاسیک [ ۳۱]، یک شبکه عصبی کانولوشنال تک بعدی جدید (۱D-U-Net) که عملیات هایی مانند کانولوشن یک بعدی، ادغام و کانولوشن انتقالی را ترکیب می کند، برای تجزیه و تحلیل ویژگی های متنی استخراج شده لیکسل ها و اختصاص یک نوع الگو به آن ها ساخته شد. هر یک. در نهایت، لیکسل های مجاور با انواع الگوی یکسان برای خروجی نتایج تقسیم بندی نهایی ترکیب شدند. برای تأیید روش پیشنهادی، مرزهای اداری به عنوان داده های تجربی انتخاب شدند. این به این دلیل است که عوامل انسانی و طبیعی هر دو بر مورفولوژی هندسی مرزهای اداری تأثیر میگذارند، بنابراین انواع مختلفی از الگوها را برای آزمایش مؤثر روش پیشنهادی ارائه میدهند.
ادامه این مقاله به شرح زیر سازماندهی شده است. بخش ۲ مجموعه داده های تجربی و انواع الگوها را برای مرزهای اداری معرفی می کند. بخش ۳ روش تقسیم بندی پیشنهادی را با استفاده از GSCD و ۱D-U-Net شرح می دهد. بخش ۴ طرح آزمایشی و نتایج و همچنین تجزیه و تحلیل دقیق، مقایسه و بحث را ارائه می دهد. در نهایت، بخش ۵ این مطالعه را به پایان می رساند.
۲٫ مجموعه داده های تجربی و الگوهای شکل
۲٫۱٫ مجموعه داده های تجربی
در این مطالعه، دو مجموعه از داده های مرز اداری برای جنوب چین استخراج شده از یک پایگاه داده کاربری زمین ۱:۵۰۰۰۰ به ترتیب به عنوان مجموعه داده های آموزشی و آزمایشی استفاده شد ( شکل ۲ ). مجموعه داده آموزشی شامل ۱۰۲ مرز اداری، با طول کل ۹۲۷٫۷۸۱ کیلومتر و طول متوسط ۹٫۰۹۶ کیلومتر است. مجموعه داده آزمایشی شامل ۵۲ مرز اداری با طول کل ۷۸۳٫۸۵۷ کیلومتر و طول متوسط ۱۵٫۰۷۴ کیلومتر بود. مرزهای دو مجموعه داده دارای ویژگیهای مورفولوژیکی پیچیده و متنوع بود که برای تأیید اثربخشی روش پیشنهادی مناسب است.
۲٫۲٫ انواع الگوی شکل مرز اداری
انواع متعدد و ترکیبی از الگوهای شکل برای خطوط در این مطالعه گنجانده شد. برای دادههای مرز اداری، اجزا ممکن است از اشیاء طبیعی، مانند رودخانهها و خطوط ساحلی، و همچنین اشیاء انسانی، مانند جادهها و مناطق ساخته شده مشتق شوند. اجسام طبیعی معمولاً با ساختار خمشی سلسله مراتبی مشخص می شوند، در حالی که اشیاء انسان زا تمایل دارند که دارای ویژگی های مصنوعی تیز یا زاویه راست باشند. سامسونوف و یاکیمووا [ ۱۲] نشان داد که این تفاوتها در الگوهای شکل خط را میتوان در سه جنبه مفهومسازی کرد: صافی، طرحوارهسازی و نظم. درجه صافی نشان می دهد که آیا تغییر شکل در امتداد یک خط صاف است (یعنی آیا جهت مماس تغییر تدریجی دارد یا دارای یک زاویه انحراف بزرگ است). شماتیسم نشان می دهد که آیا ترکیب شکل یک خط ساده است یا اینکه شامل ساختارهای منحنی سلسله مراتبی پیچیده با اندازه های مختلف است. منظم بودن به این اشاره دارد که آیا یک شکل خط دارای ویژگی های تکراری است یا خیر.
بر اساس فضای الگوی شکل ساخته شده از این سه بعد، و همچنین ویژگی های داده های تجربی، ما الگوهای شکل مرزها را به سه نوع الگو طبقه بندی کردیم: شماتیک نامنظم صاف (SIS)، شماتیک منظم تیز (SRS)، و نامنظم تیز غیر شماتیک (SIN)، همانطور که در جدول ۱ فهرست شده است. بخش های SIS به عنوان صاف، بدون ویژگی های تکراری و ساختارهای منحنی بدون عارضه مشخص شدند و از محیط های طبیعی و مصنوعی مشتق شدند. بخشهای SRS با نظمهای متعامد تیز شبیه به خطوط کلی ساختمان مشخص میشوند که عمدتاً از محیطهای مصنوعی مشتق شدهاند. بخشهای SIN بهعنوان تیز، بدون ویژگیهای تکراری و خمیدگیهای سلسله مراتبی پیچیده در اندازههای مختلف، عمدتاً از محیط طبیعی مشخص شدند.
۳٫ روش شناسی
شکل ۳ چارچوب کلی روش پیشنهادی را نشان می دهد که شامل چهار مرحله اصلی است: تولید و برچسب گذاری لیکسل، استخراج ویژگی لیکسل، طبقه بندی و تقسیم بندی.
-
تولید و برچسبگذاری Lixel: هر مرز اداری از طریق تقسیمبندی مساوی به یک سری لیکسل تبدیل شد. نوع الگوی هر لیکسل برچسب گذاری شد.
-
استخراج ویژگی برای لیکسل ها: استخراج خودکار ویژگی های متنی برای هر لیکسل، با استفاده از GSCD.
-
طبقه بندی Lixel با استفاده از ۱D-U-Net: ساخت شبکه ۱D-U-Net برای طبقه بندی نوع الگوی هر لیکس بر اساس ویژگی های استخراج شده.
-
تقسیم بندی: به دست آوردن نتایج تقسیم بندی با ترکیب لیکسل های مجاور با همان نوع الگو.
۳٫۱٫ تولید و برچسب گذاری Lixel
شکل ۴ فرآیند تولید لیکسل و برچسب گذاری را نشان می دهد. ابتدا، هر مرز اداری به صورت دستی با توجه به ویژگی های مورفولوژیکی آن تقسیم شد. نوع الگوی هر بخش بر اساس طبقه بندی الگوی شرح داده شده در بخش ۲٫۲ طبقه بندی شد، و طبقه بندی بصری در یک مقیاس ثابت انجام شد تا تأثیر مقیاس نمایش داده ها بر تمایز الگو حذف شود. سپس مرز به یک سری لیکسل با طول ثابت تقسیم شد. توجه داشته باشید که آخرین قسمت تقسیم شده از مرز که طول از پیش تعریف شده را برآورده نمی کند، یک لیکسل در نظر گرفته می شود.
نوع الگوی هر لیکسل بر اساس نوع الگوی بخشی که به آن تعلق داشت تعیین شد. اگر یک لیکسل با چند بخش مرتبط باشد، با نوع الگوی قسمتی که دارای بیشترین طول همپوشانی است، برچسب گذاری می شود. اجازه دهید En × ۱= ⟨ه۱،ه۲, … ,هn⟩ ( n > ۱ )توالی لیکسل های یک مرز اداری را نشان می دهد. اطلاعات برچسب به عنوان داده های توالی سازماندهی شد: تیn × ۱= <تی۱،تی۲, … ,تیn>، جایی که تیمن∈ { [ ۱ , ۰ , ۰ ] , [ ۰ , ۱ , ۰ ] , [ ۰ , ۰ , ۰ , ۱ ] } ( i = ۱ , ۲ , … , n )یک بردار سه بعدی یک داغ است که نشان دهنده نوع الگوی لیکسل است همن.
۳٫۲٫ استخراج ویژگی های Lixel با استفاده از GSCD
ویژگیهای مورفولوژیکی یک lixel توسط همسایگان آن در یک محدوده مشخص (یعنی اطلاعات زمینهای) تعیین شد. در این مطالعه، ما از یک GSCD که معمولاً برای تجزیه و تحلیل شکل و تشخیص الگو استفاده میشود [ ۳۲ ] برای استخراج ویژگیهای متنی لیکسلها استفاده میکنیم. برای هر لیکسل در یک مرز اداری، GSCD به صورت زیر محاسبه شد:
-
یک شبکه منظم با مرکزیت نقطه میانی لیکسل ایجاد شد. شبکه شامل سلولهای p × p بود و لبههای سلول همیشه افقی و عمودی بودند. طول لبه های سلول به طول ثابت لیکسل ها تنظیم شد.
-
طول مرز واقع در هر سلول با تقسیم طول کل مرز در همه سلول ها شمارش و نرمال شد.
-
مقادیر نرمال شده تمام سلول ها از چپ به راست و از پایین به بالا در یک بردار ویژگی مرتب شدند که برای توصیف ویژگی های متنی lixel استفاده می شد.
شکل ۵ GSCD ها را با سلول های ۵×۵ برای سه لیکسل مختلف نشان می دهد. مقدار مقیاس خاکستری هر سلول شبکه نشان دهنده مقدار ویژگی نرمال شده است. GSCDs از سه lixels در زمینه های مختلف نیز به طور قابل توجهی متفاوت است، نشان می دهد که روش GSCD توانایی توصیف ویژگی خوبی دارد.
پس از محاسبه GSCD های همه لیکسل ها در امتداد یک مرز اداری، داده های دنباله ای را به دست آوردیم. افn × ( p × p )، با nلیکسل و ( p × p )ویژگی های بعدی، که به عنوان ورودی برای ۱D-U-Net برای طبقه بندی و تقسیم بندی الگوی بعدی استفاده می شود.
۳٫۳٫ طبقه بندی لیکسل ها با استفاده از شبکه ۱D-U
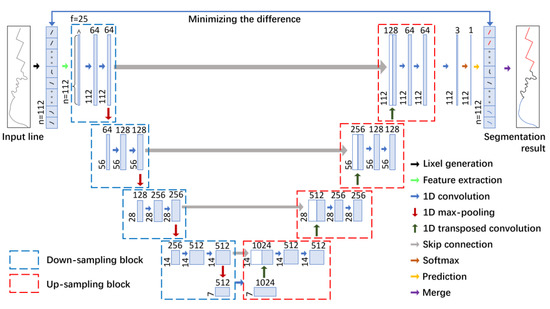
این مطالعه به U-Net کلاسیک [ ۲۱ ] برای ساخت ۱D-U-Net برای طبقه بندی الگوهای لیکسل اشاره کرد. ایده اصلی ترسیم ویژگی های ورودی بود، افn × ( p × p )، به برچسب ها، تیn × ۱، از طریق چندین عملیات کانولوشن، ادغام و نمونه برداری ۱ بعدی. شکل ۶ معماری دقیق ۱D-U-Net را نشان می دهد که از چهار بلوک نمونه برداری پایین و چهار بلوک نمونه برداری بالا تشکیل شده است. هر بلوک نمونه برداری شامل دو کانولوشن ۱ بعدی و یک تجمع حداکثری بود. هر بلوک نمونه برداری شامل یک اتصال پرش، یک پیچیدگی انتقالی ۱ بعدی و دو پیچش ۱ بعدی بود. آخرین لایه شامل یک پیچیدگی ۱ بعدی و یک تابع فعال سازی softmax بود که هر بردار ویژگی را در یک بردار برچسب نگاشت می کرد.
بخش های زیر عملیات انجام شده بر روی داده های توالی برای لیکسل های مورد استفاده در این مدل را تشریح کردند.
۳٫۳٫۱٫ عملیات پیچیدگی و ادغام یک بعدی
عملیات پیچیدگی و ادغام یک بعدی برای استخراج ویژگی های چند مقیاسی سطح بالا برای طبقه بندی الگوی لیکسل از ویژگی های کم عمق GSCD لیکسل ها استفاده شد. عملیات کانولوشن داده های محلی را در یک پنجره از طریق یک هسته کشویی پردازش می کند و ویژگی های جدیدی را با استفاده از یک تابع فعال سازی غیرخطی ایجاد می کند. یک سکانس، ایکس= {ایکس۱،ایکس۲, … ,ایکسn}، با استفاده از یک هسته پیچیده شد، k = {w1،w2, … ,wل۱}، با اندازه پنجره ل۱برای تولید یک دنباله جدید، سی. هر ویژگی، جمن، که در سیبه صورت زیر محاسبه شد:
جایی که f( ⋅ )نشان دهنده تابع فعال سازی غیرخطی یکسان سازی شده واحد خطی (ReLU) و بنشان دهنده تعصب است. دنباله تولید شده به صورت نشان داده می شود سی= {ج۱،ج۲, … ,جfمن یا آر [ _n + ۲ ∗د۱–ل۱س۱] +۱}، جایی که fمن [ ⋅ ] _ _ _بزرگترین تابع عدد صحیح است، د۱عرض بالشتک است و س۱طول گام پنجره است.
عملیات ادغام با نمایش چندین ویژگی در یک پنجره محلی بهعنوان یک ویژگی، ویژگیهای درشتتری را بهدست آورد، که منجر به کاهش پارامترها، تسریع محاسبات، و جلوگیری از برازش بیشازحد شد، در نتیجه ویژگیها و توانایی تعمیم مدل را بهبود بخشید. در این مطالعه از حداکثر ادغام استفاده شد. برای چندین ویژگی، سی( i − ۱ ) ∗س۲+ ۱ : ( i − ۱ ) ∗س۲+ل۲، با اندازه پنجره ل۲، حداکثر مقدار به عنوان ویژگی خروجی اعمال شد که به صورت زیر بیان می شود:
جایی که س۲طول گام پنجره است. دنباله تولید شده را می توان به صورت بیان کرد پ= {پ۱،پ۲, … ,پfمن یا آر [ _n –ل۲s ۲] +۱}.
شکل ۷ نمونه ای از عملیات کانولوشن و ادغام را نشان می دهد که در آن اندازه پنجره وجود دارد ل۱از هسته سه و اندازه پنجره بود ل۲از جمع دو نفر بود. یک سکانس سیبا اندازه n و دنباله پبا اندازه n /۲ به ترتیب پس از عملیات کانولوشن و حداکثر ادغام به دست آمد.
۳٫۳٫۲٫ عملیات نمونه برداری تک بعدی و اتصال پرش
عملیات ادغام اندازه ویژگی های ورودی را تغییر داد. عملیات upsampling، اجرا شده در طول کانولوشن انتقال، برای بازگرداندن اندازه ویژگی به اندازه ورودی اصلی استفاده شد.
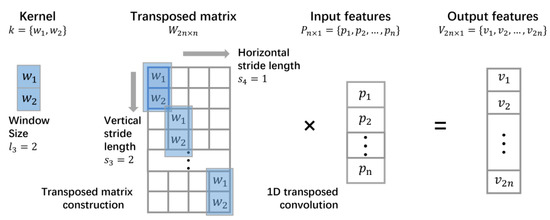
گام کلیدی در پیچیدگی جابجایی، ساختن یک ماتریس انتقالی بود. دبلیوو آن را با بردار ویژگی ضرب کنید، پ. برای ویژگی های ورودی، پ، با اندازه n × ۱، ماتریس جابجا شده، دبلیو، با لغزش یک هسته کانولوشن به دست آمد، k = {w1،w2, … ,wل۳}، با اندازه پنجره ل۳ nبار، که در آن طول گام عمودی کشویی بود س۳و طول گام افقی س۴۱٫ ماتریس جابجا شده بود دبلیومحاسبه شد:
جایی که i = { ۱ ، ۲ ، … ،س۳∗ ( n − ۱ ) +ل۳}و j = { ۱ , ۲ , … , n }به ترتیب تعداد سطرها و ستون ها را نشان می دهد. عملیات کانولوشن انتقال یافته را می توان بیان کرد:
جایی که دبلیو(س۳∗ ( n − ۱ ) +ل۳) × nنشان دهنده ماتریس جابجا شده و V(س۳∗ ( n − ۱ ) +ل۳) × ۱ویژگی های خروجی را نشان می دهد.
شکل ۸ نمونه ای از عملیات پیچش جابجا شده را نشان می دهد که در آن طول گام عمودی است س۳دو و عرض هسته پیچیدگی بود ل۳دو بود اندازه ماتریس پیچیدگی جابجا شده، دبلیو، ۲ n × n است و بنابراین یک بردار ویژگی جدید است، V، با اندازه ۲ n × ۱ به دست می آید.
توجه میکنیم که عملیات ادغام و نمونهبرداری ممکن است اطلاعات مکان مکانی مهم را از ویژگیهای ورودی اصلی حذف کند. برای کاهش این مشکل، یک عملیات اتصال پرش بین کانولوشن ۱-D و کانولوشن انتقال یافته ۱-D قرار داده شد. همانطور که در شکل ۶ نشان داده شده است، بردارهای ویژگی خروجی پس از پیچیدگی ۱ بعدی به بردارهای ویژگی پس از پیچیدگی ۱ بعدی با همان تعداد کانال متصل شدند. سپس، مقادیر هر عنصر در بردار ویژگی با استفاده از عملیات کانولوشن برای بازیابی تعداد کانال ها تصحیح شد.
۳٫۳٫۳٫ تعریف تابع ضرر
پس از پردازش کانولوشن در لایه نهایی، یک دنباله به طول دنباله ورودی خروجی شد. تعداد کانال های آن ۳ بود که مربوط به سه نوع الگو بود. در نهایت، تابع softmax برای فعال کردن ویژگی های خروجی برای به دست آوردن احتمالات پیش بینی شده به کار گرفته شد. برای من-ام ( من=۱،۲،…،n) لیکسل دنباله خروجی، احتمال (آمن)j( j=1،۲،۳) که متعلق به jنوع الگوی -ام به صورت زیر محاسبه شد:
جایی که zjنشان دهنده ویژگی کانال j- ام لیکسل است. بردار احتمال خروجی، آمن=〈(آمن)۱،(آمن)۲،(آمن)۳〉، برای من-ام لیکسل راضی است ∑j=13(آمن)j=1. نوع الگوی با بیشترین احتمال الگوی پیش بینی شده برای این لیکسل در نظر گرفته شد.
فرآیند آموزش تفاوت ها (یعنی ارزش ضرر، E) بین بردارهای احتمال پیش بینی شده به حداقل برسد، آ۱،آ۲،…،آnو برچسب گذاری بردارهای تک داغ، تی۱،تی۲،…،تیn، جایی که n تعداد لیکسل ها بود. در این مطالعه از تابع آنتروپی متقاطع برای اندازه گیری تفاوت استفاده شد که به صورت زیر بیان می شود:
هر چه ارزش زیان کمتر باشد، E، پیش بینی ها به برچسب ها نزدیک تر بود. در اینجا، ۱D-U-Net با استفاده از یک الگوریتم پس انتشار آموزش داده شد. در طول آموزش، مقدار پیشبینیشده برای هر دسته کوچک از دادهها از طریق انتشار رو به جلو بهدست آمد و مقدار تلفات محاسبه شد. سپس پارامترهای قابل آموزش با توجه به نرخ یادگیری و مشتقات جزئی هر پارامتر نسبت به مقدار تلفات به تدریج به روز شدند.
۳٫۴٫ به دست آوردن نتایج تقسیم بندی
۱D-U-Net آموزش دیده برای پیش بینی انواع الگوی همه لیکسل ها در امتداد یک مرز اداری استفاده شد. سپس بخش های همگن با ادغام لیکسل های مجاور با انواع الگوی یکسان به دست آمد. با این حال، پیشبینیهایی برای چند لیکسل وجود داشت که نادرست بود، که منجر به ایجاد بخشهای بسیار کوتاه پس از عملیات ادغام شد. از آنجایی که این بخش های کوتاه با نتایج تقسیم بندی تداخل داشتند، پس پردازش برای حذف آنها مورد نیاز بود. در این مطالعه از روش همجوشی تکراری استفاده شد. همانطور که در شکل ۹ نشان داده شده است ، پس پردازش به صورت زیر اجرا شد:
-
نتایج تقسیم بندی مرز اداری طی شد و بخش zمنبا کمترین طول مشخص شد.
-
اگر طول از zمنکوچکتر از آستانه از پیش تعریف شده بود اس، zمنبا همسایه خود با طول بیشتر ادغام شد.
-
مراحل (۱) و (۲) تکرار شد تا جایی که هیچ بخش کوچکتر از آن وجود نداشت اس.
۴٫ آزمایشات
GSCD برای استخراج خودکار ویژگیها برای لیکسلها بهعنوان یک افزونه ArcMap (مؤسسه تحقیقات سیستمهای محیطی، Redlands، CA، ایالات متحده) با C# پیادهسازی شد، و ۱D-U-Net ساختهشده برای طبقهبندی لیکسلها با پایتون در TensorFlow پیادهسازی شد. این بخش طراحی آزمایشی، عملکرد طبقهبندی لیکسل، نتایج و تجزیه و تحلیل بخشبندی خط، و بحث در مورد حساسیتهای پارامتر را ارائه میکند.
۴٫۱٫ طراحی تجربی
۴٫۱٫۱٫ نمونه تولید مجموعه داده
برای تولید نمونه ها، دو داوطلب با دانش تخصصی به طور مستقل مرزهای اداری را در مجموعه داده های آموزشی و آزمایشی بر اساس معیارهای فهرست شده در جدول ۱ تقسیم کردند. اگر نتایج تقسیمبندی دو داوطلب متفاوت بود، داوطلب سوم با تجربه نقشهبرداری گسترده دوباره بررسی کرد و تصمیم نهایی را گرفت. برای اطمینان از سازگاری جزئیات نقشهبرداری، مقیاس نمایش هنگام تقسیمبندی مرزها در مقیاس داده (یعنی ۱:۵۰۰۰۰) ثابت شد. سپس، هر مرز، همانطور که در بخش ۳٫۱ توضیح داده شد، به یک سری لیکسل تقسیم شد . تنظیم اندازه لیکسل برای درک الگوهای خط بسیار مهم است [ ۳۳ ، ۳۴]. در این مطالعه حاضر، با اشاره به مفهوم کوچکترین جسم بصری (SVO) که در کار لی و اوپنشاو [ ۳۳ ] مورد بحث قرار گرفت و بررسی های مقایسه ای آنها بر روی تنظیمات اندازه این پارامتر، طول هر لیکسل به میزان تعیین شد. ۰٫۵ میلی متر (فاصله نقشه)، مربوط به فاصله زمین ۲۵ متر در مقیاس ۱:۵۰۰۰۰٫ در نتیجه، به ترتیب ۳۷۲۳۵ و ۳۱۴۲۵ لیکسل برای مجموعه داده های آموزشی و آزمایشی وجود داشت.
برای آموزش کامل مدل طبقهبندی لیکسل، از دو روش افزایش دادهها برای افزایش حجم نمونه مجموعه داده آموزشی استفاده شد. همانطور که در شکل ۱۰ نشان داده شده است، هر مرز اداری ابتدا هر ۳۰ درجه چرخانده شد. حجم نمونه ۱۱ برابر افزایش یافت. در مرحله بعد، روش پنجره کشویی را اجرا کردیم، یک پنجره ثابت با اندازه ۱۱۲ لیکسل در امتداد هر مرز در مراحل ۳۰ لیکسل لغزانید. همانطور که در شکل ۱۰ ب نشان داده شده است، هر اسلاید پنجره یک نمونه به دست می دهد. بنابراین، نمونه های متعدد با همپوشانی جزئی از یک مرز اداری به دست آمد. از طریق افزایش داده ها، ۹۴۳۲ نمونه آموزشی به دست آمد.
برای مجموعه داده آزمایشی، تقویت داده ها اعمال نشد و دنباله لیکسل هر مرز اداری به نمونه هایی با طول ۱۱۲ لیکس تقسیم شد. اگر آخرین نمونه به طول مورد نیاز نمی رسید، صفرها اضافه می شدند. در نهایت ۳۰۸ نمونه آزمایش به دست آمد.
۴٫۱٫۲٫ تنظیمات پارامتر
پس از آمادهسازی تمام نمونهها، ویژگیهای متنی هر لیکسل با استفاده از GSCD محاسبه شد. شبکهای از سلولهای ۵×۵ برای ساخت GSCD در آزمایشها استفاده شد. بنابراین، هر لیکسل با استفاده از ویژگی های ۲۵ بعدی توصیف شد. این مدل با استفاده از بهینه ساز Adam برای ۵۰ دوره، با نرخ یادگیری ۰٫۰۰۰۱ آموزش داده شد.
دو روش تقسیم بندی موجود مبتنی بر یادگیری ماشین برای مقایسه اجرا شد. شبکه عصبی مصنوعی پس انتشار (BANN) [ ۱۶ ، ۱۷ ] و روش های بیزی ساده (NB) [ ۱۸ ]. هر دو روش از روش پنجره کشویی برای تولید نمونه از مرزهای اداری استفاده کردند. مرحله کلیدی این بود که مرزهای اداری را با توجه به پنجره با اندازه ثابت که با افزایش طول مشخصی حرکت می کرد، برید. با اشاره به تنظیمات پارامتر تجربی مورد بحث در ادبیات [ ۱۷ ، ۱۸]، اندازه پنجره و طول افزایش به ترتیب ۱۵۰۰ و ۱۵۰ متر تعیین شد. ده ویژگی برای توصیف ساختارهای مورفولوژیکی نمونهها شامل طول قطعه و نسبت طول خط پایه، میانگین طول خم، فاصله عمودی میانه از هر نقطه تا خط پایه، ضریب واریانس طول خط پایه خم، ضریب واریانس استخراج شد. از طول خم و نسبت طول خط مبنا، فاصله میانه بین دو نقطه پیوسته، ضریب واریانس سطح خم و نسبت طول خط پایه مربع، نسبت متوسط طول خم به طول خط پایه، بعد فراکتال و میانگین زوایای چرخش. برای اطلاعات بیشتر در مورد تعاریف و محاسبات این ویژگی ها، لطفاً به آثار آریزا لوپز و بالبوآ مراجعه کنید [ ۱۶ ، ۱۷ ]] و لیو و همکاران. [ ۱۸ ]. بر اساس تجزیه و تحلیل مؤلفه های اصلی (PCA)، هفت ویژگی با مجموع اطلاعات بیشتر از ۹۰ درصد به عنوان ورودی برای مدل های BANN و NB استفاده شد. تعداد نورون ها در لایه پنهان BANN روی ۱۵ تنظیم شد و از تابع فعال سازی ReLU استفاده شد. برای روش NB از مدل گاوسی استفاده شد.
۴٫۲٫ عملکرد طبقه بندی Lixel با استفاده از ۱D-U-Net
شکل ۱۱ دقت و مقادیر تلفات ۱D-U-Net را برای طبقه بندی لیکسل در طول مرحله آموزش نشان می دهد. دقت طبقه بندی و از دست دادن تمرین در طول پنج دور اول به سرعت تغییر کرد، به تدریج پس از ده دوره تثبیت شد و پس از ۵۰ دوره به اوج رسید. پس از همگرایی آموزش، دقت طبقه بندی مدل در مجموعه آموزشی به ۹۹٫۰۴ درصد رسید. متعاقباً از مدل آموزشدیده برای طبقهبندی لیکسلها در نمونههای آزمایشی با دقت طبقهبندی ۹۰٫۴۲ درصد استفاده شد. این نتیجه نشان می دهد که ۱D-U-Net می تواند انواع الگوی لیکسل ها را با دقت بالا طبقه بندی کند.
دقت ، یادآوری ، و اف۱– امتیاز برای ارزیابی کمی نتایج طبقه بندی استفاده شد. برای هر نوع الگو، سه معیار به صورت زیر تعریف می شود:
جایی که تیپnتومترتعداد لیکسلهایی را نشان میدهد که هم بهطور خودکار پیشبینی شدهاند و هم بهصورت دستی با یک نوع الگو برچسبگذاری شدهاند. افپnتومترتعداد لیکسل هایی است که به طور خودکار از این نوع الگو پیش بینی شده بود اما به صورت دستی به عنوان یک نوع الگوی متفاوت شناسایی شدند. و افنnتومترتعداد لیکسل هایی را نشان می دهد که به صورت دستی به عنوان این نوع الگو شناسایی شده اند اما به اشتباه به عنوان انواع الگوهای مختلف پیش بینی شده اند.
جدول ۲ ماتریس سردرگمی نتایج طبقهبندی lixel را برای نمونههای آزمایشی با استفاده از مدل آموزشدیده و سه معیار فهرست میکند. این اف۱– ارزش امتیاز برای الگوی SIN به ۰٫۹۶ رسید در حالی که اف۱– مقادیر امتیاز برای الگوهای SIS و SRS کمی پایین تر، به ترتیب ۰٫۹۰ و ۰٫۸۸ بود. این به این دلیل است که طبقهبندی اشتباه عمدتاً بین لیکسلهای SIS و SRS رخ داده است. به طور کلی، مدل پیشنهادی میتواند ویژگیهای زمینهای شکلها را استخراج کند و به طبقهبندی لیکسل برای مرزهای آزمون با دقت نسبتاً بالایی دست یابد.
۴٫۳٫ ارزیابی نتیجه تقسیم بندی
۴٫۳٫۱٫ ارزیابی کیفی
بر اساس نتایج طبقهبندی، بخشهای همگن با ادغام لیکسلهای مجاور با انواع الگوی یکسان به دست آمد. برای مقایسه منصفانهتر، روش همجوشی تکراری نیز در روشهای BANN و NB پس از طبقهبندی هر افزایش استفاده شد. در هر سه روش، آستانه طول اسبرای بخش کوتاهی که نیاز به ادغام داشت روی ۹۰۰ متر تنظیم شد (یعنی ۳۶ لیکس در روش پیشنهادی و شش افزایش در روشهای BANN و NB). شکل ۱۲ نتایج تقسیم بندی مرزهای آزمون را با استفاده از روش های مختلف نشان می دهد.
هر سه روش در تقسیم بندی مرزهای آزمون به خوبی عمل کردند. با استفاده از روش همجوشی تکراری، بسیاری از بخش های کوتاه حذف شدند و نتایج تقسیم بندی منسجم تر شد. مقایسه دقیق نشان داد که روش پیشنهادی نسبت به روشهای BANN و NB دارای خطاهای تقسیمبندی کمتری است. به عنوان مثال، بخش مشخص شده با بیضی سبز در شکل ۱۲ a به صورت دستی به عنوان یک الگوی SRS برچسب گذاری شد، اما هر دو روش BANN و NB به اشتباه آن را به عنوان SIS یا SIN پیش بینی کردند. تنها نتایج روش پیشنهادی با برچسبگذاری دستی مطابقت داشت.
شکل ۱۳ تفاوتهای بین نتایج دستی و پیشبینیشده را بر اساس روشهای مختلف نشان میدهد، که در آن پیشبینیهایی که با نتایج دستی مطابقت دارند به رنگ خاکستری ارائه میشوند در حالی که نتایج رنگی نشاندهنده نتایج ناسازگار است. در نتایج روش پیشنهادی، بخشهای ناسازگار کمتری نسبت به دو روش دیگر وجود داشت. طول بخشهای ناسازگار در نتایج روش پیشنهادی ۵۹٫۵ کیلومتر بود در حالی که روشهای BANN و NB به ترتیب مجموعاً ۱۶۷٫۶۴ و ۱۸۴٫۱۸ کیلومتر قطعه ناسازگار تولید کردند.
تقسیم بندی ناسازگار را می توان به دو دسته تقسیم کرد. طبقه اول با بخش های ناسازگار که کوتاه هستند مشخص می شود. این نوع ناسازگاری با انحراف در نقاط قطعه ایجاد شد. انحرافات در محدوده معینی تأثیر ناچیزی بر تحلیلهای بعدی داشت. نمونههای دسته دوم شامل بخشهای طولانی ناسازگار بود که به دلیل طبقهبندی نادرست انواع الگوها ایجاد میشد. همانطور که در شکل ۱۳ نشان داده شده است ، هر دو دسته ناسازگاری در نتایج به دست آمده توسط روش های BANN و NB به طور قابل توجهی بیشتر از روش پیشنهادی بود.
برای بررسی بیشتر دو دسته ناسازگاری که در نتایج تقسیمبندی با استفاده از روشهای مختلف رخ داده است، ناسازگاریها را در چهار مرز معمولی، همانطور که در شکل ۱۴ نشان داده شده است، تجزیه و تحلیل کردیم.. انحراف در نقاط تقسیمبندی عمدتاً در اتصالات بخشهای SIS و SRS رخ داده است. از نظر طبقهبندی نادرست، شناسایی بخشهای SRS بدترین عملکرد را بهویژه در نتایج روشهای BANN و NB ایجاد کرد. خطوط با الگوهای SRS ممکن است دارای بخشهای مستقیم طولانی در هر دو طرف باشند یا ممکن است خمیدگیهای متوالی را نشان دهند. در مورد اول، ویژگیهای محلی مشابه خطوط SIS در مناطق با شیب ملایم است، در حالی که در مورد دوم، خطوط SRS و SIN شباهت کلی را نشان میدهند. به طور کلی، شناسایی دقیق بخشهای SRS نیازمند درک ویژگیهای محلی و جهانی خطوط است.
۴٫۳٫۲٫ ارزیابی کمی
نسبت سازگاری (CR) متریک برای تجزیه و تحلیل کمی عملکرد بخشبندی روشهای مختلف تعریف شد. برای نوع الگوی i- ام،سیآرمنمتریک به صورت زیر محاسبه شد:
جایی که Lجمنو Lتیمنطول کل قطعاتی را که بهترتیب بهعنوان نوع الگوی i- ام و طول کل قطعات برچسبگذاری شده به عنوان نوع الگوی i- ام به درستی شناسایی شدهاند، نشان میدهند. CR کلی (OCR) به صورت زیر محاسبه شد:
جایی که Lتیطول کل تمام مرزهای آزمون را نشان می دهد. جدول ۳ معیارهای CR و OCR را برای نتایج تقسیم بندی به دست آمده با استفاده از روش های مختلف فهرست می کند. OCR روش ۱D-U-Net به ۹۲٫۴۱ درصد رسید که بالاتر از هر یک از دو روش موجود بود. علاوه بر این، شناسایی بخشهای SIN بالاترین CR را داشت که با استفاده از هر سه روش به ۹۷ درصد رسید. در مقابل، سه روش هر کدام کمترین CR را برای بخشهای SRS داشتند، با CR برای دو روش موجود که کمتر از ۶۰٪ بودند. CR روش پیشنهادی به ۹۰٪ نزدیک شد. به طور کلی، روش پیشنهادی بهترین عملکرد بخشبندی را از نظر معیارهای CR و OCR نشان داد. در شناسایی بخشهای SRS در مقایسه با روشهای سنتی BANN و NB سودمند بود.
۴٫۴٫ بحث
همانطور که قبلا ذکر شد، GSCD میتواند ویژگیهای زمینهای محلی هر lixel را به تصویر بکشد و تأثیر ذهنی ویژگیهای مصنوعی تعریفشده را کاهش دهد. با این حال، اندازه شبکه (یعنی تعداد سلول ها) تأثیر قابل توجهی بر استخراج ویژگی لیکسل داشت و ممکن است بر عملکرد تقسیم بندی تأثیر بگذارد. برای توصیفگرها با اندازه های شبکه متفاوت، ویژگی های استخراج شده متفاوت است ( شکل ۱۵ ).
برای بحث در مورد حساسیت روش پیشنهادی به اندازه GSCD، آزمایشی با تغییر اندازه شبکه از ۳ × ۳ تا ۷ × ۷ انجام شد. جدول ۴ دقت طبقه بندی lixel را فهرست می کند. با افزایش اندازه شبکه، دقت طبقه بندی لیکسل مدل در ابتدا افزایش و سپس کاهش یافت. این مدل زمانی بهترین عملکرد را داشت که اندازه سلول شبکه ۵ × ۵ بود. یک دلیل احتمالی برای این نتیجه این است که با افزایش تعداد سلول ها از ۳ × ۳، میدان پذیرنده به تدریج افزایش یافت. بنابراین، ویژگیهای زمینهای لیکسلها غنیتر شد و در نتیجه عملکرد طبقهبندی بهبود یافت. با این حال، زمانی که اندازه شبکه بزرگتر از ۵ × ۵ بود، بسیاری از ویژگی ها صفر بودند ( شکل ۱۵ج) و اطلاعات متنی ممکن است توسط مرزهای مسافت طولانی مختل شده باشد، بنابراین منجر به تنزل عملکرد طبقه بندی می شود.
۵٫ نتیجه گیری و چشم انداز
این مطالعه یک رویکرد یادگیری عمیق جدید را برای تشخیص الگو و تقسیمبندی مرزهای اداری، بر اساس ۱D-U-Net پیشنهاد کرد. در این مدل، یک لیکسل به عنوان واحد پردازش پایه و از یک GSCD برای استخراج ویژگی های توصیفی هر لیکسل استفاده شد. پس از آن، یک معماری ۱D-U-Net برای پیش بینی انواع الگوی لیکسل ها ساخته شد. در نهایت، نتایج پیشبینیشده به طور مکرر برای به دست آوردن نتایج تقسیمبندی نهایی برای مرزهای اداری ترکیب شدند. نتایج تجربی نشان داد که دقت طبقهبندی لیکسل ۱D-U-Net به ۹۰٫۴۲ درصد برای مرزهای اداری آزمون رسیده است. OCR نتایج تقسیمبندی برای نمونههای آزمایشی ۹۲٫۴۱ درصد بود که بالاتر از روشهای تقسیمبندی مبتنی بر BANN و NB بود.
بر خلاف روش های موجود، روش پیشنهادی از تقسیم بندی تصویر مشتق شده است. با نمایش دادههای مبتنی بر برداری بدون ساختار به عنوان دادههای توالی مبتنی بر لیکسل، مسئله تقسیمبندی خط را به طبقهبندی لیکسل تبدیل میکند. علاوه بر این، GSCD ابزار امیدوارکننده ای برای توصیف اطلاعات متنی محلی در لیکسل ها فراهم می کند. این دو مزیت به روش پیشنهادی اجازه میدهد تا به طور موثر ویژگیهای شکل یک خط را شناسایی کند، که به طور قابل توجهی عملکرد بخشبندی را بهبود میبخشد. مطالعات بعدی باید بر جنبه های خاصی متمرکز شود. این روش باید در سایر خطوط جغرافیایی مانند خطوط ساحلی، رودخانه ها و جاده ها اعمال شود. بهینه سازی مدل و تنظیمات پارامتر برای روش، مانند اندازه لیکسل، باید بیشتر مورد بررسی قرار گیرد.