تأثیر تراکم داده ها و ادغام بر نقشه برداری پوشش تاج جنگل با استفاده از سری های زمانی Sentinel-1 و Sentinel-2 در جنگل های بلوط مدیترانه ای


چکیده

پوشش تاج جنگل (FCC) یکی از مهم ترین پارامترهای موجودی جنگل است و نقش مهمی در ارزیابی عملکرد جنگل ایفا می کند. این مطالعه پتانسیل ادغام داده‌های Sentinel-1 (S-1) و Sentinel-2 (S-2) را برای نقشه‌برداری FCC در جنگل‌های بلوط مدیترانه‌ای ناهمگون غرب ایران در تراکم‌های داده‌های مختلف (مجموعه داده‌های یک ساله در مقابل سه-سال) بررسی می‌کند. مجموعه داده های سال). این مطالعه از تصاویر ماهواره‌ای با وضوح بسیار بالا از Google Earth، نقاط شبکه‌بندی شده و نمودارهای موجودی میدانی برای تولید یک مجموعه داده مرجع استفاده کرد. بر اساس آن، چهار کلاس FCC تعریف شد، یعنی غیر جنگل، جنگل کم (FCC = 1-30٪)، جنگل با تراکم متوسط ​​(FCC = 31-60٪)، و جنگل متراکم (FCC> 60٪). در این مطالعه، سه مدل یادگیری ماشین (ML) شامل جنگل تصادفی (RF)، ماشین بردار پشتیبان (SVM)، و طبقه بندی و درخت رگرسیون (CART)، در موتور Google Earth استفاده شد و عملکرد آنها برای طبقه بندی مقایسه شد. نتایج نشان داد که SVM بالاترین دقت را در نقشه برداری FCC ایجاد می کند. سری زمانی سه ساله توانایی همه مدل‌های ML را برای طبقه‌بندی کلاس‌های FCC، به‌ویژه کلاس جنگل‌های پراکنده، که با مجموعه داده‌های یک ساله به خوبی متمایز نشد، افزایش داد. نتایج ارزیابی دقت در سطح کلاس افزایش قابل توجهی را در امتیازات F-1 برای طبقه‌بندی جنگل‌های پراکنده با ادغام S-1 و S-2 نشان داد (به ترتیب ۱۰٫۴ تا ۱۸٫۲ درصد افزایش برای مدل‌های CART و SVM ML). در نتیجه، استفاده هم افزایی از معیارهای زمانی طیفی S-1 و S-2 دقت طبقه بندی را در مقایسه با آنچه که تنها با استفاده از S-2 به دست آمده بود، بهبود بخشید.

کلید واژه ها:

پوشش تاج پوشش جنگل ; موتور گوگل ارث ؛ یادگیری ماشینی ؛ جنگل تصادفی ; ماشین بردار پشتیبانی ; درخت طبقه بندی و رگرسیون ; سری زمانی سنتینل ; کوئرکوس برانتی ; ایران

۱٫ مقدمه

سیستم‌های پایش جنگل‌های مؤثر به روش‌ها و ابزارهای جدید و سازمان‌یافته برای ارائه داده‌های به‌روز و قابل اعتماد در مورد جنگل‌ها نیاز دارند [ ۱ ، ۲ ]. توسعه تکنیک‌های سنجش از دور و پردازش تصویر، نقشه‌برداری خودکار، مقرون‌به‌صرفه، با کیفیت بالا، فضایی پیوسته و صرفه‌جویی در منابع ویژگی‌های جنگل [ ۳ ، ۴ ، ۵ ] را در مقیاس‌های فضایی مختلف [ ۶ ] ممکن کرده است.
پوشش تاج پوشش جنگل (FCC) یکی از مهم ترین پارامترهای موجودی جنگل است و نقش مهمی در ارزیابی عملکرد جنگل ایفا می کند [ ۷ ، ۸ ]. به عنوان مثال، FCC اغلب به عنوان یک متغیر توضیحی در چرخه آب [ ۹ ، ۱۰ ، ۱۱ ]، ارزیابی فرسایش خاک [ ۱۲ ، ۱۳ ]، زیستگاه حیات وحش [ ۱۴ ، ۱۵ ]، بازسازی جنگل و بقای درختان و جنگل ها [ ۱۶ ] استفاده می شود. ، ۱۷ ]، ساختار جنگل [ ۱۸ ، ۱۹ ]، ارزیابی خطر آتش سوزی جنگلی [ ۲۰ ، ۲۱] و تصفیه هوا [۲۲ ، ۲۳ ]. این به این دلیل است که FCC با کاهش تأثیر قطرات باران بر سطوح بایر، فرسایش خاک را کاهش می دهد [ ۱۰ ]. علاوه بر این، کاهش FCC در دسترس بودن نور زیر طبقه را برای بازسازی جنگل افزایش می دهد [ ۱۹ ]. از زمانی که چنین فناوری‌هایی در دسترس قرار گرفتند، تکنیک‌ها و داده‌های سنجش از راه دور مختلفی برای نقشه‌برداری FCC استفاده شده‌اند [ ۲۴ ، ۲۵ ، ۲۶ ]]. به طور کلی، نقشه برداری FCC با استفاده از مجموعه داده های مشاهده زمین (مجموعه داده های مرجع) به دلیل تفکیک پذیری کم بین طبقاتی و امضاهای طیفی مشابه پیچیده است. علاوه بر این، نقشه برداری FCC در مقیاس بزرگ به تعداد کافی نمونه آموزشی و اعتبارسنجی نیاز دارد. در مطالعات قبلی، این نمونه معمولاً در طول موجودی های میدانی جمع آوری می شد که بسیار وقت گیر و پرهزینه است [ ۲۷ ، ۲۸ ، ۲۹ ]. بنابراین، افزایش نقشه برداری FCC در دهه های اخیر موضوع مورد علاقه سنجش از دور و جنگلداری باقی مانده است. آنچانگ و همکاران [ ۳۰] از نمودارهای موجودی جنگل، تصاویر ماهواره‌ای VHR Google Earth و سری‌های زمانی Sentinel-1 و -۲ استفاده کرد و گزارش داد که روش آن‌ها قادر به ترسیم پوشش تاج پوشش چوب (WCC) به ۱۰ کلاس با خطای کم (RMSE = 8٪) بود. Arumae و Lang [ ۳۱ ] از داده‌های اسکن لیزری هوابرد (ALS) و عکاسی نیم‌کره‌ای برای تولید یک مدل FCC مبتنی بر ALS استفاده کردند. آنها همچنین تأثیر آستانه های ارتفاع متفاوت و زوایای اسکن بر تخمین FCC را بررسی کردند. بر اساس نتایج آنها، بهترین مدل با استفاده از تمام اکوها و شکست ارتفاع ۱٫۳ متر (R .= ۰٫۸۱; RMSE = 11.8٪. اگرچه مطالعات قبلی تلاش کرده‌اند تا روش‌های مؤثری را برای استفاده از داده‌های سنجش از دور ایجاد کنند، اما چالش‌های زیادی در رابطه با نقشه‌برداری FCC در مقیاس بزرگ وجود دارد. برای مثال، اکثر مطالعات قبلی در سایت‌های کوچک (مقیاس محلی) انجام شده‌اند [ ۳۲ ، ۳۳ ]، و برخی نشان داده‌اند که سری‌های زمانی و تکنیک‌های پردازش تصویر چند سنسوری، نقشه‌برداری FCC را با دقت بالاتری در مقایسه با تصاویر تک‌تاریخ فعال می‌کنند [ ۳۴ ] ، ۳۵ ]. با این حال، بیشتر آنها از تصاویر ماهواره‌ای تک تاریخ یا تک منبع استفاده می‌کردند، زیرا با محدودیت‌های متعددی مانند ظرفیت ذخیره‌سازی داده‌ها و قدرت محاسباتی کم مواجه بودند [ ۳۶ ، ۳۷ ]]. علاوه بر این، مطالعات قبلی نقشه برداری FCC با تصاویر ماهواره ای بدون ابر یا تقریباً بدون ابر انجام شد. آنها اغلب با مجموعه داده هایی با چگالی کم مواجه بودند، به خصوص در مناطقی که دارای ابرهای زیادی بودند.
به لطف ظهور پلتفرم‌های رایانش ابری متخصص در سنجش از دور، مانند موتور Google Earth (GEE)، تجزیه و تحلیل تعداد زیادی از تصاویر ماهواره‌ای مؤثرتر شده است [ ۳۸ ، ۳۹ ]. روش‌های جدید پردازش تصویر سری‌های زمانی، ادغام تمام مقادیر بازتاب بدون ابر از همه تصاویر در طول یک دوره و تولید معیارهای طیفی-زمانی قابل اجرا برای راه‌حل‌های نقشه‌برداری و مدل‌سازی را آسان‌تر کرد [ ۴۰ ]. ثابت شده است که تصاویر ماهواره‌ای رایگان در دسترس، مانند آن‌هایی که از حسگرهای سنتینل آژانس فضایی اروپا (ESA) به دست می‌آیند، مقرون به صرفه، به موقع و آسان برای ادغام منابع داده هستند و اغلب برای نقشه‌برداری FCC استفاده می‌شوند [ ۴۰ , ۴۱ ]]. سیستم Sentinel-1 (S-1) از صورت فلکی دو ماهواره تشکیل شده است که داده های رادار دهانه مصنوعی باند C (SAR) را در چهار حالت اکتساب با زمان بازبینی ۶ روز ارائه می کنند [ ۴۲ ]. ماهواره‌های نوری Sentinel-2 (S-2) داده‌های با وضوح زمانی بالا را با زمان بازبینی ۵ روز جمع‌آوری می‌کنند که با یک پیکربندی طیفی غنی که شامل ۱۳ باند طیفی است [ ۴۳ ، ۴۴ ]. مطالعات قبلی گزارش کردند که ادغام تصاویر S-1 و S-2 دقت طبقه‌بندی کلاس‌های کاربری و پوشش زمین (LULC) را در مقایسه با نتایج به‌دست‌آمده تنها با داده‌های S-1 یا S-2 بهبود می‌بخشد [ ۴۵ ، ۴۶ ]]. دلیل آن این است که سیگنال رادار به هندسه حساس است (به عنوان مثال، زبری، بافت، و ساختار داخلی)، و فیزیولوژی آنها بر بازتاب نوری تأثیر می گذارد [ ۴۷ ]. با این حال، اثرات ادغام سری های زمانی S-1 و S-2 بر روی نقشه برداری کلاس های FCC به خوبی مورد مطالعه قرار نگرفته است، و شکاف تحقیقاتی قابل توجهی در ارزیابی اینکه چگونه این یکپارچگی می تواند نتایج بهتری را در نگاشت کلاس های FCC با سطح بالا ارائه دهد وجود دارد. از شباهت های طیفی اگرچه بسیاری از مطالعات از تصاویر Google Earth VHR برای تهیه نمونه های آموزشی و اعتبار سنجی استفاده کرده اند [ ۴۸ ، ۴۹ ، ۵۰ ]، اما دقت نمونه های استخراج شده را گزارش نکردند.
الگوریتم‌های طبقه‌بندی جزء مهم دیگری هستند، زیرا باید نقشه‌های دقیقی را از داده‌های سنجش از دور تولید کنند. یک مجموعه داده مرجع دقیق و قوی مهمترین جزء طبقه بندی کننده های نظارت شده، به ویژه مدل های یادگیری ماشین (ML) است [ ۵۱ ، ۵۲ ]]. مجموعه میدانی از مجموعه داده های مرجع بخشی زمانبر و پرهزینه از تمام مطالعات پایش جنگل است، زیرا مناطق مورد مطالعه بزرگ و مناطق غیرقابل دسترس هستند. مجموعه داده مرجع باید نمونه های آموزشی و اعتبار سنجی کافی را برای نشان دادن تنوع تراکم های مختلف پوشش تاج پوشش (از جمله تمام کلاس های FCC) ارائه دهد و به خوبی در سراسر سایت مطالعه توزیع شود. زمانی که تعداد نمونه های آموزشی کافی نباشد، خطر تطبیق بیش از حد داده های آموزشی وجود دارد که می تواند منجر به قابلیت تعمیم ضعیف طبقه بندی کننده شود [ ۵۳ ، ۵۴ ]. ارائه این نوع مجموعه داده مرجع در نقشه برداری FCC در مقیاس بزرگ چالش برانگیز است، زیرا نمونه های آموزشی و اعتبار سنجی در نگاشت منطقه بزرگ معمولاً توسط موجودی های میدانی جمع آوری می شوند [ ۵۵ ]]. این کار بر اساس یافته‌های قبلی در مورد تهیه مجموعه داده‌های مرجع قابل اعتماد، تکنیک‌های جدید پردازش تصویر و مدل‌های ML است تا نقشه FCC دقیق‌تری ارائه کند. از آنجایی که راه‌حل‌های هوش مصنوعی ارتقاء‌دهنده برای نقشه‌برداری در مقیاس بزرگ مهم هستند، بنابراین این مطالعه اهداف خاص زیر را داشت:
(۱)
ارائه یک روش ساده اما کارآمد برای تهیه یک مجموعه داده مرجع دقیق،
(۲)
ارزیابی اثرات تراکم داده ها (یعنی مجموعه داده های یک ساله در مقابل مجموعه داده های سه ساله) بر دقت نقشه برداری FCC،
(۳)
ارزیابی تاثیر حوزه های طیفی مختلف بر دقت نقشه برداری FCC و
(۴)
مقایسه کارایی مدل‌های مختلف ML، یعنی جنگل تصادفی (RF)، ماشین بردار پشتیبان (SVM) و طبقه‌بندی و درخت رگرسیون (CART) بر دقت نقشه‌برداری FCC.

۲٫ مواد و روشها

۲٫۱٫ منطقه مطالعه

منطقه مورد مطالعه جنگل زاگرس دهستان گهواره است که در استان کرمانشاه، غرب ایران واقع شده است ( شکل ۱ ). مساحت این ناحیه ۹۴۰ کیلومتر مربع ، عرض جغرافیایی از ۳۴ درجه و ۲۵ دقیقه اینچ تا ۳۴ درجه و ۶۳ دقیقه و ۹۸ سانتی‌متر شمالی و امتداد طولی از ۴۶ درجه و ۰۱ دقیقه تا ۴۶ درجه و ۵۳ دقیقه و ۶۷ سانتی‌متر شرقی است. WGS84 Universal Mercator projection). ارتفاع از سطح دریا بین ۱۲۲۰ تا ۲۵۵۰ متر است. منطقه مورد مطالعه با آب و هوای مدیترانه ای با میانگین دمای سالانه ۲۲٫۷ درجه سانتی گراد و بارش سالانه ۵۵۰ میلی متر مشخص می شود. جنگل‌های زاگرس عموماً از جنگل‌های باز کم‌درخت یا بوته‌زارهایی تشکیل شده‌اند که گونه‌های بلوط ( Quercus sp.) بر آن غالب هستند. ۵۶ ]] که شبیه جنگل های دیگر کشورهای خاورمیانه (مانند عراق، سوریه، لبنان و ترکیه) است. منطقه مورد مطالعه تحت سلطه جنگل های بلوط ایرانی ( Q. brantii Lindl.) است. در دهه‌های اخیر، این منطقه به دلیل مرگ ناگهانی بلوط و بیماری زغال چوب، تلفات چشمگیری را تجربه کرده است که اولین بار در سال ۱۹۹۸ گزارش شد [ ۵۷ ، ۵۸ ]، و اخیراً به دلیل سندرم زوال بلوط، که ترکیبی از تغییرات آب و هوایی، بیماری‌ها، و سایر عوامل استرس زا که برای اولین بار در سال ۲۰۰۲ مشاهده شد (به عنوان مثال، [ ۵۹ ] را ببینید).

۲٫۲٫ روش شناسی کلی

گردش کار روش تحقیق شامل مجموعه ای از کارها، از جمله اندازه گیری درجا تاج درختان، آماده سازی نمونه های آموزشی و اعتبار سنجی، ارزیابی دقت مجموعه داده های مرجع، تعریف مجموعه داده های طبقه بندی، و طبقه بندی و ارزیابی دقت است که در شکل ۲ نشان داده شده است. .

۲٫۳٫ مجموعه داده مرجع

برای تهیه تعداد کافی نمونه آموزشی و اعتبار سنجی، از تصاویر ماهواره ای با وضوح بسیار بالا ارائه شده توسط Google Earth و تفسیر بصری استفاده شد. در این راستا، همانطور که توسط Anchang و همکاران توصیه شده است، از نقاط نمونه گیری شبکه ای برای اندازه گیری FCC استفاده شد. [ ۳۰ ]. تعدادی از ۵۲۰ قطعه مربع (۴۰ × ۴۰ متر) گرفته شد، مربوط به ۴ × ۴ پیکسل سنتینل. اندازه کرت بر اساس ویژگی های تاج درخت (مانند محیط تاج) و توزیع درختان تعیین شد. یک شبکه منظم از نقاط نمونه با فواصل ۴ متری ایجاد شد که در مجموع به ۱۲۱ نقطه در هر قطعه منجر شد. از تفسیر بصری برای تعیین تعداد نقاط نمونه که بر روی تاج درختان افتاده استفاده شد (نقطه سبز در شکل ۳)). در این مطالعه، QGis (نسخه ۳٫۲۴٫۲) برای ایجاد شبکه ماهیگیری و تفسیر بصری استفاده شد. بر اساس تعداد نقاط همپوشانی روی تاج درختان در هر قطعه و تعداد کل نقاط واقع در یک قطعه، ما FCC را به عنوان نسبت بین آنها محاسبه کردیم.

۲٫۴٫ اندازه گیری درجا

یک فهرست میدانی برای اندازه‌گیری FCC بیش از ۷۰ قطعه مربع (۴۰ × ۴۰ متر) در آگوست ۲۰۲۰ انجام شد. از آنجایی که دقت GPS تحت تأثیر عوامل زیادی است [ ۶۰ ]، در این مطالعه از یک واحد GPS با دقت ۱± متر (مدل: Garmin Map 64S C) استفاده کردیم. مطالعات قبلی [ ۲۳ ، ۶۱ ] بیان کرده اند که اگر تاج درخت از شکل دایره ای پیروی کند، میانگین قطر تاج را می توان با اندازه گیری دو قطر تاج (بزرگترین و کوچکترین قطر تاج درخت) محاسبه کرد. بنابراین، پیش بینی های افقی تاج درخت برای اندازه گیری FCC با استفاده از فاصله یاب لیزری TruPulse 360R (کلرادو، ایالات متحده آمریکا) اندازه گیری شد.https://lasertech.com/product/trupulse-360-rangefinder در ۱ مه ۲۰۲۲ قابل دسترسی است. میانگین قطر تاج و سطح تاج بر اساس این پیش بینی ها محاسبه شد. در نهایت، FCC هر قطعه بر اساس رابطه (۱) محاسبه شد:

افسیسی=∑من=۱nسیآپآ×۱۰۰

که در آن CA مساحت سطح تاج است، n نشان دهنده تعداد درختان است، و PA مساحت هر قطعه نمونه برداری است (یعنی ۱۶۰۰ متر مربع ) .

۲٫۵٫ ارزیابی دقت مجموعه داده مرجع

با توجه به اهمیت دقت نمونه در آموزش موثر مدل‌های ML، مقادیر FCC مبتنی بر میدان برای ارزیابی دقت مقادیر FCC به‌دست‌آمده توسط تصاویر ماهواره‌ای Google Earth VHR و نقاط نمونه شبکه‌بندی شده استفاده شد. در این راستا، معیارهای ضریب همبستگی پیرسون، ضریب تعیین (R2)، ریشه میانگین مربعات خطا (RMSE)، نش-ساتکلیف (E) و میانگین خطای مطلق (MAE) برای ارزیابی رابطه بین FCC به دست آمده از نمودارهای موجودی میدانی و اندازه‌گیری‌های FCC بر اساس تصاویر Google Earth VHR.

۲٫۶٫ نمونه های آموزشی و اعتبار سنجی

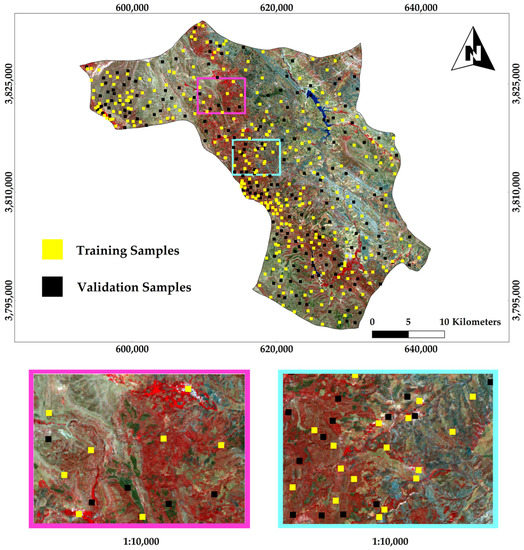
چهار کلاس FCC به شرح زیر تعریف شد: غیرجنگل (NF)، جنگل تنک (SF؛ FCC = 1-30٪)، جنگل با تراکم متوسط ​​(MDF؛ FCC = 31-60٪)، و جنگل متراکم (DF؛ FCC). > 60٪ [ ۲۵ ، ۲۹ ]. داده های تمام ۵۲۰ قطعه به طور تصادفی به زیر مجموعه های آموزشی (۶۰%) و اعتبارسنجی (۴۰%) تقسیم شدند ( جدول ۱ ). توزیع تمام نمودارهای نمونه در شکل ۴ نشان داده شده است.

۲٫۷٫ سری زمانی تصاویر ماهواره ای و پیش پردازش

تجزیه و تحلیل تصاویر ماهواره ای در پلت فرم محاسبات ابری GEE انجام شد. تمام تصاویر رادار دیافراگم مصنوعی S-1 (SAR) و S-2 بین ۱ ± ۱ ژوئیه تا ۳۰ سپتامبر ۲۰۲۰ (یعنی چگالی داده = ۲۰۱۹، ۲۰۲۰ و ۲۰۲۱) در محل مورد مطالعه استفاده شد. چگالی داده نشان دهنده تعداد تصاویر ماهواره ای در طول یک دوره است ( جدول ۲ ). سایت مطالعه ما توسط سه کاشی سنتینل مختلف، از جمله T38SND، T38SPD، و T38SPC پوشیده شده است. این مقیاس زمانی محدود و کوتاه برای در نظر گرفتن پایداری تاج درختان تعریف شد. در مورد تصاویر S-2، تمامی محصولات بازتابی سطحی با پوشش ابری کمتر از ۳۰ درصد استفاده شد. الگوریتم بدون ابر S-2 برای پوشش پیکسلی ابر و سایه ابر از مجموعه تصاویر S2 استفاده شد [ ۶۲]. از نظر سری زمانی S-1، مجموعه داده های قطبی دوگانه (VV و VH) شناسایی شده با محدوده زمینی (GRD) در حالت نواری تداخل سنجی گسترده (IW) استفاده شد [ ۶۳ ]. استفاده کارآمد از محصولات S-1 نیاز به پیش پردازشی دارد، از جمله اعمال فایل مداری، حذف نویز حرارتی، زمین، تصحیح رادیومتریک، و فیلتر لکه [ ۶۴ ]. این عملیات پیش پردازش برای همه تصاویر S-1 ذخیره شده در GEE اعمال شد. در این تحقیق، تنها فیلتر لی [ ۶۵ ] بر روی پلت فرم GEE با یک پنجره ۷×۷ برای کاهش اثرات لکه، همانطور که در جعبه ابزار S-1 ارائه شده در سکوی کاربردی سنتینل (SNAP) ارائه شده است، اعمال شد.

۲٫۸٫ ویژگی های کمکی

علاوه بر باندهای طیفی S-1 و S-2، چندین شاخص پوشش گیاهی بر اساس S-2 قابل مشاهده، NIR و نوارهای لبه قرمز ( جدول ۳ ) محاسبه شد، از جمله MSAVI (شاخص گیاهی اصلاح شده خاک اصلاح شده) [ ۶۶ ]، DVI (شاخص گیاهی تفاوت) [ ۶۷ ]، NDVI (شاخص گیاهی تفاوت نرمال شده) [ ۶۸ ]، GNDVI (شاخص گیاهی تفاوت عادی شده سبز) [ ۶۹ ] و NDI45 (شاخص تفاوت نرمال شده بر اساس B5 و B4) [ ۷۰ ].
علاوه بر این، مجموعه داده های ارتفاعی دیجیتالی ماموریت توپوگرافی رادار شاتل (SRTM) برای استخراج لایه های ارتفاعی و شیب [ ۷۱ ] استفاده شد.

۲٫۹٫ سنتینل طیفی-زمانی معیارها و مجموعه داده های طبقه بندی

معیارهای طیفی-زمانی (STMs) آمار توصیفی باندی هستند که بازتاب (یا شاخص مشتق شده از آن، مانند شاخص‌های پوشش گیاهی) را برای یک دوره زمانی مشخص خلاصه می‌کنند [ ۷۲ ]. سری های زمانی S-1 و S-2 و ویژگی های کمکی برای محاسبه STM ها استفاده شد. برای هر دو سری زمانی S-1 و S-2 از روش های یکسانی استفاده شد. ویژگی های آماری S-1 STM ها شامل حداقل، حداکثر، میانگین، انحراف استاندارد و صدک های ۵، ۲۵، ۵۰، ۷۵ و ۹۵ برای هر دو قطبش VV و VH محاسبه شد. برای مجموعه تصاویر S-2، آمار یکسان برای همه نوارها و شاخص های پوشش گیاهی محاسبه شد ( جدول ۴). از این رو، تعدادی از ۱۵۵ STM و معیارهای طیفی-زمانی S-1 و S-2 در طول فصل رشد اوج (۱ جولای تا ۳۱ سپتامبر) در مقیاس های زمانی مختلف (۱ ± ۲۰۲۰ و ۲۰۲۰) برای ارزیابی تأثیر داده ها محاسبه شد. چگالی در نقشه برداری FCC
در نهایت، تاثیر چگالی داده ها و دامنه های طیفی بر دقت نقشه برداری FCC مورد ارزیابی قرار گرفت. برای این منظور، سه مجموعه داده ( جدول ۵ ) با تنظیمات مجموعه ویژگی های مختلف تعریف شد. نتایج تجزیه و تحلیل مجموعه داده کامل (همه تصاویر S-1 و S-2 بین ۱ ژوئیه تا ۳۰ سپتامبر در ۱±۲۰۲۰) و مجموعه داده ۱ ساله (همه تصاویر S-1 و S-2 بین ۱ ژوئیه- ۳۰ سپتامبر ۲۰۲۰) برای ارزیابی تأثیر چگالی داده ها بر نقشه برداری FCC مقایسه شد. علاوه بر این، با توجه به تأثیر دامنه های طیفی و ادغام STM های S-1 و S-2، نتایج مجموعه داده های کامل و مجموعه داده S-2 (فقط تصاویر S-2 بین ۱ ژوئیه تا ۳۰ سپتامبر ۲۰۲۰ ± ۱) مقایسه شدند.

۲٫۱۰٫ مدل‌های طبقه‌بندی یادگیری ماشین و ارزیابی دقت

سه مدل ML شامل جنگل تصادفی (RF)، ماشین بردار پشتیبان (SVM) و طبقه‌بندی و درخت رگرسیون (CART) در GEE استفاده شد و عملکرد آنها در نقشه‌برداری FCC مقایسه شد. دقت هر طبقه‌بندی‌کننده با ترکیب‌های مختلف پارامترها با رویکرد آزمون و خطا، گزارش و مقایسه نتایج آزمایش شد ( جدول A1 ).
RF یک طبقه‌بندی‌کننده محبوب است که بر اساس درخت‌های تصمیم توسعه یافته است. مزایای آن این است که مفروضات توزیعی در مورد پیش بینی کننده ها ایجاد نمی کند، اهمیت متغیرها را اندازه گیری می کند، و حساسیت کمتری نسبت به نویز یا برازش بیش از حد دارد [ ۷۳ ]. در GEE، برای به حداکثر رساندن دقت طبقه‌بندی، طبقه‌بندی‌کننده تصادفی جنگل را می‌توان بر اساس چندین پارامتر تنظیم کرد، از جمله (۱) تعداد درخت‌های تصمیم، (۲) تعداد ویژگی‌ها در هر تقسیم، (۳) حداقل جمعیت برگ، (۴) ) کسر کیسه ای، (۵) حداکثر تعداد گره ها، و (۶) تصادفی سازی بذر. در این مطالعه، ما فقط تعداد درخت های تصمیم و تعداد پیش بینی کننده ها را تنظیم کردیم [ ۵ ، ۲۵ ، ۷۴ ] و از بقیه مقادیر پیش فرض استفاده کردیم (https://developers.google.com/earth-engine/apidocs/ee-classifier-smilerandomforest در ۱ مه ۲۰۲۲ قابل دسترسی است.
SVM یک مدل ML مبتنی بر هسته است که به طور گسترده در مطالعات طبقه بندی تصاویر ماهواره ای نظارت شده استفاده می شود. GEE اجازه می دهد تا چندین پارامتر از مدل را تنظیم کنید، مانند ( https://developers.google.com/earth-engine/apidocs/ee-classifier-libsvm در تاریخ ۱ مه ۲۰۲۲): رویه تصمیم گیری (رای گیری یا حاشیه)، نوع SVM (ما از پیش‌فرض استفاده کردیم: C_SVC)، نوع هسته (تابع پایه خطی، چند جمله‌ای، سیگموئیدی یا شعاعی)، و پارامتر هزینه (C) (چند نمونه در حاشیه به خطای کلی کمک می‌کنند) [ ۷۵ ، ۷۶ ]. C در SVM ها گنجانده شده است تا جریمه مربوط به خطاهای طبقه بندی اشتباه را برآورد کند [ ۷۷ ].
CART یک طبقه بندی تصمیم گیری تک درختی است، شبیه به RF [ ۷۸ ]. در هر گره درختی، مشخصه ای که تقسیم را تعریف می کند، داده ها را بر اساس به دست آوردن اطلاعات نرمال شده به زیر مجموعه ها تقسیم می کند. تصمیمات نهایی بر اساس ویژگی با بالاترین سود اطلاعات نرمال شده گرفته می شود [ ۷۸ ، ۷۹ ]. برای الگوریتم سبد خرید ( https://developers.google.com/earth-engine/apidocs/ee-classifier-libsvm در تاریخ ۱ مه ۲۰۲۲ قابل دسترسی است)، GEE اجازه می دهد تنها دو پارامتر اصلاح شود: حداقل جمعیت برگ و حداکثر تعداد از گره ها [ ۸۰ ].
این مطالعه از بهینه‌ساز فراپارامتر مبتنی بر GEE برای تعیین بهترین ترکیب پارامتری که فرآیند یادگیری و دقت طبقه‌بندی بیشتر را افزایش می‌دهد، استفاده کرد. در همین راستا در مدل RF تعدادی درخت کوک شد. در SVM، از نوع هسته تابع پایه شعاعی (RBF) برای همه مدل‌ها استفاده شد و ما فقط پارامتر هزینه (C) را تنظیم کردیم. با توجه به مدل CART، حداکثر گره (حداکثر تعداد گره برگ در هر درخت) و حداقل جمعیت برگ (حداقل تعداد نمونه آموزشی در هر گره برگ) تنظیم شد.

از یک طرف، عملکرد مدل‌های ML برای نگاشت دقیق FCC مقایسه شد. از سوی دیگر، تأثیر چگالی داده ها بر عملکرد طبقه بندی سه مدل ML مورد ارزیابی قرار گرفت. در نهایت، تاثیر ترکیب رادار (S-1) و نوری (S-2) STM ها مورد ارزیابی قرار گرفت. ارزیابی دقت بر اساس نمونه‌های اعتبارسنجی با توسعه ماتریس‌های سردرگمی و صادرات معیارهای عملکرد، یعنی دقت کلی، ضریب کاپا، دقت مصرف‌کننده (CA) و تولیدکننده (PA) و امتیاز F-1 مورد ارزیابی قرار گرفت. معیارهای ارزیابی دقت در سطح کلاس برای تجزیه و تحلیل عمیق تر و مقایسه بهتر بین مجموعه داده ها محاسبه شد. از آزمون مک نمار برای مقایسه بهتر مجموعه داده های مختلف و شناسایی تفاوت های معنی دار بین آنها استفاده شد [ ۸۱]. این آزمون مبتنی بر مقایسه زوجی ماتریس های سردرگمی است و آمار خی دو (χ۲ ) را به صورت زیر بیان می کند:

χ۲=(f12-f21)2f12+f21

که در آن f ۱۲ تعداد نمونه هایی را نشان می دهد که به درستی توسط مجموعه داده-۱ طبقه بندی شده اند اما به اشتباه توسط مجموعه داده-۲ طبقه بندی شده اند، و f ۲۱ نشان دهنده تعداد نمونه هایی است که به درستی توسط مجموعه داده-۲ طبقه بندی شده اند اما به اشتباه توسط مجموعه داده-۱ طبقه بندی شده اند. اگر χ۲ برابر یا بزرگتر از ۱٫۶ و ۳٫۲ باشد، تفاوت بین دو مجموعه داده مقایسه شده به ترتیب در سطوح اطمینان ۹۵% و ۹۹% قابل توجه است.

۳٫ نتایج

۳٫۱٫ ارزیابی دقت مجموعه داده مرجع

جدول ۶ آمار FCC اندازه گیری شده در میدان و آنهایی که با استفاده از تصاویر VHR Google Earth تخمین زده شده است را نشان می دهد. علاوه بر این، رگرسیون خطی ( شکل ۵ الف و جدول ۶ ) و معیارهای عملکرد مدل، رابطه قوی بین FCC تخمینی از تصاویر Google Earth VHR و مقادیر واقعی اندازه‌گیری شده در میدان را نشان دادند. باقیمانده ها نشان دادند که تفاوت بین Google Earth FCC و اندازه گیری های میدانی از ۴٫۷۲٪ تا ۳٫۱۳٪ متغیر است ( شکل ۵ ب). نمودارهای باقیمانده چند تفاوت بین اندازه‌گیری میدانی و Google Earth FCC را نشان دادند.

۳٫۲٫ نتایج طبقه بندی

نتایج ارزیابی دقت نقشه برداری FCC در جدول ۷ آورده شده است، که بر اساس S-1 و S-2 STMs (داده کامل) محاسبه شده در طول فصل اوج رشد (۱ ژوئیه تا ۳۱ سپتامبر) طی سه سال (۱ ± ۲۰۲۱) است. . بر اساس نتایج، مدل SVM بالاترین دقت (OA = 91.37% و Kappa = 0.86) و مدل CART کمترین دقت (OA = 87.22% و Kappa = 0.79) را تولید کرد. علاوه بر این، نمرات CA، PA، و F-1 در سطح کلاس در تمام کلاس‌های دارای SVM بالاتر بود. کمترین مقادیر CA، PA و F-1 توسط CART (به جز CA از DF و PA از MDF) تولید شد. همانطور که در جدول ۷ مشاهده می شود، مقادیر امتیاز CA، PA و F-1 برای همه کلاس ها (به جز SF) نسبتاً نزدیک بود و تفاوت متضادی بین مدل های ML وجود نداشت. کلاس NF بالاترین سطح دقت کلاس را با تمام مدل‌های ML به دست آورد، و CA از ۹۵٫۲۸ تا ۹۶٫۸۰ درصد، PA بین ۹۲٫۴۴ و ۹۷٫۳۸ درصد، و F-1 از ۹۳٫۸۴ تا ۹۷٫۰۸ درصد متغیر بود. دومین دقت بالاتر برای DF (CA = 91.93-94.41٪، PA = 89.85-94.62٪، و امتیاز F-1 = 91.64-94.51٪) به دست آمد. برای کلاس MDF، تمام مدل‌های ML دقت قابل‌توجهی تولید کردند (CA = 74.39-78.89٪، PA = 78.02-81.68، و F-1 = 77.45-79.49٪). کمترین دقت سطح کلاس برای SF مشاهده شد، با امتیاز F-1 بین ۵۳٫۱۱ و ۷۲٫۹۳٪. این نتایج نشان داد که مدل CART ضعیف‌ترین مدل برای شناسایی SF بود، در حالی که در طبقه‌بندی سایر کلاس‌های FCC عملکرد خوبی داشت.
بر اساس آزمون مک نمار ( جدول ۸ )، بین SVM و RF تفاوت معنی داری وجود داشت. χ۲ = ۸٫۶۹)، SVM و CART (χ ۲ = ۳۲٫۵۷)، و RF و CART (χ ۲ = ۱۳٫۶) مدل های ML. شکل ۶ نقشه های FCC حاصل از مدل های ML و مجموعه داده کامل را نشان می دهد.

۳٫۳٫ تاثیر چگالی داده ها

بر اساس نتایج ( جدول ۹ )، تمام مدل‌های ML دقت بالاتری با چگالی داده‌های بالاتر (داده‌های کامل) تولید کردند. معیار عملکرد مدل OA 1.63٪، ۱٫۴۶٪ و ۲٫۰۴٪ با مدل های SVM، RF، و CART با استفاده از مجموعه تصاویر کامل (۱±۲۰۲۰) برای محاسبه STM افزایش یافت. در بین مدل‌های ML مورد مطالعه، CART بالاترین حساسیت را به چگالی داده‌ها نشان داد. ضریب کاپا و میانگین امتیاز F-1 به ترتیب ۰٫۰۴۳ و ۵٫۰۵ درصد افزایش یافت.
مقایسه نقشه‌های FCC استخراج‌شده از مجموعه داده‌های کامل و یک ساله تفاوت معنی‌داری را بین آنها در همه مدل‌های ML نشان داد ( جدول ۱۰ ). بزرگترین و کوچکترین تفاوت معنادار بین دو مجموعه داده به ترتیب با CART (CART_Full در مقابل CART_1-year) و SVM (SVM_ Full در مقابل SVM_1-year) ایجاد شد.
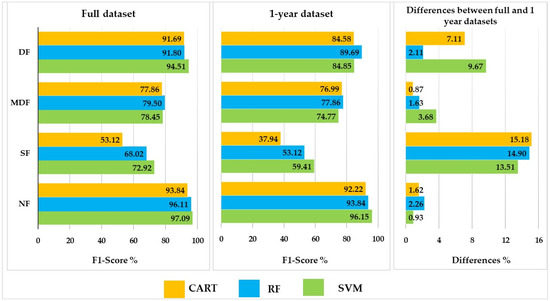
یک چگالی داده بالا (یعنی مجموعه داده کامل) امتیازهای F-1 بالاتری را برای همه کلاس‌های FCC ایجاد کرد ( شکل ۷)). مشاهده شد که تراکم داده‌های بالاتر تأثیر عمده‌ای بر طبقه‌بندی کلاس NF ندارد، زیرا تفاوت بین دو چگالی داده برای همه مدل‌های ML کم بود. نتایج مشابهی نیز هنگام مقایسه نمرات F-1 بین دو تراکم داده در مورد MDF مشاهده شد. علاوه بر این، نتایج نشان داد که شناسایی SF و DF بیشترین سود را از تراکم داده‌های بالاتر دارد. بیشترین تفاوت بین دو تراکم داده (۱ ± ۲۰۲۰، ۲۰۲۰) برای SF مشاهده شد، جایی که امتیاز F-1 به ترتیب با ۱۳٫۵۱٪، ۱۴٫۹۰٪ و ۱۵٫۱۸٪ با مدل های SVM، RF و CART ML افزایش یافت. از نظر طبقه بندی DF، بیشترین تفاوت با استفاده از طبقه بندی کننده SVM (8.67٪) مشاهده شد، و CART (7.11٪) به دنبال آن قرار گرفت ( شکل ۶ ).). در مقابل، تراکم داده‌های بالاتر افزایش قابل‌توجهی در عملکرد RF برای کلاس‌های DF نشان نداد (۲٫۱۱٪).

۳٫۴٫ تأثیر دامنه های طیفی و ادغام S-1 و S-2 STM

جدول ۱۱ نشان می دهد که دقت طبقه بندی با استفاده از S-2 STM بسیار بالا بود، با OA بین ۸۶٫۸۳٪ و ۸۹٫۰۷٪. بالاترین دقت با استفاده از ترکیب معیارهای طیفی-زمانی S-2 و S-1 (داده داده کامل) به دست آمد. همانطور که در جدول ۱۱ نشان داده شده است ، استفاده هم افزایی از ویژگی های S-1 و S-2 بیشترین تاثیر را بر نتایج طبقه بندی RF نشان داد، جایی که امتیاز OA و میانگین F-1 به ترتیب ۳٫۶۷% و ۴٫۷۷% افزایش یافت. در مقابل، نتایج مدل CART کمترین تأثیر مثبت را بر معیارهای دقت زمانی که STM های S-1 و S-2 یکپارچه می شوند، نشان داد.
هنگام ارزیابی تفاوت بین مجموعه داده کامل و مجموعه داده S-2، تفاوت معنی داری فقط با مدل RF ML بر اساس آزمون مک نمار مشاهده شد ( جدول ۱۲ ). تفاوت بین مجموعه داده کامل و مجموعه داده S-2 هنگام استفاده از مدل‌های SVM و CART ML معنی‌دار نبود.
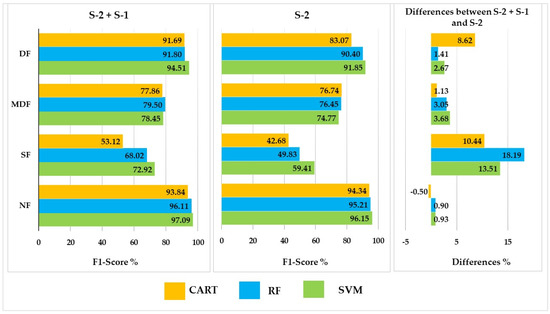
بر اساس نتایج ارزیابی دقت سطح کلاس ( شکل ۸ )، افزایش قابل توجهی در امتیازات F-1 برای کلاس SF با ادغام داده های S-1 و S-2 به دست آمد. امتیاز F-1 به ترتیب با ۱۳٫۵۱٪، ۱۸٫۱۹٪ و ۱۰٫۴۴٪ با مدل های SVM، RF و CART افزایش یافت که داده های S-1 در طبقه بندی گنجانده شد. نتیجه مشابه با بهبود جزئی برای سایر کلاس‌های FFC نیز مشاهده شد. به عنوان مثال، ویژگی های S-1 توانایی مدل CART را برای تشخیص کلاس DF به میزان ۸٫۶۲% بهبود بخشید.

۴٫ بحث

به طور کلی، ترکیب مدل‌های ML با داده‌های آزادانه در دسترس منجر به نتایج رضایت‌بخشی شد و بهترین مدل نتایج بسیار دقیقی را تولید کرد (OA = 91.37٪ و Kappa = 0.861). اولین مؤلفه ای که به دستیابی به این نتایج کمک کرد یک مجموعه داده مرجع دقیق و قوی برای نقشه برداری FCC بود. در این راستا، تصاویر ماهواره‌ای VHR از Google Earth و نقاط شبکه‌بندی شده برای تهیه ۵۲۰ نمونه FCC استفاده شد که به ما امکان آموزش کارآمد مدل‌های ML و ارزیابی دقت با کیفیت بالا را می‌دهد. دقت این نمونه ها بر اساس نمودارهای موجودی میدانی، که نشان دهنده دقت مجموعه داده مرجع استفاده شده است، ارزیابی شد. علاوه بر این، سطح بالایی از همبستگی بین مقادیر اندازه‌گیری شده و برآورد شده FCC مشاهده شد. از این رو، مطالعه حاضر نشان داد که تصاویر ماهواره‌ای VHR ارائه شده توسط GEE و نقاط نمونه‌گیری شبکه‌ای در حال حاضر یک جایگزین عملی برای جمع‌آوری سریع نمونه‌های FCC مورد نیاز با هزینه کم هستند. محدودیت‌های موجودی‌های زمینی، محققان را به استفاده از محصولات و روش‌های مختلف سنجش از دور برای تخمین FCC برای به دست آوردن مجموعه داده‌های مرجع، سوق داده است. به عنوان مثال، کورهونن و همکاران. [۲۸ ] از داده‌های LiDAR موجود در هوا با چگالی پالس ۱/m2 برای تخمین FCC و مقادیر حاصله به عنوان نمونه‌های آموزشی و اعتبارسنجی استفاده کرد. اگرچه کارایی استفاده از داده‌های LiDAR برای ارائه پارامترهای موجودی دقیق جنگل در مطالعات مختلف قبلی ثابت شده است [ ۸۲ ، ۸۳ ، ۸۴ ]، استفاده از چنین داده‌هایی برای محققان بسیار پرهزینه شده است و محدودیت‌های تکنولوژیکی و لجستیکی، به ویژه در برنامه‌های کاربردی، محدود شده است. برای پوشش مناطق بزرگ، یا آنهایی که نیاز به کاربردهای مکرر دارند [ ۸۵ ، ۸۶ ، ۸۷ ]. در مطالعه دیگری، هوانگ و همکاران. [ ۲۹] از تصاویر ماهواره ای VHR موجود در Google Earth برای اندازه گیری FCC استفاده کرد. آنها یک گردش کار پیچیده پردازش تصویر را تعریف کردند و از آن استفاده کردند که شامل گرفتن اسکرین شات از تصاویر Google Earth، دور انداختن سیاه و سفید، تنظیم روشنایی و کنتراست، و اندازه گیری FCC با استفاده از ابزار برش چگالی بود. آنها دقت اندازه گیری های خود را ارائه نکرده اند و امکان مقایسه آماری وجود ندارد. با این حال، چنین روش های پیچیده ای به زمان بیشتر و تجربه پردازش تصویر بیشتری نیاز دارند. از این رو، به این نتیجه رسیدیم که استفاده از تصاویر VHR جغرافیایی به‌دست‌آمده از Google Earth برای اندازه‌گیری FCC نیازی به تجربه پردازش تصویر زیادی ندارد و می‌تواند سطح بالایی از دقت را ارائه دهد.
با توجه به طبقه‌بندی‌کننده‌های ML، SVM بدون در نظر گرفتن تراکم و ادغام داده‌ها، بالاترین دقت را در مقایسه با RF و CART ایجاد کرد. علاوه بر این، بر اساس آزمون مک نمار، SVM به طور قابل توجهی بهتر از RF و CART عمل کرد. این نتایج با مطالعات قبلی مطابقت دارد، که نشان داد SVM کارآمدترین الگوریتم برای نقشه برداری LULC است [ ۸۸ ، ۸۹ ]]. بالاترین دقت سطح کلاس (نمره CA، UA، و F-1) با استفاده از SVM تولید شد، که نشان می‌دهد SVM هم خطاهای کمیسیون و هم خطاهای حذف را کاهش می‌دهد. کمترین دقت طبقه بندی با استفاده از CART برای تمام طبقات جنگلی به دست آمد. به عنوان مثال، کمترین امتیاز F-1 توسط CART برای نقشه برداری جنگل های پراکنده تولید شد که نشان دهنده تناسب کمتر این الگوریتم برای طبقه بندی ویژگی هایی با شباهت های طیفی مشابه است. در مورد چنین امضاهای طیفی مشابهی، توانایی بالاتر SVM برای متمایز ساختن این کلاس‌ها ممکن است به دلیل طراحی آن با هدف یافتن مرزهای تصمیم‌گیری که حاشیه را به حداکثر می‌رسانند، ایجاد شده باشد [ ۹۰ ]]. در مقابل، همه مدل‌های ML عملکرد مشابهی را برای طبقه‌بندی سایر کلاس‌های FCC، به‌ویژه جنگل‌های غیر جنگلی و انبوه نشان دادند. این نتایج نشان می‌دهد که همه مدل‌های ML زمانی که کلاس‌ها از نظر امضاهای طیفی نسبتاً خالص بودند، عملکرد خوبی داشتند، که از یافته‌های قبلی پشتیبانی می‌کند. به عنوان مثال، بر اساس Adugna و همکاران. [ ۹۱ ]، RF و SVM عملکرد مشابهی را برای طبقه‌بندی طبقات خالص با ویژگی‌های طیفی متمایز مانند توده‌های آبی و پوشش گیاهی کم نشان دادند. در این مطالعه، دقت بالاتر الگوریتم SVM در مقایسه با RF و CART ممکن است با حجم نمونه آموزشی مرتبط باشد. بر اساس Shetty و همکاران. [ ۹۲]، SVM نسبت به سایر مدل ها حساسیت کمتری به تعداد نمونه های آموزشی دارد و با تعداد ویژگی های زیاد و نمونه های آموزشی کوچک، دقت بالاتری را ارائه می دهد. نتایج مشابهی در سایر مطالعات نیز مشاهده شد. به عنوان مثال، سابات تومالا و همکاران. [ ۹۳] عملکرد الگوریتم های RF و SVM را در نقشه برداری سه گونه مهاجم با استفاده از ۴۳۰ باند ابرطیفی مقایسه کرد. آنها همچنین تأثیر حجم نمونه آموزشی را بر دقت طبقه‌بندی ارزیابی کردند که برای آن از اندازه‌های مختلف نمونه‌های آموزشی (۳۰، ۵۰، ۱۰۰، ۲۰۰ و ۳۰۰ نمونه در هر کلاس) استفاده کردند. آنها دریافتند که SVM نسبت به RF به تعداد نمونه های آموزشی حساس تر است، زمانی که بسیاری از ویژگی ها در گردش کار طبقه بندی دخیل بودند. به عبارت دیگر، ویژگی‌های مورد استفاده برای طبقه‌بندی RF ممکن است تفاوت‌های طیفی بین کلاس‌ها را به‌طور بهینه تشخیص ندهند. Raczko و Zagajewski [ ۹۴ ] گزارش کردند که انتخاب نادرست ویژگی ها ممکن است بر نتایج طبقه بندی RF نیز تأثیر بگذارد. با این حال، در برخی از مطالعات، RF بهتر از SVM عمل کرده است. به عنوان مثال، لی و همکاران. [ ۹۵] گزارش داد که RF بالاترین معیار عملکرد مدل OA را در مقایسه با SVM، به ویژه برای نقشه برداری کلاس های پیچیده مانند زمین های استخراج شده از سطح زمین، تولید می کند. به طور خلاصه، با توجه به مطالعات قبلی، RF و SVM معمولاً توانایی‌های مشابهی را نشان می‌دهند و اغلب از الگوریتم‌های دیگر مانند CART [ ۹۶ ]، شبکه عصبی مصنوعی (ANN) [ ۹۷ ] و طبقه‌بندی حداکثر احتمال (MLC) [ ۹۸ ] بهتر عمل می‌کنند و آن‌ها را در میان آنها قرار می‌دهند. بهترین گزینه ها برای راه حل های طبقه بندی
علاوه بر این، در این مطالعه، تاثیر چگالی داده ها بر دقت طبقه بندی FCC مورد ارزیابی قرار گرفت. به عنوان مثال، آدامز و همکاران. [ ۹۹ ] از تمام تصاویر ماهواره‌ای Landsat-8 OLI از ۲۰۱۳ تا ۲۰۱۷، از جمله ۳۳۰ مشاهدات واضح (یعنی پس از پوشش ابر) استفاده کرد و یک سری زمانی متراکم برای نقشه‌برداری ترکیب جنگل تولید کرد. آزاری و لوبل [ ۱۰۰] مجموعه‌ای شامل تمام تصاویر ماهواره‌ای از سنسورهای Landsat-7 TM، Landsat 7 ETM+ و Landsat 8 OLI بین سال‌های ۲۰۱۲ و ۲۰۱۵ برای دستیابی به تراکم داده‌های بالا و تولید مشاهدات قابل اعتماد برای نظارت بر پوشش زمین در زامبیا ایجاد کرد. با این حال، بر خلاف مطالعات قبلی، در مطالعه حاضر، هر دو STM مبتنی بر یک ساله و چند ساله برای تعیین اینکه چگونه تراکم داده بالا بر نتایج طبقه‌بندی تأثیر می‌گذارد استفاده شد. این مطالعه تفاوت های بسیار قابل توجهی را در ارتباط با تراکم داده های بالاتر در تمام مدل های ML مشاهده کرد. بر اساس نتایج، OA با SVM، RF و CART به ترتیب ۱٫۶۳٪، ۱٫۴۶٪ و ۲٫۰۴٪ افزایش یافت. سری زمانی سه ساله به همه مدل‌های ML کمک کرد و توانایی آن‌ها را برای طبقه‌بندی کلاس‌های FCC، به‌ویژه کلاس جنگل‌های پراکنده که با مجموعه داده‌های یک ساله به خوبی متمایز نشد، افزایش داد. این نتایج توسط Pflugmacher و همکاران پشتیبانی می شود. [۱۰۱ ]، که دریافتند که نتایج طبقه‌بندی زمانی افزایش می‌یابد که معیارهای طیفی و زمانی با استفاده از یک سری زمانی سه ساله به جای داده‌های یک ساله محاسبه می‌شوند. استفاده از یک سری زمانی ماهواره ای چند ساله یک روش عملی و موثر برای محاسبه قابل اطمینان تر STM ها [ ۱۰۲ ] است، زیرا مشاهدات بیشتر می تواند اطلاعات بیشتری از ویژگی های سطح زمین ارائه دهد.
با توجه به ادغام داده ها بر اساس نتایج، استفاده هم افزایی از S-1 SAR و STM های نوری S-2 دقت طبقه بندی را در مقایسه با مواردی که تنها با استفاده از S-2 به دست آمده بودند، بهبود بخشید. ادغام S-1 STM OA را با الگوریتم های SVM، RF و CART به ترتیب ۲٫۳%، ۳٫۶۷% و ۰٫۳۹% افزایش داد. ادغام بالاترین تأثیر را بر طبقه بندی جنگل های تنک داشته است، که نشان می دهد این طبقه دارای ویژگی های طیفی مشابه با موارد موجود در سایر طبقات، عمدتاً جنگل های غیر جنگلی و جنگل های با تراکم متوسط ​​است، و بنابراین نمی تواند به طور موثر توسط ویژگی های نوری طبقه بندی شود. . برخی از مطالعات بر روی یکپارچه سازی داده های نوری و راداری متمرکز شده اند و به این نتیجه رسیده اند که استفاده از آنها با هم نتایج بهتری نسبت به استفاده جداگانه از آنها ارائه می دهد [ ۱۰۳ ، ۱۰۴]. برای مثال، بورخس و همکاران. [ ۱۰۵ ] پیکربندی‌های مجموعه ویژگی‌های مختلفی را بر اساس ویژگی‌های S-1، S-2، و S-1 و S-2 تعریف کرد و اظهار داشت که استفاده هم‌افزایی از S-1 و S-2 دقت را برای اکثر انواع پوشش زمین افزایش می‌دهد. بنابراین، این دو حوزه طیفی اطلاعات تکمیلی را ارائه می دهند [ ۱۰۶ ].
به عنوان اولین محدودیت، به دلیل عدم وجود نمونه های آموزشی و اعتبار سنجی، نتوانستیم مطالعه خود را در مقیاس بسیار بزرگتر انجام دهیم. مطالعات آینده می‌توانند نتایج سایر طبقه‌بندی‌کننده‌های محبوب را برای نقشه‌برداری FCC، مانند ANN و یادگیری عمیق، مقایسه کنند، زیرا دقت طبقه‌بندی ممکن است تحت تأثیر نوع مدل ML مورد استفاده قرار گیرد (محدودیت دوم). به عنوان مثال، شبکه های عصبی مصنوعی ممکن است روی سایر کلاس های سیگنال بهتر کار کنند [ ۷ ، ۱۰۷]. همچنین اندازه گیری قطر تاج درختان در برخی از قطعات نمونه با توجه به محیط کوهستانی جنگل های زاگرس (محدودیت سوم) چالش برانگیز بود. به عنوان یک گزینه جایگزین، می توان از تصاویر با وضوح بالا برای تخمین FCC برای مناطقی که در مناطق شیب دار قرار دارند استفاده کرد. علاوه بر این، برای درک تعمیم پذیری رویکرد ما، ما پیشنهاد می کنیم این رویکرد را آزمایش کنیم به طوری که نمونه های آموزشی و آزمایشی از مناطق مختلف جمع آوری شود، که می تواند قابلیت انتقال نتایج را به مناطق دیگر نشان دهد.
در حال حاضر گزارش رسمی از FCC در پهنه رویشی زاگرس وجود ندارد. بنابراین، نقشه FCC تولید شده با استفاده از الگوریتم SVM در این مطالعه می‌تواند به عنوان مبنایی برای تصمیم‌گیران سازمان جنگل‌ها، مراتع و آبخیزداری ایران برای پایش تغییرات FCC در منطقه، چه نتیجه فعالیت‌های انسانی باشد و چه در نتیجه، مورد استفاده قرار گیرد. رویدادهای طبیعی و ایجاد یک برنامه مدیریت جنگل.

۵٫ نتیجه گیری ها

هدف این تحقیق استفاده از تمامی قابلیت‌های موجود، از جمله تصاویر ماهواره‌ای VHR، نمودارهای موجودی میدانی، سری زمانی سنتینل، محاسبات ابری GEE و الگوریتم‌های ML برای شناسایی کلاس‌های FCC در جنگل‌های بلوط مدیترانه‌ای ناهمگن بود. با توجه به روش مورد استفاده و نتایج، می‌توان موارد زیر را نتیجه‌گیری کرد: (۱) تصاویر ماهواره‌ای VHR و نقاط نمونه‌گیری شبکه‌ای را می‌توان برای تهیه تعداد کافی نمونه آموزشی و اعتبارسنجی برای یک رویکرد سریع، دقیق و مقرون‌به‌صرفه ترکیب کرد. (ii) سری های زمانی نوری و راداری Sentinel اطلاعات مفیدی را برای نقشه برداری دقیق FCC ارائه می دهند. ترکیب آنها بهترین گزینه برای شناسایی تمام کلاس های FCC بود. (iii) استفاده از یک سری زمانی سه ساله توانایی همه مدل‌های ML را برای طبقه‌بندی کلاس‌های FCC افزایش داد، عمدتاً جنگل های تنک که با استفاده از مجموعه داده یک ساله به خوبی تشخیص داده نشدند. تفاوت های بسیار قابل توجهی مرتبط با تراکم داده های بالاتر برای همه مدل های ML مشاهده شد. (IV) استفاده هم افزایی از S-1 SAR و S-2 STM های نوری، دقت طبقه بندی را در مقایسه با مواردی که فقط با استفاده از S-2 به دست آمده بودند، بهبود بخشید. این نتیجه بر اهمیت استفاده از مجموعه داده های چند حسگر و انواع مختلف پیش بینی کننده ها در نقشه برداری FCC تاکید می کند. (v) مدل‌های مختلف ML با توجه به عملکرد آموزشی و دقت طبقه‌بندی آن‌ها بر اساس مجموعه داده‌های سنجش از راه دور مورد بررسی قرار گرفتند. بر اساس نتایج، SVM کارآمدترین الگوریتم برای نقشه برداری FCC بود. با این حال، RF نیز نتایج معقولی را نشان داد. ما نتیجه می گیریم که محبوب ترین مدل های ML، از جمله SVM و RF، که در GEE ارائه شده اند، برای راه حل های دقیق نقشه برداری FCC کافی هستند. علاوه بر این، روش استفاده شده اطلاعات بهینه و به روزی را در مورد نقشه برداری FCC می دهد و می تواند به عنوان یک رویکرد قدرتمند و سازماندهی شده، به ویژه در جنگل های مدیترانه گسترش یابد. مطالعات بیشتری برای بررسی پتانسیل سایر مجموعه داده های رصد زمین و ادغام آنها، مانند سری های زمانی Landsat و ALOS توصیه می شود. علاوه بر این، عملکرد طبقه‌بندی‌کننده‌های یادگیری عمیق باید ارزیابی شود.

پیوست اول

جدول A1. مقادیر بهینه برای فراپارامترهای الگوریتم های یادگیری ماشین (ML).

منابع

  1. جیانگ، اچ. آهنگ، ال. لی، ی. ما، م. Fan, L. نظارت بر کاهش انعطاف پذیری جنگل ها در جنوب غربی چین با استفاده از داده های سنجش از دور بلند مدت. Remote Sens. ۲۰۲۱ , ۱۴ , ۳۲٫ [ Google Scholar ] [ CrossRef ]
  2. جان، ای. بانتینگ، پ. هاردی، ا. سیلایو، دی اس؛ ماسونگا، ای. سیستم نظارت بر جنگل برای تانزانیا. Remote Sens. ۲۰۲۱ , ۱۳ , ۳۰۸۱٫ [ Google Scholar ] [ CrossRef ]
  3. لو، ی. Wang, L. چگونه نقشه برداری به موقع حرا در مقیاس بزرگ را با سنجش از دور خودکار کنیم. سنسور از راه دور محیط. ۲۰۲۱ ، ۲۶۴ ، ۱۱۲۵۸۴٫ [ Google Scholar ] [ CrossRef ]
  4. مالکوچ، ای. روتسچی، ام. گینزلر، سی. Waser، LT نقشه برداری سراسری درختان خارج از جنگل ها بر اساس داده های سنجش از دور در سوئیس. بین المللی J. Appl. رصد زمین. Geoinf. ۲۰۲۱ ، ۱۰۰ ، ۱۰۲۳۳۶٫ [ Google Scholar ] [ CrossRef ]
  5. مرادی، ف. درویش صفت، ع.ا. پوررحمتی، محمدرضا; دلجویی، ع. برز، SA برآورد بیومس بالای زمین در جنگل های انبوه هیرکانی با استفاده از داده های Sentinel-2. Forests ۲۰۲۲ , ۱۳ , ۱۰۴٫ [ Google Scholar ] [ CrossRef ]
  6. سفید، JC; Coops، NC; Wulder، MA; واستارانتا، م. هیلکر، تی. Tompalski, P. Remote Sensing Technologies for Enhancing Forest Inventory: A Review. می توان. J. Remote Sens. ۲۰۱۶ ، ۴۲ ، ۶۱۹-۶۴۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  7. گاستون، ا. بلازکز-کابررا، اس. متئو سانچز، ام. سیمون، ام. Saura, S. نقش پوشش تاج پوشش جنگل در انتخاب زیستگاه: بینش از سیاهگوش ایبری . یورو جی. وایلدل. Res. ۲۰۱۹ ، ۶۵ ، ۳۰٫ [ Google Scholar ] [ CrossRef ]
  8. والریو، م. ایبانیز، آر. Gazol, A. نقش دینامیک پوشش تاج پوشش در طول یک دهه تغییرات در زیر داستان جنگل راش-بلوط اقیانوس اطلس. Forests ۲۰۲۱ , ۱۲ , ۹۳۸٫ [ Google Scholar ] [ CrossRef ]
  9. صادقی، اس ام ام; عطارود، پ. تفاوت Pypker، TG در مهار بارندگی در طول فصول رشد و غیررشد در مزرعه Fraxinus rotundifolia واقع در آب و هوای نیمه خشک. جی. آگریک. علمی تکنولوژی ۲۰۱۵ ، ۱۷ ، ۱۴۵-۱۵۶٫ [ Google Scholar ]
  10. صادقی، اس ام ام; گوردون، دی. Van Stan II، JT سنتز جهانی آب و هواشناسی عبوری و جریان ساقه. در تقسیم بندی بارش توسط پوشش گیاهی ; Springer: برلین/هایدلبرگ، آلمان، ۲۰۲۰؛ صص ۴۹-۷۰٫ [ Google Scholar ]
  11. صادقی، اس ام ام; Van Stan II، JT; Pypker، TG; Friesen، J. Canopy Hydromeeorological Dynamics در سراسر یک توالی زمانی یک گونه مهاجم جهانی، Ailanthus altissima (میل.، درخت بهشت). کشاورزی برای. هواشناسی ۲۰۱۷ ، ۲۴۰ ، ۱۰-۱۷٫ [ Google Scholar ] [ CrossRef ]
  12. پناهنده، ت. عطارود، پ. صادقی، اس ام ام; بایرام زاده، و. تانگ، کیو. لیو، ایکس. عملکرد مدل رهگیری بارندگی گاش اصلاح شده در جنگل های معتدل هیرکانی شمال ایران. جی هیدرول. ۲۰۲۲ , ۶۱۲ , ۱۲۸۰۹۲٫ [ Google Scholar ] [ CrossRef ]
  13. خو، اچ. هو، ایکس. گوان، اچ. ژانگ، بی. وانگ، ام. چن، اس. چن، ام. یک روش مبتنی بر سنجش از دور برای تشخیص فرسایش خاک در جنگل ها. Remote Sens. ۲۰۱۹ , ۱۱ , ۵۱۳٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  14. هاجر، JC; یوست، آ. Haggerty، PK ترکیب معیارهای LiDAR در یک مدل زیستگاه مبتنی بر ساختار برای گونه‌های سایبان. سنسور از راه دور محیط. ۲۰۲۰ ، ۲۳۶ ، ۱۱۱۴۹۹٫ [ Google Scholar ] [ CrossRef ]
  15. لی، اس. هو، ز. جی، جی. وانگ، تی. ارزیابی اثرات گیاهخواران بزرگ بر ساختار سه بعدی جنگل های معتدل با استفاده از اسکن لیزری زمینی. برای. Ecol. مدیریت ۲۰۲۲ ، ۵۰۷ ، ۱۱۹۹۸۵٫ [ Google Scholar ] [ CrossRef ]
  16. آواستی، ن. آریال، ک. چهتری، BBK; بنداری، اس.کی. خانال، ی. گوتامه، پ. بارال، ک. تأمل در تنوع گونه‌ها و پویایی‌های بازسازی شیوه‌های علمی مدیریت جنگل در نپال. برای. Ecol. مدیریت ۲۰۲۰ , ۴۷۴ , ۱۱۸۳۷۸٫ [ Google Scholar ] [ CrossRef ]
  17. دلجویی، ع. صادقی، اس ام ام; عبدی، ا. برنهارت-رومرمان، م. Pascoe, EL; Marcantonio, M. تاثیر اختلال جاده بر روی پوشش گیاهی و خواص خاک در یک توده راش، جنگل هیرکانی. یورو جی. برای. Res. ۲۰۱۸ ، ۱۳۷ ، ۷۵۹-۷۷۰٫ [ Google Scholar ] [ CrossRef ]
  18. پیرمن، جی. هوگان، جی. فرکانس، شدت و ساختار جنگل لین، اختلال TC تغییرات ناشی از طوفان را در پوشش تاج جنگل حرا تعدیل می کند. گلوب. Ecol. Biogeogr. ۲۰۲۲ ، ۳۱ ، ۳۷-۵۰٫ [ Google Scholar ] [ CrossRef ]
  19. سفیدی، ک. کپن هیور، کالیفرنیا؛ صادقی، فشارهای انسانی SMM کاهش پیچیدگی ساختاری در جنگل های قفقاز ایران. Écoscience ۲۰۲۲ ، ۲۹ ، ۱۹۹-۲۰۹٫ [ Google Scholar ] [ CrossRef ]
  20. فرناندز-آلوارز، م. آرمستو، جی. Picos, J. LiDAR-based Wildfire Prevention in WUI: The Automatic Detection, Measurement and Evaluation of Forest Fuels. Forests ۲۰۱۹ , ۱۰ , ۱۴۸٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  21. ویلسون، ن. برادستاک، آر. Bedward، M. تأثیر ساختار سوخت برگرفته از اسکن لیزری زمینی (TLS) بر شدت آتش سوزی در جنگل های ثبت شده. جی. محیط زیست. مدیریت ۲۰۲۲ ، ۳۰۲ ، ۱۱۴۰۱۱٫ [ Google Scholar ] [ CrossRef ]
  22. نواک، دی جی; هیرابایاشی، اس. دویل، ام. مک گاورن، ام. Pasher, J. حذف آلودگی هوا توسط جنگل های شهری در کانادا و تأثیر آن بر کیفیت هوا و سلامت انسان. شهری برای. سبز شهری. ۲۰۱۸ ، ۲۹ ، ۴۰-۴۸٫ [ Google Scholar ] [ CrossRef ]
  23. حشمت الواعظین، س.م. جویباری، م.م. دایی، ع. آواتفی همت، م. شیروانی، ع. تالیس، ام جی. هیرابایاشی، اس. معین الدینی، م. حمیدیان، ق. صادقی، SMM اثربخشی درختان شهری در کاهش ذرات معلق در هوا با رسوب خشک در تهران، ایران. محیط زیست نظارت کنید. ارزیابی کنید. ۲۰۲۱ ، ۱۹۳ ، ۸۴۲٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
  24. نارین، LL; پوپسکو، اس. نوینشواندر، آ. ژو، تی. سرینیواسان، س. Harbeck، K. تخمین پوشش زیست توده و پوشش جنگلی با شبیه سازی داده های ICESat-2. سنسور از راه دور محیط. ۲۰۱۹ ، ۲۲۴ ، ۱-۱۱٫ [ Google Scholar ] [ CrossRef ]
  25. نصیری، و. درویش صفت، ع.ا. عارفی، ح. گریس، VC؛ صادقی، اس ام ام; برز، SA مدلسازی پوشش سایبان جنگلی: استفاده هم افزایی از Sentinel-2، داده های فتوگرامتری هوایی و یادگیری ماشین. Remote Sens. ۲۰۲۲ , ۱۴ , ۱۴۵۳٫ [ Google Scholar ] [ CrossRef ]
  26. تانگ، اچ. آرمستون، جی. هنکاک، اس. مارسلیس، اس. گوتز، اس. Dubayah, R. مشخص کردن توزیع پوشش تاج جنگل جهانی با استفاده از Spaceborne Lidar. سنسور از راه دور محیط. ۲۰۱۹ ، ۲۳۱ ، ۱۱۱۲۶۲٫ [ Google Scholar ] [ CrossRef ]
  27. رجب پور، م. درویش صفت، ع.ا. خلیل پور، ع. قابلیت داده های SPOT5-HRG برای نقشه برداری تراکم جنگل (مطالعه موردی: جنگل های دیلمان در استان گیلان). ایران. جی. برای. صنوبر Res. ۲۰۱۰ ، ۱۸ ، ۱۳۲-۱۴۲٫ [ Google Scholar ]
  28. کورهونن، ال. علی سیستو، د. Tokola، T. برآورد پوشش پوشش جنگل های استوایی با استفاده از تصاویر ماهواره ای و داده های مرجع Lidar هوابرد. سیلوا فن ۲۰۱۵ ، ۴۹ ، ۱۴۰۵٫ [ Google Scholar ] [ CrossRef ]
  29. هوانگ، ایکس. وو، دبلیو. شن، تی. زی، ال. Qin، Y.; پنگ، اس. ژو، ایکس. فو، ایکس. لی، جی. Zhang, Z. تخمین پوشش سایبان جنگلی با سنجش از دور چند مقیاسی در شمال شرقی جیانگشی، چین. Land ۲۰۲۱ , ۱۰ , ۴۳۳٫ [ Google Scholar ] [ CrossRef ]
  30. آنچانگ، جی. پریودکو، ال. جی، دبلیو. کومار، اس.اس. راس، CW; یو، کیو. لیند، بی. سار، MA; Diouf، AA; Hanan، NP به سمت نقشه برداری عملیاتی پوشش چوبی تاج پوشش در ساوانای گرمسیری با استفاده از موتور Google Earth. جلو. محیط زیست علمی ۲۰۲۰ ، ۸ ، ۴٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
  31. آرومه، تی. Lang، M. برآورد پوشش تاج پوشش در جنگل های انبوه ترکیبی با استفاده از داده های هوابرد Lidar. یورو J. Remote Sens. ۲۰۱۸ ، ۵۱ ، ۱۳۲-۱۴۱٫ [ Google Scholar ] [ CrossRef ]
  32. مارسیک، م. Staub، CG; کلایندل، WJ; هال، جی.ام. فو، سی.- اس. یانگ، دی. استیونز، FR; بینفورد، نقشه های مدیریت مقیاس منطقه ای MW برای مناطق جنگلی جنوب شرقی ایالات متحده و شمال غرب اقیانوس آرام ایالات متحده. علمی داده ۲۰۱۸ ، ۵ ، ۱۸۰۱۶۵٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
  33. میرونیک، وی. کوتیا، م. جی سرکیسیان، ع. بیلوس، ا. لیو، اس. نقشه برداری جنگل در مقیاس منطقه ای بر روی مناظر تکه تکه شده با استفاده از محصولات جهانی جنگل و طبقه بندی سری های زمانی Landsat. Remote Sens. ۲۰۲۰ , ۱۲ , ۱۸۷٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  34. دزلورز، جی. ینکو، دی. بوترل، ا. Ranc، N. یادگیری بدون برچسب مثبت برای تجزیه و تحلیل سری زمانی تصاویر ماهواره ای: یک کاربرد برای نقشه برداری غلات و جنگل. Remote Sens. ۲۰۲۱ , ۱۴ , ۱۴۰٫ [ Google Scholar ] [ CrossRef ]
  35. گاریود، ع. والرو، اس. جووردانو، اس. مالت، سی. رگرسیون مبتنی بر مکرر سری زمانی سنتینل برای پایش مداوم پوشش گیاهی. سنسور از راه دور محیط. ۲۰۲۱ ، ۲۶۳ ، ۱۱۲۴۱۹٫ [ Google Scholar ] [ CrossRef ]
  36. لیو، جی. ژو، ی. رن، ک. آهنگ، جی. آسیاب بادی، سی. مریت، پی. بازیابی کمی سری زمانی با کارایی بالا از تصاویر ماهواره ای در یک خوشه GPU. IEEE J. Sel. بالا. Appl. زمین Obs. Remote Sens. ۲۰۱۹ , ۱۲ , ۲۸۱۰–۲۸۲۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  37. زنگ، ال. واردلو، بی.دی. شیانگ، دی. هو، اس. لی، دی. مروری بر استخراج معیارهای فنولوژیکی گیاهی با استفاده از سری های زمانی، فتای ماهواره چندطیفی. سنسور از راه دور محیط. ۲۰۲۰ , ۲۳۷ , ۱۱۱۵۱۱٫ [ Google Scholar ] [ CrossRef ]
  38. موتانگا، او. Kumar, L. برنامه های کاربردی موتور Google Earth. Remote Sens. ۲۰۱۹ , ۱۱ , ۵۹۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  39. تمیمینیا، اچ. صالحی، ب. مهدیان پری، م. کواکنبوش، ال. عادلی، س. Brisco، B. Google Earth Engine برای کاربردهای داده های بزرگ جغرافیایی: یک متاآنالیز و بررسی سیستماتیک. ISPRS J. Photogramm. Remote Sens. ۲۰۲۰ , ۱۶۴ , ۱۵۲–۱۷۰٫ [ Google Scholar ] [ CrossRef ]
  40. بان، ی. ژانگ، پی. ناستی، آ. Bevington، AR; Wulder، MA نزدیک به نظارت بر پیشرفت آتش‌سوزی در زمان واقعی با سری زمانی Sentinel-1 SAR و یادگیری عمیق. علمی جمهوری ۲۰۲۰ ، ۱۰ ، ۱۳۲۲٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
  41. جانسون، پی. کای، ز. ملاس، ای. فریدل، MA; Eklundh, L. روشی برای تخمین قوی فصلی بودن پوشش گیاهی از داده های سری زمانی Landsat و Sentinel-2. Remote Sens. ۲۰۱۸ , ۱۰ , ۶۳۵٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  42. دوستالوا، ا. لانگ، ام. ایوانوف، جی. Waser, LT; واگنر، W. طبقه بندی جنگل های گسترده اروپا بر اساس داده های Sentinel-1. Remote Sens. ۲۰۲۱ , ۱۳ , ۳۳۷٫ [ Google Scholar ] [ CrossRef ]
  43. مرادی، ف. صادقی، اس ام ام; حیدرلو، HB; دلجویی، ع. بوشکار، ای. برز، SA برآورد زیست توده بالای زمین در جنگل بلوط پراکنده مدیترانه ای با استفاده از داده های Sentinel-2. ان برای. Res. ۲۰۲۲ ، ۶۵ ، ۱۶۵-۱۸۲٫ [ Google Scholar ]
  44. فیری، دی. سیمواندا، م. سالکین، اس. Nyirenda، VR؛ مورایاما، ی. داده های Ranagalage، M. Sentinel-2 برای نقشه برداری پوشش زمین/استفاده: یک بررسی. Remote Sens. ۲۰۲۰ , ۱۲ , ۲۲۹۱٫ [ Google Scholar ] [ CrossRef ]
  45. کومیسارنکو، وی. وورمانسیک، ک. الشاوی، ر. Sakr، S. بهره‌برداری از سری‌های زمانی Sentinel-1 و Sentinel-2 برای شناسایی رویدادهای درو علفزار با استفاده از یادگیری عمیق با منطقه رد. علمی Rep. ۲۰۲۲ , ۱۲ , ۹۸۳٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
  46. مرسیر، ا. بتبدر، جی. بودری، جی. لو روکس، وی. اسپیچر، اف. لاکوکس، جی. راجر، دی. Hubert-Moy, L. ارزیابی سری های زمانی سنتینل-۱ و ۲ برای پیش بینی مراحل فنولوژیک گندم و کلزا. ISPRS J. Photogramm. Remote Sens. ۲۰۲۰ , ۱۶۳ , ۲۳۱–۲۵۶٫ [ Google Scholar ]
  47. فلگری، س. شریفی، ع. مروج، ک. امین، م. گلچین، ع. مزیرفوتی، ع. طارق، ع. ژائو، ن. ادغام تصاویر ماهواره ای Sentinel 1 و Sentinel 2 برای نقشه برداری محصول. Appl. علمی ۲۰۲۱ ، ۱۱ ، ۱۰۱۰۴٫ [ Google Scholar ] [ CrossRef ]
  48. گلدبلات، آر. تو، دبلیو. هانسون، جی. Khandelwal، AK تشخیص مرزهای مناطق شهری در هند: مجموعه داده ای برای طبقه بندی تصاویر مبتنی بر پیکسل در موتور Google Earth. Remote Sens. ۲۰۱۶ ، ۸ ، ۶۳۴٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
  49. مجیدی، ج. نامو، ال. امپاندلی، اس. Mabhaudhi، T. کاربرد طبقه‌بندی‌کننده تصادفی جنگل برای نقشه‌برداری مناطق آبی با استفاده از موتور Google Earth. Remote Sens. ۲۰۲۱ , ۱۳ , ۸۷۶٫ [ Google Scholar ] [ CrossRef ]
  50. پولیگه، جی. Lupia, F. نقشه برداری از الگوهای فضایی کشاورزی شهری در رم (ایتالیا) با استفاده از Google Earth و خدمات نقشه برداری وب. سیاست کاربری زمین ۲۰۱۶ ، ۵۹ ، ۴۹-۵۸٫ [ Google Scholar ] [ CrossRef ]
  51. خانال، س. فولتون، جی. کلوپفنشتاین، آ. دوریداس، ن. Shearer, S. ادغام داده‌های سنجش از دور با وضوح بالا و تکنیک‌های یادگیری ماشین برای پیش‌بینی فضایی ویژگی‌های خاک و عملکرد ذرت. محاسبه کنید. الکترون. کشاورزی ۲۰۱۸ ، ۱۵۳ ، ۲۱۳-۲۲۵٫ [ Google Scholar ] [ CrossRef ]
  52. رمضان، ج. وارنر، تی. ماکسول، الف. ارزیابی راهبردهای تنظیم نمونه‌برداری و اعتبارسنجی متقابل برای طبقه‌بندی یادگیری ماشین در مقیاس منطقه‌ای. Remote Sens. ۲۰۱۹ , ۱۱ , ۱۸۵٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  53. چی، م. فنگ، آر. Bruzzone، L. طبقه‌بندی داده‌های سنجش از دور فراطیفی با SVM اولیه برای مشکل مجموعه داده‌های آموزشی با اندازه کوچک. Adv. Space Res. ۲۰۰۸ ، ۴۱ ، ۱۷۹۳-۱۷۹۹٫ [ Google Scholar ] [ CrossRef ]
  54. گانز، اس. آدلر، پی. Kändler, G. نقشه پوشش جنگل بر اساس ترکیبی از تصاویر هوایی و داده های ماهواره Sentinel-2 در مقایسه با داده های موجودی جنگل ملی. Forests ۲۰۲۰ , ۱۱ , ۱۳۲۲٫ [ Google Scholar ] [ CrossRef ]
  55. ژانگ، ایکس. لانگ، تی. او، جی. گوا، ی. یین، آر. ژانگ، ز. شیائو، اچ. لی، ام. چنگ، ب. تولید سریع نقشه پوشش جنگلی جهانی با استفاده از Landsat بر اساس مناطق اکولوژیکی جنگلی. J. Appl. Remote Sens. ۲۰۲۰ , ۱۴ , ۰۲۲۲۱۱٫ [ Google Scholar ] [ CrossRef ]
  56. میرهاشمی، ح. مرادی، ف. پوربابایی، ح. مزبانی، ع. تغییرات فلور، اشکال زندگی و پراکنش جغرافیایی گونه‌های گیاهی علفی در طول یک شیب ارتفاعی در جنگل‌های بلوط ایران. کاسپ جی. محیط زیست. علمی ۲۰۲۱ ، ۱۹ ، ۶۱۹-۶۲۷٫ [ Google Scholar ]
  57. عطارود، پ. رستمی، ف. دولتشاهی، ع. صادقی، اس ام ام; زاهدی امیری، غ. بایرام زاده، وی. آیا تغییرات پارامترهای هواشناسی و تبخیر و تعرق بر کاهش جنگل های بلوط ایران تأثیر می گذارد؟ جی. برای. علمی ۲۰۱۶ ، ۶۲ ، ۵۵۳-۵۶۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  58. فتحی زاده، ا. صادقی، اس ام ام; پژوهان، ط. قنبری، س. عطارود، پ. Su، L. تغییرپذیری فضایی و تعداد بهینه باران سنج برای نمونه برداری از زیر درختان بلوط منفرد در طول دوره بدون برگ. Forests ۲۰۲۱ , ۱۲ , ۵۸۵٫ [ Google Scholar ] [ CrossRef ]
  59. عطارود، پ. صادقی، اس ام ام; پایپکر، تی. بایرام زاده، وی. زوال درختان بلوط; نشانه ای از تأثیرات تغییرپذیری آب و هوا در غرب ایران. کاسپ جی. محیط زیست. علمی ۲۰۱۷ ، ۱۵ ، ۳۷۳-۳۸۴٫ [ Google Scholar ]
  60. عبدی، ا. صوفی مریو، ح. مشایخی، ز. دلجویی، ع. رهبریسی سخت، س. تغییرات فصلی دقت و دقت GPS در نقشه برداری جاده جنگل. گاو نر Transilv. Uni. سوتین. سر. II برای. چوب صنعت کشاورزی. مهندس غذا ۲۰۲۲ ، ۱۵ ، ۱-۱۲٫ [ Google Scholar ] [ CrossRef ]
  61. فتحی زاده، ا. صادقی، اس ام ام; نگهدارنده، سی دی; سو، L. فنولوژی برگ الگوهای ریزش فضایی-زمانی را تحت یک کوئرکوس castaneifolia CAMey منفرد هدایت می کند. Forests ۲۰۲۰ , ۱۱ , ۶۸۸٫ [ Google Scholar ] [ CrossRef ]
  62. مین-نورن، ام. Pflug، B. لوئیس، جی. دباکر، وی. مولر-ویلم، U. Gascon، F. Sen2Cor برای Sentinel-2. در مجموعه مقالات پردازش تصویر و سیگنال برای سنجش از دور XXIII، ورشو، لهستان، ۱ تا ۱۳ سپتامبر ۲۰۱۷٫ پ. ۱۰۴۲۷۰۴٫ [ Google Scholar ]
  63. طاووس، بی. کوکامن، س. نفسلی اوغلو، اچ. Gokceoglu، C. یک رویکرد ترکیبی برای نقشه برداری سیل با استفاده از مجموعه داده Sentinel-1 و Sentinel-2. بین المللی قوس. فتوگرام حسگر از راه دور اسپات. Inf. علمی ۲۰۲۰ ، ۴۳ ، ۶۴۱-۶۴۸٫ [ Google Scholar ] [ CrossRef ]
  64. فیلیپونی، F. Sentinel-1 GRD گردش کار پیش پردازش. مجموعه مقالات ۲۰۱۹ ، ۱۸ ، ۱۱٫ [ Google Scholar ]
  65. لی، جی.اس. یورکویچ، ال. دوائل، پی. Wambacq، P. Oosterlinck، A. Speckle Filtering از تصاویر رادار دیافراگم مصنوعی: یک بررسی. Remote Sens. Rev. ۱۹۹۴ , ۸ , ۳۱۳-۳۴۰٫ [ Google Scholar ] [ CrossRef ]
  66. Huete، AR A Soil Adjusted Vegetation Index (SAVI). سنسور از راه دور محیط. ۱۹۸۸ ، ۲۵ ، ۲۹۵-۳۰۹٫ [ Google Scholar ] [ CrossRef ]
  67. پری، سی آر، جونیور؛ Lautenschlager، LF هم ارزی عملکردی شاخص های پوشش گیاهی طیفی. سنسور از راه دور محیط. ۱۹۸۴ ، ۱۴ ، ۱۶۹-۱۸۲٫ [ Google Scholar ] [ CrossRef ]
  68. سبحانی، پ. اسماعیل زاده، ح. برقجلوه، س. صادقی، اس ام ام; Marcu، MV یکپارچگی زیستگاه در مناطق حفاظت شده در معرض تهدید تغییرات LULC و تکه تکه شدن: مطالعه موردی در استان تهران، ایران. Land ۲۰۲۲ , ۱۱ , ۶٫ [ Google Scholar ] [ CrossRef ]
  69. Gitelson، AA; Merzlyak، MN تجزیه و تحلیل امضای طیف بازتاب برگ: الگوریتم Fevelopment برای سنجش از دور کلروفیل. J. گیاه فیزیول. ۱۹۹۶ ، ۱۴۸ ، ۴۹۴-۵۰۰٫ [ Google Scholar ] [ CrossRef ]
  70. دلگیدو، جی. ورلست، جی. آلونسو، ال. مورنو، جی. ارزیابی نوارهای لبه قرمز Sentinel-2 برای تخمین تجربی LAI سبز و محتوای کلروفیل. Sensors ۲۰۱۱ , ۱۱ , ۷۰۶۳-۷۰۸۱٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  71. فالورنی، جی. Teles، V. Vivoni، ER; سوتین، RL; آماراتونگا، تحلیل KS و مشخص کردن دقت عمودی مدل‌های ارتفاعی دیجیتال از ماموریت توپوگرافی رادار شاتل. جی. ژئوفیز. Res. زمین گشت و گذار. ۲۰۰۵ ، ۱۱۰ ، ۱-۲۰٫ [ Google Scholar ] [ CrossRef ]
  72. شوگ، اف. فرانتز، دی. اوکوجنی، ا. ون در لیندن، اس. Hostert، P. نقشه برداری شیب شهری-روستایی سکونتگاه ها و پوشش گیاهی در Acale ملی با استفاده از معیارهای سنتینل-۲ طیفی-زمانی و عدم اختلاط مبتنی بر رگرسیون با داده های آموزشی مصنوعی. سنسور از راه دور محیط. ۲۰۲۰ , ۲۴۶ , ۱۱۱۸۱۰٫ [ Google Scholar ] [ CrossRef ]
  73. بریمن، ال. جنگل های تصادفی. ماخ فرا گرفتن. ۲۰۰۱ ، ۴۵ ، ۵-۳۲٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  74. نصیری، و. دلجویی، ع. مرادی، ف. صادقی، اس ام ام; نقشه برداری کاربری زمین و پوشش زمین برز، SA با استفاده از تصاویر ماهواره ای Sentinel-2، Landsat-8 و موتور Google Earth: مقایسه دو روش ترکیبی. Remote Sens. ۲۰۲۲ , ۱۴ , ۱۹۷۷٫ [ Google Scholar ] [ CrossRef ]
  75. لیو، پی. چو، K.-KR; وانگ، ال. هوانگ، F. SVM یا یادگیری عمیق؟ مطالعه تطبیقی ​​طبقه بندی تصاویر سنجش از دور. محاسبات نرم. ۲۰۱۷ ، ۲۱ ، ۷۰۵۳-۷۰۶۵٫ [ Google Scholar ] [ CrossRef ]
  76. نخل.؛ Mather، ماشین‌های بردار پشتیبان PM برای طبقه‌بندی در سنجش از دور. بین المللی J. Remote Sens. ۲۰۰۵ ، ۲۶ ، ۱۰۰۷-۱۰۱۱٫ [ Google Scholar ] [ CrossRef ]
  77. مونتراکیس، جی. من، جی. Ogole, C. ماشین‌های بردار پشتیبانی در سنجش از راه دور: یک بررسی. ISPRS J. Photogramm. Remote Sens. ۲۰۱۱ , ۶۶ , ۲۴۷-۲۵۹٫ [ Google Scholar ] [ CrossRef ]
  78. Loh، WY طبقه بندی و رگرسیون درختان. حداقل داده بدانید. کشف کنید. ۲۰۱۱ ، ۱ ، ۱۴-۲۳٫ [ Google Scholar ] [ CrossRef ]
  79. فریدل، MA; برادلی، طبقه‌بندی درخت تصمیم CE پوشش زمین از داده‌های سنجش از دور. سنسور از راه دور محیط. ۱۹۹۷ ، ۶۱ ، ۳۹۹-۴۰۹٫ [ Google Scholar ] [ CrossRef ]
  80. پراتیکو، اس. سولانو، اف. دی فازیو، اس. Modica، G. طبقه‌بندی یادگیری ماشینی زیستگاه‌های جنگلی مدیترانه‌ای در موتور Google Earth براساس سری‌های زمانی Seasonal Sentinel-2 و بهینه‌سازی ترکیب تصویر ورودی. Remote Sens. ۲۰۲۱ , ۱۳ , ۵۸۶٫ [ Google Scholar ] [ CrossRef ]
  81. مک نمار، کیو. توجه به خطای نمونه گیری تفاوت بین نسبت ها یا درصدهای همبسته. Psychometrika ۱۹۴۷ ، ۱۲ ، ۱۵۳-۱۵۷٫ [ Google Scholar ] [ CrossRef ]
  82. Jaron, LR; Coops، NC; مکنزی، WH; تومپالسکی، پ. Dykstra، P. تشخیص ساختار جنگل زیر سایه با استفاده از هوابرد LiDAR. سنسور از راه دور محیط. ۲۰۲۰ , ۲۴۴ , ۱۱۱۷۷۰٫ [ Google Scholar ] [ CrossRef ]
  83. نوویل، آر. بیتس، جی اس. Jonard، F. برآورد ساختار جنگل از ابر نقطه‌ای LiDAR با پهپاد با استفاده از یادگیری ماشین. Remote Sens. ۲۰۲۱ , ۱۳ , ۳۵۲٫ [ Google Scholar ] [ CrossRef ]
  84. ریشماوی، ک. هوانگ، سی. Zhan, X. نظارت بر ویژگی‌های کلیدی ساختار جنگل در سراسر ایالات متحده با ادغام اندازه‌گیری‌های GEDI LiDAR و داده‌های VIIRS. Remote Sens. ۲۰۲۱ , ۱۳ , ۴۴۲٫ [ Google Scholar ] [ CrossRef ]
  85. بلند، ام. پارکر، جی. اسپارو، بی. هاردینگ، دی. چسمر، ال. فین، اس. آنتوناراکیس، ا. Strahler، A. در مورد ترویج استفاده از سیستم های لیدار در تحقیقات اکوسیستم جنگلی. برای. Ecol. مدیریت ۲۰۱۹ , ۴۵۰ , ۱۱۷۴۸۴٫ [ Google Scholar ] [ CrossRef ]
  86. ویگینز، HL; نلسون، CR; لارسون، ای جی؛ Safford، HD با استفاده از LiDAR برای توسعه مدل‌های مرجع با وضوح بالا ساختار جنگل و الگوی فضایی. برای. Ecol. مدیریت ۲۰۱۹ ، ۴۳۴ ، ۳۱۸-۳۳۰٫ [ Google Scholar ] [ CrossRef ]
  87. ژو، ال. منگ، آر. تان، ی. Lv، Z. ژائو، ی. خو، بی. ژائو، اف. مقایسه LiDAR مبتنی بر پهپاد و فتوگرامتری هوایی دیجیتال برای اندازه‌گیری ارتفاع سایبان در سطح تاج در محیط شهری. شهری برای. سبز شهری. ۲۰۲۲ ، ۶۹ ، ۱۲۷۴۸۹٫ [ Google Scholar ] [ CrossRef ]
  88. Abdi، AM Land Vover و عملکرد طبقه‌بندی کاربری زمین الگوریتم‌های یادگیری ماشین در یک منظره شمالی با استفاده از داده‌های Sentinel-2. GIScience Remote Sens. ۲۰۲۰ ، ۵۷ ، ۱-۲۰٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  89. مائو، دبلیو. لو، دی. هو، ال. لیو، ایکس. Yue, W. مقایسه روش‌های یادگیری ماشینی برای نقشه‌برداری کاربری اراضی شهری در شهر هانگژو، چین. Remote Sens. ۲۰۲۰ , ۱۲ , ۲۸۱۷٫ [ Google Scholar ] [ CrossRef ]
  90. رانا، VK; Suryanarayana، روش تصمیم گیری چند معیاره مبتنی بر GIS TMV برای شناسایی مناطق ذخیره رواناب بالقوه در حوزه آبخیز. ان GIS ۲۰۲۰ ، ۲۶ ، ۱۴۹-۱۶۸٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  91. آدوگنا، تی. خو، دبلیو. Fan, J. مقایسه طبقه‌بندی‌کننده‌های ماشین بردار تصادفی جنگل و پشتیبان برای نقشه‌برداری پوشش زمین منطقه‌ای با استفاده از تصاویر با وضوح درشت FY-3C. Remote Sens. ۲۰۲۲ , ۱۴ , ۵۷۴٫ [ Google Scholar ] [ CrossRef ]
  92. شتی، اس. گوپتا، پی کی. بلژیک، م. Srivastav، S. ارزیابی تأثیر طراحی نمونه‌گیری آموزش بر عملکرد طبقه‌بندی‌کننده‌های یادگیری ماشین برای نقشه‌برداری پوشش زمین با استفاده از داده‌های سنجش از راه دور چند زمانی و موتور Google Earth. Remote Sens. ۲۰۲۱ , ۱۳ , ۱۴۳۳٫ [ Google Scholar ] [ CrossRef ]
  93. ساباط تومالا، ع. راچکو، ای. Zagajewski، B. مقایسه ماشین بردار پشتیبان و الگوریتم‌های جنگل تصادفی برای طبقه‌بندی گونه‌های مهاجم و گسترده با استفاده از داده‌های ابرطیفی هوابرد. Remote Sens. ۲۰۲۰ , ۱۲ , ۵۱۶٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  94. راچکو، ای. Zagajewski، B. مقایسه طبقه‌بندی‌کننده‌های ماشین بردار پشتیبان، جنگل تصادفی و شبکه عصبی برای طبقه‌بندی گونه‌های درختی در تصاویر APEX فراطیفی هوابرد. یورو J. Remote Sens. ۲۰۱۷ ، ۵۰ ، ۱۴۴-۱۵۴٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  95. لی، ایکس. چن، دبلیو. چنگ، ایکس. وانگ، ال. مقایسه الگوریتم های یادگیری ماشین برای نقشه برداری از مناظر پیچیده سطحی و کشاورزی با استفاده از تصاویر ماهواره ای استریو ZiYuan-3. Remote Sens. ۲۰۱۶ , ۸ , ۵۱۴٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  96. شائو، ی. Lunetta، RS مقایسه الگوریتم‌های پشتیبان ماشین بردار، شبکه عصبی و CART برای طبقه‌بندی پوشش زمین با استفاده از نقاط داده آموزشی محدود. ISPRS J. Photogramm. Remote Sens. ۲۰۱۲ ، ۷۰ ، ۷۸-۸۷٫ [ Google Scholar ] [ CrossRef ]
  97. Thanh Noi، P. کاپاس، ام. مقایسه طبقه‌بندی‌کننده‌های جنگل تصادفی، k-نزدیک‌ترین همسایه و ماشین بردار پشتیبان برای طبقه‌بندی پوشش زمین با استفاده از تصاویر Sentinel-2. Sensors ۲۰۱۷ , ۱۸ , ۱۸٫ [ Google Scholar ] [ CrossRef ] [ PubMed ][ نسخه سبز ]
  98. ریمال، بی. رجال، س. Kunwar، R. مقایسه ماشین‌های بردار پشتیبان و طبقه‌بندی‌کننده‌های حداکثر احتمال برای نقشه‌برداری شهرنشینی. J. شرکت هندی Remote Sens. ۲۰۲۰ , ۴۸ , ۷۱–۷۹٫ [ Google Scholar ] [ CrossRef ]
  99. آدامز، بی. آیورسون، ال. متیوز، اس. پیترز، ام. پراساد، ع. Hix، نقشه برداری DM ترکیب جنگل با سری زمانی Landsat: ارزیابی کامپوزیت های فصلی و رگرسیون هارمونیک. Remote Sens. ۲۰۲۰ , ۱۲ , ۶۱۰٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  100. آذری، گ. لوبل، دی. طبقه‌بندی مبتنی بر لندست در ابر: فرصتی برای تغییر پارادایم در نظارت بر پوشش زمین. سنسور از راه دور محیط. ۲۰۱۷ ، ۲۰۲ ، ۶۴-۷۴٫ [ Google Scholar ] [ CrossRef ]
  101. Pflugmacher، D.; رابه، ا. پیترز، ام. Hostert، P. نقشه پوشش زمین پان-اروپایی ۲۰۱۵ بر اساس داده های Landsat و LUCAS. نقشه برداری پوشش زمین پان-اروپایی با استفاده از متریک های طیفی-زمانی Landsat و بررسی اروپایی LUCAS. سنسور از راه دور محیط. ۲۰۱۹ ، ۲۲۱ ، ۵۸۳-۵۹۵٫ [ Google Scholar ] [ CrossRef ]
  102. تانگ، ز. ادیکاری، ح. Pellikka، PK؛ Heiskanen, J. روشی برای پیش‌بینی مشاهدات گم‌شده با ناحیه بزرگ در سری‌های زمانی Landsat با استفاده از متریک‌های طیفی-زمانی. بین المللی J. Appl. رصد زمین. Geoinf. ۲۰۲۱ ، ۹۹ ، ۱۰۲۳۱۹٫ [ Google Scholar ] [ CrossRef ]
  103. دی لوکا، جی. MN سیلوا، جی. دی فازیو، اس. Modica، G. استفاده یکپارچه از داده های Sentinel-1 و Sentinel-2 و الگوریتم های یادگیری ماشین منبع باز برای نقشه برداری پوشش زمین در یک منطقه مدیترانه. یورو J. Remote Sens. ۲۰۲۲ ، ۵۵ ، ۵۲-۷۰٫ [ Google Scholar ] [ CrossRef ]
  104. Tavares، PA; بلترائو، NES؛ گیماراس، ایالات متحده؛ تئودورو، ادغام AC Sentinel-1 و Sentinel-2 برای طبقه بندی و نقشه برداری LULC در منطقه شهری بلم، آمازون شرقی برزیل. Sensors ۲۰۱۹ , ۱۹ , ۱۱۴۰٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
  105. بورخس، جی. Higginbottom، TP; سیمئوناکیس، ای. داده های جونز، M. Sentinel-1 و Sentinel-2 برای نقشه برداری پوشش زمین ساوانا: بهینه سازی ترکیب حسگرها و فصول. Remote Sens. ۲۰۲۰ , ۱۲ , ۳۸۶۲٫ [ Google Scholar ] [ CrossRef ]
  106. شرستا، بی. احمد، س. استفان، اچ. ترکیب داده‌های Sentinel-1 و Sentinel-2 در نقشه‌برداری از سطوح نفوذناپذیر در مقیاس شهر. محیط زیست نظارت کنید. ارزیابی کنید. ۲۰۲۱ ، ۱۹۳ ، ۵۵۶٫ [ Google Scholar ] [ CrossRef ] [ PubMed ]
  107. برز، س. چتا، م. بیردا، م. Proto، AR طبقه‌بندی رویدادهای عملیاتی در Cable Yarding توسط یک برنامه یادگیری ماشینی برای داده‌های جمع‌آوری‌شده توسط GNSS: مطالعه موردی در سراشیبی با کمک جاذبه. گاو نر Transilv. Uni. سوتین. سر. II برای. چوب صنعت کشاورزی. مهندس غذا ۲۰۲۲ ، ۱۵ ، ۱۳-۳۲٫ [ Google Scholar ] [ CrossRef ]
شکل ۱٫ موقعیت جغرافیایی منطقه مورد مطالعه.
شکل ۲٫ نمودار گردش کار مراحل اصلی روش شناختی.
شکل ۳٫ نمونه ای از اندازه گیری سطح نمودار درصد پوشش تاج جنگل (FCC%) با استفاده از تصاویر با وضوح بالا و نقاط نمونه شبکه بندی شده Google Earth.
شکل ۴٫ توزیع نمونه های آموزشی و اعتبار سنجی در منطقه تحقیقاتی (نقاط نشان دهنده مراکز نمودار). برای تصویر بهتر، از یک بافر ۵۰ متری در اطراف قطعات مربعی استفاده شد.
شکل ۵٫ ( الف ) قطعات پراکنده و ( ب ) باقیمانده پوشش تاج پوشش جنگلی اندازه گیری و برآورد شده (FCC).
شکل ۶٫ نقشه های پوشش تاج جنگل (FCC) تولید شده توسط مدل های یادگیری ماشین و مجموعه داده کامل.
شکل ۷٫ امتیاز سطح کلاس F-1 برای همه مدل های یادگیری ماشین و تغییر در دقت زمانی که از مجموعه داده با چگالی بالاتر استفاده می شود. مجموعه داده کامل: همه تصاویر S-1 و S-2 بین ۱ ژوئیه تا ۳۰ سپتامبر ۲۰۲۰ ± ۱، مجموعه داده ۱ ساله: همه تصاویر S-1 و S-2 بین ۱ ژوئیه تا ۳۰ سپتامبر ۲۰۲۰، NF: غیر جنگل، SF: جنگل تنک، MDF: جنگل با تراکم متوسط، و DF: جنگل انبوه.
شکل ۸٫ امتیاز سطح کلاس F-1 برای همه مدل های یادگیری ماشین و تغییر در دقت زمانی که از مجموعه داده با چگالی بالاتر استفاده می شود. مجموعه داده کامل: همه تصاویر S-1 و S-2 بین ۱ ژوئیه تا ۳۰ سپتامبر ۲۰۲۰ ± ۱، فقط تصاویر S-2 بین ۱ ژوئیه تا ۳۰ سپتامبر در سال ۲۰۲۰ ± ۱، NF: غیر جنگلی، SF: جنگل کم، MDF: جنگل با تراکم متوسط ​​و DF: جنگل متراکم.

دیدگاهتان را بنویسید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *

خانهدربارهتماسارتباط با ما