الگوهای هم‌مکانی نوع کاوی- β در مرکزیت نزدیکی در مجموعه‌های داده‌های فضایی


چکیده

الگوی هم‌مکانی مجموعه‌ای از ویژگی‌های فضایی است که نمونه‌های آن اغلب در فضا با یکدیگر مرتبط هستند. مدل های استخراج آن همیشه از دو مرحله ضروری تشکیل شده است. یک مرحله ایجاد روابط همسایه بین نمونه‌های فضایی است و مرحله دیگر بررسی شیوع الگوهای کاندید در روابط مثلث‌بندی دسته، ستاره یا دلونه است. در این مقاله حداقل به سه موضوع اصلی پرداخته شده است. اول، از آنجایی که مناطق مختلف فضایی، تراکم توزیع متفاوت، تنظیم پارامترهای مناسب برای ایجاد روابط همسایه ایده آل دشوار است. دوم، رابطه دسته و دیگران آنقدر سفت و سخت است که منافع شخصی کاربران سرکوب می شود. برخی از الگوهای جالب بدون افزایش افزونگی نادیده گرفته می شوند. سوم، قدرت متفاوت همبستگی بین نمونه ها در محاسبه شیوع نادیده گرفته می شود. این باعث می شود که همبستگی بین ویژگی ها تمایز نیافته باشد. بر این اساس، کار اصلی این مقاله شامل موارد زیر است: (۱) تولید رابطه همسایه را می توان با این ایده بهبود بخشید که فواصل بین یک نمونه و هیچ یک از همسایگان آن تفاوت قابل توجهی ندارد. (۲) نوع βالگوی هم‌مکانی بر اساس یک اتفاق همزمان تعریف و بررسی می‌شود که در آن مرکز نزدیکی هر نمونه کمتر از یک آستانه معین نباشد. β. (۳) از آنجایی که مرکزیت نزدیکی دارای قدرت همبستگی بین نمونه ها است، قدرت همبستگی بین یک ویژگی و سایر موارد در یک نوع βالگوی هم‌مکانی را می‌توان با محاسبه شیوع ارزیابی کرد. در نهایت، آزمایش‌ها بر روی مجموعه داده‌های مکانی مصنوعی و دنیای واقعی برای ارزیابی اثربخشی و کارایی کارهای ما استفاده می‌شوند. نتایج نشان می دهد که روابط همسایه فضایی کمتری ایجاد می شود و الگوهای جالب تری را می توان با تنظیم انعطاف پذیر کشف کرد. βبا توجه به ترجیحات کاربر

کلید واژه ها:

داده کاوی مکانی ; الگوی هم‌مکانی نوع β رابطه توپولوژیکی فضایی ; نزدیکی مرکزیت ; قدرت همبستگی

۱٫ مقدمه

داده کاوی فضایی با پیشرفت فناوری جمع آوری و پردازش داده ها به اوج خود رسیده است. یکی از مهمترین علایق پژوهشی در این حوزه، الگوی کاوی هم مکان [ ۱ ] است. برای کاوی الگوی هم‌مکانی در مجموعه‌های داده‌های مکانی، یک ویژگی فضایی برچسب برخی از اشیا (به عنوان مثال، شبدر) است. علاوه بر این، یک نمونه شی یک ویژگی با اطلاعات مکان است. الگوی هم‌مکانی مجموعه‌ای از ویژگی‌های فضایی است که نمونه‌های آن اغلب با هم در یک فضای جغرافیایی قرار دارند [ ۲ ]. برای مثال، الگوی هم‌مکانی {شدر، زنبور، موش، گربه، گاو} نشان می‌دهد که نمونه‌هایی از ویژگی‌های فضایی در این الگو یک سیستم اکولوژیکی دام سالم می‌سازد [ ۳ ]]. استخراج الگوی هم‌مکانی به‌طور گسترده در حوزه‌هایی مانند حفاظت اکولوژیکی، بهداشت عمومی، برنامه‌ریزی شهری، توزیع آگهی و غیره به کار می‌رود، زیرا الگوهای هم‌مکانی ممکن است همزمانی ویژگی‌های فضایی را آشکار کنند [ ۴ ].
به طور کلی، دو مرحله اصلی برای استخراج الگوهای هم‌مکانی در مدل‌های سنتی وجود دارد.
یک مرحله ایجاد روابط همسایه فضایی در نمونه هایی از مجموعه داده های مکانی داده شده است. روابط همسایه (یعنی مجاورت فضایی) از قانون اول جغرافیای توبلر پیروی می کند: همه چیز به هر چیز دیگری مربوط است، اما چیزهای نزدیک بیشتر از چیزهای دور مرتبط هستند. با این حال، قانون دوم جغرافیایی گودهیلد ادعا می کند که متغیرهای جغرافیایی واریانس کنترل نشده ای از خود نشان می دهند. یعنی همسایه های ایده آل نه تنها با فواصل (قانون اول) همبستگی دارند، بلکه با تراکم توزیع منطقه ای نیز مرتبط هستند (قانون دوم). به عنوان مثال، فرض کنید A1 و D1 در شکل ۱ همسایه هستند، A1 و B1 نیز همینطور هستند. اگرچه فاصله بین A3 و B3 مشابه فاصله بین B2 و D1 است، اما به دلیل تراکم توزیع منطقه ای متفاوت، همبستگی قوی تری بین A3 و B3 نسبت به بین B2 و D1 وجود دارد.
مرحله دیگر بررسی شیوع الگوهای نامزد در روابط همسایه فضایی است. نمونه‌های هر الگو (یعنی چک‌لیست‌های شیوع) باید روی هم‌روندی مانند دسته [ ۵ ]، ستاره [ ۶ ]، یا روابط مبتنی بر مثلث [ ۷ ] باشد. به طور کلی، هر چه نسبت هم‌رویدادها بیشتر باشد، شیوع این الگو بیشتر می‌شود. به عنوان مثال، {A2، B2، C2، D2} آشکارا از شیوع {A، ​​B، C، D} پشتیبانی می‌کند، حتی اگر یک دسته یا ستاره در شکل ۱ ج نباشد.

۱٫۱٫ انگیزه

اگرچه بسیاری از محققان درگیر تحقیقات مرتبط بوده اند، حداقل سه مشکل باقی مانده است.
  • ساختن مدلی برای ایجاد روابط همسایه برای تطبیق مجموعه داده‌ها با تراکم‌های توزیع مختلف دشوار است. برای به دست آوردن روابط همسایه با تراکم ها، بسیاری از محققان راه حل های مختلفی را پیشنهاد کرده اند. شکل ۱برخی از رویکردهای نماینده در آستانه های فاصله، مانند KNN و مثلث دلونی را نشان می دهد. به عنوان مثال، شهودی است که A1 و B1 در یک منطقه متراکم همسایه یکدیگر هستند، و همچنین A3 و B3 در یک منطقه پراکنده. برعکس، شهودی است که B2 و D1 همسایه یکدیگر نیستند در حالی که B3 و D3 همسایه هستند. در نتیجه، تعیین آستانه فاصله بهینه برای ایجاد روابط همسایه حتی برای کاربران آزمایشی کار دوستانه نیست زیرا (الف) آستانه فاصله بسیار کوچک ممکن است شیوع الگوها را در مناطق پراکنده دست کم بگیرد (به عنوان مثال، شکل ۱ a) در حالی که ( ب) یک الگوی خیلی بزرگ ممکن است شیوع الگوها را در مناطق متراکم بیش از حد تخمین بزند (به عنوان مثال، شکل ۱ب). به عنوان مثال، A1 و D1 را نباید همسایه یکدیگر در نظر گرفت، در حالی که D1 و E1 را می توان همسایه یکدیگر در شکل ۱ d در نظر گرفت. علاوه بر این، روابط همسایه در مناطق چگالی مختلف می‌تواند همپوشانی داشته باشد اما تقسیم نشود. این بزرگترین تفاوت بین استخراج الگوی هم‌مکانی و تحلیل ارتباط مبتنی بر تراکنش است. به عنوان مثال، D1 و E1 می توانند در یک منطقه متراکم همسایه یکدیگر باشند، و همچنین B2 و E1 در یک منطقه پراکنده می توانند همسایه یکدیگر باشند. بنابراین، این بیانیه برای خوشه بندی کلاسیک مناسب نیست.
  • نمونه یک الگو باید همزمان باشد، و سپس ادغام و گسترش همزمانی‌های سنتی مانند دسته، ستاره و غیره عالی است [ ۸ ]. به عنوان مثال، {A2، B2، C2، D2} پیشنهاد می‌شود که نمونه‌ای از {A، B، C، D} نباشد، در حالی که این نمونه بر اساس دسته در شکل ۱ a است. با این حال، همبستگی در {A2، B2، C2، D2} نیز قوی است. علاوه بر این، {A، B، C، D} به طور انتخابی در سایر مناطق شکل ۱ رخ می دهد . اگر نمونه هایی از الگوها بر اساس دسته باشند، {A, B, C, D} فقط در شکل ۱ می تواند رایج باشد.b هنگامی که آستانه شیوع ۱ باشد. این نمی تواند این انتظار را برآورده کند که ویژگی های {A, B, C, D} به شدت همبستگی دارند. علاوه بر این، کاربران یکسان ممکن است به الگوهایی با همبستگی های مختلف در مجموعه داده های مختلف علاقه مند شوند، چه رسد به کاربران مختلف. برای به دست آوردن الگوهای مورد انتظار، کاربران همیشه باید اندازه پارامتر تولید روابط همسایه یا آستانه شیوع را در مدل‌های استخراج الگوی هم‌مکانی سنتی تغییر دهند. به ناچار منجر به افزونگی می شود. به عنوان مثال، برای به دست آوردن {A, B, C, D} در شکل ۱ ، آستانه شیوع باید به ۱/۳ کاهش یابد اگر روابط همسایه مانند شکل ۱ a باشد، یا آستانه فاصله باید به ۱۶ متر افزایش یابد. در شکل ۱ b زمانی که آستانه شیوع ۱ است.
  • از آنجایی که مدل‌های سنتی شیوع الگوها را به طور کلی بر روی نسبت‌های ظاهری نمونه ویژگی‌ها بررسی می‌کنند، به ناچار توپولوژی نمونه را در روابط همسایه فضایی از دست می‌دهند. به عنوان مثال، می توان اذعان کرد که {B، C، D} بیشتر از {B، D، E} همبستگی دارد، حتی اگر نمونه های هر یک از ویژگی های متناظر در دو الگو با یک تعریف تطبیقی ​​از نمونه های الگو ظاهر شده باشند. همبستگی بین یک ویژگی و سایر ویژگی‌های یک الگو را می‌توان از توپولوژی نمونه‌های الگو ارزیابی کرد. قابل درک است که اگر نمونه‌های یک ویژگی در یک الگو همیشه مرکز بالاتری در توپولوژی داشته باشند، این ویژگی نسبت به سایر ویژگی‌های الگو همبستگی قوی‌تری با سایر ویژگی‌های الگو دارد. چگونه می توان روابط فضایی همسایه را به الگوهای جالب منتقل کرد و انباشت کرد؟ این مشکل نیاز به بررسی فوری دارد. برای مثال، B و C بیشتر در مرکز توپولوژی قرار دارند تا A و D در {A, B, C, D} درشکل ۱ .

۱٫۲٫ راه حل کلی

قابل درک است که فواصل بین هر نمونه و همسایه‌های آن مشابه هستند اما تفاوت زیادی ندارند. به عنوان مثال، B1، C1، و D1 را می توان همسایه A1 در نظر گرفت، اما B2 به این دلیل نیست که به طور شهودی از B1، C1 و D1 بیشتر از A1 در شکل ۱ است. علاوه بر این، A2، B2، C2، D2، و E1 می‌توانند همسایه‌های F1 باشند، اما B3 نمی‌توانند، زیرا B3 آشکارا از A2، B2، C2، D2 و E1 از F1 دورتر است. بنابراین، یک راه قوی با مصالحه بین آستانه فاصله و KNN برای ایجاد یک رابطه همسایه کاربردی تر در این مقاله پیشنهاد شده است. به عنوان مثال نشان داده شده است منتو، فاصله بین منتوو نزدیکترین همسایه آن به جز خودش نشان داده می شود دستی. با توجه به ضریب الاستیک αو یک نمونه منv، اگر فاصله بین منتوو منvفراتر از آن نیست دستی∗α، منvرا می توان همسایه هدایت شده در نظر گرفت منتو. به عنوان مثال، فواصل A1 تا B1، C1، D1، E1 و B2 به ترتیب ۳، ۳٫۲، ۴٫۸، ۱۰٫۷ و ۱۵٫۷ هستند. بنابراین، B1، C1 و D1 به عنوان همسایگان جهت دار A1 در نظر گرفته می شوند که ۱٫۶≥α≤۳٫۶٫ علاوه بر این، برای هر جفت نمونه، اگر و فقط اگر همسایگان هدایت شده یکدیگر باشند، همسایگان متقابل یکدیگر هستند. به عنوان مثال، D1 و E1 همسایه های متقابل یکدیگر هستند، اما A1 و E1 همسایه یکدیگر نیستند، زیرا A1 همسایه هدایت شده E1 است اما برعکس نیست. نمودار رابطه همسایگی متقابل در شکل ۲ ب نشان داده شده است. بدیهی است که یک پایین تر دستیمنطقه متراکم تری را هدایت می کند. برعکس، بزرگتر دستیمنطقه پراکنده تری را هدایت می کند. یعنی آستانه دستی∗αمی تواند به تولید روابط همسایه کمک کند تا با تراکم توزیع منطقه سازگار باشد.
برای اندازه گیری شیوع الگوها، نمونه های آنها باید در روابط همسایه شناسایی شود. محققان تمایل دارند نمونه های الگوها را بر اساس دسته تعریف کنند. دسته یک زیرگراف در نمودار رابطه همسایه فضایی است که در آن هر جفت نمونه همسایه یکدیگر هستند. به عنوان مثال، {A1، B1، C1} یک نمونه از {A، B، C} در شکل ۱ b است. جالب توجه است که مرکزیت نزدیکی [ ۹ ] هر نمونه در یک دسته ۱ است. علاوه بر این، مرکزیت نزدیکی یک گره منتودر n گره قابل دسترسی با خودش، متقابل میانگین کوتاهترین فاصله مسیر است منتوبه طور کلی n-1گره های قابل دسترسی به این معنا که حداقل مرکزیت نزدیکی مصادیق در یک دسته ۱ است. با این حال، برای یک دسته بودن یک اتفاق لازم نیست. همچنین می تواند یک اتفاق قوی مانند ستاره باشد. حداقل مرکزیت نزدیکی نمونه ها در یک ستاره کمتر از ۱/۲ ( ک-۱۲ک-۳>1/2، جایی که k تعداد نمونه ستاره است). بنابراین، برای هر الگوی p ، اگر همزمانی حامل p وجود داشته باشد که حداقل مرکزیت نزدیکی نمونه‌های آن کمتر از یک آستانه معین نباشد. β( ۰<β≤۱در این مقاله ، وقوع همزمان نمونه‌ای از p است.
آستانه βهمبستگی نمونه های الگوها را تنظیم می کند. بزرگتر β، همبستگی های قوی تر یعنی کاربران می توانند یک مناسب تنظیم کنند βبرای تامین منافع فردی آنها اتفاق جدید ما بر اساس مرکزیت نزدیکی می‌تواند گسترشی از دسته و ستاره باشد. برای اتخاذ الگوهای جالب مورد انتظار، کاربران همچنین می توانند اندازه را تغییر دهند βبه جای بازسازی روابط همسایگان یا تغییر آستانه شیوع.
علاوه بر این، برای هر الگو، اگر یک ویژگی در الگو همیشه مرکزیت نزدیکی بالاتری در نمونه الگو داشته باشد، تمایل به مرکزیت نزدیکی بالاتری در الگو دارد. به عبارت دیگر، یک ویژگی در یک الگو که نمونه آن همیشه مرکزیت نزدیکی بالاتری دارد، همیشه همبستگی قوی‌تری با سایر ویژگی‌های الگو دارد. علاوه بر این، توپولوژی نمونه های الگوها به ویژگی های الگو منتقل می شود.
مشارکت های این مقاله در موارد زیر خلاصه می شود:
  • بر این اساس که فاصله بین یک نمونه و همسایگان آن مشابه است، روشی قوی برای ایجاد روابط همسایه معرفی شده است. این روش برای چگالی های توزیع مختلف مجموعه داده های مکانی مناسب است. مزایای آستانه فاصله و نزدیکترین همسایگان را جذب می کند.
  • یک اتفاق همزمان مبتنی بر مرکزیت نزدیکی برای ادغام دسته و ستاره پیشنهاد شده است. این بسط نمونه‌هایی از الگوی هم‌مکانی سنتی است. با تنظیم آستانه می توان آن را به طور انعطاف پذیری مقیاس کرد βبا توجه به علایق کاربر برخی از الگوهای جالب دیگر نادیده گرفته نمی شوند، در حالی که روابط همسایه فضایی و الگوهای شیوع نباید قربانی افزونگی شوند.
  • یک الگوی هم‌مکانی گسترده، به نام نوع βالگوی هم‌مکانی، بر روی مرکزیت نزدیکی پیشنهاد شده است. از آنجایی که مرکزیت نزدیک حامل توپولوژی نمونه ها است، آیا یک ویژگی در مرکز توپولوژی یک نوع قرار دارد یا خیر. βالگوی هم‌مکانی قابل ارزیابی است.
  • برخی از خواص برای هرس الگوهای نامزد نشان داده شده است. الگوریتم های ما که معتبر و جامع بودن آنها ثابت شده است پیشنهاد شده است. علاوه بر این، آنها با استفاده از مجموعه داده های واقعی و مصنوعی مورد آزمایش قرار می گیرند. یافته های کارآزمایی نشان می دهد که چارچوب در مقایسه با برخی از الگوریتم های دیگر با نیازهای کاربران سازگارتر است.
بقیه این مقاله به شرح زیر است. بخش ۲ با مروری بر مدل استاندارد الگوی هم‌مکانی آغاز می‌شود و پس از آن مروری بر تحقیقات قبلی ارائه می‌شود. برای ساختن یک نمودار رابطه همسایه قابل اجرا، بخش ۳ یک استراتژی قوی را توصیف می کند که از مصالحه آستانه فاصله و KNN استفاده می کند. معیارهای شیوع الگو در مرکزیت نزدیکی در بخش ۴ پیشنهاد شده است ، و سپس استانداردی برای ارزیابی تسلط هر ویژگی در الگوها معرفی شده است. علاوه بر این، دو الگوریتم متناظر نیز پیشنهاد شده است. نتایج تجربی در بخش ۵ پیشنهاد شده است. در بخش ۶ ، ما کارهای خود را در این مقاله نتیجه گیری و بحث می کنیم.

۲٫ کارهای مرتبط

در این بخش، هر دو مدل سنتی کاوی الگوی هم‌مکانی و کارهای مرتبط بررسی می‌شوند.

۲٫۱٫ تعاریف و لمای سنتی

با توجه به مجموعه داده های مکانی D با ویژگی های فضایی m ( اف={f1،f2،⋯،fمتر}) و n نمونه ویژگی فضایی ( من={من۱،من۲،⋯،منn}) که در آن هر نمونه دارای یک برچسب ویژگی است [ ۱۰ ].
برای هر جفت نمونه (نشان داده شده است منتوو منv) در یک منطقه نزدیک (مثلا دمنس(منتو،منv)≤دجایی که دمنس(منتو،منv)فاصله بین را برمی گرداند منتوو منv، و d یک آستانه فاصله معین توسط کاربر است)، می گوییم یک رابطه همسایه بین وجود دارد منتوو منv(نشان داده شده است منتوآرمنvیا (منتو،منv)∈آر). بطور کلی، منتوهمسایه خودش است

تعریف  ۱

(گراف رابطه همسایه). با توجه به یک رابطه فضایی همسایه R در مجموعه نمونه I، undigraph جی=(من،آر)نمودار رابطه همسایه فضایی نامیده می شود.
مثال ۱٫ (A1, B1) ∈آردر شکل ۱ الف.
از آنجایی که مناطق مختلف همیشه چگالی توزیع متفاوتی در مجموعه داده‌های مکانی دارند، نمودار رابطه همسایه فضایی گاهی اوقات بر روی نزدیک‌ترین همسایه‌ها نیز تولید می‌شود. این وضعیت در بخش فرعی بررسی بحث شده است.
برای هر زیر مجموعه ای به عنوان مثال من”( من”⊆من)، زیر مجموعه ای متشکل از ویژگی های حمل شده توسط من”مجموعه ویژگی های مربوطه نامیده می شود من”(نشان داده شده است سیافس(من”)) سیافس(من”)={fهآ(منتو)∣منتو∈من”}جایی که fهآ(منتو)ویژگی حمل شده توسط را برمی گرداند منتو.

تعریف  ۲

(نمونه جدول هم مکان سیمنس(پ)) با توجه به یک زیر مجموعه ویژگی غیر خالی p ( پ⊆اف)، اجازه دهید من”زیر مجموعه ای از I باشد که مجموعه ویژگی های مربوطه آن p است. اگر من”دسته ای است که اندازه آن است ∣پ∣. من”یک نمونه هم‌مکانی p نامیده می‌شود (نشان داده می‌شود سیمن(پ)). مجموعه‌ای که شامل همه نمونه‌های هم‌مکانی p است، نمونه جدول هم‌مکانی p نامیده می‌شود. سیمنس(پ)). برای مثال،

سیمنس(پ)={من”∣من”⊆من،∣من”∣=∣پ∣،سیافس(من”)=پ،(∀منتو∈من”،∀منv∈من”)((منتو،منv)∈آر)}

مثال  ۲٫

در شکل ۱ ب، سیمنس({آ،ب،سی،D})= {{A1، B1، C1، D1}، {A2، B2، C2، D2}، {A3، B3، C3، D3}}.
تعریف نمونه یک الگو به طور کلی بر روی دسته است. در این مقاله، آن را به حالت کشسانی گسترش می دهیم.

تعریف  ۳

(شاخص مشارکت پمن(پ)) با توجه به یک زیر مجموعه ویژگی غیر خالی p ( پ⊆اف) و یک ویژگی fمندر p fمننسبت مشارکت در p نسبت نمونه های متمایز از است fمنکه در سیمنس(پ)به مصادیق حمل fمن. برای مثال،

پآر(پ،fمن)=∣{منتو∣منتو∈∪سیمنس(پ)،fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من،fهآ(منتو)=fمن}∣

علاوه بر این، شاخص مشارکت p حداقل نسبت مشارکت هر ویژگی در p است. برای مثال،

پمن(پ)=مترمنnfمن∈پپآر(پ،fمن)

که در آن تابع مترمنn(·)حداقل مقدار را برمی گرداند.

شاخص مشارکت می تواند متغیر باشد در حالی که نسبت مشارکت نسبتاً ثابت است. در این مقاله، ما این دو را با مرکزیت نزدیکی به روز می کنیم.

تعریف  ۴

(الگوی هم مکان) با توجه به آستانه شیوع مترمنn_پمن( ۰<مترمنn_پمن≤۱، اجازه دهید p ( ∅⊂پ⊆اف) یک الگو باشد. اگر پمن(پ)≥مترمنn_پمن، p الگوی هم‌مکانی رایج (به اختصار الگوی هم‌مکانی) نامیده می‌شود.

مثال  ۳٫

در شکل ۱ ب، پمن(آ،ب،سی،D)= مترمنn(پآر({آ،ب،سی،D}،آ)،پآر({آ،ب،سی،D}،ب)،پآر({آ،ب،سی،D}،سی)،پآر({آ،ب،سی،D}،D))= مترمنn(3/3،۳/۳،۳/۳،۳/۳)= ۱٫ با فرض مترمنn_پمن= ۰٫۵، {A، B، C، D} یک الگوی هم‌مکانی است.
هر زیر مجموعه غیر خالی مجموعه ویژگی اف={f1،f2،⋯،fمتر}یک الگو است (مثلا {f1،f3،f4}). کاربران به همه زیرمجموعه ها علاقه ندارند، بلکه به زیر مجموعه های رایج علاقه دارند. بنابراین، الگوهای هم‌مکانی را می‌توان از زیر مجموعه‌های F به نوبه خود بررسی کرد. با این حال، وقت گیر است زیرا اندازه نامزد نمایی است. یک لم قابل اجرا به طور کلی برای هرس نامزدها پیشنهاد می شود [ ۱۱ ].

لم  ۱

(آنتی مونوتونیک از پمن(پ)) اجازه دهید p و پ”دو الگو باشد ( پ”⊆پ⊆اف). نسبت مشارکت هر ویژگی در پ”بزرگتر یا مساوی یکی در p است. برای مثال،

(∀پ⊆اف)(∀پ”⊆پ)(fمن∈پ”)⇒پآر(پ”،fمن)≥پآر(پ،fمن)

علاوه بر این، شاخص مشارکت از پ”بزرگتر یا مساوی یکی از p است. برای مثال،

(∀پ⊆اف)(∀پ”⊆پ)(پمن(پ”)≥پمن(پ))
اثبات لم ۱ را می توان در [ ۱۰ ] مشاهده کرد.

مثال  ۴٫

در شکل ۱ ب، پآر({سی،D،E}،D)=3/3≥۲/۳=پآر({آ،ب،سی،D،E}،D). علاوه بر این، پمن({سی،D،E})=3/3≥۲/۳=پمن({آ،ب،سی،D،E})
لم ۱ اعلام می کند که یک الگوی اندازه- k فقط در صورتی می تواند رایج باشد که تمام اندازه آن-( ک-۱) در جایی که زیر مجموعه ها رایج هستند ۲≤ک≤∣اف∣. برخی از الگوریتم های کلاسیک مانند Join-based و CPI-Tree توسط این لم هدایت می شوند. در این مقاله، این لم قابل اجرا نیست. یکی دیگر از استراتژی های هرس با کران بالا در بخش بعدی آورده شده است.
از آنجایی که تعاریف کلاسیک و لم معرفی شدند، کار مرتبط در بخش فرعی بعدی بررسی می شود.

۲٫۲٫ مرور

مدل کاوی کلاسیک از زمانی که [ ۱۲ ] تحقیقات الگوی هم‌مکانی فضایی را آغاز کرد، بر روی تولید رابطه همسایه و آزمون‌های شیوع متمرکز شده است.
روش های تولید نمودارهای رابطه همسایه فضایی را می توان طبقه بندی کرد.
راه اول بر اساس آستانه فاصله داده شده توسط کاربران است. محبوب ترین روش در آستانه فاصله استاتیک جهانی است. یعنی اگر فاصله بین یک جفت از حد معین بیشتر نباشد، جفت همسایه یکدیگر محسوب می شوند. در مجموعه داده های توزیع شده یکنواخت قابل اجرا است. از آنجایی که مجموعه داده‌های توزیع نابرابر وجود دارد، فواصل توسط تابع هسته در برخی مقالات تقویت می‌شوند [ ۱۳ ]. این روش که الگوریتم آن نامیده می شود اسجیسیتی_ک، یک روش کلاسیک برای افتراق فواصل در مناطق با تراکم توزیع متفاوت است. این می تواند یک الگوریتم معیار در مقایسه با روش های ما باشد. علاوه بر این، روش‌های پویا محلی برای تناسب با توزیع‌های مختلف در مناطق محلی معرفی شده‌اند [ ۱۴ ]. فرض اساسی این است که نمونه ها به طور مساوی در هر منطقه محلی توزیع می شوند.
راه دوم بر اساس k -نزدیکترین همسایگان است. مرجع. [ ۱۵ ] یک چارچوب کاوی الگوی هم‌مکانی سلسله مراتبی را با در نظر گرفتن انواع فاصله‌های همسایگی و ناهمگونی فضایی پیشنهاد کرد. با اتخاذ یک نمودار k- نزدیکترین همسایه ( KNNG ) به جای آستانه فاصله، یک ضریب تغییر فاصله را به عنوان یک معیار جدید برای هدایت فرآیند استخراج و تعیین یک نمودار رابطه همسایه فردی برای هر منطقه پیشنهاد می‌کند. این روش الگوی کاوی هم‌مکانی را به الگوی هم‌مکانی منطقه‌ای هدایت کرد. بنابراین، می‌تواند ارائه‌ای از تولید رابطه همسایه با نزدیک‌ترین همسایه برای تطبیق تراکم‌های توزیع مختلف باشد. الگوریتم مربوط به آن نامگذاری شده است آرسیمآیک طرح معیار در مقایسه با روش جدید ما است. پذیرفته شده است که مثلث سازی دلون و نمودار ورونوی ابزارهای ایده آل طبیعی برای تشخیص نزدیکترین همسایگان هستند. بنابراین، برخی از محققان [ ۷ ، ۱۶ ، ۱۷ ، ۱۸ ] به هر دو علاقه مند هستند. آنها به خوبی با قانون اول جغرافیای توبلر مطابقت دارند. خوشبختانه نیازی به تنظیم پارامترها نیست. با این حال، ممکن است منجر به این شوند که یک نمونه دیگر ممکن است یک همسایه باشد اما یک نمونه نزدیک نه. به عنوان مثال، A3 همسایه E1 است، اما A1 در شکل ۱ d نیست.
راه سوم مبتنی بر خوشه بندی است. با این حال، تعیین پارامترها (به عنوان مثال، k برای k-means ) دشوار است [ ۱۹ ]. علاوه بر این، یک جفت نمونه بین خوشه ای ممکن است بسیار نزدیکتر از یک جفت درون خوشه ای باشد [ ۲۰ ]. به عنوان مثال، فاصله بین A1 و E1 بیشتر از فاصله بین E1 و B2 است، اما جفت اول تمایل دارد در یک خوشه باشد در حالی که جفت دوم نه. قانون اول جغرافیای توبلر را نقض می کند.
آخرین راه سعی می کند فاصله ها و شیوع را متعادل کند. مراجع. [ ۲۱ و ۲۲ ] ترجیحات را با محدودیت های همسایگی پویا به پایان رساندند. بر این اساس، آنها وظیفه استخراج را به عنوان یک مسئله بهینه‌سازی تعریف کردند و یک الگوریتم حریصانه برای الگوهای هم‌مکانی استخراج با محدودیت‌های همسایگی پویا پیشنهاد کردند. با این حال، نسبت به اندازه بافر داده شده توسط کاربران بسیار حساس است، علاوه بر آن، ممکن است قانون اول توبر را نیز نقض کند، در حالی که یک ویژگی نادر مربوط به یک لبه وجود دارد.
از آنجایی که تعریف مجموعه روابط همسایه در مجموعه های مختلف داده توزیع آسان نیست، محققان تمایل دارند فضای جهانی را به مناطق (یا مناطق) تقسیم کنند که در آن نمونه ها تمایل دارند به طور مساوی توزیع شوند [ ۲۳ ، ۲۴ ]. بنابراین، استخراج الگوی هم‌مکانی به الگوی هم‌مکانی منطقه‌ای (یا منطقه‌ای) تبدیل می‌شود. با این حال، این روش‌ها حوزه‌های جهانی فضایی را تقسیم می‌کنند. ما در این مقاله بر استخراج الگوی هم‌مکانی در فضای جهانی تمرکز می‌کنیم.
بررسی تحقیق در مورد تولید رابطه همسایگی نشان می‌دهد که بزرگترین مشکل این است که چگونه تراکم‌های توزیع مختلف مجموعه داده‌های مکانی را تطبیق دهیم. مهم نیست راه آستانه فاصله یا روش نزدیکترین همسایه، یا آستانه ایده آل وجود ندارد یا قفل کردن آن دشوار است یا در برابر تداخل نویز آسیب پذیر است. استراتژی ما مصالحه بین راه آستانه فاصله و روش نزدیکترین همسایه است.
هنگامی که یک نمودار رابطه همسایه ایجاد شد، سه مرحله اصلی برای بررسی شیوع الگوها وجود دارد. در ابتدا، الگوهای هم‌مکانی نامزد تولید می‌شوند. از آنجایی که استخراج الگوی هم‌مکانی از تجزیه و تحلیل تداعی ناشی می‌شود، انتظار می‌رود ویژگی بسته شدن رو به پایین یا بسته شدن جزئی [ ۲۵ ] نامزدها را هرس کند. ثانیاً، نمونه‌هایی از هر الگوی نامزد عموماً روی دسته‌ها جمع‌آوری می‌شوند. دو مرحله فوق به طور کلی متقاطع هستند. بیشتر و بیشتر محققان متوجه می شوند که نمونه های مبتنی بر دسته بسیار سختگیرانه هستند زیرا هر جفت نمونه باید در یک دسته با یکدیگر همسایه باشند. بنابراین، رابطه ستاره ای همسایه [ ۶ ]، رابطه مبتنی بر مثلث [ ۱۶] و غیره معرفی می شوند. به عبارت دیگر، فقدان یکپارچه سازی (یا گسترش) مؤثر روش های مربوطه وجود دارد. ثالثاً، شیوع همیشه بر اساس حداقل نسبت مشارکت ویژگی‌ها در هر الگوی نامزد (یا حداکثر نسبت مشارکت ویژگی‌ها در هر الگوی نامزد با ویژگی‌های نادر) اندازه‌گیری می‌شود [ ۲۶ ]. علاوه بر این، ر. [ ۲۷ ] معیار جدیدی به نام امتیاز کسری پیشنهاد می‌کند که ایده آن این است که در صورت همپوشانی نمونه‌ها به صورت کسری شمارش شود. با این حال، رابطه بین معیار شیوع و مجموعه روابط همسایه به سادگی با روش های بالا تقسیم می شود.
از طریق بررسی تحقیق در مورد اعتبارسنجی الگوی رایج، متوجه می‌شویم که بزرگترین مشکل، تضاد بین علایق شخصی کاربران و افزونگی نتایج استخراج است. برای دریافت الگوهای مورد انتظار، کاربران باید یا روابط همسایه فضایی را تغییر دهند یا آستانه شیوع را تغییر اندازه دهند. تغییر در روابط همسایه فضایی ناگزیر باید دشواری ایجاد روابط همسایگی فضایی را به دلیل تراکم توزیع متفاوت تشدید کند. تغییر اندازه منجر به افزونگی الگوهای خروجی می شود.
مرجع. [ ۲۸ ] خاطرنشان می کند که کاربران نه تنها به شناسایی شیوع یک مجموعه ویژگی علاقه مند هستند، بلکه به ویژگی های غالب نیز علاقه مند هستند. آنها بر روی ویژگی‌های غالب استخراج در هر الگوی هم‌مکانی بر روی تغییرات نسبت مشارکت هر ویژگی در الگوهای اندازه متمرکز می‌شوند. با این حال، محققان بین روابط همسایه قوی و ضعیف برای اعتبار الگوی شیوع تمایز قائل نشده اند، چه رسد به تأثیر توپولوژی در بین ویژگی های الگوها.
به طور خلاصه، (الف) نسل سنتی روابط همسایه توجه بیشتری به مجموعه داده‌های توزیع نابرابر دارد، اما هنوز راه درازی در پیش دارد. (ب) محققان تلاش می‌کنند تا کارایی بررسی شیوع الگو را بهبود بخشند یا بر بهینه‌سازی شاخص مشارکت تمرکز کنند، اما منافع کاربران به دلیل افزونگی الگوهای خروجی به خطر می‌افتد. ج) تحقیق در مورد توپولوژی ویژگی در الگوهای رایج آغاز شده است، اما راکد است.

۳٫ نمودار روابط همسایه متقابل فضایی

در این بخش، همسایه‌های هدایت‌شده هر نمونه از مجموعه داده‌ها بر اساس نزدیک‌ترین همسایه‌شان به جز خودش و یک آستانه معین، تقسیم‌بندی می‌شوند. αو سپس روابط همسایگان متقابل از آنها بررسی می شود.

۳٫۱٫ تقسیم بندی

به عنوان مثال، فاصله بین آن و همسایگانش مشابه است اما تفاوت قابل توجهی ندارد. این فرضیه ما در این مقاله است. به عبارت دیگر، فاصله بین یک نمونه و نزدیکترین همسایه به جز خودش، همسایگان احتمالی آن را تعیین می کند.

تعریف  ۵

(شعاع داخل) با توجه به یک مجموعه داده مکانی D با یک مجموعه نمونه من={من۱،من۲،⋯،منn}و یک مجموعه ویژگی اف={f1،f2،⋯،fمتر}، اجازه دهید منتویک نمونه باشد ( منتو∈من). شعاع داخلی از منتو(نشان داده شده است منآر(منتو)) فاصله بین است منتوو نزدیکترین همسایه اش جز خودش. برای مثال،

منآر(منتو)=مترمنnمنv∈من\منتودمنس(منتو،منv)

جایی که دمنس(منتو،منv)فاصله (مثلاً فاصله اقلیدسی) بین نمونه را برمی گرداند منتوو منv.

به طور شهودی، منآر(منتو)فاصله بین منتوو همسایگان احتمالی آن، یعنی همه همسایگان ممکن منتوممکن است خیلی دورتر از منآر(منتو)از جانب منتو.

تعریف  ۶

(شعاع بیرونی) با توجه به ضریب الاستیک α ( α≥۱) توسط کاربر، اجازه دهید منآر(منتو)شعاع داخلی نمونه باشد منتو. شعاع بیرونی منتو(نشان داده شده است Oآرα(منتو)) است منآر(منتو)∗α. برای مثال،

Oآرα(منتو)=منآر(منتو)∗α

تعریف  ۷

(همسایگان هدایت شده) همسایگان هدایت شده از نمونه منتو(نشان داده شده است Dنسα(منتو)) از نمونه هایی تشکیل شده اند که فواصل بین آنها و منتوبیشتر از شعاع بیرونی نیستند منتو. برای مثال،

Dنسα(منتو)={منv∣منv∈من،دمنس(منتو،منv)≤Oآرα(منتو)}
تعریف ۷ نمونه در شعاع بیرونی برای فیلتر کردن همسایگان هدایت شده برای هر نمونه. هنگامی که همسایه های هدایت شده هر نمونه شناسایی شدند، همسایگان متقابل را می توان بررسی کرد.

تعریف  ۸

(همسایگان متقابل) برای یک جفت نمونه منتوو منv، منتوو منvاگر و فقط اگر هر دو همسایگان متقابل یکدیگر هستند منvهمسایه هدایت شده است منتوو منتوهمسایه هدایت شده است منv. برای مثال،

منv∈منسα(منتو)∧منتو∈منسα(منv)⇔منv∈Dنسα(منتو)∧منتو∈Dنسα(منv)

جایی که مناسα(منتو)مجموعه ای متشکل از همسایگان متقابل است منتو.

کاربر می تواند مقیاس همسایه را با تنظیم تنظیم کند α. بزرگترین مزیت این روش این است که کاربر فقط باید پارامترهای بصری را مطابق با ترجیحات خود تنظیم کند و نیازی به توجه به تفاوت تراکم توزیع در مناطق ندارد.

تعریف  ۹

(گراف رابطه همسایگی متقابل) با توجه به یک مجموعه نمونه من=(من۱،من۲،⋯،منn)در یک مجموعه داده D، نمودار رابطه همسایگی متقابل G (بدیهی است که یک گراف ناشناخته) به صورت زیر تعریف می شود:

جی=(من،{(منتو،منv)∣منتو∈من،منv∈منسα(منتو)})

که در آن مجموعه نمونه I مجموعه گره G است، {(منتو،منv)∣منتو∈من،منv∈منسα(منتو)}مجموعه لبه G است.

۳٫۲٫ بیان مسأله

بر اساس تعاریف بالا، ما یک توصیف رسمی برای ایجاد یک نمودار رابطه همسایگی متقابل در ادامه ارائه می دهیم.
با توجه به : (۱) یک مجموعه داده مکانی D با یک مجموعه ویژگی F و یک مجموعه نمونه I. (۲) یک ضریب الاستیک α( α≥۱) برای تقسیم بندی
پیدا کنید : نمودار کشتی همسایه متقابل فضایی جی=(من،{(منتو،منv)∣منتو∈من،منv∈منسα(منتو)}).
محدودیت ها : هر یال e در G ( ه∈{(منتو،منv)∣منتو∈من،منv∈منسα(منتو)}) نباید بیشتر از αبار هر شعاع درونی نقاط انتهایی آن.

۳٫۳٫ ایجاد نمودار رابطه همسایه متقابل در KD-Tree

از آنجایی که نمودار رابطه همسایه متقابل به شدت با نزدیکترین همسایگان همبستگی دارد، یک درخت k -dimension ( KD-Tree ) برای ذخیره اطلاعات نمونه در مجموعه داده های داده شده استفاده می شود. الگوریتم همانطور که در الگوریتم ۱ نشان داده شده است. اطلاعات مکان همه نمونه ها برای تولید یک KD-Tree [ ۲۹ ] در مرحله ۲ استفاده می شود. برای هر نمونه، نزدیک ترین همسایه به جز خودش و شعاع داخلی آن در KD-Tree کشف می شود ، و سپس همسایه های هدایت شده آن بر روی یک درخت در مراحل، از مرحله ۳ تا مرحله ۵ یافت می شوند. برای هر نمونه، همسایگان متقابل آن در مراحل، از مرحله ۶ تا مرحله ۱۲ جستجو می شوند.

الگوریتم ۱ ایجاد نمودار رابطه همسایگی متقابل در KD-Tree.
مورد نیاز: D ، F ، I ، α.
اطمینان حاصل شود: جی=(من،E)
 ۱: E=∅
 ۲: درخت = KD-Tree(D)
 ۳: برای منتو∈من انجام دادن
 ۴:     Dنسα(منتو)=تیrهه.qتوهry(منتو.ایکسy،α)//تعریف ۷٫
 ۵: پایان برای
 ۶: برای منتو∈من انجام دادن
 ۷:     برای  منv∈Dنسα(منتو) انجام دادن
 ۸:       اگر  منتو∈Dنسα(منv) سپس
 ۹:          E.آدد((منتو،منv))//تعریف ۸٫
 ۱۰:       پایان اگر
 ۱۱:     پایان برای
 ۱۲: پایان برای
 ۱۳: بازگشت G = (I,E) //تعریف ۹٫
الگوریتم ۱ بسیار کارآمد است. هزینه مرحله ۲ O(لog2∣من∣). با فرض اینکه هر نمونه دارای k ( ۱≤ک≤متر) همسایگان هدایت شده به طور متوسط، هزینه های مرحله ۴ O(∣من∣۱-۱/ک+متر)که در آن m تعداد نزدیکترین نمونه هایی است که هر بار باید جستجو شوند. علاوه بر این، متر=۲∣E∣∣من∣به طور متوسط. بنابراین، مراحل از مرحله ۳ تا مرحله ۵ هزینه دارد O((∣من∣۱-۱/ک+متر)×∣من∣)(یعنی O(∣من∣۲)تقریبا) زیرا ∣من∣>>متردر KD-Tree. هزینه مراحل از مرحله ۶ تا مرحله ۱۲ O(ک∣من∣/۲)از آنجایی که مراحل مرحله ۷ تا ۱۱ هزینه دارد O(ک/۲). بنابراین این الگوریتم هزینه دارد O(∣من∣۲)تحت سلطه مرحله ۶ تا ۱۲٫
مرحله ۴ تضمین می کند که همسایگان هدایت شده هر نمونه صحیح هستند. مراحل از مرحله ۶ تا مرحله ۱۲ تضمین می کند که همسایگان متقابل متقارن هستند.
بنابراین، الگوریتم ۱ برای تولید همسایگان متقابل نمونه ها صحیح و کارآمد است.

۴٫ بررسی شیوع در مرکزیت نزدیکی

در این بخش، نمونه هایی از الگوها را در نمودار رابطه همسایه متقابل با مرکزیت نزدیکی تعریف می کنیم. علاوه بر این، شیوع الگوها در نمونه های آنها بررسی می شود. بر این اساس، یک الگوریتم کارآمد بر اساس روش جستجوی اندازه برای استخراج الگوهای رایج پیشنهاد شده است.

۴٫۱٫ تعاریف و قضایا

تعریف  ۱۰

(مرکزیت نزدیکی) یک نمودار فضایی رابطه همسایه متقابل ارائه شده است جی=(من،{(منتو،منv)∣منتو∈من،منv∈مآرسα(منتو)}، اجازه دهید من”زیر مجموعه ای غیر خالی از I و باشد منتونمونه ای در من”( منتو∈من”). مرکزیت نزدیکی نمونه منتوکه در من”فاصله متوسط ​​آن (فاصله معکوس) را با تمام گره های دیگر اندازه می گیرد من”. برای مثال،

سیسی(من”،منتو)=∣من”∣-۱∑منv∈من”∣سپ(منتو،منv)∣

جایی که ∣سپ(منتو،منv)∣کوتاه ترین طول مسیر [ ۳۰ ] بین را برمی گرداندمنتوو منvدر G اما نه در زیرگراف القا شده از من”در جی.

مثال  ۵٫

در شکل ۲ ب، سیسی({آ۱،E1}،آ۱)=۲-۱۲=۱/۲٫
تعریف ۱۰ دشواری دسترسی به نمونه ها را ارزیابی می کند من”از جانب منتو. هر چه پایین تر سیسی(من”،منتو)، دسترسی آسان تر است.
به خصوص، اگر یک جفت نمونه وجود داشته باشد منتوو منvکه در من”و منv∉مآرسα(منتو)، اجازه دهید سیسی(من”،منتو)=۰زیرا ∣سپ(منتو،منv)∣=∞. علاوه بر این، اجازه دهید سیسی({منتو}،منتو)=۱، به عنوان نمونه منتومی تواند مستقیماً به خود دسترسی داشته باشد.

تعریف  ۱۱

(حداقل مرکزیت نزدیکی) یک نمودار فضایی رابطه همسایه متقابل ارائه شده است جی=(من،{(منتو،منv)∣منتو∈من،منv∈مآرسα(منتو)}، اجازه دهید من”زیر مجموعه ای از I باشد. حداقل مرکزیت نزدیکی از من”حداقل مرکزیت نزدیکی نمونه ها در است من”. برای مثال،

مسیسی(من”)=مترمنnمنتو∈من”سیسی(من”،منتو)

مثال  ۶٫

در شکل ۲ ب، سیسی({آ۱،سی۲،E1})=مترمنn(3-12+4،۳-۱۲+۲،۳-۱۲+۴)=۱/۳٫
تعریف ۱۱ همبستگی موارد را نشان می دهد من”. بزرگتر مسیسی(من”)به معنای همبستگی قوی تر است.
به خصوص، اجازه دهید مسیسی(∅)=۱و مسیسی({منتو})=۱جایی که منتو∈من. اگر یک جفت نمونه در آن وجود دارد من”( من”⊆من) در نمودار رابطه همسایگی متقابل نمی توانند به یکدیگر دسترسی داشته باشند. وجود دارد مسیسی(من”)=۰زیرا (∃منتو∈من”)(سیسی(من”،منتو)=۰). اگر هر جفت نمونه در من”می توانند به یکدیگر دسترسی داشته باشند، (∀منتو∈من”)(۰≤سیسی(من”،منتو)≤۱)زیرا (∀منتو∈من”)(∀منv∈من”)(منتو≠منv⇒۱≤∣سپ(منتو،منv)∣≤∣من”∣-۱). از این رو، (∀من”⊂من)(۰≤مسیسی(من”)≤۱).

لم  ۲

(ضد یکنواختی جزئی حداقل مرکزیت نزدیکی) یک نمودار فضایی رابطه همسایه متقابل ارائه شده است جی=(من،{(منتو،منv)∣منتو∈من،منv∈مآرسα(منتو)}، اجازه دهید من”یک زیرمجموعه اندازه-k از I ( من”⊆من∧ک>=1). باید یک اندازه وجود داشته باشد-( ک-۱) زیر مجموعه ای از من”(نشان داده شده است من”) ساختن مسیسی(من”)≥مسیسی(من”). برای مثال،

(∀من”⊆من)(∃من”⊂من”)(∣من”∣≥۱∧∣من”∣=∣من”∣+۱→مسیسی(من”)≥(مسیسی(من”)))

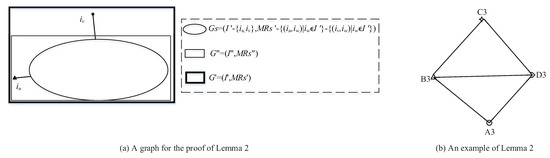
اثبات لم ۲٫

اگر مسیسی(من”)=۰، واضح است که درست است.

همانطور که در شکل ۳ نشان داده شده است ، با فرض جی”=(من”،مآرس”)یک زیرگراف در نمودار رابطه همسایگی متقابل است جی=(من،{(منتو،منv)∣منتو∈من،منv∈منسα(منتو)})جایی که من”⊆منو مآرس”={(منتو،منv)∣منتو∈من”∧منv∈من”∧∣سپ(منتو،منv)∣<∞}، اجازه دهید منvدورترین نمونه باشد منتوکه در جی”=(من”،مآرس”)، برای مثال، (∀منw∈من”)(∣سپ(منتو،منv)∣≥∣سپ(منتو،منw)∣). علاوه بر این، اجازه دهید منتونمونه ساز باشد مسیسی(من”)=سیسی(من”،منتو)جایی که من”=من”\منvو مآرس”=مآرس”-{(منv،منw)∣منw∈من”}. با فرض اینکه ∣سپ(منتو،منv)∣=κ، سپس، مسیسی(من”)=سیسی(من”،منتو)=η-۱σجایی که η=∣من”∣و σ=∑منw∈من”∣سپ(منتو،منw)∣. از این رو، مسیسی(من”)≤سیسی(من”،منتو)=η-۱+۱σ+κ=ησ+κ. بدین ترتیب،

مسیسی(من”)-مسیسی(من”)≥η-۱σ-ησ+κ=ησ-σ+ηκ-κ-ησσ(σ+κ)=ηκ-σ-κσ(σ+κ)
∵∣سپ(منتو،منv)∣=κ
∴(∀δ∈ن*)(∃منس∈من”)(۱≥δ≥κ،∣سپ(منتو،منس)∣=δ)و κ≤η-۱٫

∴η≥κ+۱∧σ≤۱+۲+⋯+(κ-۱)+κ(η-۱-(κ-۱)). بدین ترتیب،

ηκ-σ-κ≥ηκ-(۱+۲+⋯+(κ-۱)+κ(η-۱-(κ-۱)))-κ=κ۲+κ-۲۲∵κ≥۱∴κ۲+κ-۲≥۰∴κ۲+κ-۲۲≥۰∴ηκ-σ-κ≥۰∵σ(σ+κ)≥۰∴ηκ-σ-κσ(σ+κ)≥۰∴مسیسی(من”)-مسیسی(من”)≥۰∴(∀من”⊆من)(∃من”⊂من”)(∣من”∣≥۱∧∣من”∣=∣من”∣+۱→مسیسی(من”)≥مسیسی(من”))
   □
لم ۲ اعلام می کند که اگر زیر مجموعه ای وجود نداشته باشد که حداقل مرکزیت نزدیکی آن کمتر یا مساوی یک شناور معین باشد. β، هر یک از ابرمجموعه های آن به جز خودش نمی تواند کمتر یا مساوی باشد β.

مثال  ۷٫

در شکل ۲ ب، مسیسی({آ۱،E1})=1/2<2/3، مسیسی({آ۱،سی۲})=۱/۴<2/3، و مسیسی({سی۲،E1})=1/2<2/3; بدین ترتیب، مسیسی({آ۱،سی۲،E1})<2/3.

تعریف  ۱۲

(نوع- βنمونه هم محل) با دادن یک الگوی p ( پ⊆اف) و جی=(من،{(منتو،منv)∣منتو∈من،منv∈مآرسα(منتو)})، اجازه دهید مسیسی(من”)حداقل نزدیکی مرکزیت باشد من”جایی که من”⊆من. اگر مجموعه ویژگی های مربوطه از من”p و است مسیسی(من”)≥β، جایی که β آستانه داده شده توسط کاربران است، من”یک نمونه هم‌مکانی نوع β از p نامیده می‌شود. مجموعه‌ای که از همه نمونه‌های هم‌مکانی نوع β p تشکیل شده است، نمونه جدول هم‌مکانی نوع β از p نامیده می‌شود. برای مثال،

سیمنسβ(پ)={من”∣من”⊆من،∣من”∣=∣پ∣،سیافس(من”)=پ،مسیسی(من”)≥β}

مثال  ۸٫

در شکل ۲ ب، سیمنسβ({آ،ب،سی،D،E})={{آ۱،ب۱،سی۱،D1،E1}،{آ۲،ب۲،سی۲،D2،E1}،{آ۳،ب۳،سی۳،D3،E2}}در حالی که β≤۴/۷٫
در مقایسه با تعریف ۲، تعریف ۱۲ برای حداقل مرکزیت نزدیکی یک نمونه هم‌مکانی انعطاف‌پذیرتر است. من”۱ است (یعنی ∣من”∣-۱(∣من”∣-۱)∗۱).
حداقل مرکزیت نزدیکی یک نوع βنمونه هم مکان من”حداکثر فاصله بین جفت های نمونه را اندازه گیری می کند. همبستگی از من”قابل ارزیابی است. به عبارت دیگر، اگر من”یک نوع است βنمونه هم مکان، هر جفت نمونه در من”می توانند از یکدیگر در یک مرحله مرز بالایی قابل دسترسی باشند.

قضیه  ۱

(شرط لازم نوع- βنمونه هم محل) با توجه به یک مجموعه نمونه من”که در جی=(من،{(منتو،منv)∣منتو∈من،منv∈مآرسα(منتو)})، اگر من”یک نمونه هم‌مکانی نوع β است، هر جفت نمونه در من”می توانند در دسترس یکدیگر قرار گیرند ⌈۲β⌉-۱مراحل برای مثال،

مسیسی(من”)≥β⇒(∀منتو∈من”)(∀منv∈من”)(۰≤∣سپ(منتو،منv)∣≤⌈۲β⌉-۱)

اثبات قضیه ۱٫

با توجه به یک مجموعه نمونه من”که در جی=(من،{(منتو،منv)∣منتو∈من،منv∈مآرسα(منتو)})، اگر من”یک نوع است βنمونه هم مکان، ۱≥مسیسی(من”)≥β. اجازه دهید η=∣من”∣. اجازه دهید من۰،من۱،⋯،منκطولانی ترین کوتاه ترین مسیر بین هر جفت نمونه باشد من”. بدین ترتیب، من۰∈من”∧منκ∈من”. علاوه بر این، سیسی(من”،من۰)≥β∧سیسی(من”،منκ)≥β. علاوه بر این، برای هر نمونه منتوکه در من”( منتو∈من”)، باید وجود داشته باشد ∣سپ(من۰،منتو)∣+∣سپ(منتو،منκ)∣≥∣سپ(من۰،منک)∣=∣{من۰،من۱،⋯،منک}∣=κ. بنابراین، برای اتخاذ حداکثر κکه در من”، اجازه دهید هر نمونه منتوکه در من”( منتو∈من”)، ساخت ∣سپ(من۰،منتو)∣+∣سپ(منتو،منκ)∣=κدر حالی که اجازه می دهد مسیسی(من”)=β. که این است که بگوییم، مسیسی(من”)=η-۱⌈ηκ۲⌉=βباعث می شود κحداکثر باشد بدین ترتیب، κ≤⌊۲β-۲ηβ⌋. زیرا κ∈ن*و ۰≤β≤۱، ηβمی تواند بسیار بزرگتر از β. بدین ترتیب، ۲β>>2ηβ. از این رو، (∀منتو∈من”)(∀منv∈من”)(۱≤∣سپ(منتو،منv)∣≤⌈۲β⌉-۱). □
قضیه ۱ بیان می کند که یک همبستگی قوی بین نوع وجود دارد βنمونه های هم مکان به عنوان مثال، اگر β=۱، هر جفت نمونه می تواند در ۱ به یکدیگر دسترسی داشته باشد (یعنی ⌈۲۱⌉-۱) گام. حداقل یک دسته است. به طور مشابه، اگر β≥۴/۵، هر جفت نمونه می تواند در ۲ مورد به یکدیگر دسترسی داشته باشد (یعنی ⌈۲۴/۵⌉-۱) مراحل. حداقل یک ستاره است. اگر β≥۱/۲، هر جفت نمونه می تواند در ۳ مورد به یکدیگر دسترسی داشته باشد (یعنی ⌈۲۱/۲⌉-۱) مراحل. اگر β≥۲/۵، هر جفت نمونه می تواند در ۴ مورد به یکدیگر دسترسی داشته باشد (یعنی ⌈۲۲/۵⌉-۱) مراحل. اگر β≥۱/۳، هر جفت نمونه می تواند در ۵ مورد به یکدیگر دسترسی داشته باشد (یعنی ⌈۲۱/۳⌉-۱) مراحل بقیه را می توان به همین ترتیب انجام داد.
متأسفانه، اگر هر جفت نمونه در یک زیر مجموعه نمونه باشد من”می توانند در دسترس یکدیگر قرار گیرند ⌈۲β⌉-۱مراحل، مسیسی(من”)≥βلزوما درست نیست یعنی شرط لازم است ولی الزاما کافی نیست.

مثال ۹٫

مسیسی({آ۱،ب۱،سی۱،D1،E1})=4/7⇒(∀منتو∈{آ۱،ب۱،سی۱،D1،E1})(∀منv∈{آ۱،ب۱،سی۱،D1،E1})(∣sp(iu,iv)∣≤⌈۲۷/۴⌉-۱=۳). برعکس، ⌈۲β⌉-۱=۲ولی مسیسی({آ۱،E1})=2-12=12<βهنگامی که β = ۲/۳ در شکل ۲ ب.
با توجه به لما ۲ و قضیه ۱، نوع کاندید βنمونه هم مکان را می توان به خوبی هرس کرد. به این معنا که اگر یک جفت نمونه در یک نوع کاندید وجود داشته باشد- βمحل مشترک، نمونه من”نمی توانند به یکدیگر دسترسی داشته باشند ⌈۲β⌉-۱مراحل، بنابراین نمی تواند درست باشد. علاوه بر این، اگر اندازه وجود ندارد-( ∣من”∣-۱) زیر مجموعه ای از من”یک نوع بودن βنمونه هم‌مکانی، هنوز هم نباید یک نوع باشد βنمونه هم مکان

تعریف  ۱۳

(نوع- βنسبت مشارکت) اجازه دهید سیمنسβ(پ)نمونه جدول هم‌مکانی نوع β یک الگوی p باشد. نسبت مشارکت نوع-β یک ویژگی fمندر p نسبت نزدیکی مرکزیت خلاصه است fمنموارد ظاهر شدن در سیمنسβ(پ)به نمونه هایی از fمن. برای مثال،

پآرβ(پ،fمن)=∑منتو∈∪سیمنسβ(پ)∧fهآ(منتو)=fمنسیسی(من”،منتو)∣{منتو∣منتو∈من∧منتو∉∪سیمنسβ(پ)∧fهآ(منتو)=fمن}+∣سیمنسβ(پ)∣

مثال  ۱۰٫

پآرβ({آ،ب،سی،D،E}،E)=4/7+4/7+4/63=40/63در شکل ۲ ب در حالی که β≤۴/۷٫ متفاوت است از پآر({آ،ب،سی،D،E}،E)=0در تعریف ۳٫
دلیل عدم استفاده پآرβ(پ،fمن)=∑منتو∈∪سیمنسβ(پ)∧fهآ(منتو)=fمنسیسی(من”،منتو)∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣این است که یک نمونه ممکن است بارها و بارها در انواع مختلف ظاهر شود- βنمونه های هم مکان

تعریف  ۱۴

(نوع- βشاخص مشارکت) با دادن یک الگوی p ( پ⊆اف)، شاخص مشارکت نوع-β آن حداقل نسبت مشارکت نوع-β ویژگی ها در p است. برای مثال،

پمنβ(پ)=مترمنnfمن∈پپآرβ(پ،fمن)

مثال  ۱۱٫

پمنβ({آ،ب،سی،D،E})=مترمنn(4/5+4/5+4/53،۴/۵+۴/۴+۴/۵۳،۴/۵+۴/۵+۴/۴۳،۴/۴+۴/۴+۴/۴۳،۴/۷+۴/۶+۴/۶۳)=۴۰/۶۳در شکل ۲ ب در حالی که β≤۴/۷٫ متفاوت است از پمن({آ،ب،سی،D،E})=0در تعریف ۳٫

تعریف  ۱۵

(نوع- βالگوی مکان مشترک) با دادن یک الگوی p ( پ⊆اف) و یک آستانه شیوع ζ، اگر و فقط اگر پمنβ(پ)≥زما الگوی هم‌مکانی pa type-β می‌نامیم. مجموعه متشکل از همه الگوهای هم‌مکانی نوع β نشان داده می‌شود سیپسβ. برای مثال،

پمنβ(پ)≥ز⇔پ∈سیپسβ

مثال  ۱۲٫

{A, B, C, D, E} یک الگوی هم‌مکانی نوع β است وقتی β≤۴/۷∧ز≤۴۰/۶۳، اما یک الگوی هم‌مکانی در تعریف ۴ وقتی نیست مترمنn_پمن>0در شکل ۲ ب.
شاید هر زیرمجموعه غیر خالی از F بتواند از لحاظ نظری یک نوع کاندید باشد- βالگوی مکان مشترک اگر همه ۲∣اف∣-∣اف∣-۱الگوهای نامزد به نوبه خود با نوع آنها بررسی می شوند βتولید نمونه هم‌مکانی، زمان‌بر است. در مقایسه با Lemma 1، ویژگی پیشینی به نوع راضی نیست βالگوهای هم‌مکانی به دلیل Lemma 2. بنابراین، ابتدا نوع تقریبی را معرفی می‌کنیم. βالگوی هم‌مکانی برای جلوگیری از انفجار ترکیبی، و سپس یک ویژگی جدید در قضیه ۱ پیشنهاد کنید.

تعریف  ۱۶

(نوع تقریبی- βالگوی مکان مشترک) با دادن یک الگوی p ( پ⊆اف) و آستانه شیوع ζ، اگر شاخص مشارکت نوع β آن بزرگتر یا مساوی با ζ باشد زمانی که موارد هم‌مکانی نوع β آن به‌عنوان جفت‌های نمونه آرام هستند و می‌توانند به یکدیگر دسترسی پیدا کنند. ⌈۲β⌉-۱مراحل، p یک الگوی هم‌مکانی نوع β تقریبی نامیده می‌شود. مجموعه متشکل از الگوهای هم‌مکانی تقریبی نوع β با نشان داده می‌شود آپسβ. برای مثال،

مترمنnfمن∈پ{∣{منتو∣منتو∈∪Uمنسβ(پ)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣}≥ز⇔پ∈آپسβ

جایی که Uمنسβ(پ)={من”∣(∀منv∈من”)(∀منw∈من”)(من”⊆من∧{fهآ(منس)∣منس∈من”}=پ∧∣من”∣=∣پ∣∧∣سپ(منv،منw)∣≤⌈۲β⌉-۱)}.

مثال  ۱۳٫

{آ،ب،سی،D،E،اف}∈آپسβچه زمانی β≤۴/۷و ز≤۲/۳، ولی پمنβ({آ،ب،سی،D،E،اف}) =۵/۲۱٫

قضیه  ۲

(بسته شدن رو به پایین از نوع تقریبی- βالگوی مکان مشترک) با توجه به یک زیر مجموعه p از مجموعه ویژگی F ( پ⊆افاگر p یک الگوی هم‌مکانی نوع β تقریبی باشد، هر زیر مجموعه‌ای از p باید یک الگوی هم‌مکانی نوع β تقریبی باشد. برای مثال،

(∀پ⊆اف)(∀پ”⊆پ)(پ∈آپسβ→پ”∈آپسβ)

اثبات قضیه ۲٫

با توجه به دو زیر مجموعه p و پ”از مجموعه ویژگی های F ( پ”⊂پ⊆اف)، اجازه دهید fمنیک ویژگی در باشد پ”( fمن∈پ”∧fمن∈پ). با فرض اینکه من”آیا هر زیر مجموعه نمونه ای رضایت بخش است (∀منv∈من”)(∀منw∈من”)(من”⊆من∧{fهآ(منس)∣منس∈من”}=پ∧∣من”∣=∣پ∣∧∣سپ(منv،منw)∣≤⌈۲β⌉-۱)، قابل درک است که هر زیر مجموعه ای از من”، که مجموعه ویژگی های مربوطه آن است پ”، می تواند راضی کند (∀منv∈من”)(∀منw∈من”)(من”⊆من”∧{fهآ(منس)∣منس∈من”}=پ”∧∣من”∣=∣پ”∣∧∣سپ(منv،منw)∣≤⌈۲β⌉-۱). یعنی اگر مصداقی باشد منتوکه ویژگی آن است fمنظاهر می شود من”، همچنین باید در ظاهر شود من”. بدین ترتیب، ∣{منتو∣منتو∈∪Uمنسβ(پ)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣≤∣{منتو∣منتو∈∪Uمنسβ(پ”)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣، و سپس ∣{منتو∣منتو∈∪Uمنسβ(پ)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣≥ز⇒∣{منتو∣منتو∈∪Uمنسβ(پ”)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣≥ز. اثبات دقیق تر را می توان بر اساس اثبات ضد یکنواختی نسبت های مشارکت و شاخص های مشارکت در [ ۳۱ ] مدل سازی کرد. ] مدل‌سازی کرد.

علاوه بر این،

مترمنnfمن∈پ”{∣{منتو∣منتو∈∪Uمنسβ(پ”)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣}≥مترمنn{مترمنnfمن∈پ”{∣{منتو∣منتو∈∪Uمنسβ(پ”)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣}،مترمنnfj∈پ-پ”{∣{منتو∣منتو∈∪Uمنسβ(پ)∧fهآ(منتو)=fj}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fj}∣}≥مترمنn{مترمنnfمن∈پ”{∣{منتو∣منتو∈∪Uمنسβ(پ)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣}،مترمنnfj∈پ-پ”{∣{منتو∣منتو∈∪Uمنسβ(پ)∧fهآ(منتو)=fj}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fj}∣}=مترمنn{مترمنnfمن∈پ{∣{منتو∣منتو∈∪Uمنسβ(پ)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣}

برای مثال،

مترمنnfمن∈پ{∣{منتو∣منتو∈∪Uمنسβ(پ)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣}≥ز∧پ”⊆پ⇒مترمنnfمن∈پ”{∣{منتو∣منتو∈∪Uمنسβ(پ”)∧fهآ(منتو)=fمن}∣∣{منتو∣منتو∈من∧fهآ(منتو)=fمن}∣}≥ز

بدین ترتیب،

(∀پ⊆اف)(∀پ”⊆پ)(پ∈آپسβ→پ”∈آپسβ)
   □

مثال  ۱۴٫

{آ،ب،سی،D،E،اف}∈آپسβچه زمانی β≤۴/۷و ز≤۲/۳، هر زیر مجموعه ای از {آ،ب،سی،D،E،اف}.
با مقایسه تعاریف ۱۵ و ۱۶، قضیه ۲ بیان می کند که یک الگو نمی تواند یک نوع باشد. βالگوی هم‌مکانی تا زمانی که زیرمجموعه‌ای وجود نداشته باشد که یک نوع تقریبی نباشد. βالگوی هم‌مکانی، از آنجایی که مرکزیت نزدیکی یک نمونه بزرگتر یا مساوی ۰ و کمتر یا مساوی ۱ است. در این مرحله، این نوع βمشکل کاوی الگوی هم‌مکانی را می‌توان به مشکل کاوی الگوی هم‌مکانی کلاسیک تبدیل کرد. بنابراین، اکثر الگوریتم‌های سنتی استخراج الگوی هم‌مکانی مانند Join-based، Join-less [ ۳۲ ]، CPI-tree و غیره را می‌توان به نوع استخراج بهبود داد. βالگوهای مکان مشترک
برای یک نوع βنمونه هم‌مکانی، هر نمونه دارای مرکزیت نزدیکی است. بر این اساس، برای یک نوع βالگوی هم‌مکانی، هر ویژگی دارای مرکزیت نزدیکی است.

تعریف  ۱۷

(مرکزیت نزدیکی از fمن( fمن∈پ،پ⊆اف)) با توجه به الگوی هم‌مکانی نوع β p، اجازه دهید fمنهر ویژگی در p باشد. مرکزیت نزدیکی از fمندر p میانگین مرکزیت نزدیکی نمونه های حامل است fمندر موارد هم‌مکانی نوع β آن. برای مثال

سیسیاف(پ،fمن)=∑منتو∈من”،من”∈سیمنسβ(پ)،fهآ(منتو)=fمنسیسی(من”،منتو))∣سیمنسβ(پ)∣

مثال  ۱۵٫

سیسیاف({آ،ب،سی،D،E}،آ)=۴/۵=۰٫۸، سیسیاف({آ،ب،سی،D،E}،ب)=۱۳/۱۵≈۰٫۸۷، سیسیاف({آ،ب،سی،D،E}،سی)=۱۳/۱۵≈۰٫۸۷، سیسیاف({آ،ب،سی،D،E}،D)=1، و سیسیاف({آ،ب،سی،D،E}،E)=40/63≈۰٫۶۳چه زمانی β≤۴/۷و ز≤۴۰/۶۳در شکل ۲ ب.
دلیل این که مخرج نباشد ∣{منتو∣(∃س∈سیمنس(پ))(منتو∈س،fهآ(منتو)=fمن)}∣بجای ∣سیمنس(پ)∣شهودی تر بودن این یک نمونه است منتوممکن است در انواع مختلف ظاهر شود – βنمونه های هم محل p .
از آنجایی که مرکزیت نزدیکی هر نمونه در یک نوع βنمونه الگوی هم‌مکانی بزرگتر یا مساوی است βطبق تعریف ۱۲، مرکزیت نزدیکی هر ویژگی در یک نوع βالگوی هم‌مکانی نیز باید بزرگ‌تر یا مساوی باشد βطبق تعریف ۱۷٫ علاوه بر این، مرکزیت نزدیکی هر ویژگی در یک نوع βالگوی مکان مشترک ممکن است متفاوت باشد. یعنی در یک نوع βالگوی مکان مشترک، همبستگی بین یک ویژگی و ویژگی دیگر ممکن است متفاوت باشد. برخی از ویژگی ها ممکن است در مرکز توپولوژی الگو قرار گیرند در حالی که برخی دیگر در لبه قرار دارند. ویژگی با مرکزیت نزدیکی بالا با سایر ویژگی ها همبستگی بیشتری دارد. بدیهی است که هر چه نزدیک تر است سیسیاف(پ،fمن)به ۱ می رسد، همبستگی با سایر ویژگی ها بیشتر است fمنزمانی که توزیع کل مجموعه داده در نظر گرفته شود در p است.
مرکزیت نزدیکی نمونه ها در یک زیر مجموعه نمونه من”می تواند متفاوت باشد حتی اگر من”یک دسته است بنابراین، تعریف ۱۷ قابل بهبود است. به هر حال، این در مورد تعریف ۱۲ صدق نمی کند. در این مقاله، ما بر روی تعریف ۱۷ تمرکز می کنیم اما نه تعریف ۱۸٫

تعریف  ۱۸

(مرکزیت نزدیکی گسترده از fمن( fمن∈پ،پ⊆اف)) با توجه به الگوی هم‌مکانی نوع β p، اجازه دهید fمنهر ویژگی در ص باشد. مرکزیت نزدیکی گسترده fمندر p میانگین مرکزیت نزدیکی در فواصل نمونه های حامل است fمندر موارد هم‌مکانی نوع β آن. برای مثال،

Eسیسیاف(پ،fمن)=∑منتو∈من”،من”∈سیمنسβ(پ)،fهآ(منتو)=fمنEسیسی(من”،منتو)∣سیمنسβ(پ)∣

جایی که Eسیسی(من”،منتو)=مترمنn_wهمنgساعتتیس(من”)∑منv∈من”دمنس(منتو،منv)و مترمنn_wهمنgساعتتیس(من”)خلاصه وزن لبه در حداقل درخت پوشا [ ۳۳ ] از است جی”=(من”،{(منتو،منv)∣منتو∈من”∧منv∈من”}،{دمنس(منتو،منv)∣منتو∈من”∧منv ∈من”}).

مثال  ۱۶٫

Eسیسیاف({آ،ب،سی}،آ)=(۳+۳٫۲)/(۳+۳٫۲)+(۵٫۶+۵٫۱)/(۵٫۶+۵٫۱)+(۱۱٫۲+۱۱٫۶)/(۱۱٫۶+۱۶٫۲)۳≈۰٫۹۴، Eسیسیاف({آ،ب،سی}،ب)=(۳+۳٫۲)/(۳+۳٫۶)+(۵٫۶+۵٫۱)/(۵٫۶+۵٫۸)+(۱۱٫۲+۱۱٫۶)/(۱۱٫۶+۱۱٫۲)۳≈۰٫۹۶، Eسیسیاف({آ،ب،سی}،سی)=(۳+۳٫۲)/(۳٫۲+۳٫۶)+(۵٫۶+۵٫۱)/(۵٫۱+۵٫۸)+(۱۱٫۲+۱۱٫۶)/(۱۱٫۲+۱۶٫۲)۳≈۰٫۹۱چه زمانی β≤۱و ز≤۱، ولی سیسیاف({آ،ب،سی}،آ)=۱، سیسیاف({آ،ب،سی}،ب)=۱، سیسیاف({آ،ب،سی}،سی)=۱در شکل ۲ ب.
به طور مشخص، ۰≤Eسیسی(من”،منتو)≤۱برای هر نمونه منتودر یک زیر مجموعه نمونه من”. علاوه بر این، تعریف ۱۸ مرکزیت نزدیکی همه ویژگی ها را در الگوهای متناظر آنها عادی می کند. یعنی نزدیکتر Eسیسیاف(پ،fمن)به ۱ می رسد، همبستگی بالاتر بین fمنو ویژگی های دیگر در p هنگامی که توزیع های نوع- βنمونه‌های هم‌مکانی فقط در نظر گرفته می‌شوند، نه همه نمونه‌ها.
از آنجایی که انتظار می‌رود مرکزیت نزدیکی هر ویژگی در الگوهای رایج مورد ارزیابی قرار گیرد، الگوریتمی مبتنی بر Join-less به شیوه‌ای اندازه عاقلانه به جای الگوی حداکثر [ ۳۴ ] راه یافتن در این مقاله پیشنهاد شده است.

۴٫۲٫ نوع βاستخراج الگوی موقعیت مکانی

با توجه به اینکه Join-less مرکزیت نزدیکی را در نظر نمی گیرد، باید از جنبه های زیر بهبود یابد. (الف) طول مسیر بین جفت‌های نمونه باید با کوتاه‌ترین الگوریتم‌های مسیر مانند الگوریتم Dijkstra در محاسبه شود. جی=(V،E)(خروجی الگوریتم ۱)، و سپس، اگر طول مسیر بین یک جفت نمونه بزرگتر از ⌈۲β⌉-۱، یک یال بین جفت نمونه ها را مطابق قضیه ۱ به روز کنید. (ب) همه نوع تقریبی- βالگوهای هم‌مکانی و نمونه‌های آن‌ها در به‌روزرسانی‌شده اتخاذ می‌شوند جی=(V،E)توسط Join-less طبق قضیه ۲٫ (ج) شیوع هر نوع تقریبی را بررسی کنید. βالگوی هم‌مکانی روی نمونه‌های آنها با قضیه ۱ و تعریف ۱۵٫ (د) برای هر نوع βالگوی مکان مشترک، مرکزیت نزدیکی هر ویژگی را می توان در تعریف ۱۷ یا تعریف ۱۸ محاسبه کرد.

الگوریتم ۲ برای یافتن نوع استفاده می شود βالگوهای هم‌مکانی با مقادیر مرکزیت نزدیکی ویژگی‌هایشان. در مرحله بعد، الگوریتم را می خوانیم و پیچیدگی زمانی را تجزیه و تحلیل می کنیم. مرحله ۱ یک نمودار رابطه همسایگی متقابل توسط الگوریتم ۱ ایجاد می کند. هزینه آن است O(∣من∣۲). مرحله ۲ کوتاه ترین طول مسیر بین هر جفت نمونه را توسط الگوریتم Dijkstra برمی گرداند. هزینه دارد O(∣E∣۲). مراحل ۳ تا ۹ نمودار رابطه همسایگی متقابل را مطابق قضیه ۱ به روز رسانی می کنند. هزینه آنها O(∣من∣۲). از آنجایی که هر جفت نمونه ای که کوتاه ترین طول مسیر بین آنها بیشتر نیست ⌈۲β⌉-۱قابل تشخیص است، بدون نوع تقریبی βالگوی هم‌مکانی را می‌توان در مرحله ۱۰ نادیده گرفت. مرحله ۱۰ پیچیدگی زمانی کل الگوریتم را تعیین می‌کند. پذیرفته شده است که Join-less کارآمد است، بنابراین این الگوریتم نیز کارآمد است. مراحل ۱۱ تا ۱۹ تمایل به اتخاذ نوع βالگوهای هم‌مکانی و محاسبه مرکزیت نزدیکی ویژگی آن از نوع تقریبی βالگوهای مکان مشترک در مرحله ۱۵، مرکزیت نزدیکی ویژگی مطابق Lemma 2 محاسبه می شود. این مرحله هزینه دارد O(∣پ∣۲). این ۹ مرحله هزینه دارد O(∣آپسβ∣×∣من∣∣اف∣×∣پ∣۲)به طور متوسط. کل الگوریتم بر اساس لم ها و قضایای اثبات شده است. بنابراین صحیح و کامل است.

الگوریتم ۲ نوع استخراج- βالگوهای هم مکان ( β-CPM)
نیاز: D (مجموعه داده داده شده)، F (مجموعه ویژگی)، I (مجموعه نمونه با اطلاعات مکان)، αضریب کشسانی برای ایجاد روابط همسایه متقابل، βآستانه مرکزیت نزدیکی، ز(آستانه شیوع داده شده).
اطمینان حاصل شود: سیپسβ(نوع- βالگوهای هم‌مکانی با مرکزیت نزدیکی هر ویژگی).
 ۱: G = الگوریتم ۱ ( D , α) //ایجاد نمودار روابط همسایه متقابل فضایی.
 ۲: {∣سپ(منتو،منv)∣∣منتو∈من∧منv∈من}=Dمنjکستیrآ(جی)//کوتاه ترین طول مسیرها را بین جفت های نمونه دریافت کنید.
 ۳: برای منتو∈من انجام دادن
 ۴:     برای  منv∈من انجام دادن
 ۵:       اگر  ∣سپ(منتو،منv)∣≤⌈۲β⌉-۱ سپس
 ۶:          E=E∪{(منتو،منv)}//قضیه ۱٫
 ۷:       پایان اگر
 ۸:     پایان برای
 ۹: پایان برای
 ۱۰: آپسβ،آپسβ_منnس=جیoمنn-لهسس(دآتیآ=جی،مترمنn_پمن=β)//قضیه ۲٫
 ۱۱: برای پ∈آپسβ انجام دادن
 ۱۲:     اگر  جساعتهجک_سیپسβ(پ،آپسβ_منnس) سپس
 ۱۳:       پ_دمنجتی={}
 ۱۴:       برای  fمن∈پ انجام دادن
 ۱۵:          پ_دمنجتی.توپدآتیه({fمن:سیسیاف(پ،fمن)})//تعریف ۱۷/ ۱۸ و لم ۲٫
 ۱۶:       پایان برای
 ۱۷:       سیپسβ=سیپسβ∪{پ_دمنجتی}//تعریف ۱۵٫
 ۱۸:     پایان اگر
 ۱۹: پایان برای
 ۲۰: بازگشت سیپسβ

۵٫ تجزیه و تحلیل آزمایش

در این بخش، از مجموعه داده های مصنوعی و واقعی برای طراحی آزمایش های ما استفاده می شود. دلیل استفاده از مجموعه داده های مصنوعی این است که ارزیابی اینکه چه چیزی می تواند نتیجه ایده آل در مجموعه داده های واقعی باشد دشوار است.
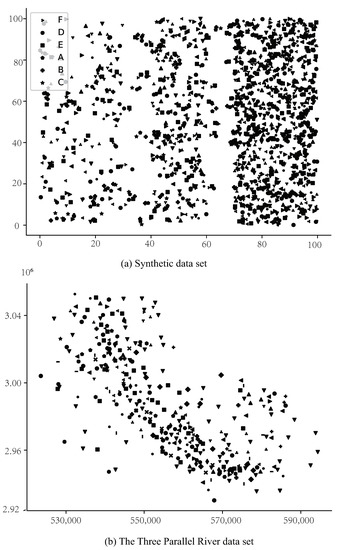
مجموعه داده های مصنوعی شکل ۴ a مجموعه داده های مصنوعی را نشان می دهد که مجموعه داده های مصنوعی نامیده می شود که توسط ما تولید شده است. فضا به سه منطقه از مناطق مشابه تقسیم شده است. مختصات نمونه ها به طور تصادفی در هر منطقه به دنبال تراکم توزیع ۳:۸:۱۳ اختصاص داده می شود. علاوه بر این، نمونه‌هایی که دارای ویژگی‌هایی در {A، B، C} هستند، عمداً برای جمع‌آوری مرتب شده‌اند، و همینطور در {D، E، F} هستند. چگالی نمونه‌های {A, B, C} و {D, E, F} از چگالی منطقه‌ای متناظرشان بیشتر است (متوسط ​​فاصله همسایه‌های نمونه جفت از ۶ متر، ۴ متر و ۲ متر بیشتر نیست. به ترتیب سه منطقه مربوطه). به عبارت دیگر، {A، B، C} و {D، E، F} می توانند الگوهای جالبی باشند، اما دیگران نه.
مجموعه داده های سه رودخانه موازی شکل ۴ ب توزیع گیاهان کمیاب در سه رودخانه موازی (مخفف مجموعه داده های سه رودخانه موازی) را نشان می دهد. به طور کلی پراکنده است، اما توزیع چگالی بسیار متفاوت است.
جدول ۱ توزیع ویژگی و نمونه را نشان می دهد. برخی از شاخص های کلیدی عملکرد به شرح زیر آزمایش می شوند.

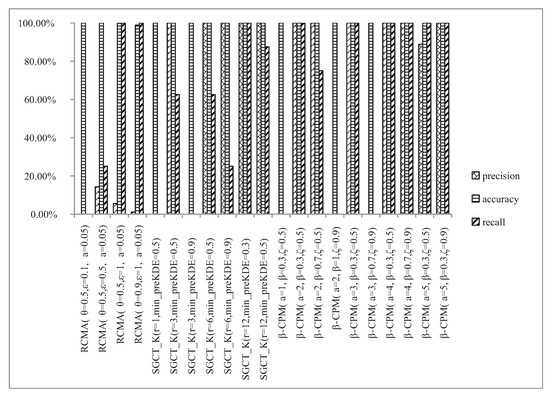
۵٫۱٫ دقت، دقت و یادآوری

دقت، دقت و یادآوری به ترتیب بر روی مجموعه داده های مصنوعی آزمایش می شوند، در حالی که نمی توان آنها را به طور عینی در مجموعه داده های واقعی ارزیابی کرد. در مجموعه داده‌های مصنوعی، {A، B، C} و {D، E، F} به همراه زیر مجموعه‌های غیر سایز ۱ خود همبستگی بالایی دارند. به عبارت دیگر، {A، B}، {A، C}، {B، C}، {A، B، C}، {D، E}، {D، F}، {E، F}، و { D، E، F} را می توان به عنوان الگوهای مثبت در نظر گرفت، در حالی که بقیه ۲∣اف∣-∣اف∣-۱-۸غیر سایز ۱ را می توان به عنوان الگوهای منفی انجام داد. بر اساس نتایج استخراج، الگوهای مثبت واقعی را به عنوان نشان می دهیم تیپ، الگوهای مثبت کاذب به عنوان افپ، الگوهای منفی واقعی به عنوان تین، و الگوهای منفی کاذب به عنوان افن، با گرفتن تعاریف از [ ۳۵ ]. در امتداد این خط، دقت الگوریتم ما (الگوریتم ۲) را می توان به صورت پیشنهادی ∣تیپ∣∣تیپ∣+∣افپ∣و دقت را می توان به صورت انجام داد ∣تیپ∣+∣تین∣∣تیپ∣+∣تین∣+∣افپ∣+∣افن∣، در حالی که فراخوان را می توان به عنوان انجام داد ∣تیپ∣∣تیپ∣+∣افن∣.
شکل ۵ دقت، دقت و یادآوری را نشان می دهد β-CPM در پارامترهای مختلف نماینده در مجموعه داده های مصنوعی در مقایسه با RMCA [ ۱۵ ] و SGCT_K [ ۱۳ ]. تعادل دقت و فراخوانی دشوار است، در حالی که دقت در RCMA ترجیح داده می شود. در همین حال، نقاط تعادل دقت، دقت و فراخوانی SGCT_K توسط کاربران به سختی یافت می شود زیرا محدوده بسیار باریکی دارند. علاوه بر این، از آنجایی که شاخص های مشارکت بر اساس توابع هسته در SGCT_K هستند، برآورد آستانه شاخص مشارکت بهینه توسط کاربران آسان نیست. همه الگوهای مثبت باید از نظر تئوری یک بار کشف شوند r≥۶٫ با این حال، SGCT_K به دلیل توابع هسته نمی تواند آن را انجام دهد. خوشبختانه ما β-CPM برای عملکرد خوب قوی است. که هر یک از α، β، و زبهینه بودن می تواند به نتیجه مطلوب منجر شود.
شکل ۵ همچنین نشان می دهد که الگوهای منفی نسبت به آنها حساس نیستند αو β. یعنی کشف الگوهای منفی آسان نیست β-CPM علاوه بر این، یک پایین تر βمی تواند این واقعیت را جبران کند αخیلی کوچک است. برعکس، بزرگتر αهمچنین می تواند این واقعیت را جبران کند βخیلی بزرگ است

۵٫۲٫ بهره وری

از آنجایی که مجموعه داده های مکانی بزرگ یا حتی عظیم هستند، کاربران به هزینه های زمانی کل الگوریتم ها نیز علاقه مند هستند. جدول ۲ کل هزینه های زمانی را نشان می دهد β-CPM در مجموعه داده های مصنوعی و مجموعه داده های سه رودخانه موازی در مقایسه با RCMA و SGCT_K با پارامترهای بهینه. RCMA وقت گیر است زیرا تکرارهای آن بر اساس k پویا KNN است. اگر مجموعه داده‌ها به طور مساوی توزیع شوند، باید الگوی هم‌مکانی جهانی را هدایت کند. به عبارت دیگر، یافتن مکرر الگوها برای بررسی شباهت مناطقی که باید متصل شوند، ضروری است. بنابراین، یافتن الگوهای هم‌مکانی منطقه‌ای به جای الگوهای جهانی در حالی که تراکم توزیع متفاوت است، قابل اجرا است. SGCT_K بر تأثیر فواصل بر نزدیکی تمرکز می کند. یعنی هر چه نزدیکتر مهمتر می داند. از تأثیر تراکم توزیع محلی بر مجاورت غفلت می کند. در یک کلام، به جهتی که ما در نظر گرفته ایم بی ربط است β-CPM در این مقاله. β-CPM از دو مورد دیگر با نتایج الگوی مشابه کارآمدتر است زیرا همسایگان ارزشمند را شناسایی می کند.

۵٫۳٫ پاسخ چگالی

شکل ۶ توزیع فاصله جفت های همسایه را نشان می دهد β-CPM در مجموعه داده های مصنوعی و مجموعه داده های سه رودخانه موازی در مقایسه با داده های SGCT_K. از آنجایی که RCMA بر الگوهای هم‌مکانی منطقه‌ای تمرکز می‌کند، دیگر مقایسه نمی‌کنیم β-CPM با آن.
تقریباً هیچ تکینگی در نمودارهای جعبه SGCT_K در هر دو شکل ۶ a,b وجود ندارد. دلیل آن این است که همسایگان بر روی یک آستانه فاصله ثابت جهانی تعریف می شوند، در حالی که فاصله بین جفت های نمونه معمولاً توزیع می شود. با این حال، کاربران به قدری به الگوهای رایج اهمیت می دهند که ممکن است به روابط همسایه خاصی از نمونه ها اهمیتی ندهند. به عبارت دیگر، جفت های همسایه بسیار زیاد است. مهمتر از آن، SGCT_K از تأثیرات چگالی توزیع تحت قانون اول جغرافیایی توبلر غفلت می کند. β-CPM جفت های همسایه کمتری را کشف می کند اما همچنان الگوهای جالبی پیدا می کند. تکینگی ها نشان می دهد که برخی مناطق پراکنده در فضا وجود دارد. این به طور موثر به تأثیر چگالی توزیع منطقه ای بر قانون اول جغرافیای توبلر پاسخ می دهد.

۵٫۴٫ ویژگی نزدیکی مرکزیت

در یک الگوی رایج سنتی، فقط نسبت‌های مشارکت وجود دارد اما ارزش‌های مرکزیت نزدیکی برای ویژگی‌ها وجود ندارد. شکل ۷ نمونه دندروگرام های مرکزیت نزدیکی ویژگی را در مجموعه داده های مصنوعی و مجموعه داده های سه رودخانه موازی نشان می دهد. این نشان می دهد که ضد یکنواختی نوع تقریبی βالگوهای هم‌مکانی گاهی ممکن است به ضد یکنواختی نوع βالگوهای مکان مشترک علاوه بر این، ویژگی های مختلف ممکن است مرکزیت نزدیکی متفاوتی داشته باشند. برای مثال، A مرکزیت نزدیکی بالاتری نسبت به B در {A, B} دارد، همانطور که در شکل ۷ نشان داده شده است ، در حالی که α= ۲، β= ۰٫۳ و ز= ۰٫۵٫
برای جمع بندی، β-CPM در دقت، دقت، یادآوری، کارایی، پاسخ چگالی و بیان مرکزیت نزدیکی ویژگی قابل اجرا است.

۶٫ نتیجه گیری و بحث

در این مقاله، نوع βالگوهای مکان مشترک به روشی نوآورانه کشف می شوند. اولا، روابط همسایه متقابل فضایی بر اساس این ایده ایجاد می شود که فاصله بین یک نمونه و همسایگان آن مشابه است اما تفاوت قابل ملاحظه ای ندارد. این روش با چگالی های توزیع مختلف در مناطق و مجموعه داده ها سازگار است. این منجر به جفت‌های همسایه کمتر اما پاسخ‌های مؤثر به علایق کاربران در مورد الگوهای مثبت مورد انتظار می‌شود. ثانیاً، نمونه‌هایی از الگوهای جالب در محوریت نزدیکی به جای روی دسته‌ها یا ستاره‌ها پیشنهاد می‌شوند. قالب‌های نمونه‌های الگو را گسترش می‌دهد و با اثرات نامطلوب الگوهای خیلی کوچک مقابله می‌کند α. کاربران می توانند به صورت انعطاف پذیر تنظیم کنند βبا توجه به ترجیحات خود برای کنترل قدرت همبستگی نمونه ها. ثالثاً، مرکزیت نزدیکی هر ویژگی در الگوهای جالب با مرکزیت نزدیکی اشیاء در نمونه‌هایی از الگوها اندازه‌گیری می‌شود. این می تواند همبستگی بین هر ویژگی و ویژگی های دیگر را در یک نوع آشکار کند. βالگوی مکان مشترک یک ویژگی با مرکزیت نزدیکی بالاتر، نوع را متراکم می کند βالگوی هم‌مکانی بیشتر
ویژگی های یکسان دارای مرکزیت نزدیکی متفاوت در انواع مختلف هستند. βالگوهای مکان مشترک بنابراین، بررسی این قانون که مرکزیت نزدیکی ویژگی‌ها با رشد اندازه الگوها تغییر می‌کند، می‌تواند مکانیسم تعامل بین ویژگی‌های فضایی را بیشتر آشکار کند. علاوه بر این، با افزایش اندازه الگو، ویژگی‌هایی که مرکزیت نزدیکی بالاتری داشته‌اند، ناگهان به حداقل می‌رسند و تجزیه و تحلیل عمیق دلایل این امر می‌تواند به ما در درک بیشتر نحوه بقای الگوها و چگونگی همبستگی بین ویژگی‌ها کمک کند. برای بقای الگوها همه موارد فوق کار اصلی آینده ما خواهد بود.

اختصارات

در این نسخه از اختصارات زیر استفاده شده است:

کنن k -نزدیکترین همسایگان
سیمنس نمونه جدول هم مکان
پمن شاخص مشارکت
منآر شعاع داخلی
Oآرα شعاع بیرونی محدود شده توسط α
Dنسα همسایگان هدایت شده محدود شده توسط α
منسα همسایگان متقابل محدود شده توسط α
سیسی مرکزیت نزدیکی
مسیسی حداقل مرکزیت نزدیکی
سیمنسβ نوع βنمونه هم مکان
پآرβ نوع βنسبت مشارکت
پمنβ نوع βشاخص مشارکت
سیپسβ نوع βالگوهای مکان مشترک
آپسβ نوع تقریبی – βالگوهای مکان مشترک
سیسیاف مرکزیت نزدیکی یک ویژگی
Eسیسیاف مرکزیت نزدیکی گسترده یک ویژگی
β-CPM الگوریتم کاوی نوع βالگوهای مکان مشترک
RCMA الگوریتم استخراج هم‌مکانی منطقه‌ای
SGCT_K یک الگوریتم هم‌مکانی حداکثری مبتنی بر درخت با نمودار پراکنده و متراکم با یک
تابع هسته
تیپ مجموعه الگوی مثبت واقعی
افپ مجموعه الگوی مثبت کاذب
تین مجموعه الگوی منفی واقعی
افن مجموعه الگوی منفی کاذب

منابع

  1. وانگ، ایکس. لی، ال. وانگ، ال. یانگ، پی. چن، اچ. کشف الگوی هم‌مکانی فضایی با ترکیب نظریه فازی. IEEE Trans. سیستم فازی ۲۰۲۱ ، ۳۰ ، ۲۰۵۵-۲۰۷۲٫ [ Google Scholar ] [ CrossRef ]
  2. وانگ، LZ; نیش، ی. ژو، L. الگوی کاوی مکان یابی فضایی مبتنی بر ترجیح . سری مدیریت داده های بزرگ؛ Springer: سنگاپور، ۲۰۲۲٫ [ Google Scholar ] [ CrossRef ]
  3. داروین، سی . منشاء گونه ها . انتشارات دانشگاه منچستر: منچستر، انگلستان؛ نیویورک، نیویورک، ایالات متحده آمریکا، ۱۹۹۸٫ [ Google Scholar ]
  4. لی، جی. عادل ماگامبتوف، ا. جبار، م.م. زین، OR; اوسورنیو-وارگاس، آ. Wine, O. در مورد کشف الگوهای موقعیت مکانی مشترک در مجموعه داده ها: مطالعه موردی آلاینده ها و سرطان های کودکان. Geoinformatica ۲۰۱۶ ، ۲۰ ، ۶۵۱-۶۹۲٫ [ Google Scholar ] [ CrossRef ]
  5. تران، وی. وانگ، ال. چن، اچ. Xiao, Q. MCHT: یک الگوریتم استخراج الگوی هم‌مکانی رایج مبتنی بر جدول حداکثری و هش. سیستم خبره Appl. ۲۰۲۱ ، ۱۷۵ ، ۱۱۴۸۳۰–۱۱۴۸۵۰٫ [ Google Scholar ] [ CrossRef ]
  6. وانگ، ال. بائو، ایکس. ژو، ال. چن، اچ. استخراج حداکثر الگوهای هم‌مکانی زیر رایج. وب جهانی ۲۰۱۹ ، ۲۲ ، ۱۹۷۱–۱۹۹۷٫ [ Google Scholar ] [ CrossRef ]
  7. Sundaram، VM; ثناگاولو، ا. Paneer, P. کشف الگوهای هم‌مکانی از حوزه فضایی با استفاده از رویکرد delaunay. Procedia Eng. ۲۰۱۲ ، ۳۸ ، ۲۸۳۲-۲۸۴۵٫ [ Google Scholar ] [ CrossRef ]
  8. هو، ز. وانگ، ال. تران، وی. چن، اچ. الگوهای هم‌مکانی فضایی را با استفاده از دسته‌های شبکه فازی استخراج می‌کند. Inf. علمی ۲۰۲۲ ، ۵۹۲ ، ۳۶۱-۳۸۸٫ [ Google Scholar ] [ CrossRef ]
  9. ژانگ، ایکس. ژو، جی. وانگ، کیو. ژائو، اچ. شناسایی گره های تاثیرگذار در شبکه های پیچیده با ساختار جامعه. بدانید. سیستم مبتنی بر ۲۰۱۳ ، ۴۲ ، ۷۴-۸۴٫ [ Google Scholar ] [ CrossRef ]
  10. هوانگ، ی. شیونگ، اچ. شکر، س. Pei, J. Mining قوانین هم‌مکانی مطمئن بدون آستانه پشتیبانی. در مجموعه مقالات سمپوزیوم ACM 2003، سن دیگو، کالیفرنیا، ایالات متحده آمریکا، ۱۰-۱۲ ژوئن ۲۰۰۳; صص ۴۹۷–۵۰۲٫ [ Google Scholar ]
  11. باتال، آی. Hauskrecht، M. یک نمایش مختصر از قوانین انجمن با استفاده از حداقل قوانین پیش بینی. در مجموعه مقالات یادگیری ماشین و کشف دانش در پایگاه های داده ECML PKDD 2010، برلین/هایدلبرگ، آلمان، ۲۰-۲۴ سپتامبر ۲۰۱۰٫ صص ۸۷-۱۰۲٫ [ Google Scholar ]
  12. هوانگ، ی. شکر، س. Xiong، H. کشف الگوهای هم مکان از مجموعه داده های مکانی: یک رویکرد کلی. IEEE Trans. بدانید. مهندسی داده ۲۰۰۴ ، ۱۶ ، ۱۴۷۲-۱۴۸۵٫ [ Google Scholar ] [ CrossRef ]
  13. یائو، ایکس. چن، ال. پنگ، ال. چی، تی. الگوریتم الگوریتم کاوی هم‌مکانی با در نظر گرفتن آستانه فاصله وزن‌دار چگالی. Inf. علمی ۲۰۱۷ ، ۳۹۶ ، ۱۴۴-۱۶۱٫ [ Google Scholar ] [ CrossRef ]
  14. ژائو، جی. وانگ، ال. بائو، ایکس. Tan, Y. الگوهای هم‌مکانی معدن با ویژگی‌های توزیع فضایی. در مجموعه مقالات کنفرانس بین المللی ۲۰۱۶ کامپیوتر، اطلاعات و سیستم های مخابراتی (CITS)، کونمینگ، چین، ۶ تا ۸ ژوئیه ۲۰۱۶؛ صص ۱-۵٫ [ Google Scholar ] [ CrossRef ]
  15. فنگ، Q. چیو، ک. او، س. Huang، H. الگوهای هم‌مکانی منطقه‌ای معدن با KNNG. جی. اینتل. Inf. سیستم ۲۰۱۴ ، ۴۲ ، ۴۸۵-۵۰۵٫ [ Google Scholar ]
  16. تران، وی. وانگ، ال. چن، اچ. الگوریتم کاوی الگوی هم‌مکانی فضایی بدون آستانه‌های فاصله. در مجموعه مقالات کنفرانس بین المللی IEEE 2019 درباره دانش بزرگ (ICBK)، پکن، چین، ۱۰-۱۱ نوامبر ۲۰۱۹؛ ص ۲۴۲-۲۴۹٫ [ Google Scholar ] [ CrossRef ]
  17. وانگ، جی. وانگ، ال. وانگ، X. الگوهای رایج محل یابی معدن بر اساس روابط توپولوژیکی جهانی. در مجموعه مقالات بیستمین کنفرانس بین المللی IEEE 2019 در مورد مدیریت داده های تلفن همراه (MDM)، هنگ کنگ، چین، ۱۰ تا ۱۳ ژوئن ۲۰۱۹؛ ص ۲۱۰-۲۱۵٫ [ Google Scholar ] [ CrossRef ]
  18. یائو، ایکس. وانگ، دی. پنگ، ال. چی، تی. یک الگوریتم تطبیقی ​​حداکثر هم‌مکانی استخراج. در مجموعه مقالات سمپوزیوم بین المللی زمین شناسی و سنجش از دور IEEE 2017 (IGARSS)، فورت ورث، تگزاس، ایالات متحده آمریکا، ۲۳ تا ۲۸ ژوئیه ۲۰۱۷؛ صص ۵۵۵۱–۵۵۵۴٫ [ Google Scholar ] [ CrossRef ]
  19. تنتروم، جی. موروا، ا. Stuetzle، W. خوشه‌بندی مبتنی بر مدل سلسله مراتبی مجموعه داده‌های بزرگ از طریق شکنش و شکست. Inf. سیستم ۲۰۰۴ ، ۲۹ ، ۳۱۵-۳۲۶٫ [ Google Scholar ] [ CrossRef ]
  20. ژو، جی. لی، کیو. دنگ، جی. یو، تی. ژو، ایکس. الگوهای هم‌مکانی استخراج با آیتم‌های خوشه‌بندی از مجموعه داده‌های مکانی. ISPRS—Int. قوس. فتوگرام حسگر از راه دور اسپات. Inf. علمی ۲۰۱۸ ، XLII-3 ، ۲۵۰۵–۲۵۰۹٫ [ Google Scholar ] [ CrossRef ]
  21. کیان، ف. یین، ال. او، س. او، جی. الگوهای مکان یابی مکانی-زمانی معدنی با پنجره کشویی وزن دار. در مجموعه مقالات کنفرانس بین المللی IEEE 2009 در مورد محاسبات هوشمند و سیستم های هوشمند، شانگهای، چین، ۲۰-۲۲ نوامبر ۲۰۰۹٫ جلد ۳، ص ۱۸۱-۱۸۵٫ [ Google Scholar ] [ CrossRef ]
  22. تانگ، م. Wang, Z. تحقیق الگوی هم‌مکانی فضایی بر اساس وزن آستانه تقسیم‌بندی برای مجموعه داده بزرگ. در مجموعه مقالات دومین کنفرانس بین المللی IEEE در سال ۲۰۱۵ در مورد داده کاوی مکانی و خدمات دانش جغرافیایی (ICSDM)، فوژو، چین، ۸ تا ۱۰ ژوئیه ۲۰۱۵؛ ص ۴۹-۵۴٫ [ Google Scholar ] [ CrossRef ]
  23. دای، BR; Lin, MY استخراج کارآمد الگوهای هم‌مکانی منطقه‌ای پویا بر اساس حداکثر مکان‌های مشترک. در مجموعه مقالات یازدهمین کنفرانس بین المللی IEEE 2011 در کارگاه های داده کاوی، ونکوور، BC، کانادا، ۱۱ دسامبر ۲۰۱۱٫ صص ۸۶۱-۸۶۸٫ [ Google Scholar ] [ CrossRef ]
  24. آگاروال، پ. ورما، ر. Gunturi، VMV کشف مناطق فضایی با همبستگی بالا. در مجموعه مقالات شانزدهمین کنفرانس بین المللی IEEE 2016 در کارگاه های داده کاوی (ICDMW)، بارسلون، اسپانیا، ۱۲ تا ۱۵ دسامبر ۲۰۱۶؛ ص ۱۰۸۲-۱۰۸۹٫ [ Google Scholar ] [ CrossRef ]
  25. زنگ، ایکس. لی، ز. وانگ، جی. Li، X. الگوهای هم‌مکانی با کاربرد بالا استخراج از مجموعه داده‌های فضایی با فاصله زمانی. در مجموعه مقالات چهارمین کنفرانس بین المللی IEEE 2019 در مورد تصویر، بینایی و محاسبات (ICIVC)، Xiamen، چین، ۵ تا ۷ ژوئیه ۲۰۱۹؛ صص ۶۲۸-۶۳۶٫ [ Google Scholar ] [ CrossRef ]
  26. یانگ، پی. وانگ، ال. وانگ، ایکس. Fang, D. یک رویکرد مؤثر در استخراج الگوهای مکان مشترک از پایگاه‌های داده فضایی با ویژگی‌های نادر. در مجموعه مقالات بیستمین کنفرانس بین المللی IEEE 2019 در مورد مدیریت داده های تلفن همراه (MDM)، هنگ کنگ، چین، ۱۰ تا ۱۳ ژوئن ۲۰۱۹؛ صص ۵۳-۶۲٫ [ Google Scholar ] [ CrossRef ]
  27. چان، HKH; لانگ، سی. یان، دی. Wong، RCW Fraction-score: یک معیار پشتیبانی جدید برای استخراج الگوی هم‌مکانی. در مجموعه مقالات سی و پنجمین کنفرانس بین المللی مهندسی داده IEEE 2019 (ICDE)، ماکائو، چین، ۸ تا ۱۱ آوریل ۲۰۱۹؛ صص ۱۵۱۴-۱۵۲۵٫ [ Google Scholar ] [ CrossRef ]
  28. نیش، ی. وانگ، ال. ژو، ال. الگوهای هم‌مکانی فضایی معدن با ویژگی‌های کلیدی. J. Data Acquis. روند. ۲۰۱۸ ، ۳۳ ، ۶۹۲-۷۰۳٫ [ Google Scholar ]
  29. هو، دبلیو. لی، دی. خو، سی. ژانگ، اچ. Li، T. یک الگوریتم طبقه بندی پیشرفته k نزدیکترین همسایه بر اساس KD-tree. در مجموعه مقالات کنفرانس بین المللی IEEE 2018 اطلاعات اطلاعات تولید ایمنی (IICSPI)، چونگ کینگ، چین، ۱۰ تا ۱۲ دسامبر ۲۰۱۸؛ ص ۹۰۲–۹۰۵٫ [ Google Scholar ] [ CrossRef ]
  30. Shee, SC الگوریتم های جدولی برای کوتاه ترین مسیر و طولانی ترین مسیر. ریاضی نانتا. ۱۹۷۷ ، ۱۰ ، ۱۰۰-۱۰۵٫ [ Google Scholar ]
  31. شکر، س. Huang, Y. کشف الگوهای هم‌مکانی فضایی: خلاصه‌ای از نتایج. لکت. یادداشت ها محاسبه. علمی ۲۰۰۱ ، ۲۱۲۱ ، ۲۳۶-۲۵۶٫ [ Google Scholar ] [ CrossRef ]
  32. یو، جی اس. Shekhar, S. یک رویکرد بدون اتصال برای استخراج الگوهای مکان‌یابی فضایی. IEEE Trans. بدانید. مهندسی داده ۲۰۰۶ ، ۱۸ ، ۱۳۲۳-۱۳۳۷٫ [ Google Scholar ] [ CrossRef ]
  33. گراهام، RL; جهنم، P. در مورد تاریخچه مشکل درخت پوشا حداقل. ان تاریخچه محاسبه کنید. ۱۹۸۵ ، ۷ ، ۴۳-۵۷٫ [ Google Scholar ] [ CrossRef ]
  34. وانگ، ال. بائو، ایکس. چن، اچ. Cao, L. نمایش متراکم بدون تلفات موثر و کشف الگوهای هم‌مکانی فضایی. Inf. علمی ۲۰۱۸ ، ۴۳۶ ، ۱۹۷-۲۱۳٫ [ Google Scholar ] [ CrossRef ]
  35. باکلند، MK; Gey, FC رابطه بین Recall و Precision. J. Assoc. Inf. علمی تکنولوژی ۲۰۱۰ ، ۴۵ ، ۱۲-۱۹٫ [ Google Scholar ] [ CrossRef ]
شکل ۱٫ این یک نمونه اسباب بازی از مجموعه داده های مکانی است. هر حرف نشان دهنده یک ویژگی و شماره زیر آن یک نمونه از ویژگی را نشان می دهد. دقت مختصات بر حسب متر است. ( الف ) نمودار رابطه همسایه در مسیر آستانه فاصله زمانی که آستانه فاصله داده شده d = ۳ متر باشد. ( ب ) نمودار رابطه همسایه در مسیر آستانه فاصله زمانی که آستانه فاصله d = ۱۳ متر است. ( ج ) گراف رابطه همسایه در mutual-KNN زمانی که k = ۳٫ ( د ) نمودار رابطه همسایه در مثلث سازی دلونی.
شکل ۲٫ این یک نمودار بهبود یافته رابطه همسایه از شکل ۱ است. ( الف ) روابط همسایه جهت دار بر روی نزدیکترین همسایگان و ضریب داده شده ایجاد می شود α= ۲٫ ( ب ) دیگراف در همسایه های متقابل به undigraph تبدیل می شود. خوشبختانه، با چگالی توزیع مختلف سازگار است.
شکل ۳٫ این یک نمودار برای لمای ۲ است. ( a ) مسیسی(من”)≥مسیسی(من”)اگر طولانی ترین کوتاه ترین مسیر در من”است سپ(منتو،منv)]و مسیسی(من”)=سیسی(من”،منتو). ( ب ) مسیسی({آ۳،ب۳،D3})≥مسیسی({آ۳،ب۳،سی۳،D3})ولی مسیسی({آ۳،ب۳،سی۳})<مسیسی({آ۳،ب۳،سی۳،D3}).
شکل ۴٫ اینها توزیع های مجموعه داده های مصنوعی و مجموعه داده های سه رودخانه موازی هستند. ( الف ) A، B و C در هر سه ناحیه چگالی به شدت با یکدیگر همبستگی دارند، و به همین ترتیب D، E، و F. ( ب ) چگالی های مختلف در مجموعه داده ها توزیع شده است. واحد پیش‌فرض معیارهای فاصله، متر در شکل ۴ a,b علاوه بر تمام آستانه‌های فاصله در این بخش است.
شکل ۵٫ دقت، دقت، و یادآوری الگوریتم های مختلف با برخی پارامترها در مجموعه داده های مصنوعی. تست ها بر اساس β-CPM در مقایسه با RCMA و SGCT_K.
شکل ۶٫ توزیع فاصله جفت های همسایه در مجموعه داده های داده شده با β-CPM در مقایسه با SGCT_K. ( الف ) فواصل کمتر و متمایزتر با β-CPM نسبت به SGCT_K در مجموعه داده های مصنوعی، ( b ) و همینطور در مجموعه داده های سه رودخانه موازی.
شکل ۷٫ دندروگرام های نوع βنمونه‌های الگوی هم‌مکانی در مجموعه داده‌های داده شده. ( الف ) از آنجایی که مرکزیت نزدیکی هر ویژگی در مثال های داده شده با یکدیگر مشابه است β-CPM ( α= ۲، β= ۰٫۳، ز= ۰٫۵)، مرکزیت نزدیکی هر ویژگی مشابه یکدیگر است. ( ب ) مرکزیت نزدیکی f2 به وضوح کمتر از f0، f1 و f2 است. این یک تناقض ثانویه در {f0، f1، f2، f3} با β-CPM ( α= ۳، β= ۰٫۵ و ز= ۰٫۳). علاوه بر این، آنها به ترتیب تسلط در {f0، f1، f2، f3} f3، f0، f1 و f2 هستند.

دیدگاهتان را بنویسید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *

خانهدربارهتماسارتباط با ما