۱٫ معرفی
هر ساله در پرتغال هزاران هکتار از جنگل ها توسط آتش سوزی ها مصرف می شود که باعث آسیب های زیست محیطی، زیرساختی و شخصی می شود [ ۱ ]. با هدف به حداقل رساندن خسارات ناشی از آتش سوزی، دولت پرتغال مناطق مدیریت سوخت (FMZs) را ایجاد کرد، که مناطقی هستند که در آن پوشش گیاهی باید درمان شود، به معنای حذف یا حذف بخشی از پوشش گیاهی، برای حفاظت از انواع زیرساخت ها و همچنین به عنوان نقاط استراتژیک برای مقابله با آتش سوزی عمل می کنند [ ۲ ، ۳]. از آنجایی که مسئولیت درمان FMZ ها بر عهده افرادی است که دارای یک زمین خاص هستند، مانند شهروندان، نهادهای خصوصی، و همچنین شهرستان ها، نظارت فعال بر درمان FMZ ها بسیار مهم است. گارد ملی جمهوری خواه مسئول نظارت بر FMZ ها است.
FMZ ها بخش بزرگی از قلمرو پرتغال را پوشش می دهند و یک شبکه سه سطحی را تشکیل می دهند: شبکه اولیه، شبکه ثانویه و شبکه سوم. شبکه اولیه در سطح منطقه تعریف شده است، در حالی که شبکه های ثانویه و سوم در سطح شهرداری و محلی تعریف شده اند. علاوه بر این، مداخلات انجام شده در این مناطق به شرح زیر طبقه بندی می شوند: مناطق کاهش سوخت (FRZs) و مناطق قطع سوخت (FIZs). FRZ ها با حذف پوشش گیاهی سطحی و قطع درختان برای ایجاد جدایی بین فنجان ها مشخص می شوند. FIZها شامل حذف کل انواع پوشش گیاهی در محدوده تعریف شده [ ۴ ] است.
FMZ اولیه بخش بزرگی از قلمرو پرتغال را پوشش می دهد و آن را به قطعاتی با مساحت بین ۵۰۰ تا ۱۰۰۰۰ هکتار تقسیم می کند. این شبکه از نوارهایی به عرض ۱۲۵ متر تشکیل شده است. این نوارها علاوه بر کاهش مساحت پیموده شده توسط آتش سوزی های جنگلی، عنصر کمکی در برنامه ریزی اطفای حریق نیز هستند، زیرا این شبکه در مناطق استراتژیک ساخته شده است. FMZ های ثانویه و ثالث در اطراف جاده ها، مسیرها، خطوط برق، راه آهن و شهرک ها تعریف می شوند. این شبکه ها بخشی از طرح شهرداری برای دفاع از جنگل ها در برابر آتش سوزی است. نوارهای ایجاد شده در امتداد جاده ها، ریل ها و راه آهن ها از نوع FIZ هستند. نوارهای اطراف خانهها و سکونتگاههای فردی نیز از انواع FIZ هستند، به علاوه اینکه تاج درختان باید بیش از ۵ متر از خانهها فاصله داشته باشد.
از آنجایی که FMZ ها می توانند پسوندهای عظیمی داشته باشند (هزاران هکتار)، نظارت بر این مناطق و تشخیص اینکه کدام یک نیاز به مداخله دارند برای مقامات دشوار است. وجود فرآیندهای خودکار یا نیمه خودکار که امکان شناسایی FMZهایی را که تحت درمان قرار گرفتهاند، میتواند به فرآیند نظارت، سرعت بخشیدن به شناسایی مناطق نیازمند مداخله کمک کند، بنابراین امکان نگهداری به موقع و افزایش حفاظت کلی در برابر آتشسوزی جنگلها را فراهم میکند. استفاده از روش های یادگیری ماشینی که برای سنجش از دور برای تجزیه و تحلیل جغرافیایی در مقیاس بزرگ استفاده می شود، رایج است [ ۵ ، ۶ ، ۷ ، ۸]. موسسه حفاظت از طبیعت و جنگل ها (ICNF) اطلاعات جغرافیایی FMZ ها را حفظ می کند و این اطلاعات را در دسترس عموم قرار می دهد. ترکیب این اطلاعات با تصاویر ماهوارهای در دسترس عموم از ماهوارههایی مانند Sentinel-1 و Sentinel-2 که تصاویری با وضوح حداکثر ۱۰ در ۱۰ متر میگیرند، امکان ادغام روشهای جدیدی را فراهم میکند که از تشخیص از راه دور در فرآیند نظارت FMZ استفاده میکنند.
FMZ ها باید هر سال تحت درمان قرار گیرند تا در طول فصل آتش سوزی پوشش گیاهی داخل تا حد امکان کاهش یابد تا این مناطق به هدف خود عمل کنند. گستردگی بالای این مناطق و این واقعیت که بخش بزرگی از FMZs با زمین خصوصی تلاقی میکند، میتواند مانع از فرآیند تمیز کردن و ایجاد ناپیوستگی در مناطق تحت درمان FMZs شود. این عوامل نظارت بر مناطق تحت درمان یا شناسایی مناطق نیازمند مداخله را به یک مشکل پیچیده تبدیل می کند.
اگرچه آتش سوزی جنگل ها یک مشکل جدی است، تحقیقات گسترده ای در مورد فرآیند نظارت بر FMZ ها انجام نشده است. در [ ۹ ]، شاخص تفاوت نرمال شده گیاهی (NDVI) به همراه اطلاعات جغرافیایی جاده ها و مزارع کشاورزی برای شناسایی FMZ ها استفاده شد. در زمینه ای متفاوت، کار [ ۱۰ ] دقت سه مدل سطح دیجیتال را برای تخمین ارتفاع زمین در مناطق مربوط به FMZ ها، در بخش شمالی یونان، مقایسه کرد.
چندین رویکرد در مورد نظارت بر محصول و پوشش گیاهی و تخمین زیست توده وجود دارد که می تواند به عنوان مبنایی برای ایجاد راه حلی قوی برای نظارت بر FMZ ها استفاده شود. برخی از مطالعات که در آنها تمرکز بر طبقه بندی انواع محصولات است [ ۸ ، ۱۱ ، ۱۲ ]، برخی دیگر که گونه های درختی را در مناطق جنگلی طبقه بندی می کنند [ ۸ ]، و همچنین رویکردهای طبقه بندی جامع تری که بر تمایز انواع مختلف پوشش زمین تمرکز دارند (به عنوان مثال ، مناطق جنگلی، شهری، کشاورزی و غیره) [ ۵ ، ۱۳ ، ۱۴ ]. برخی از مطالعات فقط از داده های باندهای ماهواره ای به طور مستقیم استفاده می کنند [ ۵ ، ۸]، اگرچه در بیشتر موارد از شاخص های پوشش گیاهی به عنوان شاخص ویژگی های پوشش گیاهی استفاده می شود. برخی از آثار از سری های زمانی برای استخراج اطلاعات بیشتر در مورد پوشش گیاهی استفاده می کنند [ ۱۱ ، ۱۴ ، ۱۵ ]. استفاده از سری های زمانی نتایج بهتری را در طبقه بندی پوشش گیاهی و پوشش زمین نسبت به استفاده از داده های مربوط به تنها یک تاریخ نشان داده است [ ۱۴ ، ۱۶ ].
همچنین برخی از مطالعات وجود دارد که در آنها ابعاد و ویژگیهای مناطق مورد تجزیه و تحلیل مشابه با FMZs است [ ۱۷ ، ۱۸ ]. ایمیتزر و همکاران [ ۸ ] پوشش گیاهی را در یک منطقه کشاورزی و یک منطقه جنگلی با استفاده از جنگل های تصادفی طبقه بندی کرد. در حوزه کشاورزی ۸ نوع محصول و در منطقه جنگلی ۶ گونه درخت طبقه بندی شدند. دو رویکرد مقایسه شدند: مبتنی بر پیکسل و مبتنی بر شی، و مشاهده شد که در منطقه جنگل رویکرد مبتنی بر شی نتایج بهتری به دست آورد. Clevers et al. [ ۱۷ ] از دادههای Sentinel-2 و شاخصهای پوشش گیاهی برای تجزیه و تحلیل مناطق مشابه اندازه FMZs با ۳۰ در ۳۰ متر استفاده کرد. همچنین با استفاده از همان نوع داده Rozenstein et al. [ ۱۹] دریافت که یک همبستگی قوی وجود دارد ( آر۲=۰٫۹۴) بین NDVI و مصرف آب آن گیاه، که ممکن است هنگام تجزیه و تحلیل وضعیت پوشش گیاهی در یک FMZ مفید باشد. مطالعات دیگر تلاش می کنند تا تولید یک محصول معین را به دنبال شاخص هایی مانند شاخص سطح برگ (LAI) و شاخص های پوشش گیاهی تخمین بزنند [ ۲۰ ، ۲۱ ]. ستییونو و همکاران [ ۲۱ ] از دادههای رادار دیافراگم مصنوعی (SAR) از Sentinel-1 و دادههای چند طیفی از ماهواره MODIS برای تخمین تولید برنج، در مقایسه با دادههای بهدستآمده در مزرعه، با خطاهای کمتر از ۱۰% استفاده کرد. کاستیو و همکاران [ ۲۲] از دادههای Sentinel-2، Sentinel-1 و ارتفاع، همراه با برخی از شاخصهای پوشش گیاهی برای تخمین مقدار زیست توده موجود در جنگلهای حرا در فیلیپین استفاده کرد. نتایج نشان داد که بین سطوح زیست توده با برخی از شاخص های پوشش گیاهی و شاخص سطح برگ همبستگی وجود دارد.
تمام اطلاعات ارائه شده در این آثار به عنوان یک پایگاه دانش برای ایجاد یک استراتژی مناسب برای انجام طبقه بندی مداخلات و نظارت بر وضعیت پوشش گیاهی در FMZ ها عمل می کند. این مقاله یک رویکرد یادگیری ماشین خودکار را ارائه میکند که از سریهای زمانی برای تشخیص اینکه آیا یک FMZ از دادههای ماهوارهای باز با وضوح ۱۰ در ۱۰ متر استفاده شده است یا نه، استفاده میکند. تا جایی که ما می دانیم، این اولین کاری است که یک رویکرد یادگیری ماشینی را برای تشخیص اینکه آیا FMZ ها طبق قانون حفظ می شوند پیشنهاد می کند. یادگیری ماشینی همراه با سنجش از راه دور می تواند روند نظارت بر این FMZ ها را تسریع بخشد که در غیر این صورت وقت گیر خواهد بود. علاوه بر این، هزینه های پولی مرتبط با کار دستی مورد نیاز برای نظارت بر FMZ ها را می توان با استفاده از داده های ماهواره ای باز کاهش داد. مشارکتهای این مقاله به شرح زیر است: (۱) روشی برای تشخیص مداخلات در FMZs ارائه شده است که از اطلاعات مربوط به پوشش گیاهی موجود در داخل و خارج از FMZs استفاده میکند. این رویکرد می تواند برای تجزیه و تحلیل هر نوع FMZ که تقریباً از مشخصات، ابعاد، شکل و هدف پیروی می کند استفاده شود. (۲) مجموعه ای از ابزارهای نرم افزاری که با توجه به اطلاعات برداری در مورد FMZ ها و مجموعه ای از تصاویر ماهواره ای می توانند معیارها را از الگوهای سری زمانی استخراج کنند و تخمین بزنند که آیا FMZ ها به درستی با درجه بالایی از دقت حفظ شده اند یا خیر. ابعاد، شکل و هدف؛ (۲) مجموعه ای از ابزارهای نرم افزاری که با توجه به اطلاعات برداری در مورد FMZ ها و مجموعه ای از تصاویر ماهواره ای می توانند معیارها را از الگوهای سری زمانی استخراج کنند و تخمین بزنند که آیا FMZ ها به درستی با درجه بالایی از دقت حفظ شده اند یا خیر. ابعاد، شکل و هدف؛ (۲) مجموعه ای از ابزارهای نرم افزاری که با توجه به اطلاعات برداری در مورد FMZ ها و مجموعه ای از تصاویر ماهواره ای می توانند معیارها را از الگوهای سری زمانی استخراج کنند و تخمین بزنند که آیا FMZ ها به درستی با درجه بالایی از دقت حفظ شده اند یا خیر.
این مقاله به شرح زیر سازماندهی شده است: بخش ۲ خط لوله پردازش آزمایشی را توصیف می کند، نشان می دهد که چگونه داده ها به دست آمدند و پردازش شدند، چگونه FMZ ها خوشه بندی شدند، و چگونه مجموعه داده ها ایجاد شدند. بخش ۳ نتایج را با جفت کردن چندین الگوریتم با مجموعه داده های مختلف نشان می دهد و مقایسه می کند. در نهایت، بخش ۴ و بخش ۵ بحث و نتیجه گیری را ارائه می کند.
۲٫ مواد و روشها
۲٫۱٫ منطقه مطالعه
همانطور که در شکل ۱ نشان داده شده است منطقه مورد مطالعه انتخاب شده Mação در ناحیه Santarém بود . این منطقه چندین بار دچار آتش سوزی شده و چندین سال است که FMZ ها را مدیریت می کند. این منطقه در بخش مرکزی پرتغال قاره ای واقع شده است (۳۹°۳۲’۵۴٫۷۰۸″ N–۸°۰’۱۷٫۹۹۶۴″ W) و FMZ های آن مساحتی در حدود ۴۲۶۳ هکتار را پوشش می دهند که ۱۱۲۰ هکتار آن FMZ در اطراف جاده ها است. همراه با اطلاعات جغرافیایی، در قالب برداری، در مورد FMZ های این شهرداری، همکاری بین NOVA LINCS (یک آزمایشگاه تحقیقاتی علوم کامپیوتر واقع در دانشکده علوم و فناوری دانشگاه NOVA لیسبون) و تالار شهر ماچائو ایجاد شد. اطلاعات مربوط به FMZهایی که در سال ۲۰۱۸ تحت درمان قرار گرفتند. در شکل ۲برخی از FMZهایی که تحت درمان قرار گرفته اند (سفید) و برخی دیگر که انجام نشده اند (قرمز) نشان داده شده اند. این نوع اطلاعات برای اعتبارسنجی مدل های ایجاد شده ضروری است.
۲٫۲٫ بررسی اجمالی رویکرد
برای تشخیص مداخله در یک FMZ، این کار مقایسه پوشش گیاهی داخل FMZs و پوشش گیاهی در نواحی بیرونی مجاور FMZs را با ایجاد بافرهایی در مجاورت مرزهای FMZs پیشنهاد میکند. FMZ ها ابعاد مختلفی دارند (عرض آنها بین ۱۰ تا ۱۲۵ متر متغیر است)، دارای فرمتی هستند که با توجه به نوع FMZ متفاوت است و همچنین لازم است تضمین شود که این بافرها در مناطق پوشش گیاهی قرار دارند. موادی که به عنوان پایه ای برای تجزیه و تحلیل استفاده می شوند، تصاویر ماهواره ای و اطلاعات برداری FMZs هستند.
تصاویر ماهواره ای از پیش پردازش شده است، و مناطق مورد علاقه برای به دست آوردن داده ها از مناطق FMZ که در حال تجزیه و تحلیل هستند، بریده شدند. اطلاعات برداری FMZs نیز از پیش پردازش شده و برای برش تصاویر ماهواره ای استفاده می شود. از تصویر حاصل، چندین معیار استخراج شده و سپس به الگوریتمهای یادگیری ماشینی برای پیشبینی وارد میشوند. الگوریتم هایی با بهترین نتایج در ادبیات برای ارزیابی اینکه کدامیک برای مسئله ارائه شده بهتر عمل می کند، استفاده شد. الگوریتمهای مورد استفاده عبارتند از: ماشین بردار پشتیبانی (SVM)، جنگل تصادفی (RF)، تقویت گرادیان شدید (XGBoost)، و نزدیکترین همسایه K (KNN). عملکرد این الگوریتم ها عمدتاً از طریق امتیاز F1 (معادله ( ۱ ) تجزیه و تحلیل خواهد شد.))، که با دقت و یادآوری کامل به حداکثر مقدار خود و امتیاز کاپا می رسد.
برای بهینه سازی الگوریتم های یادگیری، داده های ورودی به دو مجموعه آموزش و آزمایش با تقسیم ۷۰ و ۳۰ درصد تقسیم شدند. ۷۰ درصد از داده ها (مجموعه قطار) همراه با اعتبارسنجی متقابل ۵ برابری برای یافتن بهترین پارامترها برای همه الگوریتم ها از طریق جستجوی تصادفی پارامترهای الگوریتم استفاده شد.
۲٫۳٫ اکتساب داده های ماهواره ای
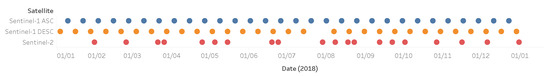
رویکرد مورد استفاده از ترکیبی از دادههای استخراجشده از دو صورت فلکی ماهواره، Sentinel-1 و Sentinel-2، و همچنین برخی از شاخصهای مشتقشده از دادههای چند طیفی استفاده میکند: NDVI [ ۲۳ ]، شاخص گیاهی تنظیمشده با خاک (SAVI) [ ۲۴ ] ، نسبت ساده (SR) [ ۲۵ ]، شاخص کلروفیل لبه قرمز معکوس (IRECI) [ ۲۶ ] و شاخص تفاوت عادی آب (NDWI) [ ۲۷ ]. داده های مورد استفاده در این مطالعه از کوپرنیک ESA بین ۳۰ ژانویه ۲۰۱۸ تا ۲۸ دسامبر ۲۰۱۸ استخراج شده است، توزیع تصاویر در طول سال در شکل ۳ ارائه شده است.، با مجموع ۲۰ تصویر برای Sentinel-2 و برای Sentinel-1، ۳۰ تصویر در مدار نزولی و ۳۰ تصویر در مدار صعودی. برای دادههای Sentinel-2، تنها تصاویری با درصد پوشش ابری زیر ۱۰ درصد در نظر گرفته شدند، که سپس به صورت دستی بررسی شدند تا اطمینان حاصل شود که هیچ ابری در منطقه مورد مطالعه وجود ندارد.
برخی از محصولات ماهواره Sentinel-2 فقط مقادیر بازتاب را در بالای جو (سطح ۱C) ارائه می دهند. این می تواند هنگام برخورد با داده های چند زمانی مشکل ساز باشد زیرا ترکیب لایه اتمسفر ثابت نیست و بسته به زمان سال یا حتی مکان می تواند متفاوت باشد. این ناپایداری بر مقادیر بهدستآمده توسط باندهای ماهوارهای و در نتیجه بر شاخصهای پوشش گیاهی محاسبهشده از آنها تأثیر میگذارد، بهویژه زمانی که از دادههای چند زمانی استفاده میشود [ ۲۸ ، ۲۹ ]. ابزار Sen2Cor [ ۳۰ ] برای پردازش داده های سطح ۱C Sentinel-2 به سطح اصلاح شده ۲A استفاده شد.
برای Sentinel-1، تصاویر با نوع محصول Ground Range Detected (GRD) در مدار نزولی و صعودی با مقادیر شدت تبدیل به Gamma0 استفاده شد. خط لوله پردازش، با استفاده از پلت فرم برنامه کاربردی نگهبان ESA (SNAP) (سکوی برنامه کاربردی نگهبان ESA (SNAP) — http://step.esa.int/main/toolboxes/snap/ — آخرین بازدید در ۶ مارس ۲۰۲۰)، به شرح زیر بود. : (۱) Apply-Orbit-File; (۲) تصحیح زمین. (۳) LinearToFromdB.
۲٫۴٫ پردازش اطلاعات برداری FMZs
همه انواع FMZ در یک فایل برداری واحد وجود دارد و برای تجزیه و تحلیل هر یک از آنها به صورت جداگانه لازم است که قبلا آنها را بر اساس نوع آنها جدا کنید. این جداسازی در ۴ نوع FMZ انجام شد: جاده ها، خطوط برق، سکونتگاه ها و FMZ اولیه، همانطور که در شکل ۴ ارائه شده است. روش مورد استفاده برای تشخیص اینکه آیا یک FMZ درمان شده است شامل مقایسه پوشش گیاهی داخل FMZ با پوشش گیاهی خارج از FMZ است. برای امکان پذیر ساختن این مقایسه، بافرهایی که خارج از FMZ با عرض ۲۰ متر هستند ایجاد شد. شکل چند ضلعی های به دست آمده که نشان دهنده FMZ هستند بسته به نوع آن متفاوت است و به همین دلیل فرآیند ایجاد بافرها باید تطبیق داده شود.
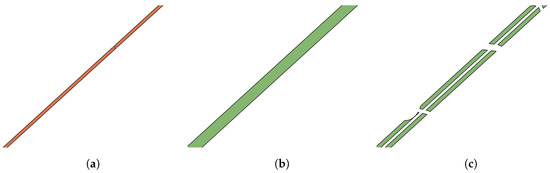
برای خطوط برق، جاده ها و FMZ اولیه، فرآیند ایجاد بافر مشابه است. نتیجه نهایی به همراه نتایج میانی در شکل ۵ ارائه شده است. ابتدا FMZ اصلی، شکل ۵ a را بگیرید و یک بافر با ۲۰ متر برای هر طرف اعمال کنید و شکل ۵ ب را بدست آورید. در نهایت، FMZ اصلی را از بافر جدا کنید تا فقط مناطق بیرونی را که در شکل ۵ نشان داده شده است، بدست آورید .
برای FMZ های اطراف خانه ها و سکونتگاه ها، ایجاد بافر پیچیده تر است، زیرا تنها بافر در قسمت بیرونی FMZ ها مورد نیاز است. این FMZ ها شکل دایره ای و سوراخ های زیادی دارند که ساختمان های واقعی در آن قرار دارند. اعمال یک بافر ساده، مناطق تقاطع زیادی را در داخل چند ضلعی ایجاد می کند. برای حل این مشکل، زنجیره پردازش ارائه شده در شکل ۶ اعمال می شود. ابتدا، تمام نقاط مربوط به فایل برداری FMZ را استخراج کرده و الگوریتم بدنه مقعر [ ۳۱ ] را اعمال کنید، در نتیجه، پوشش مجموعه ای از نقاط، موجود در شکل ۶ ب به دست می آید. پس از اعمال بدنه مقعر، چند ضلعی حاصل حل می شود و سوراخ های آن پر می شود و در نتیجه چند ضلعی ارائه شده در شکل ۶ ایجاد می شود.ج. در نهایت، یک بافر ۲۰ متری را روی FMZ اولیه اعمال کنید و از چند ضلعی حل شده برای برش در بافر استفاده کنید، و در نتیجه فقط بافر بیرونی FMZ ایجاد شود ( شکل ۶ د).
برخی از خطاها در بافرهای نهایی را می توان در شکل ۵ ج و شکل ۶ د مشاهده کرد. اطلاعات جاده استخراج شده از OpenStreetMap [ ۳۲ ] به بافرهای FMZ نهایی بریده شد، زیرا جاده ها بخشی از این FMZ ها نیستند. این کار مناطق بافر ناخواسته را که در آن FMZ ها دارای مناطقی در داخل آن هستند که به FMZ ها تعلق ندارند (مثلا جاده ها) حذف می کند.
۲٫۵٫ خوشه بندی برداری FMZs
FMZ ها گسترش زیادی دارند و برای تجزیه و تحلیل آنها، این مقاله یک رویکرد مبتنی بر شی را پیشنهاد می کند که در آن FMZ ها به بخش هایی با ابعاد تقریباً یکسان تقسیم می شوند. از آنجایی که تصاویر ماهواره ای وضوح فضایی ۱۰ متر دارند، برخی از FMZ ها می توانند چندین پیکسل عرض داشته باشند، که مقایسه مقادیر پیکسل های موجود در بافر با پیکسل های داخل FMZ را دشوار می کند. استفاده از یک رویکرد مبتنی بر شی، این مقایسه را با ترکیب مقدار چند پیکسل تنها در یک مقدار، و مقایسه دو مقدار (مقدار بافر با مقدار FMZ) ساده میکند. رویکرد مبتنی بر شی دارای مزایای دیگری مانند کاهش نویز پیکسل ها است که می تواند تحت تأثیر بازتاب ساختارهای مجاور قرار گیرد. یکی دیگر از مزایای این روش کاهش اندازه مجموعه داده ها است.
ایجاد بخش ها پس از ایجاد بافرها انجام می شود بنابراین هر بخش اطلاعاتی در مورد FMZ و بافر خارجی دارد. این بخش ها با استفاده از K-means [ ۳۳ ] ایجاد شدند که نتایج خوشه ای به عنوان بخش های FMZ نامیده می شود. با استفاده از K-means، بخشها برخی از ویژگیهای آن را به ارث میبرند، مانند ایجاد خوشههای غیر سلسله مراتبی و غیرهمپوشانی در یک الگوی Voronoi، که بخشهایی با اندازه مشابه همراه با وسعت FMZ ایجاد میکند. یکی از اشکالات K-means این است که قبل از اجرای الگوریتم باید تعداد خوشه ها (K) مشخص باشد.
روش استفاده شده به شرح زیر است: ابتدا پیکسل هایی که مربوط به فضای داخلی FMZ و بافر هستند را به نقاط تبدیل کنید ( شکل ۷).آ). سپس K با تقسیم تعداد کل نقاط یک FMZ بر تعداد پیکسل های مورد نظر در یک بخش انتخاب می شود. به عنوان مثال، در مورد FMZ های کنار جاده ها، با مجموع ۲۰۸۰۰۰ نقطه و ۴۰ نقطه در هر خوشه، ۵۲۰۰ قطعه به دست آمد. پس از آزمایش طیفی از اعداد ۱۰ تا ۱۰۰ امتیاز در هر خوشه، ۴۰ امتیاز برای ارائه نتایج و روش شناسی این مقاله انتخاب شد. این مقدار مقداری است که بخش هایی از FMZ ها را بهتر نشان می دهد و قسمت های داخلی و خارجی آنها را قطع می کند. تعداد نقاط در هر بخش نمیتواند بسیار کم باشد (مثلاً ۱۰)، زیرا بخشهایی را ایجاد میکند که نوار و بافر بیرونی آن را نمیپوشاند، و همچنین نمیتواند خیلی زیاد باشد (مثلاً ۱۰۰) تا احتمال وجود یک بخش حاوی تیمار را کاهش دهد. و مناطق درمان نشده پس از بازرسی چشمی، این مقدار تعادل بین وضوح پیکسل ها، عرض FMZ ها و بافرهای ایجاد شده را نشان می دهد. در نهایت، برای به دست آوردن چند ضلعی که مربوط به یک بخش است، الگوریتم Convex Hull برای هر خوشه تولید شده توسط K-Means اجرا می شود. نتیجه مجموعه ای از چند ضلعی ها با مساحت تقریباً یکسان است که کل FMZ را پوشش می دهد (شکل ۷ ب) و اطلاعاتی را در مورد اینکه کدام نقاط به داخل و خارج FMZ تعلق دارند را حفظ می کند. نمونه هایی از نتایج نهایی برای هر نوع FMZ در شکل ۸ نشان داده شده است. لطفاً توجه داشته باشید که نوع FMZ بر شکل کلی بخش ها تأثیر می گذارد.
۲٫۶٫ مجموعه داده ها
ویژگی های چندگانه برای توصیف فضای داخلی FMZ و بافر بیرونی برای هر بخش استفاده شد. علاوه بر داده های ماهواره ای، ویژگی های جدیدی با استفاده از باندهای Sentinel-2 و قطبش Sentinel-1 استخراج شد. ویژگی های استخراج شده در جدول ۱ موجود است. برای Sentinel-1 تفاوت و نسبت بین پلاریزاسیون VV و VH در مدارهای صعودی و نزولی محاسبه شده است زیرا قبلاً نشان داده شده است که دقت طبقه بندی را بهبود می بخشند [ ۳۴ ]. برای Sentinel-2 برخی از شاخص های پوشش گیاهی به دست آمد.
با این ویژگی ها، ۵ مجموعه داده برای مقایسه تأثیر هر گروه از ویژگی ها در نتایج ایجاد شد ( جدول ۲ ). مجموعه داده DS_ALL دارای تمام باندهای Sentinel-2، شاخص های پوشش گیاهی و قطبش های Sentinel-1 است، مجموعه داده DS_INDICES فقط دارای شاخص های پوشش گیاهی و DS_BAND فقط دارای باندهای ماهواره ای است. DS_FUSION با استفاده از نوارهای قرمز، سبز، لبه قرمز و نزدیک به مادون قرمز، که نوارهایی هستند که در محاسبات شاخصهای پوشش گیاهی استفاده میشوند، و دو شاخص که ویژگیهای پوشش گیاهی مختلف را ارزیابی میکنند ایجاد شد: NDVI و NDWI. در نهایت، DS_SAR منحصراً از داده های Sentinel-1 استفاده می کند.
برای هر یک از این ویژگی ها، اطلاعات از داخل FMZ و بافر بیرونی استخراج شد. با تکمیل آن، تفاوت (معادله ( ۲ )) و نسبت (معادله ( ۳ )) بین بافر بیرونی و FMZ داخلی برای هر مشخصه محاسبه شد. با این کار، هر بخش به داده هایی در مورد بافر، FMZ، تفاوت و نسبت ها ختم می شود.
جایی که ایکسبنشان دهنده داده های بافر و ایکسمنداده های FMZ، برای مشخصه x .
تجزیه و تحلیل چند زمانی می تواند از چندین تصویر استخراج شده استفاده کند، زیرا برای هر مشخصه تفاوت بین دو تاریخ متوالی برای کل سری زمانی محاسبه می شود (معادله ( ۴ )).
جایی که دمنfایکس،کنشان دهنده تفاوت بین بافر بیرونی و داخلی FMZ برای ویژگی x در تاریخ k است.
در تحلیل زمانی، هر یک از این ویژگیها یک الگوی زمانی ایجاد میکنند و از آن الگو، معیارهای حداکثر، حداقل، میانگین و انحراف معیار استخراج میشوند. این مقادیر به عنوان نمایشی از رفتار پوشش گیاهی در طول زمان، برای هر بخش استفاده می شود.
۳٫ نتایج
در این بخش، نتایج هم برای تجزیه و تحلیل استاتیک (فقط یک تاریخ، بخش ۳٫۱ ) و هم برای تجزیه و تحلیل زمانی (داده های سری زمانی از سال ۲۰۱۸، بخش ۳٫۲ ) برای جاده ها ارائه شده است. سایر انواع FMZ به دلیل عدم قطعیت و عدم وجود حقیقت پایه، از تجزیه و تحلیل دقیق تر حذف شدند. برای هر دو نوع تجزیه و تحلیل، چهار الگوریتم انتخابی (KNN، RF، SVM، و XGBoost) بر روی تمام مجموعههای داده تعریفشده آموزش داده شدند. علاوه بر این، تمام تجربیات تجزیه و تحلیل زمانی با و بدون دادههای Sentinel-1 تکرار شد، زیرا این امکان ارزیابی تأثیر دادههای رادار در تشخیص مداخلات FMZs را فراهم میکرد. هم کد و هم داده های مورد استفاده برای به دست آوردن این نتایج به صورت آنلاین در دسترس هستندhttps://bitbucket.org/rfafonso/fuel-management-zones-interventions/commits/cef0be1 .
۳٫۱٫ تجزیه و تحلیل استاتیک
اولین تجزیه و تحلیل شامل مقایسه مجموعه داده های مختلف با استفاده از داده های Sentinel-2 تنها از یک تاریخ، ۱۲ سپتامبر است، این نزدیک ترین تاریخ به حقیقت اصلی ما است. شکل ۹ مقادیر امتیاز F1 را برای الگوریتم های مورد استفاده و مجموعه داده های مختلف نشان می دهد، توجه داشته باشید که مجموعه داده ها بر اساس عملکرد و مدل مرتب شده اند. RF و XGBoost الگوریتم هایی بودند که نتایج بهتری به دست آوردند و RF به مقادیر کمی بهتر رسید.
مجموعه داده DS_ALL به طور مداوم نتایج خوبی را برای همه الگوریتمها ارائه میدهد و بهترین نتیجه با استفاده از این مجموعه داده با الگوریتم RF به دست آمد. انتخاب مجموعه داده، در این مورد، می تواند تأثیر زیادی بر نتایج داشته باشد، در برخی موارد، در امتیاز F1 بیش از ۴ درصد تأثیر دارد. کمترین نتیجه با استفاده از مجموعه داده DS_INDICES با SVM به دست آمد که منجر به امتیاز F1 0.83 شد.
با تجزیه و تحلیل با جزئیات بیشتر ترکیبی که بهترین نتایج را ایجاد کرد (RF با استفاده از مجموعه داده DS_ALL ) با استفاده از یک ماتریس سردرگمی ( جدول ۳ )، کلاس بخشهای «درمان نشده» بخشهایی با امتیاز F1 بالاتر ۰٫۹۸ و با دقت و دقت بود. فراخوانی به ترتیب ۰٫۹۸ و ۰٫۹۹٫ کلاس بخشهای «درمانشده» دارای ارزش امتیاز F1 پایینتر ۰٫۸۲ بود.
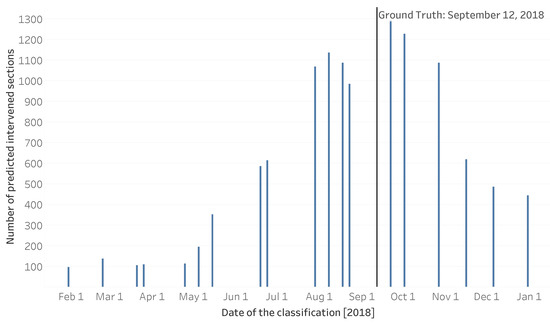
اگرچه بهترین مدل کاملاً خوب عمل می کند، نتایج قبلی تنها تا یک تاریخ، ۱۲ سپتامبر نشان داده شده است، با توجه به اینکه تنها حقیقت اصلی برای آن تاریخ خاص وجود دارد. از آنجایی که تجزیه و تحلیل استاتیک تنها از تصاویر ماهوارهای مرجع از یک تاریخ برای آموزش مدل استفاده میکند، میتوان از محصولات دیگر حذف شده برای بررسی اینکه آیا رفتار الگوریتم مطابق انتظار است، استفاده کرد. این مدل (RF) با تصویر مرجع از ۱۲ شهریور و حقیقت زمین تا همان تاریخ آموزش داده شد. سپس این مدل برای هر تاریخی که داده Sentinel-2 داشت، اعمال شد. این نشان می دهد که چگونه مدل با داده ها قبل (شروع سال)، در طول (اواسط سال) و بعد از مداخلات (پایان سال) رفتار می کند. این تحلیل به ویژه جالب است زیرا حقیقت زمینی مداخلات در FMZ ها را تا ۱۲ سپتامبر نشان می دهد. به این معنی که مداخلات می توانند در تصاویر در مقاطع زمانی مشخص قبل از آن تاریخ ظاهر شوند. که درشکل ۱۰ تعداد بخش های طبقه بندی شده به عنوان درمان برای هر تاریخ ارائه شده است.
هیچ معیار دقیقی برای نتایج تاریخ های قبل و در طول دوره مداخله مشاهده شده وجود ندارد زیرا حقیقت زمین تاریخ مداخله را برای هر بخش ندارد. با پیشرفت طبقه بندی در طول سال، تعداد مداخلات شناسایی شده به محض انجام اولین مداخله شروع به افزایش می کند. همانطور که FMZ های بیشتری در طول سال تمیز می شوند، مدل می تواند آن مداخلات را شناسایی کند. پس از تاریخ حقیقت زمین، تعداد مناطق مداخله شناسایی شده شروع به کاهش می کند، عمدتاً به دلیل رشد مجدد پوشش گیاهی و سایه ها یا پیکسل های منطقه تاریک در تصاویر در پایان سال.
۳٫۲٫ تحلیل زمانی
FMZها در امتداد جادهها نیز با استفاده از دادههای سری زمانی با سه ساختار اصلی تجزیه و تحلیل شدند: دادههای Sentinel-1، دادههای Sentinel-2، و با ترکیب دادههای Sentinel-2 و Sentinel-1.
۳٫۲٫۱٫ یک ماهواره: Sentinel-1
برای رویکرد داده Sentinel-1، دو قطبی (VV و VH) و مدار چندگانه (صعودی و نزولی) محصولات (DS_SAR) استفاده شد. حتی هنگام استفاده از رویکرد زمانی، دقت این ماهواره به طور قابل توجهی کمتر از Sentinel-2 در تجزیه و تحلیل استاتیک بود، که بین امتیاز F1 0.6208 و ۰٫۶۸۷۲ برای همه مدلها و با امتیاز کاپا پایین بین ۰٫۲۵۰۸ و ۰٫۳۷۶۹ در نوسان بود. با این وجود، RF امتیاز F1 0.69 را به دست آورد. از سوی دیگر، SVM و KNN نتایج کمتری به دست آوردند، زیرا آنها قادر به طبقهبندی بخشهای درمانشده به درستی نبودند و بیشتر نمونهها را به عنوان بخشهای درماننشده طبقهبندی کردند. این رفتار برای مدل های دیگر نیز صادق است، بنابراین مقادیر توافق کاپا پایین است.
هنگامی که ماتریس سردرگمی ( جدول ۴ ) نتایج RF را با جزئیات بیشتر تجزیه و تحلیل میکنیم، نشان میدهد که معیارهای بخشهای درماننشده تأثیر زیادی بر ارزش امتیاز جهانی F1 دارند، زیرا بخشهای درمانشده فقط دارای یک امتیاز F1 هستند. ۰٫۴۴٫
۳٫۲٫۲٫ یک ماهواره: Sentinel-2
شکل ۱۱ نتایج طبقه بندی آزمایش سری زمانی را با استفاده از داده های Sentinel-2 نشان می دهد، توجه داشته باشید که مجموعه داده ها بر اساس عملکرد و مدل مرتب شده اند. همه مجموعه داده ها، به جز DS_INDICES ، نتایج مشابهی به دست آوردند. در مقایسه DS_INDICES با سایر مجموعههای داده، برای الگوریتمهای KNN و SVM، نتایج بهطور قابلتوجهی پایینتر بود و حدود ۲۲ درصد کمتر از بهترین نتایج برای KNN بود. برخلاف تجزیه و تحلیل استاتیک، نتایج طبقهبندیکننده SVM توانستند از روشهای مجموعه (به استثنای مجموعه دادههای DS_INDICES ) بهتر عمل کنند. بهترین الگوریتم SVM با امتیاز F1 0.93 بود، با این وجود، XGBoost و RF نتایجی را ایجاد کردند که واریانس کمتری در بین مجموعه دادهها دارند.
جدول ۵ ماتریس سردرگمی را برای بهترین نتایج نشان می دهد که SVM از مجموعه داده DS_BAND استفاده می کند. کلاس بخشهای «درمان نشده» معیارهای بسیار بالایی نزدیک به ۱ داشت. برای کلاس بخشهای «درمانشده»، معیارها پایینتر، اما همچنان خوب بودند، با امتیاز F1 0.88، و تنها ۱۰ بخش بهطور نادرست به عنوان درمانشده طبقهبندی شدند.
با استفاده از سری های زمانی، در مقایسه با تجزیه و تحلیل استاتیک، در طبقه بندی بخش های درمان شده و درمان نشده برای FMZ ها در امتداد جاده ها، با امتیاز F1 کلاس بخش های درمان شده از ۰٫۸۲ به ۰٫۸۸ افزایش یافته است.
با تجزیه و تحلیل دقیق تر خطاها، در شکل ۱۲ دو نمونه از بخش هایی وجود دارد که به اشتباه به عنوان درمان طبقه بندی شده اند. این بخش ها در مناطق تقاطع بین FMZ هایی هستند که تحت درمان قرار گرفتند و FMZ هایی که درمان نشده اند ( شکل ۱۲ a) یا در حد بین داخلی و خارجی خوشه های خانه ( شکل ۱۲ ب).
۳٫۲٫۳٫ هر دو ماهواره: Sentinel-1 و Sentinel-2
اطلاعات Sentinel-2 و Sentinel-1 با هم ادغام شدند تا بررسی شود که آیا در نتایج تأثیر داشته است یا خیر. شکل ۱۳مقادیر امتیاز F1 را برای الگوریتم ها و مجموعه داده های مختلف ارائه می دهد، توجه داشته باشید که مجموعه داده ها بر اساس عملکرد و مدل مرتب شده اند. در سطح جهانی، این مقادیر رفتاری مشابه با مقادیر مشاهده شده تنها با استفاده از داده های Sentinel-2 حفظ کردند. برای SVM، بهترین مقادیر امتیاز F1 در مقایسه با استفاده از داده Sentinel-2 تغییری نکرد. برای RF، امتیاز F1 در تمام مجموعه داده ها کمی افزایش یافته است. این ترکیب داده بیشترین تأثیر را در نتایج XGBoost داشت و امتیاز F1 را بیش از ۱ درصد در مقایسه با استفاده از دادههای Sentinel-2 افزایش داد. در این آزمایش، الگوریتم XGBoost با بهترین نتایج به امتیاز F1 0.94 رسید. به طور کلی، استفاده از دادههای Sentinel-1 همراه با دادههای Sentinel-2 بهبودهایی را در نتایج الگوریتمها نشان داد.
۳٫۳٫ تخمین تاریخ مداخله FMZs
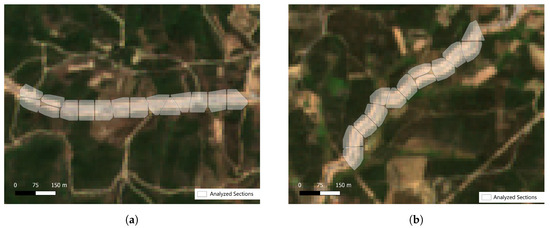
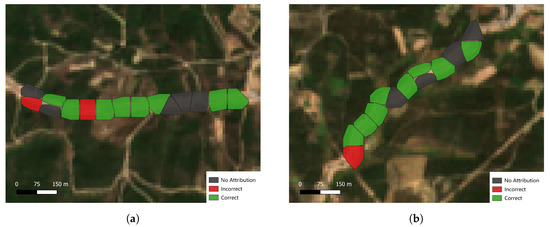
هدف این کار طبقهبندی اینکه آیا FMZها درمان و نگهداری میشوند یا خیر، اما مشخص کردن اینکه چه زمانی همان FMZها درمان میشوند نیز جالب است. برای این منظور، یک آزمایش اضافی برای تخمین تاریخ هایی که در آن مداخلات در FMZ ها رخ داده است، انجام شد. برای دستیابی به این هدف، برخی از بخشهای خوشهای برای تجزیه و تحلیل بیشتر انتخاب شدند. این بخش ها در همان زمان از سال درمان شدند، اما بخشی از دو مکان مختلف هستند: سایت A ( شکل ۱۴ الف) و سایت B ( شکل ۱۴ ب).
این FMZ ها به طور خاص به دلیل عدم دسترسی به اطلاعات رسمی آنها توسط تالار شهر Mação انتخاب شده اند، و به این دلیل که دخالت FMZ ها در اطراف جاده ها در تصاویر ماهواره ای به راحتی قابل توجه است. همانطور که در شکل ۱۵ مشاهده می شود ، برای سایت A، مقادیر NDVI قبل و بعد از مداخله تغییرات شدیدی دارند. همین امر را می توان برای سایت B در شکل ۱۶ مشاهده کرد. یک مقدار آستانه ساده به عنوان طبقه بندی کننده با استفاده از الگوی زمانی استفاده شد ΔدمنfنDVمن(معادله ( ۴ )) که تفاوت را محاسبه می کند دمنfنDVمن(معادله ( ۲ )) در دو تاریخ متوالی. با ایجاد آستانه ای از ل=۰٫۱۰، یک FMZ در زمانی که درمان می شود فرض می شود ΔدمنfنDVمن>ل. این شاخص نشان دهنده افت ناگهانی مقادیر FMZ NDVI در ماه های متوالی است، در حالی که مقادیر در بافر بیرونی تغییرات کمی دارند.
نتایج برای هر دو سایت در شکل ۱۷ ارائه شده است. در هر دو مورد، اکثر تاریخهای مداخله برآورد شده با تاریخ مشاهده دستی مطابقت دارد، که تنها در ۳ بخش از ۲۸ مورد شکست خورده است. اما برای چندین بخش، هیچ نتیجهای وجود ندارد. در مجموع، ۱۶ بخش به درستی، ۳ بخش نادرست و ۹ بخش فاقد تاریخ مداخله تخمینی بودند (یعنی دمنfنDVمن=<0.10).
۴٫ بحث
در این مقاله، دو نوع تجزیه و تحلیل انجام شد: تجزیه و تحلیل استاتیک، با استفاده از تنها دادههای Sentinel-2 از یک تاریخ، و تجزیه و تحلیل زمانی با استفاده از الگوهای زمانی ویژگیهای Sentinel-2 و Sentinel-1. FMZs در امتداد جاده ها با استفاده از الگوریتم های طبقه بندی و الگوهای زمانی برای طبقه بندی بخش های FMZ که تحت درمان قرار گرفتند، تجزیه و تحلیل شدند. ارزیابی الگوریتمهای طبقهبندی مختلف، هم در تحلیل زمانی و هم در تحلیل استاتیک، با مقایسه نتایج این الگوریتمها با استفاده از مجموعه دادههای مختلف انجام شد. علاوه بر این آزمایشهای طبقهبندی، آزمایشی نیز برای تعیین تاریخ مداخله FMZs در امتداد جادهها انجام شد. در این بخش، نتایج آزمایش های مختلف مورد بحث قرار می گیرد.
الگوریتم های طبقه بندی مختلف در این کار استفاده شد: RF، SVM، XGBoost، و KNN. الگوریتم هایی که برجسته هستند XGBoost و RF هستند که تقریباً در همه آزمایش ها بهترین نتایج را به دست آوردند. الگوریتم هایی که به طور کلی بدترین نتایج را به دست آوردند SVM و KNN بودند. در تجزیه و تحلیل استاتیک، SVM با استفاده از مجموعه داده DS_INDICES کمترین نتایج را به دست آورد . با این حال، در تجزیه و تحلیل زمانی، نتایج این الگوریتمها بهطور قابلتوجهی بهبود یافت، به گونهای که SVM با استفاده از دادههای Sentinel-2 بلافاصله پشت سر XGBoost قرار گرفت. با این وجود، روشهای مجموعه، مانند RF و XGBoost، روشها میتوانند به طور مداوم به عملکرد بالایی دست یابند و عملکرد در هر مجموعه داده با حاشیه زیادی تغییر نمیکند.
با توجه به دادهها، پنج مجموعه داده مختلف با هم مقایسه شدند: DS_ALL ، DS_INDICES ، DS_BAND ، DS_FUSION ، و DS_SAR . در تجزیه و تحلیل استاتیک، تنها داده های Sentinel-2 استفاده شد و در تجزیه و تحلیل زمانی اطلاعات Sentinel-1 اضافه شد. در هر دو تجزیه و تحلیل زمانی و استاتیک، مجموعه داده DS_ALL همیشه در میان مجموعه دادههایی با بالاترین معیارها قرار داشت و به دلیل داشتن اطلاعات بیشتر برای الگوریتمها، در اکثر آزمایشها بهترین بود. DS_INDICES تقریباً در تمام آزمایشات در مقایسه با DS_BAND نتایج بدتری به دست آوردمجموعه داده، اغلب با تفاوت زیادی بین نتایج هر دو. در تجزیه و تحلیل زمانی، برای الگوریتمهای RF و XGBoost، DS_INDICES امتیاز F1 نزدیک به بهترین نتایج را به دست آورد. با این حال برای SVM و KNN نتایج کمتر بود، با اختلاف ۲۲٪ برای بهترین نتیجه در یکی از آزمایش ها (استفاده از KNN در FMZs در امتداد جاده ها). می توان نتیجه گرفت که شاخص های پوشش گیاهی به خودی خود به اندازه کافی گویا نیستند تا خواص FMZ ها را مدل کنند تا مشخص شود که آیا آنها درمان شده اند یا نه. علاوه بر این، SVM و KNN تمایل به بیش از حد برازش در DS_INDICES را نشان دادند .
تجزیه و تحلیل زمانی با استفاده از مجموعه داده DS_SAR(فقط داده های Sentinel-1) نتایج قابل توجهی پایین تری ایجاد کرد. اگرچه کاپا میانگین امتیاز F1 را کسب کرد، اما کاپا به ۰٫۲۵ رسید. این نشان می دهد که این نوع داده ها به اندازه کافی قابل اعتماد نیستند تا برای این نوع برنامه ها مورد استفاده قرار گیرند. تحقیقات بیشتری مورد نیاز است تا ببینیم آیا میتوان عملکرد بیشتری را از دادههای SAR، چه با مدلهای جدید یا یک خط لوله پردازش متفاوت (مثلاً افزودن اطلاعات بافتی) به کار برد. دادههای SAR مخصوصاً زمانی جالب هستند که دادههای چند طیفی در دسترس نباشند، برای مثال زمانی که پوشش ابری در منطقه مورد مطالعه وجود دارد. حتی با عملکرد پایین SAR، ترکیب Sentinel-1 و Sentinel-2 بهبود جزئی در نتایج نشان داد، با بیشترین بهبود در امتیاز F1، که تقریباً ۲٪ افزایش یافت. اگرچه امتیاز جهانی F1 در هنگام استفاده از دادههای Sentinel-2 و Sentinel-2 در ارتباط با دادههای Sentinel-1 برابر است، تفاوتی در نتایج برای کلاس بخشهای تحت درمان وجود داشت. فقط با داده های Sentinel-2، کلاس بخش های درمان شده دارای امتیاز F1 0.88 بود، زمانی که داده های Sentinel-1 را اضافه کرد، این مقدار به ۰٫۹۰ افزایش یافت. ترکیب Sentinel-1 و Sentinel-2 می تواند عملکرد الگوریتم های پیشنهادی را افزایش دهد. حتی اگر افزایش عملکرد در ۲٪ اندازه گیری شد، در دسترس بودن بالای داده های Sentinel-1 (که تحت تأثیر پوشش ابری قرار نمی گیرد) می تواند مفید باشد. با این حال، باید تنها اشکال اصلی آن در ارتباط با پیچیدگی پیشفرض دادهها در نظر گرفته شود. کلاس بخش های درمان شده دارای امتیاز F1 0.88 بود که هنگام اضافه کردن داده های Sentinel-1 این مقدار به ۰٫۹۰ افزایش یافت. ترکیب Sentinel-1 و Sentinel-2 می تواند عملکرد الگوریتم های پیشنهادی را افزایش دهد. حتی اگر افزایش عملکرد در ۲٪ اندازه گیری شد، در دسترس بودن بالای داده های Sentinel-1 (که تحت تأثیر پوشش ابری قرار نمی گیرد) می تواند مفید باشد. با این حال، باید تنها اشکال اصلی آن در ارتباط با پیچیدگی پیشفرض دادهها در نظر گرفته شود. کلاس بخش های درمان شده دارای امتیاز F1 0.88 بود که هنگام اضافه کردن داده های Sentinel-1 این مقدار به ۰٫۹۰ افزایش یافت. ترکیب Sentinel-1 و Sentinel-2 می تواند عملکرد الگوریتم های پیشنهادی را افزایش دهد. حتی اگر افزایش عملکرد در ۲٪ اندازه گیری شد، در دسترس بودن بالای داده های Sentinel-1 (که تحت تأثیر پوشش ابری قرار نمی گیرد) می تواند مفید باشد. با این حال، باید تنها اشکال اصلی آن در ارتباط با پیچیدگی پیشفرض دادهها در نظر گرفته شود.
در نهایت، از آنجایی که نه تنها مهم است که بدانیم آیا FMZ ها درمان می شوند یا خیر، بلکه مهم است که آزمایش نهایی چه زمانی انجام شده است. هدف اصلی ایجاد الگوریتمی بود که بتواند تقریباً تاریخ مداخلات را تخمین بزند. در هر دو منطقه مورد مطالعه، الگوریتم بسیار خوب عمل کرد و بسیاری از تاریخهای مداخله را در مقایسه با مواردی که پس از معاینه دستی بهدست آمدند، درست تشخیص داد. این آزمایش نقش اثبات مفهوم را داشت، زیرا حجم نمونه کوچکتر بود، اما به عنوان نقطه شروعی برای تحقیقات آینده در مورد تخمین تاریخ مداخله عمل می کند. این کار می تواند به حل ابهامات و عدم قطعیت در حقیقت زمینی در مورد FMZ کمک کند.
تحقیقات کامل برای کار مرتبط هیچ مطالعه قبلی که مستقیماً به تجزیه و تحلیل وضعیت FMZ ها نزدیک شود، به همراه نداشت. به طور کلی، نتایج ارائه شده بسیار خوب هستند و نشان میدهند که استفاده از تکنیکهای سنجش از دور در ارتباط با الگوریتمهای طبقهبندی میتواند به تشخیص مداخلات در FMZها کمک کند و حفاظت در برابر آتش را در اطراف مناطق شناسایی شده ارتقا دهد.
۵٫ نتیجه گیری ها
این کار روش جدیدی را برای تشخیص مداخلات در FMZ با استفاده از الگوریتمهای یادگیری ماشین و تصاویر ماهوارهای Sentinel-2 و Sentinel-1 ارائه کرد. ترکیب یادگیری ماشینی و داده های ماهواره ای باز می تواند هزینه های مربوط به بررسی دستی FMZ ها را کاهش دهد. این فرآیند همچنین مقیاس پذیر است زیرا فقط نیاز به استخراج تصاویر ماهواره ای بیشتری از منطقه مورد مطالعه دارد. تکنیک اصلی مورد استفاده برای تشخیص یک مداخله استخراج اطلاعات در مورد پوشش گیاهی در داخل و خارج یک FMZ برای تشخیص تغییرات بود. این رویکرد مستلزم ایجاد بافرهایی در خارج از FMZ، در مناطق پوشش گیاهی بود که بسته به نوع FMZ میتواند پیچیده باشد. این اطلاعات در مورد فضای داخلی و خارجی FMZ ها سپس برای تولید ویژگی های جدید از تصاویر طیفی و رادیومتری ورودی ماهواره استفاده می شود. روش پیشنهادی میتواند بهعنوان پایهای برای کار آینده در تشخیص رشد و نگهداری پوشش گیاهی در مناطق حساس به آتشسوزی جنگلها، در این مورد، FMZs باشد.
نتایج نشان میدهد که استفاده از دادههای ماهوارهای را میتوان برای تشخیص اینکه آیا FMZ به درستی تمیز و نگهداری میشود، در نتیجه حفاظت از آتشسوزی جنگلها را بهبود میبخشد. همانطور که انتظار می رفت، به دلیل داشتن اطلاعات بیشتر، داده های سری زمانی نتایج بهتری نسبت به استفاده از تنها یک تاریخ داشتند. علاوه بر این، از بین تمام مجموعه دادههای آزمایش شده، DS_ALL بهترین امتیازات را در کل داشت. با توجه به الگوریتمهای یادگیری ماشینی مورد استفاده، روشهای مجموعه (RF و XGBoost) با داشتن امتیازات خوب در سراسر صفحه، در هنگام کار با دادههای سنجش از دور قوی هستند. در آزمایشها، بهترین امتیازات توسط XGBoost هنگامی که با بهترین مجموعه داده، DS_FUSION ترکیب میشود ، به دست آمد که از دادههای طیفی و راداری و همچنین برخی از شاخصهای گیاهی مشتق شده استفاده میکند.
اگرچه نتایج ارائه شده در این کار به FMZ های جاده ای اشاره دارد، آزمایش های دیگری در انواع دیگر FMZ ها، به ویژه برای خطوط الکتریکی FMZ انجام شد. به دلیل عدم قطعیت در مورد حقیقت زمینی این نوع FMZ، نتایج در اینجا نشان داده نشده است. با این وجود، کار مقدماتی امیدوارکننده است، حتی اگر به دلیل عدم قطعیت در حقیقت اصلی، نمی تواند همان سطح قطعیت نتایج را داشته باشد. جدای از آن، امتیازات خطوط برق FMZs میتواند تحت تأثیر عوامل مختلفی مانند تعمیر و نگهداری منظم به دلیل خطر آتشسوزی مرتبط با این خطوط قرار گیرد، که تشخیص تغییر پوشش گیاهی را دشوارتر میکند. اندازه بخش های این نوع FMZ کوچکتر است و در نتیجه اطلاعات کمتری نسبت به بخش های جاده دارد.