۱٫ مقدمه
با توسعه سریع فناوری سنجش از دور و دسترسی رایگان به داده ها، نقشه های بیشتر و بیشتری از پوشش زمین از طریق تجزیه و تحلیل طبقه بندی تصویر در دهه های اخیر تولید شده است [ ۱ ]. چنین محصولاتی برای کاربردهای نظارت بر محیط زیست، مانند مطالعات اکوسیستم های مرتبط با آب، گسترش زمین شهری، از دست دادن زمین های زیر کشت و جنگل زدایی مهم هستند [ ۲ ]. با این حال، انواع مختلفی از خطاها و عدم قطعیت ها در طول فرآیند تولید داده های پوشش زمین مواجه می شوند. در اکتساب، پردازش، طبقه بندی و تجزیه و تحلیل داده ها [ ۳ ، ۴ ، ۵]؛ و تأثیر این خطاها مستقیماً بر کیفیت محصول نهایی تأثیر می گذارد. بنابراین، یک تخمین بی طرفانه از دقت محصولات پوشش زمین ضروری است.
در مطالعات تحقیقاتی قبلی، ارزیابی دقت برای اعتبارسنجی محصولات پوشش زمین و ارائه درک بهتری از کیفیت محصول به کاربر استفاده شده است [ ۶ ]. نتیجه ارزیابی دقت همچنین میتواند به تولیدکنندگان در بهبود طبقهبندی، جستجوی ویژگیهای طبقهبندی بهینه، یا ترکیب دادههای خارجی برای بهبود دقت طبقهبندی کمک کند [ ۷ ]. فرآیند اصلی ارزیابی دقت، کمی کردن سازگاری فضایی و ویژگیها بین محصول طبقهبندی و دادههای مرجع است [ ۶ ]. با توجه به اصول آمار، چندین نقطه نمونه معرف را می توان در فضای جغرافیایی انتخاب کرد و داده های مرجع مربوطه را که می تواند حقیقت پایه را منعکس کند انتخاب شود [ ۸ ]]. سپس برچسب های مرجع را می توان به صورت بصری از داده های با وضوح بسیار بالا، مانند عکس های هوایی یا داده های اندازه گیری میدانی [ ۹ ] تفسیر کرد. بنابراین، اجرای ارزیابی دقیق آماری دقیق میتواند بر اساس شیوههای خوب [ ۱۰ ] و برآورد مبتنی بر نمونهبرداری، که منعکسکننده سازگاری طبقهبندی نقشه و دادههای مرجع [ ۱۱ ] باشد، به دست آید.]. ماتریس خطا یک جدول بندی متقابل از برچسب های طبقه بندی نقشه در برابر برچسب های داده مرجع است. ردیف های آن نشان دهنده برچسب های طبقه بندی نقشه و ستون ها نشان دهنده برچسب های داده های مرجع هستند. سپس، ورودیهای مربوطه برای محاسبه دقت کلی، دقت تولیدکننده، و دقت کاربر با انحرافات استاندارد در فواصل اطمینان مختلف (بیشتر از فاصله اطمینان ۹۵ درصد و فاصله اطمینان ۹۰ درصد استفاده شد) استفاده شد [ ۱۲ ، ۱۳ ، ۱۴ ]. در یک برنامه طبقه بندی باینری، دقت، یادآوری و امتیاز F نقش مهمی در محاسبه دقت بازی می کند [ ۱۵ ].
بسیاری از مطالعات تحقیقاتی گذشته به ارزیابی دقت محصولات جهانی پوشش زمین به شیوهای آماری دقیق اختصاص داشت [ ۱۰ ]. به عنوان مثال، مایو و همکاران. [ ۱۶ ] ارزیابی محصول GLC2000 را با ترکیب یک روش اعتمادسازی و نمونهگیری تصادفی طبقهای انجام داد و دقت کلی ۶۸٫۶% را گزارش کرد. گونگ و همکاران [ ۱۷ ] محصول مشاهده و نظارت با وضوح دقیق – پوشش زمین جهانی (FROM-GLC) را تولید و تخمین زد، کره را با شش ضلعی تقسیم کرد و پنج نمونه تصادفی از هر شش ضلعی انتخاب کرد. طبقهبندیکننده ماشین بردار پشتیبان بالاترین دقت طبقهبندی کلی را با ۶۴٫۹٪ تولید کرد. محصول منطقه سوخته جهانی MODIS-MCD45 توسط Padilla و همکاران تأیید شد. [ ۱۸] در سال ۲۰۰۸؛ نمونه گیری تصادفی طبقه ای برای انتخاب ۱۰۲ نمونه منطقه صحنه تیسن استفاده شد. برای تخصیص اندازه نمونه به اقشار بر اساس وسعت منطقه سوخته، هم دقت کلی و هم دقت برای برخی از بیومهای زمینی برآورد شد. سازگاری زمانی نقشههای سری زمانی طولانی در حال حاضر منطقه مورد توجه است [ ۱۹ ]. لیو و همکاران [ ۲۰] یک نقشه جهانی سطح غیرقابل نفوذ ۳۰ متری تهیه کرد و در مجموع ۱۱۹۴۲ نقطه نمونه به طور تصادفی در ۱۵ منطقه تأیید معمولی برای تأیید صحت آنها انتخاب شدند. دقت کلی آن ۹۵٫۱٪ و کاپا = ۰٫۸۹۸ است. کمیته ماهوارههای رصد زمین (CEOS) فعالیتهای متعددی را در رابطه با کالیبراسیون و اعتبارسنجی دادههای ماهوارهای تأیید کرده و توصیههایی در مورد اعتبارسنجی نقشههای تغییر (یعنی جمعآوری دادههای مرجع جدید، با کیفیت بالا و چند وضوح) ارائه کرده است. برای ارائه اندازهگیریهای ماهوارهای نماینده فضایی برای اعتبارسنجی [ ۲۱]. با این حال، بسیاری از کاربران در درجه اول به الگوی فضایی پوشش زمین توجه دارند و کمتر به بعد زمانی اهمیت می دهند. بنابراین، نیاز فوری به گسترش تخمین دقت محصولات چندزمانی پوشش زمین با اعتبارسنجی سازگاری مکانی و زمانی وجود دارد.
محصولات پوشش زمین چندزمانی مکان مکانی یکسانی را پوشش میدهند و تغییرات ویژگی سری زمانی را نشان میدهند [ ۲۲ ]. برای ارزیابی دقت یک دوره، هزینه و زمان مصرف می تواند بسیار بالا باشد. ارزیابی دادههای تک دورهای تنها میتواند کیفیت دادههای هر دوره را منعکس کند، اما ارزیابی دادههای پوشش زمین چند زمانی نه تنها میتواند دقت یک دوره واحد را فراهم کند، بلکه تغییر را نیز استخراج میکند. با این حال، پیچیدگی تغییر با داده های بیشتر در حوزه زمانی به طور قابل توجهی افزایش می یابد. طراحی یک روش نمونه گیری طبقه ای منطقی با استفاده از تغییرات در تمامی دوره ها ضروری است.
در طول فرآیند نمونهبرداری، چندین نمونه نماینده در منطقه مورد نظر بر اساس تئوری نمونهگیری آماری احتمال انتخاب شدند که بر دقت تخمین محصولات سنجش از دور تأثیر مستقیم دارد. در بین تمامی طرحهای نمونهگیری، نمونهگیری تصادفی طبقهای کاربرد گستردهای دارد و به عنوان انتخاب یک نمونه تصادفی ساده از هر طبقه تعریف میشود. نمونهگیری طبقهای امکان وجود دقتهای متفاوت در لایههای مختلف را فراهم میکند. SSCE با توجه به تخمین دقت طبقهبندی، زمانی که تنها چند نقطه نمونه وجود دارد، دقت بالایی دارد. SSCE به نقاط نمونه برداری کمتری نسبت به SS تحت تحمل خطای یکسان نیاز دارد [ ۲۳ ].
با این حال، تخصیص نمونهها به هر لایه در چند دوره زمانی برای محصولات پوشش زمین چند زمانی یک کار چالش برانگیز است. برای محصولات چندمدت پوشش زمین با تنها دو دسته، مانند تغییر و بدون تغییر، شهری و غیر شهری، جنگلی و غیرجنگلی و غیره، مساحت بدون تغییر معمولاً بزرگتر است و مساحت تغییر عبارت است از کوچکتر. اگر حجم نمونه با توجه به مساحت پوشش زمین تخصیص داده شود، منجر به حجم نمونه کوچکتر برای نوع کمیاب خواهد شد. روشهای تخصیص منطقی حجم نمونه برای این نوع محصول داده نیاز به مطالعه دارد.
مطالعات مختلف اصول متفاوتی را برای تعیین اندازه نمونه اقشار مختلف با در نظر گرفتن اهداف مختلف و همچنین سهم انحراف استاندارد مشخص شده پیشنهاد میکنند [ ۲۴ ، ۲۵ ]. یک اصل برای تعیین تخصیص حجم نمونه بر اساس قوانین تجربی است. انحراف استاندارد دقت تغییر کاربر برآورد شده با تخصیص برابر کاهش می یابد. روش تخصیص متناسب به مساحت کلاس های مختلف نقشه بستگی دارد. نمونههای بیشتری در کلاس مشترک با مساحت بزرگ انتخاب میشوند، در حالی که نمونههای کمتری برای کلاسهای نادر انتخاب میشوند. این نوع تخصیص حجم نمونه به جای مدل ریاضی به قوانین تجربی وابسته است که تا حد زیادی به تجربه متخصص متکی است.
انواع پوشش زمین با نسبت کم، گاهی اوقات به نمونه های بیشتری نسبت به نمونه های با نسبت زیاد نیاز دارند که به نتایج ارزیابی قابل اعتمادتری دست می یابد [ ۴ ]. منطقه تغییر در پوشش زمین چند زمانی کوچک است، اما برای کاربران مهم است. تنها تعداد کمی از مطالعات تحقیقاتی طرحهای نمونهگیری طبقهبندیشده فضایی و تخصیص اندازه نمونه را برای اقشار نادر در نظر میگیرند. برای برخی از اقشار تغییر نادر مورد علاقه، تخصیص معقول اندازه نمونه با استفاده از مدل تجربی قابل دستیابی نیست.
اصل دیگر بر اساس واریانس برآوردگرهای مختلف است، به عنوان مثال، دقت کلی، دقت کاربر، و دقت تولید کننده. تخصیص نیمن شامل تخصیص اندازه های مختلف نمونه با به حداقل رساندن واریانس دقت کلی برآورد شده است [ ۲۴ ]. کوکران [ ۲۵ ] از یک برآوردگر حداقل واریانس برای به دست آوردن تخصیص اندازه نمونه با استفاده از طبقه بندی با در نظر گرفتن دقت هم ناحیه کلاس مرجع و هم دقت کلی استفاده کرد. Stehman [ ۲۴] تخصیص بهینه اندازه نمونه را با استفاده از یک تابع هدف ایجاد شده توسط مجموع سه واریانس (دقت تولید کننده، دقت کاربر و تخمین مساحت یک کلاس) بدست آورد و طرح های تخصیص نمونه مختلف را برای ماتریس خطا تجزیه و تحلیل کرد. از آنجایی که این سه نوع واریانس مکمل یکدیگر هستند، نتیجه به حداقل رساندن تابع هدف با استفاده از یک شاخص واحد، بایاس است [ ۲۶ ]. بنابراین، طرح نمونهبرداری ایدهآل باید از معیار تخمین با دقت بالا پیروی کند تا در صورت عدم ارائه نشانگر خاصی، همه برآوردگرها دارای یک انحراف معیار کوچک باشند.
در این مطالعه، ما یک نمونهبرداری طبقهبندیشده مکانی-زمانی برای تخمین دقت مکانی محصولات جهانی پوشش زمین با در نظر گرفتن ویژگی مکانی-زمانی و بهینهسازی تخصیص نمونه برای هر لایه ایجاد کردیم. در کاربردهای عملی، ویژگیهای زمانی و مکانی، یعنی نوعی تغییر پوشش زمین و عدم تغییر در دورههای تملک، به عنوان مبنای نمونهگیری طبقهای مورد استفاده قرار میگیرد. واحدهای نمونه از نظر فضایی بر اساس پیکسلهای وضوح ۳۰ متری تعریف میشوند و بهطور موقت با تاریخهای اکتساب تصاویر چندزمانی پوشش زمین تعریف میشوند. از آنجا که هیچ اطلاعات کیفیت محصول قبل از اعتبارسنجی نتایج در دسترس نیست، ماتریس خطای اولیه با تفسیر کسری از نمونه به دست می آید. و تابع هدف برای تعیین اندازه نمونه طبقه بندی شده بر اساس به حداقل رساندن مجموع واریانس دقت کاربر، واریانس دقت تولید کننده، و واریانس نسبت مساحت تخمین زده شده برای همه لایه ها ساخته شده است. متفاوت از مطالعات قبلی [۲۴ ] برای تخصیص اندازه نمونه، الگوریتم پیشنهادی هیچ لایه خاصی یا یک کلاس مورد علاقه اولیه را انتخاب نمیکند، و نشان میدهد که تخمینگرهای دقت همه لایههای مکانی-زمانی به یک اندازه مهم در نظر گرفته میشوند. ما روش پیشنهادی را با مجموعه داده شانگهای (SH) آزمایش کردیم [ ۲۷ ]. علاوه بر این، روشهای نمونهگیری طبقهبندیشده مکانی-زمانی و تخصیص نمونه بهینه برای یک محصول پوشش زمین شهری جهانی چندزمانی [ ۲۸ ] اعمال شد. با توجه به ویژگی خوشهبندی فضایی مناطق شهری، ما روش محوری محلی (LPM) را برای انتخاب نمونههای پراکنده و برای بهبود کارایی تخمینهای دقت اتخاذ کردیم.
آثار اصلی این مقاله به شرح زیر است:
- (۱)
-
ما یک طبقه بندی زمانی را با ترکیبی از انواع پوشش زمین در سه تاریخ مختلف به منظور دستیابی به نمونه های طبقه بندی شده معقول پیشنهاد می کنیم.
- (۲)
-
یک تخصیص نمونه بهینه با توجه به بهینه سازی سه نوع واریانس از همه اقشار پیشنهاد شده است.
- (۳)
-
نمونهگیری طبقهبندیشده مکانی-زمانی پیشنهادی برای مجموعه دادههای پوشش زمین شهری جهانی چند زمانی اعمال میشود.
۲٫ منابع داده ها و روش ها
نمونهگیری طبقهای معمولاً در ارزیابی دقت مورد استفاده قرار میگیرد، با اقشار مربوط به انواع پوشش زمین یا مناطق جغرافیایی [ ۲۹ ، ۳۰ ]. اگر جامعه به طور قابل توجهی ناهمگن باشد، نمونه گیری طبقه ای می تواند دقت را با بهینه سازی طبقه بندی بهبود بخشد، که در آن نمونه ها در هر طبقه باید تا حد امکان همگن باشند [ ۳ ]. بنابراین، طبقه بندی معقول و تخصیص اندازه نمونه بهینه چالش های اصلی در طول نمونه گیری طبقه بندی شده است [ ۳۱ ]]. برای مثال، نمونهبرداری طبقهای با یک طبقه از پوشش زمین میتواند با استفاده از طبقه پوشش زمین یا طبقهبندی جغرافیایی بر اساس قارهها انجام شود. نقشه های پوشش زمین چند زمانی شامل انواع مختلف تغییر پوشش زمین و بدون تغییر است. بنابراین، برخی از انواع پوشش زمین را می توان به عنوان اقشار برای نمونه گیری طبقه ای در نظر گرفت.
۲٫۱٫ داده ها
۲٫۱٫۱٫ ماهواره چینی GaoFen-2 بر فراز شانگهای
مجموعه داده اعتبارسنجی از یک جفت تصویر چند طیفی (MS) و پانکروماتیک (PAN) تشکیل شده است که توسط ماهواره چینی GaoFen-2 بر فراز شانگهای، چین، در ۲ ژانویه ۲۰۱۵ [ ۲۷ ] به دست آمده است. وضوح فضایی MS (با نوارهای آبی، سبز، قرمز و نزدیک به مادون قرمز) و تصاویر PAN به ترتیب ۴ متر و ۱ متر است. اندازه تصویر مربوطه ۱۲۰۰ × ۱۲۲۰ پیکسل است. در این صحنه تصویر پنج کلاس وجود دارد، یعنی ساختمان، جاده ها، آب، درختان و علف ها، که در شکل با اعداد ۱ تا ۵ نشان داده شده اند. شکل ۱ نتایج طبقه بندی تصاویر MS و PAN و نقشه مرجع حقیقت زمینی مربوطه را نشان می دهد. این مجموعه داده برای تأیید استحکام تخصیص بهینه نمونه های طبقه بندی شده استفاده شد.
آزمایش تخصیص نمونه بهینه با منطقه کوچکی از دادهها به عنوان مرجعی برای تخصیص منطقی نمونهها پس از طبقهبندی محصول پوشش زمین جهانی چند زمانی بعدی استفاده شد. اولاً، ماتریس خطای پیش داوری اولیه باید تولید می شد. نقشه طبقه بندی در مجموع دارای پنج دسته بود که بر اساس طبقه بندی پوشش زمین طبقه بندی شدند.
تخصیص بهینه توان (OPA) حجم نمونه برای هر لایه از مجموعه داده SH از رابطه (۲) به دست آمد. با مقایسه OPA با تخصیص مساوی و تخصیص متناسب، برتری این روش توزیع بهینه آشکار است. تخصیص برابر (EA) شامل تخصیص مساوی بین هر قشر است. تخصیص متناسب (PA) شامل تخصیص متناسب نسبت به تعداد کل پیکسل ها در هر لایه است. حجم کل نمونه ۵۰۰۰ نفر بود.
۲٫۱٫۲٫ پوشش زمین شهری جهانی چند زمانی
این مطالعه تحقیقاتی بر روی یک محصول چندزمانی جهانی پوشش زمین شهری جدید از سال ۲۰۰۰ تا ۲۰۱۰ با فاصله زمانی پنج ساله، بر اساس تصاویر Landsat [ ۲۸ ] متمرکز شد. دادههای چندزمانی پوشش زمین شهری جهانی از ۸۰ درجه شمالی تا ۶۰ درجه جنوبی متغیر است و با روش شاخص مرکب منطقه شهری نرمال شده (NUACI) ارائه شده توسط لیو و همکاران تولید شد. [ ۲۸]، بر اساس پلت فرم Google Earth Engine. نتایج نگاشت ارائه شده نیز دارای دو محدودیت است. اولاً، زیرساختهای مصنوعی مانند بزرگراههای بین ایالتی و سکونتگاههای آسفالتشده در شناسایی با استفاده از دادههای نور شبانه مشکل دارند، که ممکن است دقت پوشش زمین شهری را کاهش دهد. ثانیاً، طبقهبندی باینری مشکل پیکسلهای مختلط تصاویر Landsat را ساده میکند و بنابراین، دقت ضعیفی در مناطق گرمسیری و مناطق خشک دارد. مجموعه داده جهانی پوشش زمین شهری برای هر دوره شامل ۲۲۴ برگه نقشه است. این ۲۲۴ برگه نقشه دارای تفکیک مکانی ۳۰ متری هستند و یک منطقه ۱۰ × ۱۰ درجه را پوشش می دهند ( شکل ۲ ). دو دسته طبقه بندی در این مجموعه داده، یعنی شهری و غیر شهری در جدول ۱٫ تفسیر دقیق دادههای پوشش زمین شهری میتواند به ما در درک دگرگونی طبیعت توسط انسان کمک کند و پشتیبانی دادهها را برای نظارت بر تغییرات محیطی اکولوژیکی فراهم میکند. این مجموعه داده برای تأیید کاربرد نمونهگیری طبقهبندیشده مکانی-زمانی استفاده شد. هدف از این مطالعه تحقیقاتی ارزیابی دقت محصول جهانی پوشش زمین شهری و عدم قطعیت متناظر آن در فاصله اطمینان ۹۵ درصد، بر اساس طرح نمونهگیری طبقهای [ ۷ ] بود.
در سطح جهانی، پوشش زمین شهری معمولاً از نظر مکانی متمرکز است. سه ویژگی محصول پوشش زمین شهری جهانی چند زمانی به شرح زیر است. (۱) منطقه بزرگی را شامل می شود که شامل بازه های زمانی متعدد و مقدار زیادی داده می شود. این محصول سال های ۱۹۹۰ تا ۲۰۱۰ را با فاصله زمانی ۵ ساله پوشش می دهد. (۲) تنها دو طبقه بندی وجود دارد، یعنی شهری و دیگر (یعنی غیر شهری). (۳) لایه غیر شهری منطقه وسیعی را اشغال می کند و لایه شهری منطقه کوچکی را اشغال می کند. داده های پوشش زمین شهری یک توزیع فضایی انباشته شده را ارائه می دهند. اگر ویژگیهای چند زمانی دادههای پوشش زمین شهری جهانی به درستی در نظر گرفته نشوند، یک طرح نمونهگیری تصادفی میتواند منجر به سوگیری در دقت تخمین زده شود.
۲٫۲٫ طبقه بندی با ترکیب انواع پوشش زمین در سه تاریخ مختلف
مهمترین معیار برای یک طرح نمونه گیری دقیق آماری این است که باید طرح نمونه گیری احتمالی را برآورده کند به طوری که برآوردگرهای استنباط شده برای پارامترهای مورد نظر سازگار باشند [ ۱۱ ]. احتمال شمول باید شناخته شود و باید بزرگتر از صفر باشد [ ۱۴ ]. برای برآورد دقیق دستههای نادر، نمونهگیری طبقهای انتخاب خوبی است. برای ارزیابی دقیق دقت سه دوره داده های پوشش زمین شهری در مقیاس جهانی، نمونه گیری طبقه ای برای به دست آوردن نمونه های مرجع اتخاذ شد. نقشه های زمین شهری جهانی چند زمانی مورد استفاده در این تحقیق دارای دو کلاس شهری و غیر شهری می باشد [ ۲۸ ].]. ارزیابی دقت انجام شده در هر دوره به حجم کاری و هزینه زمانی قابل توجهی نیاز دارد و ارزیابی تک دوره ای فقط کیفیت داده های یک دوره را منعکس می کند. در مقابل، ارزیابی دادههای چندزمانی نه تنها شامل تخمین دقت دادهها در یک دوره واحد میشود، بلکه شامل تعیین انواع ترکیبهای تغییرات زمانی و بدون تغییر نیز میشود. بنابراین، دقت باید با استفاده از مجموعه ای گسترده از نمونه های مکانی و زمانی ارزیابی شود. اقشار همه موقعیت های ممکن موجود در محصول را نشان می دهند [ ۳۲ ]. واحدهای نمونه برداری به صورت مکانی بر اساس پیکسل های با وضوح ۳۰ متر و به طور موقت با تاریخ های اکتساب تصاویر پوشش زمین چند زمانی تعریف شدند.
متفاوت از مطالعه قبلی با استفاده از نمونهگیری تصادفی طبقهبندی شده با برچسبهای طبقهبندی به عنوان طبقات [ ۳۰ ]، طبقهبندی زمانی انجامشده در این مطالعه بر اساس ترکیب انواع پوشش زمین در سه تاریخ مختلف بود. با در نظر گرفتن تغییرات و بدون تغییر در سه دوره، ۸ نوع تغییر زمانی وجود دارد. نمونه ای از پس طبقه بندی زمانی در شکل ۳ نشان داده شده است . در اینجا، شهری را با «۱» و غیر شهری را با «۰» نشان میدهیم.
بنابراین طبقه بندی مکانی-زمانی شامل دو مرحله است. ابتدا، یک نقشه جهانی زمین شهری برای تعریف یک طبقه بندی فضایی بر اساس مناطق بوم شهری پیشنهاد شده توسط اشنایدر و همکاران استفاده شد. [ ۳۳ ]. این طبقه بندی فضایی تضمین کرد که بوم مناطق به اندازه کافی در نمونه داده های مرجع نشان داده شده اند [ ۳۲ ]. بر اساس طبقه بندی فضایی، طبقه بندی زمانی انجام می شود، سپس. طبقه بندی مکانی-زمانی پیشنهادی برای اطمینان از اندازه نمونه کافی در همان مکان مکانی با تغییرات ویژگی سری زمانی بود.
۲٫۳٫ تخصیص نمونه به طبقات
جدول ۲ نمونه ای از یک ماتریس خطای جمعیت با نسبت M × M را نشان می دهد. با مقایسه نقشه طبقه بندی با برچسب های مرجع مربوطه توسط تفسیر بصری ایجاد می شود. عناصر ماتریس نسبت های نمونه ناحیه مرجع برای هر لایه هستند. ردیف نشان دهنده کلاس نقشه است در حالی که ستون نشان دهنده کلاس مرجع است. p ij نسبت جمعیت منطقه را با کلاس نقشه i و کلاس مرجع j نشان می دهد. p i+ و p +j به ترتیب مجموع p ij را در هر سطر و ستون نشان می دهند.
با توجه به سیستم های طبقه بندی مختلف، مساحت زمین شهری جهانی به عنوان نسبتی بین ۱٪ و ۳٪ گزارش شده است [ ۳۴ ، ۳۵ ، ۳۶ ]]. بنابراین می توان مشاهده کرد که مساحت پوشش اراضی غیر شهری بیشترین سهم را به خود اختصاص می دهد. اگر حجم نمونه متناسب با نواحی طبقات تخصیص داده شود، اغلب نمونه ها در اصل غیرشهری هستند که می تواند منجر به مشکل حجم نمونه بسیار کوچک برای زمین های شهری در طول روش نمونه برداری شود. اندازه نمونه کوچک اغلب منجر به انحراف استاندارد نسبتاً بزرگ برای زمین شهری و انواع تغییرات نادر می شود. به منظور تولید تخصیص نمونه معقول تر، به اقشار با واریانس زیاد نمونه های بیشتری اختصاص داده می شود به طوری که اعتبار نمونه منطقی تر است [ ۳۷ ]]. از آنجایی که اقشار تغییر در مقیاس جهانی احتمالاً دقت طبقهبندی پایینتری دارند، روشهای تخصیص نمونهها به لایهها بر اساس استراتژی بهینهسازی برای لایههای تغییر نادر مسائل کلیدی هستند. برای محصول چند زمانی پوشش زمین شهری، از روش تخصیص بهینه برای تخصیص نمونهها برای نمونهبرداری طبقهای استفاده کردیم. نتایج نمونه گیری طبقه ای نسبت به تخصیص حجم نمونه تحت اطلاعات قبلی متفاوت حساس است. تابع هدف برای تعیین اندازه نمونه طبقه بندی شده بر اساس مجموع واریانس دقت کاربر، واریانس دقت تولید کننده و واریانس نسبت مساحت تخمین زده شده برای همه لایه ها ساخته شده است. با این حال، به دست آوردن واریانس آنها در مرحله طراحی نمونه دشوار است، زیرا داده های مرجع جمع آوری نشده اند. برای حل این مشکل، ما تعداد معینی از نمونه ها را از لایه طبقه بندی شده انتخاب می کنیم و به صورت بصری آنها را تفسیر می کنیم تا برچسب داده های مرجع را بدست آوریم. سپس ماتریس خطا را بدست می آوریم که آن را ماتریس پیش داوری می نامیم. روش تخصیص بهینه مورد استفاده در این مطالعه نیاز به یک ماتریس پیش داوری برای به دست آوردن درک اساسی از ویژگی های داده ها پس از طبقه بندی دقت دارد. نمونه ها به طور تصادفی در سطح جهانی برای به دست آوردن یک ماتریس پیش داوری برای تعیین حجم نمونه برای نمونه گیری طبقه ای از ۱۵ منطقه زیست محیطی انتخاب شدند. روش تخصیص بهینه مورد استفاده در این مطالعه نیاز به یک ماتریس پیش داوری برای به دست آوردن درک اساسی از ویژگی های داده ها پس از طبقه بندی دقت دارد. نمونه ها به طور تصادفی در سطح جهانی برای به دست آوردن یک ماتریس پیش داوری برای تعیین حجم نمونه برای نمونه گیری طبقه ای از ۱۵ منطقه زیست محیطی انتخاب شدند. روش تخصیص بهینه مورد استفاده در این مطالعه نیاز به یک ماتریس پیش داوری برای به دست آوردن درک اساسی از ویژگی های داده ها پس از طبقه بندی دقت دارد. نمونه ها به طور تصادفی در سطح جهانی برای به دست آوردن یک ماتریس پیش داوری برای تعیین حجم نمونه برای نمونه گیری طبقه ای از ۱۵ منطقه زیست محیطی انتخاب شدند.
واریانس دقت کاربر، دقت تولیدکننده، و نسبت تخمینی مساحت برای هر دسته را می توان از ماتریس خطای پیش داوری تخمین زد. تابع تخصیص بهینه با مجموع واریانس های تمام لایه ها برای دقت کاربر، دقت تولید کننده و نسبت تخمینی مساحت ارائه می شود. تابع هدف مسئله بهینه سازی را می توان به صورت زیر تعریف کرد:
که در آن p ij نسبت جمعیت منطقه را با کلاس نقشه i و کلاس مرجع j نشان می دهد. p i+ و p +j به ترتیب مجموع p ij را در هر سطر و ستون نشان می دهند. توجه داشته باشید که احتمال درج نمونه در مرحله پیش نمونه گیری در نظر گرفته نمی شود.
برای به حداقل رساندن مجموع انحراف معیار واریانس ها، حجم نمونه بهینه تخصیص یافته به لایه h به شرح زیر است:
جایی که
که در آن n حجم کل نمونه و n h حجم نمونه در لایه h است.
۲٫۴٫ انتخاب نمونه بر اساس LPM
دادههای پوشش زمین شهری دارای ویژگیهای خوشهبندی هستند و پیکسلهای همسایه را میتوان با احتمال زیاد در یک کلاس انتخاب کرد. با توجه به همبستگی زیاد بین پیکسل های مجاور در حوزه فضایی، انتخاب یک پیکسل می تواند اطلاعات کافی برای ارزیابی دقت ارائه دهد و گنجاندن محیط اطراف آن اتلاف وقت است. بنابراین، همبستگی فضایی بین واحدهای نمونه را با استفاده از طرح نمونهگیری مکانی حذف میکنیم تا نمونههای معرف بیشتری به دست آوریم. پس از تعیین حجم نمونه مربوط به هر قشر از منطقه اکولوژیکی، از LPM برای انتخاب پیکسل های نمونه استفاده می شود. گرافستروم و همکاران [ ۳۸ ، ۳۹] LPM را برای نمونه برداری متعادل فضایی پیشنهاد کرد. در طول عملیات آزمایشی، موقعیت مکانی پیکسل به عنوان اطلاعات کمکی برای دستیابی به نمونه برداری متعادل فضایی استفاده می شود. شکل ۴ مقایسه ای بین نمونه گیری تصادفی ساده (SRS) و LPM را نشان می دهد. در شکل ۴ الف، پیکسل های مجاور همان احتمال انتخاب شدن را دارند که منجر به توزیع ضعیف نمونه ها می شود، همانطور که در سمت راست نشان داده شده است. در مقابل، LPM فرض می کند که احتمال انتخاب دو پیکسل مجاور به عنوان نمونه در یک زمان بسیار کم است. به عنوان مثال، هنگامی که یک پیکسل را به عنوان نمونه انتخاب می کنیم، احتمال نمونه برداری از پیکسل های مجاور آن با استفاده از معیار به روز رسانی به روز می شود. همانطور که در شکل ۱ نشان داده شده استb، دو پیکسل درجه بالایی از همبستگی منفی با احتمال گنجاندن نشان دادند. اگر دو یا چند واحد با فاصله نزدیک یکسان وجود داشته باشد، نمونه به طور تصادفی از نزدیکترین واحدها با احتمال مساوی انتخاب می شود. این یک توزیع بهبود یافته را برای نمونه های انتخاب شده، همانطور که در شکل ۴ ب نشان داده شده است، به همراه دارد. با توجه به معیار به روز رسانی، نمونه با احتمال درج به روز می شود تا زمانی که همه واحدها در منطقه هدف یک بار طی شوند. LPM برای به روز رسانی احتمال گنجاندن استفاده می شود و معادله (۴) یا (۵) به عنوان معیار به روز رسانی استفاده می شود تا زمانی که همه واحدها یک بار پیمایش شوند [ ۴۰ ].
معیارهای به روز رسانی احتمال درج به شرح زیر است.
ما آزمایشی را برای ارزیابی دقت دادههای چند زمانی پوشش زمین شهری در مقیاس جهانی انجام دادیم. فرآیند پیاده سازی خاص شامل سه جزء اصلی بود: طراحی نمونه گیری، طراحی پاسخ، و تجزیه و تحلیل و برآورد [ ۶ ]. از طرح نمونه برای تعیین واحد نمونه، حجم نمونه و انتخاب نمونه استفاده شد [ ۲۳ ]. ویژگیهای کلیدی طراحی پاسخ شامل دادههای مرجع، تفسیر کور بصری، معیارهای قضاوت و رتبهبندی قابلیت اطمینان قضاوت نمونه بود. تجزیه و تحلیل و تخمین به عنوان یک پروتکل استنتاج آماری برای تخمین دقت از داده های نمونه مرجع استفاده می شود [ ۱۴ ]] شامل دقت کلی، دقت تولیدکننده و دقت کاربر، با فاصله اطمینان ۹۵ درصد بود. ارزیابی دقت پوشش زمین شهری عمدتاً با سه نتیجه تخمین مربوط می شود، یعنی دقت نقشه های تک تاریخی (۲۰۰۰، ۲۰۰۵، و ۲۰۱۰)، تغییرات داده ها در فاز دوم (۲۰۰۰-۲۰۰۵، ۲۰۰۵-۲۰۱۰، و ۲۰۰۰-۲۰۱۰)، و داده ها در فاز III (2000-2005-2010) تغییر می کند.
۲٫۵٫ مقایسه داده های مرجع و داده های نقشه
طراحی پاسخ مجموعه ای از پروتکل ها برای تعیین سازگاری بین داده های نقشه و مجموعه داده مرجع [ ۶ ] است. ارزیابی دقت نقشه مستلزم آن است که داده های مرجع کیفیت بالاتری نسبت به نقشه در حال ارزیابی داشته باشند [ ۴۱ ]. مجموعه داده های اعتبارسنجی اغلب از تصاویر با وضوح بالا یا داده های اندازه گیری میدانی به دست می آیند. در این مطالعه، از تصاویر Google Earth TM به عنوان داده های مرجع اصلی استفاده کردیم [ ۴۲ ]. در مجموع هشت متخصص تصویر سنجش از دور برچسب های نمونه مرجع را به صورت بصری تفسیر کردند. داده های مرجع عمدتاً در طول سه دوره اعتبار سنجی جمع آوری شد.
۲٫۶٫ تخمین و تحلیل دقت
با توجه به مقایسه سازگاری بین دادههای جهانی پوشش زمین شهری و دادههای مرجع، میتوان یک ماتریس خطا جمعآوری کرد. هر پیکسل نمونه بر اساس نمونه گیری احتمالی به دست می آید. بنابراین، تئوری تحلیل آماری را می توان برای تجزیه و تحلیل نتایج تفسیر استفاده کرد [ ۶ ]. در آزمایش انجام شده در این مطالعه، احتمال ورود اولیه [ ۲۹ ] هر طبقه از نمونه هر منطقه اکولوژیکی به صورت زیر تعریف شد:
که در آن π uh احتمال گنجاندن پیکسل در طبقات h منطقه اکولوژیکی u است. ماتریس خطا و شاخص تخمین زده شده از ماتریس خطا مستلزم احتمال درج هر پیکسل نمونه است. هنگام ترکیب دادههای نمونه چند لایه و در نظر گرفتن احتمالهای گنجاندن مختلف در لایهها، یک تخمین وزنی از ماتریس خطا مورد نیاز است. وزن تخمین زده شده با احتمال درج هر پیکسل نمونه نسبت معکوس دارد و نسبت مساحت هر سلول در ماتریس خطا تخمین زده می شود. عنصر ماتریس خطا را می توان به صورت زیر تعریف کرد:
جایی که
که در آن N تعداد پیکسل های جمعیت است و y u مشاهده پیکسل u است. معیارهای دقت زیر را می توان با استفاده از ماتریس خطا بدست آورد. دقت کلی برای محصولات پوشش زمین شهری جهانی تک تاریخ (۲۰۰۰، ۲۰۰۵، ۲۰۱۰) و تغییر بین آنها برای سه بازه زمانی (۲۰۰۰-۲۰۰۵، ۲۰۰۵-۲۰۱۰، ۲۰۰۰-۲۰۱۰) برآورد شد. دقت کلی به صورت زیر برآورد شد [ ۴۳ ]:
که در آن P h نسبت پیکسل های نمونه به درستی طبقه بندی شده در لایه h است، N h تعداد کل پیکسل ها در لایه h ، N کل ناحیه تأیید، و H ناحیه تأیید با مجموع لایه های H است. . دقت کاربر و سازنده با استفاده از نسبت اطلاع رسانی [ ۲۵ ] برآورد شد:
که در آن Y مجموع جمعیت y i است که به صورت زیر تعریف می شود.
X مجموع جمعیت x i است که به صورت زیر تعریف می شود.
به عنوان مثال، برای تخمین دقت کاربر از زمین شهری، A داده های شهری، برچسب داده های مرجع “شهری” و B داده های شهری است. اگر دقت تولیدکننده زمین شهری برآورد شود، A داده های شهری، برچسب داده های مرجع “شهری” و B برچسب داده های مرجع است. سپس این نسبت می تواند به موارد زیر تبدیل شود:
جایی که ایکس¯ساعتمیانگین x i در طبقه h است و y¯ساعتمیانگین y i در طبقه h است. واریانس نسبت به صورت زیر برآورد می شود:
که در آن n h اندازه نمونه لایه h است، سایکسساعت۲واریانس نمونه x i لایه h است، سyساعت۲واریانس نمونه y i لایه h است و سایکسyساعتکوواریانس نمونه x i و y i لایه h است.
خطای کمیسیون (Ce) و خطای حذف (Oe) به ترتیب مکمل دقت کاربر و دقت تولیدکننده هستند. نسبت خطای کمیسیون [ ۳۱ ، ۳۲ ، ۴۴ ] به صورت زیر تعریف می شود.
نسبت خطای حذف به صورت زیر تعریف می شود.
ضریب تشابه تاس ( DC ) [ ۴۵ ] اطلاعات مربوط به کمیسیون و حذف یک کلاس واحد را ترکیب می کند و به صورت زیر تعریف می شود.
relB تعصب نسبت به طبقه شهری مرجع است. مقدار relB نشان می دهد که آیا یک محصول وسعت طبقه شهری را بیش از حد تخمین می زند یا دست کم می گیرد که به شرح زیر تعریف می شود.
چهار شاخص و همچنین واریانس آنها را می توان با استفاده از معادلات (۱۳) – (۱۵) تخمین زد.
۳٫ نتایج
این برنامه با MATLAB R2021b کامپایل شده و کار تفسیر نمونه با کمک پلتفرم Google Earth™ تکمیل شده است.
۳٫۱٫ اعتبارسنجی تخصیص نمونه بهینه
در مجموع، ۱۰۰ نمونه به طور تصادفی از هر دسته برای تفسیر و قضاوت انتخاب شدند و یک ماتریس خطای پیش داوری اولیه ایجاد شد، همانطور که در جدول ۳ نشان داده شده است. نمونه های تخصیص یافته به هر نوع پوشش زمین بر اساس EA، PA و OPA در شکل ۵ نشان داده شده است ، که در آن EA نمونه ها را به طور مساوی بین هر نوع تقسیم می کند. روش OPA اندازه های نمونه را برای ساختمان ها، جاده ها، آب، درختان و چمن به ترتیب ۱۵۱۶، ۱۳۱۰، ۵۸۶، ۱۱۸۴ و ۴۰۴ اختصاص می دهد. تخصیص PA منجر به انواع پوشش زمین با نسبت های بزرگ با نمونه های اختصاص داده شده بیشتر می شود.
بایاس محاسبه شده بین مقادیر واقعی و سه روش تخصیص مختلف در شکل ۶ نشان داده شده است . بایاس به دست آمده با تخصیص بهینه (نوارهای زرد) همیشه کوچکتر از بقیه است، که نشان می دهد نمونه های انتخاب شده از تخصیص بهینه به مقادیر واقعی نزدیکتر هستند. نتایج تجربی نشان داد که تخصیص حجم نمونه با روش پیشنهادی در مقایسه با تخصیص مساوی و تخصیص متناسب، کمترین سوگیری را به همراه دارد. مقایسه اطلاعات کمی در مورد نحوه تخصیص منطقی نمونه ها به این اقشار ارائه می دهد [ ۳۱ ].
۳٫۲٫ اجرای طبقه بندی مکانی- زمانی
بوم مناطق شهری پیشنهاد شده توسط اشنایدر و همکاران. [ ۳۳] برای تشکیل اقشار فضایی استفاده شد و آنها به طور مستقل نمونه برداری شدند. این طبقه بندی اکولوژیکی شهری به این دلیل استفاده شد که تولید مجموعه داده پوشش زمین شهری جهانی چند زمانی مبتنی بر NUACI بر اساس این طبقه بندی بود. پهنهبندی اکولوژیکی شهری شباهتهای عوامل اکولوژیکی، فرهنگی و اجتماعی کاربری زمین شهری را در مقیاس جهانی در نظر میگیرد و مساحت زمین جهانی به ۱۶ بیوم اکولوژیکی تقسیم میشود. این روش طبقه بندی توزیع فضایی خوبی از نمونه ها را در سراسر جهان تضمین می کند. از آنجایی که منطقه ۱۶ اکولوژیکی، پوشش چند ساله یخی و برفی است که برای آن طبقه بندی اراضی شهری وجود ندارد، این منطقه اکولوژیکی در این مطالعه لحاظ نشده است. مطالعه ما از شیوه های خوب توصیه شده توسط اولوفسون و همکاران پیروی کرد. [ ۱۴ ].
در این مطالعه، بوم مناطق شهری به عنوان لایههای نمونهگیری مرحله اول برای افزایش گستردگی جغرافیایی نمونهها و تولید تخمینهای دقیق از دقت کاربر برای طبقات نادر استفاده شد [ ۴۶ ]. به منظور توزیع یکنواختتر نقشههای نمونه در فضا، هر نقشه اصلی (۱۰ × ۱۰ درجه) به برگههای نقشه (۱ × ۱ درجه) تقسیم شد، همانطور که در شکل ۷ نشان داده شده است.. سپس ۲۲۴۰۰ برگه نقشه (۱ درجه × ۱ درجه) به دست آوردیم که کل جهان را پوشش می دهد. تفاوت اصلی بین برگه های نقشه ۱۰ × ۱۰ درجه و برگه های نقشه ۱ × ۱ درجه به عنوان واحد نمونه برداری این است که نمونه ها در فضای جهانی برای برگه های نقشه ۱ × ۱ درجه پراکنده تر و یکنواخت تر هستند و بیشتر هستند. نماینده. این برگههای نقشه ۱ درجه × ۱ درجه واحد نمونهگیری اولیه (PSU) را تشکیل میدادند و بهطور تصادفی در هر بوم منطقه شهری انتخاب شدند، که هدف آن این بود که برگههای نقشه نمونه از نظر فضایی معرفتر شوند. با در نظر گرفتن برگه نقشه نمونه به عنوان واحد نمونه برداری مرحله اول، لازم بود اندازه نمونه برای برگه های نقشه در مقیاس جهانی تعیین شود. به طور کلی، با افزایش حجم نمونه، انحراف معیار و عرض فاصله اطمینان صحت و تخمین مساحت کوچکتر می شود. اما افزایش حجم نمونه، هزینه به دست آوردن نمونه و تفسیر بصری را نیز افزایش می دهد. در این مرحله، اندازه نمونه باید به تعادل موثری بین دقت و هزینه برسد.
با توجه به اصل آمار احتمال، یک مدل تخمین حجم نمونه با محدود کردن خطای نسبی بین دقت خطای طبقهبندی واقعی و خطای صحت طبقهبندی مورد انتظار ایجاد شد. ما حجم نمونه را برای برگه های نقشه بر اساس فرمول مدل آماری نمونه گیری احتمالی محاسبه کردیم [ ۴۷ ]. با ۲۲۴۰۰ برگ نقشه به عنوان جامعه نمونه، میزان خطای طبقه بندی تخمین زده شده ۲۰٪ بود. نتیجه اندازه نمونه برگه نقشه برای داده های پوشش زمین غیرقابل نفوذ جهانی چند دوره ای ۳۷۸ بود.
برگه های نقشه نمونه بر اساس نسبت مساحت شهری در هر منطقه اکولوژیکی تخصیص داده شد. تعداد برگه های نمونه نقشه در هر منطقه زیست محیطی در جدول ۴ آمده است. منطقه اکولوژیکی شماره ۱۶ پوشیده از یخ و برف چند ساله در این مطالعه به دلیل عدم وجود منطقه شهری در نظر گرفته نشد. از آنجایی که جنگلهای پهن برگ استوایی در آفریقا، جنگلهای شمالی و مناطق توندرا سطح زمین کوچکی را پوشش میدهند، تعداد برگههای نقشه نمونه اختصاص داده شده به آنها کم است. مساحت جنگلهای معتدل در آمریکای شمالی و جنگلهای معتدل در اروپا ۱۹ درصد و ۱۵٫۴ درصد از کل مساحت جهان را تشکیل میدهند. بر اساس اصل تخصیص با توجه به نسبت مساحت شهری، حجم نمونه متناظر برای این برگه های نقشه به ترتیب ۷۲ و ۵۸ است.
از آنجایی که تعداد نمونهها برای برگههای نقشه در هر بوم منطقه با توجه به درصد مساحت تعیین شد، احتمال گنجاندن نمونههای برگه نقشه در هر بوم منطقه مشابه است. در هر لایه جغرافیایی، PSU ها با در نظر گرفتن معیار طرح نمونه گیری تصادفی طبقه ای به طور تصادفی انتخاب شدند. شکل ۸ نتیجه توزیع برگههای نقشه نمونه را برای دادههای چندزمانی پوشش زمین شهری در مقیاس جهانی نشان میدهد.
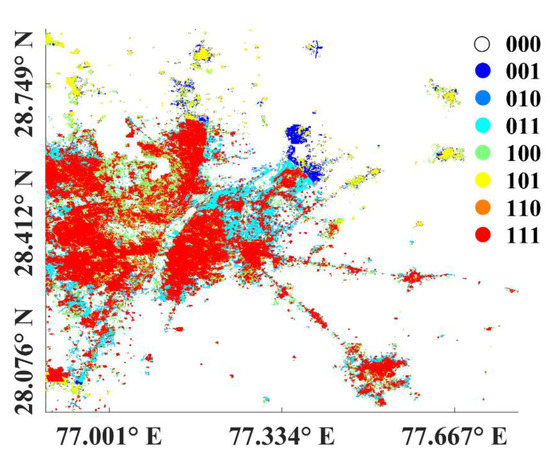
ما سه دوره داده های جهانی پوشش زمین شهری را به عنوان مثال در نظر می گیریم. انواع ترکیبات تغییرات زمانی و بدون تغییر محصول پوشش زمین شهری برای به دست آوردن هشت لایه استفاده شد ( جدول ۵ ). در حوزه زمانی، واحدهای نمونه مشابه در هر پیکسل در سه دوره مشاهده شد. در حوزه فضایی، طرح نمونهگیری، نمونهگیری خوشهای دو مرحلهای است. این هدف با افزایش نسبت نمونه برای نوع تغییر نادر محقق می شود. دو نوع پوشش زمین شهری جهانی وجود دارد. برای سهولت ارائه، از ۰ برای نشان دادن غیر شهری و ۱ برای نشان دادن شهری در جدول ۳ استفاده می کنیم.. مزایای چنین طبقه بندی به شرح زیر است: (۱) طبقه بندی بر اساس سری زمانی مبنایی برای ارزیابی دقت دسته بندی تغییر و عدم تغییر بین سال های مختلف است. (۲) از نمونه برداری مکرر در همان نقطه اجتناب می کند. تیپهای ۰۰۰ و ۱۱۱ انواعی هستند که تغییری نکردهاند و این نشان میدهد که پوشش زمین یا غیرشهری یا شهری و به ترتیب بین سالهای ۲۰۰۰ تا ۲۰۱۰ بوده است. تیپ های ۰۰۱ و ۰۱۱ نماینده گسترش شهری هستند و با روند گسترش شهری جهانی مطابقت دارند. تیپ ۱۱۰ و ۱۰۰ نشان می دهد که برچسب طبقه بندی زمین شهری بر اساس سیاست شهرسازی تغییر کرده است. این تغییرات در مقایسه با گسترش شهری نسبتاً کوچک هستند، بنابراین ممکن است حاوی اطلاعات غلط طبقه بندی شده بیشتری باشند. نوع ۱۰۱ نشان می دهد که این زمین شهری در سال ۲۰۰۰ بوده است. اما در سال ۲۰۰۵ به زمین غیر شهری تبدیل شد و سپس در سال ۲۰۱۰ دوباره به زمین شهری تبدیل شد. این ممکن است نمایانگر روند تخریب ساختمان های قدیمی و بازسازی ساختمان های جدید باشد. نوع ۰۱۰ نشان می دهد که محل در ابتدا زمینی غیر شهری بوده که تبدیل به زمین ساختمانی شده و در نهایت به زمین غیر شهری تبدیل شده است. این تغییر دلایل مختلفی می تواند داشته باشد که تخریب ساختمان های غیرمجاز یکی از آنهاست.
جدول ۵ نمونه برداری طبقه بندی شده را بر اساس استفاده از تغییرات چند زمانی پوشش زمین و انواع بدون تغییر برای تعریف طبقات نشان می دهد. هدف از تقسیم به هشت طبقه، بهبود دقت برای انواع تغییرات نادر است، که این هدف با افزایش نسبت نمونه های آنها محقق می شود.
واحدهای نمونهگیری مرحله دوم به پیکسلهای موجود در PSUهای مرحله اول هر منطقه اکولوژیکی اشاره دارد. واحدهای نمونه با وضوح محصول جهانی پوشش زمین شهری منطبق است. با نرخ خطای طبقهبندی ۲۰ درصد، سطح اطمینان ۹۵ درصد و خطای نسبی ۰٫۰۵، تعداد پیکسلهای نمونه بر اساس مدل آمار احتمال برای مقیاس جهانی ۶۷۵۵ است [ ۴۷ ]. اندازه نمونه برای هر منطقه اکولوژیکی بر اساس مساحت زمین شهری تا کل مساحت زمین شهری جهانی در نقشه طبقه بندی، همانطور که در جدول ۶ نشان داده شده است، تعیین شد .
۳٫۳٫ تخصیص نمونه به اقشار برای محصول پوشش زمین شهری جهانی چندموقت
حجم نمونه ۵۰۰ نفری به عنوان مبادله ای بین مقرون به صرفه بودن و به موقع بودن انتخاب شد. سپس ماتریس خطای مربوطه نشان داده شده در جدول ۷ با تفسیر بصری نتایج برای این نمونه های از پیش انتخاب شده به دست آمد. تخصیص نمونه بهینه بر اساس تابع مجموع واریانس همه اقشار برای دقت کاربر، دقت تولیدکننده و نسبت تخمینی مساحت انجام شد. یک قانون کلی توصیه شده توسط Congalton [ ۴۸ ] استفاده از حداقل حجم نمونه ۵۰ برای هر کلاس در ماتریس خطا بود. این حداقل باید به ۷۵ یا ۱۰۰ افزایش یابد اگر طبقه بندی دارای کلاس های زیادی در نقشه طبقه بندی باشد یا دارای مساحت بزرگی باشد [ ۴۸ ].]. نمونه های تخصیص یافته به هر قشر در زیر بوم مناطق در شکل ۹ نشان داده شده است.
اجرای LPM می تواند نمونه ای را از یک جامعه دو بعدی انتخاب کند. نمونه ها در فضا بر اساس LPM [ ۳۸ ] گسسته می شوند. با در نظر گرفتن زمان مصرف، از نمونه گیری تصادفی برای انتخاب نقاط نمونه در لایه بدون تغییر (یعنی لایه ۰۰۰) داده های زمانی سه دوره استفاده شد، در حالی که از روش LPM برای انتخاب نقاط نمونه در هفت لایه باقی مانده استفاده شد. .
۳٫۴٫ تخمین دقت
در طول تخمین دقت، شاخص دقت واحد اغلب به نتیجه گیری نادرستی منجر می شود. بنابراین، شاخص های متعددی مانند دقت کاربر، تولیدکننده و غیره برای ارزیابی داده ها استفاده می شود. در فرآیند عملی، علاوه بر دقت کلی، از شاخص های دقت شرح داده شده در معادلات (۱۱) تا (۱۸) برای ارزیابی استفاده می شود.
۳٫۴٫۱٫ تخمین های دقت تک تاریخ
ارزیابی دقت منطقه شهری جهانی تکتاریخ، اطلاعات مهمی را در رابطه با کیفیت محصول چند زمانی ارائه میدهد. دقت کلی منطقه شهری جهانی ۹۷٫۱۸% برای سال ۲۰۰۰، ۹۷٫۱۱% برای سال ۲۰۰۵، و ۹۶٫۸۴% برای سال ۲۰۱۰، با انحراف معیار به ترتیب ۰٫۲۱%، ۰٫۲۱% و ۰٫۲۲% است ( شکل ۱۰ a). دقت کلی این نقشه های شهری چند زمانی و تک تاریخی همگی بیش از ۹۵ درصد است. این به این دلیل است که نسبت مناطق غیر شهری در بسیاری از برگه های نقشه بسیار نزدیک به ۰ است و نسبت غالب مناطق غیر شهری به درستی طبقه بندی شده است که در نتیجه دقت بالایی دارد.
دقت کاربر برای غیر شهری با گذشت زمان کاهش یافت ( شکل ۱۰ ب). با این حال، دقت کاربر برای شهری به طور قابل توجهی از ۰٫۸۲ ± ۵۸٫۳ درصد به ۰٫۸۷ ± ۶۷٫۲۷ درصد طی ۱۰ سال افزایش یافته است. این داده ها نشان می دهد که از سال ۲۰۰۰ تا ۲۰۱۰، سطح شهرنشینی جهانی افزایش یافته است که احتمال سقوط نمونه های انتخاب شده در قطعات شهری همگن را افزایش می دهد و بر نتیجه ارزیابی دقت آن تأثیر می گذارد. تفاوت قابل توجهی در دقت بین مناطق غیر شهری و شهری وجود دارد. برای مناطق غیر شهری، دقت کاربر در مقیاس جهانی بالای ۹۵ درصد است که بیشترین دقت ۰٫۳ ± ۹۸٫۰۷ درصد برای سال ۲۰۱۰ و کمترین دقت ۹۷٫۶۵ ± ۰٫۳ درصد برای سال ۲۰۰۰ است. همین روند را می توان در تولیدکننده مشاهده کرد. دقت برای مناطق غیر شهری و شهری
شکل ۱۰ b,c نیز نشان می دهد که انحراف معیار منطقه شهری در دقت کاربر و تولید کننده بیشتر از منطقه غیر شهری است. این به این دلیل است که مساحت زمین شهری نسبت نسبتاً کمی از مساحت نقشه برداری شده را نشان می دهد و در مقایسه با مساحت زمین غیر شهری نسبتاً پراکنده است. نتایج تفسیر نمونه به طور مداوم ضعیف است که منجر به خطاهای بزرگ می شود. با این وجود، در طی ۱۰ سال، مناطق غیر شهری و شهری به طور پیوسته با دقت بالا نقشه برداری شدند.
۳٫۴٫۲٫ دقت سه فاز پوشش زمین شهری برای انواع تغییر و بدون تغییر
زمین شهری سه دوره با در نظر گرفتن ویژگی های زمانی و مکانی طبقه بندی و سپس دقت ارزیابی شد. در مقیاس جهانی، ۰۰۰ به نوع غیر شهری اشاره دارد که بیشترین نسبت کل منطقه را به خود اختصاص داده است. ممکن است طبقه بندی های اشتباهی وجود داشته باشد، اما این مربوط به خطاهای شهری-زمینی نیست. بنابراین، این نوع خطا بر دقت تأثیر نمی گذارد. شکل ۱۱نشان میدهد که دقت کلی بالای ۹۵ درصد ناشی از نسبت بزرگ منطقه غیر شهری است. دقت کاربر برای منطقه غیر شهری بیش از ۹۵٪ است. دقت کاربر برای نوع تغییر پوشش زمین به طور کلی بسیار کمتر است، در کمتر از ۱۰٪ برای برخی از اقشار، در حالی که دقت تولید کننده برای نوع تغییر پوشش زمین بالاتر است. دقت کاربر برای گسترش شهری بیشتر از دقت کاربر برای نوع تغییر پوشش زمین است. نسبت مساحت انواع مختلف تغییرات ممکن است باعث انحراف معیار بزرگ شود. از شکل ۱۱ ، دقت شهرنشینی (۰۱۰، ۱۰۰، ۱۰۱، و ۱۱۰) در مقایسه با سود شهری (۰۰۱ و ۰۱۱) بسیار پایین است زیرا نسبت شهرزدایی کم است.
۳٫۴٫۳٫ دقت برای انواع تغییر و بدون تغییر
منطقه شهری-سرزمین جهانی بر اساس تقسیمات اکولوژیکی به ۱۵ منطقه فرعی تقسیم شد. از جدول ۸ ، جدول ۹ و جدول ۱۰، دقت کلی تغییر باینری و طبقه بندی بدون تغییر بیش از ۹۰٪ در سطح جهانی است. نرخ توافق کلی بالا ناشی از نسبت بزرگ منطقه بدون تغییر است. دقت کاربر و تولید کننده برای عدم تغییر به طور مداوم بالای ۹۰٪ است، در حالی که دقت کاربر و تولید کننده برای تغییر در همه مناطق فرعی کمتر و متغیرتر است. تمهای گزارشدهی لایههای تغییر باقیمانده دقت کاربر کمتری دارند. توضیح جزئی برای عدم دقت بالای یکنواخت کاربر برای مضامین گزارش که نشان دهنده تغییر هستند در ماتریس های خطا مشهود است. دقت طبقهبندی تغییر تولیدکننده برای سالهای ۲۰۰۰-۲۰۰۵ ( جدول ۱۰) نسبت به سایر دوره ها بیشتر است، اما واریانس بالایی را نشان می دهد. این ممکن است نتیجه کیفیت پایین داده های مرجع از سال ۲۰۰۰ تا ۲۰۰۵ باشد.
در مقیاس منطقه اکولوژیکی، حجم نمونه اختصاص داده شده به هر منطقه با توجه به نسبت وسعت منطقه شهری تعیین می شود. بنابراین به مناطق ۷ و ۹ تعداد کمی نمونه اختصاص داده شده است. دقت کلی برای مناطق مختلف زیست محیطی متفاوت است، و همه آنها بالای ۹۰٪ با انحراف استاندارد کمتر از ۱٪ هستند. بیشترین دقت در منطقه ۱۵ برای سه دوره و کمترین دقت در منطقه ۴ مشاهده می شود ( شکل ۱۲ ). این نتایج نشان می دهد که دقت در هر دو سال مختلف و مناطق مختلف اکولوژیکی متفاوت است. بنابراین، مناطق بومشناختی را میتوان بهعنوان موجودیتهای ناهمگن در نظر گرفت و نمونهگیری طبقهای منطقهای درک بهتری از محصول جهانی پوشش زمین شهری را فراهم میکند.۳۰ ].
۳٫۴٫۴٫ دقت گسترش شهری و بدون تغییر
تحقیقات قبلی در مورد ارزیابی دقت در منطقه شهری فقط سود پایدار شهری، پایدار غیر شهری و شهری را در نظر میگیرد، یعنی (۰۰۰، ۰۰۱، ۰۱۱، و ۱۱۱). اگر فقط محاسبه دقت نمونه ها را از این چهار لایه در نظر بگیریم، نمونه هایی از سایر لایه ها در محاسبه لحاظ نمی شوند. دقت کلی برای سه فاز برای گسترش شهری و بدون تغییر ۰٫۳ ± ۹۶٫۹٪ است ( شکل ۱۳ ). از شکل ۱۴ الف، دقت کلی برای زمین شهری در سه فاز به طور قابل توجهی در مقایسه با نوع تغییر هشت لایه بهبود یافته است. دقت کاربر و دقت تولید کننده روند یکسانی دارند ( شکل ۱۴قبل از میلاد مسیح). OA تخمین زده شده برای سال ۲۰۰۰ بالاترین میزان است و برای سال های ۲۰۰۵ و ۲۰۱۰ کمی پایین تر است که مشابه نتایج ارزیابی هشت لایه قبلی است. طرح های مختلف نمونه گیری تأثیر مستقیمی بر نتایج ارزیابی دقت محصول دارد. در مقایسه با شکل ۱۳ و شکل ۱۴ ، دقت کاربر و دقت تولیدکننده برای چهار نوع لایه در مقایسه با هشت نوع (۰۰۰، ۰۱۰، ۰۰۱، ۰۰۱، ۱۱۰، ۱۰۰، ۱۰۱، و ۱۱۱) بهبود یافته است. کم دقت ترین لایه ۰۱۱ است.
۳٫۴٫۵٫ معیارهای دقت
جدول ۱۱مقادیر متریک دقت تخمینی را در مقیاس جهانی و انحراف استاندارد آنها را برای هر سال اعتبار سنجی نشان می دهد. مقادیر Oe بالاتر از مقادیر Ce برای سه دوره است، که با مقادیر منفی relB مطابقت دارد، که نشان دهنده دست کم گرفتن دقت زمین شهری است. سال ۲۰۱۰ بالاترین DC را با ۵۳% (۵٫۵±%) نشان می دهد، پس از آن سال ۲۰۰۵ با ۵۲% (±۵٫۶%) و سال ۲۰۰۰ با ۴۸% (±۵٫۷%) قرار دارد. سال ۲۰۱۰ بیشترین دقت را در Ce و DC به دست آورد، در حالی که سال ۲۰۰۰ کمترین دقت را در Ce، Oe و DC نشان می دهد. سال ۲۰۰۵ به کمترین مقدار relB 28-% (±۱۳٫۲%) رسید. تخمین انحراف استاندارد از چهار معیار دقت برای سال ۲۰۱۰ کمترین میزان است. محدوده معیارهای دقت بین سه دوره نسبتاً کوچک است. محدوده Ce، Oe و DC برای سه دوره کمتر از ۵٪ است.
۴٫ بحث
در این مقاله، ما یک چارچوب نمونهبرداری طبقهبندیشده مکانی-زمانی برای دادههای پوشش زمین شهری جهانی چند زمانی پیشنهاد کردهایم که با هدف ارزیابی دقیق دقت دادههای تک دورهای و همچنین تغییر دو دورهای و دقت نوع بدون تغییر انجام میشود. در طرح نمونهگیری، از مدل آماری نمونهگیری احتمالی برای محاسبه حجم نمونه واحدهای نمونهگیری اولیه و ثانویه استفاده میشود. روش نمونهگیری درصدی دارای معایبی است، مانند دستههای بزرگ سخت و دستههای کوچک شل، و نمیتوان آن را به خوبی برای تعیین حجم نمونه اعمال کرد. مطالعات متعدد در مورد چگونگی تعیین منطقی اندازه نمونه در هنگام ارزیابی دقت محصولات پوشش زمین شکست خورده اند. با این حال،۲۴]. در رویکرد پیشنهادی، طبقهبندی توسط مناطق بومشناختی شهری جهانی و تغییرات مکانی-زمانی تعیین میشود و یک چارچوب نمونهبرداری دو مرحلهای ایجاد میشود. در طول نمونهگیری مرحله اول، یک طرح نمونهگیری تصادفی طبقهای منطقهای برای تخصیص نمونهها به طبقات با توجه به نسبت وسعت منطقه شهری محصول جهانی پوشش زمین شهری استفاده میشود. طبقه بندی تغییرات مکانی-زمانی پشتیبانی فنی برای نظارت پویا محصول را فراهم می کند. در مرحله دوم، بر اساس ویژگی های زمین شهری چند زمانی، روشی برای تعیین حجم نمونه طبقه بندی شده با تابع هدف پیشنهاد شده است. با توجه به ویژگیهای توزیع فضایی پوشش زمین شهری، پیکسلهای نمونه توسط LPM انتخاب میشوند.
برآوردهای دقت انجام شده بر اساس نمونهای از دادههای مرجع اطلاعات ارزشمندی را در مورد نقشههای تکتاریخ و دادههای چندزمانی جهانی پوشش زمین شهری برای انواع تغییر و بدون تغییر ارائه میدهد. هنگامی که فقط انواع بدون تغییر (۰۰۰ و ۱۱۱) و گسترش شهری (۰۰۱ و ۰۱۱) به عنوان لایه در نظر گرفته شد، مشخص شد که دقت کلی به تدریج از سال ۲۰۰۰ تا ۲۰۱۰ کاهش یافته است ( شکل ۱۴ a). نتایج ارزیابی دقت برای هشت لایه با در نظر گرفتن تغییرات مکانی-زمانی به بالاترین میزان در سال ۲۰۰۰ و کمترین آن در سال ۲۰۱۰ رسید ( شکل ۱۰).آ). توضیحی برای این امر این است که نسبت مساحت زمین اشغال شده توسط اقشار تغییر اندک است، اما همچنان بر نتیجه ارزیابی دقت طبقه بندی شده تأثیر دارد. از سال ۲۰۰۰ تا ۲۰۱۰ مشخص شد که مساحت زمین شهری رو به افزایش بوده است و دقت طبقه بندی آن کمتر از زمین های غیر شهری بوده که به نوبه خود بر دقت کلی محصول تأثیر می گذارد. در تحقیقات آتی، میتوان از انواع شاخصهای دقت برای ارزیابی دقت یک نوع محصول داده استفاده کرد و به دقت کلی، دقت تولیدکننده و دقت کاربر در نظر گرفته شده در این مطالعه محدود نمیشود. در این مقاله، آزمایش ارزیابی دقت پوشش زمین چند زمانی تنها از سه دوره داده برای اعتبار سنجی استفاده می کند. و انتظار می رود که در آینده بتوان از بیش از سه دوره داده برای تأیید روش استفاده کرد. برای روش تخصیص حجم نمونه بر اساس بهینهسازی تابع هدف، لازم است واریانس دادهها از قبل بدانیم. اما در مرحله طراحی نمونه، این اطلاعات مشخص نیست. انتظار می رود در آینده بتوان آن را با سایر اطلاعات نقشه مانند مساحت هر طبقه در نقشه طبقه بندی توسعه داد. مدلهای معقولی برای کاهش شدت کار ناشی از نمونهگیری اولیه ایجاد خواهد شد. می توان آن را با سایر اطلاعات نقشه مانند مساحت هر طبقه در نقشه طبقه بندی توسعه داد. مدلهای معقولی برای کاهش شدت کار ناشی از نمونهگیری اولیه ایجاد خواهد شد. می توان آن را با سایر اطلاعات نقشه مانند مساحت هر طبقه در نقشه طبقه بندی توسعه داد. مدلهای معقولی برای کاهش شدت کار ناشی از نمونهگیری اولیه ایجاد خواهد شد.
عوامل زیادی وجود دارد که بر دقت تفسیر تصویر بصری تأثیر میگذارد: ناهماهنگی در تعریف دادههای زمین شهری [ ۴۹ ]، طبقهبندی اشتباه در دادههای زمین شهری جهانی، ناهماهنگی فضایی بین نقشه طبقهبندی و دادههای مرجع، مفسران مختلف که یک نمونه مشابه را با برچسبهای متفاوت نشان میدهند. برچسب های مرجع [ ۵۰ ]، و داده های مرجع عاری از خطا نیستند [ ۵۱ ]. رویه های اعتبارسنجی باید در مطالعات آینده بهبود یابد.
۵٫ نتیجه گیری ها
کیفیت داده ها یک ویژگی کلیدی محصولات چندزمانی جهانی پوشش زمین شهری است و دقت موضوعی یک شاخص ضروری برای اجرای کنترل کیفیت محصول است. روش نمونهگیری طبقهبندیشده مکانی-زمانی پیشنهادی، روشی کارآمد و دقیق برای اعتبارسنجی محصولات پوشش زمین شهری جهانی چندزمانی ارائه میکند. طبقه بندی دو مرحله ای توسط هر دو منطقه بوم شهری جهانی و تغییرات مکانی-زمانی نمونه های معقولی را ارائه می دهد و بنابراین، قابلیت اطمینان ارزیابی دقت را بهبود می بخشد. علاوه بر این، اندازه نمونه بهینه برای طبقهبندی با استفاده از ماتریس خطای پیش داوری اولیه به دست میآید و یک تابع هدف با ترکیب مجموع واریانس دقت کاربر، واریانس دقت تولیدکننده و واریانس نسبت مساحت تخمین زده شده برای همه لایهها ساخته میشود. این رویکرد واریانس کمتری را در دقت تخمینی نسبت به تخصیص مساوی و تخصیص متناسب نشان می دهد. علاوه بر این، از LPM برای متعادل کردن توزیع فضایی نمونهها استفاده میشود که منجر به تعادل فضایی نمونهها و کاهش واریانس نمونهبرداری میشود. از ارزیابی دقت محصول چندزمانی جهانی پوشش زمین شهری، یافتههای اصلی به شرح زیر است: (۱) در ارزیابی دقت پوشش زمین شهری جهانی در سالهای ۲۰۰۰ و ۲۰۱۰، دقت کلی دادهها اندکی کاهش مییابد. مساحت لایه تغییر نادر افزایش می یابد. (۲) دقت کلی برای تاریخ های تک بیش از ۹۵٪ است، اما دقت کاربر باید در محصولات مجموعه داده آینده بهبود یابد. (۳) انحراف استاندارد دقت کلی کمتر از ۱٪ است که نشان می دهد روش ارزیابی دقت پیشنهاد شده در این مقاله موثر است.