
چکیده
امکان ارائه شده توسط فناوری فعلی برای جمعآوری و ذخیره مجموعه دادههای مربوط به مکانهای عمومی واقع در کره زمین، چالشهای جدیدی را تا آنجا که به ادغام این مجموعه دادهها مربوط میشود، ایجاد میکند. تحلیلگران معمولاً نیاز دارند چنین ادغامی را از ابتدا انجام دهند، بدون انجام کارهای پیش پردازش یا پاکسازی داده پیچیده و طولانی، و همچنین بدون انجام فعالیت های آموزشی که نیاز به برچسب گذاری طولانی و خسته کننده داده ها دارد. علاوه بر این، تحلیلگران اکنون باید با فرمت محبوب JSON و مجموعه داده های ذخیره شده در JSON سر و کار داشته باشندفروشگاه های اسناد این مقاله نشان میدهد که یک روش مبتنی بر یکپارچهسازی نرم (یعنی یکپارچهسازی دادهها از طریق محاسبات نرم و مجموعههای فازی) اکنون میتواند به طور موثر از ابتدا، از طریق چارچوب J-CO ، که یک ابزار مستقل برای پردازش دادههای JSON است، اعمال شود. مجموعههایی که در اسناد JSON ذخیره میشوند، احتمالاً با انجام پرس و جوی نرم روی مجموعه دادهها. به طور خاص، این مقاله کمکهای زیر را ارائه میکند: (۱) یک تکنیک محاسباتی نرم برای یکپارچهسازی مجموعههای دادهای که مکانهای عمومی را توصیف میکنند، بدون هیچگونه پیش پردازش، تمیز کردن و آموزش اولیه، که میتواند از ابتدا اعمال شود، ارائه میکند. (۲) قابلیت های فعلی را برای ادغام نرم مجموعه داده های JSON ارائه شده توسطچارچوب J-CO . (۳) اثربخشی تکنیک یکپارچه سازی نرم را نشان می دهد. (۴) نشان می دهد که چگونه یک ابزار مستقل قادر به پشتیبانی از محاسبات نرم (به عنوان چارچوب J-CO ) می تواند در انجام وظایف یکپارچه سازی داده ها از ابتدا مؤثر و کارآمد باشد.
کلید واژه ها:
ادغام آفلاین مجموعه داده های دارای برچسب جغرافیایی ؛ مجموعه داده ها در مورد مکان های عمومی ؛ روش ادغام نرم ; یکپارچه سازی نرم موثر از طریق یک ابزار مستقل
۱٫ مقدمه
یکپارچه سازی اطلاعات جغرافیایی-مکانی به یک وظیفه حیاتی در دنیای کنونی تبدیل شده است. در واقع، در عصر دادههای باز و دادههای بزرگ، تعداد زیادی از منابع میتوانند مجموعههای داده معتبر و غیرمعتبر را در مورد مکانها ارائه دهند. این وضعیت با این واقعیت پیچیده تر می شود که رسانه های اجتماعی ابزارهایی را در اختیار مردم قرار می دهند تا مکان ها را به روشی غیر کنترل شده توصیف کنند. به عنوان مثال، فیس بوک به کاربران خود قابلیت تعریف “صفحه” را ارائه می دهد. یک دسته خاص از صفحه یک “مکان عمومی” را توصیف می کند، مانند رستوران ها، میخانه ها، کمدهای هوا، دانشگاه ها، پارک ها و غیره. از طریق API (رابط برنامه نویسی برنامه)، صفحات را می توان بر اساس دسته بندی، مکان، مختصات و غیره جستجو کرد. سرویس جالب دیگر Google Places نام دارد: یکی از خدمات فرعی Google Maps است. Google Places API را می توان برای پرس و جو از مجموعه آن برای یافتن مکان های مورد علاقه، بر اساس دسته، مکان، و غیره استفاده کرد. این مجموعه توسط Google Maps با ادغام دادههای معتبر و غیرمعتبر ساخته شده است، این دادههای دوم توسط کاربران از طریق رابط اجتماعی ارائه شده توسط Google Maps ارائه میشوند .
در سناریوی فعلی، جمعآوری مجموعه دادهها از منابع متعدد بسیار آسان است، به طوری که این مجموعه دادهها اطلاعات برچسبگذاری شده جغرافیایی در مورد مکانهای عمومی ارائه میدهند. از آنجایی که APIهای فعلی رسانههای اجتماعی و پورتالهای Open-Data دادهها را بهعنوان اسناد JSON با برچسب جغرافیایی (احتمالاً) ارائه میکنند ( JSON مخفف علامت گذاری شی جاوا اسکریپت است، به [ ۱ ] مراجعه کنید)، ذخیرهسازی اسناد JSON ذخیرهسازی طبیعی است که در آن مجموعههای داده ذخیره میشود. در نتیجه، ادغام مجموعه دادههای برچسبگذاریشده جغرافیایی که مکانهای عمومی را توصیف میکنند، ابزارهای مناسبی را میطلبد که قادر به کار در فروشگاههای اسناد JSON هستند. به همین دلیل است که در دانشگاه برگامو (ایتالیا)، ما در حال ابداع [ ۲ ، ۳ ، ۴ هستیم., ۵ ] یک ابزار نوآورانه به نام J-CO Framework، برای انجام یکپارچه سازی و جستجوی پیچیده مجموعه داده های JSON (احتمالاً دارای برچسب جغرافیایی).
با این وجود، یکپارچه سازی مجموعه داده های برچسب گذاری شده جغرافیایی که مکان های عمومی را توصیف می کنند، مشکل جدیدی نیست. به طور کلی، رویکردهای سنتی بر تکنیکهای یادگیری ماشینی تکیه میکنند که نیاز به یک مرحله آموزش مقدماتی دارند. در [ ۶ ]، به این مشکل به روشی متفاوت پرداخته شد، زیرا زمینه تجمیع «آنلاین» در نظر گرفته شد. یک رابطه فازی تعریف شد که یک معیار محاسبه آسان را ارائه می دهد که برای ادغام آنلاین داده ها در مورد مکان های عمومی مناسب است. آزمایشها نشان داد که این رویکرد از نظر اثربخشی با تکنیکهای طبقهبندی آفلاین مؤثر و قابل مقایسه است. با این حال، تکنیک ارائه شده در [ ۶] در نمونه اولیه نرم افزار به صورت سخت کدگذاری شد. این واقعیت باعث شد که بتوانیم برخی از مراحل پیش پردازش را روی رشتههایی که بلافاصله پس از بهدستآمدن توصیفگرهای مکان انجام میشوند، بگنجانیم. با این حال، به نظر میرسد این رویکرد کلی است و میتواند برای یکپارچهسازی مجموعههای داده به صورت آفلاین نیز با مجموعه دادههای ذخیره شده در فروشگاههای JSON اعمال شود. به طرز متناقضی، این تغییر ظاهراً کوچک زمینه چالش مهمی را ایجاد میکند: در واقع، راهحل ساده میتواند همچنان کدگذاری سخت تکنیک در یک ابزار نرمافزاری باشد، اما این رویکرد با دنیای فروشگاههای اسناد JSON سازگار نیست. ما فکر می کنیم که بهره برداری از یک ابزار مستقل می تواند JSON را پرس و جو کندفروشگاه ها ترجیح داده می شوند، زیرا برای تحلیلگران شفاف و قابل درک است. با این حال، یک ابزار مستقل برای پردازش مجموعه دادههای JSON لزوماً انعطافپذیرتر از یک زبان برنامهنویسی است. بنابراین، چالش به شرح زیر است: آیا می توان یک ابزار مستقل را شناسایی کرد و تکنیک یکپارچه سازی ارائه شده در [ ۶ ] را با مورد ادغام آفلاین مجموعه داده های JSON دارای برچسب جغرافیایی از فروشگاه های JSON تطبیق داد ؟
تکامل فعلی J-CO-QL +، زبان پرس و جو از چارچوب J-CO ، ساختارهایی را برای ارزیابی عضویت اسناد JSON در مجموعه های فازی ارائه می دهد [ ۷ ، ۸ ، ۹ ]. بنابراین، ایده ساده بررسی قابلیت فعلی J-CO-QL +برای ادغام مجموعههای داده JSON که مکانهای عمومی را توصیف میکنند، منتشر شده است: به طور خاص، از J-CO-QL +قادر به مقابله با پرس و جوی نرم پیچیده مجموعه داده های JSON است و تکنیک ارائه شده در [ ۶ ] برای ادغام آنلاین مجموعه داده های مربوط به مکان های عمومی بر اساس روابط فازی است، ما شهود ترکیب این دو رویکرد را داشتیم. به عبارت دیگر، با توجه به دو مجموعه از توصیفگرهای مکان که به عنوان اسناد JSON نشان داده شده و در یک فروشگاه اسناد JSON ذخیره می شوند ، در این مقاله، ما با استفاده از تکنیک فازی ارائه شده در [ ۶ ] (به طور دقیق، نسخه کمی تکامل یافته از آن) با استفاده از J-COچارچوب، به صورت آفلاین. هدف این است که تأیید شود که این رویکرد در یک زمینه آفلاین، بدون فعالیتهای آموزشی قبلی و مداخله توسط انسان برای برچسبگذاری مجموعه دادهها برای هدایت مرحله یادگیری (معمولی تکنیکهای طبقهبندی) مناسب است. قطعاً، ما میخواهیم نشان دهیم که در دسترس بودن یک ابزار مستقل مانند J-CO Framework، که قادر به پردازش مجموعه دادههای JSON با استفاده از محاسبات نرم و مجموعههای فازی است، در واقع ابزاری قدرتمند برای حل یک مشکل در اختیار تحلیلگران قرار میدهد. تحلیلگران داده به روشی مؤثر و (احتمالاً) کارآمد با آن مواجه می شوند.
به طور خلاصه، سهم مقاله بسیار متنوع است: (۱) ارائه یک تکنیک محاسباتی نرم برای یکپارچه سازی مجموعه داده هایی که مکان های عمومی را توصیف می کنند، بدون هیچ گونه پیش پردازش اولیه، تمیز کردن و آموزش، که می تواند از ابتدا اعمال شود. (۲) ارائه قابلیتهای فعلی برای ادغام نرم مجموعه دادههای JSON ، همانطور که توسط J-CO-QL ارائه میشود.+; (۳) نشان دادن اثربخشی تکنیک یکپارچه سازی نرم در زمینه سخت تر از آنچه در [ ۶ ] در نظر گرفته شده است. (۴) نشان می دهد چگونه یک ابزار مستقل می تواند از محاسبات نرم پشتیبانی کند (به عنوان J-CO-QL +) می تواند در انجام وظایف یکپارچه سازی داده ها از ابتدا موثر و کارآمد باشد.
مقاله بصورت زیر مرتب شده است. بخش ۲ کار مرتبط مرتبط با مقاله را ارائه می دهد. بخش ۳ مقدمه ای کوتاه بر مفاهیم مرتبط در مورد نظریه مجموعه فازی ارائه می دهد. بخش ۴ ویژگی های اصلی چارچوب J-CO را معرفی می کند. بخش ۵ دقیقاً مشکل پرداخته شده را توضیح می دهد و روشی را که ما دنبال می کنیم، که بر مفهوم رابطه فازی متکی است، معرفی می کند. بخش ۶ اسکریپت نوشته شده با استفاده از J-CO-QL را ارائه و مورد بحث قرار می دهد+، که عملاً روش ارائه شده در بخش ۵ را به کار می گیرد . هر دستورالعمل منفرد توضیح داده شده است تا نحوه رفتار و سهم آن در فیلمنامه را نشان دهد. بخش ۷ نتایج یک ارزیابی تجربی را گزارش میکند که در آن اثربخشی و به طور جزئی زمان اجرا را ارزیابی کردیم. در نهایت، بخش ۸ نتیجه گیری و کار احتمالی آینده را ترسیم می کند.
۲٫ کارهای مرتبط
این مقاله دو خط تحقیقاتی مختلف را در بر می گیرد: پرس و جوی نرم در پایگاه داده ها به طور کلی و در فروشگاه های اسناد JSON به طور خاص ( بخش ۲٫۱ )، و همچنین ادغام مجموعه داده هایی که مکان های عمومی را توصیف می کنند ( بخش ۲٫۲ ).
۲٫۱٫ پرس و جوی نرم در پایگاه های داده
ارائه قابلیتهایی به کاربران داده برای جستجوی انعطافپذیر پایگاههای داده یک چالش قدیمی است. به طور خاص، زمانی که شرایط انتخاب میتواند به محمولهای مبهم متکی باشد، پرسوجوها «نرم» میشوند، به این معنی که آنها نسبت به آستانهها متحمل هستند (مثلاً با توجه به قیمت محمول بولی <= 30 برای انتخاب محصولات ارزان، محصولی که قیمت آن ۳۰٫۴۵انتخاب نشده است، در حالی که در عوض می تواند مورد علاقه باشد) و موارد انتخاب شده را می توان بر اساس ارتباط آنها با شرایط انتخاب رتبه بندی کرد. مجموعه های فازی به عنوان چارچوب رسمی برای تعیین شرایط انتخاب نرم ظاهر شدند [ ۱۰ ]. از آنجایی که فناوری پایگاه داده رابطه ای بر چشم انداز فناوری پایگاه داده تسلط داشت، کارهای زیادی برای پیشنهاد گسترش SQL (زبان پرس و جو استاندارد برای پایگاه داده های رابطه ای) به سمت پرس و جوی نرم مبتنی بر مجموعه های فازی انجام شد. برخی از پیشنهادات محبوب عبارتند از SQLf [ ۱۱ ، ۱۲ ] (که میتوان به تلاشی برای پیادهسازی آن اشاره کرد [ ۱۳ ]) و پسوند آن به نام SQLf3 (که با ساختارهای معرفیشده در SQL3 مقابله میکند.، و همچنین FQUERY for Access [ ۱۴ ، ۱۵ ] (طراحی شده برای کار بر روی پایگاه های داده مدیریت شده توسط Microsoft Access). در میان همه این پیشنهادات، SoftSQL [ ۱۶ ، ۱۷ ، ۱۸ ] به کاربران دستوری برای تعریف «مقدمات زبانی» غیر پیش پا افتاده ارائه کرد، تا در دستور SELECT توسعه یافته برای انتخاب ردیف های جدول از طریق محمولات زبانی استفاده شود. خواننده علاقه مند می تواند نظرسنجی های مختلفی را در مورد این موضوع بیابد [ ۱۹ ، ۲۰ ]. به طور خاص، کار [ ۲۱ ] یک کتاب راهنمای بسیار بزرگ است که تمام کارهای تحقیقاتی در مورد این موضوع را خلاصه می کند.
ظهور پایگاههای داده NoSQL (نه فقط SQL) [ ۲۲ ]، یعنی پایگاههایی که به مدل رابطهای کلاسیک متکی نیستند، عصر جدیدی را در مدیریت دادهها آغاز کرده است. به طور خاص، محبوبیت به دست آمده توسط فرمت JSON (Notation Object JavaScript) برای نشان دادن هر نوع داده پیچیده، مهندس داده را با مفهوم بدیع (در رابطه با پایگاه داده های رابطه ای) ” ذخیره اسناد JSON “، یعنی پایگاه داده ای مواجه کرده است. اسناد JSON را به صورت بومی ذخیره می کند. معروف ترین فروشگاه اسناد JSON MongoDB [ ۲۳ ] است، اما بسیاری دیگر نیز در دسترس هستند (مانند CouchDB [ ۲۴ ]]، در پلتفرم زنجیره بلوکی به نام HyperLedger Fabric [ ۲۵ ] مورد بهره برداری قرار می گیرد. در نتیجه، این سناریوی جدید موضوع پرس و جوی نرم در پایگاههای داده را اصلاح میکند، این بار در پایگاههای داده NoSQL به طور کلی و در فروشگاههای اسناد JSON به طور خاص.
توسعه MQL، زبان پرس و جو MongoDB ، در [ ۲۶ ] پیشنهاد شده است. در این پسوند، که “fMQL” نامیده می شود، از “برچسب های فازی” می توان برای پرس و جو از اسناد JSON استفاده کرد ، زیرا آنها معادل محمولات زبانی هستند. متأسفانه، کار [ ۲۶ ] هیچ نشانه ای در مورد چگونگی تعریف برچسب های فازی ارائه نمی دهد. محدودیت دیگر پیشنهاد این است که برای هر سند JSON ، تنها یک مدرک عضویت به طور ضمنی ارزیابی می شود (در مقابل، J-CO-QL +اجازه می دهد تا با درجات عضویت زیادی برای هر سند منفرد برخورد کنید).
در نهایت، کار [ ۲۷ ] رویکردی را برای پرس و جوی نرم اسناد JSON پیشنهاد میکند : مجموعه اسناد JSON در ابتدا به سهگانه RDF فازی ترجمه میشود [ ۲۸ ]. سپس، پرس و جو به fSPARQL [ ۲۹ ]، یک پسوند فازی از SPARQL [ ۳۰ ] ترجمه می شود. به نظر ما، این رویکرد برای پردازش اسناد JSON مناسب نیست ، زیرا روی اسناد اصلی کار نمی کند، بلکه بر روی یک نمایش جایگزین از آنها کار می کند.
۲٫۲٫ ادغام مجموعه دادههایی که مکانهای عمومی را توصیف میکنند
موضوع تجمیع اطلاعات مکانهای عمومی از منابع اینترنتی در دهه اخیر مورد بررسی قرار گرفته است. بسیاری از رویکردهای مختلف دنبال شده است.
برای مثال، کار [ ۳۱ ] تکنیک DAS را برای ادغام دادههای مربوط به مکانهای عمومی بهطور منحصربهفرد با بهرهبرداری از شباهت رشتهها در نامها، بهویژه با مقایسه دو رشته بدون و با توکنسازی اتخاذ میکند.
کار [ ۳۲ ] معیارهای مختلف شباهت رشتهها را با روشهای مختلف یادگیری ماشین مقایسه میکند تا مشکل تطبیق نام نامها را حل کند. نتایج نشان میدهد که روشهای یادگیری ماشین (به ویژه طبقهبندیکنندهها) بهتر از معیارهای شباهت رشتهای عمل میکنند. بدیهی است که آنها را نمی توان از ابتدا و بدون برچسب گذاری اولیه و فعالیت های آموزشی اعمال کرد. به طور مشابه، کار [ ۳۳ ] از یک شبکه عصبی برای انجام “تطبیق نام”، یعنی جفت کردن رشته هایی که مکان یکسانی را نشان می دهند، بهره برداری می کند.
این کار [ ۳۴ ] با اتخاذ یک تکنیک مبتنی بر آنتروپی به مشکل “ترکیب داده های جغرافیایی- فضایی” (نام کلی مسئله پرداخته شده در این مقاله) می پردازد: ایده کلیدی استفاده از رونویسی های آوایی برای جبران اشتباهات در نوشتن است. نام ها
کار دیگری که می تواند به عنوان مرتبط با این مقاله در نظر گرفته شود [ ۳۵ ] است که در آن به “تراز معنایی” مجموعه داده های ناهمگن جغرافیایی-مکانی (GDs) پرداخته شده است. به طور خاص، یک تکنیک تطبیق شباهت کارآمد را پیشنهاد کرد که سیستمهای دستهبندی مختلف را به طور همزمان ادغام میکند.
در نهایت، نزدیک ترین کار به این مقاله [ ۶ ] است: این کار را می توان تکامل طبیعی آن در نظر گرفت. به طور خاص، یک رابطه فازی پیچیده برای انجام ادغام مکان عمومی به صورت آنلاین تعریف شده است. مقایسه با یک تکنیک طبقهبندی معروف (یعنی طبقهبندیکنندههای “جنگل تصادفی”) انجام شد که نشان میدهد رویکرد فازی به روشی قابل مقایسه مؤثر است. در اینجا، تعریف رابطه فازی برای مقابله با نامها و آدرسهای پاکنشده بهبود یافته است، و همچنین در چارچوب J-CO برای ادغام آفلاین مجموعههای داده JSON اعمال میشود.
۳٫ مفاهیم پایه در مجموعه های فازی
زاده در [ ۳۶ ] نظریه مجموعه فازی را معرفی کرد. به سرعت مشخص شد که پتانسیل بسیار زیادی برای کاربرد موفقیت آمیز در بسیاری از زمینه های علوم کامپیوتر مانند تصمیم گیری، نظریه کنترل، سیستم های خبره، هوش مصنوعی، پردازش زبان طبیعی و غیره دارد (و هنوز هم دارد). در اینجا، ما برخی از مفاهیم اساسی را گزارش میکنیم که مبنای درک سهم اصلی این مقاله را تشکیل میدهند.
تعریف ۱٫
مجموعه فازی. یک “مجموعه جهان” U را در نظر بگیرید. یک مجموعه فازی (یا مجموعه فازی نوع ۱) A در U ( آ⊆U) نقشه برداری است آ:U→[۰،۱]. ارزش آ(ایکس)به عنوان درجه عضویت عنصر x به مجموعه فازی A گفته می شودμآ(ایکس)∈[۰،۱]می تواند به کار رود.
واضح است که یک مورد داده شده است ایکس∈U، اگر آ(ایکس)=۰، این بدان معنی است که x اصلاً متعلق به A نیست. یک مقدار میانی ۰<آ(ایکس)<1به این معنی است که x تا حدی متعلق به A است (هر چه مقدار بیشتر باشد، درجه عضویت آن بالاتر است). اگر آ(ایکس)=۱، این بدان معنی است که مورد x به طور کامل متعلق به A است.
در نتیجه، یک مجموعه فازی «خالی» است اگر و تنها در صورتی که تابع عضویت آن برای هر یک به طور یکسان صفر باشد. ایکس∈U.
علاوه بر این، با توجه به دو مجموعه فازی A در U و B در U ، آنها “برابر” هستند (به صورت آ=ب)، اگر و تنها اگر آ(ایکس)=ب(ایکس)(متناوبا، از سوی دیگر، μآ(ایکس)=μب(ایکس)) برای همه ایکس∈U.
با گسترش عملگرهای کلاسیک در مجموعه های سنتی می توان عملگرهای مجموعه های فازی را به راحتی تعریف کرد.
تعریف ۲٫
اتحاد، تقاطع و مکمل. یک جهان U و دو مجموعه فازی A در U و B در U را در نظر بگیرید.
اتحاد دو مجموعه فازی A و B که به عنوان نشان داده می شوداس=آ∪ب، یک مجموعه فازی جدید S را ایجاد می کند که تابع عضویت آن است اس(ایکس)=مترآایکس(آ(ایکس)،ب(ایکس))، برای هر ایکس∈U(متناوبا، از سوی دیگر، μاس(ایکس)=مترآایکس(μآ(ایکس)،μب(ایکس))).
تقاطع دو مجموعه فازی A و B که به عنوان نشان داده می شود من=آ∩ب، یک مجموعه فازی جدید S را ایجاد می کند که تابع عضویت آن است من(ایکس)=مترمنn(آ(ایکس)،ب(ایکس))، برای هر ایکس∈U(متناوبا، از سوی دیگر، μمن(ایکس)=مترمنn(μآ(ایکس)،μب(ایکس))).
مکمل یک مجموعه فازی A که به عنوان نشان داده می شود سی=آ¯، یک مجموعه فازی جدید C ایجاد می کند که تابع عضویت آن است سی(ایکس)=۱-آ(ایکس)، برای هر ایکس∈U(متناوبا، از سوی دیگر، μسی(ایکس)=۱-μآ(ایکس)).
عملگرهای منطقی کلاسیک بر روی عملگرها در مجموعه های فازی نگاشت می شوند: عملگر OR بر روی اتحادیه نگاشت می شود. عملگر AND روی تقاطع نگاشت می شود. عملگر NOT روی مکمل نگاشت می شود.
مجموعههای فازی برای نمایش مفاهیم مبهم، که مشخصه بسیاری از زمینههای کاربردی زندگی واقعی هستند، مفید هستند. به عنوان مثال، اگر جهان مجموعه ای از افراد است، می توانیم فکر کنیم که آنها را به “جوان” و “پیر” تقسیم کنیم. با این حال، آیا فردی که سنش ۴۰ سال است واقعا جوان است یا پیر؟ او کمی جوان و کمی پیر است، نه کاملاً جوان و نه کاملاً پیر.
عملگرهای مختلف دیگری در مجموعه های فازی قابل تعریف هستند. در تعریف زیر عملگر “weighted aggregation” را معرفی می کنیم.
تعریف ۳٫
تجمع وزنی با توجه به یک جهان U و دو مجموعه فازی A در U و B در U، عملگر تجمع وزنیدبلیو=wآgβ(آ،ب)(با β∈[۰،۱]) یک مجموعه فازی جدید W تولید می کند که تابع عضویت آن به صورت تعریف شده است دبلیو(ایکس)=β×آ(ایکس)+(۱-β)×ب(ایکس)(متناوبا، از سوی دیگر، μدبلیو(ایکس)=β×μآ(ایکس)+(۱-β)×μب(ایکس)).
مثال ۱٫
از طریق درجه عضویت، می توان به عضویت جزئی یک آیتم اشاره کرد ایکس∈Uبه A; به این ترتیب می توان مفاهیم مبهم زبانی را مدلسازی کرد. به عنوان مثال، با توجه به یک مکان عمومی p، عضویت آن در پoپتولآrپلآجهسمجموعه فازی می تواند جزئی باشد، که نشان دهنده مکانی است که چندان محبوب نیست. بنابراین، درجه عضویت میزان محبوبیت آن را می سنجد، به عنوان مثال بر اساس تعداد لایک های به دست آمده در رسانه های اجتماعی.
فرض کنید که در همان جهان از مکان های عمومی، ما تصور می کنیم سیساعتهآپآرهستیآتوrآnتیسمجموعه فازی، که درجه عضویت آن بیانگر این تصور است که یک مکان عمومی ارزان است (این تصور را می توان با تجزیه و تحلیل منوهای منتشر شده در رسانه های اجتماعی القا کرد).
ما اکنون نحوه جمع آوری را نشان می دهیم پoپتولآrپلآجهسو سیساعتهآپآرهستیآتوrآnتیسمجموعه های فازی برای به دست آوردن مکان های جالب.
-
اگر به دنبال ” رستوران های محبوب و ارزان” هستیم، می توانیم جستجو را به صورت “پoپتولآrپلآجهسو سیساعتهآپآرهستیآتوrآnتیس” (از نظر مجموعه های فازی است من=پoپتولآrپلآجهس ∩ سیساعتهآپآرهستیآتوrآnتیس). واضح است که درجه عضویت کمتر ارتباط واقعی یک مکان p را تعیین می کند.
-
اگر به دنبال ” رستوران های محبوب یا ارزان” هستیم، می توانیم جستجو را به صورت “پoپتولآrپلآجهسیا سیساعتهآپآرهستیآتوrآnتیس” (از نظر مجموعه های فازی است اس=پoپتولآrپلآجهس ∪ سیساعتهآپآرهستیآتوrآnتیس). واضح است که درجه عضویت بالاتر ارتباط واقعی یک مکان p را تعیین می کند (مکانی ممکن است محبوب نباشد، اما بسیار ارزان باشد).
-
اگر به دنبال ” رستوران های محبوب و احتمالا ارزان” هستیم، می توانیم جستجو را به صورت “۷۰%” فرموله کنیم.پoپتولآrپلآجهسو ۳۰% سیساعتهآپآرهستیآتوrآnتیس” (از نظر مجموعه های فازی است دبلیو=wآg0.7(پoپتولآrپلآجهس، سیساعتهآپآرهستیآتوrآnتیس)). واضح است که درجه عضویت نهایی تحت سلطه درجه محبوبیت است، اما یک مکان محبوب که یک رستوران ارزان نیز باشد دارای درجه عضویت بالاتری نسبت به مکان محبوبی است که اصلاً یک رستوران ارزان نیست.
سه جستجوی ذکر شده در بالا نمونههایی از «پرسمانهای نرم» هستند که شرایط انتخاب به شیوهای مبهم بیان میشوند. درجه عضویت به دست آمده نشان دهنده “ارتباط” یک مورد با پرس و جو نرم افزاری است.
علاوه بر این، توجه داشته باشید که وقتی نامهایی که به مجموعههای فازی داده میشود، از نظر زبانی آیتمها را به روشی مناسب مشخص میکنند، میتوان از این نامها در شرایط نرم برای بیان زبانی آنها استفاده کرد.
تعریف ۴٫
رابطه فازی دو جهان را در نظر بگیرید U1و U2. یک رابطه فازی R در U1و U2، به عنوان … تعریف شده است آر:U1×U2→[۰،۱]. آر(ایکس۱،ایکس۲)∈[۰،۱]، با ایکس۱∈U1و ایکس۲∈U2، درجه عضویت رابطه بین است ایکس۱و ایکس۲; معنای رابطه از نظر زبانی با نام رابطه بیان می شود.
از طریق مفهوم رابطه فازی، می توان قدرت یک رابطه بین دو مورد را مدل کرد ایکس۱∈U1و ایکس۲∈U2. با این وجود، توجه کنید که یک رابطه فازی یک مورد خاص از مجموعه فازی در جهان است U=U1×U2. بنابراین، ما می توانیم رابطه را به صورت مجدد فرموله کنیم آر:U→[۰،۱]، جایی که ایکس=〈ایکس۱،ایکس۲〉∈U; در نتیجه، میتوانیم به روشی معادل بنویسیم آر(ایکس۱،ایکس۲)یا آر(〈ایکس۱،ایکس۲〉).
در این مقاله، ما روی جهان اسناد JSON کار می کنیم. بنابراین، یک سند داده شده است د∈Uتمرکز بر ارزیابی درجات عضویت آن در یک یا چند مجموعه فازی خواهد بود.
۴٫ چارچوب J-CO
چارچوب J-CO مجموعهای از ابزارهای نرمافزاری است که میتوانند مجموعههای داده JSON را به روشی مستقل از منبع داده پردازش کنند. در واقع، میتواند مجموعههای داده را هم از فروشگاههای اسناد JSON (مانند MongoDB ) و هم از منابع وب دریافت کند. در اطراف J-CO-QL ساخته شده است+زبان و شامل ابزارهای مختلفی است که در شکل ۱ نشان داده شده است.
-
J – CO-QL +موتور در واقع J-CO-QL را پردازش می کند+پرس و جوها داده هایی را برای پردازش از فروشگاه های اسناد JSON و از منابع وب به دست می آورد. می تواند نتایج را دوباره در فروشگاه های اسناد JSON ذخیره کند.
-
J-CO-DS یک فروشگاه اسناد JSON ساده شده است [ ۳۷ ]: برای ارائه قابلیت ذخیره اسناد بزرگ تک JSON به کاربران طراحی شده است (معمولاً، فروشگاه های محبوب اسناد JSON قادر به مقابله با اسناد بسیار بزرگ تک JSON نیستند ) . J-CO-DS هیچ قابلیت محاسباتی داخلی ارائه نمی دهد، به عنوان مثال، یک زبان پرس و جو ارائه نمی کند: در واقع، بخشی از چارچوب J-CO است، که در آن جزء ارائه دهنده قابلیت های محاسباتی J-CO- است. QL +موتور .
-
J-CO-UI رابط کاربری چارچوب است. یک رابط گرافیکی برای نوشتن تعاملی J-CO-QL در اختیار کاربران قرار می دهد+پرس و جو به روش گام به گام؛ کاربران همچنین می توانند نتایج میانی را بررسی کنند.
۴٫۱٫ زبان پرس و جو
J-CO-QL +تکامل فعلی J-CO-QL اصلی است (نگاه کنید به [ ۳ ، ۴ ، ۵ ]): به عنوان سلف خود، برای ارائه عبارات سطح بالا و اعلامی طراحی شده است که برای استفاده از آن نیازی به مهارت های برنامه نویسی نیست. با استفاده از آنها، می توان رویه های پیچیده (اسکریپت) را مشخص کرد که قادر به بازیابی، ادغام، تبدیل و ذخیره مجموعه داده های JSON هستند. با توجه به نسل قبلی خود، J-CO-QL +همان رویکرد را حفظ میکند، اما نحو و معنای عبارات را برای بهبود قابلیت استفاده و اثربخشی آنها بازبینی میکند. در ادامه مدل داده و مدل اجرای آن را ارائه می کنیم.
۴٫۱٫۱٫ مدل داده
در اینجا، مدل دادهای را ارائه میکنیم که J-CO-QL بر اساس آن است+متکی است.
-
مورد اساسی برای پردازش یک سند JSON است. یک سند در داخل یک جفت پرانتز ” { ” و ” } ” نمایش داده می شود. دنباله ای از فیلدهایی است که با کاما از هم جدا شده اند.یک فیلد یک جفت “name: value” است که “name” نام فیلد است، در حالی که “value” مقدار فیلد است. نام همیشه درون گیومه های دوتایی محصور می شود (به عنوان مثال، "نام" ). مقدار می تواند یک عدد، یک رشته (محصور در داخل گیومه های دوتایی یا تک کوتیشن)، یک مقدار بولی، یک سند فرعی تو در تو (محصور در یک جفت پرانتز ” { ” و ” } “) یا یک آرایه (محصور در داخل) باشد. براکت های مربع ” [ ” و ” ] “، که آیتم های آن می تواند هر نوع مقدار JSON باشد که با کاما از هم جدا شده اند.
-
J-CO-QL +به فیلدهای سطح ریشه که نام آنها با " ~ ” می شود، معنای خاصی می دهد . این نامها با قوانین نامگذاری JSON مطابقت دارند، اما J-CO-QL +برخی از آنها را به گونه ای خاص مورد توجه قرار می دهد که در ادامه نشان داده می شود.
- –
-
فیلد ~ fuzzysets در سطح ریشه برای نشان دادن درجات عضویت یک سند d به مجموعه های فازی استفاده می شود. این به عنوان یک نقشه “کلید-مقدار” کار می کند: با توجه به یک فیلد در ~ fuzzysets ، نام فیلد نام مجموعه فازی است که درجه عضویت به آن ارزیابی شده است. مقدار یک عدد واقعی در محدوده است [۰،۱]، که نشان دهنده درجه عضویت است. به این ترتیب، با توجه به یک سند d ، می توان عضویت آن را در بسیاری از مجموعه های فازی نشان داد.
- –
-
فیلد ~ geometry در سطح ریشه هندسههایی را نشان میدهد (که “برچسبگذاری جغرافیایی” نیز نامیده میشود) موجودیتهای فضایی که به عنوان اسناد JSON نشان داده میشوند. در این مقاله، ما از هندسه استفاده نمی کنیم (خواننده علاقه مند می تواند به [ ۵ ] مراجعه کند).
-
“مجموعه” مجموعه ای نامرتب از اسناد ناهمگن است، به عنوان مثال، می تواند حاوی چندین نسخه از یک سند باشد.
۴٫۱٫۲٫ مدل اجرا
مدل اجرا همان است که در انتشارات قبلی [ ۵ ، ۷ ] ارائه شده است. در ادامه به اختصار به بیان آن می پردازیم.
-
یک “پرس و جو” q=(من۱،من۲،⋯،منn)دنباله ای از دستورالعمل ها است منj، با ۱≤j≤n. پرس و جو یک “لوله دستورالعمل” است.
-
هر دستورالعمل منjیک ورودی “وضعیت فرآیند پرس و جو” را دریافت می کند سj-1و یک حالت فرآیند پرس و جو جدید ایجاد می کند سj.
-
یک “وضعیت فرآیند پرس و جو” سj(با ۰≤j≤n) یک تاپلی است سj=〈تیج،منآر،Dباس،افO،جیاساف〉.
- –
-
تیج”مجموعه موقت” نامیده می شود، زیرا مجموعه ای از اسناد JSON است که از لوله دستورالعمل ها عبور می کند و حاوی نتایج موقت فرآیند پرس و جو است.
- –
-
منآر”پایگاه داده نتایج میانی” است، یعنی پایگاه داده ای است که برای فرآیند پرس و جو انحصاری است تا نتایج میانی را ذخیره کند تا بعدا مورد استفاده قرار گیرند.
- –
-
Dباسمجموعهای از «توصیفگرهای پایگاه داده» است که برای رسیدگی به اتصالات با ذخیرهسازی اسناد JSON خارجی استفاده میشود.
- –
-
افOمجموعه ای از “عملگرهای فازی” است که در پرس و جو تعریف شده است. آنها امکان ارزیابی درجه عضویت در مجموعه های فازی را فراهم می کنند (به بخش ۶٫۲ مراجعه کنید ).
- –
-
جیاسافمجموعه ای از “توابع جاوا اسکریپت” تعریف شده توسط کاربر است. آنها در سراسر پرس و جو برای تکمیل قابلیت های محاسباتی زبان پرس و جو تعریف می شوند (به [ ۳۸ ] مراجعه کنید).
-
حالت فرآیند پرس و جو اولیه است س۰=〈تیج:∅،منآر:∅،Dباس:∅،افO:∅،جیاساف:∅〉. هر دستورالعمل احتمالاً یک عضو از حالت query-process را تغییر می دهد.
۵٫ مسئله و روش
در این بخش، مقدماتی را که مقاله از آن سرچشمه گرفته است، مورد بحث قرار می دهیم و مشکلی را که به عنوان مطالعه موردی به آن پرداختیم، معرفی می کنیم ( بخش ۵٫۱ ). سپس، چارچوب روششناختی را ارائه میکنیم که این کار بر آن تکیه دارد ( بخش ۵٫۲ ).
۵٫۱٫ مقدمات و مشکل
در [ ۶ ]، یک روش فازی برای تجمیع آنلاین POI (نقاط مورد علاقه) ارائه شده است. مشکلی که در آن مقاله به آن پرداخته میشود اینطور خلاصه میشود: اگر یک برنامه وب باید توصیفگرهای مکانهای عمومی (یا POI) را که در حال پرواز از سرویسهای خارجی گرفته میشوند یکپارچه کند، تصمیمگیری در مورد اینکه آیا دو توصیفگر واقعاً یک مکان عمومی را توصیف میکنند یا خیر، باید اتخاذ شود. گرفته شده در زمان واقعی: تکنیک هایی که نیاز به کار آفلاین دارند را نمی توان استفاده کرد.
در [ ۶ ]، ثابت شد که این تکنیک می تواند سطوح بسیار بالایی از دقت را به دست آورد که کاملاً قابل مقایسه با تکنیک های آفلاین است. در نتیجه، در اینجا، ما استدلال میکنیم که همان تکنیک را میتوان به طور موثر برای ادغام دو مجموعه داده که مکانهای عمومی را توصیف میکنند، به روش آفلاین به کار برد. به طور خاص، پشتیبانی جدید برای پرس و جوی نرم [ ۷ ] توسط J-CO-QL ارائه شده است+(زبان جستجوی چارچوب J-CO ) سناریو را اصلاح کرده است: در واقع، چارچوب J-CO یک ابزار مستقل است که برای دستکاری و پرس و جو مجموعه های مجموعه داده های JSON طراحی شده است. در نتیجه، بررسی امکان بهرهبرداری از آن برای استفاده از تکنیک فازی ارائهشده در [ ۶ ] برای ادغام دو مجموعه توصیفگر مکانهای عمومی که از دو منبع مختلف میآیند، با اتخاذ رویکرد پایگاه داده (پرسش دادهها با استفاده از یک پرس و جو) ساده است. زبان) به جای کدنویسی سخت متدولوژی با زبان برنامه نویسی.
از این به بعد مشکل را مطرح می کنیم. سپس، بخش ۵٫۲ فرمول بهبود یافته ای از تکنیک فازی ارائه شده در [ ۶ ] را ارائه می دهد که در J-CO-QL اعمال خواهد شد.+اسکریپت ها (مورد بحث در بخش ۶ ).
مشکل ۱٫
دو مجموعه توصیفگر را در نظر بگیرید D1و D2. یک توصیفگر d (به این صورت که یا د∈D1یا د∈D2) یک مکان عمومی را توصیف می کند. ما فرض می کنیم که d یک تاپل است که شکل حداقل آن است د=〈nآمتره،آددrهسس،لآتی،لon〉، جایی که د.nآمترهنام مکان عمومی است، د.آددrهسسآدرس خام (یعنی همانطور که توسط منبع داده ارائه شده است، بدون هیچ گونه پیش پردازش یا تمیز کردن) مکان عمومی است، در حالی که د.لآتیو د.لonبه ترتیب طول و عرض جغرافیایی مکان عمومی هستند. بسته به منبع، این فیلدها ممکن است از دست رفته باشند (یا مقدار تهی یا رشته با طول صفر).
با فرض اینکه توصیفگرها در D1و D2مربوط به همین شهرداری هستند، می خواهیم مجموعه را بسازیم اسپ={پ۱،پ۲،⋯}جفت توصیفگر پمن:〈د۱،ساعت،د۲،ک〉(با د۱،ساعت∈D1و د۲،ک∈D2) به گونه ای که احتمال آن بسیار زیاد است د۱،ساعتو د۲،کدر واقع همان مکان عمومی را توصیف می کند.
۵٫۲٫ رابطه فازی برای تطبیق مکان های عمومی
سهم کلیدی [ ۶ ] یک رابطه فازی است که نامیده می شود مآتیجساعتمنngپلآجهس. با توجه به دو توصیف کننده د۱و د۲، به صورت نوشته می شود مآتیجساعتمنngپلآجهس(د۱،د۲). درجه عضویت آن نشان دهنده این امکان است د۱و د۲همان مکان را توصیف کنید اگر جهان هستی را در نظر بگیریم پ=D1×D2از جفت پمن:〈د۱،ساعت،د۲،ک〉، از طریق مآتیجساعتمنngپلآجهسرابطه فازی می خواهیم مجموعه فازی را بسازیم پآرپدر P از جفتهای احتمالاً مرتبط که درجه عضویت برای آنها پمناست پآرپ(پمن)>0.
برای اینکه واقعاً تصمیم بگیرد که آیا توصیفگرها در a پمنجفت در واقع همان مکان عمومی، حداقل آستانه را توصیف می کند α∈[۰،۱]برای تمرکز روی Relevant Pairs استفاده می شود آرپ⊆پآرپ، جایی که آرپ(پمن)≥α.
با این حال، با توجه به یک توصیفگر د۱،ساعت∈D1، می تواند چندین بار در آن ظاهر شود آرپ، زیرا ممکن است جفت های مرتبط زیادی وجود داشته باشد که در آن دخیل است. برای هر د۱،ساعت∈D1، زیر مجموعه آرپ¯۱،ساعت⊆آرپمجموعه ای از جفت است پمن∈آرپبه طوری که پ۱٫د۱=د۱،ساعت; اگر آرپ¯۱،ساعتخالی نیست، جفت پ۱،ساعت∈آرپ¯۱،ساعتبه طوری که آرپ¯۱،ساعت(پ۱،ساعت)≥آرپ¯۱،ساعت(پمن)، برای همه پمن∈آرپ¯۱،ساعت، ظاهر می شود اسپ(زیرا دو توصیفگر جفت شده در واقع قرار است یک مکان را توصیف کنند).
در ادامه این بخش، چارچوب رسمی کامل را معرفی می کنیم.
۵٫۲٫۱٫ توابع و روابط اساسی
را مآتیجساعتمنngپلآجهسرابطه فازی با استفاده از برخی توابع اساسی و روابط فازی تعریف می شود.
با توجه به دو جفت مختصات، به عنوان مثال، لآتی۱،لon1و لآتی۲،لon2(نشان دهنده طول و عرض جغرافیایی دو نقطه در کره زمین)، Dمنستیآnجهتابع “فاصله ژئودزیکی” [ ۳۹ ] بین دو نقطه را بر حسب کیلومتر محاسبه می کند. به عنوان مشخص می شود Dمنستیآnجه(لآتی۱،لon1،لآتی۲،لon2). بر این اساس، می توان به تعریف سیلoسهتابع عضویت که با توجه به فاصله دمنستی(در کیلومتر) تعیین می کند که آیا فاصله نشان دهنده نزدیکی دو نقطه است یا خیر. به عنوان نشان داده می شود سیلoسه(دمنستی); نمونه ای از یک تابع عضویت معمولی برای این مفهوم (همان مورد بهره برداری در [ ۶ ]) در شکل ۲ نشان داده شده است : توجه داشته باشید که بر اساس فاصله ژئودزیکی بین دو نقطه، درجه عضویت ۱ است زمانی که فاصله بین دو نقطه باشد. ۰ و ۵۰ متر؛ سپس به صورت خطی از ۵۰ تا ۱۰۰۰ متر کاهش می یابد. در بخش ۶٫۲ ، تابع عضویت پیچیده تری را تعریف خواهیم کرد.
را سیلoسهتابع عضویت می تواند به عنوان مبنایی برای تعریف استفاده شود سیلoسهپلآجهسرابطه فازی: با توجه به دو توصیف مکان د۱و د۲، سیلoسهپلآجهس(د۱،د۲)=سیلoسه(Dمنستیآnجه (د۱٫لآتی،د۱٫لon،د۲٫لآتی،د۲٫لon)).
با توجه به دو رشته س۱و س۲، اسمنمترمنلآrرابطه فازی به صورت نشان داده می شود اسمنمترمنلآr(س۱،س۲). به عنوان تابع عضویت، هر متریک تشابه رشتهای که مقدار آن در محدوده باشد [۰،۱]می تواند استفاده شود؛ در [ ۶ ]، از متریک شباهت جارو-وینکلر [ ۴۰ ، ۴۱ ، ۴۲ ، ۴۳ ] استفاده شد. در اینجا، ما هنوز از آن استفاده می کنیم، اما به روشی پیچیده تر (به بخش ۶٫۲ مراجعه کنید ).
بر مبنای اسمنمترمنلآrرابطه ای که بر روی جهان رشته ها تعریف می شود، می توان دو رابطه مشتق شده را که بر روی جهان جفت های توصیفگر تعریف می شوند، تعریف کرد. پ=D1×D2.
را اسمنمترمنلآrآددrهسسرابطه فازی نشان دهنده میزانی است که آددrهسسفیلدهای دو توصیفگر مشابه هستند. به عنوان تعریف شده است اسمنمترمنلآrآددrهسس(د۱،د۲)=اسمنمترمنلآr(د۱٫آددrهسس، د۲٫آددrهسس).
را اسمنمترمنلآrنآمترهرابطه فازی نشان دهنده میزانی است که nآمترهفیلدهای دو توصیفگر مشابه هستند. به عنوان تعریف شده است اسمنمترمنلآrنآمتره(د۱،د۲)=اسمنمترمنلآr(د۱٫nآمتره،د۲٫nآمتره).
۵٫۲٫۲٫ رابطه SameLocation _
را مآتیجساعتمنngپلآجهسرابطه با ارزیابی قبلی بدست می آید اسآمترهLoجآتیمنonرابطه فازی به عنوان مشخص می شود اسآمترهLoجآتیمنon(د۱،د۲). تابع عضویت آن بسته به این واقعیت که فیلدهای مربوط به جنبه های جغرافیایی (یعنی آدرس و مختصات) در د۱و د۲مفقود هستند یا نه از این پس، ما سه تعریف مختلف از آن ارائه می دهیم اسآمترهLoجآتیمنonرابطه، برای هر مورد فرعی که باید به آن رسیدگی شود.
-
مورد الف: آدرس(های) گم شده است. اگر د۱٫آددrهسسگم شده است، یا د۲٫آددrهسسوجود ندارد یا هر دو، اما دو جفت مختصات موجود هستند، فقط از این دومی می توان برای ارزیابی اسآمترهLoجآتیمنonرابطه
-
مورد B: مختصات (های) گم شده است. هنگامی که یک یا چند مختصات در د۱و د۲گم شده اند، اما هر دو آدرس د۱٫آددrهسسو د۲٫آددrهسسدر دسترس هستند، فقط از این موارد اخیر می توان برای ارزیابی استفاده کرد اسآمترهLoجآتیمنonرابطه
-
مورد ج: آدرس ها و مختصات همه موجود است. زمانی که در د۱و د۲همه زمینه های جغرافیایی (یعنی آدرس و مختصات) در دسترس هستند، همه آنها به ارزیابی کمک می کنند اسآمترهLoجآتیمنonرابطه
هنگامی که سه مورد مورد علاقه شناسایی شد، می توان آن را تعریف کرد اسآمترهLoجآتیمنonرابطه
تعریف ۵٫
مورد A. با توجه به دو توصیف کننده د۱و د۲، که برای آن یا د۱٫آددrهسسیا د۲٫آددrهسسیا هر دو گم شده اند، در حالی که لآتیو لonفیلدها در هر دو تهی نیستند د۱و د۲، اسآمترهLoجآتیمنonرابطه به صورت زیر تعریف می شود:
اسآمترهLoجآتیمنon(د۱،د۲)=سیلoسهپلآجهس(د۱،د۲)
به عنوان مثال، درجه عضویت در اسآمترهLoجآتیمنonرابطه منطبق با درجه عضویت در سیلoسهپلآجهسرابطه
تعریف ۶٫
مورد B. با توجه به دو توصیف کننده د۱و د۲که حداقل یکی از آنها د۱٫لآتی، د۱٫لon، د۲٫لآتیو د۲٫لonپوچ است، در حالی که هر دو د۱٫آددrهسسو د۲٫آددrهسسدر دسترس هستند، اسآمترهLoجآتیمنonرابطه به صورت زیر تعریف می شود:
اسآمترهLoجآتیمنon(د۱،د۲)=اسمنمترمنلآrآددrهسس(د۱،د۲)
به عنوان مثال، درجه عضویت در اسآمترهLoجآتیمنonرابطه منطبق با درجه عضویت در اسمنمترمنلآrآددrهسسرابطه
تعریف ۷٫
مورد ج. با توجه به دو توصیف کننده د۱و د۲، که برای آن تمام زمینه ها د۱٫آددrهسس، د۱٫لآتی، د۱٫لon، د۲٫آددrهسس، د۲٫لآتیو د۲٫لonدر دسترس هستند، اسآمترهLoجآتیمنonرابطه به صورت زیر تعریف می شود:
اسآمترهLoجآتیمنon(د۱،د۲)=wآgβgهo(اسمنمترمنلآrآددrهسس(د۱،د۲)،سیلoسهپلآجهس(د۱،د۲))
به عنوان مثال، درجه عضویت در اسآمترهLoجآتیمنonرابطه تجمع وزنی است اسمنمترمنلآr آددrهسسرابطه و از سیلoسهپلآجهسرابطه βgهo∈[۰،۱]وزن عبارت اول (شباهت بین آدرس ها) است.
در بخش ۶٫۳ ، ما استفاده می کنیم βgهo=0.55: به این ترتیب شباهت بین آدرس ها کمی بر نزدیکی غالب می شود. در واقع، اگر دو آدرس بسیار مشابه باشند، شباهت آنها بیشتر از مختصات است. به این ترتیب، اثر مختصات اشتباهی که باعث ایجاد فواصل زیاد می شود، کاهش می یابد.
۵٫۲٫۳٫ ارتباط جهانی با مکانها
در این مرحله میتوانیم جهانی را تعریف کنیم مآتیجساعتمنngپلآجهسرابطه
تعریف ۸٫
با توجه به دو توصیف کننده د۱و د۲، که برای هر دو زمینه د۱٫nآمترهو د۲٫nآمترهدر دسترس هستند، و برای آنها اسآمترهLoجآتیمنonرابطه تعریف شده است و اسآمترهLoجآتیمنon(د۱،د۲)≥αgهo(با αgهo∈[۰،۱])، مآتیجساعتمنngپلآجهسرابطه به صورت زیر تعریف می شود:
مآتیجساعتمنngپلآجهس(د۱،د۲)=wآgβnآمتره(اسمنمترمنلآrنآمتره(د۱،د۲)،اسآمترهLoجآتیمنon(د۱،د۲))
به عنوان مثال، درجه عضویت در مآتیجساعتمنngپلآجهسرابطه با تجمیع درجات عضویت به دست می آید اسمنمترمنلآrنآمترهرابطه و از اسآمترهLoجآتیمنonرابطه، با استفاده از جمع کننده وزنی با وزن βnآمترهبرای تشابه نام ها
در بخش ۶٫۴ تنظیم کردیم βnآمتره=۰٫۶: به این ترتیب شباهت بین نام ها بر درجه عضویت غلبه دارد اسآمترهLoجآتیمنonرابطه دلیل منطقی به شرح زیر است: با توجه به دو نام مشابه، آنها فقط برای آن مشارکت دارند ۶۰%; باقیمانده ۴۰%توسط سهم جغرافیایی داده می شود. با این حال، برای اجتناب از دو توصیفگر که سهم جغرافیایی آنها قابل توجه نیست، αgهoآستانه معرفی می شود: در صورتی که درجه عضویت از اسآمترهLoجآتیمنonرابطه فازی کمتر از αgهo، د۱و د۲دیگر برای یک مکان واجد شرایط در نظر گرفته نمیشوند: دو مکان میتوانند نامهای بسیار مشابهی داشته باشند (حتی یکسان – دو رستوران از یک زنجیره را تصور کنید)، اما اگر شک وجود داشته باشد که به طور منطقی نزدیک هستند، ممکن است جفت اشتباهی باشند. در بخش ۶٫۳ ، ما این آستانه را به عنوان تعیین می کنیم αgهo=0.4.
درجه عضویت در مآتیجساعتمنngپلآجهسرابطه فازی برای تعیین اینکه آیا یک جفت واقعاً به آن تعلق دارد یا خیر استفاده می شود آرپمجموعه ای از جفت های مربوطه، به عنوان مثال، آرپ(پمن)≥αبه معنای مآتیجساعتمنngپلآجهس (پ۱٫د۱،پ۱٫د۲)≥α. در بخش ۶٫۴ ، ما این آستانه را به عنوان تعیین می کنیم α=۰٫۸، زیرا در آزمایشات ما (به بخش ۷٫۱ مراجعه کنید )، دریافتیم که این آستانه ای است که بهترین اثربخشی را می دهد.
۶٫ ارائه اسکریپت
در این بخش، سهم فنی مقاله را ارائه می دهیم. به طور خاص، ما نشان می دهیم که چگونه نسخه فعلی J-CO-QL +قادر به ادغام نرم دو مجموعه حاوی اسناد JSON است که مکان های عمومی را که از دو منبع داده مختلف به دست آمده اند، توصیف می کند.
۶٫۱٫ مجموعه داده ها
یک پایگاه داده MongoDB به نام ijgiDb شامل دو مجموعه از اسناد JSON است: اولین مورد به نام FacebookDescriptors و اسناد آن توصیفگر صفحاتی هستند که مکان های عمومی را که عمدتاً در منطقه منچستر (بریتانیا) واقع شده اند، نشان می دهند. مجموعه دوم GoogleDescriptors نام دارد و اسناد آن توصیف مکان هایی است که بیشتر در منطقه منچستر (بریتانیا) واقع شده اند که از Google Places به دست آمده است . مجموعه FacebookDescriptors شامل ۵۷۳۸ سند است، در حالی که مجموعه GoogleDesciptors شامل ۵۲۱۴ سند است. شکل ۳ توصیفگرهای الف یک سند نمونه را نشان می دهدفیس بوکمجموعه، در حالی که شکل ۳ ب یک سند نمونه را در مجموعه GoogleDescriptors گزارش می دهد . خواننده می تواند متوجه شود که توصیفگرهای فیس بوک به وضوح آدرس (در قسمت fbStreet ) را از نام شهر (در قسمت fbCity ) از کد پستی (در قسمت fbZip ) متمایز می کند. در مقابل، در یک توصیفگر Google Places ، محتوای فیلد gAddress کمتر تمیز است، زیرا حاوی نام شهر نیز می باشد. این همچنین نشان میدهد که ما روی نامها و آدرسهایی کار میکنیم که توسط فیسبوک ارائه میشوند و Google Places ارائه شدهاند کار میکنیم، بدون هیچ گونه پیش پردازش یا تمیز کردن (در [ ۶ ]، آدرس ها از اعداد و نامگذاری های شهری، مانند “خیابان” پاک شدند). در نتیجه، در اینجا، ما به یک وضعیت نه چندان مطلوب می پردازیم.
۶٫۲٫ تعریف عملگرهای فازی
ما شروع به ارائه J-CO-QL می کنیم+اسکریپت قسمت اول اسکریپت در فهرست ۱ گزارش شده است.
مفهوم کلیدی ارائه شده توسط J-CO-QL +برای ارزیابی درجه عضویت اسناد JSON مفهوم “اپراتور فازی” است. چنین اپراتور در شرایط نرم فراخوانی می شود: با توجه به برخی پارامترهای واقعی (عبارات بر اساس فیلدهای سند)، اپراتور درجه عضویت را برمی گرداند. این درجه برای ارزیابی درجه عضویت کلی یک سند در یک مجموعه فازی خاص استفاده خواهد شد.
فهرست ۱٫ J-CO-QL +اسکریپت: عملگرهای فازی
۶٫۲٫۱٫ اپراتور فازی نزدیک
دستورالعمل خط ۱ J-CO-QL +اسکریپت در فهرست ۱ عملگر فازی Close را تعریف می کند : درجه نزدیکی دو مکان را بر اساس فاصله بین آنها ارزیابی می کند. در ادامه این دستورالعمل را با جزئیات شرح می دهیم.
-
بند PARAMETERS پارامترهای رسمی اپراتور را تعریف می کند. به طور خاص، فقط پارامتر فاصله تعریف شده است.
-
بند PRECONDITION یک شرط را روی پارامترها تعریف می کند: اگر شرط برآورده نشود، ارزیابی عملگر فازی متوقف می شود و یک سیگنال خطا بلند می شود. به طور خاص، پیش شرط می گوید که فاصله نباید کمتر از ۰ باشد.
-
عبارت EVALUATE یک عبارت ریاضی روی پارامترها را مشخص می کند که مقدار آن به عنوان مختصات محور x در برابر تابع عضویت تعریف شده توسط عبارت POLYLINE بعدی استفاده می شود. در عملگر فازی Close ، عبارت به سادگی مقدار پارامتر فاصله را می گیرد.
-
بند POLYLINE تابع عضویت را مشخص می کند که در واقع برای محاسبه مقدار عضویت استفاده می شود. تابع به عنوان چند خط، با دنباله ای از جفت ها تعریف می شود (ایکسمن،yمن)، جایی که ایکسمنمی تواند هر ارزش واقعی باشد، در حالی که yمن∈[۰،۱]; با توجه به دو امتیاز متوالی (ایکسمن،yمن)و (ایکسمن+۱،yمن+۱)، باید اینگونه باشد ایکسمن<ایکسمن+۱٫ هر جفت نقطه متوالی یک بخش را تعریف می کند. با توجه به مقدار x ، اگر بین باشد ایکس۱و ایکسn(در مورد n امتیاز)، مقدار y مربوطه به عنوان درجه عضویت در نظر گرفته می شود. اگر ایکس<ایکس۱، مدرک عضویت می باشد y1; اگر ایکس>ایکسn، مدرک عضویت می باشد yn.
شکل ۴ a چند خط تعریف شده برای عملگر فازی Close را گزارش می کند. توجه داشته باشید که در [ ۶ ] یکسان نیست (در شکل ۲ گزارش شده است ): در واقع، ما تابعی را انتخاب کردیم که فوراً فواصل بین ۵۰ متر و ۶۰۰ متر را جریمه می کند، زیرا دو مکان در یک محله درک نمی شوند. زمانی که فاصله آنها از ۱۰۰ متر بیشتر شود بسیار نزدیک است.
۶٫۲٫۲٫ اپراتور فازی مشابه
دستورالعمل خط ۲ J-CO-QL +اسکریپت در لیست ۱ عملگر فازی مشابه را ایجاد می کند. هدف آن ارزیابی درجه عضویت بر اساس درجه تشابه دو رشته است. اپراتور در ادامه به تفصیل توضیح داده می شود.
-
اپراتور دو پارامتر به نام های st1 و st2 را دریافت می کند . آنها دو رشته برای مقایسه هستند.
-
هیچ پیش شرطی مشخص نشده است: در مورد رشته های خالی یا پوچ، عملگر ۰ را به عنوان درجه عضویت برمی گرداند، زیرا درجه شباهت ۰ است.
-
عبارت EVALUATE داخلی (یعنی ارائه شده توسط J-CO-QL) را فراخوانی می کند+) تابعی با نام JARO_WINKLER_SIMILARITY ، برای به دست آوردن درجه تشابه دو رشته. درجه تشابه یک مقدار در محدوده است [۰،۱]. در مورد رشته های با طول تهی یا صفر، درجه شباهت برگشتی ۰ است.
-
بند POLYLINE تابع عضویت نشان داده شده در شکل ۴ ب را تعریف می کند. توجه داشته باشید که درجات تشابه کمتر از را جریمه می کند ۰٫۷، در حالی که درجات عضویت بیشتر از ۰٫۸پاداش می گیرند: این به دلیل رفتار گاه عجیب شباهت جارو-وینکلر است، که درجات شباهت بالایی را حتی زمانی که رشته ها فقط برخی از کاراکترها را به اشتراک می گذارند، بازمی گرداند، اما در واقع مشابه نیستند. علاوه بر این، برای رشته هایی مانند « اسب خاکستری » و « اسب خاکستری »، درجه شباهت تقریباً وجود دارد. ۰٫۷، اگرچه به وضوح باید آنها را بسیار مشابه در نظر گرفت. با این شکل، سعی می کنیم رفتار شباهت جارو-وینکلر را جبران کنیم تا با آدرس ها و نام های خام (یعنی پاک نشده از مقالات، اعداد، علائم نگارشی و غیره) برخورد کنیم.
۶٫۲٫۳٫ عملگر فازی WeightedAggregationBeta
دستورالعمل خط ۳ J-CO-QL +اسکریپت در لیست ۱ سومین عملگر فازی را تعریف می کند. این WeightedAggregationBeta نامیده می شود و هدف آن انجام “تجمیع وزنی” است. wآgβ(به تعریف ۳ مراجعه کنید). در واقع J-CO-QL +چنین اپراتور را به زبان خود ارائه نمی دهد. از طریق عملگر فازی WeightedAggregationBeta ، نحوه معرفی مفاهیم فازی جدید را نشان می دهیم. عملگر فازی در ادامه به تفصیل توضیح داده می شود.
-
اپراتور سه پارامتر دریافت می کند: f1 و f2 دو مقدار در محدوده هستند [۰،۱]برای تجمیع، در حالی که بتا وزن تجمع است (در محدوده [۰،۱]بیش از حد) از f1 با توجه به f2 .
-
بند PRECONDITION تضمین می کند که مقادیر واقعی سه پارامتر در محدوده قرار دارند [۰،۱](به گزاره IN_RANGE توجه کنید ).
-
عبارت EVALUATE در واقع تجمیع وزنی را انجام می دهد.
-
بند POLYLINE یک تابع عضویت بسیار ساده را تعریف می کند که در شکل ۴ ج گزارش شده است: این یک بخش مستقیم از نقطه است. (۰،۰)به نقطه (۱،۱); به این ترتیب، مقدار محاسبه شده توسط عبارت EVALUATE ، همانطور که هست، به عنوان درجه عضویت برگردانده می شود.
۶٫۳٫ بازیابی و جفت کردن توصیفگرها
هنگامی که سه عملگر فازی تعریف شدند، زمان شروع کار بر روی مجموعه داده است. این توسط بخش دوم J-CO-QL انجام می شود+اسکریپت، که در فهرست ۲ گزارش شده است.
فهرست ۲٫ J-CO-QL +اسکریپت: بازیابی و پیوستن به مجموعه ها.
دستورالعمل خط ۴ فرآیند پرس و جو را به پایگاه داده متصل می کند. پس از این دستورالعمل، دسترسی به پایگاه داده ijgiDb برای بازیابی و ذخیره مجموعه ها امکان پذیر خواهد بود .
دستورالعمل JOIN OF COLLECTIONS در خط ۵، دو مجموعه منبع (به نامهای FacebookDescriptors و GoogleDescriptors ) را بازیابی میکند و تمام جفتهای ممکن اسناد موجود در دو مجموعه را ایجاد میکند. سپس، بند CASE بعدی مجموعهای از شرایط را در این جفتها ارزیابی میکند تا احتمالاً مجموعههای فازی را روی جفتهای واقعاً جالب ارزیابی کند و بقیه را کنار بگذارد. این دستورالعمل در ادامه به تفصیل توضیح داده می شود.
-
این دستورالعمل مجموعه FacebookDescriptors را از پایگاه داده ijgiDb بازیابی می کند و آن را با نام مستعار f ; به طور مشابه، مجموعه GoogleDescriptors را از همان پایگاه داده بازیابی می کند و آن را با نام مستعار g .برای هر سند f از مجموعه f و برای هر سند g از مجموعه g ، یک سند d جدید ایجاد می شود. این سند شامل دو فیلد است: اولین فیلد f نامیده می شود و مقدار آن سند منبع f است. مورد دوم g نامیده می شود و مقدار آن منبع g سند است. سند d توسط بند بعدی CASE پردازش می شود.شکل ۵ نمونه ای از سند d را گزارش می کند که با پیوستن به دو سند نمونه گزارش شده در شکل ۳ به دست می آید . به نام فیلدهای سطح ریشه توجه کنید.
-
بند CASE مجموعه ای از شرایط انتخاب بیان شده در یک بند WHERE را ارزیابی می کند. اگر یک سند d با یک شرط انتخاب شده باشد، طبق زیرشاخه های بعدی پردازش می شود. بسیاری از شاخه های WHERE امکان پذیر است: یک سند d توسط شعبه مرتبط با اولین شرط WHERE که برآورده می شود پردازش می شود. اگر هیچ شرطی برآورده نشد، d کنار گذاشته می شود (در مجموعه موقت خروجی ظاهر نمی شود).به طور خاص، بند CASE در دستورالعمل خط ۵ در فهرست ۲ شامل سه شاخه WHERE است: هر یک از آنها با یکی از سه وضعیت در نظر گرفته شده برای تعریف اسآمترهLoجآتیمنonرابطه با تعاریف ۵-۷٫ در ادامه به طور جداگانه به رفتار سه شاخه می پردازیم.
- –
-
اولین شعبه WHERE به مورد الف می پردازداسآمترهLoجآتیمنonرابطه فازی، که در تعریف ۵ تعریف شده است. اگر مقدار فیلد fbStreet وجود نداشته باشد یا مقدار فیلد gAddress وجود نداشته باشد یا هر دو از دست رفته باشند، و همه مختصات در دسترس باشند، شرط درست است. اگر یک سند d شرایط را برآورده کند، بلوک GENERATE d را از طریق عبارت CHECK FOR که هدف آن ارزیابی درجات عضویت d تا مجموعه های فازی است، پردازش می کند.به طور خاص، دو شاخه FUZZY SET وجود دارد: اولی مجموعه فازی ClosePlaces را ارزیابی می کند، دومی مجموعه فازی SameLocation را ارزیابی می کند.درجه عضویت در مجموعه فازی ClosePlaces توسط عبارت USING مرتبط به دست می آید : این یک “شرایط نرم” است که در آن عملگرهای فازی (مانند مواردی که در بخش ۶٫۲ تعریف شده اند ) و نام های مجموعه فازی را می توان با حالت معمول (فازی) تشکیل داد. عملگرهای منطقی AND , OR و NOT . درجه عضویت حاصل، درجه عضویت در مجموعه فازی ارزیابی شده است. اگر این اولین درجه عضویت است که برای d ارزیابی می شود ، d ~ خاص را ندارد .فیلد: در این حالت فیلد اضافه می شود و در داخل آن فقط یک فیلد وجود دارد که همان نام مجموعه فازی ارزیابی شده را دارد که مقدار آن درجه عضویت محاسبه شده است. در مقابل، اگر فیلد مجموعههای فازی از قبل وجود داشته باشد، با یک فیلد داخلی اضافی گسترش مییابد که درجه عضویت را به مجموعه فازی ارزیابیشده جدید توصیف میکند.به طور خاص، شعبه اول درجه عضویت را در مجموعه فازی ClosePlaces با استفاده از عملگر فازی Close (به فهرست ۱ مراجعه کنید) ارزیابی می کند، که به آن عبور فاصله ژئودزیکی محاسبه شده توسط تابع داخلی GEODESIC_DISTANCE گفته می شود.شاخه دوم FUZZY SET درجه عضویت را در مجموعه فازی SameLocation ارزیابی می کند، با این فرض که با مجموعه فازی ClosePlaces مطابقت دارد (به تعریف ۵ مراجعه کنید). در نهایت، بند ALPHACUT سند d را از مجموعه موقت خروجی حذف می کند اگر درجه عضویت آن در مجموعه فازی SameLocation کمتر از۰٫۴; به یاد داشته باشید که این است αgهoآستانه ذکر شده در تعریف ۸٫ شکل ۶ یک سند نمونه تولید شده توسط اولین شعبه WHERE را گزارش می دهد. به وجود میدان ~ fuzzysets و میدان های داخلی آن توجه کنید.
- –
-
شعبه دوم WHERE به مورد B می پردازداسآمترهLoجآتیمنonرابطه (به تعریف ۶ مراجعه کنید)، یعنی حداقل یک مختصات تهی است اما هر دو آدرس موجود هستند.در این مورد (به تعریف ۶ مراجعه کنید)، درجه عضویت در مجموعه فازی SimilarAddress با استفاده از عملگر فازی Similar ، که رابطه شباهت فازی بین دو رشته (در این مورد، دو آدرس) را ارزیابی میکند، ارزیابی میشود.سپس، همانطور که توسط تعریف ۶ تعریف شده است، دومین شاخه FUZZY SET می گوید که مجموعه فازی SameLocation با مجموعه فازی SimilarAddress منطبق است. مجدداً، بند ALPHACUT سند d را در مجموعه موقت خروجی قرار می دهد اگر درجه عضویت در مجموعه فازی SameLocation کمتر از۰٫۴( αgهoآستانه در تعریف ۸). شکل ۶ b یک سند نمونه تولید شده توسط دومین شاخه WHERE را نشان می دهد.
- –
-
سومین شعبه WHERE به مورد C می پردازداسآمترهLoجآتیمنonرابطه فازی (به تعریف ۷ مراجعه کنید)، یعنی هم همه آدرس ها و هم همه مختصات در دسترس هستند. در نتیجه، درجات عضویت در سه مجموعه فازی مختلف ارزیابی میشوند: اولین مورد ، مجموعه فازی SimilarAddress است که با استفاده از عملگر فازی Similar به آدرسها اعمال میشود. مورد دوم مجموعه فازی ClosePlaces است که با استفاده از عملگر فازی Close روی فاصله ژئودزیکی بین دو نقطه اعمال می شود.سومین شاخه FUZZY SET درجه عضویت در مجموعه فازی به نام SameLocation را ارزیابی می کند : طبق تعریف ۷، با فراخوانی عملگر فازی WeightedAggregationBeta که هدف آن انجام تجمع وزنی است، به دست می آید: دو مقدار را دریافت می کند (در محدوده). [۰،۱]) به تجمیع و βوزن.شرط نرم افزار USING عملگر فازی WeightedAggregationBeta را فراخوانی می کند و مقادیر عضویت را به مجموعه فازی SimilarAddress و مجموعه فازی ClosePlaces منتقل می کند که با استفاده از تابع داخلی MEMBERSHIP_OF (که درجه عضویت را از داخل فیلد ~ fuzzysets استخراج می کند) به دست می آید. ). پارامتر سوم مقدار ثابت است ۰٫۵۵: این است βgهoوزن ارائه شده و مورد بحث در تعریف ۷٫ بند ALPHACUT سند ارزیابی شده را در صورتی که درجه عضویت آن در مجموعه فازی SameLocation کمتر از۰٫۴( αgهoآستانه ذکر شده در تعریف ۸).شکل ۶c یک سند نمونه تولید شده توسط شعبه سوم را گزارش می دهد. توجه کنید که فیلد ~ fuzzysets دارای سه میدان داخلی است.
مجموعه موقتی که توسط دستورالعمل خط ۵ فهرست ۲ تهیه شده است، تا آنجا که به ساختار فیلد مجموعه های فازی مربوط می شود، حاوی اسناد ناهمگنی است ، اما همگی دارای فیلد SameLocation داخلی هستند که درجه عضویت را به مجموعه فازی SameLocation نشان می دهد. در دستورالعمل بعدی برای ارزیابی درجه عضویت در مجموعه فازی MatchingPlaces استفاده خواهد شد.
علاوه بر این، توجه داشته باشید که SameLocation ، ClosePlaces و SimilarAddresses “مجموعه های فازی” نامیده می شوند، در حالی که در بخش ۵ به عنوان “روابط فازی” تعریف شده اند: این یک اشتباه نیست، بلکه نتیجه این واقعیت است که اسناد JSON جفت توصیفگر را نشان می دهد. در نتیجه، رابطه فازی روی جفت ها به مجموعه های فازی در اسناد JSON ترجمه می شود.
۶٫۴٫ جفت های مربوطه
تمام اسناد موجود در مجموعه موقت تولید شده توسط دستورالعمل خط ۵ (فهرست ۲) دارای درجه عضویت در مجموعه فازی SameLocation کمتر از αgهo=0.4همانطور که در تعریف ۸ لازم است. دستورالعمل FILTER در خط ۶ در لیست ۳ در واقع درجه عضویت را در مجموعه فازی MatchingPlaces ارزیابی می کند که با مآتیجساعتمنngپلجهسرابطه تعریف شده در تعریف ۸٫ دستورالعمل FILTER در خط ۶ در ادامه به تفصیل شرح داده می شود.
-
دستور FILTER مجموعه موقت را به عنوان ورودی می گیرد و با اعمال یک بند CASE یک مجموعه موقت جدید ایجاد می کند. رفتار این بند مانند عبارت JOIN OF COLLECTIONS است.
-
در خط ۶، فقط یک شاخه WHERE وجود دارد: اگر سندی شرایط انتخاب را نداشته باشد، از مجموعه موقت خروجی حذف می شود.به طور خاص، شرط انتخاب آن اسنادی را انتخاب میکند که هر دو نام را در دو توصیفگر جفتی دارند تا درجه عضویت در مجموعه فازی SimilarName ارزیابی شود.
-
اولین شاخه FUZZY SET در عبارت CHECK FOR درجه عضویت را به مجموعه فازی SimilarName ارزیابی می کند. دوباره، در شرایط نرم افزار USING ، عملگر فازی مشابه (به فهرست ۱ مراجعه کنید) فراخوانی می شود که این بار نام ها را ارسال می کند (به جای آدرس).
-
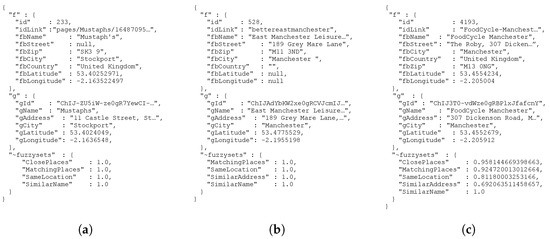
شاخه دوم FUZZY SET در نهایت می تواند درجه عضویت را در مجموعه فازی MatchingPlaces ، مطابق بامآتیجساعتمنngپلآجهسرابطه فازی تعریف شده توسط تعریف ۸٫ به یاد داشته باشید که روابط فازی نامگذاری شده است اسآمترهLoجآتیمنonو اسمنمترمنلآrنآمترهبا استفاده از عملگر تجمع وزنی تجمیع می شوند. در فهرست ۱، عملگر فازی WeightedAggregationBeta را تعریف کردیم که در اینجا برای جمعآوری مجموعه فازی SimilarName و مجموعه فازی SameLocation استفاده میشود. وزن مجموعه فازی SimilarName برای۶۰%درجه عضویت نهایی (این است βnآمترهوزن ذکر شده در تعریف ۸)، به طوری که شباهت بین نام ها به طور متوسط بر شباهت جغرافیایی غلبه دارد (که هدف آن تأیید این است که دو مکان با نام های مشابه یا یکسان در واقع یک مکان هستند). درجه عضویت حاصل به درجه عضویت در مجموعه فازی MatchingPlaces تبدیل می شود.سه سند نمونه گزارش شده در شکل ۶ به شکل گزارش شده در شکل ۷ تبدیل می شوند . به حضور فیلد داخلی MatchingPlaces در فیلد ~ fuzzysets توجه کنید.
-
در این مرحله، فقط جفت های مرتبط باید نگه داشته شوند، یعنی آن جفت هایی که درجه عضویت آنها در مجموعه فازی MatchingPlaces کمتر ازα=۰٫۸٫ بند ALPHACUT این کار را انجام می دهد.
-
بخش BUILD نهایی (که اختیاری است، به همین دلیل است که در دستورالعمل JOIN OF COLLECTIONS در خط ۵ در فهرست ۲ وجود نداشت) همه اسناد باقی مانده را بازسازی می کند.به طور خاص، یک رمان فیلد رتبه جدید اضافه می شود که مقدار آن درجه عضویت در مجموعه فازی MatchingPlaces است. این فیلد ضروری است، زیرا گزینه بعدی DEFUZZIFY فیلد ~ fuzzysets را کنار می گذارد (در نتیجه، اسناد “فازی زدایی” می شوند).شکل ۸ وضعیت نهایی سه سند نمونه گزارش شده در شکل ۷ را گزارش می کند. به وجود فیلد رتبه توجه کنید که مقدار آن درجه عضویت مجموعه فازی MatchingPlaces است.
لیست ۳٫ J-CO-QL +اسکریپت: مکان های تطبیق.
دستورالعمل خط ۷ در فهرست ۳ مجموعه موقت را در پایگاه داده ijgiDb با نام RelevantPairs ذخیره می کند. اسناد آن حاوی امیدوارکننده ترین جفت توصیفگرها هستند (به یاد داشته باشید آرپمجموعه ای که در بخش ۵٫۲ ذکر شده است )، اما ممکن است اتفاق بیفتد که، به عنوان مثال، همان توصیفگر Google Places با بیش از یک مرتبط باشد. توصیفگر فیس بوک مرتبط باشد. واضح است که انتخاب جفتی که بالاترین رتبه را دارد (یعنی ساخت فینال) درست است اسپمجموعه ذکر شده در بخش ۵٫۲ ). این در بخش ۶٫۵ مورد بحث قرار گرفته است .
۶٫۵٫ انتخاب بهترین جفت
آخرین قسمت از J-CO-QL +اسکریپت در فهرست ۴ گزارش شده است. در واقع بهترین جفتهایی را انتخاب میکند که شامل هر توصیفگر Google Places است که توسط خط ۶ در فهرست ۳ به دست آمده است. در واقع، زبان اصلی J-CO-QL (از آن J-CO-QL است. +استخراج می شود) برای مقابله با این نوع کار نیز طراحی شده است (به [ ۳ ، ۴ ] مراجعه کنید). در ادامه این قسمت آخر فیلمنامه را به اختصار شرح می دهیم.
-
دستورالعمل GET COLLECTION در خط ۸ دوباره مجموعه RelevantPairs را از پایگاه داده دریافت می کند و دوباره آن را به مجموعه موقت تبدیل می کند.
-
دستورالعمل GROUP در خط ۹، اسناد را در مجموعه موقت، بر اساس فیلد gId ، که شناسه توصیفگرهای Google Places است ، گروه بندی می کند. برای هر گروه، یک سند جدید در مجموعه خروجی ایجاد می شود، به طوری که دارای فیلد gId و آرایه ای به نام gGroup است که در آن همه اسناد گروه بندی شده گزارش می شوند. این آرایه به ترتیب معکوس مقدار فیلد رتبه در اسناد گروه بندی شده مرتب شده است. شکل ۹ a نمونه ای از سند گروه بندی شده را گزارش می کند.
-
دستورالعمل EXPAND در خط ۱۰ مجدداً همه اسناد گروه بندی شده را باز می کند. برای هر سند خروجی، فیلد gPair به موارد کلی اضافه می شود (به غیر از آرایه توسعه یافته). این فیلد جدید شامل دو فیلد داخلی است: فیلد مورد حاوی سند غیر تودرتو است. فیلد موقعیت نشان دهنده موقعیت اشغال شده توسط آیتم غیر تودرتو در gGroup است آرایهدر نتیجه، مجموعه موقت تولید شده توسط خط ۱۰ حاوی تعداد زیادی سند در مجموعه RankedPairs است، اما اکنون آنها با ترتیب نسبی برای توصیفگرهای Google Places بر اساس فیلد رتبه برچسب گذاری می شوند. شکل ۹ ب نمونه ای از یک سند غیر تودرتو را گزارش می کند.
-
دستورالعمل FILTER در خط ۱۱ در واقع فقط اسنادی را انتخاب می کند که قبلاً در گروه خود مقام اول را داشتند (بر اساس ترتیب معکوس رتبه ، آنها کسانی هستند که بالاترین رتبه را دارند). بخش BUILD دوباره همان ساختار را مانند مجموعه RelevantPairs می سازد. شکل ۹ ج نمونه ای از سند حاصل را گزارش می کند.
-
در نهایت (در خط ۱۲) آخرین مجموعه موقت در پایگاه داده ijgiDb با نام SamePlaces ذخیره می شود که خروجی مورد نظر فرآیند است.
فهرست ۴٫ J-CO-QL +اسکریپت: انتخاب بهترین جفت ها.
۷٫ ارزیابی تجربی
در این بخش، ارزیابی مختصری از نتایجی را که میتوان توسط J-CO-QL به دست آورد، گزارش میکنیم+اسکریپت ما از همان مجموعه دادههای اتخاذ شده در [ ۶ ]، مربوط به شهر منچستر (بریتانیا) بهرهبرداری کردیم. از بخش ۶٫۱ به یاد داشته باشید که مجموعه FacebookDescriptors شامل ۵۷۳۸ توصیفگر است، در حالی که مجموعه GoogleDescriptors شامل ۵۲۱۴ توصیف کننده است. هر دو مجموعه حاوی توضیحاتی درباره انواع مکان های عمومی مختلف مانند رستوران ها، میخانه ها، آرایشگاه ها، دانشگاه ها، پارک ها و غیره هستند.
۷٫۱٫ اثربخشی
به منظور ارزیابی اثربخشی روش، یک تحلیل حساسیت با تغییر مقدار آن انجام دادیم αآستانه از ۰٫۵به ۰٫۹۹٫
ما دوباره از همان مجموعه آزمایشی استفاده کردیم که در کار استفاده شد [ ۶ ]: در مجموع شامل ۴۰۰ جفت بود که از بین موارد انتخاب شده بود. ۵۷۳۸×۵۲۱۴مجموع جفت، توسط یک انسان به عنوان ارزیابی شده است جیooدیا بآد. ما به طور تصادفی ۳۰۰ جفت از ۴۰۰ جفت اولیه را انتخاب کردیم و از هر جفت، ۳۰۰ توصیفگر Google Places و ۳۰۰ توصیفگر فیس بوک را استخراج کردیم . در بین تمام جفت های ممکن، ۱۰۳ جفت به عنوان برچسب گذاری شدند جیooدجفت ها (و بدیهی است که ۱۹۷ باقیمانده به عنوان برچسب گذاری شدند بآد).
سپس، اسکریپت را بر روی این دو مجموعه کاهش یافته توصیفگر اجرا می کنیم. جدول ۱ نتایج آزمایش های ما را گزارش می کند. به طور خاص، ستون اول مقادیر منفرد را برای برش آلفا گزارش می کند α; ستون های دوم و سوم تعداد جفت های مربوطه ذخیره شده توسط خط ۷ J-CO-QL را گزارش می کنند.+اسکریپت (فهرست ۳) در مجموعه RelevantPairs و تعداد جفت هایی که توسط خط ۱۲ اسکریپت (فهرست ۴) تولید شده و به ترتیب در مجموعه SamePlaces ذخیره شده است. ستون های ۴ تا ۷ عدد را گزارش می دهند تیپاز جفت های مثبت واقعی، تعداد تیناز جفت های منفی، تعداد افپاز جفت های مثبت کاذب و تعداد افنبه ترتیب از جفت های منفی کاذب. در نهایت، سه ستون آخر «دقت» (تعریف شده به عنوان تیپ/(تیپ+افپ))، “یادآوری” (تعریف شده به عنوان تیپ/(تیپ+افن)) و “دقت” (تعریف شده به عنوان (تیپ+تین)/(تیپ+تین+افپ+افن))، به ترتیب. این سه مقدار اخیر در شکل ۱۰ نشان داده شده است : محور x مقادیر برش آلفا را گزارش می کند. αپارامتر؛ دقت با خط آبی، یادآوری با خط قرمز و دقت با خط سیاه نشان داده می شود.
با تجزیه و تحلیل جدول ۱ و شکل ۱۰ ، می توان دریافت که بهترین ترکیب از مقادیر برای دقت، یادآوری و دقت به دست آمده است. α=۰٫۸: دقت است ۰٫۹۶۲، یادآوری است ۰٫۹۸۱و دقت است ۰٫۹۸۰٫ در واقع، این مقدار برای αبه نظر می رسد بهترین سازش بین نیاز به حفظ هر چه بیشتر جفت ها و این واقعیت است که آن جفت ها در واقع یک مکان را توصیف می کنند، حتی اگر نام ها، آدرس ها و مختصات متفاوت باشند. خواننده می تواند بیشتر متوجه شود که مقادیر بالاتر از αدقت ۱ را با یادآوری ضعیف ایجاد می کند، در حالی که مقادیر کمتری برای αباعث فراخوانی ۱ با دقت ضعیف می شود. برای نتیجه گیری این تحلیل، توجه کنید که با α=۰٫۸۵، دقت همان است که برای به دست آمده است α=۰٫۸; می توان آن را به عنوان یک انتخاب جایگزین معتبر، با دقت بهتر اما یادآوری کم در نظر گرفت.
بنابراین، می توانیم بیان کنیم که فرمول جدید برای مآتیجساعتمنngپکلآجهسرابطه و توابع عضویت پیچیده اتخاذ شده برای عملگر فازی مشابه و برای عملگر فازی بسته موثر هستند، مشروط بر اینکه α=۰٫۸٫
ما می توانیم نتایج گزارش شده در [ ۶ ] را به عنوان پایه ای برای ارزیابی بیشتر اثربخشی فرمول جدید تکنیک در نظر بگیریم.
به یاد داشته باشید که نسخه ارائه شده در [ ۶ ] (برای تجمیع آنلاین) وظایف پیش پردازشی را روی نام ها و آدرس ها انجام می داد تا آنها را از نام گذاری ها و اعداد شهری پاک کند. در مقابل، نسخه حاضر اینطور نیست. دلیل اصلی این است که انجام چنین پیش پردازش و تمیز کردن در J-CO-QL آسان نیست.+اسکریپت ها با این حال، به نظر می رسد انعطاف پذیری عبارت CREATE FUZZY OPERATOR تا آنجا که امکان تعریف اشکال پیچیده برای توابع عضویت وجود دارد، موثر است. در نتیجه، خط پایه مناسب برای در نظر گرفتن بهترین نتیجه ارائه شده در [ ۶ ] است. در آنجا، مقایسه ای با یک تکنیک یادگیری ماشینی، یعنی طبقه بندی “جنگل تصادفی”، با اعمال آن بر روی همان مجموعه داده انجام شد. نتایج در جدول ۲ گزارش شده است : برای سه تکنیک در نظر گرفته شده، دقت، یادآوری و امتیاز F1 (تعریف شده به صورت ۲×(پrهجمنسمنon×rهجآلل)/(پrهجمنسمنon+rهجآلل)) گزارش می شوند. توجه کنید که در [ ۶ ]، تکنیک پیشنهادی به اندازه طبقهبندیکنندههای جنگل تصادفی مؤثر بود. نسخه فعلی از آنها بهتر عمل می کند، حتی اگر نام ها و آدرس ها نه از قبل پردازش شده باشند و نه پاک شده اند. توجه داشته باشید که نسخه قدیمی تکنیک فازی و تکنیک جنگل تصادفی، که بر روی مجموعه دادههایی که مکانهای عمومی را در منچستر (بریتانیا) توصیف میکنند، اعمال میشوند، اثربخشی یکسانی دارند. به همین دلیل است که [ ۶ ] بیان می کند که این دو تکنیک قابل مقایسه هستند.
در نتیجه، می توان گفت که نسخه فعلی نسخه قدیمی را بهبود می بخشد و برای اجرا به عنوان J-CO-QL مناسب است.+اسکریپت علاوه بر این، همچنان مزیت ارائه شده توسط نسخه قدیمی را در مقایسه با تکنیک های طبقه بندی حفظ می کند، یعنی می توان آن را از ابتدا، بدون دانستن مجموعه داده ها، اعمال کرد. در مقابل، تکنیکهای طبقهبندی یک مرحله آموزشی را در مجموعههای آموزشی که قبلاً برچسبگذاری شدهاند، درخواست میکنند، که یک فعالیت زمانبر و حیاتی است.
۷٫۲٫ درباره زمان اجرا
قبل از پایان این کار، نکاتی را در مورد زمان اجرا گزارش می کنیم.
معمولاً این جنبه در ادبیات مربوط به ادغام مجموعه داده های جغرافیایی در نظر گرفته نمی شود: نویسندگان بر اثربخشی تکنیک های پیشنهادی تمرکز داشتند، اما کارایی را در نظر نمی گرفتند. با این حال، به نظر ما، این یک جنبه ناچیز برای استفاده عملی از تکنیک های یکپارچه سازی، به ویژه با مجموعه داده های بزرگ برای یکپارچه سازی نیست.
در این مقاله، هدف نه ارائه کارآمدترین تکنیک، و نه ارزیابی زمان اجرای انبوهی از تکنیکهای پیشنهاد شده در ادبیات است. در اینجا، هدف این است که هنگام اجرای J-CO-QL، آنچه را که باید انتظار داشت، مشاهده کنید+اسکریپت روی یک مجموعه داده واقعی، مانند مجموعهای که برای آزمایشهای خود استفاده کردیم.
ما تصمیم گرفتیم یک محیط کاری را در نظر بگیریم که می تواند یک موقعیت معمول باشد: تحلیلگران مجهز به رایانه های شخصی مستقل هستند که فعالیت های روزانه خود را روی آن انجام می دهند. در این رایانههای شخصی، ممکن است نمونهای از MongoDB در حال اجرا داشته باشند که مجموعه دادههای آنها را در مورد مکانهای جغرافیایی ذخیره میکند و همچنین یک چارچوب J-CO را نصب میکند . در واقع، لزوماً تحلیلگران به ابر رایانه ها مجهز نیستند. در نتیجه، آزمایشهایی را روی یک رایانه شخصی لپتاپ با پردازنده چهار هستهای اینتل i7-8550-U اجرا میکنیم که در ۱٫۸۰گیگاهرتز، مجهز به ۱۶ گیگابایت رم و ۲۵۰ گیگابایت درایو حالت جامد و اجرای نسخه ماشین مجازی جاوا ۱٫۸٫۰_۲۵۱( J-CO-QL +موتور به زبان برنامه نویسی جاوا نوشته شده است).
جدول ۳ زمان های اجرای اسکریپت مورد بحث در این مقاله را گزارش می کند. ما از توصیفگرهای گزارش مجموعه داده کامل مکان های عمومی واقع در منچستر (بریتانیا) استفاده کردیم. به یاد داشته باشید که شامل ۵۷۳۸ توصیفگر فیس بوک و ۵۲۱۴ توصیفگر گوگل است.
جدول ۳ زمان های اجرای مشاهده شده برای هر دستورالعمل منفرد در اسکریپت را گزارش می کند. ستون سمت راست، زمان اجرای تجمعی را پس از هر دستور گزارش می کند. واضح است که زمان اجرای کلی تحت سلطه دستور JOIN OF COLLECTIONS است که در واقع می سازد ۵۷۳۸×۵۲۱۴=۲۹،۹۱۷،۹۳۲جفت توصیفگر؛ طول می کشد ۲۱۶٫۶۱س با نگاهی به دستورالعمل های دیگر، آنها فقط کمتر از ۴ ثانیه کمک می کنند، به طوری که زمان اجرای کلی است ۲۲۰٫۸۰۴s، یعنی، در مورد ۳٫۶دقیقه
از نظر درک کاربر، انتظار برای حدود ۳ دقیقه در این زمینه قابل قبول است، که در آن عملکردهای زمان واقعی انتظار نمی رود. علاوه بر این، ما می خواهیم یادآور شویم که هنگامی که دو مجموعه داده برای ادغام در دسترس هستند، J-CO-QL +اسکریپت را می توان از ابتدا اعمال کرد و چند دقیقه بعد مجموعه داده های یکپارچه به دست می آید. این یک مزیت باورنکردنی در مقایسه با پذیرش تکنیکهای طبقهبندی است، زیرا نیازی به ساخت مجموعههای آموزشی با برچسبگذاری توسط انسان نیست. این فعالیت می تواند از چند ساعت تا چند روز (بسته به اندازه مجموعه آموزشی) طول بکشد و مستعد خطا و سوء تفاهم است و همچنین اثربخشی آن به نحوه ساخت مجموعه های آموزشی قبل از برچسب زدن بستگی دارد.
۸٫ نتیجه گیری و کار آینده
برای نتیجه گیری، وقت آن است که سهم مقاله را خلاصه و بحث کنیم، و همچنین تحولات آینده را ترسیم کنیم.
۸٫۱٫ نتیجه گیری
این مقاله به مشکل یکپارچهسازی نرم مجموعههای داده در توصیف مکانهای عمومی میپردازد، زمانی که این مجموعه دادهها به عنوان اسناد JSON نشان داده میشوند و در یک فروشگاه اسناد JSON ذخیره میشوند. به طور خاص، نظریه مجموعه فازی چارچوب رسمی را برای روش ادغام ارائه شده در مقاله ارائه می دهد: مآتیجساعتمنngپلآجهسرابطه فازی هسته اصلی روش پیشنهادی است. سپس، روش یکپارچه سازی نرم به روشی عملی با استفاده از چارچوب J-CO اعمال می شود : یک اسکریپت (یا پرس و جو) که در J-CO-QL نوشته شده است.+(زبان پرس و جو چارچوب J-CO ) نوشته شده است که روش یکپارچه سازی نرم را با بهره برداری از قابلیت های فازی آن پیاده سازی می کند. این سهم اصلی مقاله است: نشان می دهد که یک ابزار مستقل جدید ( چارچوب J-CO )، مناسب برای انجام یکپارچه سازی نرم مجموعه داده های JSON دارای برچسب جغرافیایی ذخیره شده در JSON ، اکنون برای تحلیلگران و تحلیلگران در دسترس است. مهندسین داده های مکانی
از این پس می خواهیم نکاتی را انجام دهیم.
-
اثربخشی که فیلمنامه به دست می آورد بسیار جالب است: با ارزش αآستانه تنظیم شده است α=۰٫۸، می توان بهترین تعادل بین دقت و فراخوان را بدست آورد که کمی کمتر از ۱۰۰%.
-
زمان اجرا نیز خوب است: کمتر از ۴ دقیقه برای انجام یکپارچه سازی نرم کاملاً قابل قبول است (خواننده می تواند متوجه شود که نوشتن اسکریپت کامل از ابتدا زمان بیشتری می برد).
-
توابع عضویت پیچیده ای که می توان آنها را در عملگرهای فازی مشخص کرد (به بخش ۶٫۲ مراجعه کنید ) برای مقابله با رفتار عجیب متریک رشته شباهت جارو-وینکلر مورد سوء استفاده قرار گرفت. در واقع، مقادیر تشابه بالایی را برای رشته هایی که به نظر می رسد بسیار متفاوت هستند برمی گرداند (به این معنا که آنها نام های مشابه یا آدرس های مشابه را نشان نمی دهند). با این حال، ما رفتار مخالف را نیز تجربه کردیم، یعنی دو رشته که در واقع بسیار مشابه بودند، درجه تشابه نه چندان بالایی را به دست آوردند. تابع عضویت پیچیده ای که برای عملگر فازی مشابه تعریف کردیم به ما اجازه داد تا این رفتار را جبران کنیم.
۸٫۲٫ کار آینده
در آینده، فعالیت های زیادی در راستای توسعه چارچوب J-CO و کاربرد آن برای مشکلات یکپارچه سازی داده ها برنامه ریزی شده است.
-
اول از همه، ما قصد داریم توسعه تمام J-CO-QL را تکمیل کنیم+عباراتی با پشتیبانی از مفاهیم فازی به طور خاص، ما میخواهیم به مشکل تعریف «جمعکنندههای نرم» که میتوانند روی آرایههای اسناد JSON اعمال شوند، بپردازیم. ما رویکرد مشابهی را برای تعریف عملگرهای فازی اتخاذ خواهیم کرد.
-
انواع مختلفی از مجموعههای فازی در ادبیات پیشنهاد شدهاند (به عنوان مثال، مجموعههای فازی شهودی [ ۴۴ ، ۴۵ ] و مجموعههای فازی نوع ۲ [ ۴۶ ، ۴۷ ، ۴۸ ]. در تکامل دیدگاه خود، ما قصد داریم J-CO- را گسترش دهیم. QL +برای پشتیبانی از چندین نوع مجموعه فازی به طور همزمان.
-
چالشهای زیادی در رابطه با یکپارچهسازی و پردازش مجموعه دادههای برچسبگذاریشده جغرافیایی در حال ظهور است. به عنوان مثال، فرمت GeoJSON [ ۴۹ ] یک لایه اطلاعات جغرافیایی را به عنوان یک سند JSON منحصر به فرد، غول پیکر نشان می دهد. ما ایده تعریف یک زبان خاص دامنه را برای جستجوی ویژگیها در اسناد GeoJSON [ ۵۰ ] که به J-CO-QL ترجمه شده است، در نظر گرفتیم.+اسکریپت ها ما قصد داریم این ایده را با شناسایی سایر حوزههای کاربردی و تعریف زبانهای خاص دامنه جدید برای ترجمه به J-CO-QL بررسی کنیم.+. در واقع، ایده ابداع چارچوب J-CO هنگام کار بر روی یک پروژه بین المللی [ ۵۱ ، ۵۲ ]، که در آن کلان داده در مورد تحرک باید جمع آوری و پردازش می شد، مطرح شد.
چارچوب J-CO در یک مخزن عمومی GitHub در دسترس است ( https://github.com/JcoProjectTeam/JcoProjectPage ، در تاریخ ۱ سپتامبر ۲۰۲۲ قابل دسترسی است).
منابع
- Bray, T. فرمت تبادل داده نمادگذاری شی جاوا اسکریپت (JSON). ۲۰۱۴٫ در دسترس آنلاین: https://www.rfc-editor.org/rfc/rfc7159.txt (در ۱ سپتامبر ۲۰۲۲ قابل دسترسی است).
- بوردوگنا، جی. کاپلی، اس. Psaila, G. یک چارچوب پرس و جو داده های جغرافیایی بزرگ برای ارتباط داده های باز با پست های دارای برچسب جغرافیایی شبکه های اجتماعی. در مجموعه مقالات کنفرانس بین المللی سالانه علوم اطلاعات جغرافیایی، واگنینگن، هلند، ۱۰-۱۱ مه ۲۰۱۷؛ ص ۱۸۵-۲۰۳٫ [ Google Scholar ]
- بوردوگنا، جی. Ciriello، DE; Psaila، G. چارچوبی انعطافپذیر برای تجزیه و تحلیل متقابل اطلاعات چند منبع جغرافیایی ناهمگن: پیشنهاد J-CO-QL و اجرای آن. در مجموعه مقالات کنفرانس بین المللی هوش وب، لایپزیگ، آلمان، ۲۳ تا ۲۶ ژوئن ۲۰۱۷٫ صص ۴۹۹-۵۰۸٫ [ Google Scholar ]
- بوردوگنا، جی. کاپلی، اس. Ciriello، DE; Psaila، G. یک چارچوب تحلیل متقابل برای اطلاعات جغرافیایی داوطلبانه، جمعسپاری و معتبر چند منبعی: مطالعه موردی تجزیه و تحلیل ردیابیهای شخصی داوطلبانه در برابر دادههای شبکه حملونقل. ژئو اسپات. Inf. علمی ۲۰۱۸ ، ۲۱ ، ۲۵۷-۲۷۱٫ [ Google Scholar ] [ CrossRef ]
- پسایلا، جی. Fosci، P. J-CO: چارچوبی مستقل از پلتفرم برای مدیریت مجموعه دادههای JSON با مرجع جغرافیایی. Electronics ۲۰۲۱ , ۱۰ , ۶۲۱٫ [ Google Scholar ] [ CrossRef ]
- پسایلا، جی. Toccu, M. A Fuzzy Technique for On-Line Aggregation POIs از رسانه های اجتماعی: تعریف و مقایسه با طبقه بندی کننده های تصادفی جنگلی آفلاین. اطلاعات ۲۰۱۹ ، ۱۰ ، ۳۸۸٫ [ Google Scholar ] [ CrossRef ]
- فوسی، پی. Psaila، G. به سوی بازیابی انعطاف پذیر، ادغام و تجزیه و تحلیل مجموعه داده های json از طریق مجموعه های فازی: مطالعه موردی. اطلاعات ۲۰۲۱ ، ۱۲ ، ۲۵۸٫ [ Google Scholar ] [ CrossRef ]
- فوسی، پی. Psaila، G. J-CO، چارچوبی برای مجموعههای جستجوی فازی اسناد JSON. در مجموعه مقالات کنفرانس بینالمللی سیستمهای پاسخگویی پرسشهای انعطافپذیر، براتیسلاوا، اسلواکی، ۱۹ تا ۲۴ سپتامبر ۲۰۲۱؛ اسپرینگر: چم، سوئیس؛ صص ۱۴۲-۱۵۳٫ [ Google Scholar ]
- پسایلا، جی. Marrara, S. اولین گام به سوی چارچوب فازی برای تجزیه و تحلیل مجموعه اسناد JSON. در مجموعه مقالات IADIS AC 2019، کالیاری، ایتالیا، ۷-۹ نوامبر ۲۰۱۹؛ ص ۱۹-۲۸٫ [ Google Scholar ]
- Blair, DC Information Retrieval, 2nd ed. سی جی ون رایسبرگن. لندن: Butterworths; ۱۹۷۹: ۲۰۸ ص قیمت: ۳۲٫۵۰ دلار . مربا. Soc. Inf. علمی ۱۹۷۹ ، ۳۰ ، ۳۷۴-۳۷۵٫ [ Google Scholar ] [ CrossRef ]
- Bosc، P. Pivert, O. SQLf: یک زبان پایگاه داده رابطه ای برای پرس و جو فازی. IEEE Trans. سیستم فازی ۱۹۹۵ , ۳ , ۴۸۹۵۹۷۷٫ [ Google Scholar ] [ CrossRef ]
- Bosc، P. عملکرد پرس و جو Pivert، O. SQLf در بالای یک سیستم مدیریت پایگاه داده رابطه ای معمولی. در مدیریت دانش در پایگاه های داده فازی ; Springer: برلین/هایدلبرگ، آلمان، ۲۰۰۰; صص ۱۷۱-۱۹۰٫ [ Google Scholar ]
- گالیندو، جی. مدینه، ج.م. پونز، او. Cubero, JC سروری برای پرس و جوهای SQL فازی. در مجموعه مقالات کنفرانس بینالمللی سیستمهای پاسخگویی پرسشهای انعطافپذیر، راسکیلد، دانمارک، ۱۳ تا ۱۵ مه ۱۹۹۸٫ صص ۱۶۴-۱۷۴٫ [ Google Scholar ]
- زادروزنی، س. Kacprzyk, J. Fquery for access: Towards human query interface user. در مجموعه مقالات سمپوزیوم ACM 1996 در محاسبات کاربردی، فیلادلفیا، PA، ایالات متحده آمریکا، ۱۷-۱۹ فوریه ۱۹۹۶٫ صص ۵۳۲-۵۳۶٫ [ Google Scholar ]
- کاکرزیک، جی. Zadrożny، S. FQUERY برای دسترسی: پرس و جو فازی برای DBMS مبتنی بر ویندوز. در Fuzziness در سیستم های مدیریت پایگاه داده ; Springer: برلین/هایدلبرگ، آلمان، ۱۹۹۵; ص ۴۱۵-۴۳۳٫ [ Google Scholar ]
- بوردوگنا، جی. Psaila, G. مدلسازی شرایط نرم با اهمیت نابرابر در پایگاههای داده فازی بر اساس هنجار p برداری. در مجموعه مقالات کنفرانس IPMU، مالاگا، اسپانیا، ۲۲-۲۷ ژوئن ۲۰۰۸٫ [ Google Scholar ]
- بوردوگنا، جی. Psaila, G. پرس و جو انعطاف پذیر قابل تنظیم در پایگاه داده های رابطه ای کلاسیک. در کتابچه راهنمای تحقیق در مورد پردازش اطلاعات فازی در پایگاه های داده ; IGI Global: Hershey، PA، USA، ۲۰۰۸; صص ۱۹۱-۲۱۷٫ [ Google Scholar ]
- بوردوگنا، جی. Psaila, G. Soft Aggregation in Flexible Databases Querying بر اساس Vector p-norm. بین المللی J. نامشخص. سیستم مبتنی بر دانش فازی. ۲۰۰۹ ، ۱۷ ، ۲۵-۴۰٫ [ Google Scholar ] [ CrossRef ]
- کاکرزیک، جی. Zadrozny، S. SQLf و FQUERY برای دسترسی. در مجموعه مقالات نهمین کنگره جهانی مشترک IFSA و بیستمین کنفرانس بین المللی NAFIPS (Cat. No. 01TH8569)، ونکوور، BC، کانادا، ۲۵-۲۸ ژوئیه ۲۰۰۱٫ جلد ۴، ص ۲۴۶۴–۲۴۶۹٫ [ Google Scholar ]
- اوروتیا، ا. تینیو، ال. گونزالس، سی. FSQL و SQLf: به سوی یک استاندارد در پایگاه های داده فازی. در کتابچه راهنمای تحقیق در مورد پردازش اطلاعات فازی در پایگاه های داده ; IGI Global: Hershey، PA، USA، ۲۰۰۸; ص ۲۷۰-۲۹۸٫ [ Google Scholar ]
- Galindo, J. Handbook of Research on Fuzzy Information Processing in Databases ; IGI Global: Hershey، PA، USA، ۲۰۰۸٫ [ Google Scholar ]
- هان، جی. هایهونگ، ای. پا.؛ Du, J. Survey در پایگاه داده NoSQL. در مجموعه مقالات ششمین کنفرانس بین المللی ۲۰۱۱ در مورد محاسبات فراگیر و کاربردها، پورت الیزابت، آفریقای جنوبی، ۲۶-۲۸ اکتبر ۲۰۱۱٫ صص ۳۶۳-۳۶۶٫ [ Google Scholar ]
- Chodorow, K. MongoDB: The Definitive Guide: Powerful and Scalable Data Storage ; O’Reilly Media, Inc.: Sebastopol, CA, USA, 2013. [ Google Scholar ]
- اندرسون، جی سی. لناردت، جی. Slater, N. CouchDB: The Definitive Guide: Time to Relax ; O’Reilly Media, Inc.: Sebastopol, CA, USA, 2010. [ Google Scholar ]
- گارسیا برینگاس، پی. کشیش، آی. Psaila، G. آیا فناوری BlockChain می تواند سیستم های اطلاعاتی را با پایگاه داده قابل اعتماد ارائه دهد؟ مورد Fabric HyperLedger. در مجموعه مقالات کنفرانس بینالمللی سیستمهای پاسخگویی پرسشهای انعطافپذیر، آمانتیا، ایتالیا، ۲ تا ۵ ژوئیه ۲۰۱۹؛ اسپرینگر: چم، سوئیس؛ ص ۲۶۵-۲۷۷٫ [ Google Scholar ]
- ابیر، ب.ک. Amel، GT به سمت پرس و جوی فازی از پایگاه داده های سند گرا NoSQL. در مجموعه مقالات DBKDA 2015: هفتمین کنفرانس بین المللی پیشرفت در پایگاه های داده، دانش و کاربردهای داده، رم، ایتالیا، ۲۴ تا ۲۹ مه ۲۰۱۵٫ پ. ۱۶۳٫ [ Google Scholar ]
- Almendros-Jimenez, JM; بسرا-ترون، آ. Moreno, G. Fuzzy پرس و جوهای شبکه های اجتماعی با FSA-SPARQL. سیستم خبره Appl. ۲۰۱۸ ، ۱۱۳ ، ۱۲۸-۱۴۶٫ [ Google Scholar ] [ CrossRef ]
- مانولا، اف. میلر، ای. McBride، B. RDF Primer. توصیه W3C (2004). در دسترس آنلاین: http://www.w3.org/TR/rdf-primer (در ۱ سپتامبر ۲۰۲۲ قابل دسترسی است).
- چنگ، جی. Ma، ZM; Yan, L. f-SPARQL: توسعه انعطاف پذیر SPARQL. در مجموعه مقالات کنفرانس بین المللی پایگاه داده و کاربردهای سیستم های خبره، بیلبائو، اسپانیا، ۳۰ اوت تا ۳ سپتامبر ۲۰۱۰٫ اسپرینگر: برلین/هایدلبرگ، آلمان؛ ص ۴۸۷-۴۹۴٫ [ Google Scholar ]
- پرز، جی. آرناس، م. گوتیرز، سی. معناشناسی و پیچیدگی SPARQL. ACM Trans. سیستم پایگاه داده (TODS) ۲۰۰۹ ، ۳۴ ، ۱۶٫ [ Google Scholar ] [ CrossRef ]
- Kilinc، D. یک اندازه گیری دقیق تطبیق نام های بر اساس تطبیق رشته های تقریبی. J. Inf. علمی ۲۰۱۶ ، ۴۲ ، ۱۳۸-۱۴۹٫ [ Google Scholar ] [ CrossRef ]
- سانتوس، آر. موریتا-فلورس، پی. مارتینز، بی. آموزش ترکیب معیارهای تشابه رشتهای چندگانه برای تطبیق مؤثر نامهای نام. بین المللی جی دیجیت. زمین ۲۰۱۸ ، ۱۱ ، ۹۱۳-۹۳۸٫ [ Google Scholar ] [ CrossRef ]
- روی، س. پاتریشیا، ام.اف. پاول، سی. برونو، ام. تطبیق نام از طریق شبکه های عصبی عمیق. بین المللی جی. جئوگر. Inf. ۲۰۱۸ ، ۳۲ ، ۳۲۴-۳۴۸٫ [ Google Scholar ]
- لی، ال. زینگ، ایکس. شیا، اچ. Huang, X. تطبیق نمونه با وزن آنتروپی بین نقاط مختلف منبع مورد علاقه. Entropy ۲۰۱۶ , ۱۸ , ۴۵٫ [ Google Scholar ] [ CrossRef ]
- یو، ال. کیو، پی. لیو، ایکس. لو، اف. وان، بی. رویکردی کل نگر برای تراز کردن داده های مکانی با اندازه گیری تشابه چند بعدی. بین المللی جی دیجیت. زمین ۲۰۱۸ ، ۱۱ ، ۸۴۵–۸۶۲٫ [ Google Scholar ] [ CrossRef ]
- زاده، لس آنجلس مفهوم متغیر زبانی و کاربرد آن در استدلال تقریبی – I. Inf. علمی ۱۹۷۵ ، ۸ ، ۱۹۹-۲۴۹٫ [ Google Scholar ] [ CrossRef ]
- پسایلا، جی. Fosci, P. Toward a Anayist-Oriented Polystore Framework for Processing JSON Geo-Data. در مجموعه مقالات کنفرانس های بین المللی WWW/Internet، ICWI 2018 and Applied Computing 2018، بوداپست، مجارستان، ۲۱ تا ۲۳ اکتبر ۲۰۱۸؛ IADIS (انجمن بین المللی برای توسعه جامعه اطلاعاتی): بوداپست، مجارستان، ۲۰۱۸; صص ۲۱۳-۲۲۲٫ [ Google Scholar ]
- فوسی، پی. Psaila، G. قدرت پرس و جو نرم در J-CO-QL با توابع جاوا اسکریپت. در مجموعه مقالات کارگاه بین المللی مدل های محاسبات نرم در کاربردهای صنعتی و محیطی، بیلبائو، اسپانیا، ۲۲ تا ۲۴ سپتامبر ۲۰۲۱؛ اسپرینگر: چم، سوئیس؛ ص ۲۰۷-۲۲۱٫ [ Google Scholar ]
- سلیمان، ج. رستموف، ر. گیباس، ال. Butscher, A. فواصل حرکت دهنده زمین در سطوح گسسته. ACM Trans. نمودار. (ToG) ۲۰۱۴ , ۳۳ , ۶۷٫ [ Google Scholar ] [ CrossRef ]
- Jaro, MA UNIMATCH, a Record Linkage System: Users Manual ; دفتر سرشماری: واشنگتن، دی سی، ایالات متحده آمریکا، ۱۹۸۰٫ [ Google Scholar ]
- Jaro، MA پیشرفت در روش شناسی رکورد-پیوند به عنوان تطبیق سرشماری ۱۹۸۵ تمپا، فلوریدا. مربا. آمار دانشیار ۱۹۸۹ ، ۸۴ ، ۴۱۴-۴۲۰٫ [ Google Scholar ] [ CrossRef ]
- وینکلر، معیارهای مقایسهکننده رشتههای WE و قوانین تصمیمگیری پیشرفته در مدل پیوند رکورد Fellegi-Sunter. در مجموعه مقالات بخش روشهای تحقیق پیمایشی ; انجمن آماری آمریکا: بوستون، MA، ایالات متحده آمریکا، ۱۹۹۰; صص ۳۵۴-۳۵۹٫ [ Google Scholar ]
- وینکلر، ما وضعیت پیوند رکوردها و مشکلات تحقیق کنونی . بخش تحقیقات آماری، اداره سرشماری ایالات متحده: واشنگتن، دی سی، ایالات متحده آمریکا، ۱۹۹۹٫
- آتاناسوف، کی. مجموعه های فازی شهودی. سیستم مجموعه های فازی ۱۹۸۶ ، ۲۰ ، ۱۸۷-۱۹۶٫ [ Google Scholar ] [ CrossRef ]
- میز کار؛ بیسواس، ر. روی، AR کاربرد مجموعه های فازی شهودی در تشخیص پزشکی. سیستم مجموعه های فازی ۲۰۰۱ ، ۱۱۷ ، ۲۰۹-۲۱۳٫ [ Google Scholar ] [ CrossRef ]
- کارنیک، NN; مندل، JM عملیات بر روی مجموعه های فازی نوع ۲٫ سیستم مجموعه های فازی ۲۰۰۱ ، ۱۲۲ ، ۳۲۷-۳۴۸٫ [ Google Scholar ] [ CrossRef ]
- مجموعهها و سیستمهای فازی مندل، JM Type-2: مروری. محاسبات IEEE. هوشمند Mag. ۲۰۰۷ ، ۲ ، ۲۰-۲۹٫ [ Google Scholar ] [ CrossRef ]
- مندل، جی.ام. جان، RB نوع ۲ مجموعه های فازی ساده ساخته شده است. IEEE Trans. سیستم فازی ۲۰۰۲ ، ۱۰ ، ۱۱۷-۱۲۷٫ [ Google Scholar ] [ CrossRef ]
- باتلر، اچ. دالی، م. دویل، ا. گیلیز، اس. هاگن، اس. Schaub, T. فرمت GeoJSON ; گروه ویژه مهندسی اینترنت (IETF): فرمونت، کالیفرنیا، ایالات متحده آمریکا، ۲۰۱۶٫ [ Google Scholar ]
- فوسی، پی. مارارا، اس. Psaila، G. Soft Querying اسناد GeoJSON در چارچوب J-CO. در مجموعه مقالات شانزدهمین کنفرانس بین المللی سیستم ها و فناوری های اطلاعات وب (WEBIST 2020)، به صورت آنلاین، ۳ تا ۵ نوامبر ۲۰۲۰؛ انتشارات SciTePress-Science and Technology، Lda.: Setubal، پرتغال، ۲۰۲۰؛ صص ۲۵۳-۲۶۵٫ [ Google Scholar ]
- بورینی، اف. کورتزی، ن. گوتی، ک. Psaila، G. رویکرد پیوند شهری برای تحلیل تحرک در شهر هوشمند: به سوی شناسایی شبکههای کاربران شهر. اوباش Inf. سیستم ۲۰۱۸ ، ۲۰۱۸ ، ۶۲۹۴۸۷۲٫ [ Google Scholar ] [ CrossRef ]
- بوردوگنا، جی. کوزوکریا، آ. فریجریو، ال. پسایلا، جی. Toccu، M. یک چارچوب داده باز قابل تعامل برای کشف تورهای محبوب بر اساس توییت های دارای برچسب جغرافیایی. بین المللی جی. اینتل. Inf. سیستم پایگاه داده ۲۰۱۷ ، ۱۰ ، ۲۴۶-۲۶۸٫ [ Google Scholar ] [ CrossRef ]

شکل ۱٫ چارچوب J-CO .

شکل ۲٫ نمونه سیلoسهتابع عضویت از [ ۶ ] گرفته شده است.

شکل ۳٫ نمونه هایی از اسنادی که توصیفگرهای مکان را نشان می دهند. ( الف ) نمونه ای از سند در مجموعه FacebookDescriptors . ( ب ) نمونه ای از سند در مجموعه GoogleDescriptors .

شکل ۴٫ توابع عضویت برای عملگرهای فازی در فهرست ۱٫ ( الف ) بستن ; ( ب ) مشابه ; ( ج ) WeightedAggregationBeta .

شکل ۵٫ نمونه ای از سند ایجاد شده توسط دستورالعمل JOIN OF COLLECTIONS در خط ۵ J-CO-QL +اسکریپت، قبل از عبارت CASE .

شکل ۶٫ نمونه هایی از اسناد تولید شده توسط دستورالعمل JOIN OF COLLECTIONS در خط ۵٫ ( الف ) مثال برای مورد A. ( ب ) مثال برای مورد B. ( ج ) مثال برای مورد C.
شکل ۷٫ نمونه هایی از اسناد تبدیل شده توسط دستورالعمل FILTER در خط ۶ قبل از بخش BUILD . ( الف ) مثال برای مورد الف ( ب ) مثال برای مورد ب. ( ج ) مثال برای مورد ج.

شکل ۸٫ نمونه هایی از اسناد تولید شده توسط دستورالعمل FILTER در خط ۶٫ ( الف ) مثال برای مورد A. ( ب ) مثال برای مورد B. ( ج ) مثال برای مورد C.
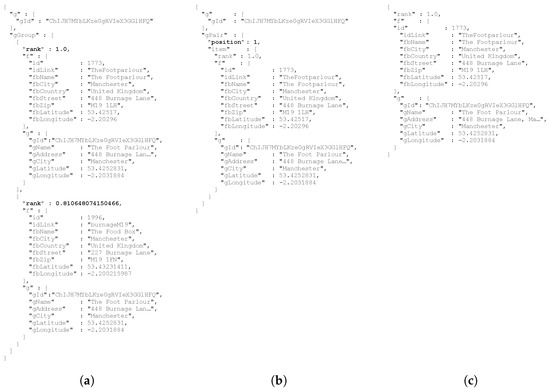
شکل ۹٫ نمونه هایی از اسناد در حین انتخاب BestPairs در فهرست ۴٫ ( الف ) نمونه ای از سند پس از دستور GROUP در خط ۹٫ ( ب ) نمونه ای از سند در طول دستورالعمل EXPAND در خط ۱۰ قبل از عبارت BUILD . ( ج ) نمونه ای از سند پس از دستورالعمل EXPAND در خط ۱۰٫
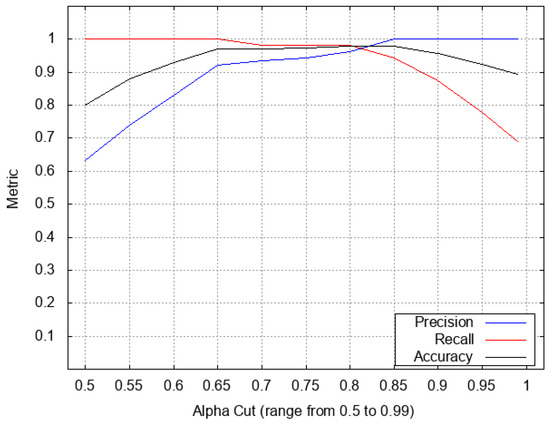
شکل ۱۰٫ تجزیه و تحلیل حساسیت دقت، یادآوری و دقت.