
پیچیدگی یک شبکه جاده ای باید پس از تغییر مقیاس کاهش یابد تا بتوان خوانایی نقشه را حفظ کرد. با این حال، تصمیم گیری برای نشان دادن یک بخش جاده خاص بر روی نقشه یک فرآیند بسیار پیچیده است. این فرآیند، که انتخاب نامیده می شود، اولین گام در توالی عملیات تعمیم بیشتر را تشکیل می دهد و پیش نیاز تعمیم موثر شبکه راه است. تاکنون راهحلهای جامع زیادی برای انتخاب مؤثر جاده بهطور خاص در مقیاسهای کوچک ایجاد نشده است، زیرا مطالعات عمدتاً با نقشههای مقیاس بزرگ سروکار داشتهاند. این مقاله آزمایشی را با استفاده از یادگیری ماشین (ML)، بهویژه مدلهای مبتنی بر درخت تصمیم (DT)، برای بهینهسازی انتخاب جادهها از مقیاسهای ۱:۲۵۰۰۰۰ تا ۱:۵۰۰۰۰۰ و ۱:۱,۰۰۰,۰۰۰ ارائه میکند. دامنه این تحقیق طراحی و تأیید مدلهای انتخاب جاده بر اساس نمونه سه منطقه منتخب در لهستان را پوشش میدهد. هدف این است که مسئله تعمیم جاده را به طور کل نگر در نظر بگیریم، از جمله ویژگی های متعدد معنایی، هندسی، توپولوژیکی و آماری جاده. این تحقیق به فهرستی از ویژگی های جاده قابل اندازه گیری منجر شد که به طور جامع رتبه یک بخش جاده خاص را توصیف می کند. نتیجه همچنین شامل وزنهای ویژگی، همبستگی ویژگی محاسبهشده برای جادهها، و مدلهای یادگیری ماشینی است که برای انتخاب خودکار شبکه جادهها طراحی شدهاند. عملکرد مدل های یادگیری ماشین بسیار بالا است و از ۸۰٫۹۴% تا ۹۱٫۲۳% برای مقیاس هدف ۱:۵۰۰۰۰۰ و ۹۸٫۲۱% تا ۹۹٫۸۶% برای مقیاس ۱:۱,۰۰۰,۰۰۰ متغیر است. هدف این است که مسئله تعمیم جاده را به طور کل نگر در نظر بگیریم، از جمله ویژگی های متعدد معنایی، هندسی، توپولوژیکی و آماری جاده. این تحقیق به فهرستی از ویژگی های جاده قابل اندازه گیری منجر شد که به طور جامع رتبه یک بخش جاده خاص را توصیف می کند. نتیجه همچنین شامل وزنهای ویژگی، همبستگی ویژگی محاسبهشده برای جادهها، و مدلهای یادگیری ماشینی است که برای انتخاب خودکار شبکه جادهها طراحی شدهاند. عملکرد مدل های یادگیری ماشین بسیار بالا است و از ۸۰٫۹۴% تا ۹۱٫۲۳% برای مقیاس هدف ۱:۵۰۰۰۰۰ و ۹۸٫۲۱% تا ۹۹٫۸۶% برای مقیاس ۱:۱,۰۰۰,۰۰۰ متغیر است. هدف این است که مسئله تعمیم جاده را به طور کل نگر در نظر بگیریم، از جمله ویژگی های متعدد معنایی، هندسی، توپولوژیکی و آماری جاده. این تحقیق به فهرستی از ویژگی های جاده قابل اندازه گیری منجر شد که به طور جامع رتبه یک بخش جاده خاص را توصیف می کند. نتیجه همچنین شامل وزنهای ویژگی، همبستگی ویژگی محاسبهشده برای جادهها، و مدلهای یادگیری ماشینی است که برای انتخاب خودکار شبکه جادهها طراحی شدهاند. عملکرد مدل های یادگیری ماشین بسیار بالا است و از ۸۰٫۹۴% تا ۹۱٫۲۳% برای مقیاس هدف ۱:۵۰۰۰۰۰ و ۹۸٫۲۱% تا ۹۹٫۸۶% برای مقیاس ۱:۱,۰۰۰,۰۰۰ متغیر است. این تحقیق به فهرستی از ویژگی های جاده قابل اندازه گیری منجر شد که به طور جامع رتبه یک بخش جاده خاص را توصیف می کند. نتیجه همچنین شامل وزنهای ویژگی، همبستگی ویژگی محاسبهشده برای جادهها، و مدلهای یادگیری ماشینی است که برای انتخاب خودکار شبکه جادهها طراحی شدهاند. عملکرد مدل های یادگیری ماشین بسیار بالا است و از ۸۰٫۹۴% تا ۹۱٫۲۳% برای مقیاس هدف ۱:۵۰۰۰۰۰ و ۹۸٫۲۱% تا ۹۹٫۸۶% برای مقیاس ۱:۱,۰۰۰,۰۰۰ متغیر است. این تحقیق به فهرستی از ویژگی های جاده قابل اندازه گیری منجر شد که به طور جامع رتبه یک بخش جاده خاص را توصیف می کند. نتیجه همچنین شامل وزنهای ویژگی، همبستگی ویژگی محاسبهشده برای جادهها، و مدلهای یادگیری ماشینی است که برای انتخاب خودکار شبکه جادهها طراحی شدهاند. عملکرد مدل های یادگیری ماشین بسیار بالا است و از ۸۰٫۹۴% تا ۹۱٫۲۳% برای مقیاس هدف ۱:۵۰۰۰۰۰ و ۹۸٫۲۱% تا ۹۹٫۸۶% برای مقیاس ۱:۱,۰۰۰,۰۰۰ متغیر است.
کلید واژه ها:
جاده ها ; تعمیم نقشه کشی ; درختان تصمیم ; نقشه های در مقیاس کوچک ؛ فراگیری ماشین
۱٫ مقدمه
تعمیم شبکه راه ها برای دهه ها مورد توجه دانشمندان بوده است [ ۱ ، ۲ ، ۳ ، ۴ ]. روش های مختلفی برای انتخاب جاده ها در مقیاس های بزرگ نقشه توسعه یافته است [ ۵ ]، اما هنوز راه حل های موثری برای مقیاس های کوچک وجود ندارد [ ۶ ]. بنابراین، در این تحقیق بر روی مقیاسهای کوچک تمرکز میکنیم، اما همچنین معتقدیم که پس از اصلاحات مناسب، رویکرد پیشنهادی میتواند در مقیاسهای بزرگ اعمال شود.
محققین موافق هستند که یک فرآیند تعمیم شبکه جاده ای کافی مستلزم این است که به ویژگی های معنایی، هندسی، توپولوژیکی و آماری شبکه جاده ها توجه شود [ ۷ ، ۸ ، ۹ ، ۱۰ ]. برای فرآیند انتخاب جاده، رویکردهای مختلفی پیشنهاد شده است، از جمله روشهای مبتنی بر نظریه گراف [ ۸ ، ۱۱ ]، روشهای مبتنی بر ضربه [ ۹ ]، الگوریتم مرکزی پیشرفته [ ۴ ]]، روش های مبتنی بر نظریه اطلاعات و اقدامات مختلف دیگر. با این حال، روشهای مبتنی بر نظریه گراف معمولاً ویژگیهای معنایی و هندسی جادهها را در نظر نمیگیرند، در حالی که روشهای مبتنی بر سکته مغزی به ندرت ویژگیهای آماری جاده را در نظر میگیرند [ ۹ ، ۱۲ ].
نقشهنگاران با تجربه بر اساس شرایط و وابستگیهای متعدد تصمیم میگیرند، در حالی که به طور همزمان ویژگیهای شیء مختلف نقشه را در نظر میگیرند. یک الگوریتم مؤثر و خودکار که ویژگیهای اساسی جاده را به طور کلی تشریح میکند، به کاهش هزینههای طراحی نقشه کمک میکند، در حالی که آن را کارآمدتر و سریعتر میکند. جایگزینی تصمیمات ذهنی نقشهبردار با یک الگوریتم مستلزم این است که تعدادی از ویژگیهای شی نقشه در نظر گرفته شود که به خاطر اتوماسیون فرآیند، باید قابل اندازهگیری و مقایسه باشند. توسعه چنین الگوریتم های پیشرفته ای همچنین مستلزم استفاده از ابزارهایی است که امکان پردازش مجموعه داده های بزرگ و جستجوی قوانین مربوطه را فراهم می کند. یادگیری ماشینی (ML) که با موفقیت در نقشه کشی و بسیاری از حوزه های دیگر استفاده می شود، چنین فرصت هایی را فراهم می کند.۱۳ ، ۱۴ ، ۱۵ ] و تعمیم ساختمان ها [ ۱۶ ]، همچنین با استفاده از یادگیری عمیق (DL) [ ۱۷ ]، و همچنین برای صاف کردن و انتخاب اشیاء خطی [ ۱۸ ، ۱۹ ]، به ویژه با استفاده از عصبی شبکه ها [ ۲۰ ].
اگرچه هوش مصنوعی سنتی و روشهای مبتنی بر تئوری نمودار کارایی انتخاب جاده را بهبود بخشیدهاند، اما اشکالاتی نیز دارند. به عنوان مثال، آنها نمی توانند به طور کامل ویژگی های فضایی شبکه های جاده ای را استخراج کنند. علاوه بر این، آنها همیشه خودکار و اغلب ذهنی نیستند [ ۲۱ ]. راه حل می تواند ترکیب آن رویکردها و استفاده از شبکه های کانولوشن گراف (GCNs) باشد که از هوش مصنوعی و نظریه گراف سود می برند [ ۲۲ ]. در مطالعه [ ۲۱]، شبکه های کانولوشن گراف عمیق (DGCNs) برای انتخاب خودکار جاده استفاده شد. نویسندگان نتایج GCN های مختلف (GraphSAGE و شبکه های توجه گراف [GAT]) را با انتخاب شبکه های جاده ای در مقیاس کوچک با استفاده از معماری های عمیق مختلف (JK-Nets، ResNet، و DenseNet) مقایسه و تجزیه و تحلیل کردند. آنها به این نتیجه رسیدند که معماری GAT و JK-Nets بهترین نتایج را با دقت حدود ۸۸ درصد در مقایسه با انتخاب انجام شده توسط یک متخصص ارائه کردند. با این وجود، حتی در مورد GAT، نویسندگان متوجه تعدادی از جادههای انتخابشده و حذفشده نادرست شدند، بنابراین به این نتیجه رسیدند که چنین تحقیقاتی به آزمایشهای بیشتری نیاز دارد زیرا هنوز از کاربردهای عملی فاصله دارند [ ۲۱ ].
روش جالب دیگری که در انتخاب شبکه راه ها به کار می رود، استفاده از فرآیند تحلیل سلسله مراتبی (AHP) است. AHP یکی از روش های تصمیم گیری چند معیاره (MCDM) است. این تکنیک با در نظر گرفتن مقادیر متعدد و ترجیحات کاربر به یافتن تصمیمات بهینه کمک می کند. AHP معمولی معمولاً در مورد برنامه های تصمیم گیری به وضوح تعریف شده استفاده می شود، که همیشه در انتخاب جاده صدق نمی کند. در [ ۲۳ ]، نویسندگان یک رویکرد AHP فازی را با فرض ویژگیهای جاده به عنوان معیارهای فازی پیشنهاد و اجرا کردند، سپس از این رویکرد برای تعریف وزنهای ویژگی استفاده کردند و از آنها برای ساخت سلسلهمراتب شبکه راه، برای تعیین اولویتهای جادهها برای انتخاب استفاده کردند. ۲۳]. در این رویکرد از پنج ویژگی مربوط به خصوصیات معنایی، هندسی و توپولوژیکی جاده، یعنی کلاس جاده، طول و سه معیار مرکزیت (بین، نزدیکی و درجه) استفاده شد. رویکرد AHP کلاسیک نیز اخیراً برای انتخاب جاده توسط [ ۲۴ ] استفاده شد. آنها از نقاط مورد علاقه (POIs) برای ایجاد شاخصهای ویژگیهای زمینهای و محاسبه اهمیت ضربه خاص با استفاده از مدل AHP استفاده کردند. سپس جاده ها بر اساس اهمیت سکته مغزی، و همچنین بر اساس معیارهای بیشتر تراکم و نگهداری کلی اتصال شبکه جاده انتخاب شدند. بر اساس نقشه به دست آمده در مقیاس ۱:۲۰۰۰۰۰، نویسندگان به این نتیجه رسیدند که استفاده از روش AHP به حفظ ساختار و ویژگی های شبکه راه مبدأ کمک می کند.
کاستیهای تحقیق توصیفشده شامل در نظر گرفتن ویژگیهای منتخب راه بود. به ندرت، معناشناسی گسترده همراه با ویژگی های جاده آماری، هندسی و توپولوژیکی در نظر گرفته می شد. علاوه بر این، تحقیقات قبلی به آزمایشها و بسط بیشتری نیاز دارد، زیرا هنوز از کاربردهای عملی فاصله دارند. علاوه بر این، راهحلهای پیشنهادی اکثراً برای نقشههای مقیاس بزرگ اختصاص داده شده و تطبیق داده شدهاند. بنابراین، انگیزه این تحقیق پر کردن این شکاف تحقیقاتی و توسعه روشها و مدلهای کاملاً خودکار، اختصاصی اما نه محدود به مقیاسهای کوچک و با در نظر گرفتن اقدامات غنی و کلنگر شبکه جادهای است.
هدف خاص این مطالعه ارزیابی و گسترش روش مبتنی بر غنی سازی داده ها و یادگیری ماشینی است که برای تسویه حساب توسط [ ۱۳ ] پیشنهاد شده است. انگیزه غنی سازی روش با متغیرهای جدیدی است که برای شبکه جاده ها تعریف شده است، بنابراین روش پیشنهادی را به شبکه جاده ها گسترش می دهد، و همچنین در نظر گرفتن مناطق آزمایشی جدید و مدل های یادگیری ماشین بیشتر. چنین گسترشی به ما امکان می دهد جهانی بودن روش توسعه یافته و امکان کاربرد آن را بر روی اشیاء مختلف نقشه برداری با ویژگی های جغرافیایی مختلف ارزیابی کنیم.
۲٫ مواد و روشها
۲٫۱٫ داده ها
دادههای منبع شبکه جادهای را تشکیل میدهند که در پایگاه دادههای عمومی جغرافیایی (GGOD) با مقیاس ۱:۲۵۰۰۰۰ مطابقت دارد. GGOD کل کشور را پوشش می دهد و با تعمیم نیمه خودکار از پایگاه داده اشیاء توپوگرافی به دست می آید. در این مطالعه، سه منطقه آزمایشی، یعنی سه منطقه در لهستان در نظر گرفته شد. ولسوالی ها از نظر ویژگی های شبکه راه متفاوت هستند ( شکل ۱ ). این مناطق در نقاط مختلف لهستان واقع شده اند و تنوع تراکم شبکه جاده ای را برای کل کشور به تصویر می کشند. ارجاع به واحدهای اداری نواحی مربوط به اندازه بهینه آنها برای تجزیه و تحلیل داده های مقیاس کوچک است. مقررات موجود در مورد نقشه برداری نیز مناطق را به عنوان واحدهای اساسی برای تعمیم داده های مکانی نشان می دهد [ ۲۵ ]].
۲٫۲٫ انتخاب بر اساس مقررات و یادگیری ماشین
در محدوده این تحقیق، دو رویکرد اساسی و تقویت شده طراحی شده است ( شکل ۲ ).
در رویکرد اساسی، قوانین انتخاب از مقررات وزارت کشور و اداره لهستان [ ۲۵ ] به دست آمد و در داده های جاده GGOD اعمال شد. رویکرد اصلی با استفاده از قابلیت ArcMap نسخه ۱۰٫۶ پیاده سازی شد. ویژگی های جاده هایی که در رویکرد اساسی در نظر گرفته شده اند در جدول ۱ ارائه شده است.
در رویکرد بهبودیافته، مراحل زیر انجام شد: (۱) جمعآوری دانش نقشهبرداری، (۲) غنیسازی جادهها با ویژگیهای اضافی (متغیرهای نامگذاریشده)، (۳) رسمیسازی مقادیر متغیر، (۴) استفاده از مدلهای یادگیری ماشین، یعنی درختهای تصمیم. DT)، بهینهسازی درختهای تصمیم با الگوریتمهای ژنتیک (DT-GA) و جنگل تصادفی (RF)، (۵) پیادهسازی مدلهای توسعهیافته، و (۶) اعتبارسنجی نتایج.
در اولین قدم با نقشهبرداران مجرب مشورت شد. موضوعاتی مانند ویژگی های جاده، روابط با سایر اشیاء نقشه، تداوم شبکه راه، و نگهداری الگوهای شبکه راه مورد بحث قرار گرفت. در مرحله دوم، فهرستی از مشخصات اساسی جاده جمع آوری شد. در این مطالعه، ویژگی هایی که به طور قابل اندازه گیری رسمیت یافته اند، متغیر نامیده می شوند. متغیرها هم به ویژگیهای معنایی جاده و هم ویژگیهای فضایی مربوط میشوند. متغیرهای در نظر گرفته شده در رویکرد افزایش یافته در جدول ۲ ارائه شده است. انتقال از ایدههای کلی متغیرهای جادهها به مقادیر قابل کمیت خاص «رسمیسازی ارزش متغیر» نامیده میشود. تمام مقادیر اضافی با استفاده از ArcGIS نسخه ۱۰٫۶ و ابزار Python محاسبه شد. شبکه راه ها از بخش های زیادی تشکیل شده است (شکل ۳ ). جاده بین تقاطع ها “قطعه” نامیده می شود و ممکن است از چندین “بخش” تشکیل شود. در این تحقیق ما بخشهایی را بر اساس مقادیر مشخصهها، یعنی کلاس و دسته راه، تعداد جادهها و نوع سطح میسازیم، در حالی که بخشها ممکن است چندین بخش را تشکیل دهند. این بخش ها با اتصال بخش های جاده بین تقاطع ها ایجاد شدند. شیئی که در این مورد قطعه نامیده می شود با لبه های نمودار مطابقت دارد و تقاطع ها گره های آن هستند (از نظر مقادیر مشخصه یکنواخت). در مرحله سوم، روشی برای محاسبه مقادیر برای هر متغیر توسعه داده شد. به دست آوردن مقادیر کمی که می توانند به طور عینی محاسبه و مقایسه شوند برای اتوماسیون فرآیند بسیار مرتبط است.
ما همچنین روابط با شهرکها و سایر بخشهای شبکه، مانند تراکم شبکه جادهای در داخل منطقه، تعداد اتصالات با جادههای دیگر، اندازهگیری مرکزیت بین لبه، نوع سطح و تعداد خطوط را بررسی کردیم. این متغیرها باید در بین جاده های تشکیل دهنده شبکه راه قابل اندازه گیری و مقایسه باشند [ ۲۶ ]. با غنی سازی داده های جاده با متغیرهای مربوطه و در نظر گرفتن نمونه های به اندازه کافی بزرگ، ما توانستیم مدل های یادگیری ماشین را طراحی کنیم.
در مرحله چهار از رویکرد پیشرفته، ML در استودیو RapidMiner نسخه ۹٫۹ (دانشگاه فنی دورتموند، آلمان) اجرا شد. فرآیند انتخاب شامل توسعه و بکارگیری سه مدل مبتنی بر درخت تصمیم بود. ما فرآیندهای انتخاب جداگانه را بر اساس درختان تصمیم (DT)، درختان تصمیم پشتیبانی شده با الگوریتم های ژنتیک (DT-GA) و مدل های جنگل تصادفی (RF) طراحی کردیم. برای همه مدلهای ML آزمایششده، پارامترهای پیشفرض پیادهسازی شده در نرمافزار داده کاوی استفاده شد [ ۲۷ ]. پارامترها و مقادیر آنها به شرح زیر بود:
-
نسبت بهره: در مورد مدل DT، معیاری که ویژگیها برای تقسیم انتخاب شدند، نسبت بهره بود. این نوعی از بهره اطلاعات است که به دست آوردن اطلاعات را برای هر ویژگی تنظیم می کند تا اجازه دهد وسعت و یکنواختی مقادیر مشخصه گرفته شود. پارامتر نسبت افزایش وزن ویژگی ها را با توجه به ویژگی برچسب با استفاده از نسبت افزایش اطلاعات محاسبه می کند. هر چه وزن یک صفت بیشتر باشد، مرتبط تر در نظر گرفته می شود.
-
اندازه کوچک تقسیم: مجموعه ای برابر با ۴٫ اندازه یک گره تعداد نمونه های زیر مجموعه آن است. اندازه گره ریشه برابر است با تعداد کل نمونه های در نظر گرفته شده. فقط گره هایی تقسیم می شوند که اندازه آنها بزرگتر یا مساوی با حداقل اندازه تقسیم است.
-
اندازه حداقل برگ برابر با ۴ بود. اندازه گره برگ تعداد نمونه های زیر مجموعه آن است. درخت به گونه ای تولید می شود که هر زیر مجموعه گره برگ حداقل تعداد نمونه های اندازه برگ را داشته باشد.
-
حداقل بهره: برابر با ۰٫۱ تنظیم کنید. سود یک گره قبل از تقسیم آن محاسبه می شود. گره در صورتی تقسیم می شود که بهره آن از حداقل بهره بیشتر باشد. مقادیر بالاتر از حداقل بهره منجر به شکاف های کمتر و در نتیجه درخت کوچکتر می شود. مقدار بیش از حد بالا به طور کامل از تقسیم جلوگیری می کند و یک درخت با یک گره تولید می شود.
-
حداقل عمق: برابر با ۲۰ تنظیم کنید. عمق یک درخت بسته به اندازه و ماهیت نمونه ها متفاوت است. این پارامتر برای محدود کردن اندازه درخت تصمیم استفاده می شود.
-
Confidence: برابر ۰٫۲۵ تنظیم کنید. این پارامتر سطح اطمینان مورد استفاده برای محاسبه خطای بدبینانه هرس را مشخص می کند.
-
تعداد جایگزینهای پیش هرس: برابر با ۳ تنظیم کنید. این پارامتر تعداد گرههای جایگزینی را که برای شکافتن امتحان میشوند تنظیم میکند، زمانی که از شکافتن با پیش هرس کردن در یک گره خاص جلوگیری میشود.
-
در مورد مدل DT-GA، اپراتور به نام «انتخاب بهینه» علاوه بر این مورد استفاده قرار گرفت و از یک الگوریتم ژنتیک (GA) برای انتخاب مرتبطترین ویژگیهای مجموعه نمونه داده شده استفاده کرد. GA یک جستجوی اکتشافی است که فرآیند تکامل طبیعی مانند وراثت، جهش، انتخاب و متقاطع را تقلید می کند [ ۲۷ ].
-
برای مدل RF، پارامترهای بیشتر شامل تعداد درختهای تولید شده (تنظیم به ۱۰۰) و حداکثر عمق درخت (معادل ۱۰) بود. این پارامتر برای محدود کردن عمق برای هر مجموعه درخت تصادفی استفاده می شود [ ۲۷ ].
جاده های ارائه شده بر روی نقشه های اطلس طراحی شده توسط نقشه نگاران مجرب به عنوان مواد آموزشی مورد استفاده قرار گرفت. در نتیجه، درختهای تصمیم را بهدست آوردیم که نشان میدهد کدام متغیرها هنگام انتخاب بخشهای جاده خاص تعیینکننده هستند. بر اساس مدل به دست آمده از فرآیند یادگیری، فرآیند پیش بینی انجام شد. سپس، جادههای مطابق با الزامات مدل انتخاب شدند. در هر دو رویکرد، صحت انتخاب با مقایسه نتایج رویکردهای اساسی و پیشرفته در برابر جادههای نشاندادهشده در نقشههای اطلس طراحیشده توسط نقشهبرداران با تجربه ارزیابی شد. در نتیجه استفاده از مدلهای ML، وزنهای متغیر و همبستگی متغیر را نیز دریافت کردیم.
۳٫ نتایج
۳٫۱٫ درختان تصمیم
نتایج تحقیق شامل مدلهای مبتنی بر درخت تصمیم، یک ماتریس همبستگی، وزنهای متغیر جاده و جادههای تعمیمشده به مقیاسهای ۱:۵۰۰۰۰۰ و ۱:۱۰۰۰۰۰۰ است. از درختان تصمیم بهدستآمده، مهمترین متغیرها در فرآیند انتخاب راه قابل شناسایی هستند. آنها در ریشه درخت قرار می گیرند ( شکل ۴ ، شکل ۵ و شکل ۶ ).
به لطف توانایی خواندن قوانین از درخت تصمیم (DT و DT-GA)، می توان از قبل قابل قبول بودن مدل های یادگیری ماشین را ارزیابی کرد. قوانین توسعه یافته منطقی هستند و همچنین با رویه نقشه کشی پذیرفته شده همسو هستند.
هنگام استفاده از الگوریتم RF، چندین درخت تصمیم ایجاد می شود که نظارت و ارزیابی یادگیری ماشین را در این رویکرد غیرممکن می کند. با این حال، ماهیت جعبه سیاه این روش، یک نقطه ضعف قابل توجه است.
۳٫۲٫ دقت مدل ML
دقت نتایج بهدستآمده با ارزیابی درصد شباهت نتایج بهدستآمده با نقشه اطلس طراحیشده توسط یک نقشهبر مشخص شد. دقت بهعنوان تعداد بخشهای جادهای که هم در نقشه اطلس و هم در رویکرد پایه یا پیشرفته بهعنوان انتخابشده یا حذف شده طبقهبندی شدهاند، محاسبه شد. دقت رویکرد پایه و همه مدلهای ML پیادهسازی شده به ترتیب در جدول ۳ و جدول ۴ برای دو سطح در نظر گرفته شده از جزئیات ارائه شده است.
۳٫۳٫ نقشه ها
نتایج رویکرد پایه و پیشرفته نیز به صورت بصری با نقشه اطلس برای ارزیابی سازگاری شبکه و حفظ الگوهای شبکه راه مشخص مقایسه شد. شکل ۷ ، شکل ۸ ، شکل ۹ ، شکل ۱۰ ، شکل ۱۱ و شکل ۱۲ نتایج را برای مناطق در نظر گرفته شده برای هر دو سطح جزئیات ارائه می دهد.
۴٫ ارزیابی
برای تأیید مناسب بودن مدلهای مبتنی بر درخت تصمیم برای انتخاب خودکار جاده در نقشههای مقیاس کوچک، ما سه مدل را برای نمونه اولیه سه منطقه در لهستان طراحی کردیم. ما درختهای تصمیمگیری (DT)، درختهای تصمیمگیری با الگوریتمهای ژنتیک (DT-GA) و مدلهای یادگیری ماشینی جنگل تصادفی (RF) را ارزیابی کردیم. هدف در نظر گرفتن متغیرهای جدید، بررسی اهمیت و همبستگی آنها و ارزیابی نتایج مدلهای یادگیری ماشین خودکار به صورت کیفی و کمی بود. این بخش برای اظهار نظر در مورد این اهداف و چالش ها سازماندهی شده است.
۴٫۱٫ ارزیابی کیفی
ارزیابی بصری نتایج بهدستآمده از رویکردهای پیشرفته و اساسی در مقایسه با نقشه اطلس به نفع رویکرد افزایش یافته است ( شکل ۷ ، شکل ۸ ، شکل ۹ ، شکل ۱۰ ، شکل ۱۱ و شکل ۱۲ را ببینید). در رویکرد بهبودیافته، جادههای اصلی حفظ شدهاند، جادههای انتخاب شده شبکه منسجمتری را در رابطه با رویکرد اصلی تشکیل میدهند و خصوصیات کلی و تفاوتها در تراکم جاده بهتر از رویکرد اصلی منعکس میشود. در همین حال، در رویکرد پایه، شبکه راه در مقایسه با نقشه اطلس بیش از حد متراکم است ( شکل ۸ و شکل ۹).) و همچنین در بسیاری از نقاط ناپیوسته است ( شکل ۷ ، شکل ۸ و شکل ۹ ). در عین حال، شکل ۱۲ نشان می دهد که در هر دو رویکرد افزایش یافته (DT-GA و RF)، جاده مهم در بخش شرقی منطقه به درستی روی نقشه نگه داشته شده است، در حالی که در رویکرد اصلی حذف شده است. از سوی دیگر، در شکل ۱۱برخی از جاده ها در بخش جنوبی توسط RF و رویکرد اصلی حذف شدند، که باعث می شود نتیجه RF، به ویژه، بیشتر شبیه به نقشه اطلس باشد. در همین حال، این جادهها در نقشه DT-GA نگهداری میشدند، بنابراین، اگرچه شباهت کمتری به نقشه اطلس دارد، اما این راهحل باعث میشود نتیجه DT-GA از نظر حفظ ثبات کلی شبکه راه در این منطقه صحیحتر باشد. بر اساس ارزیابی کیفی، ما همچنین مشکلات جاده های بن بست را در رویکردهای پایه و پیشرفته به طور یکسان یادداشت می کنیم ( شکل ۷ ، شکل ۸ و شکل ۱۲ ). بر اساس روش نقشهبرداری، جادههایی که به جادهها یا سکونتگاههای دیگر متصل نمیشوند باید حذف یا دوباره وصل شوند [ ۴ ]. در برخی موارد، مانند منطقه Białostocki ( شکل ۷حذف تمام بن بست ها منجر به حذف بسیاری از بخش های جاده می شود که ممکن است به نوبه خود منجر به تغییرات کاملاً قابل توجهی در تراکم جاده شود. در چنین مواردی، اتصال مجدد برخی از بخش های جاده ممکن است راه حل باشد. این موضوع باید در تحقیقات آینده بیشتر مورد توجه قرار گیرد، به عنوان مثال، مشخص کردن متغیرهای توپولوژیکی بیشتر و محدودیتهای توپولوژیکی.
در مورد سه منطقه در نظر گرفته شده و همه رویکردهای افزایش یافته در نظر گرفته شده، متغیرهایی که روی درخت ظاهر می شوند دسته مدیریت راه (دسته راه) و تعداد اتصالات جاده (تعداد جاده های متصل) هستند ( شکل ۴ ، شکل ۵ و شکل را ببینید. ۶ ). وجود این متغیرها در ریشه درخت منطقی و معقول است. نقشه کش باتجربه نیز آنها را بسیار مهم می داند. علاوه بر این، با تجزیه و تحلیل درخت از ریشه تا برگ، قوانین انتخاب جاده را می توان به روشی ساده خواند. این قوانین می تواند مکمل قوانین انتخاب مندرج در آیین نامه [ ۲۵ ] باشد]. درخت های تصمیم که نتایج DT و DT-GA در مقیاس ۱:۱,۰۰۰,۰۰۰ هستند در هر دو سطح جزئیات در نظر گرفته شده ساختار یکسانی دارند. ساختار درخت بسیار ساده است، اما دقت انتخاب بالا است ( شکل ۶ ، جدول ۴ ). دقت برای رویکرد پیشرفته DT-GA در تمام موارد آزمایش شده بالاترین است. درخت فقط شامل یک سطح است و متغیر تعیین کننده رده جاده است. این قابل انتظار است و با تمرین نقشه کشی در مقیاس ۱:۱،۰۰۰،۰۰۰ منسجم است.
همچنین لازم به ذکر است که رویکرد پایه نیز نتایجی را به همراه دارد که از نظر دقت بسیار بالا هستند ( جدول ۴ ). از این می توان نتیجه گرفت که برای مقیاس های بسیار کوچک، تقریباً فرقی نمی کند که از کدام روش استفاده شود. همه عملکرد بسیار خوبی دارند. همانطور که شکل ۶ نشان می دهد، استفاده از دسته راه برای انتخاب جاده های مناسب کافی است. این نیز قانون سطح بالا در مقررات برای مقیاس ۱:۱,۰۰۰,۰۰۰ است ( جدول ۱ ). بنابراین، الگوریتم های انتخاب توسعه یافته از DT و DT-GA برای مقیاس ۱:۱،۰۰۰،۰۰۰ یکسان خواهند بود. در همین حال، درختان تصمیم در رویکردهای DT و DT-GA برای مقیاس ۱:۵۰۰۰۰۰ متفاوت هستند ( شکل ۴ و شکل ۵). درخت های تصمیم به دست آمده برای سه ناحیه در این مقیاس ( شکل ۴ و شکل ۵ ) از نظر ساختار پیچیده تر هستند. برای DT-GA، درخت از چهار سطح تعیین کننده تشکیل شده است، در حالی که درخت برای رویکرد DT شامل سه سطح تعیین کننده است. ما همچنین فرض می کنیم که وقتی تجزیه و تحلیل خود را گسترش دهیم تا مناطق بیشتری را شامل شود، درخت ممکن است پیچیده تر شود. در عین حال، تجزیه و تحلیل دقیق بیشتری باید انجام شود، زیرا یک درخت تصمیم گیری گسترده ممکن است نشان دهنده بیش از حد تناسب باشد، زمانی که به جای تدوین یک قانون، توصیفی از داده های آموزشی تولید می شود.
۴٫۲٫ ارزیابی کمی
جاده های انتخاب شده در همه رویکردها با نقشه مرجع مقایسه شدند. بنابراین، می توان درصد شباهت را بر اساس تعداد اشیاء به درستی انتخاب شده و حذف شده تعیین کرد. مدلهای توسعهیافته در نتیجه ML امکان بهبود دقت انتخاب را در مقایسه با راهحل اعمال شده در رویکرد پایه فراهم کردند. برای سطح جزئیات ۱:۵۰۰۰۰۰، تفاوت در دقت از ۳۱٫۵۱٪ تا ۴۹٫۱۳٪ به نفع رویکرد افزایش یافته است ( جدول ۳ ). در همین حال، برای سطح جزئیات ۱:۱،۰۰۰،۰۰۰، این تفاوت چندان قابل توجه نیست، اگرچه به نفع رویکرد افزایش یافته نیز است، از ۱٫۴۷٪ تا ۷٫۳۲٪ ( جدول ۴ ).
شایان ذکر است که دقت به دست آمده در رویکرد پایه به طرز شگفت آوری کمتر از حد انتظار است ( جدول ۴ ). رویکرد اصلی قوانین تعمیم رسمی مندرج در مقررات را اجرا می کند، بنابراین می توان نتایج را با کیفیت و دقت بالاتر پیش بینی کرد. در عین حال، برای هر منطقه آزمایش شده، دقت رویکرد افزایش یافته بالاتر از رویکرد اصلی است، چه همه مناطق با هم در نظر گرفته شوند یا هر منطقه به طور جداگانه ( جدول ۳ و جدول ۴ ). تفاوت در دقت بسیار قابل توجه است و به نفع رویکرد افزایش یافته است. بنابراین، این امر تأیید می کند که رویکرد پیشرفته، فرآیند انتخاب را کارآمدتر می کند.
مقایسه کمی جاده های بن بست نیز نتایج بهتری را در رویکرد افزایش یافته نشان می دهد ( جدول ۵ و جدول ۶ ). برای جزئیات سطح ۱:۵۰۰۰۰۰ در رویکرد اصلی، ۱۲۷ جاده از این دست وجود داشت، در حالی که در مورد هر دو رویکرد مبتنی بر ML، بیش از دو برابر کمتر جادههای بن بست وجود دارد، چه همه مناطق را در نظر بگیریم یا یک منطقه خاص. نتیجه مقیاس ۱:۱,۰۰۰,۰۰۰ برای همه رویکردها در مورد همه مناطق در نظر گرفته شده یکسان است. در مورد منطقه Kępiński، یک جاده بن بست در رویکرد اصلی ظاهر می شود، در حالی که در یک جاده پیشرفته، هیچ بن بست ایجاد نمی شود. برای منطقه Rzeszowski، در صورت رویکرد اولیه، هیچ بن بست ایجاد نشد. در هر مورد، تنها یک جاده بنبست در مقیاس ۱:۱۰۰۰۰۰۰ ایجاد شد.
۴٫۳٫ وزن های متغیر
یکی از مزایای مهم استفاده از مدل های ML امکان محاسبه وزن های متغیر است. وزن ها برای متغیرهای جاده پیشنهادی در رویکرد افزایش یافته محاسبه شد ( جدول ۷). بیشترین وزن به تعداد سوارهروها تعلق گرفت که مطابق با قوانین مندرج در آییننامه است، زیرا این متغیر در اسناد رسمی نیز بهعنوان پیشرو شناخته شده است. با این حال، متغیرهای دوم و سوم که بیشترین وزنها را به خود اختصاص دادند، یعنی مرکزیت بین و تعداد جادههای متصل (بخشها) متغیرهای جدیدی هستند که در رویکرد تقویتشده پیشنهاد شدهاند و طبق مقررات در نظر گرفته نشدهاند. در میان متغیرهای موجود در مقررات، نوع سطح جاده، کلاس جاده، و دسته راه نیز وزنهای بسیار بالایی را به خود اختصاص دادند، در حالی که همه متغیرهای دیگر با بالاترین وزن، آنهایی را تشکیل میدهند که در رویکرد بهبودیافته پیشنهاد شدهاند. جالب توجه است که دو متغیر مربوط به حداقل تعداد بخشهای جادهای که از شهرکها منتهی میشوند، و همچنین متغیر مربوط به اتصال به سکونتگاه ها نیز وزن های بالایی را به خود اختصاص دادند. از اینجا میتوان نتیجه گرفت که روابط بین شهرکها و شبکه راه معنادار است و بنابراین این متغیرها باید در فرآیند انتخاب لحاظ شوند. کمترین وزن برای متغیرهای مربوط به تراکم جاده به دست آمد. این متغیرها نیز در آیین نامه ذکر نشده اند. وزن تمام متغیرهای جاده در ارائه شده استجدول ۷ . وزن متغیرها از ۰ تا ۱ متغیر است. در جدول ۷ میانگین وزن متغیرهای انتخاب شده ارائه شده است. وزنها میانگین دو رویکرد با بهترین عملکرد یعنی DT-GA و RF را تشکیل میدهند.
۴٫۴٫ تجزیه و تحلیل همبستگی
مقادیر همبستگی بین متغیرهای جاده نیز محاسبه شد ( جدول ۸ ). یک همبستگی قوی ممکن است نشان دهنده تکرار اطلاعاتی باشد که ممکن است نادیده گرفتن متغیر را در مطالعات آتی ضروری کند. همبستگی کم نشان دهنده منحصر به فرد بودن اطلاعاتی است که متغیر منتقل می کند.
قویترین همبستگیها بین طول بخش جاده و تراکم شبکه جاده در مناطق اصلی مختلف مشاهده میشود. همبستگی بین مقادیر این متغیرها منطقی است، زیرا طول جاده ها بر تراکم آنها در مناطق مرجع تأثیر می گذارد. کمترین همبستگی با سایر متغیرها، پارامترهای فنی مانند نوع سطح و تعداد کالسکه است. این متغیرهای ویژگی با سایر مشخصات جاده همبستگی ضعیفی دارند و اطلاعاتی در مورد کیفیت و وضعیت آنها دارند.
این وضعیت نشان میدهد که در تحقیقات آینده برخی از مرتبطترین ویژگیها، بهویژه موضوعی، میتوانند حذف شوند، در حالی که همچنان نتایج با کیفیت بالا حفظ میشوند. از سوی دیگر، ویژگیهای فضایی که کمترین همبستگی را با یکدیگر دارند و همچنین ویژگیهای موضوعی باید حفظ شوند.
۵٫ نتیجه گیری ها
در این مقاله، ما یک رویکرد نوآورانه برای تعمیم خودکار جادهها بر روی نقشههای مقیاس کوچک ارائه کردیم که از یادگیری ماشینی استفاده میکند، یعنی مدلهای درخت تصمیم (DT)، مدلهای درخت تصمیم پشتیبانی شده توسط الگوریتمهای ژنتیک (DT-GA)، و جنگل تصادفی (RF). ) مدل ها. این مقاله متغیرها را پیشنهاد میکند و روشی را برای توسعه قوانین انتخاب، غنیسازی دادهها و ارزیابی صحت تعمیم برای شبکههای جادهای پیادهسازی میکند. ما نتایج تعمیم جاده را از نظر دقت کمی و کیفی ارزیابی کردیم. استفاده از مدل های ML امکان شناسایی اهمیت متغیرهای در نظر گرفته شده را برای هر دو سطح جزئیات در نظر گرفته شده ۱:۵۰۰,۰۰۰ و ۱:۱,۰۰۰,۰۰۰ نیز فراهم کرد. ما همچنین وزن متغیرها و همبستگی متقابل آنها را نشان دادیم. این ممکن است منجر به شناسایی حیاتی ترین متغیرها در تحقیقات آینده شود و همچنین امکان حذف برخی از آنها را فراهم کند. با این حال، قبل از هر گونه حذف، لازم است مناطق آزمایش شده را بزرگتر کرده و مناطق بیشتری را برای تجزیه و تحلیل نمونه های نماینده بیشتر در نظر بگیرید.
ما میتوانیم نتیجه بگیریم که توسعه قوانین تعمیم پشتیبانی شده توسط هوش مصنوعی منجر به الگوریتمی میشود که فرآیند تصمیمگیری را که قبلاً توسط یک نقشهنگار انجام شده بود، تقریب میکند. شواهدی برای چنین نتیجه ای قبلاً در تحقیقات قبلی در مورد تعمیم سکونتگاه ارائه شده است [ ۱۳ ، ۱۵]. در اینجا، ما این فرض را برای نمونه اولیه انتخاب جاده به عنوان نمایشی از نوع داده شبکه تأیید کردیم. نتایج مربوط به جاده ها هستند، اما ممکن است برای شبکه های دیگر مانند رودخانه ها نیز مرتبط باشند. تجزیه و تحلیل بیشتر در مورد دیگر انواع لایه های موضوعی نقشه باید در تحقیقات آینده انجام شود. در رویکرد بهبودیافته، ما نتایجی به دست آوردیم که تا حدود ۵۰ درصد بهتر و نزدیکتر به نقشه های طراحی شده توسط نقشه نگاران با تجربه نسبت به نقشه های به دست آمده از رویکرد پایه بود. عملکرد مدل های یادگیری ماشین (رویکرد پیشرفته) از ۸۰٫۹۴% تا ۹۱٫۲۳% برای مقیاس ۱:۵۰۰۰۰۰ و ۹۸٫۲۱% تا ۹۹٫۸۶% برای مقیاس ۱:۱,۰۰۰,۰۰۰ متغیر است. در مقابل، در مورد رویکرد پایه که متغیرهای بسیار ساده و محدود را پیاده سازی می کند، عملکرد بسیار بدتر است، زیرا از ۴۲٫۱٪ تا ۵۵ متغیر است. ۲۵% برای مقیاس ۱:۵۰۰,۰۰۰ و بین ۹۱٫۸۹% و ۹۸٫۳۹% برای مقیاس ۱:۱,۰۰۰,۰۰۰٫ شایان ذکر است که تفاوت بین رویکرد پایه و مدل پیشرفته با بهترین عملکرد در مقیاس ۱:۵۰۰۰۰۰، بهویژه برای ناحیه کپینسکی، به نزدیک به ۵۰ درصد میرسد که یک پیشرفت قابلتوجه است. برای مقیاس ۱:۱،۰۰۰،۰۰۰، تفاوت در عملکرد بین رویکردهای پایه و پیشرفته چندان قابل توجه نیست، اما همچنان در مورد منطقه Rzeszowski به بیش از ۷٪ می رسد. با این حال، در نتایج ML، ما هنوز شاهد برخی ناسازگاری ها و ناپیوستگی ها در شبکه راه هستیم که باید در تحقیقات بیشتر مورد بررسی قرار گیرد. برای مثال، اگرچه تعداد بنبستها در مورد DT-GA و RF تقریباً دو برابر کمتر از روش اصلی است، برای سطح جزئیات ۱:۵۰۰۰۰۰،جدول ۵ ، شکل ۷ ، شکل ۸ و شکل ۹ ). در حالی که، در مورد سطح جزئیات مربوط به مقیاس ۱:۱،۰۰۰،۰۰۰، در هر دو رویکرد پایه و پیشرفته، تعداد بن بست ها بسیار کم است ( جدول ۶ ، شکل ۱۰ ، شکل ۱۱ و شکل ۱۲).). دلیل این امر در ویژگی های این سطح از جزئیات نهفته است. در این مقیاس فقط جاده های اصلی حفظ می شوند که معمولاً یک شبکه منسجم را تشکیل می دهند. بنابراین، در کار آینده، مدلهای ML مورد استفاده در این تحقیق باید بهگونهای بهینهسازی و پارامترسازی شوند تا از سازگاری و اتصال کلی شبکه جاده اطمینان حاصل شود. برای غلبه بر این مشکلات، متغیرهای توپولوژیکی اضافی، به عنوان مثال، معیارهای بیشتر مرکزیت (نزدیک و درجه)، باید در آینده گنجانده شده و ارزیابی شوند [ ۴ ، ۸ ]. به منظور حفظ ثبات شبکه راه، محدودیت های توپولوژیکی نیز باید تعریف و در تحقیقات بیشتر اضافه شوند [ ۲۸ ]]. علاوه بر این، تخصیص اوزان یا اولویتهای بالاتر به متغیرهای مربوط به روابط فضایی بین بخشهای جاده و بخشهای جاده و سکونتگاهها باید مورد بررسی قرار گیرد [ ۲۳ ]. مشکلات مربوط به سازگاری شبکه راه ممکن است ماهیت مختلفی داشته باشد. دلیل نیز می تواند تفاوت بین پایگاه داده منبع و نقشه اطلس مرجع از نظر به موقع بودن و این واقعیت باشد که این دو مجموعه داده جداگانه ایجاد شده اند و بر اساس مفاهیم متفاوت هستند. بنابراین، در تحقیقات آینده، مجموعه دادههای هدف بهینهتر میتواند ایجاد شود. به عنوان مثال، برای آموزش مدلهای ML، میتوان از خروجی دادههای GGOD شبکه جادهای تعمیمیافته دستی که توسط یک نقشهنگار با تجربه ارائه میشود، استفاده کرد.
در نهایت، باید توجه داشت که هدف این تحقیق بازسازی کار یک نقشهبر دستی نیست: به هر حال، فرآیند طراحی نقشه دستی ذهنی است و ممکن است در بین طراحان نقشه متفاوت باشد. در عوض، هدف نهایی بررسی راه هایی برای کمک به کاهش هزینه طراحی نقشه و در عین حال سریعتر و کارآمدتر کردن فرآیند است. این واقعیت که دقت به ۱۰۰٪ نمی رسد به این معنی است که کار بیشتر بر روی بهینه سازی مدل های انتخاب جاده توصیه می شود. بنابراین، در کارهای آینده، متغیرهای بیشتر و گسترش مطالعات ما به حوزه های آزمایشی گسترده تر باید در نظر گرفته شود. با گسترش این تحقیق، انتظار داریم درختهای تصمیم گیری پیچیدهتر، اما در عین حال آموزندهتر و جامعتر بهدست آوریم.
منابع
- دی سرس، بی. روی، AG جهت جریان و هندسه انشعاب در اتصالات در شبکه های رودخانه دندریتیک. پروفسور Geogr. ۱۹۹۰ ، ۴۲ ، ۱۴۹-۲۰۱٫ [ Google Scholar ] [ CrossRef ]
- یو، ایکس. ساده سازی شبکه جاده با تحلیل فضایی مبتنی بر دانش. جی. جئوگر. علمی ۲۰۰۱ ، ۱۱ ، ۵۴-۶۲٫ [ Google Scholar ] [ CrossRef ]
- ژانگ، اچ. Li, Z. شبکه من وزنی برای تشکیل ساختار سلسله مراتبی شبکه های جاده ای. بین المللی جی. جئوگر. Inf. علمی ۲۰۱۱ ، ۲۵ ، ۲۵۵-۲۷۲٫ [ Google Scholar ] [ CrossRef ]
- ویس، آر. Weibel، R. انتخاب شبکه جاده برای نقشههای مقیاس کوچک با استفاده از الگوریتم بهبود یافته مبتنی بر مرکزیت. جی. اسپات. Inf. علمی ۲۰۱۴ ، ۹ ، ۷۱-۹۹٫ [ Google Scholar ] [ CrossRef ]
- بنز، SA; Weibel, R. انتخاب شبکه جاده برای مقیاس های متوسط با استفاده از الگوریتم ترکیبی مشبک-مش گسترده. کارتوگر. Geogr. Inf. علمی ۲۰۱۴ ، ۴۱ ، ۳۲۳-۳۳۹٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- سامسونوف، تی. Krivosheina، AM تعمیم مشترک نقاط شهر و شبکه جاده برای نقشه برداری در مقیاس کوچک. در GIScience 2012: هفتمین کنفرانس بین المللی علم اطلاعات جغرافیایی ; کلمبوس، اوه، ایالات متحده آمریکا، ۲۰۱۲; در دسترس آنلاین: https://www.researchgate.net/publication/264829198_Joint_generalization_of_city_points_and_road_network_for_small-scale_mapping (در ۵ ژانویه ۲۰۲۲ قابل دسترسی است).
- ریچاردسون، دی. تامسون، RC ادغام اطلاعات موضوعی، هندسی و توپولوژیکی در تعمیم شبکه های جاده ای. کارتوگر. بین المللی جی. جئوگر. Inf. Geovisualization ۱۹۹۶ ، ۳۳ ، ۷۵-۸۳٫ [ Google Scholar ] [ CrossRef ]
- جیانگ، بی. کلارامونت، سی. رویکردی ساختاری به تعمیم مدل شبکه خیابان شهری. GeoInformatica ۲۰۰۴ ، ۸ ، ۱۵۷-۱۷۱٫ [ Google Scholar ] [ CrossRef ]
- لیو، ایکس. ژان، بی. Ai, T. انتخاب جاده بر اساس نمودارهای ورونوی و «سکتهها» در تعمیم نقشه. بین المللی J. Appl. زمین Obs. Geoinf. ۲۰۱۰ ، ۱۲ (ضمیمه ۲)، ۱۹۴-۲۰۲٫ [ Google Scholar ] [ CrossRef ]
- Touya, G. فرآیند انتخاب شبکه جاده ای بر اساس غنی سازی داده ها و تشخیص ساختار. ترانس. GIS ۲۰۱۰ ، ۱۴ ، ۵۹۵-۶۱۴٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- Mackaness، W. Beard, K. استفاده از نظریه گراف برای پشتیبانی از تعمیم نقشه. کارتوگر. Geogr. Inf. سیستم ۱۹۹۳ ، ۲۰ ، ۲۱۰-۲۲۱٫ [ Google Scholar ] [ CrossRef ]
- Yan, H. توضیحات رویکردها و الگوریتمهای تعمیم خودکار برای گروههایی از اشیاء نقشه . Springer: سنگاپور، ۲۰۱۹٫ [ Google Scholar ]
- کارزنیا، آی. Weibel, R. بهبود انتخاب سکونت برای نقشههای مقیاس کوچک با استفاده از غنیسازی داده و یادگیری ماشین. کارتوگر. Geogr. Inf. علمی ۲۰۱۸ ، ۴۵ ، ۱۱۱-۱۲۷٫ [ Google Scholar ] [ CrossRef ][ نسخه سبز ]
- کارزنیا، آی. Sielicka، K. بررسی متغیرهای اساسی در انتخاب حل و فصل برای نقشههای مقیاس کوچک با استفاده از یادگیری ماشین. در چکیده های انجمن بین المللی کارتوگرافی ; فوجیتا، اچ.، ویرایش. انجمن بین المللی کارتوگرافی: توکیو، ژاپن، ۲۰۱۹؛ جلد ۱، ص. ۱۶۲٫ [ Google Scholar ] [ CrossRef ]
- کارزنیا، آی. Sielicka، K. هنگامی که انتخاب سنتی شکست میخورد: نحوه بهبود انتخاب سکونت برای نقشههای مقیاس کوچک با استفاده از یادگیری ماشین. ISPRS Int. J. Geo-Inf. ۲۰۲۰ ، ۹ ، ۲۳۰٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
- سستر، ام. فنگ، ی. Thiemann, F. ساخت تعمیم با استفاده از یادگیری عمیق. در آرشیو بین المللی فتوگرامتری، سنجش از دور و علوم اطلاعات فضایی، جلد XLII-4، مجموعه مقالات سمپوزیوم میان مدت ۲۰۱۸ ISPRS TC IV «علم اطلاعات فضایی سه بعدی—موتور تغییر»، دلفت، هلند، ۱- ۵ اکتبر ۲۰۱۸ ; انجمن بین المللی فتوگرامتری و سنجش از دور: دلفت، هلند، ۲۰۱۸٫ [ Google Scholar ]
- فنگ، ی. تیمن، اف. Sester, M. آموزش تعمیم ساختمان نقشه برداری با شبکه عصبی کانولوشنال عمیق. بین المللی J. Geo-Inf. ۲۰۱۹ ، ۸ ، ۲۵۸٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
- لاگرانژ، اف. لندراس، بی. Mustiere, S. تکنیک های یادگیری ماشینی برای تعیین پارامترهای الگوریتم های تعمیم نقشه برداری ; نوزدهمین کنگره ISPRS: آمستردام، هلند، ۲۰۰۰; جلد XXXIII، Pt B4، صص ۷۱۸–۷۲۵٫ [ Google Scholar ]
- بالبوآ، JLG؛ لوپز، طبقه بندی خطوط جاده تعمیم گرا FJA با استفاده از یک شبکه عصبی مصنوعی. Geoinformatica ۲۰۰۸ ، ۱۲ ، ۲۸۹-۳۱۲٫ [ Google Scholar ] [ CrossRef ]
- ژو، Q. Li, Z. استفاده از شبکه های عصبی مصنوعی برای حذف انتخابی در به روز رسانی شبکه های جاده ای. کارتوگر. J. ۲۰۱۴ ، ۵۱ ، ۳۸-۵۱٫ [ Google Scholar ] [ CrossRef ]
- ژنگ، جی. گائو، ز. ما، جی. شن، جی. Zhang، K. گراف عمیق شبکه های کانولوشن برای انتخاب دقیق شبکه جاده. ISPRS Int. J. Geo-Inf. ۲۰۲۱ ، ۱۰ ، ۷۶۸٫ [ Google Scholar ] [ CrossRef ]
- جپسن، ST; جنسن، CS; Dyhre Nielsen, T. Relational Fusion Networks: Graph Convolutional Networks for Road Networks. IEEE Trans. هوشمند ترانسپ سیستم ۲۰۲۲ ، ۲۳ ، ۴۱۸-۴۲۹٫ [ Google Scholar ] [ CrossRef ]
- Gülgen, F. سلسله مراتب جاده با ادغام صفات با استفاده از فازی-AHP. Geocarto Int. ۲۰۱۴ ، ۲۹ ، ۶۸۸-۷۰۸٫ [ Google Scholar ] [ CrossRef ]
- هان، ی. وانگ، ز. لو، ایکس. Hu, B. کاربرد AHP در انتخاب جاده. ISPRS Int. J. Geo-Inf. ۲۰۲۰ ، ۹ ، ۸۶٫ [ Google Scholar ] [ CrossRef ] [ نسخه سبز ]
- آیین نامه وزارت کشور در تاریخ ۱۷ نوامبر ۲۰۱۱ در مورد پایگاه داده های اشیاء توپوگرافی و پایگاه داده های اشیاء جغرافیایی عمومی و همچنین محصولات استاندارد کارتوگرافی، مجله قوانین سال ۱۳۹۰، شماره ۲۷۹ مورد ۱۶۴۲٫ موجود به صورت آنلاین: https://isap.sejm. gov.pl/isap.nsf/DocDetails.xsp?id=WDU20112791642 (دسترسی در ۵ ژانویه ۲۰۲۲).
- کارزنیا، آی. سیلیکا، ک. Weibel, R. بهینه سازی انتخاب جاده برای نقشه های مقیاس کوچک با استفاده از مدل های مبتنی بر درخت تصمیم. در چکیدههای AutoCarto بیست و سومین سمپوزیوم بینالمللی پژوهشی نقشهبرداری و علوم GIS نقشهبرداری و جامعه اطلاعات جغرافیایی ; ردلندز، کالیفرنیا، ایالات متحده آمریکا، ۲۰۲۰؛ در دسترس آنلاین: https://tinyurl.com/58yrs79a (در ۵ ژانویه ۲۰۲۲ قابل دسترسی است).
- RapidMiner 9. Operator Reference Manual 2019. بازیابی شده در ۱۲ مه ۲۰۲۲٫ موجود به صورت آنلاین: https://docs.rapidminer.com/latest/studio/operators/rapidminer-studio-operator-reference.pdf (دسترسی در ۵ ژانویه ۲۰۲۲).
- دادگاهی، ع. تویا، جی. Zhang، X. ارزیابی مبتنی بر محدودیت تصاویر نقشه تعمیم یافته توسط یادگیری عمیق. جی. جوویس. تف کردن مقعدی ۲۰۲۲ ، ۶ ، ۱۳٫ [ Google Scholar ] [ CrossRef ]
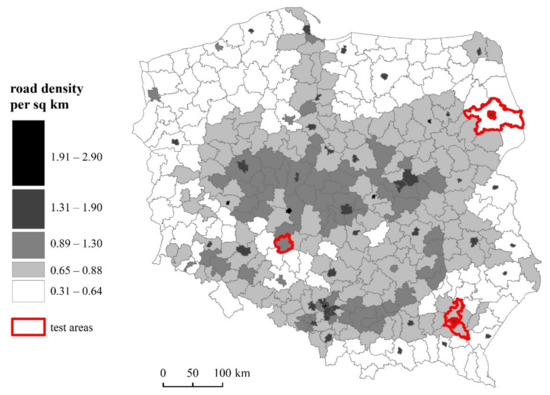
شکل ۱٫ نواحی انتخاب شده به عنوان مناطق آزمایشی که بر روی یک نقشه choropleth از تراکم جاده در لهستان پوشانده شده اند.

شکل ۲٫ گردش کار روش تحقیق (بر اساس [ ۱۳ ]).
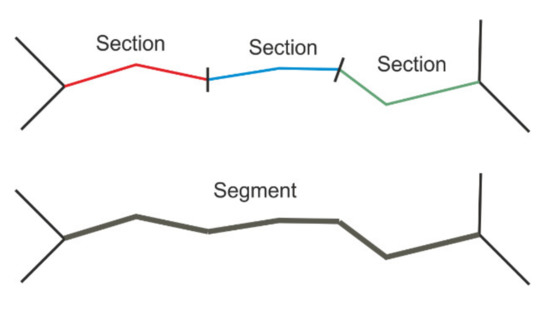
شکل ۳٫ جاده ها به صورت بخش ها و بخش ها ارائه شده اند.

شکل ۴٫ درخت تصمیم برای سه ناحیه، نتیجه یادگیری ماشین DT-GA – انتخاب جاده برای مقیاس ۱:۵۰۰۰۰۰٫

شکل ۵٫ درخت تصمیم برای سه ناحیه، نتیجه یادگیری ماشین DT – انتخاب جاده برای مقیاس ۱:۵۰۰۰۰۰٫

شکل ۶٫ درخت تصمیم برای سه ناحیه، نتیجه یادگیری ماشین DT و DT-GA – انتخاب جاده برای مقیاس ۱:۱,۰۰۰,۰۰۰٫
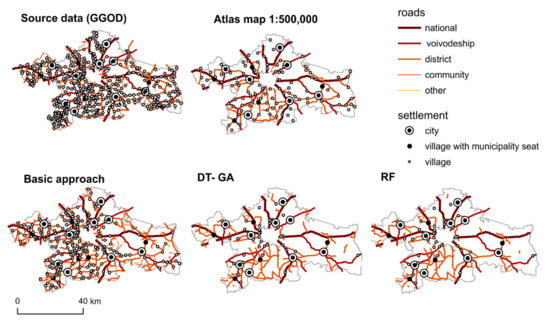
شکل ۷٫ نتایج انتخاب در ناحیه Białostocki در مقیاس ۱:۵۰۰۰۰۰٫

شکل ۸٫ نتایج انتخاب در ناحیه رززووسکی در مقیاس ۱:۵۰۰۰۰۰٫

شکل ۹٫ نتایج انتخاب در ناحیه Kępiński در مقیاس ۱:۵۰۰۰۰۰٫

شکل ۱۰٫ نتایج انتخاب در ناحیه Białostocki در مقیاس ۱:۱,۰۰۰,۰۰۰٫

شکل ۱۱٫ نتایج انتخاب در ناحیه رززووسکی در مقیاس ۱:۱,۰۰۰,۰۰۰٫
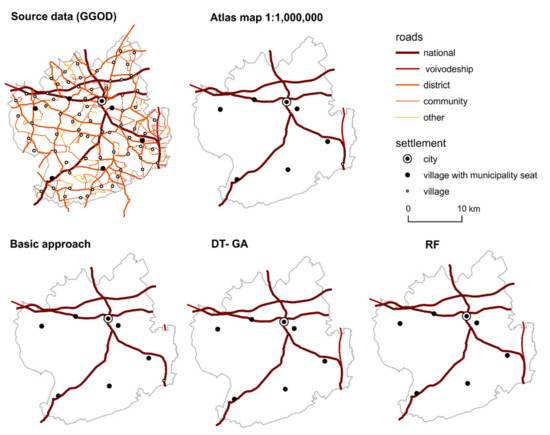
شکل ۱۲٫ نتایج انتخاب در ناحیه Kępiński در مقیاس ۱:۱,۰۰۰,۰۰۰٫